
6.6k的涡轮7900xtx拉不拉--- 蓝宝石7900 XTX BLOWER涡轮对比自用白金版
-
蓝宝石7900 XTX BLOWER涡轮对比白金版:拉不拉 ---不拉

手头原来有一张蓝宝石 RX 7900 XTX 24G白金版,最近又买了一张蓝宝石 RX 7900 XTX 24G BLOWER涡轮卡。主要用途是本地大模型,发现两张卡速度有差距,这次将两张卡都设为驱动默认硬件策略,再用同一套模型软件参数测了一轮。
两张卡在实际推理中出现过明显速度差距,所以继续做了相同模型、相同软件参数的对照,也检查了功耗、温度、基础计算及PCIe路径。
先说当前测到的成绩:
三任务算术均值 白金303W BLOWER 257W 涡轮落后 普通解码 44.69 token/s 43.76 token/s 2.1% ngram12+MTP 81.22 token/s 76.81 token/s 5.4% 两卡保留各自默认功耗上限,均为默认profile、自动DVFS及自动风扇。普通解码已经很接近,MTP尚有约5%~6%的差距。
个人觉得还是很值的差距两卡差距5%左右,不排除pcie影响,这差距我是能接受的,6636RMB 新卡,免息三期。机箱里有个这个卡跟白金完美搭配,能把机箱内空气排出去完美。
测试平台、方法与参数
测试日期2026-10-27;Ubuntu 26.04、Intel ES 14核20线程、B760 DDR4,64GB(4×16GB),本轮2133 MT/s。下表中的两张卡在相同内存频率下测试。
项目 共同设置或区别 引擎 llama.cpp Vulkan,a8d9a7e,build169 驱动 Mesa RADV 26.0.8-1ubuntu0.3;libdrm 2.4.131;内核7.0.0-38 模型 Qwen3.8-27B-UD-Q4_K_S.gguf,同一个约15.36GB文件,保留mmproj-F16.gguf 推荐环境变量 GGML_VK_ALLOW_GRAPHICS_QUEUE=1、RADV_PERFTEST=sam上下文 -c 262144 --parallel 2,总上下文262K;实际输入为短提示或16K文档卸载与KV -ngl 999 -fa 1 -ub 512;K/V均q4_0;backend sampling投机组 ngram-map-k4v+draft-mtp,ngram长度12,draft最多3,p-min0 请求 temperature0、seed42、关闭思考;三个短任务强制512输出token 白金路径 CPU直连侧Gen4×16,功耗上限303W 涡轮路径 南桥上游实际Gen3×4,GPU端点虽显示×16,整条路径仍受×4限制;功耗上限257W 硬件策略 两卡均profile0/BOOTUP_DEFAULT、auto DVFS、自动风扇 两卡依次单独服务,另一张空闲;每个配置两次独立启动,第二轮反转顺序,每组有固定冷却阈值。表图来自本轮完整96请求实验中、双方使用推荐参数的对应48条记录,其中包括预热、短任务及长文测试。本帖未测双卡TP或双请求并发。
两张卡都在启动llama-server前设置:
export GGML_VK_ALLOW_GRAPHICS_QUEUE=1 export RADV_PERFTEST=samsam是AMD RADV/Vulkan的进程选项,不会把PCIe×4变成×16;ROCm/HIP未由这项参数优化。已有RADV选项需要合并,避免sam/nosam冲突。未替换驱动或刷VBIOS。生成速度:两张卡使用同样参数
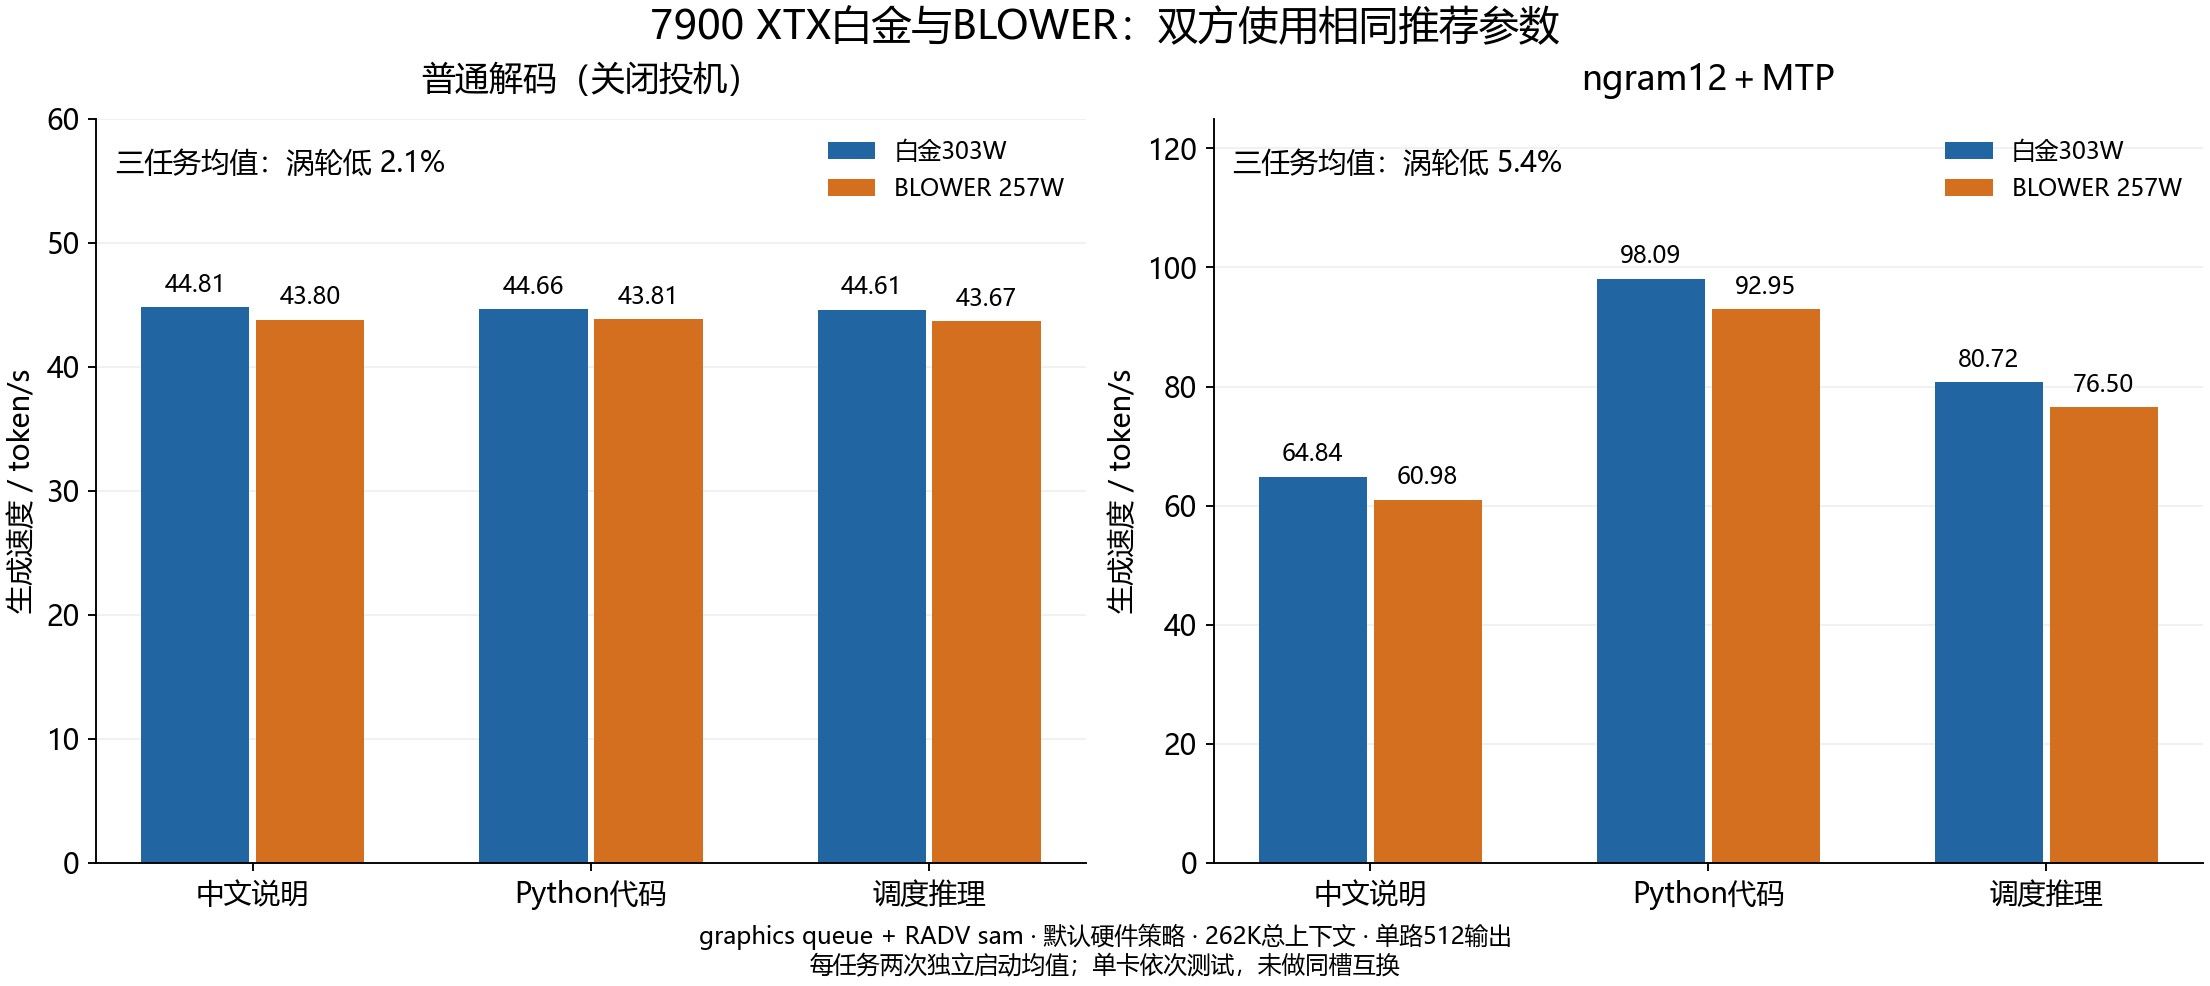
模式 任务 白金303W / token/s BLOWER 257W / token/s 涡轮落后 普通解码 中文说明 44.81 43.80 2.2% 普通解码 Python代码 44.66 43.81 1.9% 普通解码 调度推理 44.61 43.67 2.1% 普通解码 三任务算术均值 44.69 43.76 2.1% ngram12+MTP 中文说明 64.84 60.98 6.0% ngram12+MTP Python代码 98.09 92.95 5.2% ngram12+MTP 调度推理 80.72 76.50 5.2% ngram12+MTP 三任务算术均值 81.22 76.81 5.4% 每格为同一提示、两次独立启动的算术均值,每次输出512token;三任务均值不代表所有业务的固定吞吐。使用服务原生
timings.predicted_per_second。同模式同提示的两卡输出SHA256一致;MTP草稿数量与接受数量也一致,比较没有依赖接受率变化。功耗、热点和显存温度
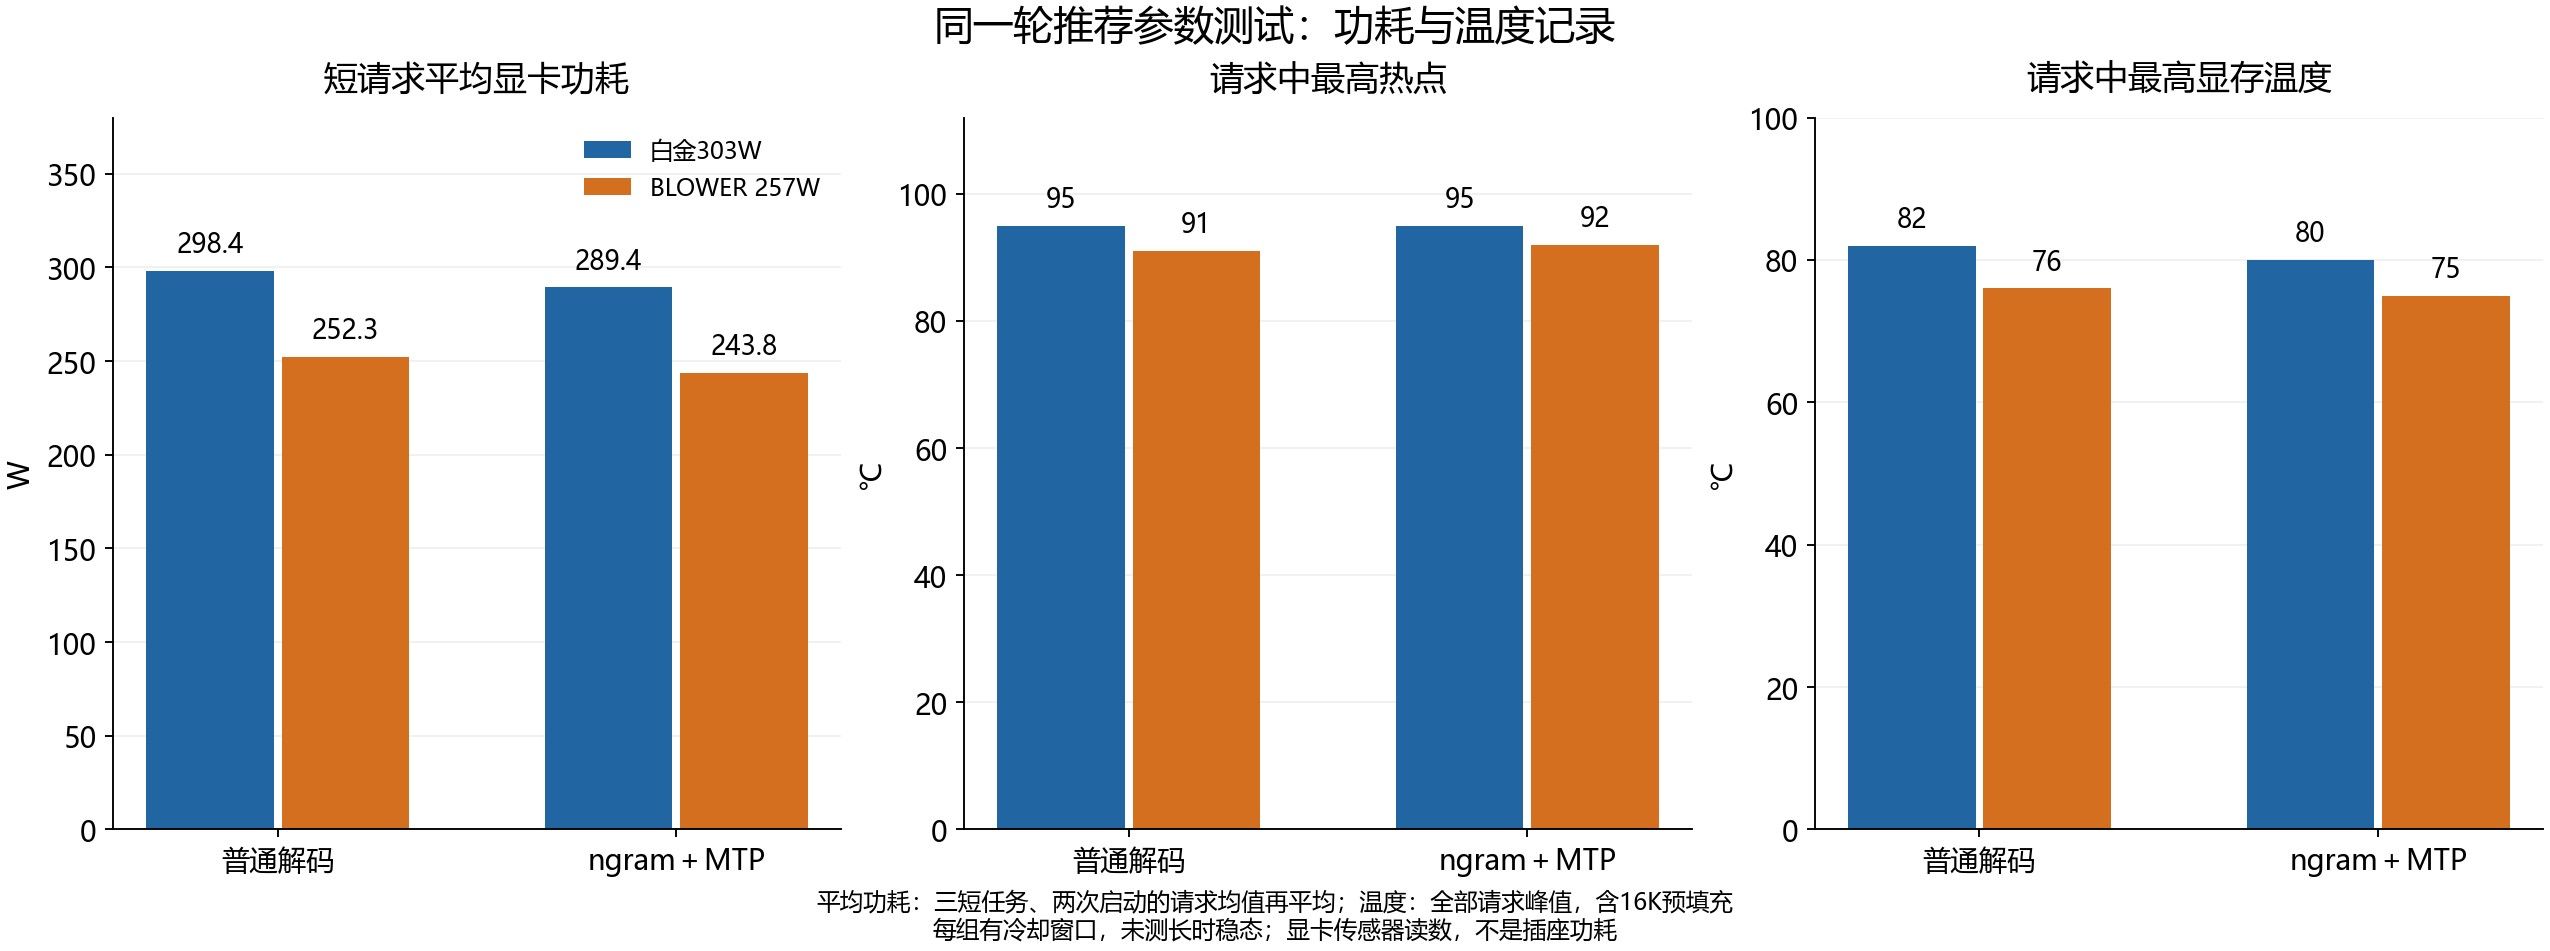
模式 显卡 短请求平均功耗/W 请求最高热点/℃ 请求最高显存/℃ 普通解码 白金 298.4 95 82 普通解码 BLOWER 252.3 91 76 ngram+MTP 白金 289.4 95 80 ngram+MTP BLOWER 243.8 92 75 平均功耗是三个短任务、两次启动的请求均值再平均;最高温度来自该配置全部请求,含16K预填充。数据来自显卡传感器,不能当作插座整机功耗。
每组有冷却窗口,不能据此排名长时稳态散热,也不能说明涡轮升温一定更慢。本轮没有触发实验温度保护。此前涡轮提高到303W跑持续INT8负载曾达到103℃热点并停止,该记录仍保留,散热余量需单独考虑。本帖没有测噪音分贝。
16K长文首字和立即重复
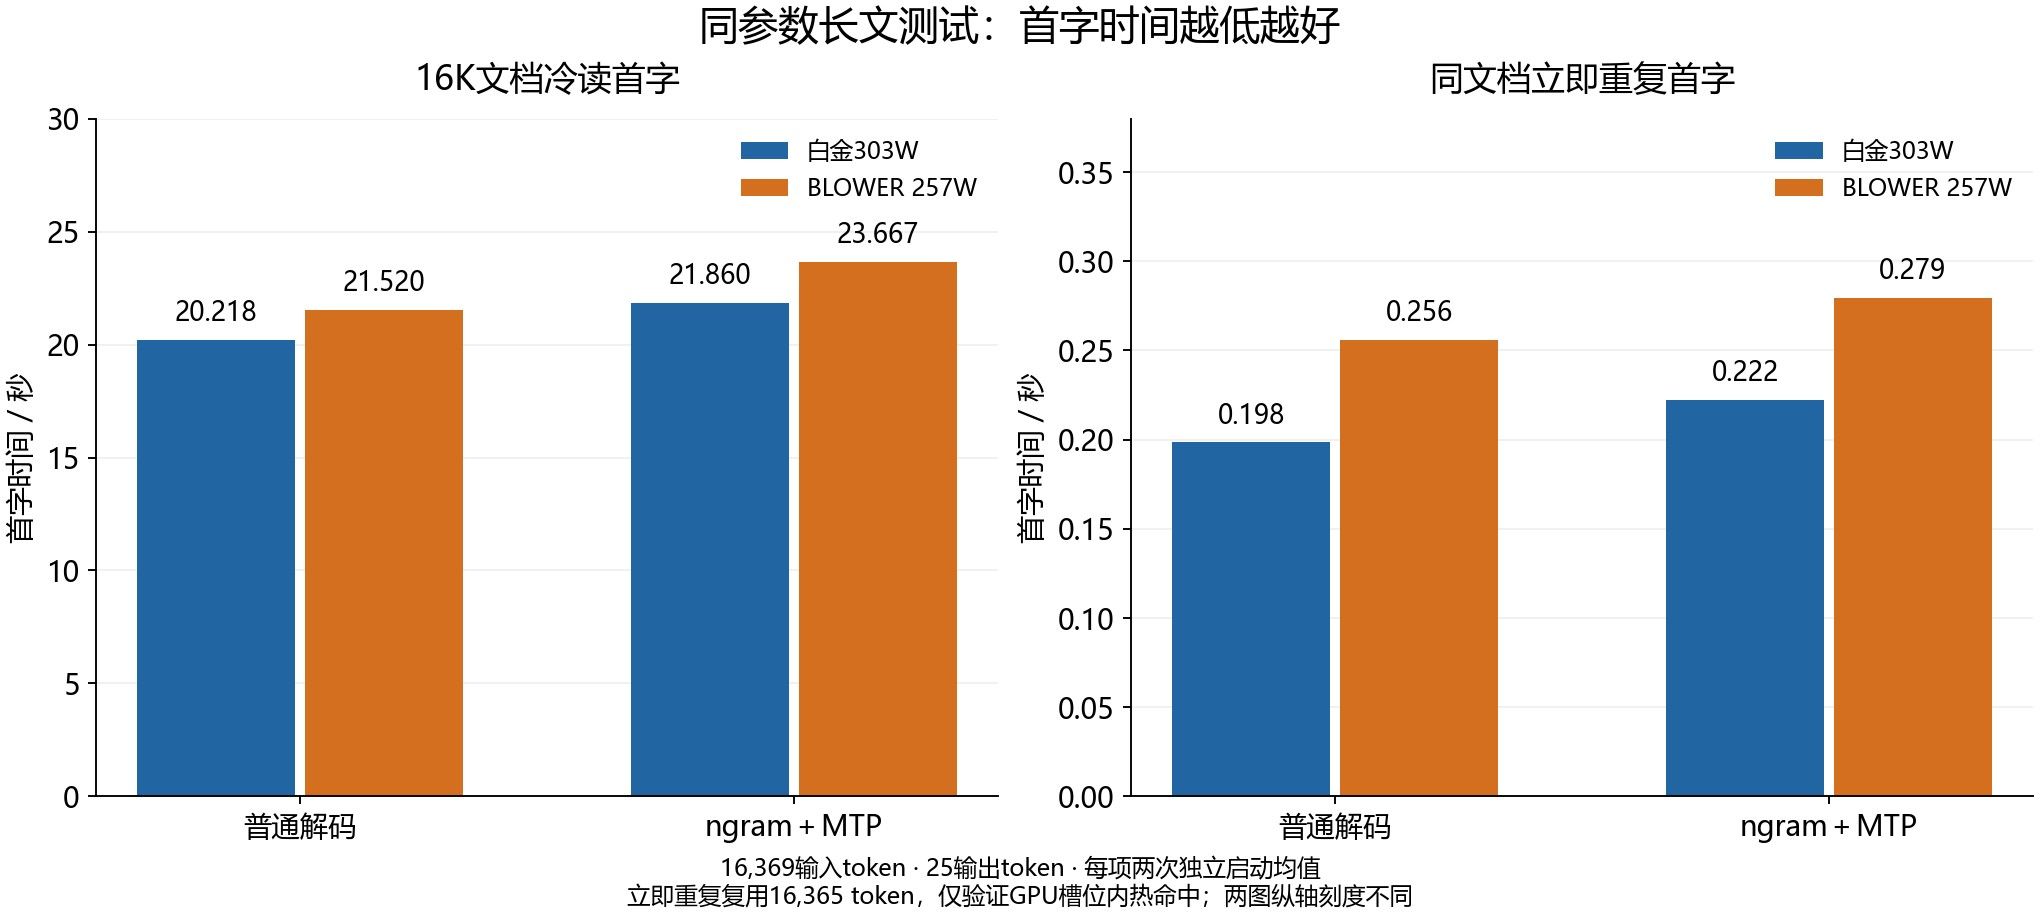
模式 显卡 16K冷读首字 / 秒 立即重复首字 / 秒 普通解码 白金 20.218 0.198 普通解码 BLOWER 21.520 0.256 ngram12+MTP 白金 21.860 0.222 ngram12+MTP BLOWER 23.667 0.279 固定16369输入token、25输出token,前中后三个标记均通过。立即重复复用16365token、重算4token。这是GPU槽位内立即命中,不能仅凭配置了16GiB RAM缓存,就视为换出后从RAM恢复的成绩。推荐参数主要改善生成,本轮没有看到预填充或热命中首字同等幅度的收益。
找到的主要影响因素:RADV缓冲区放置策略
除了模型权重,执行还涉及命令、描述符及上传数据。Mesa的
radv_amdgpu_cs_domain()会按PCIe带宽、显存可见性等选择命令缓冲区的放置策略,upload buffer也使用该选择。本机南桥低带宽路径默认倾向GTT系统内存,RADV_PERFTEST=sam使对应分配优先使用VRAM。前期分配探针记录到:每进程98笔分配中,60笔、约3.13MB的命令/上传类请求在GTT与VRAM优先策略间切换;大块权重分配保持不变。再结合sam/nosam反向对照,主要Vulkan差距已定位到这项策略与南桥路径的组合。VRAM优先仍可回退GTT,没有逐包定位每笔PCIe延迟。
此前持续探针在相同272W下,FP32差约1.5%,INT8涡轮略快约1.8%,显存读取/复制差不到0.5%。这与修正软件路径后生成速度接近的结果相符,目前不足以将这张卡判成“核心或显存天生慢十几个百分点”。这些是有限探针,并非全显存体检或整卡质量认证。
源码参考:缓冲区放置选择、upload buffer调用。
这张6636元涡轮卡,我现在怎么评价
主要用于本地推理时,统一软件参数后的成绩比最初预期更接近白金:普通解码差2.1%,ngram+MTP均值差5.4%,同时涡轮保留257W上限,白金为303W。这改善了保留这张卡的理由。
目前的探针和模型结果不足以支持“涡轮用了次品核心,所以算力差十几个百分点”的判断。不过,算力接近只是其中一项,仍需确认主槽链路能稳定×16;长时散热和噪音也要结合实际使用体验。短请求温度较低不能证明散热器更强,本文也未进行全显存体检或噪音分贝测试。
我的后续重点是把主槽链路确认完整,再根据是否反复降宽、异常是否跟着卡走,判断是否需要售后。完成前,不给这张卡下“硬件完全没问题”或“卡已经坏了”的结论。
这篇只比较两张卡各自运行27B模型。双卡TP、分层及独立服务并发需要另做对照,不能用这里的单卡数据换算双卡收益或R9700等其他显卡成绩。
完整启动参数和复现材料
先将
LLAMA_SERVER_BIN、MODEL_FILE、MMPROJ_FILE设为实际路径;GPU_DEVICE按--list-devices重新选。换槽后设备编号可能改变。export GGML_VK_ALLOW_GRAPHICS_QUEUE=1 export RADV_PERFTEST=sam "$LLAMA_SERVER_BIN" -m "$MODEL_FILE" --device "$GPU_DEVICE" \ --mmproj "$MMPROJ_FILE" \ --spec-type ngram-map-k4v,draft-mtp \ --spec-ngram-map-k4v-size-n 12 \ --spec-draft-n-max 3 --spec-draft-p-min 0 --backend-sampling \ --host 127.0.0.1 --port 58091 -ngl 999 -fa 1 -c 262144 -ub 512 \ --cache-type-k q4_0 --cache-type-v q4_0 --reasoning off \ --cont-batching --cache-prompt --cache-reuse 256 --parallel 2 \ --slot-prompt-similarity 0.80 --cache-ram 16384普通解码仅将
--spec-type改成none。 -
-
-
,
 T terry 固定了此主题
-
这也算是一个大事,涡轮卡我是拒绝的,尤其是官方有大风扇版本的情况下,但是6600,蓝宝石的话,可以考虑。
-
-
-
-
-
@terry 我最近在考虑用X99 TF 装双卡7900xtx蓝宝石白金版,发现有一个问题,直接插两个x16的pice槽,两张卡之间只有不到1cm,只能用pcie连接线了。如果有一张是涡轮就没有这个问题了,这也算是涡轮的一个好处吧
-
还不如外接,外接只要再650左右就够了,但是热量应该能够降低5°
-
-
-
-
只爱涡轮卡
帮显卡搬个家,换了个机箱
多装了3个风扇
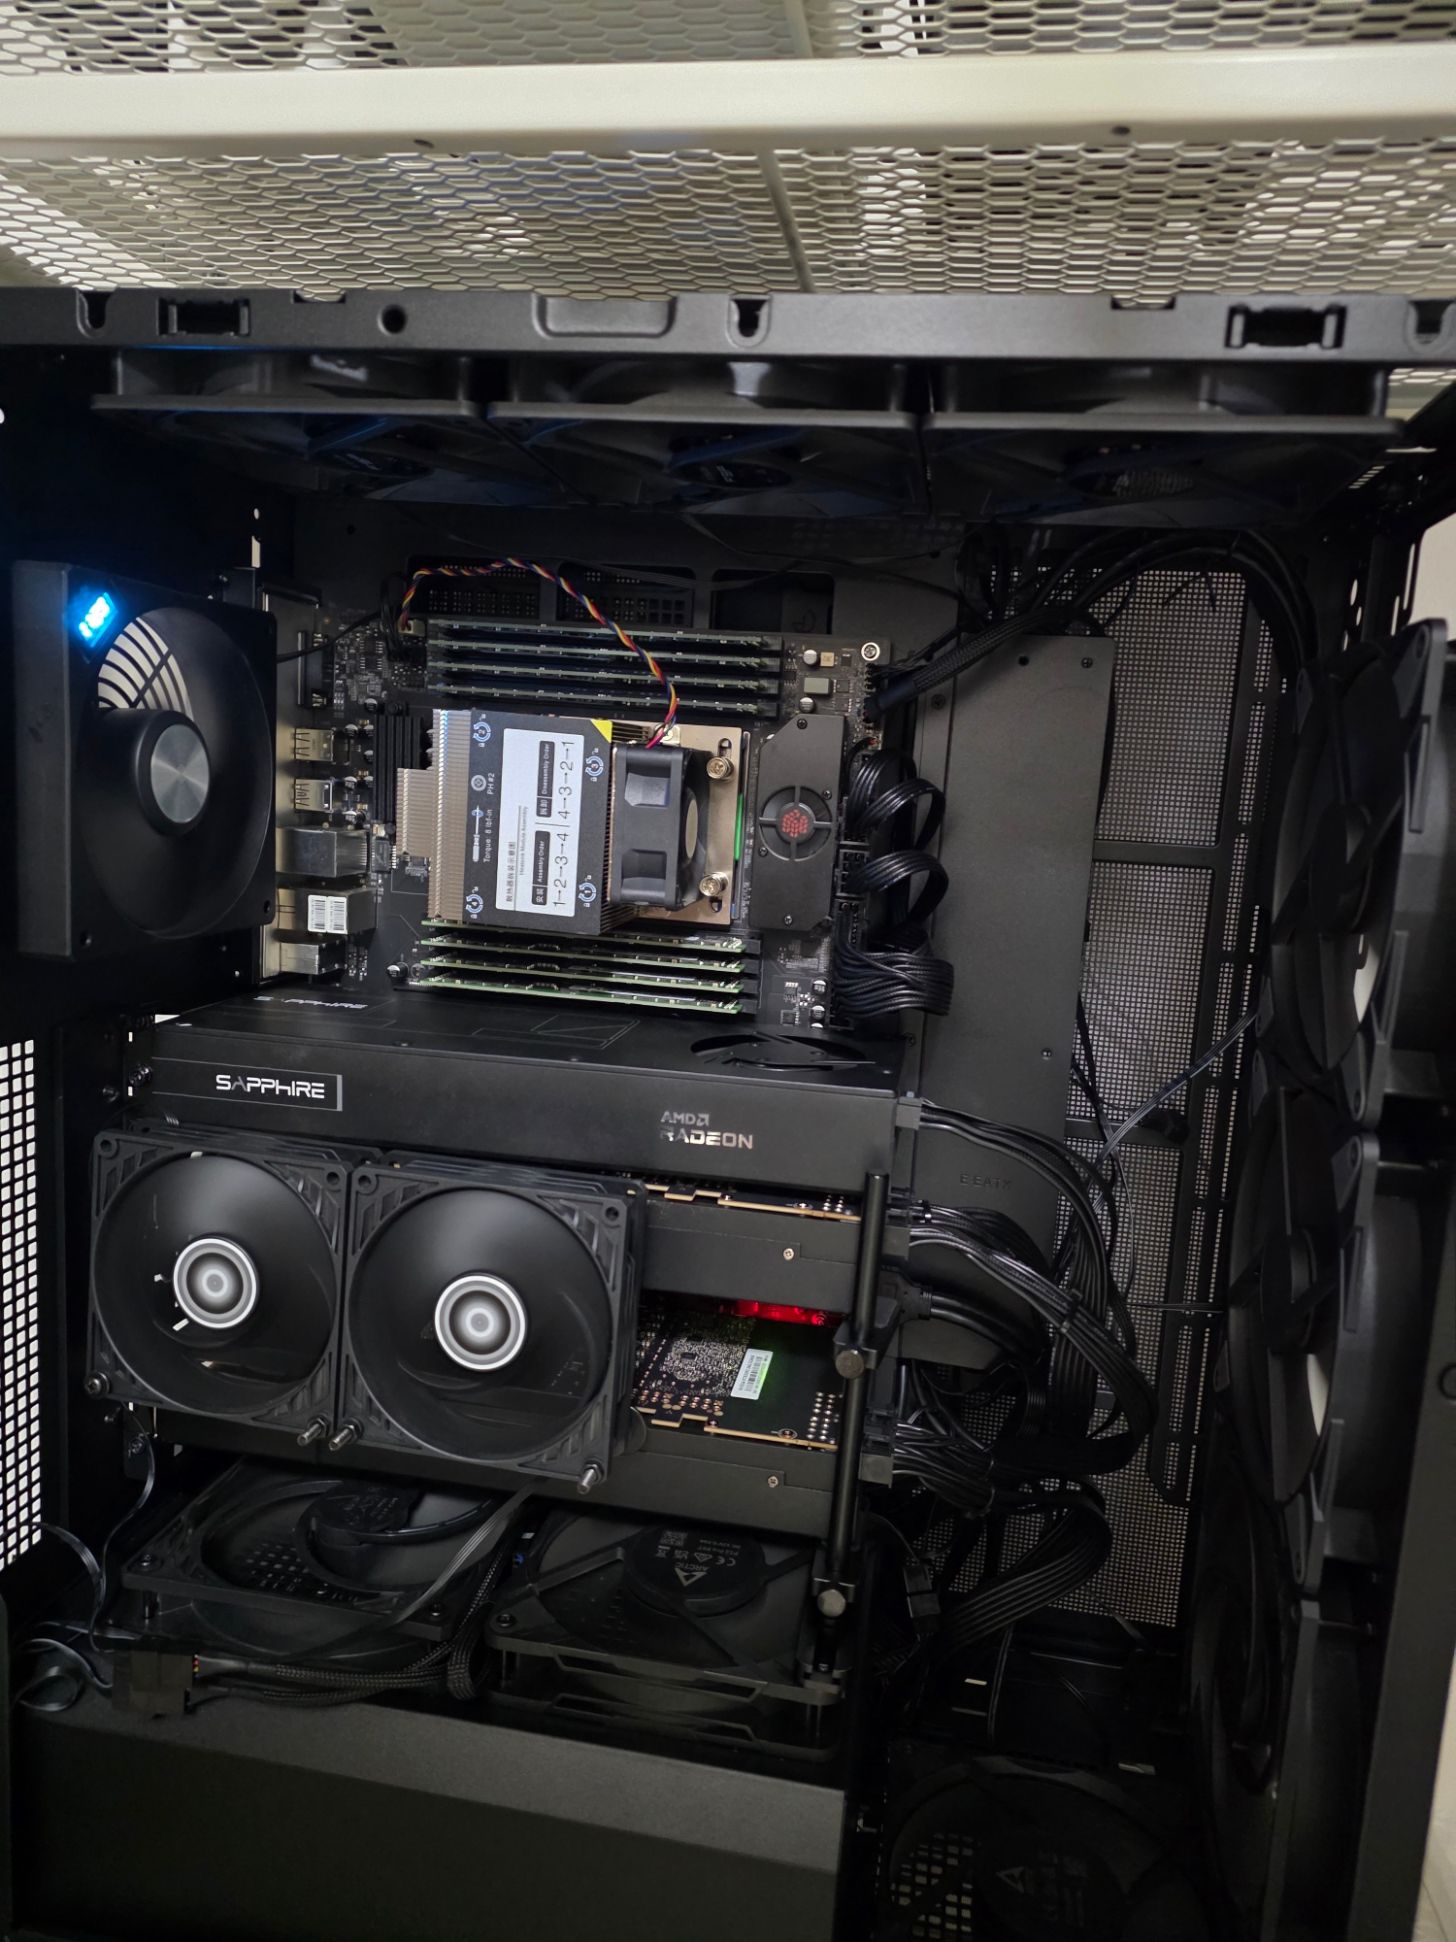
@applejuice 涡轮卡弄不好容易撞功耗墙。 我之前的 3090 涡轮就是这样, 跑一会就上95了, 然后撞墙降速。 后来被我发现了, 换成了三风扇, 非常静音而且不撞墙了, 满载没超过80.
-
-
-
@applejuice 涡轮卡弄不好容易撞功耗墙。 我之前的 3090 涡轮就是这样, 跑一会就上95了, 然后撞墙降速。 后来被我发现了, 换成了三风扇, 非常静音而且不撞墙了, 满载没超过80.
@johnnybegood 我三张卡都限功耗250w
一方面我的电源也不能支撑3张卡满载
再来后面1/3功耗 只换来15%所以我就限制了在250w我测试过3090满功耗 显卡风扇75%转 热点也只在90以内
如果是显卡温度只在70以内
cpu 温度55,机箱里面温度也只有45以内我只考虑3090 寿命 噪音不是我的考虑因为机器在房间 外面
-
@terry 京东自营 那天上架我看到的是6300元。之后24小时内连续涨价。比股票的走势还玄学。
-
@terry 我最近在考虑用X99 TF 装双卡7900xtx蓝宝石白金版,发现有一个问题,直接插两个x16的pice槽,两张卡之间只有不到1cm,只能用pcie连接线了。如果有一张是涡轮就没有这个问题了,这也算是涡轮的一个好处吧
-
只爱涡轮卡
帮显卡搬个家,换了个机箱
多装了3个风扇





 本帖参与讨论人数已达 10+,入选热议,作者 +3 积分奖励,感谢分享!