
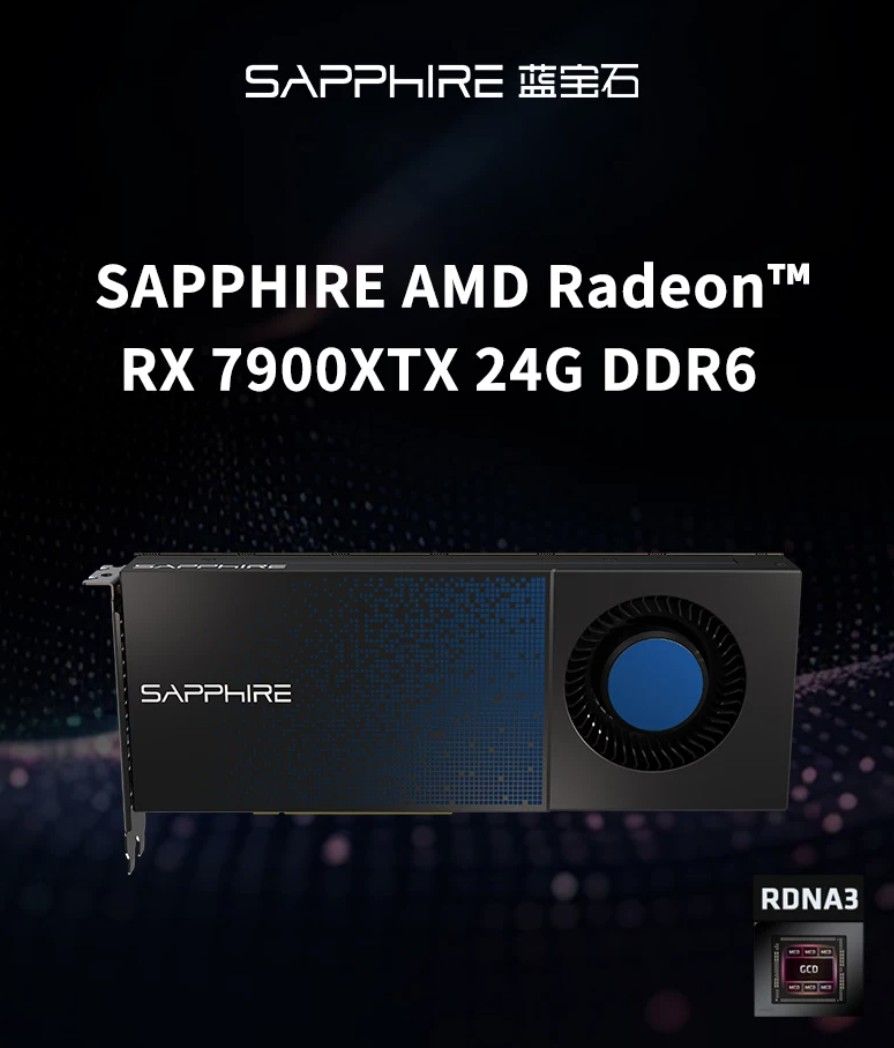
6.6k的涡轮7900xtx拉不拉--- 蓝宝石7900 XTX BLOWER涡轮对比自用白金版
-
蓝宝石7900 XTX BLOWER涡轮对比白金版:恢复默认硬件策略再测27B
手头原来有一张蓝宝石 RX 7900 XTX 24G白金版,最近又买了一张蓝宝石 RX 7900 XTX 24G BLOWER涡轮卡。主要用途是本地大模型,发现两张卡速度有差距,这次将两张卡都设为驱动默认硬件策略,再用同一套模型软件参数测了一轮。
先说本机结果:27B模型普通解码下,BLOWER比白金版低约16.4%~16.6%;开启ngram+MTP后,三个任务低约13.6%~14.2%。 两次独立启动均保留了原始记录。
这是一台机器当前部署状态的对比。两卡的功耗上限、PCIe上游通道不同,本轮没有同槽互换,因此这些数字不能直接认定为BLOWER卡本体的纯性能差。 也不能推广成所有同款卡的表现。
环境和测试方法
测试日期:2026-10-26。
项目 设置 平台 Ubuntu 26.04;Intel ES 14核20线程;B760 DDR4 内存 64GB,4×16GB,当前2666 MT/s 推理引擎 llama.cpp Vulkan,0.7.0-dev,build169,commit a8d9a7e1e55f5b613f297504d9e159807ec3a99b 模型 Qwen3.8-27B-UD-Q4_K_S.gguf,保留mmproj-F16.gguf加载 GPU卸载 / KV -ngl 999;K/V均q4_0;Flash Attention开启 上下文 / 槽位 -c 262144,parallel=2;测试每次只发一路请求 两卡固定的软件负载参数 ngram长度12、MTP draft最大3、p-min=0、backend-sampling、RAM会话缓存16GiB 请求 temperature=0、seed=42、关闭思考;相同输入SHA256 对比两种模式:普通解码
--spec-type none;开启投机的--spec-type ngram-map-k4v,draft-mtp。后者是ngram与MTP的组合,表中的加速比不等于单独MTP的贡献。两卡硬件均为
BOOTUP_DEFAULT(profile0)、动态频率auto、自动风扇。功耗分别采用驱动读回的power1_cap_default,不超频、不降压、不提高功耗。每条请求前后均读回核验默认策略。这里的“默认”指硬件策略,软件仍使用公开列出的相同测试配方。每种模式按白金→BLOWER→BLOWER→白金交替执行,每卡两次独立启动。每次先算术预热,然后依次测试中文技术说明、Python LRU代码、仓库调度方案,以及同一份16K文档的首次读取和立即重复。共8组、48条请求,其中8条为预热。
三个短任务均禁止复用提示,最大输出512 token,本轮实际也均为512 token。16K文档实际输入16369 token,最多输出48,实际均输出25 token,并检查开头、中间、结尾三个标记。另一张卡的原实例保持空闲。
下表生成速度采用服务端原生timings的两次算术均值;同时存了客户端流式计时。首字从发出请求计到收到第一段非空内容,包含提示处理。两次重复只用来观察复现情况,没有据此计算置信区间。相同seed在不同计算路径下仍可能生成不同正文,本次不是模型质量评测。
27B生成速度
模式 任务 白金版 tok/s BLOWER tok/s BLOWER低多少 普通解码 中文说明 42.15 35.13 16.6% 普通解码 Python代码 42.09 35.16 16.5% 普通解码 调度方案 41.98 35.09 16.4% ngram12+MTP 中文说明 61.87 53.10 14.2% ngram12+MTP Python代码 92.86 80.23 13.6% ngram12+MTP 调度方案 76.67 65.93 14.0% BLOWER启用ngram+MTP后,相比它自己的普通解码,三个任务生成速度提高约51%~128%。软件加速对它有效,但这轮没有把两卡的差距消除。具体收益随任务和草稿接受率变化,代码速度不能代表所有对话。
本轮MTP的三个短任务,两卡输出SHA256逐项一致,草稿接受计数也一致:中文291/700(41.57%)、代码360/450(80.00%)、调度328/546(60.07%)。这几个任务的速度差,不能用“新卡碰巧生成了另一段内容、接受率更低”来解释;仍未分离功耗与连接路径的影响。
16K文档首字时间
模式 白金冷读首字 BLOWER冷读首字 白金立即重复 BLOWER立即重复 普通解码 19.767秒 21.754秒 0.191秒 0.270秒 ngram12+MTP 21.498秒 23.856秒 0.222秒 0.284秒 首次读取各组复用token均为0;立即重复均复用16365 token,只重新计算4 token。这是GPU活动槽位的立即命中,不是切换多份文档后的RAM恢复测试。长文只生成25 token,因此没有拿它的短输出速度作为主要性能结论。
功耗、温度,以及没有排除的因素
项目 白金版 BLOWER 固件默认功耗上限 303W 257W 驱动策略 / 频率 / 风扇 BOOTUP_DEFAULT / auto / 自动 BOOTUP_DEFAULT / auto / 自动 当前PCIe整条路径 Gen4×16 显卡端点显示Gen4×16,但上游实际为Gen3×4 供电线,按我的装机记录 三根 两根 模式 卡 三个短任务平均功耗 三个短任务平均核心频率 全组最高热点 --- --- ---: ---: ---: 普通解码 白金版 300.1W 2831MHz 96°C 普通解码 BLOWER涡轮 252.3W 2698MHz 94°C ngram12+MTP 白金版 292.8W 2493MHz 95°C ngram12+MTP BLOWER涡轮 245.8W 2437MHz 95°C 功耗是GPU传感器读数,含各请求的提示处理和生成;不是插座功耗。频率也是请求期间的采样均值。全组温度包含16K预填,最高为96°C;本轮没有达到103°C的测试中止阈值,没有观察到新增GPU内核错误。它是短时性能对比,不能替代长时间满载的散热与稳定性测试。
两根还是三根供电线,本身不足以判断性能根因。当前能确认的是,两卡均处于默认策略,但各自的功耗预算与连接路径确实不同;未做同槽互换、同功耗对照,也没有刷BIOS。
关于PCIe,我之前到货时曾把BLOWER插到主板PCIe5.0×16槽试过,体感与另一个槽接近,但那次没有保留同脚本互换日志,这里只作为使用观察。模型权重驻显存会减少PCIe传输;预填、CPU参与和同步等环节仍可能涉及主机链路,既不能把全部差距归给PCIe,也不能认为PCIe必然零影响。
我的使用判断
这张BLOWER能正常参与本地推理,ngram+MTP也有明显收益;但在我目前这台机器的部署条件下,它作为第二张卡,单卡生成速度持续低于自用白金版。
本轮只在实验期间使用原卡默认硬件策略,结束后恢复日常运行配置。没有进行优化参数筛选。
本轮测的是各卡单独处理同一任务,没有测双卡并发或把同一请求拆到两张卡,不能把两张单卡tok/s相加,当作单次对话会得到的速度。
如果购买目标是获得与现有白金版接近的第二张7900 XTX,这轮结果没有达到我的预期。是否由卡本体、功耗预算、散热或连接路径分别造成多少,还需要同槽互换等进一步对照。欢迎同款BLOWER用户用相近模型、量化、上下文和参数提供结果作比较。
<details>
<summary>本轮关键启动参数,路径已改为示例</summary>llama-server \ -m /models/Qwen3.8-27B-UD-Q4_K_S.gguf \ --mmproj /models/mmproj-F16.gguf \ --device VulkanN --host 127.0.0.1 --port 58110 \ -ngl 999 -fa 1 -c 262144 -ub 512 \ --cache-type-k q4_0 --cache-type-v q4_0 --reasoning off \ --cont-batching --cache-prompt --cache-reuse 256 \ --parallel 2 --slot-prompt-similarity 0.80 --cache-ram 16384 \ --backend-sampling \ --spec-type ngram-map-k4v,draft-mtp \ --spec-ngram-map-k4v-size-n 12 \ --spec-draft-n-max 3 --spec-draft-p-min 0普通解码仅把
--spec-type改为none;VulkanN按本机--list-devices选择,不能照抄设备编号。实际模型为约15.36GB的同一个文件,两卡使用同一二进制与输入文件。</details>
-
-
-
,
 T terry 固定了此主题
-
这也算是一个大事,涡轮卡我是拒绝的,尤其是官方有大风扇版本的情况下,但是6600,蓝宝石的话,可以考虑。
-
-
-
-
-
@terry 我最近在考虑用X99 TF 装双卡7900xtx蓝宝石白金版,发现有一个问题,直接插两个x16的pice槽,两张卡之间只有不到1cm,只能用pcie连接线了。如果有一张是涡轮就没有这个问题了,这也算是涡轮的一个好处吧
-
还不如外接,外接只要再650左右就够了,但是热量应该能够降低5°
-
-
-
-
只爱涡轮卡
帮显卡搬个家,换了个机箱
多装了3个风扇
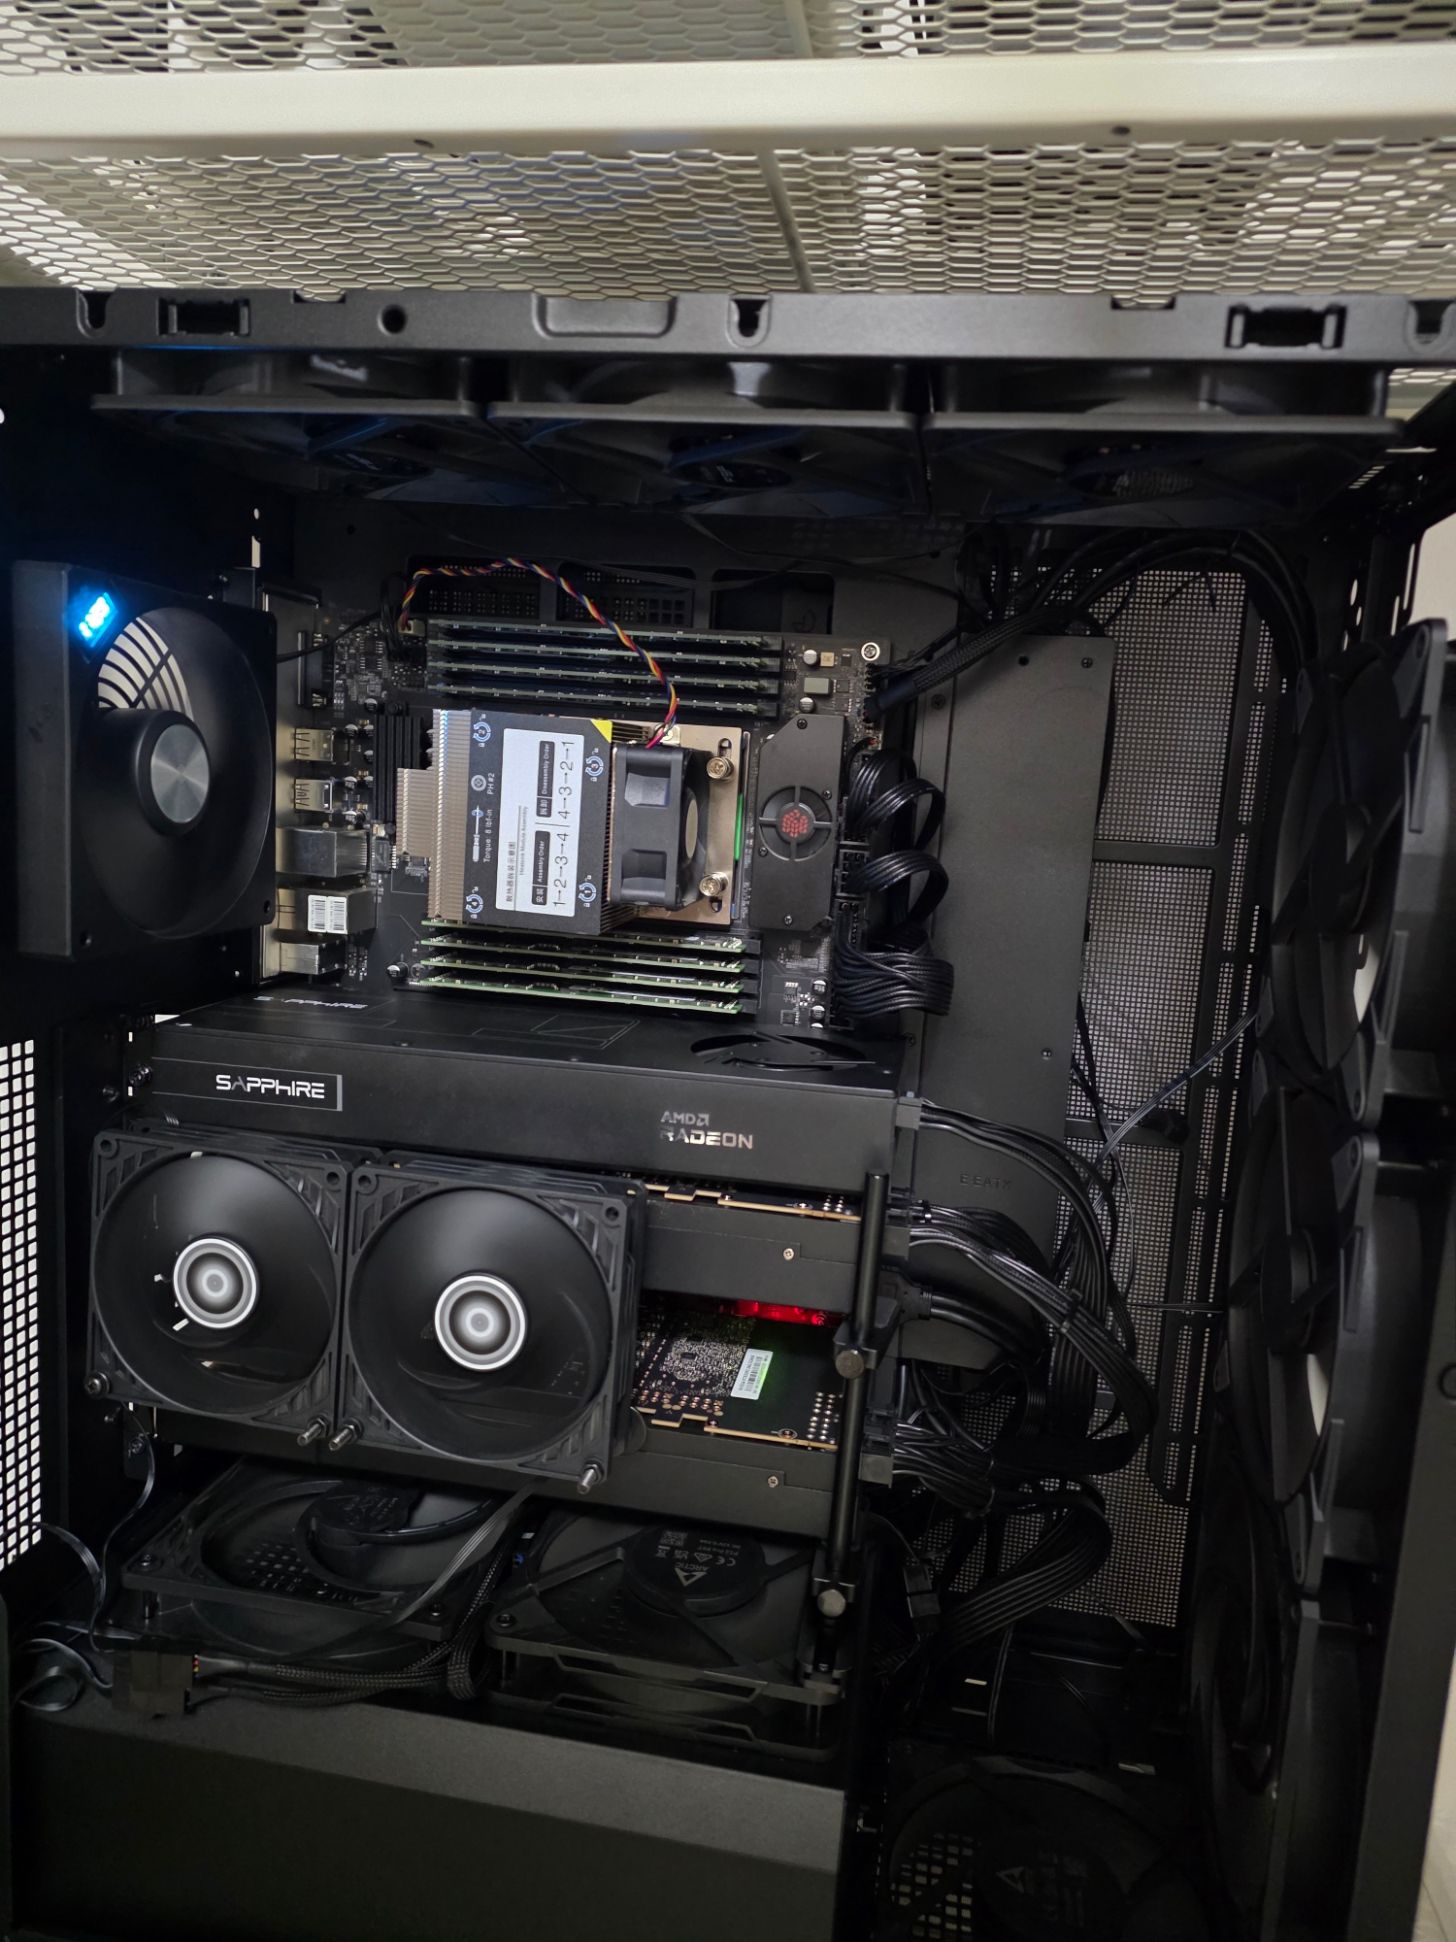
@applejuice 涡轮卡弄不好容易撞功耗墙。 我之前的 3090 涡轮就是这样, 跑一会就上95了, 然后撞墙降速。 后来被我发现了, 换成了三风扇, 非常静音而且不撞墙了, 满载没超过80.
-
-
-
@applejuice 涡轮卡弄不好容易撞功耗墙。 我之前的 3090 涡轮就是这样, 跑一会就上95了, 然后撞墙降速。 后来被我发现了, 换成了三风扇, 非常静音而且不撞墙了, 满载没超过80.
@johnnybegood 我三张卡都限功耗250w
一方面我的电源也不能支撑3张卡满载
再来后面1/3功耗 只换来15%所以我就限制了在250w我测试过3090满功耗 显卡风扇75%转 热点也只在90以内
如果是显卡温度只在70以内
cpu 温度55,机箱里面温度也只有45以内我只考虑3090 寿命 噪音不是我的考虑因为机器在房间 外面
-
@terry 京东自营 那天上架我看到的是6300元。之后24小时内连续涨价。比股票的走势还玄学。





 本帖参与讨论人数已达 10+,入选热议,作者 +3 积分奖励,感谢分享!