Google 新版的 開源Gemma 也要出來了?
-
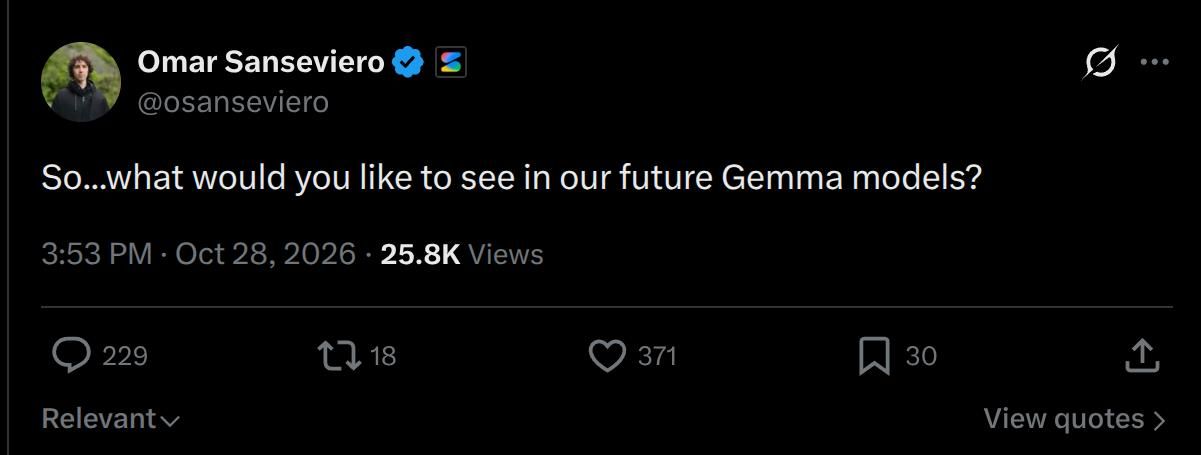
這張圖來自X.com
file:///home/alpha/Pictures/2026-10-28_20-28.jpg我一直覺的 Gemma4 31B雖然什麼都很爛
但是如果純當聊天機器人抄棒的
情緒價值給好給滿
其他就算了 哈~
-
-
-
至少训练自英文源
-
@kos-or 你破梗了.....說什麼大實話....哈~
-
這張圖來自X.com
file:///home/alpha/Pictures/2026-10-28_20-28.jpg我一直覺的 Gemma4 31B雖然什麼都很爛
但是如果純當聊天機器人抄棒的
情緒價值給好給滿
其他就算了 哈~
-
-
Gemma4 31B 測了一次,繁中過不了關,就拜拜了,GOOGLE,繁中還NG......,QWEN 繁中都過關的!!(都有加限制)
-
@YDM 繁簡問題,不要說對AI來說很難了,對我們這些用慣繁體的也很難,我只知道小學老師常常拿國語辭典來判斷繁簡
畢竟繁簡以外還有什麼異體字之類的
要解決這種方法通常是輸出後,再用國語字典之類的文字庫再過濾一遍
簡轉繁 加檢查限制,Gemma4 31B 還是會吐出簡體字,而且很看Gemma4的心情,Qwen 3.6之後就沒發生過了。
另外簡轉繁有個陷阱:「于」這個字簡繁通用(作為姓氏或地名時本來就寫「于」),如果無腦做簡轉繁,所有「于」都會被強制轉成「於」,變成「于=於」的錯誤對映,所以轉換規則必須加語意判斷,不能純字面替換。
我平常手寫是簡繁混用沒關係,但丟給 Hermes 建檔的資料一律要求全繁體。一旦混了簡體字,發到別的電腦上,簡繁字體渲染明顯不同,排版看起來非常難看;可如果全改簡體,有些長輩又會看不懂部分簡字。所以結論是乾脆全部統一全繁體最保險。
就是這個原因,模型聽不聽話很重要,最基本的簡轉繁就不穩定了,那後面我就不會測了,哈~~~