
【结论:可行!】双 RX 7900 XTX 以 TP=2 跑 MiniMax-H3 的可行性实测报告
-
-
双 RX 7900 XTX 以 TP=2 跑 MiniMax-H3和单K 4080S 32GB,就跑comfyui来说,选择哪个更有效率?反正4080S也有3年质保嘛,楼主大神建议一下。
@Michael-ZHANG 你喜欢折腾就搞A,你喜欢安逸就选N。
劈头盖脸问我是要娶柳岩好还是孙燕姿好,你也是把我问到了。 -
-
-
出1344乘768分辨率的视频,测试是16g显存就够,其实双7900xtx可以测试一下生成1920或者2048分辨率,甚至更高,看看速度怎么样
@Werther-Wang 常规工作流是跑个低分辨率低桢的视频来校验关键词,没问题通过专门的节点补桢并提升分辨率。起手高分辨率我看来意义不大。
-
@Werther-Wang 常规工作流是跑个低分辨率低桢的视频来校验关键词,没问题通过专门的节点补桢并提升分辨率。起手高分辨率我看来意义不大。
-
@xiongjie-gao 直出高分辨率画质会好一些。对画质有极致要求的可以尝试,一般也都用不到。
@Werther-Wang anyway,作为测试其能力边界,是有意义的。而且TP=2明显摊薄通信短板,已经安装上在跑了。
-
出1344乘768分辨率的视频,测试是16g显存就够,其实双7900xtx可以测试一下生成1920或者2048分辨率,甚至更高,看看速度怎么样
-
@Werther-Wang 谢谢你的对比测试,有参考意义.
@Michael-ZHANG 不过你还要考虑cpu和内存有没有影响,这个我不知道,我测试用的cpu和内存你也考虑下。
-
谢谢老哥的对比测试, 目前单卡起步跑儿童频道, 多几个月买多一张了过来抄作业. 🤩 也感谢各位a卡发热的老哥们

 现在好稀罕几个月前买下的7900xtx 下了班折腾折腾还挺好玩

-
@Michael-ZHANG 不过你还要考虑cpu和内存有没有影响,这个我不知道,我测试用的cpu和内存你也考虑下。
@Werther-Wang 我的配置:
CPU:AMD EPYC 7k62
内存:镁光DDR4 3200 RECC 32GB x2
硬盘:SSD致钛1TB NVme
主板:华南金牌H12D-8D(单路)
电源:长城F16白金1600W
显卡:AMD MI50x2
机箱:长城黑匣子AI09
网卡:主板自带2.5GBx2
C PU,内存,SSD,显卡是公司淘汰的,其他的我自己买的。目前准备再买2条32GB REC C内存。再买显卡把MI50换了,之前考虑A卡Pro9700一张或者2张, 看了大家的测评,感觉买一张N卡就可以了。这套系统主要跑comfyui。LLM用在线API,主要用Deepseek/MiniMax/千问三家的。 -
@Michael-ZHANG 不过你还要考虑cpu和内存有没有影响,这个我不知道,我测试用的cpu和内存你也考虑下。
@Werther-Wang CPU和内存不会是瓶颈
通信摊薄曲线:640×352 → 1536×864(124 帧,均为 4–8 步实测)
分辨率 S(token) 单卡 s/步 TP=2 s/步 加速比 all_reduce 通信耗时占单步 640×352 8 140 5.80 5.28 1.10× 8.6 GB 45% 832×480 14 430 11.23 9.44 1.19× 14.9 GB 40% 1024×576 21 312 19.10 14.99 1.27× 21.8 GB 36% 1280×704 32 560 35.49 26.00 1.37× 33.0 GB 32% 1344×768 37 296 43.72 30.78 1.42× 37.8 GB 29% 1536×864 47 952 65.60 44.49 1.47× 48.5 GB 26% 通信耗时 = TP2 单步 − 单卡单步/2(把「计算完美二分」当基准),等效带宽稳定在 3.6–4.2 GB/s。加速比随 S 单调上升,S 从 8.1k 到 48k(5.9×)时单卡单步涨 11.3×,因为 attention 是 S²、all_reduce 只是 S——这就是“摊薄”的来源。
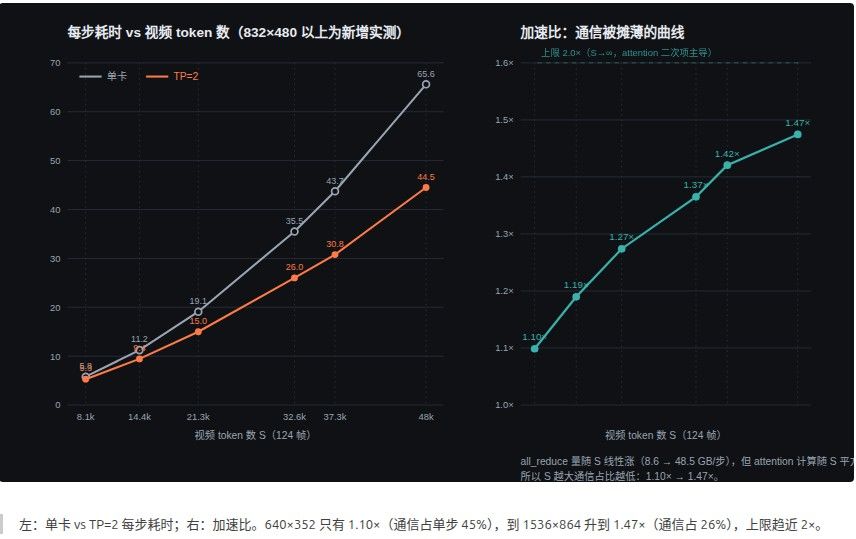
左:单卡 vs TP=2 每步耗时;右:加速比。640×352 只有 1.10×(通信占单步 45%),到 1536×864 升到 1.47×(通信占 26%),上限趋近 2×。
基本印证跟我的对提升上限1.50×的猜想
-
@Werther-Wang CPU和内存不会是瓶颈
通信摊薄曲线:640×352 → 1536×864(124 帧,均为 4–8 步实测)
分辨率 S(token) 单卡 s/步 TP=2 s/步 加速比 all_reduce 通信耗时占单步 640×352 8 140 5.80 5.28 1.10× 8.6 GB 45% 832×480 14 430 11.23 9.44 1.19× 14.9 GB 40% 1024×576 21 312 19.10 14.99 1.27× 21.8 GB 36% 1280×704 32 560 35.49 26.00 1.37× 33.0 GB 32% 1344×768 37 296 43.72 30.78 1.42× 37.8 GB 29% 1536×864 47 952 65.60 44.49 1.47× 48.5 GB 26% 通信耗时 = TP2 单步 − 单卡单步/2(把「计算完美二分」当基准),等效带宽稳定在 3.6–4.2 GB/s。加速比随 S 单调上升,S 从 8.1k 到 48k(5.9×)时单卡单步涨 11.3×,因为 attention 是 S²、all_reduce 只是 S——这就是“摊薄”的来源。
左:单卡 vs TP=2 每步耗时;右:加速比。640×352 只有 1.10×(通信占单步 45%),到 1536×864 升到 1.47×(通信占 26%),上限趋近 2×。
基本印证跟我的对提升上限1.50×的猜想
-
@xiongjie-gao 分辨率还能再提高么?最高能生成多大的分辨率,我比较好奇。
@Werther-Wang 我的两张卡性能开关都在均衡上,要测极限还要动硬件。太累了

-
,
 T terry 固定了此主题
-
-
双 RX 7900 XTX 以 TP=2 跑 MiniMax-H3和单K 4080S 32GB,就跑comfyui来说,选择哪个更有效率?反正4080S也有3年质保嘛,楼主大神建议一下。
-
@Werther-Wang 这是你的测试结果吗?怎么最近我有段时间没玩了,视频的要求已经这么低了?原生高分辨率的意义就是在正式出片时,大显存强算力单卡生产。否则试错成本太高不值得。放大也有专门的节点和工作流,虽然没原生好,调试下,也能用。
-
-
,T terry 引用了 此主题
-
-


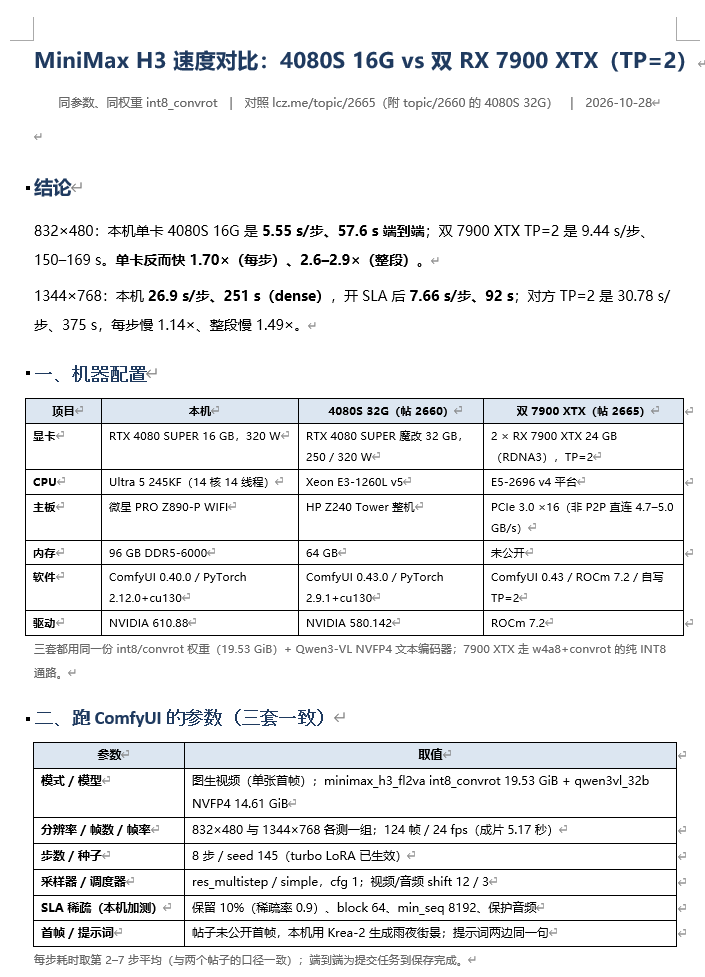
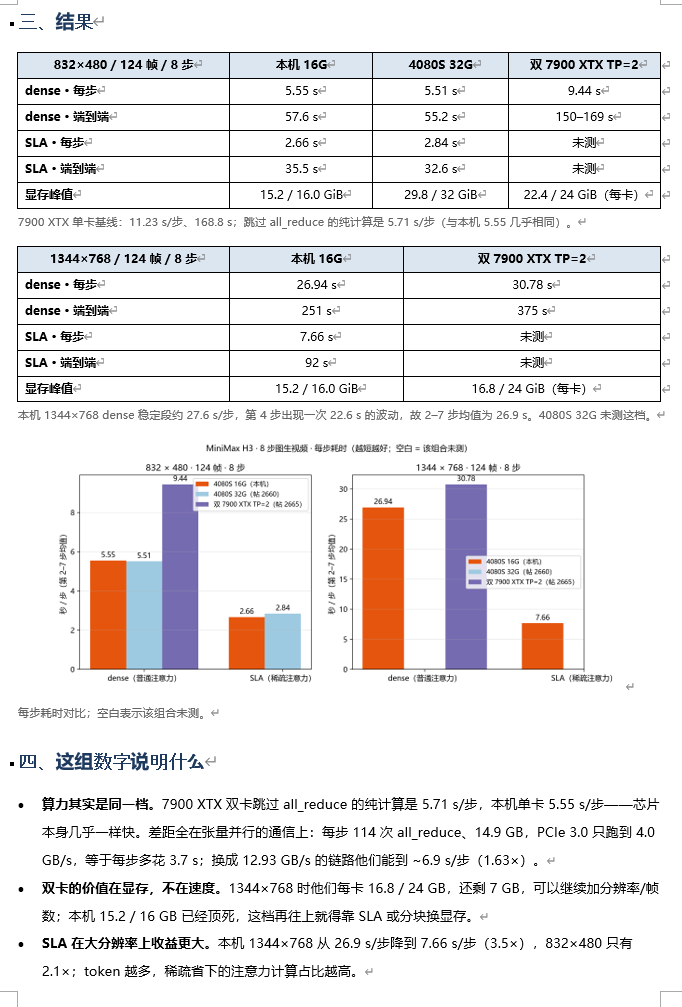


 版主审定:本帖设为精华,作者 +6 积分奖励,希望再接再厉!
