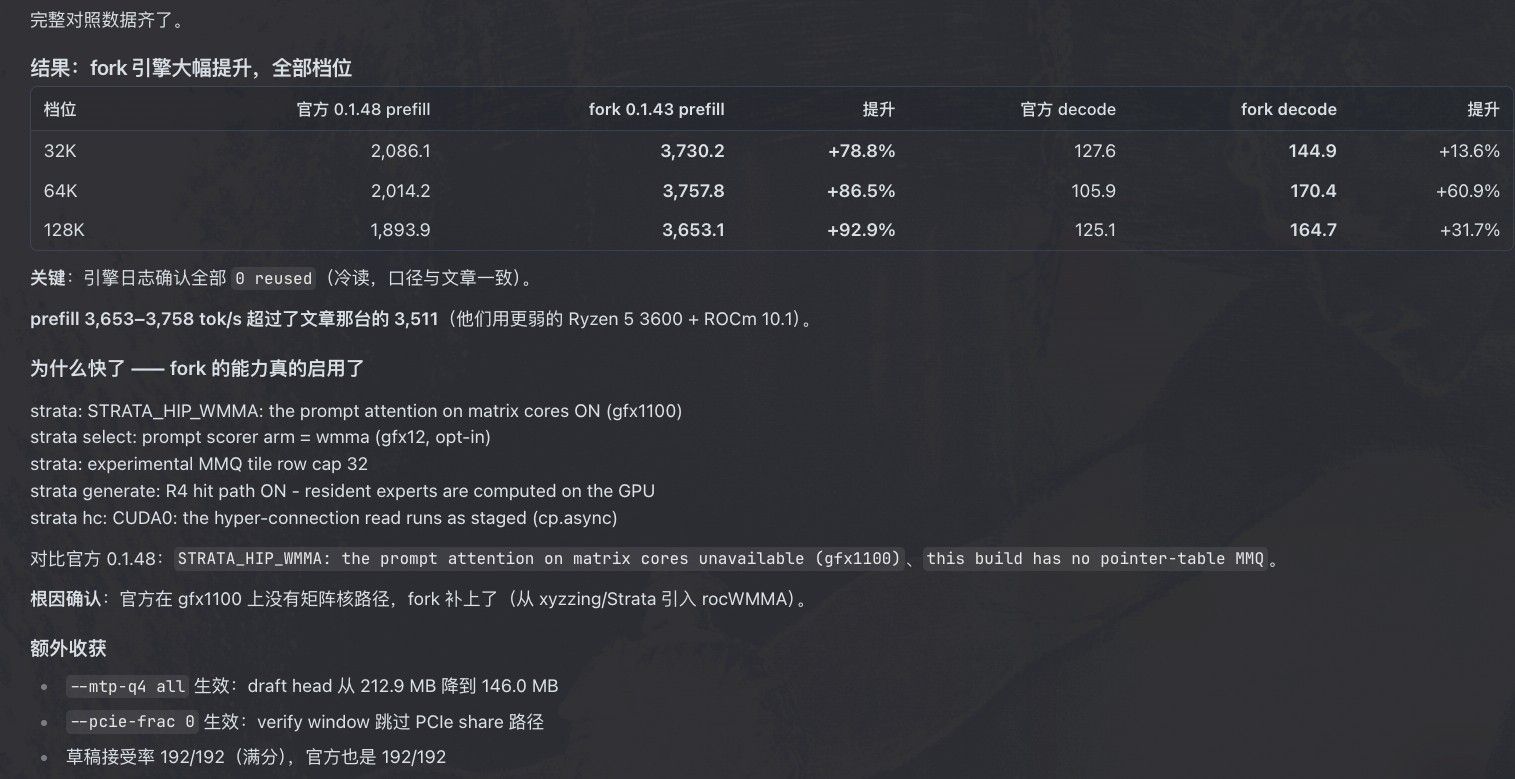
神了, 7900xtx 单卡prefill 3,570 tok/s decode 106.6 tok/s, Strata RDNA3 fork:安装、调优与 32K–256K 性能实测
-
Strata RDNA3 fork:安装、调优与 32K–256K 性能实测
机器:llm-server / 192.168.2.6 | 日期:2026-10-29 | 引擎:
nicejunjie/Strata-rdna3@ PR #1(309f0c8f),engine 0.1.43
模型:Swift 1.5 Qwen3.8-Flash-Next GSQ-RCO IQ3_S abliterated(2 shard)+ native pack + MTP draft
GPU:单张 RX 7900 XTX 24 GiB(gfx1100) | CPU:Ryzen 5 3600(6 核 12 线程,Zen 2,无 AVX-512)
0. 摘要
档位(实测 prompt) 原版 0.1.52 prefill fork prefill 倍数 原版 0.1.52 decode fork decode 倍数 32K(32,045 tok) 1,696 tok/s ※ 3,511 tok/s 2.07× ~70 tok/s ※ 100.6 tok/s 1.44× 64K(64,038 tok) — 3,570 tok/s — — 106.6 tok/s — 128K(131,056 tok) — 3,601 tok/s — — 101.2 tok/s — 256K(260,002 tok) — 3,336 tok/s — — 95.5 tok/s — ※ baseline 只有 32K,取自本机 2026-10-09 的实测记录(原版 0.1.52):裸基线 1,502 tok/s,加上
--prefill auto:32768+STRATA_PF_FUSED/GEMM/SWITCH_MIN_T+--spec-min-p 0.7这套优化后 1,696 tok/s;
decode 同机历史日志 67–70 tok/s。上表的倍数按 1,696 / 70 计算。一句话:同一台机器、同一个模型,只把引擎换成 fork 并按它的预设调参,prefill 大约翻倍,decode 约 +44%;
32K 的 prefill 达到参考帖子(Ryzen 9 3900X 上 3,529 tok/s)的 99.5%,decode 超过它(88.1)。
1. 测试环境
硬件
项 值 CPU AMD Ryzen 5 3600,6 核 12 线程,32 MiB L3,Zen 2 指令集 AVX2 / FMA / F16C,无 AVX-512(这一条决定了必须用 PR #1,见 §2.2) 内存 62 GiB DDR4(引擎常驻约 55 GB) GPU AMD Radeon RX 7900 XTX,24 GiB,gfx1100,PCIe 3.0 x16(主板限制,卡本身 Gen4) 存储 NVMe,权重约 84 GB 软件
项 值 备注 OS Ubuntu 22.04 / kernel 6.8 ROCm /opt/rocm= 10.1.0(amdgpu 7.1.9)系统安装,不是 TheRock 轮子 hipBLASLt 1.4.x 决定 tuning 表必须是 100401(见 §3.3)rocWMMA headers @ commit 1ab208f4(tag rocm-7.1.1)fork pin 的版本,自己下 zip,见 §2.4 llama.cpp commit 3cf03257CMake FetchContent 自动拉 编译器 gcc 11.4.0(host)+ /opt/rocm/llvm/bin/clang++(HIP)CMake / Ninja cmake 4.4.4 + ninja 1.13.2(pip 装进 .venv)系统 cmake 3.22 太老,fork 要求 ≥3.24 Python 3.11.6(venv) serve 层需要 numpy/jinja2/psutil 等
2. 安装(只讲 fork 本体)
下面的步骤完全不依赖任何外部守护/门卫/代理,就是"把 fork 编出来、跑起来"。
参考目录:/data/llm/strata-rdna3(源码 + build + .venv),引擎产物build/strata。2.1 前置条件
sudo apt install -y build-essential python3-venv   # 缺 ensurepip 时 venv 建不起来
ls /opt/rocm/bin/hipcc /opt/rocm/llvm/bin/clang++  # 系统 ROCm 已就位
模型侧需要准备好(fork 不负责下载):
- GGUF 第 1 个 shard(
--native与--ple-gguf都指它) - native pack(
tools/iq_pack.py --gguf <shard1> --out <pack>生成,含tokenizer/) - MTP draft 目录(示例
/data/llm/mtp/rt) - expert profile(
data/expert-profile.bin,与 slot 数匹配) - 可选:视觉侧车
strata-vision+ mmproj(fork 源码里不编这个 exe,见 §3.5)
2.2 取源码(必须用 PR #1,不能用分支头)
git clone https://github.com/nicejunjie/Strata-rdna3 /data/llm/strata-rdna3
cd /data/llm/strata-rdna3
git fetch origin refs/pull/1/head:pr1-avx2safe
git checkout pr1-avx2safe          # = ivanjiang5628:fix/avx2-safe-isa-probe, head 309f0c8f
为什么必须这条 PR:fork 的 IQ3_S/IQ3_XXS 量化核按
-mavx512f/-bw/-vl/-dq/-vnni/-vbmi编译,
并把 IQ 查找表放在命名空间作用域初始化。在 AVX2-only 的 CPU 上,这个静态初始化会执行 AVX-512 指令
→ 进程启动即 SIGILL。PR #1 把表初始化改成函数内 thread-safe static,并在 GCC 下让这些初始化/探针
以"关闭 AVX-512"的方式编译;运行期仍然按cpu_avx512_ok()派发到对应核,AVX2 主机走 AVX2 回退。
实测启动日志会明确写:strata generate: this CPU has no AVX-512: the expert kernels run on AVX-2 (multi-token for the i-quant gate/up rows)2.3 Python 环境(cmake / ninja / serve 依赖)
cd /data/llm/strata-rdna3
python3 -m venv .venv
.venv/bin/pip install -U pip
.venv/bin/pip install -r requirements.txt     # 含 cmake 4.4.3、ninja、numpy、jinja2、psutil…
.venv/bin/cmake --version                     # 需要 ≥ 3.24
2.4 rocWMMA(fork pin 的 headers)
curl -sL -o third_party/rocwmma.zip \
  https://github.com/ROCm/rocWMMA/archive/1ab208f49945c38626b79e3f0c284d65ac44a781.zip
unzip -q third_party/rocwmma.zip -d third_party/_unpack
mv third_party/_unpack/rocWMMA-1ab208f4* third_party/rocwmma
ls third_party/rocwmma/library/include/rocwmma/rocwmma.hpp
不要图省事用
/opt/rocm/include(那是 ROCm 10.1 自带的版本,与 fork pin 的不同源)。2.5 配置与编译
R=/opt/rocm
export HIP_PLATFORM=amd ROCM_PATH=$R HIP_PATH=$R
.venv/bin/cmake -S . -B build -G Ninja \
  -DCMAKE_BUILD_TYPE=Release \
  -DSTRATA_ENABLE_HIP=ON \
  -DSTRATA_PREFILL_MMQ=ON \
  -DSTRATA_MMQ_KQUANTS=ON \
  -DCMAKE_HIP_ARCHITECTURES=gfx1100 \
  -DCMAKE_HIP_COMPILER=$R/llvm/bin/clang++ \
  -DCMAKE_HIP_COMPILER_ROCM_ROOT=$R \
  "-DCMAKE_HIP_FLAGS=--rocm-path=$R --rocm-device-lib-path=$R/lib/llvm/amdgcn/bitcode" \
  -DSTRATA_ROCWMMA_INCLUDE_DIR=$PWD/third_party/rocwmma/library/include \
  -DSTRATA_BUILD_TESTS=OFF
.venv/bin/cmake --build build -j8
./build/strata --version        # -> strata 0.1.43
选项 作用 STRATA_ENABLE_HIP=ON编 gfx1100(wave32)HIP 后端 STRATA_PREFILL_MMQ=ON打开 GGML MMQ 的 prefill 路径(fork 的 prefill 提速主要来自这一族核) STRATA_MMQ_KQUANTS=ON编 Q4_K/Q5_K/Q5_1/Q6_K 的 MMQ 核;IQ3/IQ4 不受影响,但保持与预设一致 STRATA_ROCWMMA_INCLUDE_DIR打开来自 xyzzing/Strata 的 WMMA QSA 选择路径( STRATA_SELECT_WMMA用它)CMAKE_HIP_ARCHITECTURES=gfx1100只出本机目标,省编译时间 STRATA_BUILD_TESTS=OFF不编测试套件(省一半时间) 实测代价:configure 约 99 s(会下载 pin 的 llama.cpp),
-j8编译 313 个目标约 4 分钟,目录合计 1.5 GB。2.6 运行
fork 的 API 层是自带的
serve/server.py(0.1.43),需要一个 JSON 配置:{ "exe": "/data/llm/strata-rdna3/build/strata", "args": [ "--pack", "/data/llm/packs/swift-iq3_s_abliterated", "--native", "/data/llm/models/…abliterated-IQ3_S-00001-of-00002.gguf", "--ple-gguf", "/data/llm/models/…abliterated-IQ3_S-00001-of-00002.gguf", "--expert-profile", "/data/llm/strata/data/expert-profile.bin", "--expert-cache", "auto", "--prefill", "auto", "--spec", "4", "--spec-min-p", "0.5", "--mtp", "/data/llm/mtp/rt", "--max-context", "262144", "--mtp-window", "4096", "--kv", "int8", "--vram-reserve-mib", "768", "--ple-io", "direct", "--stats", "--ple-row-cache", "1048576", "--kv-resident", "32768", "--pcie-frac", "0", "--pool-workers", "6", "--mtp-q4", "all", "--vision", "--conversation-cache-mib", "2048", "--conversation-cache-slots", "2", "--conversation-cache-min-tokens", "2000", "--conversation-cache-min-free-mib", "2048" ], "cwd": "/data/llm/strata", "tokenizer": "/data/llm/packs/swift-iq3_s_abliterated/tokenizer", "model_name": "swift-1.5-iq3_s", "log": "/data/llm/strata/strata-swift-iq3_s_abliterated.log", "lib_dirs": ["/opt/rocm/lib"], "port": 8080, "backend": "hip", "host": "0.0.0.0", "api_key": "<把 key 写这里,或用 STRATA_API_KEY>", "allowed_hosts": ["llm.shaneshou.eu.org"], "vision": { "exe": "/data/llm/strata/engine/strata-vision", "mmproj": "/data/llm/models/mmproj-Swift-Qwen3.8-Flash-Next-BF16.gguf", "model": "/data/llm/models/…abliterated-IQ3_S-00001-of-00002.gguf", "gpu": false, "max_tokens": 300, "threads": 6 }, "env": { /* 见 §3.1 的 42 个开关 */ } }启动:
cd /data/llm/strata
LD_LIBRARY_PATH=/opt/rocm/lib HSA_OVERRIDE_GFX_VERSION=11.0.0 \
  /data/llm/strata-rdna3/.venv/bin/python \
  /data/llm/strata-rdna3/serve/server.py --engine strata --config <config.json> --port 8080
启动耗时:页面缓存热时约 45–50 秒;完全冷读那 46.84 GiB 专家 arena 时多约 25 秒
(日志loaded 46.84 GiB at 1.9 GiB/s)。常驻内存约 55 GB,显存 25.7/24→ 接近占满(见 §5)。2.7 自检
curl -s http://127.0.0.1:8080/health
# {"status":"ok","max_context":262144,"model":"swift-1.5-iq3_s","images":true,"api_key":true,"loaded":true,…}

curl -s http://127.0.0.1:8080/metrics -H "Authorization: Bearer <key>" | python3 -m json.tool | head -40
# engine.version / pool_workers / expert_slots / kv_resident / conversation_cache_mib 都应等于配置值
启动块里要能看到这几行(说明预设真的生效了):
this CPU has no AVX-512: the expert kernels run on AVX-2 …
loaded 46.84 GiB at 1.9x GiB/s
6 expert-pool workers + the host thread
expert cache 9286 slots, 17.6 GiB of VRAM
strata serve: prompt chunk auto: 32768 tokens, a 192-slot ring
prefill gemm: hipBLASLt tuning enabled (43 rows, gfx1100, version 100401)
strata: STRATA_HIP_WMMA: the prompt attention on matrix cores on (gfx1100)
3. 调优与参数
3.1 开关总表(fork 单卡预设,42 个环境变量)
GPU_MAX_HW_QUEUES=6                                 # ROCr 硬件队列
STRATA_HIP_WMMA=1 STRATA_SELECT_WMMA=1               # prompt attention + QSA 选择走 WMMA 矩阵核
STRATA_HC_UPMIX=1 STRATA_HEAD_MIX_MULTI=1            # hyper-connection / head mix 融合
STRATA_GR_RDNA=1 STRATA_GR_RDNA_Q8=1 STRATA_GR_RDNA_A8=1
STRATA_GR_FUSED=1 STRATA_GR_INJ_UP=1                 # RDNA hyper-connection int8/int8-act + fused down/up
STRATA_GDN_CHUNKED=1 STRATA_GDN_HEAD=1 STRATA_GDN_CONVL2=1
STRATA_GDN_NOY=1 STRATA_GDN_PP=1 STRATA_GDN_CHUNK_GDV=0   # chunked GDN 递推跑 FP16 矩阵核
STRATA_PF_FUSED=1 STRATA_PF_GEMM=1 STRATA_PF_F16=2
STRATA_PF_HCDOWN=1 STRATA_PF_PAD=1 STRATA_PF_GROUP_RES=1   # prompt 路径的融合/分块
STRATA_PREFILL_AUTO_MAX=32768 STRATA_PREFILL_RING=192
STRATA_PREFILL_CPU_SHARE=auto STRATA_PREFILL_CPU_SHARE_MAX=6144
STRATA_PREFILL_MMQ_TILE_ROWS=32                      # prompt 分块与 CPU/GPU 分工
# 另配命令行:--ple-io direct --ple-row-cache 1048576  # PLE 直读 + 行缓存
STRATA_QFUSE=1 STRATA_PA_FAST=1 STRATA_PA_KLDS=1 STRATA_KV_HOST_DMA=1
STRATA_COMBINE_CPU=1 STRATA_WAIT_FUSE=1 STRATA_ROUTE_PUBLISH=1 STRATA_VERIFY_QDEDUP=1
STRATA_RDNA_MMVQ_WAVE=3 STRATA_RDNA_Q6K=1 STRATA_STAGER_RING=64
STRATA_PEER_TRANSPORT=host STRATA_SH_STREAM=0
STRATA_HIPBLASLT_TUNING=<repo>/tools/hip/gfx1100-hipblaslt-100401.txt
分组理解(按 fork README 的分类):
- WMMA 组:
STRATA_HIP_WMMA/STRATA_SELECT_WMMA—— prompt 注意力与 QSA 选择走矩阵核,是 prefill 提升的主力。 - GDN 组:
STRATA_GDN_*—— 把串行的门控递推改成分块矩阵乘。 - GR/fuse 组:
STRATA_GR_*/STRATA_WAIT_FUSE/STRATA_ROUTE_PUBLISH/STRATA_COMBINE_CPU—— decode 侧的融合与同步削减。 - PF 组:
STRATA_PF_*+PREFILL_RING+CPU_SHARE*—— prompt 的分块、CPU 参与度和流水线环深度。
这套值是 fork 作者在 Ryzen 9 3900X + 125 GiB 上量出来的,本机几乎照抄即可,只有
--pool-workers必须改。3.2 关键调优:
--pool-workers必须按物理核算帖子用
--pool-workers 12(他那台 3900X 是 12 物理核,1:1)。本机只有 6 物理核,照抄后引擎日志是:12 pool workers on logical processors 1,2,3,4,5, the host thread on 0 ← 12 个 worker 挤在 5 个逻辑核上后果是 decode 掉 25%(TG 70.2 → 95–101),而 prefill 几乎不受影响(长批次吞吐型)。实测(同机同日、每改一次重启):
--pool-workersprefill@32K decode@32K 12(照抄帖子) 3,466 tok/s 70.2 tok/s 6(本机取值) 3,474 tok/s 95.2 tok/s 5 — 102.7 tok/s(短 prompt 口径,与 6 在误差内) 规则:pool workers ≈ 物理核数(SMT 不翻倍),host 线程另算。
3.3 tuning 表必须和 hipBLASLt 配对
引擎按 (架构, hipBLASLt 版本) 双条件校验表,不匹配就直接丢弃、退回普通 hipBLAS(prefill 会掉一大截)。
本机 hipBLASLt 1.4.x →gfx1100-hipblaslt-**100401**.txt。fork 六套自带 config 里写的是100200
(配它 pin 的 TheRock ROCm 7.10 轮子),抄到本机会失效。启动日志确认方式:prefill gemm: hipBLASLt tuning enabled (43 rows, gfx1100, version 100401)3.4 显存 / 内存预算(本机实测)
项 值 说明 专家 arena(host RAM) 46.84 GiB 默认全部常驻 pinned RAM 进程 RSS 约 55 GB 62 GB 机器上只剩 5–7 GB 给别的东西 显存 25.7 / 25.75 GiB --kv-resident 32768+--ple-row-cache 1048576之后只剩 ~350–600 MiB启动后的空闲显存 346–606 MiB 低于 --vram-reserve-mib时引擎会按请求打警告(可接受)会话停放缓存 2048 MiB / 2 槽(预设原值 6144/3) 本机 RAM 不够;超长会话不再 park,只影响切回旧会话的速度 相关参数:
--kv-resident 32768:把 262144 个 KV cell 中的 32768 常驻显存,其余留在 pinned RAM(3.09 GiB)。这是 decode 的关键项。--vram-reserve-mib:本机取 768(预设 512)。给视觉侧车和驱动留余量;代价是少约 130 个专家槽(1.4%)。--conversation-cache-*:host RAM 的会话停放,按 §3.4 的值给,别照抄 6144/3,否则会和 55 GB 常驻一起把内存吃穿。
3.5 视觉(vision)怎么做
fork 0.1.43 的 CMake 没有
strata-vision目标,但它的serve/server.py完整支持视觉侧车协议
(stdin 的ENC <image> <out>、stdout 的READY)。因此可以复用另一份安装编出的strata-vision:"args": [ …, "--vision" ], "vision": { "exe": "/path/to/strata-vision", "mmproj": "…mmproj…gguf", "model": "…shard1…gguf", "gpu": false, "max_tokens": 300, "threads": 6 }本机实测(用 0.2.7 编的
strata-vision配 fork 引擎)可以正常识图:发一张红方块+蓝圆形的 PNG,
返回「一个红色正方形和一个蓝色圆形」。注意--vision必须显式写进args,否则 serve 里有兜底逻辑会补,
但配置里若只有vision段而无--vision,旧版本会报 "started without the vision encoder"。3.6 实测过、确认无效或不要做的
--resident-experts:默认模式本来就把全部专家常驻 RAM,加了是退化(历史实测 1,093 vs 1,504 tok/s)。STRATA_SCORES_THREAD:0.1.44+ 才有的开关,fork(0.1.43)源码 0 命中,设了静默无效。- 调 GPU 频率/功耗上限:decode 期间
pp_dpm_sclk始终在最高档(2482–2549 MHz)、温度 56–57 °C、gpu_busy=100%,
不是瓶颈;gpu-power-limit.service把上限压到 294 W(默认 327 W)也未影响结果。 - CPU boost:本机
/sys/devices/system/cpu/cpufreq/boost = 0,CPU 卡在 ~3.95 GHz。这是尚未利用的余量,
可在测完后另行评估(改它属于系统级调优,不在本文范围)。
4. 性能测试
4.1 方法
- 协议来自 fork 的 PR 基准与官方
bench_prefill.py:256 token 输出、temperature=0、top_k=1、top_p=1、
min_p=0、seed=42、关闭思考(reasoning_effort=none)、串行单请求。 - 每一档:1 发同尺寸暖机 + 1 发测量(用户要求每档只测一次;暖机是为了避免"最先测的那档吃到最冷的
expert cache",导致看起来长 prompt 更快)。 - 数字全部取引擎自己返回的
timings.prompt_per_second(PP)与timings.predicted_per_second(TG),
不依赖客户端计时。 - 每发用不同随机盐生成全新文本,校验
cache_n == 0(无前缀复用)。 - 256K 档受
max-context 262144限制,实测 prompt 260,002 token(还要留 256 个输出位)。 - 脚本:
/data/llm/strata-rdna3/sweep.py,原始结果/data/llm/strata-rdna3/sweep-20261029.json。
4.2 结果(fork,本次实测)
档位 prompt tokens prefill (PP) decode (TG) 草稿命中 墙钟 32K 32,045 3,511.0 tok/s 100.6 tok/s 166/212 11.7 s 64K 64,038 3,570.5 tok/s 106.6 tok/s 168/205 20.4 s 128K 131,056 3,601.0 tok/s 101.2 tok/s 161/221 39.0 s 256K 260,002 3,336.2 tok/s 95.5 tok/s 168/204 80.8 s 引擎原始日志(可直接核对):
prompt  32045 tokens = 0 reused + 32045 read in  … ms (3511.0 tok/s), 256 generated (100.6 tok/s)
prompt  64038 tokens = 0 reused + 64038 read in  … ms (3570.5 tok/s), 256 generated (106.6 tok/s)
prompt 131056 tokens = 0 reused + 131056 read in 36395 ms (3600.9 tok/s), 256 generated in 2529 ms (101.2 tok/s)
prompt 260002 tokens = 0 reused + 260002 read in 77933 ms (3336.2 tok/s), 256 generated in 2679 ms ( 95.5 tok/s)
4.3 与原版(baseline)对比
baseline 只有 32K 档(原版 engine 0.1.52、同一台机器、同一模型、2026-10-09 实测):
32K 档 prefill decode 数据来源 原版 0.1.52,裸基线 1,502 tok/s ~67 tok/s 2026-10-09 实测 原版 0.1.52 + 当日优化包 1,696 tok/s ~70 tok/s 同上( auto:32768+PF_FUSED/GEMM/SWITCH_MIN_T+spec-min-p 0.7)fork 0.1.43 + 本文预设 3,511 tok/s 100.6 tok/s 2026-10-29 本次 - prefill:2.07×(对裸基线 2.34×)
- decode:1.44×
作为横向参考,PR 作者在自己那台(Ryzen 9 3900X / 125 GiB / 同样单卡 7900 XTX)上测得
32K 3,529 tok/s / 88.1 tok/s;本机 prefill 达到其 99.5%,decode 更优(100.6 vs 88.1)。4.4 数据怎么读
- prefill 随长度先升后降:32K→128K 从 3,511 涨到 3,601(请求固定开销被摊薄、分块更满),
到 256K 回落到 3,336(KV 只有 32768 个 cell 常驻显存,更长的上下文要流式搬 KV)。 - decode 随长度缓降:32K/64K 在 100–107 之间,128K 101,256K 95.5 —— 上下文越长,每 token 要读的 KV 越多。
- 草稿命中率稳定在 75–82%(166/212 … 168/204),说明 MTP 抽头在长上下文下没有退化。
- 这些是吞吐数字,不是质量结论:WMMA/GDN/GR 路径用 FP16 操作数、改了舍入,fork 自己也声明
"Do not infer model quality from kernel parity or throughput measurements"。真实任务质量需另行验证。
5. 已知限制与注意事项
- 非 bitwise 等价:融合核改变舍入,速度可信、质量要另测。
- 显存几乎占满:25.7/25.75 GiB,空闲 350–600 MiB,低于配置的 512/768 MiB 保留,引擎会按请求打警告。
想跑更长会话要下调--kv-resident或抬--vram-reserve-mib(两者互相挤)。 - 内存紧张:常驻 55 GB / 62 GB。同一台机器不能再跑第二个实例;会话停放缓存只能给 2048 MiB。
- fork 0.1.43 的 API 层比 0.2.x 少两个端点:
/v1/images/generations、/v1/telemetry;
聊天/补全/Anthropic messages/responses/models/status/health/metrics/mcp/props/slots 都有。
不能用 0.2.x 的serve/server.py去驱动 0.1.43 引擎(实测启动死锁:引擎在pipe_read等命令,
新版 serve 在等旧引擎不会打印的就绪标记)。 - 别用 SIGKILL 杀引擎:实测会在 amdgpu 里留下孤儿内存(曾出现 23.9 GB 匿名页 + 5.94 GiB 显存无法回收,
只能重启;amdgpu_gpu_recover写入会报 I/O error)。用 SIGTERM/正常 stop。 - AVX2-only 必须走 PR #1:用分支头会在启动时 SIGILL。
- PCIe 只跑在 3.0 x16(主板限制)——本机 prefill 仍达到参考机器的 99.5%,说明该链路不是当前瓶颈。
6. 复现命令清单
# 1) 源码(PR #1) git clone https://github.com/nicejunjie/Strata-rdna3 /data/llm/strata-rdna3 cd /data/llm/strata-rdna3 && git fetch origin refs/pull/1/head:pr1-avx2safe && git checkout pr1-avx2safe # 2) 工具链 python3 -m venv .venv && .venv/bin/pip install -U pip && .venv/bin/pip install -r requirements.txt # 3) rocWMMA(pin) curl -sL -o third_party/rocwmma.zip https://github.com/ROCm/rocWMMA/archive/1ab208f49945c38626b79e3f0c284d65ac44a781.zip unzip -q third_party/rocwmma.zip -d third_party/_unpack && mv third_party/_unpack/rocWMMA-1ab208f4* third_party/rocwmma # 4) 编译(见 §2.5 的完整 cmake 命令),产物 ./build/strata # 5) 起服务(见 §2.6:config.json + serve/server.py) # 6) 测速(本次 32/64/128/256K 用的脚本) python3 /data/llm/strata-rdna3/sweep.py # 结果写 sweep-20261029.json BENCH_BASE=http://127.0.0.1:8080 BENCH_MODEL=swift-1.5-iq3_s \ python3 /data/llm/strata-rdna3/bench.py # 32K、warmup+3 发的中位协议 - GGUF 第 1 个 shard(
-
-
-
-
-
-
-
好勁呀 ! 等我都抄一抄先, 以下係雙7900 xtx嘅測試:
硬件
項目 配置 主機板 華南金牌 HUANANZHI X99-F8D PLUS,V1.33 作業系統 Ubuntu 26.04.1 LTS,64 位元 CPU 2 × Intel Xeon E5-2673 v4,標稱基礎時脈 2.30 GHz 系統記憶體 已安裝 224 GiB:7 × 32 GiB Samsung DDR4 ECC( 本來買咗八條但係有兩條壞嘅,換貨後仍然係有一條係壞嘅 ) ) CPU0 記憶體 已安裝 96 GiB,三個記憶體通道有插 DIMM;Linux 可見約 94.0 GiB CPU1 記憶體 已安裝 128 GiB,四個記憶體通道均有插 DIMM;Linux 可見約 122.0 GiB GPU0,連接 CPU0 Sapphire Nitro+ RX 7900 XTX,24 GB 顯存;PCI 0000:07:00.0 GPU1,連接 CPU1 XFX MERC 310 RX 7900 XTX,24 GB 顯存;PCI 0000:86:00.0 電源供應器 Great Wall 2000 W,型號由使用者提供 Fork 設定
項目 設定 引擎 實際使用 RDNA3 Fork,原生引擎版本 0.1.43 原始碼 nicejunjie/Strata-rdna3 PR #1,commit: 309f0c8f8cef010f62746f80caf677c68e7141f9GPU 運作模式 單一請求使用兩張卡;24/24 分層,Nitro+ 處理第 0–23 層,MERC 處理第 24–47 層 專家資料的記憶體配置 各 GPU 階段使用其所連接 CPU 的本地記憶體 Expert workers 合共 8 個,每顆 CPU 分配 4 個;綁定邏輯 CPU 1、2、3、4、20、21、22、23 上下文上限 262,144 tokens Prefill 自動選擇,每個區塊上限 32,768 tokens;啟用雙 GPU DP prefill Prefill ring/CPU 分工 384 個槽位;CPU-share 為 auto,上限 1,024 KV cache INT8;32,768 個常駐 KV cells 推測解碼 Spec 3,最低機率 0.5;MTP Q4 all;MTP window 4,096 Pipeline windows 2 預留顯存 每張卡 2,048 MiB 對話快取 16,384 MiB,8 個槽位 HIP 硬件佇列 GPU_MAX_HW_QUEUES=8視覺功能 透過現有 CPU 視覺編碼器啟用;本次效能測試只輸入文字 單位:tokens/秒。
雙 GPU 測試結果
輸入長度 Prefill Decode 1K 607.9 115.5 8K 2353.2 115.8 10K 1450.9 113.1 15K 2119.8 104.3 32K 3609.1 121.8 64K 4339.0 123.3 128K 4645.6 107.5 250K 5457.0 104.4 -
好勁呀 ! 等我都抄一抄先, 以下係雙7900 xtx嘅測試:
硬件
項目 配置 主機板 華南金牌 HUANANZHI X99-F8D PLUS,V1.33 作業系統 Ubuntu 26.04.1 LTS,64 位元 CPU 2 × Intel Xeon E5-2673 v4,標稱基礎時脈 2.30 GHz 系統記憶體 已安裝 224 GiB:7 × 32 GiB Samsung DDR4 ECC( 本來買咗八條但係有兩條壞嘅,換貨後仍然係有一條係壞嘅 ) ) CPU0 記憶體 已安裝 96 GiB,三個記憶體通道有插 DIMM;Linux 可見約 94.0 GiB CPU1 記憶體 已安裝 128 GiB,四個記憶體通道均有插 DIMM;Linux 可見約 122.0 GiB GPU0,連接 CPU0 Sapphire Nitro+ RX 7900 XTX,24 GB 顯存;PCI 0000:07:00.0 GPU1,連接 CPU1 XFX MERC 310 RX 7900 XTX,24 GB 顯存;PCI 0000:86:00.0 電源供應器 Great Wall 2000 W,型號由使用者提供 Fork 設定
項目 設定 引擎 實際使用 RDNA3 Fork,原生引擎版本 0.1.43 原始碼 nicejunjie/Strata-rdna3 PR #1,commit: 309f0c8f8cef010f62746f80caf677c68e7141f9GPU 運作模式 單一請求使用兩張卡;24/24 分層,Nitro+ 處理第 0–23 層,MERC 處理第 24–47 層 專家資料的記憶體配置 各 GPU 階段使用其所連接 CPU 的本地記憶體 Expert workers 合共 8 個,每顆 CPU 分配 4 個;綁定邏輯 CPU 1、2、3、4、20、21、22、23 上下文上限 262,144 tokens Prefill 自動選擇,每個區塊上限 32,768 tokens;啟用雙 GPU DP prefill Prefill ring/CPU 分工 384 個槽位;CPU-share 為 auto,上限 1,024 KV cache INT8;32,768 個常駐 KV cells 推測解碼 Spec 3,最低機率 0.5;MTP Q4 all;MTP window 4,096 Pipeline windows 2 預留顯存 每張卡 2,048 MiB 對話快取 16,384 MiB,8 個槽位 HIP 硬件佇列 GPU_MAX_HW_QUEUES=8視覺功能 透過現有 CPU 視覺編碼器啟用;本次效能測試只輸入文字 單位:tokens/秒。
雙 GPU 測試結果
輸入長度 Prefill Decode 1K 607.9 115.5 8K 2353.2 115.8 10K 1450.9 113.1 15K 2119.8 104.3 32K 3609.1 121.8 64K 4339.0 123.3 128K 4645.6 107.5 250K 5457.0 104.4 -
-
-
-
@Eric-Seto 可以在优化一下,双7900XTX的262K上prefill上6000是没有问题的
-
@mudfox 怎么r9700 卖掉? 现在应该最强amd 消费级卡
@applejuice 哈哈, 卖掉 9700 买 7900 搞不懂, 这不是负优化么?
-
@懒人烘培
哥,能给兄弟们单出一篇帖子吗?我让deepseek抄作业,一直抄不明白,就卡在5000死活上不去了 -
-
-
提升非常大,用了1个小时AI去配置。
抄作业结果fork 明显更快(prefill 2 倍、agent 循环 1.76 倍)
实测已经全部完成,数据写进运维手册第 9 节了。下面是优化前 vs 优化后的完整对比。
-
prefill:处理长提示词(tok/s,越高越好)
提示词长度 优化前 0.1.45 原配置 0.1.45 只把块调到 32K fork RDNA3
1 万 token 1,019 1,263(+24%) 2,090(+105%)
8 万 token 1,281 1,429(+12%) 3,129(+144%)
三次重复测量误差仅 ±0.3%(1,018.7 / 1,019.4 / 1,021.5),这组数字很硬。 关键结论:光把 prefill 块从 8192 调到 32768 只拿到 +24%/+12%,剩下的大头是 fork 的 RDNA3 内核真本事——我专门做了这个隔离实验,否则会把功劳记错。 -
decode:生成速度(tok/s,固定 seed、6 次中位数)
优化前 优化后 提升
短提示 66.5 74.1 +11.4%
3.2 万 token 提示 64.1 77.4 +20.7% -
真实 agent 循环(12 轮,每轮追加约 830 token,上下文涨到 2.68 万)
优化前 优化后 倍数
首轮冷 prefill 15.12 s 8.01 s 1.89×
稳态每轮 2.70 s 1.59 s 1.70×
12 轮总计 46.37 s 26.32 s 1.76×
这个才是你日常体感对应的场景(大部分请求是"恢复检查点 + 追加一小段")。 -
一个重要的反向验证
我担心 fork 缺 --prompt-cache-spread(0.1.45 有,是我上次修长任务缓存抖动的开关),专门测了缓存命中:两边逐条完全相同(cached token 数 8396 / 28551 / 75576 一模一样)。所以这个差异在本机测不出影响,不是迁移障碍。 -
折算到你那个 140 步长任务
按之前统计的成本结构(prompt 读 5.12 h + decode 15.32 h = 20.4 h):
prompt 部分:5.12 h → 约 2.3 h
decode 部分:15.32 h → 约 13.4 h(decode 只快 12-16%,且它占 75%)
合计约 20.4 h → 15.7 h,省 23%
也就是说:prefill 快 2 倍多非常可观,但你的长任务瓶颈其实在生成 token 数,换引擎能省四分之一,真正的大头还是要靠少生成。- 现在的状态
fork 正在跑(strata-fork.service),strata.service 已停止但仍是开机默认
所以现在重启会回到 0.1.45,不会留下半吊子状态
回滚一条命令:systemctl stop strata-fork && systemctl start strata
0.1.45 的配置我也加了 --prefill auto:32768(白捡 +24%/+12%,无代价),备份在 strata-iq3_s.json.before-prefill32k
代价:fork 是 0.1.43(比 0.1.45 旧)、没编译 vision(源码在 tools/vision/strata_vision.cpp,需要时能补编)、多占 16 GB 源码。
-
-
,
 Y yi song 引用了 此主题
-
,A applejuice 引用了 此主题
-
-
@mudfox 怎么r9700 卖掉? 现在应该最强amd 消费级卡
@applejuice 7900XTX 带宽高



 版主审定:本帖设为精华,作者 +6 积分奖励,希望再接再厉!


 本帖参与讨论人数已达 10+,入选热议,作者 +3 积分奖励!