跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. LLM讨论区
  4. 让本地27B(或任意)模型数学从只有92.7% 准确到工程可靠!可用!

让本地27B(或任意)模型数学从只有92.7% 准确到工程可靠!可用!

已定时 已固定 已锁定 已移动 优秀 LLM讨论区
本地模型qwen-27b编程
36 帖子 8 发布者 840 浏览
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • David ChenD
    David ChenD
    David Chen
    贵族大夫 硕果累累
    编写于 最后由 David Chen 编辑
    #7

    請問妳在驗證時模型 temperature top_k top_p 是設多少? 謝謝

    fcmeF 1 条回复 最后回复
    0
    • BunseiB
      BunseiB
      Bunsei
      王侯将相
      编写于 最后由 编辑
      #8
      此主題已被删除!
      1 条回复 最后回复
      0
      • David ChenD David Chen

        請問妳在驗證時模型 temperature top_k top_p 是設多少? 謝謝

        fcmeF
        fcmeF
        fcme
        王侯将相
        编写于 最后由 fcme 编辑
        #9

        @David-Chen

        查了脚本、服务端参数和模型自带配置这三处:

        实际使用的参数

        位置 temperature top_p top_k
        测试脚本(27 题 / 110 题 / 70 题) 0 未传 未传
        服务端启动参数 0.7 0.95 20
        模型自带 generation_config.json 1.0 0.95 20

        客户端显式传入 temperature: 0,这个值会覆盖服务端的 0.7;top_p 和 top_k 没有传,因此沿用服务端 override 的 0.95 / 20;--seed 42 一直固定使用。

        但实际效果上,只有 temperature=0 在起作用

        在 vLLM 中,当 temperature=0 时走的是 argmax(贪心)路径,top_k 和 top_p 虽然设置过,但不参与采样——所以那 27 道题是确定性解码,不是“用固定随机种子跑出来的采样”。

        这样设置的理由是:要测的是模型“会不会算”,而不是“是否抽到正确的 token”。如果使用 0.7 采样,同一道题跑两次可能会得到不同答案,那么测出来的数就不是模型能力,而只是运气。

        温度是零,所以这已经是能做的最确定的测试了。总归就是大模型乱说这个事情和它的根本原理有关,而不是它的性能。越好的模型只是胡说的概率会小,但是并不会消失,定性的来说是这样。

        个人的repo,欢迎指教
        https://github.com/halonc/R9700-Strata-Qwen3.8-Flash-Next-Tuning
        https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

        1 条回复 最后回复
        1
        • 范志刚范
          范志刚范
          范志刚
          硕果累累 贵族大夫
          编写于 最后由 编辑
          #10

          学到,谢谢大佬分享关于strata真知灼见@fcme

          fcmeF 1 条回复 最后回复
          0
          • 范志刚范 范志刚

            学到,谢谢大佬分享关于strata真知灼见@fcme

            fcmeF
            fcmeF
            fcme
            王侯将相
            编写于 最后由 编辑
            #11

            @范志刚
            没有没有,在新时代大家都是小学生。交流促进,共同进步。
            Strata这个东西只单流跑的话是很好的,一到真实工作场景就是说不上来的无力感,虽然我应该把我的那个已经优化到接近基本极限了吧。

            个人的repo,欢迎指教
            https://github.com/halonc/R9700-Strata-Qwen3.8-Flash-Next-Tuning
            https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

            1 条回复 最后回复
            0
            • 范志刚范
              范志刚范
              范志刚
              硕果累累 贵族大夫
              编写于 最后由 编辑
              #12

              @fcme 之前和ai分析,他认同在moe而且只在几家模型上有闲置资源占满的优势,我追问,那么是划分系统资源部分把cpu算力和其他资源的一部分用来优化推理算力需求吗,他的回答是,不是部分,是全部可用资源,也没有预留的工程安全冗余设置,而且不算是优化是劣化,因为其他资源作为算力占满不能作为工程环境依赖,在实际工程中会占满甚至发生硬件资源分配的拥堵。他的实际意义在于可以用更低的显存拉起更大的几款moe型模型,用来展示可以,看我能跑,看我多快,而对于稠密型模型几乎没什么提升价值还带来了参数适应调试成本。你的实战进一步印证了这些推理不是幻觉,我不测了,改个推理引擎也挺累的,谢谢

              fcmeF 1 条回复 最后回复
              0
              • 范志刚范 范志刚

                @fcme 之前和ai分析,他认同在moe而且只在几家模型上有闲置资源占满的优势,我追问,那么是划分系统资源部分把cpu算力和其他资源的一部分用来优化推理算力需求吗,他的回答是,不是部分,是全部可用资源,也没有预留的工程安全冗余设置,而且不算是优化是劣化,因为其他资源作为算力占满不能作为工程环境依赖,在实际工程中会占满甚至发生硬件资源分配的拥堵。他的实际意义在于可以用更低的显存拉起更大的几款moe型模型,用来展示可以,看我能跑,看我多快,而对于稠密型模型几乎没什么提升价值还带来了参数适应调试成本。你的实战进一步印证了这些推理不是幻觉,我不测了,改个推理引擎也挺累的,谢谢

                fcmeF
                fcmeF
                fcme
                王侯将相
                编写于 最后由 fcme 编辑
                #13

                @范志刚
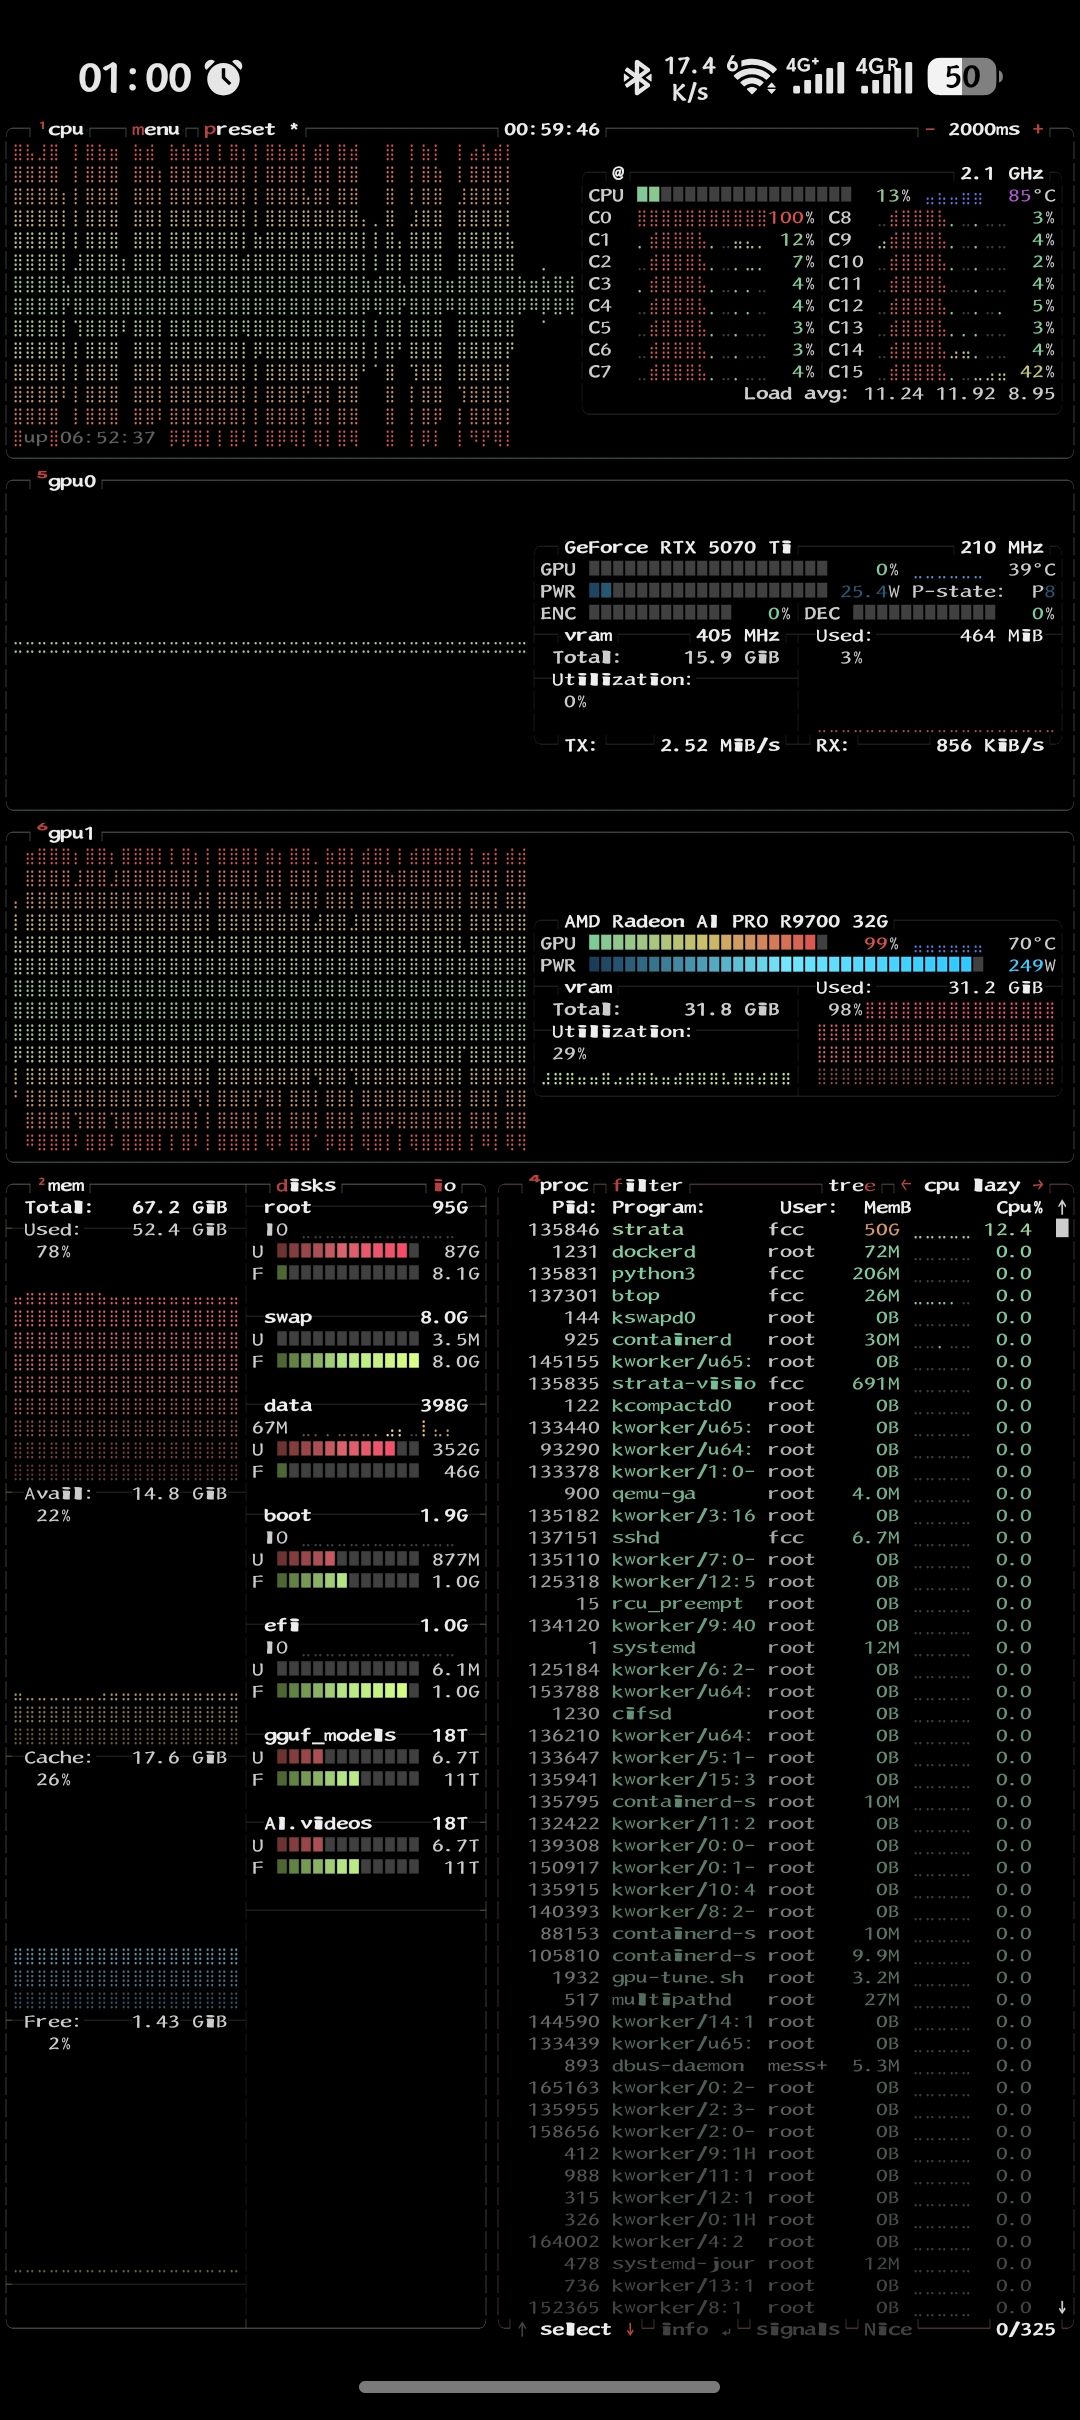
                对这个AI说的很到位,Strata本质上是llamacpp的魔改版本。所以最最最核心的缺点还是继承了llamacpp的,只是在资源调度方面做了大量的文章。分家分层加载的可以抽象为在显存里开了个小一点的稠密模型的同时还能借用一点点,开在显存里的储存更多不常用知识的调用频率(对应专家未命中率)很低的大型的稠密模型。
                所以我把我的Strata优化到冒烟以后发现GPU和CPU的占用都很高,如图:
                Screenshot_20261027_010014_com_termux_TermuxActivity.jpg

                所以从原理上他就不适合跑稠密模型,因为稠密模型无法切块,而MoE可以抽象成俩分块的稠密。

                个人的repo,欢迎指教
                https://github.com/halonc/R9700-Strata-Qwen3.8-Flash-Next-Tuning
                https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

                paul houP 1 条回复 最后回复
                0
                • fcmeF fcme

                  @范志刚
                  对这个AI说的很到位,Strata本质上是llamacpp的魔改版本。所以最最最核心的缺点还是继承了llamacpp的,只是在资源调度方面做了大量的文章。分家分层加载的可以抽象为在显存里开了个小一点的稠密模型的同时还能借用一点点,开在显存里的储存更多不常用知识的调用频率(对应专家未命中率)很低的大型的稠密模型。
                  所以我把我的Strata优化到冒烟以后发现GPU和CPU的占用都很高,如图:

                  Screenshot_20261027_010014_com_termux_TermuxActivity.jpg

                  所以从原理上他就不适合跑稠密模型,因为稠密模型无法切块,而MoE可以抽象成俩分块的稠密。

                  paul houP
                  paul houP
                  paul hou
                  硕果累累 贵族大夫
                  编写于 最后由 编辑
                  #14

                  @fcme
                  我的STRATA每次運算都會把實體核心跑滿。
                  我現在還是用QFN比較多,就是只能一個一個來,他又很愛開子代理,提示詞都還要加上叫他不要開,確實是很麻煩。

                  fcmeF 1 条回复 最后回复
                  0
                  • paul houP paul hou

                    @fcme
                    我的STRATA每次運算都會把實體核心跑滿。
                    我現在還是用QFN比較多,就是只能一個一個來,他又很愛開子代理,提示詞都還要加上叫他不要開,確實是很麻煩。

                    fcmeF
                    fcmeF
                    fcme
                    王侯将相
                    编写于 最后由 编辑
                    #15

                    @paul-hou
                    对,这个框架用多了,它的局限性就逐渐显现出来了,而且是无法克服的那种。
                    他爱开子代理,如果子代理给其他的大模型也还好,本地运行的话,基本上都只有一个模型在跑,所以就是很频繁的卡死。我之前针对strata的冒烟优化,就是着力挖掘了它的缓存方面的潜力,让单流处理的时候,时间尽量缩短来缓解这个问题,但是最后还是无解的。以后需要质量高一点的时候,直接调用云端API就好了,他和27比真的没有差那么多。至少是咱们运行的量化版本来说。

                    个人的repo,欢迎指教
                    https://github.com/halonc/R9700-Strata-Qwen3.8-Flash-Next-Tuning
                    https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

                    paul houP 1 条回复 最后回复
                    0
                    • fcmeF fcme

                      @paul-hou
                      对,这个框架用多了,它的局限性就逐渐显现出来了,而且是无法克服的那种。
                      他爱开子代理,如果子代理给其他的大模型也还好,本地运行的话,基本上都只有一个模型在跑,所以就是很频繁的卡死。我之前针对strata的冒烟优化,就是着力挖掘了它的缓存方面的潜力,让单流处理的时候,时间尽量缩短来缓解这个问题,但是最后还是无解的。以后需要质量高一点的时候,直接调用云端API就好了,他和27比真的没有差那么多。至少是咱们运行的量化版本来说。

                      paul houP
                      paul houP
                      paul hou
                      硕果累累 贵族大夫
                      编写于 最后由 编辑
                      #16

                      @fcme
                      RADIANCE單卡也能跑QFN,KV會是300K上下文左右,這個應該是可以小小的2併發。
                      我的DRAM還沒拿到,拿到了才要試。

                      fcmeF 1 条回复 最后回复
                      0
                      • suboyangS
                        suboyangS
                        suboyang
                        硕果累累 体面乡绅
                        编写于 最后由 编辑
                        #17

                        Strata 会不会是昙花一现的推理框架,我其实考虑过扩大内存去跑Strata,但是后来发现Strata其实是鸡肋。

                        fcmeF 1 条回复 最后回复
                        0
                        • paul houP paul hou

                          @fcme
                          RADIANCE單卡也能跑QFN,KV會是300K上下文左右,這個應該是可以小小的2併發。
                          我的DRAM還沒拿到,拿到了才要試。

                          fcmeF
                          fcmeF
                          fcme
                          王侯将相
                          编写于 最后由 fcme 编辑
                          #18

                          @paul-hou
                          我让27b翻了一下我的调试记录,关键点在于你pcie的速度,而且并发的时候总速度反而会掉,你可以做个参考,如下:

                          找到了。完整记录在会话 session-4ec38542(标题:R9700-Strata-调优全记录),2026-10-26 当天实测。以下是搬出来的原始数据:


                          Radiance Flash-Next 实测数据(2026-10-26,单卡 R9700,204800 窗口,4096 chunk,MTP=4,fp8 KV)

                          项 数值
                          prefill 8.9K / 33K / 134K 1,077 / 1,303 / 1,339 tok/s
                          TTFT 同上 8.3 / 25.9 / 100.6 s
                          decode(temp 0.7,400 tok) 55.9 / 63.0 tok/s
                          decode(贪心) 57.9 tok/s
                          decode(temp 0.7,多轮) 41.6 / 40.3 tok/s
                          decode @125K 上下文 34.9 tok/s
                          并发 2 / 4 聚合 31 / 50 tok/s
                          同对话追问(命中 12,288 tok 前缀) TTFT 1.53 s
                          冷启首轮 25 tok/s(必须预热)

                          启动日志关键量:专家 17.31 GiB 显存 + 43 GiB pinned 主机池;KV 4.86 GiB;PLE(n-gram) 表 47.68 GiB 在磁盘(内存装不下);模型总文件 113.6 GiB。


                          为什么放弃(三条硬理由)

                          1. 链路硬顶,prefill 被 PCIe 3.0 卡死

                          R9700 上游链路被降级到 Gen3 x16(宿主 LnkSta: 8GT/s (downgraded)),GPU 空载 2 GiB 大页拷贝实测 13.8 GB/s。Radiance 的架构是每步把 43 GiB 专家池从主机内存搬过 PCIe,算下来 PP ≈ 14 GB/s ÷ 11.3 MB/token ≈ 1,240 tok/s——与实测 1,300 完全吻合。官方 2,545 tok/s 是 Gen4/5 平台的成绩,你这台 Dell 7820(Xeon Gold 6252,PCIe 3.0)物理上到不了。

                          2. 内存模型撑不住并发和缓存

                          43 GiB pinned 池把内存吃死,只剩 6–9 GB 给对话缓存——8 条对话缓存根本开不了,SSD session 也不支持。而 Strata 只用 ~40 GiB 匿名内存 + 页缓存,剩 16 GB,才装得下 6 GiB / 8 槽的对话缓存 + SSD session。

                          3. 同卡对比 Strata 全面胜出

                          项 Radiance Strata(同卡同窗口)
                          prefill 1,300 2,250–2,336(1.8×)
                          decode 57–63 116–122(adapt-every 1)
                          8 槽对话缓存 ❌ ✅ 0.54 s 热态
                          SSD session ❌ ✅
                          可用内存 6–9 GB ~16 GB

                          附带现实约束:当时 /data 池只剩 36 GB,Radiance 的 113.6 GB 模型必须删掉才装得下 Strata 的 81 GB 权重——只能二选一,不是偏好。


                          一句话总结:Radiance 的架构(专家每步过 PCIe)在你这台 PCIe 3.0 宿主上被链路带宽锁死,prefill 天花板 ~1,300、decode ~60,而 Strata 把专家算在 CPU/常驻显存,同卡直接翻倍。模型已删,要复核需重新下载 113.6 GB。

                          个人的repo,欢迎指教
                          https://github.com/halonc/R9700-Strata-Qwen3.8-Flash-Next-Tuning
                          https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

                          1 条回复 最后回复
                          0
                          • suboyangS suboyang

                            Strata 会不会是昙花一现的推理框架,我其实考虑过扩大内存去跑Strata,但是后来发现Strata其实是鸡肋。

                            fcmeF
                            fcmeF
                            fcme
                            王侯将相
                            编写于 最后由 编辑
                            #19

                            @suboyang
                            底子不好,llamacpp本本来就是单流玩玩的东西,没有并发能力,导致浅浅测速感觉很哇塞!实际一用就卡死!

                            个人的repo,欢迎指教
                            https://github.com/halonc/R9700-Strata-Qwen3.8-Flash-Next-Tuning
                            https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

                            1 条回复 最后回复
                            0
                            • A
                              A
                              applejuice
                              王侯将相
                              编写于 最后由 编辑
                              #20

                              我用strata 用到很开心呢..
                              只是我有另一张卡跑子任务

                              fcmeF 1 条回复 最后回复
                              0
                              • A applejuice

                                我用strata 用到很开心呢..
                                只是我有另一张卡跑子任务

                                fcmeF
                                fcmeF
                                fcme
                                王侯将相
                                编写于 最后由 编辑
                                #21

                                @applejuice
                                不瞒你说,你说的这个想法我也试了。你另一张卡用的什么跑的什么模型?我是把另一张5070ti让他跑27b给qfn调用子代理的时候去用,结果翻车了。一来有那个派任务和验收的开销,二来5070Ti跑27b本来就不快,pp也就才1100左右,tg的话在三四十,算下来还不如用本体Strata跑呢,尴尬死了。

                                个人的repo,欢迎指教
                                https://github.com/halonc/R9700-Strata-Qwen3.8-Flash-Next-Tuning
                                https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

                                A 1 条回复 最后回复
                                0
                                • fcmeF fcme

                                  @applejuice
                                  不瞒你说,你说的这个想法我也试了。你另一张卡用的什么跑的什么模型?我是把另一张5070ti让他跑27b给qfn调用子代理的时候去用,结果翻车了。一来有那个派任务和验收的开销,二来5070Ti跑27b本来就不快,pp也就才1100左右,tg的话在三四十,算下来还不如用本体Strata跑呢,尴尬死了。

                                  A
                                  A
                                  applejuice
                                  王侯将相
                                  编写于 最后由 applejuice 编辑
                                  #22

                                  @fcme 我两张3090跑strata prefill 4.5k 以上
                                  r9700 跑27b 2.5k prefill
                                  现在主模型 等待时间比较长 利用率有点低

                                  fcmeF 1 条回复 最后回复
                                  0
                                  • A applejuice

                                    @fcme 我两张3090跑strata prefill 4.5k 以上
                                    r9700 跑27b 2.5k prefill
                                    现在主模型 等待时间比较长 利用率有点低

                                    fcmeF
                                    fcmeF
                                    fcme
                                    王侯将相
                                    编写于 最后由 编辑
                                    #23

                                    @applejuice
                                    你是多卡狂人,比不了比不了😂

                                    个人的repo,欢迎指教
                                    https://github.com/halonc/R9700-Strata-Qwen3.8-Flash-Next-Tuning
                                    https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

                                    A 1 条回复 最后回复
                                    0
                                    • fcmeF fcme

                                      @applejuice
                                      你是多卡狂人,比不了比不了😂

                                      A
                                      A
                                      applejuice
                                      王侯将相
                                      编写于 最后由 applejuice 编辑
                                      #24

                                      @fcme 别笑我了 论讨人手平均一张pro 6000

                                      一开始搞3090 幸好前一个月2 手买到几乎新的1万1 r9700

                                      你现在有几张卡?

                                      fcmeF 1 条回复 最后回复
                                      0
                                      • 范志刚范
                                        范志刚范
                                        范志刚
                                        硕果累累 贵族大夫
                                        编写于 最后由 编辑
                                        #25

                                        直给直要的工程需求往往不会用多卡做单任务来增加稳定性风险和维护成本@applejuice 需求不同吧,我俩追求的是简单直给的确定性结果,有点臭味相投哈哈

                                        A 1 条回复 最后回复
                                        0
                                        • 范志刚范 范志刚

                                          直给直要的工程需求往往不会用多卡做单任务来增加稳定性风险和维护成本@applejuice 需求不同吧,我俩追求的是简单直给的确定性结果,有点臭味相投哈哈

                                          A
                                          A
                                          applejuice
                                          王侯将相
                                          编写于 最后由 编辑
                                          #26

                                          @范志刚 其实如果可以我也想要单卡
                                          问题是 现在处境有点尴尬

                                          单卡 不够跑大型moe qfn 除非你买6000 pro
                                          双卡跑moe 基本也已经榨干显卡

                                          strata 方案 却只能排队,这时候有另一个模型做子任务就好多了
                                          而且我分拆子任务也是因为一个工作一个检查
                                          不是为了分拆而分拆

                                          BunseiB 1 条回复 最后回复
                                          0

                                          你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                                          厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                                          有了你的建议,这篇帖子会更精彩哦 💗

                                          注册 登录
                                          回复
                                          • 在新帖中回复
                                          登录后回复
                                          • 从旧到新
                                          • 从新到旧
                                          • 最多赞同


                                          • 登录

                                          • 登录或注册以进行搜索。
                                          • 第一个帖子
                                            最后一个帖子
                                          0
                                          • 版块
                                          • 最新
                                          • 标签
                                          • 热门
                                          • 用户
                                          • 群组