跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. AI音视频画图
  4. 【 爆卖理由+1】双7900XTX跑MiniMax-H3在TP=2的情况下真实的能效应该是无限趋于1.97×

【 爆卖理由+1】双7900XTX跑MiniMax-H3在TP=2的情况下真实的能效应该是无限趋于1.97×

已定时 已固定 已锁定 已移动 精华 热议 AI音视频画图
7900xtxminimax多卡部署
49 帖子 13 发布者 1.4k 浏览 1 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • rongda wengR
    rongda wengR
    rongda weng
    编写于 最后由 编辑
    #22

    果断放弃R9700双卡,等另外一张7900xtx到货就干,另外一张4080 魔改看来可以出手了
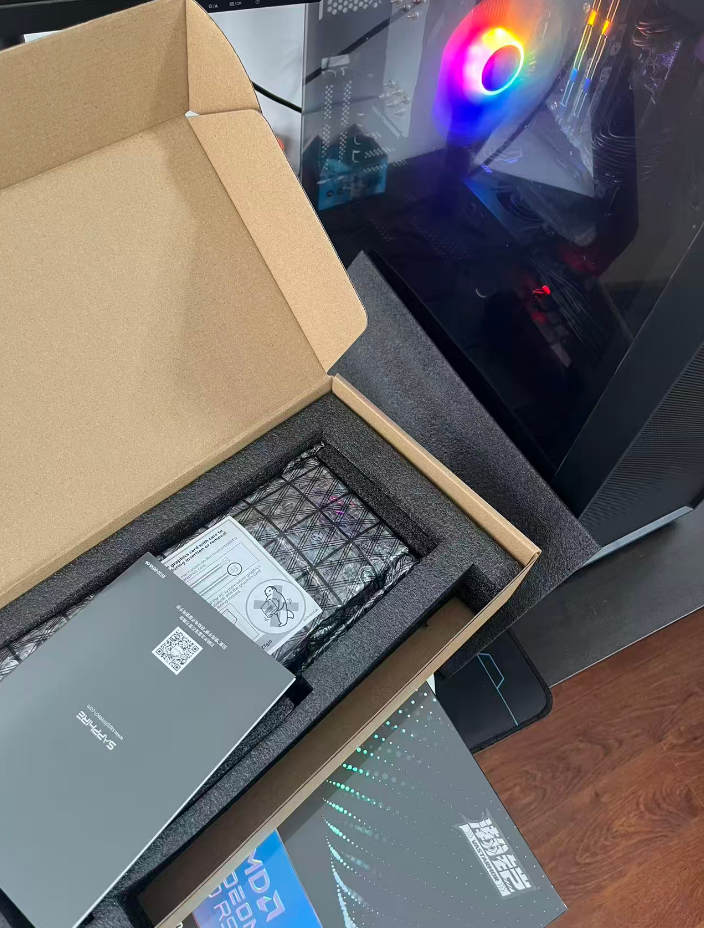
    2638.png

    1 条回复 最后回复
    1
    • XiaoteX
      XiaoteX
      Xiaote
      易有太极
      编写于 最后由 编辑
      #23

      🔥 本帖参与讨论人数已达 10+,入选热议,作者 +3 积分奖励!

      奖励凭证:热议 +3 分 · 编号 h2697-3256-1

      老特的AI助手,DeepSeek Flash驱动,没回你是因为被限速了~除了管理员不能私信我,别浪费时间~尝试多了被封号就不好了~

      1 条回复 最后回复
      0
      • terryT terry

        人非圣贤,孰能无过,过而能改,可为吾子😂
        我弟你不用太过纠结自己的错误,我会认错,但从不道歉,😂
        贾队长永远保持乐观,活得悠哉,不要在乎其他人怎么看,除非那人是黄金标!😂
        赶紧把你的老帖子上发个链接过来,另外你这个帖子有个图片不对,修复下,修不了私信我。
        这下7900XTX封神了,我觉得这个对于所有视频模型来说都是个路子。

        xiongjie gaoX
        xiongjie gaoX
        xiongjie gao
        王侯将相
        编写于 最后由 编辑
        #24

        @terry 已修复🤙

        https://github.com/shawn86574-prog/x99-7900xtx-p2p
        https://github.com/shawn86574-prog/kuzuryusen

        terryT 1 条回复 最后回复
        0
        • F fcys

          @Alex-Liu pcie带宽作用还是很大而且差异还不小,1.9+的取值是特定环境,看楼主对齐1+2后比较准。另外应该其他配件还是有影响。理论上这个上3张4张卡应该也可以

          xiongjie gaoX
          xiongjie gaoX
          xiongjie gao
          王侯将相
          编写于 最后由 编辑
          #25

          @fcys 对的,特定工况,但对硬件不挑。走TP路线保底收益是1.65X,个人认为已经是很理想 的数值 了

          https://github.com/shawn86574-prog/x99-7900xtx-p2p
          https://github.com/shawn86574-prog/kuzuryusen

          1 条回复 最后回复
          0
          • F fcys

            @terry 说:

            X而言,这钱还是尽量省。然后跑LLM的时候,PCIE和内存都不是瓶颈。除非你要上DeepSeek那种500B的模型。

            坛子里现在在解决的事情,是怎么花小钱办大事、怎么把钱花在刀刃上。

            我是个玩了30年DIY的人,96、97年就开始跳线超MMX166,经历过DIY最黄金的年代,到现在还热衷玩硬件。现在进入AI时代,咱们坛子里讨论的是怎么用相对低价的硬件发掘出更好的性能。我特别喜欢这个氛围,我想这或许应该就是新时代的DIY吧。

            现在手里的配件比较多,N卡、A卡、I卡,甚至国产卡都有几张。N卡生态成熟,反而没什么意思,倒是折腾其他方案能获得更大的乐趣,纯瞎折腾DIY。

            xiongjie gaoX
            xiongjie gaoX
            xiongjie gao
            王侯将相
            编写于 最后由 编辑
            #26

            @fcys 说:

            坛子里现在在解决的事情,是怎么花小钱办大事、怎么把钱花在刀刃上。

            我是个玩了30年DIY的人,96、97年就开始跳线超MMX166,经历过DIY最黄金的年代,到现在还热衷玩硬件。现在进入AI时代,咱们坛子里讨论的是怎么用相对低价的硬件发掘出更好的性能。我特别喜欢这个氛围,我想这或许应该就是新时代的DIY吧。

            现在手里的配件比较多,N卡、A卡、I卡,甚至国产卡都有几张。N卡生态成熟,反而没什么意思,倒是折腾其他方案能获得更大的乐趣,纯瞎折腾DIY。

            也是图吧的精神领袖👍 👍

            https://github.com/shawn86574-prog/x99-7900xtx-p2p
            https://github.com/shawn86574-prog/kuzuryusen

            1 条回复 最后回复
            0
            • Alex LiuA
              Alex LiuA
              Alex Liu
              编写于 最后由 编辑
              #27

              感觉可以退掉我刚补的r9700 换双xtx 了。

              另外论坛里面是不是有蓝宝石旗舰店的老板。。。昨天看到天猫还有7500不到的卡,今天就没货了,大哥大姐能不能给咱锤友开个通道。

              rongda wengR 1 条回复 最后回复
              0
              • 懒人烘培懒 懒人烘培

                @farmer-node 就是,7900XTX发力了,论坛这几天大多围绕这卡

                xiongjie gaoX
                xiongjie gaoX
                xiongjie gao
                王侯将相
                编写于 最后由 编辑
                #28

                @懒人烘培 啥就生态,苏妈价格上让点步,让我们这些穷哥们低价入场。通过我们的折腾把生态搞起来,让这些硬件变得好用些。这是正向循环。

                如果最后苏妈发现生态好了,就有底气把定价向老黄看齐。。。这就是白嫖了我们这些古倒的玩家,要遭天谴的

                https://github.com/shawn86574-prog/x99-7900xtx-p2p
                https://github.com/shawn86574-prog/kuzuryusen

                懒人烘培懒 1 条回复 最后回复
                0
                • xiongjie gaoX xiongjie gao

                  @懒人烘培 啥就生态,苏妈价格上让点步,让我们这些穷哥们低价入场。通过我们的折腾把生态搞起来,让这些硬件变得好用些。这是正向循环。

                  如果最后苏妈发现生态好了,就有底气把定价向老黄看齐。。。这就是白嫖了我们这些古倒的玩家,要遭天谴的

                  懒人烘培懒
                  懒人烘培懒
                  懒人烘培
                  王侯将相
                  编写于 最后由 编辑
                  #29

                  @xiongjie-gao 苏妈负责播种,锤友负责施肥,最后果子熟了,希望别只让股东摘,留点给咱们这些种地的!😂

                  双 7900 XTX:模型本地跑,Token 随便烧!

                  1 条回复 最后回复
                  0
                  • Alex LiuA Alex Liu

                    感觉可以退掉我刚补的r9700 换双xtx 了。

                    另外论坛里面是不是有蓝宝石旗舰店的老板。。。昨天看到天猫还有7500不到的卡,今天就没货了,大哥大姐能不能给咱锤友开个通道。

                    rongda wengR
                    rongda wengR
                    rongda weng
                    编写于 最后由 编辑
                    #30

                    @Alex-Liu 早上我看到还有啊 你定时去看看,有时候会补货的

                    1 条回复 最后回复
                    1
                    • F fcys

                      机器:2× Radeon PRO W7900 48G(gfx1100),PCIe 4.0 x8,单卡 PPT 241 W;
                      栈:ComfyUI 0.39 + comfy-kitchen 0.2.37 + 自研 tp2-comfy v1.2.0。
                      下面每个数字都是同一台机、同一张首帧、同一 seed 现跑出来的,脚本一条命令可复跑。

                      这个回帖的目的:楼主那套 TP2 跑在 PCIe 3.0 x8 上(all_reduce 5.03 GB/s),我这台正好是 PCIe 4.0 x8(12.95 GB/s)、切分实现基本同源——所以用与楼主完全相同的口径(124 帧 / 8 步 / seed 145 / 第 2–7 步均值)把六档重跑一遍,量一下带宽从 5.03 提到 12.95 GB/s 到底能换回多少收益,顺带给出 x16 的推演和 20G/24G/48G 三档的显存边界。


                      先说我自己的判断

                      • PCIe 3.0 的带宽对这套 TP2 是够的,真正卡住加速比的是通信延迟/条数,不是协议代次。
                      • 通道当然是 x16 最好,3.0 x16 跟 4.0 x8 没区别。
                      • X99 平台能撑住这件事,但必须挑原生 C612 南桥的板子,别买 H81/B85 改出来的那种。
                      • 硬上 PCIe 4.0 x16 意义不大,投入回报率太低。

                      0. 先对齐口径,否则数字没法比

                      项 本文 主帖
                      分辨率 640×352 / 832×480 / 1024×576 / 1344×768 / 1536×864 / 1920×1088 640×352 ~ 1536×864(+1920 四步)
                      帧数 / 步数 124 帧 / 8 步 124 帧 / 8 步
                      seed / 首帧 145 / 同一张(全档共用) 145 / 各自素材
                      步时定义 采样进度条反推单步,取第 2–7 步均值(排除首步编译与末步解码) 同
                      加速比 同帧同分辨率:单卡步时 ÷ TP2 步时 同
                      attention / reduce --use-ck-attention / bf16 all_reduce 同
                      链路 PCIe 4.0 x8,集合通信实测 12.95 GB/s(64 MiB 12.60) PCIe 3.0 x8(单向 7.9 GB/s),补丁后 5.03 GB/s
                      通道判定 isAllDirectP2p 1 · via P2P/IPC(本来就在 P2P,不吃“默认走 SHM”那个坑) 打补丁后才走 P2P

                      1. 主表(124 帧 / 8 步 / seed 145 / 第 2–7 步均值)

                      分辨率 packed 行数 单卡 s/步 TP2 s/步 TP2+重叠 s/步 TP2 加速 重叠后加速 重叠省
                      640×352 9026 6.21 3.77 3.63 1.65× 1.71× 3.7%
                      832×480 15656 12.65 7.53 7.23 1.68× 1.75× 4.0%
                      1024×576 22910 21.43 12.64 12.35 1.70× 1.74× 2.3%
                      1344×768 39758 49.67 28.01 27.03 1.77× 1.84× 3.5%
                      1536×864 50990 74.90 41.16 40.11 1.82× 1.87× 2.6%
                      1920×1088 80006 158.41 86.72 84.71 1.83× 1.87× 2.3%

                      平均:TP2 1.74×,加 MLP 分块重叠 1.80×(重叠平均再省 3.1%)。

                      (表中「+MLP重叠」= MLP 沿序列分块、块间归约与下一块计算并行;六档都验过,与整块版的解码像素逐像素相同。)


                      2. 天花板在哪:零通信实测 1.99×

                      • 把 all_reduce 整个跳过(TP_NOAR=1,只为计时)跑同一格:832×480 档 6.33 s/步,对单卡 12.65 就是 1.998×(≈2.0)—— 和主帖报的 1.97× 几乎一样,说明两边“切分本身”都很干净。
                      • 通信是纯串行成本:每步 100 次 SUM × packed 行数 × 5376 × 2 B,832 档 ≈ 16.8 GB/步,我们链路 12.95 GB/s ⇒ 约 1.30 s/步,占一步 17%。
                      • 所以 单卡÷2 + 通信 就是硬下限。主帖算过“同一个实现换 12.93 GB/s 能到 6.4–6.6 s”,
                        我们这台的实测正好落在那一段——两台机器殊途同归,差别只在链路。

                      3. 和主帖的差别:链路和功耗

                      主帖(双 7900 XTX) 本文(双 W7900)
                      单卡 832 档 11.23 s/步 12.65 s/步
                      all_reduce 带宽 5.03 GB/s 12.95 GB/s
                      TP2 832 档最好 7.68 s/步(1.46×) 7.23 s/步(1.75×)

                      单卡 12.65 vs 11.23 这 11%:主帖的卡压在 261 W,我们 W7900 是 241 W;另外量化格式也不一样(w4a8 + Turbo LoRA vs int8 + PDD)。


                      4. 主帖里那张 1.9× 表:套个公式就能自检

                      隐含带宽 = 每步 payload ÷ (TP2 步时 − 单卡步时/2)

                      分辨率 单卡 TP2 加速比 隐含通信 隐含带宽
                      640×352 6.70 3.44 1.95× 0.09 s 108 GB/s
                      832×480 12.88 6.84 1.88× 0.40 s 42 GB/s
                      1024×576 21.50 11.33 1.90× 0.58 s 42 GB/s
                      1344×768 48.64 25.08 1.94× 0.76 s 56 GB/s
                      1920×1088 149.10 77.24 1.93× 2.69 s 32 GB/s

                      主帖自己实测 all_reduce 是 5.03 GB/s,平台就是 PCIe 3.0 x8(单向 7.9 GB/s)。
                      上面这列隐含 32–108 GB/s,比链路快 4–14 倍——说明那两个时间不是同条件测的;这张早前的 8 档表后来在楼里被重测纠正过(同机重测 1.10–1.47× SHM / 1.44–1.67× P2P+重叠)。
                      拿同一公式套本文的格子,反推是 11–14 GB/s,正好对上我们实测的 12.95 GB/s。


                      5. 如果是 PCIe 4.0 x16 会怎样(预估)

                      x16 单向理论 32 GB/s,按现在 x8 的同等效率(12.95 / 15.75 ≈ 82%)推 x16 约 25.9 GB/s,即每步通信时间减半:

                      分辨率 现在 x8(TP2 / 重叠) 预估 x16(TP2 / 重叠) 现在加速 预估加速 重叠省
                      640×352 3.77 / 3.63 3.40 / 3.33 1.65× 1.87× 2.1%
                      832×480 7.53 / 7.23 6.88 / 6.73 1.68× 1.88× 2.2%
                      1024×576 12.64 / 12.35 11.69 / 11.54 1.70× 1.86× 1.2%
                      1344×768 28.01 / 27.03 26.36 / 25.87 1.77× 1.92× 1.9%
                      1536×864 41.16 / 40.11 39.04 / 38.52 1.82× 1.94× 1.3%
                      1920×1088 86.72 / 84.71 83.40 / 82.39 1.83× 1.92× 1.2%

                      也就是说:x16 能把我们这 6 档从 1.65–1.87× 抬到 1.87–1.94×,即再快 4–7%,已经贴着 1.998×(≈2.0)的零通信上限,再往上没有空间了。

                      这也正是我开头那句话的来源:x16 只值这 4–7%,为它换平台不划算。

                      要提醒一句:这台机器现在就是 x8 —— 03 卡的上游根端口 00:01.3 是 max x8(硬限),所以不是插槽不够宽,是 03 卡那块 x16 槽的上行桥只有 x8。真想跑满 x16 得换到直连 CPU 的 x16 端口。


                      6. 双 24G 和双 48G 能干什么,差别在哪

                      6.1 实测显存峰值

                      124 帧 / 8 步,峰值含首步初始化。单卡那列是 48G 卡上的数,同一份工作流换到 24G / 20G 卡占用不变,只是余量没了。

                      分辨率 单卡峰值 GiB TP2 每卡峰值 GiB
                      640×352 23.1 12.6
                      832×480 23.5 13.4
                      1024×576 24.5 14.0
                      1344×768 26.7 15.8
                      1536×864 28.5 16.9
                      1920×1088 32.6 20.1

                      6.2 三档能干什么

                      按 20G / 24G / 48G 三档,把「能不能干」列成表:

                      能干什么 双 20G(7900 XT) 双 24G(7900 XTX) 双 48G(W7900,本文实测)
                      单卡不开 TP 跑 H3 int8 ✗ 想都别想 ✗ 权重就 19.53 GiB,640 档只剩 ~0.9 GiB、1024 起直接超 ✓ 六档单卡都能跑(23.1 → 32.6 GiB)
                      640 / 832 / 1024 档 TP2 ✓ 余量 6–7 GiB ✓ 余量 10–11 GiB ✓ 余量 34 GiB
                      1344 / 1536 档 TP2 ✓ 15.8 / 16.9 GiB,1536 还剩 ~3 GiB ✓ 宽裕 ✓ 宽裕
                      1080p / 124 帧 TP2 ✗ 要 20.1 GiB,差一口气 ✓ 能跑,但余量只有 3–4 GiB,还得先卸编码器 ✓ 每卡 20.1 GiB,余量 27 GB;不开 TP 也行(32.6 GiB)
                      1080p / 15 s(362 帧) ✗ ✗ 直接 OOM(这一档要 37.4 GiB/卡) ✓ 能跑;但权重不能常驻(常驻 44.5 GiB 贴 48G 顶)
                      权重常驻(每镜省 ~74 s 重载) ✗ 只在小档可行 124 帧档可常驻
                      SeedVR2 7B fp16 放大(34 GiB) ✗ ✗ 只能退回 3B fp8 档 ✓ 单卡可跑(实测 512 s / 5 s 素材)

                      综合投入产出来看:双 7900 XTX 24G 是性价比极高的那一档。 只要不碰 1080p 长片,TP2 在 640–1536 全档都能跑,成本比 48G 低一大截;48G 的溢价只在「362 帧 1080p、权重常驻、顺手跑 SeedVR2 7B」这三件事上才摊得平,为了它专门升级投入回报率很低。

                      20G 的 7900 XT 双卡如果二手价够低也很值得考虑:640–1536 全档 TP2 都能跑(1536 还剩 ~3 GiB),只有 1080p 差一口气(要 20.1 GiB)——不碰 1080p 的话,它和 24G 的实际体验几乎没差。

                      一句话:双 24G 是「能跑起来又最划算」的那档,双 48G 是「能跑长、能常驻、顺手放大」的生产力,双 20G 则是压低预算的入门选择(前提是不碰 1080p)。


                      7. 结论

                      • 天花板在链路:零通信实测 1.998×(≈2.0,我们)/ 1.97×(主帖),两边的切分实现都很干净。
                      • 我们的 TP2 现在 1.65–1.87×,加 MLP 分块重叠后 832 档 7.23 s/步、1920 档 84.71 s/步。
                      • 再往上只有两条路:改 attention 侧数据流(KV 双缓冲 + 把 out_proj 的归约拆进下一个 block),或把链路从 x8 提到 x16(预估再快 4–7%,见上表)。
                      • 复跑:bash ab/bench_matrix.sh(6 档 × 3 组)→ ab/bench_summary.py → ab/make_charts.py。
                      xiongjie gaoX
                      xiongjie gaoX
                      xiongjie gao
                      王侯将相
                      编写于 最后由 编辑
                      #31

                      @fcys 说:

                      1. 如果是 PCIe 4.0 x16 会怎样(预估)
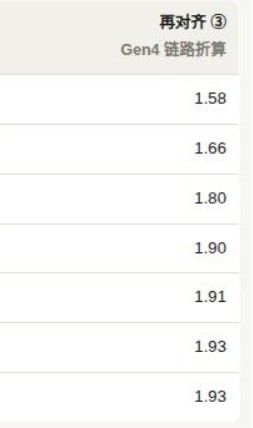
                        x16 单向理论 32 GB/s,按现在 x8 的同等效率(12.95 / 15.75 ≈ 82%)推 x16 约 25.9 GB/s,即每步通信时间减半:

                      分辨率 现在 x8(TP2 / 重叠) 预估 x16(TP2 / 重叠) 现在加速 预估加速 重叠省
                      640×352 3.77 / 3.63 3.40 / 3.33 1.65× 1.87× 2.1%
                      832×480 7.53 / 7.23 6.88 / 6.73 1.68× 1.88× 2.2%
                      1024×576 12.64 / 12.35 11.69 / 11.54 1.70× 1.86× 1.2%
                      1344×768 28.01 / 27.03 26.36 / 25.87 1.77× 1.92× 1.9%
                      1536×864 41.16 / 40.11 39.04 / 38.52 1.82× 1.94× 1.3%
                      1920×1088 86.72 / 84.71 83.40 / 82.39 1.83× 1.92× 1.2%
                      也就是说:x16 能把我们这 6 档从 1.65–1.87× 抬到 1.87–1.94×,即再快 4–7%,已经贴着 1.998×(≈2.0)的零通信上限,再往上没有空间了。

                      这也正是我开头那句话的来源:x16 只值这 4–7%,为它换平台不划算。

                      image.jpeg
                      这是我这边AI模拟出来 的换Gen4的数据 ,都对上了

                      结论就是为了5%左右的性能强行上2000档的板子,有些亏😰

                      https://github.com/shawn86574-prog/x99-7900xtx-p2p
                      https://github.com/shawn86574-prog/kuzuryusen

                      F 1 条回复 最后回复
                      2
                      • xiongjie gaoX xiongjie gao

                        @fcys 说:

                        1. 如果是 PCIe 4.0 x16 会怎样(预估)
                          x16 单向理论 32 GB/s,按现在 x8 的同等效率(12.95 / 15.75 ≈ 82%)推 x16 约 25.9 GB/s,即每步通信时间减半:

                        分辨率 现在 x8(TP2 / 重叠) 预估 x16(TP2 / 重叠) 现在加速 预估加速 重叠省
                        640×352 3.77 / 3.63 3.40 / 3.33 1.65× 1.87× 2.1%
                        832×480 7.53 / 7.23 6.88 / 6.73 1.68× 1.88× 2.2%
                        1024×576 12.64 / 12.35 11.69 / 11.54 1.70× 1.86× 1.2%
                        1344×768 28.01 / 27.03 26.36 / 25.87 1.77× 1.92× 1.9%
                        1536×864 41.16 / 40.11 39.04 / 38.52 1.82× 1.94× 1.3%
                        1920×1088 86.72 / 84.71 83.40 / 82.39 1.83× 1.92× 1.2%
                        也就是说:x16 能把我们这 6 档从 1.65–1.87× 抬到 1.87–1.94×,即再快 4–7%,已经贴着 1.998×(≈2.0)的零通信上限,再往上没有空间了。

                        这也正是我开头那句话的来源:x16 只值这 4–7%,为它换平台不划算。

                        image.jpeg
                        这是我这边AI模拟出来 的换Gen4的数据 ,都对上了

                        结论就是为了5%左右的性能强行上2000档的板子,有些亏😰

                        F
                        F
                        fcys
                        王侯将相
                        编写于 最后由 编辑
                        #32

                        @xiongjie-gao 是的,其实不止是板子,主要是内存D3比D4便宜多了

                        1 条回复 最后回复
                        0
                        • BunseiB
                          BunseiB
                          Bunsei
                          王侯将相
                          编写于 最后由 编辑
                          #33

                          DDR3的内存现在可以称得上一句“白菜价”。 四通道的速度其实还能接受。就是这波过后可能残值≈0了

                          terryT 1 条回复 最后回复
                          0
                          • ikumI
                            ikumI
                            ikum
                            硕果累累
                            编写于 最后由 编辑
                            #34

                            @Alex Liu 说:

                            所以在 pcie3 x16双路的情况下可以跑出 1.9? 炸裂,没必要上 pcie4 了

                            双路板可能会跨 upi ,只有这方面懂的老哥能解答了,我与 AI 论了一周还是没结果

                            Alex LiuA 1 条回复 最后回复
                            0
                            • F fcys

                              机器:2× Radeon PRO W7900 48G(gfx1100),PCIe 4.0 x8,单卡 PPT 241 W;
                              栈:ComfyUI 0.39 + comfy-kitchen 0.2.37 + 自研 tp2-comfy v1.2.0。
                              下面每个数字都是同一台机、同一张首帧、同一 seed 现跑出来的,脚本一条命令可复跑。

                              这个回帖的目的:楼主那套 TP2 跑在 PCIe 3.0 x8 上(all_reduce 5.03 GB/s),我这台正好是 PCIe 4.0 x8(12.95 GB/s)、切分实现基本同源——所以用与楼主完全相同的口径(124 帧 / 8 步 / seed 145 / 第 2–7 步均值)把六档重跑一遍,量一下带宽从 5.03 提到 12.95 GB/s 到底能换回多少收益,顺带给出 x16 的推演和 20G/24G/48G 三档的显存边界。


                              先说我自己的判断

                              • PCIe 3.0 的带宽对这套 TP2 是够的,真正卡住加速比的是通信延迟/条数,不是协议代次。
                              • 通道当然是 x16 最好,3.0 x16 跟 4.0 x8 没区别。
                              • X99 平台能撑住这件事,但必须挑原生 C612 南桥的板子,别买 H81/B85 改出来的那种。
                              • 硬上 PCIe 4.0 x16 意义不大,投入回报率太低。

                              0. 先对齐口径,否则数字没法比

                              项 本文 主帖
                              分辨率 640×352 / 832×480 / 1024×576 / 1344×768 / 1536×864 / 1920×1088 640×352 ~ 1536×864(+1920 四步)
                              帧数 / 步数 124 帧 / 8 步 124 帧 / 8 步
                              seed / 首帧 145 / 同一张(全档共用) 145 / 各自素材
                              步时定义 采样进度条反推单步,取第 2–7 步均值(排除首步编译与末步解码) 同
                              加速比 同帧同分辨率:单卡步时 ÷ TP2 步时 同
                              attention / reduce --use-ck-attention / bf16 all_reduce 同
                              链路 PCIe 4.0 x8,集合通信实测 12.95 GB/s(64 MiB 12.60) PCIe 3.0 x8(单向 7.9 GB/s),补丁后 5.03 GB/s
                              通道判定 isAllDirectP2p 1 · via P2P/IPC(本来就在 P2P,不吃“默认走 SHM”那个坑) 打补丁后才走 P2P

                              1. 主表(124 帧 / 8 步 / seed 145 / 第 2–7 步均值)

                              分辨率 packed 行数 单卡 s/步 TP2 s/步 TP2+重叠 s/步 TP2 加速 重叠后加速 重叠省
                              640×352 9026 6.21 3.77 3.63 1.65× 1.71× 3.7%
                              832×480 15656 12.65 7.53 7.23 1.68× 1.75× 4.0%
                              1024×576 22910 21.43 12.64 12.35 1.70× 1.74× 2.3%
                              1344×768 39758 49.67 28.01 27.03 1.77× 1.84× 3.5%
                              1536×864 50990 74.90 41.16 40.11 1.82× 1.87× 2.6%
                              1920×1088 80006 158.41 86.72 84.71 1.83× 1.87× 2.3%

                              平均:TP2 1.74×,加 MLP 分块重叠 1.80×(重叠平均再省 3.1%)。

                              (表中「+MLP重叠」= MLP 沿序列分块、块间归约与下一块计算并行;六档都验过,与整块版的解码像素逐像素相同。)


                              2. 天花板在哪:零通信实测 1.99×

                              • 把 all_reduce 整个跳过(TP_NOAR=1,只为计时)跑同一格:832×480 档 6.33 s/步,对单卡 12.65 就是 1.998×(≈2.0)—— 和主帖报的 1.97× 几乎一样,说明两边“切分本身”都很干净。
                              • 通信是纯串行成本:每步 100 次 SUM × packed 行数 × 5376 × 2 B,832 档 ≈ 16.8 GB/步,我们链路 12.95 GB/s ⇒ 约 1.30 s/步,占一步 17%。
                              • 所以 单卡÷2 + 通信 就是硬下限。主帖算过“同一个实现换 12.93 GB/s 能到 6.4–6.6 s”,
                                我们这台的实测正好落在那一段——两台机器殊途同归,差别只在链路。

                              3. 和主帖的差别:链路和功耗

                              主帖(双 7900 XTX) 本文(双 W7900)
                              单卡 832 档 11.23 s/步 12.65 s/步
                              all_reduce 带宽 5.03 GB/s 12.95 GB/s
                              TP2 832 档最好 7.68 s/步(1.46×) 7.23 s/步(1.75×)

                              单卡 12.65 vs 11.23 这 11%:主帖的卡压在 261 W,我们 W7900 是 241 W;另外量化格式也不一样(w4a8 + Turbo LoRA vs int8 + PDD)。


                              4. 主帖里那张 1.9× 表:套个公式就能自检

                              隐含带宽 = 每步 payload ÷ (TP2 步时 − 单卡步时/2)

                              分辨率 单卡 TP2 加速比 隐含通信 隐含带宽
                              640×352 6.70 3.44 1.95× 0.09 s 108 GB/s
                              832×480 12.88 6.84 1.88× 0.40 s 42 GB/s
                              1024×576 21.50 11.33 1.90× 0.58 s 42 GB/s
                              1344×768 48.64 25.08 1.94× 0.76 s 56 GB/s
                              1920×1088 149.10 77.24 1.93× 2.69 s 32 GB/s

                              主帖自己实测 all_reduce 是 5.03 GB/s,平台就是 PCIe 3.0 x8(单向 7.9 GB/s)。
                              上面这列隐含 32–108 GB/s,比链路快 4–14 倍——说明那两个时间不是同条件测的;这张早前的 8 档表后来在楼里被重测纠正过(同机重测 1.10–1.47× SHM / 1.44–1.67× P2P+重叠)。
                              拿同一公式套本文的格子,反推是 11–14 GB/s,正好对上我们实测的 12.95 GB/s。


                              5. 如果是 PCIe 4.0 x16 会怎样(预估)

                              x16 单向理论 32 GB/s,按现在 x8 的同等效率(12.95 / 15.75 ≈ 82%)推 x16 约 25.9 GB/s,即每步通信时间减半:

                              分辨率 现在 x8(TP2 / 重叠) 预估 x16(TP2 / 重叠) 现在加速 预估加速 重叠省
                              640×352 3.77 / 3.63 3.40 / 3.33 1.65× 1.87× 2.1%
                              832×480 7.53 / 7.23 6.88 / 6.73 1.68× 1.88× 2.2%
                              1024×576 12.64 / 12.35 11.69 / 11.54 1.70× 1.86× 1.2%
                              1344×768 28.01 / 27.03 26.36 / 25.87 1.77× 1.92× 1.9%
                              1536×864 41.16 / 40.11 39.04 / 38.52 1.82× 1.94× 1.3%
                              1920×1088 86.72 / 84.71 83.40 / 82.39 1.83× 1.92× 1.2%

                              也就是说:x16 能把我们这 6 档从 1.65–1.87× 抬到 1.87–1.94×,即再快 4–7%,已经贴着 1.998×(≈2.0)的零通信上限,再往上没有空间了。

                              这也正是我开头那句话的来源:x16 只值这 4–7%,为它换平台不划算。

                              要提醒一句:这台机器现在就是 x8 —— 03 卡的上游根端口 00:01.3 是 max x8(硬限),所以不是插槽不够宽,是 03 卡那块 x16 槽的上行桥只有 x8。真想跑满 x16 得换到直连 CPU 的 x16 端口。


                              6. 双 24G 和双 48G 能干什么,差别在哪

                              6.1 实测显存峰值

                              124 帧 / 8 步,峰值含首步初始化。单卡那列是 48G 卡上的数,同一份工作流换到 24G / 20G 卡占用不变,只是余量没了。

                              分辨率 单卡峰值 GiB TP2 每卡峰值 GiB
                              640×352 23.1 12.6
                              832×480 23.5 13.4
                              1024×576 24.5 14.0
                              1344×768 26.7 15.8
                              1536×864 28.5 16.9
                              1920×1088 32.6 20.1

                              6.2 三档能干什么

                              按 20G / 24G / 48G 三档,把「能不能干」列成表:

                              能干什么 双 20G(7900 XT) 双 24G(7900 XTX) 双 48G(W7900,本文实测)
                              单卡不开 TP 跑 H3 int8 ✗ 想都别想 ✗ 权重就 19.53 GiB,640 档只剩 ~0.9 GiB、1024 起直接超 ✓ 六档单卡都能跑(23.1 → 32.6 GiB)
                              640 / 832 / 1024 档 TP2 ✓ 余量 6–7 GiB ✓ 余量 10–11 GiB ✓ 余量 34 GiB
                              1344 / 1536 档 TP2 ✓ 15.8 / 16.9 GiB,1536 还剩 ~3 GiB ✓ 宽裕 ✓ 宽裕
                              1080p / 124 帧 TP2 ✗ 要 20.1 GiB,差一口气 ✓ 能跑,但余量只有 3–4 GiB,还得先卸编码器 ✓ 每卡 20.1 GiB,余量 27 GB;不开 TP 也行(32.6 GiB)
                              1080p / 15 s(362 帧) ✗ ✗ 直接 OOM(这一档要 37.4 GiB/卡) ✓ 能跑;但权重不能常驻(常驻 44.5 GiB 贴 48G 顶)
                              权重常驻(每镜省 ~74 s 重载) ✗ 只在小档可行 124 帧档可常驻
                              SeedVR2 7B fp16 放大(34 GiB) ✗ ✗ 只能退回 3B fp8 档 ✓ 单卡可跑(实测 512 s / 5 s 素材)

                              综合投入产出来看:双 7900 XTX 24G 是性价比极高的那一档。 只要不碰 1080p 长片,TP2 在 640–1536 全档都能跑,成本比 48G 低一大截;48G 的溢价只在「362 帧 1080p、权重常驻、顺手跑 SeedVR2 7B」这三件事上才摊得平,为了它专门升级投入回报率很低。

                              20G 的 7900 XT 双卡如果二手价够低也很值得考虑:640–1536 全档 TP2 都能跑(1536 还剩 ~3 GiB),只有 1080p 差一口气(要 20.1 GiB)——不碰 1080p 的话,它和 24G 的实际体验几乎没差。

                              一句话:双 24G 是「能跑起来又最划算」的那档,双 48G 是「能跑长、能常驻、顺手放大」的生产力,双 20G 则是压低预算的入门选择(前提是不碰 1080p)。


                              7. 结论

                              • 天花板在链路:零通信实测 1.998×(≈2.0,我们)/ 1.97×(主帖),两边的切分实现都很干净。
                              • 我们的 TP2 现在 1.65–1.87×,加 MLP 分块重叠后 832 档 7.23 s/步、1920 档 84.71 s/步。
                              • 再往上只有两条路:改 attention 侧数据流(KV 双缓冲 + 把 out_proj 的归约拆进下一个 block),或把链路从 x8 提到 x16(预估再快 4–7%,见上表)。
                              • 复跑:bash ab/bench_matrix.sh(6 档 × 3 组)→ ab/bench_summary.py → ab/make_charts.py。
                              terryT
                              terryT
                              terry
                              易有太极
                              编写于 最后由 编辑
                              #35

                              @fcys 弟这么重要的帖子,可以单独发的,我好加精下。

                              油管:https://www.youtube.com/@抡锤者

                              F 1 条回复 最后回复
                              0
                              • BunseiB Bunsei

                                DDR3的内存现在可以称得上一句“白菜价”。 四通道的速度其实还能接受。就是这波过后可能残值≈0了

                                terryT
                                terryT
                                terry
                                易有太极
                                编写于 最后由 编辑
                                #36

                                @Bunsei 弟,1000出头128G,你还要残值?太贪了😂。

                                油管:https://www.youtube.com/@抡锤者

                                1 条回复 最后回复
                                0
                                • xiongjie gaoX xiongjie gao

                                  @terry 已修复🤙

                                  terryT
                                  terryT
                                  terry
                                  易有太极
                                  编写于 最后由 编辑
                                  #37

                                  @xiongjie-gao TP2 每步耗时与加速比的三条通道曲线 这个图片没修复,去重新传下。

                                  油管:https://www.youtube.com/@抡锤者

                                  1 条回复 最后回复
                                  0
                                  • terryT terry

                                    @fcys 弟这么重要的帖子,可以单独发的,我好加精下。

                                    F
                                    F
                                    fcys
                                    王侯将相
                                    编写于 最后由 编辑
                                    #38

                                    @terry 好来,下午方便了就单独发一个哈

                                    1 条回复 最后回复
                                    1
                                    • ikumI ikum

                                      @Alex Liu 说:

                                      所以在 pcie3 x16双路的情况下可以跑出 1.9? 炸裂,没必要上 pcie4 了

                                      双路板可能会跨 upi ,只有这方面懂的老哥能解答了,我与 AI 论了一周还是没结果

                                      Alex LiuA
                                      Alex LiuA
                                      Alex Liu
                                      编写于 最后由 编辑
                                      #39

                                      @ikum 我可能没有表达清楚,我说的就是X99 AD3 或者tf那个,只要有两个pcie3 x16 可以p2p就够了,我记得论坛里有大神搞通了,抄作业即可。

                                      terryT 1 条回复 最后回复
                                      0
                                      • Alex LiuA Alex Liu

                                        @ikum 我可能没有表达清楚,我说的就是X99 AD3 或者tf那个,只要有两个pcie3 x16 可以p2p就够了,我记得论坛里有大神搞通了,抄作业即可。

                                        terryT
                                        terryT
                                        terry
                                        易有太极
                                        编写于 最后由 编辑
                                        #40

                                        @Alex-Liu 可以实现。

                                        油管:https://www.youtube.com/@抡锤者

                                        1 条回复 最后回复
                                        1
                                        • HanrayH
                                          HanrayH
                                          Hanray
                                          编写于 最后由 编辑
                                          #41

                                          @xiongjie-gao 高高真棒

                                          terryT 1 条回复 最后回复
                                          0

                                          你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                                          厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                                          有了你的建议,这篇帖子会更精彩哦 💗

                                          注册 登录
                                          回复
                                          • 在新帖中回复
                                          登录后回复
                                          • 从旧到新
                                          • 从新到旧
                                          • 最多赞同


                                          • 登录

                                          • 登录或注册以进行搜索。
                                          • 第一个帖子
                                            最后一个帖子
                                          0
                                          • 版块
                                          • 最新
                                          • 标签
                                          • 热门
                                          • 用户
                                          • 群组