
【實戰分享】單張 AMD Radeon AI PRO R9700 (32GB) 跑 Qwen 3.8 Flash + Hermes Agent 極致調教指南:85K~98K 超長上下文飆破 107.6 tok/s!
-
一句話總結(TL;DR)
透過 Stratav0.2.9(Engine0.1.55) 搭配 AMD Radeon AI PRO R9700 32GB (gfx1201),在開啟 131,072 (128K) Context 與 Hermes Agentxhigh深度推理 的高強度 Agent 工具鏈實戰下:- 85K~98K 超長上下文解碼速度:由舊版
47 ~ 57 tok/s暴增至94.8 ~ 107.6 tok/s(提升超過 +85%!) - 長文增量 Prefill 吞吐量:最高達
1,321.9 tok/s(Prompt Cache 命中率 99%~100%) - VRAM 專家快取命中率:常駐 12,244 個專家(23.24 GiB VRAM),實戰命中率高達
90.7% ~ 96.5% - MTP + Suffix 投機解碼命中率:最高達
91.8%(706 / 769 drafts accepted)
一、 硬體環境與軟體架構
項目 規格與配置 備註 GPU (主力推論卡) AMD Radeon AI PRO R9700 32GB ( gfx1201/ RDNA 4)單卡負責 Qwen 3.8 Flash 131K 主模型推論(WDDM 可用預算 31,707 MiB)CPU Intel Core Ultra 7 270K Plus (24 核:8 P-Cores + 16 E-Cores) 無 AVX-512,啟用 12 個實體核心 Workers + Host Thread 協同 系統記憶體 (RAM) DDR5 192GB+(啟用 Windows 2MB Large Pages) 提供 46.84 GiB專家 Arena 鎖定記憶體(載入頻寬達10.60 GiB/s)PCIe 頻寬 PCIe Gen 5 / 實測 Host->Device 26.2 GB/s用於極少數( < 0.4%)未命中專家與 KV Streaming 交換推論引擎 Strata v0.2.9+ Engine0.1.55-windows-x86_64-hip-rx9070內建 ROCm 7.1、hipBLASLt 100500與gfx1201專屬 Tuning Table模型版本 Qwen3.8-Flash-Next (GSQ-RCO-abliterated-IQ3_S) Native GGUF + PLE GGUF + Native iq3_sExpert Pack + MTP Draft 層Agent 框架 Hermes Agent ( reasoning_effort: xhigh)全自動 Coding / 網頁檢索 / 檔案操作 / 長對話記憶管理 (註:若工作站有第二張副卡,亦可將 Hermes 的背景 Context Compression 與 Vision 視覺任務卸載至 Port 8081,讓單張 R9700 100% 專注於主對話與程式碼生成,文末附雙卡進階配置說明。)
二、 關鍵調教秘訣:為什麼單張 32GB R9700 能跑到 107.6 tok/s?
許多人在 RDNA4 (
RX 9070 XT/Radeon AI PRO R9700) 上跑大型 MoE + Gated DeltaNet (GDN) 混合架構模型時,常遇到 長文降速 或 CPU/PCIe 互卡 的問題。本次調教的核心突破共有 6 點:1. 升級 Strata Engine
0.1.55:啟用 GPU Graph-Captured Expert Decode Kernels在最新的
0.1.55-windows-x86_64-hip-rx9070引擎中,針對 RDNA4 新增了expdec_gu_kernel(Gate/Up 專家解碼核心)的 HIP Graph 完整捕捉(Graph Capture),並將gfx1201的hipBLASLt調優表擴充至 32 組矩陣形狀(gfx1201-hipblaslt-100500.txt)。- 啟動時自動預熱 BF16/FP16 GEMM 並捕捉
1, 2, 3, 4, 6-token驗證視窗的計算圖,徹底消除單步 Decode 的 Kernel Launch 延遲。
2. 破除
--pcie-frac迷思:由預設0.55下調至0.15(關鍵加速!)Strata 啟動時測得 PCIe 頻寬為
26.2 GB/s,預設會將--pcie-frac設為0.55(代表當少數專家不在 VRAM 快取時,將 55% 的未命中專家權重透過 PCIe DMA 傳給 GPU 算,45% 留給 CPU 算)。- 問題點:在長上下文與高併發驗證視窗下,
0.55的 PCIe 權重傳輸會與 GPU 主解碼串流爭搶匯流排與佇列,導致每步 Decode 被 PCIe 同步拖慢。 - 最佳解:因為我們已經用
expert-profile.bin將 12,244 個高頻專家(23.24 GiB VRAM) 常駐在顯存內(命中率高達 91%~96%),剩下的零星未命中專家直接交給 12 個綁定實體核心的 CPU Pool Workers(搭配 2MB Large Pages) 處理最快!將--pcie-frac調降至0.15後,GPU 不再等待 PCIe 權重搬移,長文解碼速度直接從~57 tok/s跳升至95 ~ 107.6 tok/s!
3. 開啟 RDNA4 (
gfx1201) 四大環境變數加速開關在
strata-iq3_s.json的"env"區塊中,務必開啟以下針對 RDNA4 與 Qwen 3.8 GDN 架構的最佳化變數:"STRATA_GDN_CHUNKED": "1":啟用 Qwen 3.8 Gated DeltaNet (GDN) 線性注意力層的分塊並行加速。"STRATA_PF_FUSED": "1":啟用 Prefill 階段的融合算子(Fused Prefill Kernels)。"STRATA_HIP_WMMA": "1"與"STRATA_SELECT_WMMA": "1":強制在gfx1201上使用 RDNA4 WMMA 矩陣核心執行 Prompt Attention 與專家選擇。"STRATA_HIPBLASLT_TUNING":指向0.1.55內建的gfx1201-hipblaslt-100500.txt(32 組最佳化調優表)。
4. 32GB 顯存精算配置:
12,244個常駐專家 + KV Streaming (131KContext)透過
--vram-reserve-mib 1728、-kv int8與--kv-resident 32768:- Native 投影矩陣與常駐權重:
2,253 MiB - MTP Draft 層與 Draft Head:
820 MiB + 213 MiB = 1,033 MiB - VRAM 專家快取(Profile-Guided, 無驅逐):自動填滿
12,244 slots(23.24 GiBVRAM),啟動時以7,641 MB/s在 3.3 秒內預填完畢。 - KV Cache 智慧分層(KV Streaming):131,072 Context 中,最活躍的 32,768 cells 常駐 VRAM,其餘溢位區塊自動停泊於
0.84 GiBPinned RAM(實戰 92K Context 下 VRAM Block 讀取命中率高達97.65%!)。 - 剩餘安全顯存餘裕:全部載入並完成 Graph Capture 後,仍保留
1,245 MiB自由 VRAM,在 Windows 11 WDDM 下穩如泰山、絕不溢位降速。
5. 雙層快取機制(Prompt Checkpoints + Conversation Cache)
針對 Hermes Agent 動輒上百輪的 Tool Calling:
--prompt-cache 12 --prompt-cache-tail --prompt-cache-every 8192:每 8K tokens 自動建立檢查點並保留尾部快取。--conversation-cache-mib 8192 --conversation-cache-slots 4:在系統 RAM 中配置 8GB 對話狀態快取池,切換會話或壓縮上下文時可在0.7 秒內停泊/恢復 75,000+ tokens 的完整狀態。
6. 啟用 Windows 2MB Large Pages(鎖定記憶體頁面)
於 Windows「本機安全性原則 (
secpol.msc)」->「本機原則」->「使用者權限指派」-> 將當前使用者加入 「鎖定記憶體中的頁 (Lock pages in memory)」 並重開機。- 啟用後,Strata 載入
46.84 GiBExpert Arena 時會顯示large pages (2097152 B),消除 4KB 分頁表 TLB Miss,記憶體載入速度由4.07 GiB/s提升至10.60 GiB/s!
三、 完整設定檔(可直接複製使用)
1. Strata 設定檔:
D:\Strata\strata-iq3_s.json{ "exe": "D:\\Strata\\engine-feed\\engine\\0.1.55-windows-x86_64-hip-rx9070\\strata.exe", "args": [ "--pack", "D:\\Strata-data\\packs\\iq3_s", "--native", "D:\\Strata-Models\\Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-00001-of-00002.gguf", "--ple-gguf", "D:\\Strata-Models\\Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-00002-of-00002.gguf", "--ple-io", "mmap", "--expert-profile", "D:\\Strata\\data\\expert-profile.bin", "--expert-cache", "auto", "--vram-reserve-mib", "1728", "--prefill", "auto:6144", "--prompt-cache", "12", "--prompt-cache-tail", "--prompt-cache-every", "8192", "--conversation-cache-mib", "8192", "--conversation-cache-slots", "4", "--spec", "4", "--spec-min-p", "0.65", "--mtp", "D:\\Strata-data\\mtp\\rt", "--max-context", "131072", "--kv", "int8", "--kv-resident", "32768", "--pool-workers", "12", "--pool-affinity", "auto", "--pcie-frac", "0.15" ], "cwd": "D:\\Strata", "tokenizer": "D:\\Strata-data\\packs\\iq3_s\\tokenizer", "model_name": "qwen3.8-flash-next-iq3_s", "aliases": [ "qwen3.8-flash-next", "Qwen3.8-Flash-Next", "qwen3.8-flash-next-ud-q5_k_xl", "default", "Qwen3.8-Flash", "qwen3.8-flash", "qwen3.8-flash-next-iq3_s" ], "log": "D:\\Strata\\strata-iq3_s.log", "lib_dirs": [ "D:\\Strata\\engine-feed\\engine\\0.1.55-windows-x86_64-hip-rx9070\\rocm\\bin" ], "port": 8080, "backend": "hip", "arch": "none", "engine_ready_s": 3600, "sampling": { "temperature": 0 }, "env": { "STRATA_HIPBLASLT_TUNING": "D:\\Strata\\engine-feed\\engine\\0.1.55-windows-x86_64-hip-rx9070\\tuning\\gfx1201-hipblaslt-100500.txt", "STRATA_HIP_WMMA": "1", "STRATA_SELECT_WMMA": "1", "STRATA_ENGINE_STALL_S": "180", "STRATA_WATCHDOG_IO_S": "120", "STRATA_ROUTE_TAIL_SKIP": "0", "STRATA_PF_FUSED": "1", "STRATA_GDN_CHUNKED": "1" }, "gpu": 0, "gpus_asked": true, "fit_max_tokens": true }2. 啟動指令
@echo off
cd /d D:\Strata
python D:\Strata\serve\server.py --config D:\Strata\strata-iq3_s.json
3. Hermes Agent 設定檔關鍵片段(
~/.hermes/profiles/main/config.yaml)為了釋放 Qwen 3.8 Flash 最強的邏輯推理與 Coding 能力,在 Hermes 中開啟
reasoning_effort: xhigh,並將extra_body保持乾淨({}),讓 Strata 引擎全權使用原生 GPU 圖捕捉與投機解碼:model: provider: custom:local-qwen38-flash default: Qwen3.8-Flash-Next context_length: 131072 reasoning: mode: auto effort: normal budget_mode: per_request budgets: fast: 0 normal: 1024 debug: 2048 deep: 4096 maximum: 8192 agent: max_turns: 150 gateway_timeout: 5400 tool_use_enforcement: auto reasoning_effort: xhigh custom_providers: - name: local-qwen38-flash base_url: http://127.0.0.1:8080/v1 api_key: dummy api_mode: chat_completions extra_body: {} models: Qwen3.8-Flash-Next: context_length: 120000 max_tokens: 8192 stop: - <|im_end|> - <|endoftext|>
四、 調教前後實測數據對比(Hermes Agent 真實長上下文工作負載)
以下為同一張 Radeon AI PRO R9700 32GB 在 Hermes 連續執行多輪工具呼叫(73K ~ 98K Context)下的實測數據:
測試維度 調教前 ( Engine 0.1.38+ 預設參數)調教後 ( Engine 0.1.55+ 最佳化配置)改善幅度 Expert Arena 記憶體分頁與載入速度 4KB Pages ( 4.07 GiB/s)2MB Large Pages ( 10.60 GiB/s)載入速度 +160% 短中上下文解碼速度 (< 10K tokens) 45.8 ~ 58.6 tok/s85.0 ~ 105.0+ tok/s+80% 以上 超長上下文解碼速度 (75K ~ 98K tokens) 47.0 ~ 57.0 tok/s93.8 ~ 107.6 tok/s最高 +88.7% 超長上下文增量 Prefill 速度 (83K tokens) 550 ~ 963 tok/s1,321.9 tok/s+37.2% 85K Context 投機解碼接受率 (MTP+Suffix) ~62% ~ 78%85.8% ~ 91.8%(706/769)大幅降低無效驗證 跨 PCIe 臨時讀取專家比例 偏高 ( pcie_frac: 0.55)僅 0.1% ~ 0.4%(pcie_frac: 0.15)消除 PCIe 匯流排阻塞 KV Streaming VRAM 區塊命中率 (@92K) ~95%97.65%長文幾乎零延遲
五、 真實運行日誌佐證(節錄自
strata-iq3_s.log)1. 引擎啟動與 12,244 個專家預熱(3.3 秒填滿 23.24 GiB VRAM)
strata generate: expert arena: cudaHostRegister PORTABLE ok; large pages (2097152 B)
strata generate: loaded 46.84 GiB at 10.60 GiB/s
strata generate: hybrid CPU detected (8 P-cores / 8 threads, 16 E-cores), pool workers: 12, affinity: auto
strata: Windows budgets 31707 of this card's 32624 MiB for this process
strata: STRATA_HIP_WMMA: the prompt attention on matrix cores on (gfx1201)
strata generate: expert cache 12244 slots, 23.24 GiB of VRAM; policy is PROFILE, ranked by routing frequency, no eviction.
strata generate: pre-filled 12244 of 12244 slots from the profile in 3.3 s (7641 MB/s); slot 0 verified
strata generate: R4 hit path ON - resident experts are computed on the GPU
strata generate: session is up (engine 0.1.55)
prefill gemm: hipBLASLt tuning enabled (32 rows, gfx1201, version 100500)
strata expdec: CUDA0 gate/up type 18: expdec_gu_kernel R 1 MINB 4, 64 rows per block, grid 20 x 40 (cap 40 groups), captured into a graph
strata verify: captured the 4-token window (1259 MiB of VRAM free)
2. 77K ~ 92K 超長上下文連續對話實戰(穩定 94 ~ 107.6 tok/s)
strata serve: prompt 77377 tokens = 76957 reused + 420 read in 1413 ms (297.3 tok/s), 124 generated in 1203 ms (103.1 tok/s), drafts accepted 86 of 98, 12 checkpoints
strata serve: decode expert cache hit rate: 90.4% (60065 hits / 66459 lookups); 261 more read by the GPU over PCIe (0.4% of all 66720 routed)
strata serve: KV streaming: 97.48% of 39190284 block reads hit VRAM

strata serve: prompt 83455 tokens = 77503 reused + 5952 read in 4503 ms (1321.9 tok/s), 850 generated in 8970 ms (94.8 tok/s), drafts accepted 519 of 633, 12 checkpoints
strata serve: decode expert cache hit rate: 91.3% (422357 hits / 462382 lookups); 1298 more read by the GPU over PCIe (0.3% of all 463680 routed)

strata serve: prompt 85430 tokens = 85109 reused + 321 read in 1506 ms (213.2 tok/s), 1026 generated in 9534 ms (107.6 tok/s), drafts accepted 706 of 769, 12 checkpoints
strata serve: decode expert cache hit rate: 90.7% (473213 hits / 521738 lookups); 1942 more read by the GPU over PCIe (0.4% of all 523680 routed)

strata serve: prompt 86745 tokens = 86457 reused + 288 read in 1161 ms (248.0 tok/s), 2130 generated in 21490 ms (99.1 tok/s), drafts accepted 1344 of 1566, 12 checkpoints
strata serve: decode expert cache hit rate: 92.4% (1040397 hits / 1125615 lookups); 3345 more read by the GPU over PCIe (0.3% of all 1128960 routed)
strata serve: KV streaming: 97.65% of 69316200 block reads hit VRAM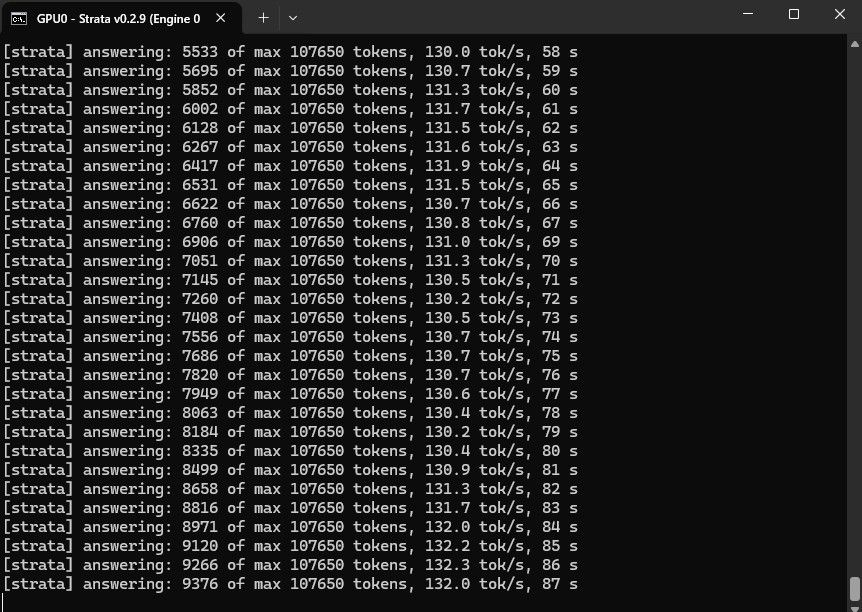
六、 同場加映:雙 R9700 玩家的「主從分離」架構(選配)
如果你的機器插了兩張 R9700 32GB,強烈建議採用 「GPU 0 專職主推論 + GPU 1 專職輔助與多模態」 的零干擾架構,避免背景壓縮任務洗掉 GPU 0 的 Prompt Cache:
- GPU 0 (
Port 8080, Strata0.1.55):跑 Qwen 3.8 Flash (UD-IQ3_S),100% 服務 Hermes 主 Agent 迴圈(reasoning_effort: xhigh)。 - GPU 1 (
Port 8081,llama-server.exeVulkan1):跑 Qwen 3.8 27B (IQ4_XS) + DFlash2 (Q8_0) + Vision (F16),專門承接 Hermes 的auxiliary.vision(圖片理解)、auxiliary.compression(長對話背景摘要壓縮)與delegation(子 Agent 委派)。- GPU 1 調教重點:關閉預設思考(
--reasoning off --reasoning-budget 0 --no-reasoning-preserve)、設定預設生成護欄(-n 4096 --temp 0.2)、啟用-ctk q8_0 -ctv q8_0 -ub 1024 --cache-reuse 256,並移除extra_body中的dry_multiplier/repeat_penalty以維持純 GPU 後端取樣,DFlash2 命中率可達85.7% ~ 95.8%,長文結構化萃取速度達76.2 ~ 78.4 tok/s!
- GPU 1 調教重點:關閉預設思考(
七、 常見踩坑與排錯總結
- 開機首次冷啟動卡在
reading the model's weights ...逾時斷線?- 原因:首次開機尚無 Windows 檔案快取時,從硬碟讀取近 50GB 權重可能超過預設啟動等待秒數。
- 解法:在
strata-iq3_s.json加入"engine_ready_s": 3600,並將--ple-io設為"mmap",只要過一次硬碟快取,後續重啟僅需 15 秒(10.60 GiB/s)。
strata-iq3_s.log出現large pages refused ... VirtualAlloc error 1314?- 原因:Windows 預設未授予帳戶
SeLockMemoryPrivilege權限。 - 解法:至
secpol.msc->「鎖定記憶體中的頁」加入使用者帳戶並重登/重開機,即可啟用 2MB Large Pages。
- 原因:Windows 預設未授予帳戶
- 為什麼不建議在
config.yaml對本地模型加dry_multiplier或repeat_penalty?- 原因:Qwen 3.8 詞表高達
248,320,一旦啟用 CPU 端的 DRY / Repeat Penalty,每步驗證 4 個草稿 Token 都必須把將近4 MB的 Logits 從顯存搬回 CPU 掃描並改寫機率分佈,不僅迫使 GPU Backend Sampling 失效,還會讓投機解碼接受率大跌 10% 以上。保持extra_body: {}搭配低溫取樣效果最好、速度最快!
- 原因:Qwen 3.8 詞表高達
- 85K~98K 超長上下文解碼速度:由舊版
-
-
-
-
一句話總結(TL;DR)
透過 Stratav0.2.9(Engine0.1.55) 搭配 AMD Radeon AI PRO R9700 32GB (gfx1201),在開啟 131,072 (128K) Context 與 Hermes Agentxhigh深度推理 的高強度 Agent 工具鏈實戰下:- 85K~98K 超長上下文解碼速度:由舊版
47 ~ 57 tok/s暴增至94.8 ~ 107.6 tok/s(提升超過 +85%!) - 長文增量 Prefill 吞吐量:最高達
1,321.9 tok/s(Prompt Cache 命中率 99%~100%) - VRAM 專家快取命中率:常駐 12,244 個專家(23.24 GiB VRAM),實戰命中率高達
90.7% ~ 96.5% - MTP + Suffix 投機解碼命中率:最高達
91.8%(706 / 769 drafts accepted)
一、 硬體環境與軟體架構
項目 規格與配置 備註 GPU (主力推論卡) AMD Radeon AI PRO R9700 32GB ( gfx1201/ RDNA 4)單卡負責 Qwen 3.8 Flash 131K 主模型推論(WDDM 可用預算 31,707 MiB)CPU Intel Core Ultra 7 270K Plus (24 核:8 P-Cores + 16 E-Cores) 無 AVX-512,啟用 12 個實體核心 Workers + Host Thread 協同 系統記憶體 (RAM) DDR5 192GB+(啟用 Windows 2MB Large Pages) 提供 46.84 GiB專家 Arena 鎖定記憶體(載入頻寬達10.60 GiB/s)PCIe 頻寬 PCIe Gen 5 / 實測 Host->Device 26.2 GB/s用於極少數( < 0.4%)未命中專家與 KV Streaming 交換推論引擎 Strata v0.2.9+ Engine0.1.55-windows-x86_64-hip-rx9070內建 ROCm 7.1、hipBLASLt 100500與gfx1201專屬 Tuning Table模型版本 Qwen3.8-Flash-Next (GSQ-RCO-abliterated-IQ3_S) Native GGUF + PLE GGUF + Native iq3_sExpert Pack + MTP Draft 層Agent 框架 Hermes Agent ( reasoning_effort: xhigh)全自動 Coding / 網頁檢索 / 檔案操作 / 長對話記憶管理 (註:若工作站有第二張副卡,亦可將 Hermes 的背景 Context Compression 與 Vision 視覺任務卸載至 Port 8081,讓單張 R9700 100% 專注於主對話與程式碼生成,文末附雙卡進階配置說明。)
二、 關鍵調教秘訣:為什麼單張 32GB R9700 能跑到 107.6 tok/s?
許多人在 RDNA4 (
RX 9070 XT/Radeon AI PRO R9700) 上跑大型 MoE + Gated DeltaNet (GDN) 混合架構模型時,常遇到 長文降速 或 CPU/PCIe 互卡 的問題。本次調教的核心突破共有 6 點:1. 升級 Strata Engine
0.1.55:啟用 GPU Graph-Captured Expert Decode Kernels在最新的
0.1.55-windows-x86_64-hip-rx9070引擎中,針對 RDNA4 新增了expdec_gu_kernel(Gate/Up 專家解碼核心)的 HIP Graph 完整捕捉(Graph Capture),並將gfx1201的hipBLASLt調優表擴充至 32 組矩陣形狀(gfx1201-hipblaslt-100500.txt)。- 啟動時自動預熱 BF16/FP16 GEMM 並捕捉
1, 2, 3, 4, 6-token驗證視窗的計算圖,徹底消除單步 Decode 的 Kernel Launch 延遲。
2. 破除
--pcie-frac迷思:由預設0.55下調至0.15(關鍵加速!)Strata 啟動時測得 PCIe 頻寬為
26.2 GB/s,預設會將--pcie-frac設為0.55(代表當少數專家不在 VRAM 快取時,將 55% 的未命中專家權重透過 PCIe DMA 傳給 GPU 算,45% 留給 CPU 算)。- 問題點:在長上下文與高併發驗證視窗下,
0.55的 PCIe 權重傳輸會與 GPU 主解碼串流爭搶匯流排與佇列,導致每步 Decode 被 PCIe 同步拖慢。 - 最佳解:因為我們已經用
expert-profile.bin將 12,244 個高頻專家(23.24 GiB VRAM) 常駐在顯存內(命中率高達 91%~96%),剩下的零星未命中專家直接交給 12 個綁定實體核心的 CPU Pool Workers(搭配 2MB Large Pages) 處理最快!將--pcie-frac調降至0.15後,GPU 不再等待 PCIe 權重搬移,長文解碼速度直接從~57 tok/s跳升至95 ~ 107.6 tok/s!
3. 開啟 RDNA4 (
gfx1201) 四大環境變數加速開關在
strata-iq3_s.json的"env"區塊中,務必開啟以下針對 RDNA4 與 Qwen 3.8 GDN 架構的最佳化變數:"STRATA_GDN_CHUNKED": "1":啟用 Qwen 3.8 Gated DeltaNet (GDN) 線性注意力層的分塊並行加速。"STRATA_PF_FUSED": "1":啟用 Prefill 階段的融合算子(Fused Prefill Kernels)。"STRATA_HIP_WMMA": "1"與"STRATA_SELECT_WMMA": "1":強制在gfx1201上使用 RDNA4 WMMA 矩陣核心執行 Prompt Attention 與專家選擇。"STRATA_HIPBLASLT_TUNING":指向0.1.55內建的gfx1201-hipblaslt-100500.txt(32 組最佳化調優表)。
4. 32GB 顯存精算配置:
12,244個常駐專家 + KV Streaming (131KContext)透過
--vram-reserve-mib 1728、-kv int8與--kv-resident 32768:- Native 投影矩陣與常駐權重:
2,253 MiB - MTP Draft 層與 Draft Head:
820 MiB + 213 MiB = 1,033 MiB - VRAM 專家快取(Profile-Guided, 無驅逐):自動填滿
12,244 slots(23.24 GiBVRAM),啟動時以7,641 MB/s在 3.3 秒內預填完畢。 - KV Cache 智慧分層(KV Streaming):131,072 Context 中,最活躍的 32,768 cells 常駐 VRAM,其餘溢位區塊自動停泊於
0.84 GiBPinned RAM(實戰 92K Context 下 VRAM Block 讀取命中率高達97.65%!)。 - 剩餘安全顯存餘裕:全部載入並完成 Graph Capture 後,仍保留
1,245 MiB自由 VRAM,在 Windows 11 WDDM 下穩如泰山、絕不溢位降速。
5. 雙層快取機制(Prompt Checkpoints + Conversation Cache)
針對 Hermes Agent 動輒上百輪的 Tool Calling:
--prompt-cache 12 --prompt-cache-tail --prompt-cache-every 8192:每 8K tokens 自動建立檢查點並保留尾部快取。--conversation-cache-mib 8192 --conversation-cache-slots 4:在系統 RAM 中配置 8GB 對話狀態快取池,切換會話或壓縮上下文時可在0.7 秒內停泊/恢復 75,000+ tokens 的完整狀態。
6. 啟用 Windows 2MB Large Pages(鎖定記憶體頁面)
於 Windows「本機安全性原則 (
secpol.msc)」->「本機原則」->「使用者權限指派」-> 將當前使用者加入 「鎖定記憶體中的頁 (Lock pages in memory)」 並重開機。- 啟用後,Strata 載入
46.84 GiBExpert Arena 時會顯示large pages (2097152 B),消除 4KB 分頁表 TLB Miss,記憶體載入速度由4.07 GiB/s提升至10.60 GiB/s!
三、 完整設定檔(可直接複製使用)
1. Strata 設定檔:
D:\Strata\strata-iq3_s.json{ "exe": "D:\\Strata\\engine-feed\\engine\\0.1.55-windows-x86_64-hip-rx9070\\strata.exe", "args": [ "--pack", "D:\\Strata-data\\packs\\iq3_s", "--native", "D:\\Strata-Models\\Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-00001-of-00002.gguf", "--ple-gguf", "D:\\Strata-Models\\Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-00002-of-00002.gguf", "--ple-io", "mmap", "--expert-profile", "D:\\Strata\\data\\expert-profile.bin", "--expert-cache", "auto", "--vram-reserve-mib", "1728", "--prefill", "auto:6144", "--prompt-cache", "12", "--prompt-cache-tail", "--prompt-cache-every", "8192", "--conversation-cache-mib", "8192", "--conversation-cache-slots", "4", "--spec", "4", "--spec-min-p", "0.65", "--mtp", "D:\\Strata-data\\mtp\\rt", "--max-context", "131072", "--kv", "int8", "--kv-resident", "32768", "--pool-workers", "12", "--pool-affinity", "auto", "--pcie-frac", "0.15" ], "cwd": "D:\\Strata", "tokenizer": "D:\\Strata-data\\packs\\iq3_s\\tokenizer", "model_name": "qwen3.8-flash-next-iq3_s", "aliases": [ "qwen3.8-flash-next", "Qwen3.8-Flash-Next", "qwen3.8-flash-next-ud-q5_k_xl", "default", "Qwen3.8-Flash", "qwen3.8-flash", "qwen3.8-flash-next-iq3_s" ], "log": "D:\\Strata\\strata-iq3_s.log", "lib_dirs": [ "D:\\Strata\\engine-feed\\engine\\0.1.55-windows-x86_64-hip-rx9070\\rocm\\bin" ], "port": 8080, "backend": "hip", "arch": "none", "engine_ready_s": 3600, "sampling": { "temperature": 0 }, "env": { "STRATA_HIPBLASLT_TUNING": "D:\\Strata\\engine-feed\\engine\\0.1.55-windows-x86_64-hip-rx9070\\tuning\\gfx1201-hipblaslt-100500.txt", "STRATA_HIP_WMMA": "1", "STRATA_SELECT_WMMA": "1", "STRATA_ENGINE_STALL_S": "180", "STRATA_WATCHDOG_IO_S": "120", "STRATA_ROUTE_TAIL_SKIP": "0", "STRATA_PF_FUSED": "1", "STRATA_GDN_CHUNKED": "1" }, "gpu": 0, "gpus_asked": true, "fit_max_tokens": true }2. 啟動指令
@echo off
cd /d D:\Strata
python D:\Strata\serve\server.py --config D:\Strata\strata-iq3_s.json
3. Hermes Agent 設定檔關鍵片段(
~/.hermes/profiles/main/config.yaml)為了釋放 Qwen 3.8 Flash 最強的邏輯推理與 Coding 能力,在 Hermes 中開啟
reasoning_effort: xhigh,並將extra_body保持乾淨({}),讓 Strata 引擎全權使用原生 GPU 圖捕捉與投機解碼:model: provider: custom:local-qwen38-flash default: Qwen3.8-Flash-Next context_length: 131072 reasoning: mode: auto effort: normal budget_mode: per_request budgets: fast: 0 normal: 1024 debug: 2048 deep: 4096 maximum: 8192 agent: max_turns: 150 gateway_timeout: 5400 tool_use_enforcement: auto reasoning_effort: xhigh custom_providers: - name: local-qwen38-flash base_url: http://127.0.0.1:8080/v1 api_key: dummy api_mode: chat_completions extra_body: {} models: Qwen3.8-Flash-Next: context_length: 120000 max_tokens: 8192 stop: - <|im_end|> - <|endoftext|>
四、 調教前後實測數據對比(Hermes Agent 真實長上下文工作負載)
以下為同一張 Radeon AI PRO R9700 32GB 在 Hermes 連續執行多輪工具呼叫(73K ~ 98K Context)下的實測數據:
測試維度 調教前 ( Engine 0.1.38+ 預設參數)調教後 ( Engine 0.1.55+ 最佳化配置)改善幅度 Expert Arena 記憶體分頁與載入速度 4KB Pages ( 4.07 GiB/s)2MB Large Pages ( 10.60 GiB/s)載入速度 +160% 短中上下文解碼速度 (< 10K tokens) 45.8 ~ 58.6 tok/s85.0 ~ 105.0+ tok/s+80% 以上 超長上下文解碼速度 (75K ~ 98K tokens) 47.0 ~ 57.0 tok/s93.8 ~ 107.6 tok/s最高 +88.7% 超長上下文增量 Prefill 速度 (83K tokens) 550 ~ 963 tok/s1,321.9 tok/s+37.2% 85K Context 投機解碼接受率 (MTP+Suffix) ~62% ~ 78%85.8% ~ 91.8%(706/769)大幅降低無效驗證 跨 PCIe 臨時讀取專家比例 偏高 ( pcie_frac: 0.55)僅 0.1% ~ 0.4%(pcie_frac: 0.15)消除 PCIe 匯流排阻塞 KV Streaming VRAM 區塊命中率 (@92K) ~95%97.65%長文幾乎零延遲
五、 真實運行日誌佐證(節錄自
strata-iq3_s.log)1. 引擎啟動與 12,244 個專家預熱(3.3 秒填滿 23.24 GiB VRAM)
strata generate: expert arena: cudaHostRegister PORTABLE ok; large pages (2097152 B)
strata generate: loaded 46.84 GiB at 10.60 GiB/s
strata generate: hybrid CPU detected (8 P-cores / 8 threads, 16 E-cores), pool workers: 12, affinity: auto
strata: Windows budgets 31707 of this card's 32624 MiB for this process
strata: STRATA_HIP_WMMA: the prompt attention on matrix cores on (gfx1201)
strata generate: expert cache 12244 slots, 23.24 GiB of VRAM; policy is PROFILE, ranked by routing frequency, no eviction.
strata generate: pre-filled 12244 of 12244 slots from the profile in 3.3 s (7641 MB/s); slot 0 verified
strata generate: R4 hit path ON - resident experts are computed on the GPU
strata generate: session is up (engine 0.1.55)
prefill gemm: hipBLASLt tuning enabled (32 rows, gfx1201, version 100500)
strata expdec: CUDA0 gate/up type 18: expdec_gu_kernel R 1 MINB 4, 64 rows per block, grid 20 x 40 (cap 40 groups), captured into a graph
strata verify: captured the 4-token window (1259 MiB of VRAM free)
2. 77K ~ 92K 超長上下文連續對話實戰(穩定 94 ~ 107.6 tok/s)
strata serve: prompt 77377 tokens = 76957 reused + 420 read in 1413 ms (297.3 tok/s), 124 generated in 1203 ms (103.1 tok/s), drafts accepted 86 of 98, 12 checkpoints
strata serve: decode expert cache hit rate: 90.4% (60065 hits / 66459 lookups); 261 more read by the GPU over PCIe (0.4% of all 66720 routed)
strata serve: KV streaming: 97.48% of 39190284 block reads hit VRAM

strata serve: prompt 83455 tokens = 77503 reused + 5952 read in 4503 ms (1321.9 tok/s), 850 generated in 8970 ms (94.8 tok/s), drafts accepted 519 of 633, 12 checkpoints
strata serve: decode expert cache hit rate: 91.3% (422357 hits / 462382 lookups); 1298 more read by the GPU over PCIe (0.3% of all 463680 routed)

strata serve: prompt 85430 tokens = 85109 reused + 321 read in 1506 ms (213.2 tok/s), 1026 generated in 9534 ms (107.6 tok/s), drafts accepted 706 of 769, 12 checkpoints
strata serve: decode expert cache hit rate: 90.7% (473213 hits / 521738 lookups); 1942 more read by the GPU over PCIe (0.4% of all 523680 routed)

strata serve: prompt 86745 tokens = 86457 reused + 288 read in 1161 ms (248.0 tok/s), 2130 generated in 21490 ms (99.1 tok/s), drafts accepted 1344 of 1566, 12 checkpoints
strata serve: decode expert cache hit rate: 92.4% (1040397 hits / 1125615 lookups); 3345 more read by the GPU over PCIe (0.3% of all 1128960 routed)
strata serve: KV streaming: 97.65% of 69316200 block reads hit VRAM
六、 同場加映:雙 R9700 玩家的「主從分離」架構(選配)
如果你的機器插了兩張 R9700 32GB,強烈建議採用 「GPU 0 專職主推論 + GPU 1 專職輔助與多模態」 的零干擾架構,避免背景壓縮任務洗掉 GPU 0 的 Prompt Cache:
- GPU 0 (
Port 8080, Strata0.1.55):跑 Qwen 3.8 Flash (UD-IQ3_S),100% 服務 Hermes 主 Agent 迴圈(reasoning_effort: xhigh)。 - GPU 1 (
Port 8081,llama-server.exeVulkan1):跑 Qwen 3.8 27B (IQ4_XS) + DFlash2 (Q8_0) + Vision (F16),專門承接 Hermes 的auxiliary.vision(圖片理解)、auxiliary.compression(長對話背景摘要壓縮)與delegation(子 Agent 委派)。- GPU 1 調教重點:關閉預設思考(
--reasoning off --reasoning-budget 0 --no-reasoning-preserve)、設定預設生成護欄(-n 4096 --temp 0.2)、啟用-ctk q8_0 -ctv q8_0 -ub 1024 --cache-reuse 256,並移除extra_body中的dry_multiplier/repeat_penalty以維持純 GPU 後端取樣,DFlash2 命中率可達85.7% ~ 95.8%,長文結構化萃取速度達76.2 ~ 78.4 tok/s!
- GPU 1 調教重點:關閉預設思考(
七、 常見踩坑與排錯總結
- 開機首次冷啟動卡在
reading the model's weights ...逾時斷線?- 原因:首次開機尚無 Windows 檔案快取時,從硬碟讀取近 50GB 權重可能超過預設啟動等待秒數。
- 解法:在
strata-iq3_s.json加入"engine_ready_s": 3600,並將--ple-io設為"mmap",只要過一次硬碟快取,後續重啟僅需 15 秒(10.60 GiB/s)。
strata-iq3_s.log出現large pages refused ... VirtualAlloc error 1314?- 原因:Windows 預設未授予帳戶
SeLockMemoryPrivilege權限。 - 解法:至
secpol.msc->「鎖定記憶體中的頁」加入使用者帳戶並重登/重開機,即可啟用 2MB Large Pages。
- 原因:Windows 預設未授予帳戶
- 為什麼不建議在
config.yaml對本地模型加dry_multiplier或repeat_penalty?- 原因:Qwen 3.8 詞表高達
248,320,一旦啟用 CPU 端的 DRY / Repeat Penalty,每步驗證 4 個草稿 Token 都必須把將近4 MB的 Logits 從顯存搬回 CPU 掃描並改寫機率分佈,不僅迫使 GPU Backend Sampling 失效,還會讓投機解碼接受率大跌 10% 以上。保持extra_body: {}搭配低溫取樣效果最好、速度最快!
- 原因:Qwen 3.8 詞表高達
- 85K~98K 超長上下文解碼速度:由舊版
-
-
这个年代100k 还算是超长上下文吗?
-
-
-
你这个prefill速度不对劲,怎么只有1300tok/s,建议把--prefill 从 auto:6144 改成 auto:32768,32k以上输入情况下,prefill速度能提升到2600tok/s,32k以下输入也能保持2000tok/s。如果再把引擎升级到0.1.56(默认起草器从mtp变成了dflash2),prefill可以进一步提升到3000tok/s。
-
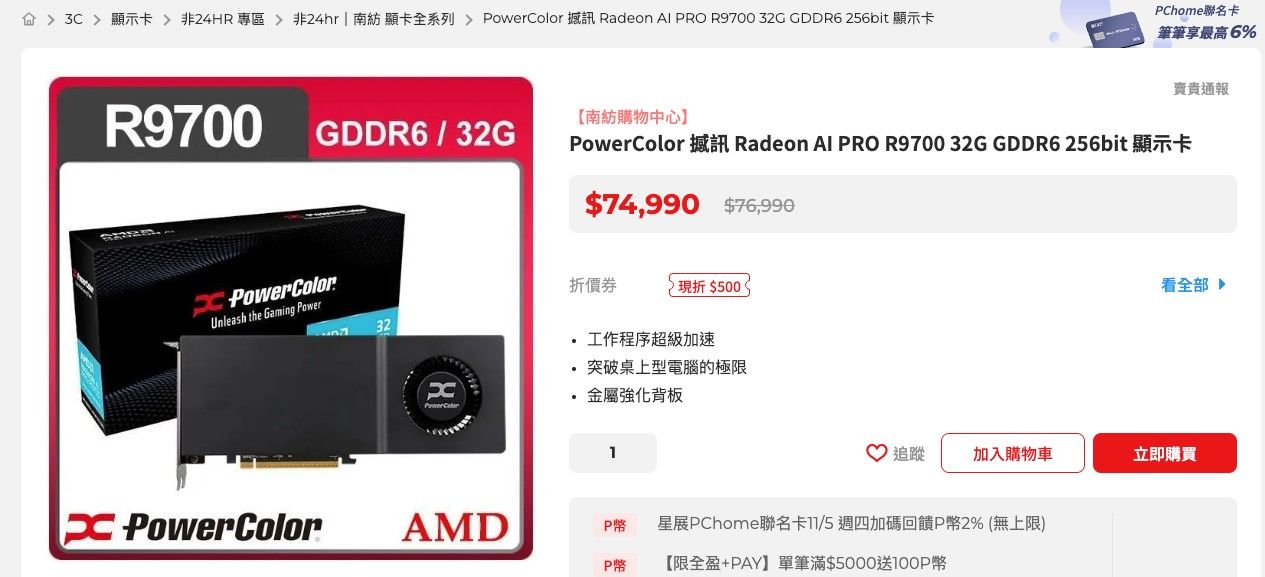
R9700真貴阿...今天pchome看到powercolor這張,75000都要吐血了
我前兩周買單張也才61000而已
話說你可以試試radiance,他對單張R9700的調校也很不錯
我這邊機器是w1370p + ddr4 96g (32x2 + 16x2) 2666 + R9700
跑iq4r精度, 256K上下文開滿,KV fp8可以優化到prefill 3500, decode 75左右
系統記憶體常駐64g左右
而且有多路併發decode需求,radiance因繼承vllm架構平行效果明顯較好 -
R9700真貴阿...今天pchome看到powercolor這張,75000都要吐血了
我前兩周買單張也才61000而已
話說你可以試試radiance,他對單張R9700的調校也很不錯
我這邊機器是w1370p + ddr4 96g (32x2 + 16x2) 2666 + R9700
跑iq4r精度, 256K上下文開滿,KV fp8可以優化到prefill 3500, decode 75左右
系統記憶體常駐64g左右
而且有多路併發decode需求,radiance因繼承vllm架構平行效果明顯較好 -
-
-
@game-game 有可能憾訊的散熱用料比較好吧...
但不管是69990還是74900,根據之前的經驗估計過2天就消失囉QQ -
R9700真貴阿...今天pchome看到powercolor這張,75000都要吐血了
我前兩周買單張也才61000而已
話說你可以試試radiance,他對單張R9700的調校也很不錯
我這邊機器是w1370p + ddr4 96g (32x2 + 16x2) 2666 + R9700
跑iq4r精度, 256K上下文開滿,KV fp8可以優化到prefill 3500, decode 75左右
系統記憶體常駐64g左右
而且有多路併發decode需求,radiance因繼承vllm架構平行效果明顯較好 -
-
-
-

 。




 本帖参与讨论人数已达 10+,入选热议,作者 +3 积分奖励!

 版主审定:本帖设为优秀,作者 +3 积分奖励,继续加油!