
双7900 XTX Strata优化补测:每路128K,单路116.5 t/s、双路合计161.1 t/s,已提PR
-
继续补一下双7900 XTX的测试。这次想解决的问题是:双路MTP能做到合计160 token/s左右,但只剩一个请求时只有70多,能不能把之前100多的单路速度也保留下来?
目前在自己的机器上做到了自动切换:同一个模型进程、同一个API,一个请求走单流窗口流水;第二个请求到来时迁入并发MTP;剩一路时再切回来。
正式入口验收:单路三次平均116.48 token/s,双路持续合计161.08 token/s。每路最大上下文仍为131072,16 GiB内存会话缓存预算和GPU识图保留。
先说明边界:这是基于旧版RDNA3引擎自行修改、编译的实验方案,不等于官方最新版已经有这个成绩。主线移植已提交草稿PR,下面分别写清楚。
1. 测试环境与计时口径
项目 设置 两张显卡 蓝宝石 RX 7900 XTX 24G白金版 + 蓝宝石 RX 7900 XTX 24G BLOWER涡轮 功率策略 白金303W、涡轮231W上限,自动风扇;本轮各档保持一致 系统 Ubuntu 26.04.1 LTS,内核7.0.0-38-generic,gfx1100 / 现有ROCm 10环境 CPU / 内存 Intel工程样品,系统识别20个逻辑CPU;可用总内存约61.5 GiB 模型 Qwen3.8-Flash-Next GSQ-RCO IQ3_XXS 引擎 自定义0.1.43基础RDNA3版,已包含DIRECT槽位复制及从上游移植的分组流水MTP 双卡分配 26/22层分配,int8 KV,KV resident 32768 上下文 / 并发 每路上限131072,HTTP活跃请求最多2个;内部4槽、2组,不等于4路同时生成 MTP spec 3,min-p 0.5,最多2个草稿token 内存缓存 会话缓存预算16384 MiB 测速用的是接近128K的固定输入:代表性请求130037个输入token,每路输出512个token;热请求中130030个输入token复用缓存。
所以本文测的是长上下文缓存命中后的生成速度,不是重新读取完整128K长文的prefill速度。
- 单路端到端速度:输出token / 请求批次墙钟时间,包含首字等待;多次测试取各次速度的算术平均。
- 双路持续吞吐:两路反复同时生成,整段总输出token / 整段墙钟时间,包含请求间恢复等开销。
- 表里的“双路”全部是两路合计,不是每路160。
2. 对照结果
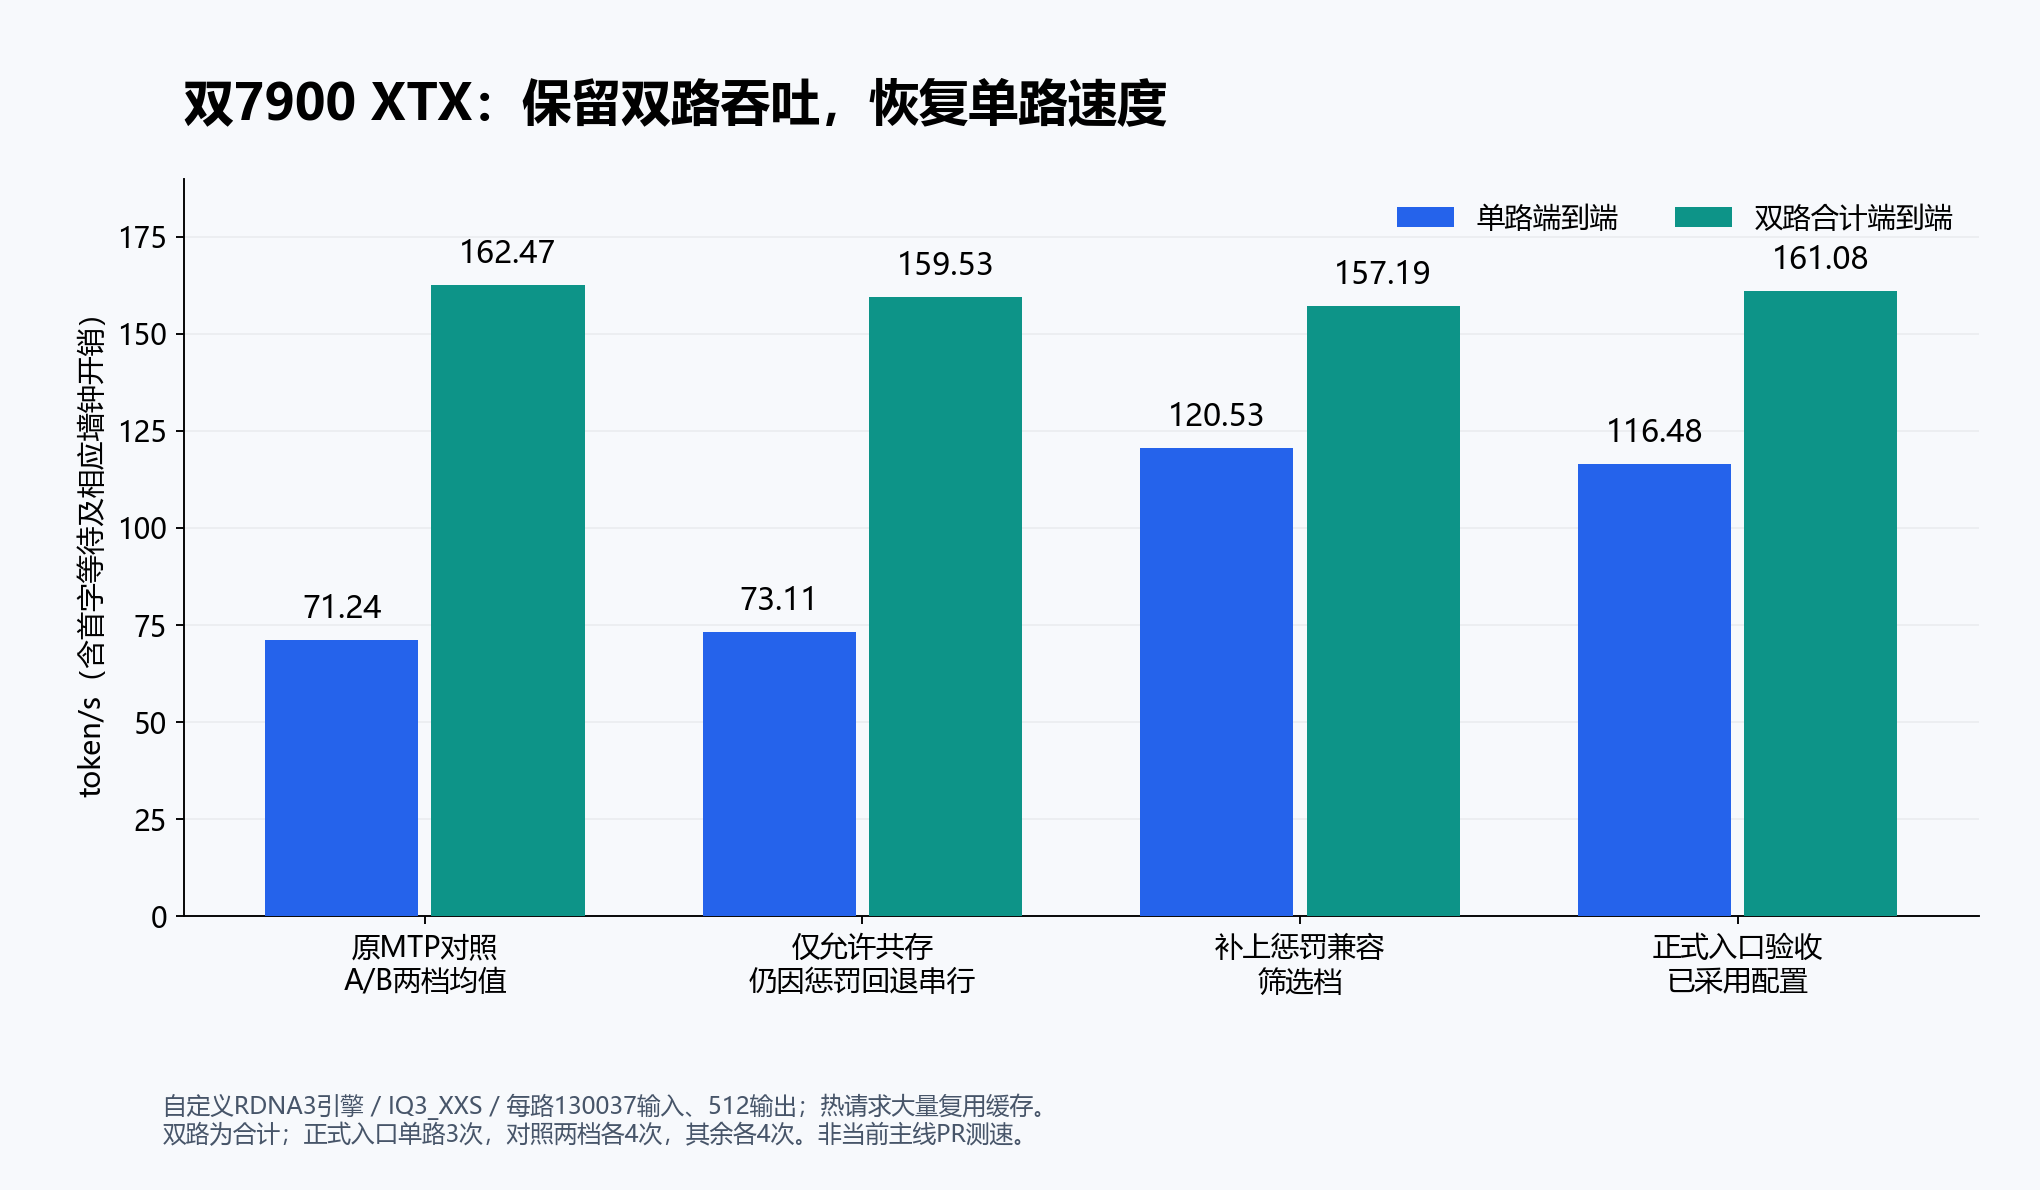
档位 单路端到端 t/s 双路合计端到端 t/s 双路持续时间 说明 原MTP对照A 70.94 161.68 95.00秒 功能检查通过 新二进制,新增开关关闭 72.61 159.79 96.13秒 功能检查通过 只允许单流流水与batch共存 73.11 159.53 96.28秒 有惩罚参数时,单路仍然回退串行 原MTP对照B 71.53 163.27 94.08秒 功能检查通过 补上惩罚兼容,筛选档 120.53 157.19 91.20秒 功能检查通过,逐字一致性诊断无结论 同一补丁,长测确认档 130.01 159.27 604.34秒,94批 速度长测完成;后面的短答长度断言失败,整套case仍记失败 同一二进制补充功能验收 128.59 159.98 32.00秒 切换、历史、取消、排队、识图通过 正式入口验收 116.48 161.08 184.35秒,29批 正式接入后的功能检查通过 正式入口三次单路分别是 106.97 / 119.98 / 122.50 t/s。不同轮次首字等待、缓存恢复和草稿接受情况有波动,因此用116.48作为这次正式验收结果,不拿实验过程中最高的一次当日用保证值。
这轮主要成果是:双路维持160级吞吐,把单路从约71恢复到约116–120,而且可以在同一服务里自动切换。 不应说成“双路也获得了和单路一样幅度的提升”。
3. 为什么只开共存还不够?
查源码发现有两个独立限制。
第一,HTTP服务本来就有GEN → STOP/DONE → BGEN以及回到GEN的迁移逻辑,但引擎会因为配置了batch槽位而关闭单流的pipeline windows。实验版先给一组受限配置放行,让两套资源能够共存,并在批量请求准入时禁用单流流水,避免共享校验资源冲突。
第二,这还不够。非思考请求会继承模型卡的
presence_penalty=1.5,引擎看到需要历史惩罚,就把这个请求送回串行循环。只改共存开关,实际单路仍然只有73左右。第二版没有把惩罚改成0,而是在最终GPU阶段启动当前窗口前,用已经接受的历史和当前窗口token构造逐行惩罚历史,继续使用原采样器。未确认的下一窗口不会进入最终采样阶段;拒绝的草稿也不会加入下一窗口的已接受前缀。同时校验历史长度和窗口位置,复制失败或位置不匹配就报错退出。
完成这一步后,保留默认presence penalty时才能实际进入单流流水路径。
自定义实测版使用的相关组合如下,仅适用于包含相应补丁的引擎,不能当作官方版通用启动参数直接照抄:
--pipeline-windows 2
--batch 4
--batch-groups 2
--spec 3
--spec-min-p 0.5

STRATA_BATCH_MTP=1
STRATA_PIPED_MTP=2
STRATA_HYBRID_WINDOWS=1
STRATA_HYBRID_PENALTIES=1
这里只列相关组合;模型路径、其他运行参数和补丁依赖见归档,不是一份完整启动命令。
4. 单路120,为什么双路不是240?
这里“单路”是一个请求,已经使用两张7900 XTX共同推理,不是一张卡120、另一张闲着。
两个请求同时运行,仍然共享两张卡的计算、显存带宽、跨卡传输和草稿校验资源。当前从单路约120到双路合计约160,是合计吞吐提高约三分之一;两路平均约80,实际各路不一定完全相等。
如果是两张卡各自独立运行同一个模型、每张都能达到120,才有理由期待合计接近240。本文是模型跨两卡分配,不能这样相加。
不过,目前也没有证据证明160就是这套双卡的极限。这个结果只能说明本配置、本模型和本组工作负载下的表现。
5. 温度与功能检查
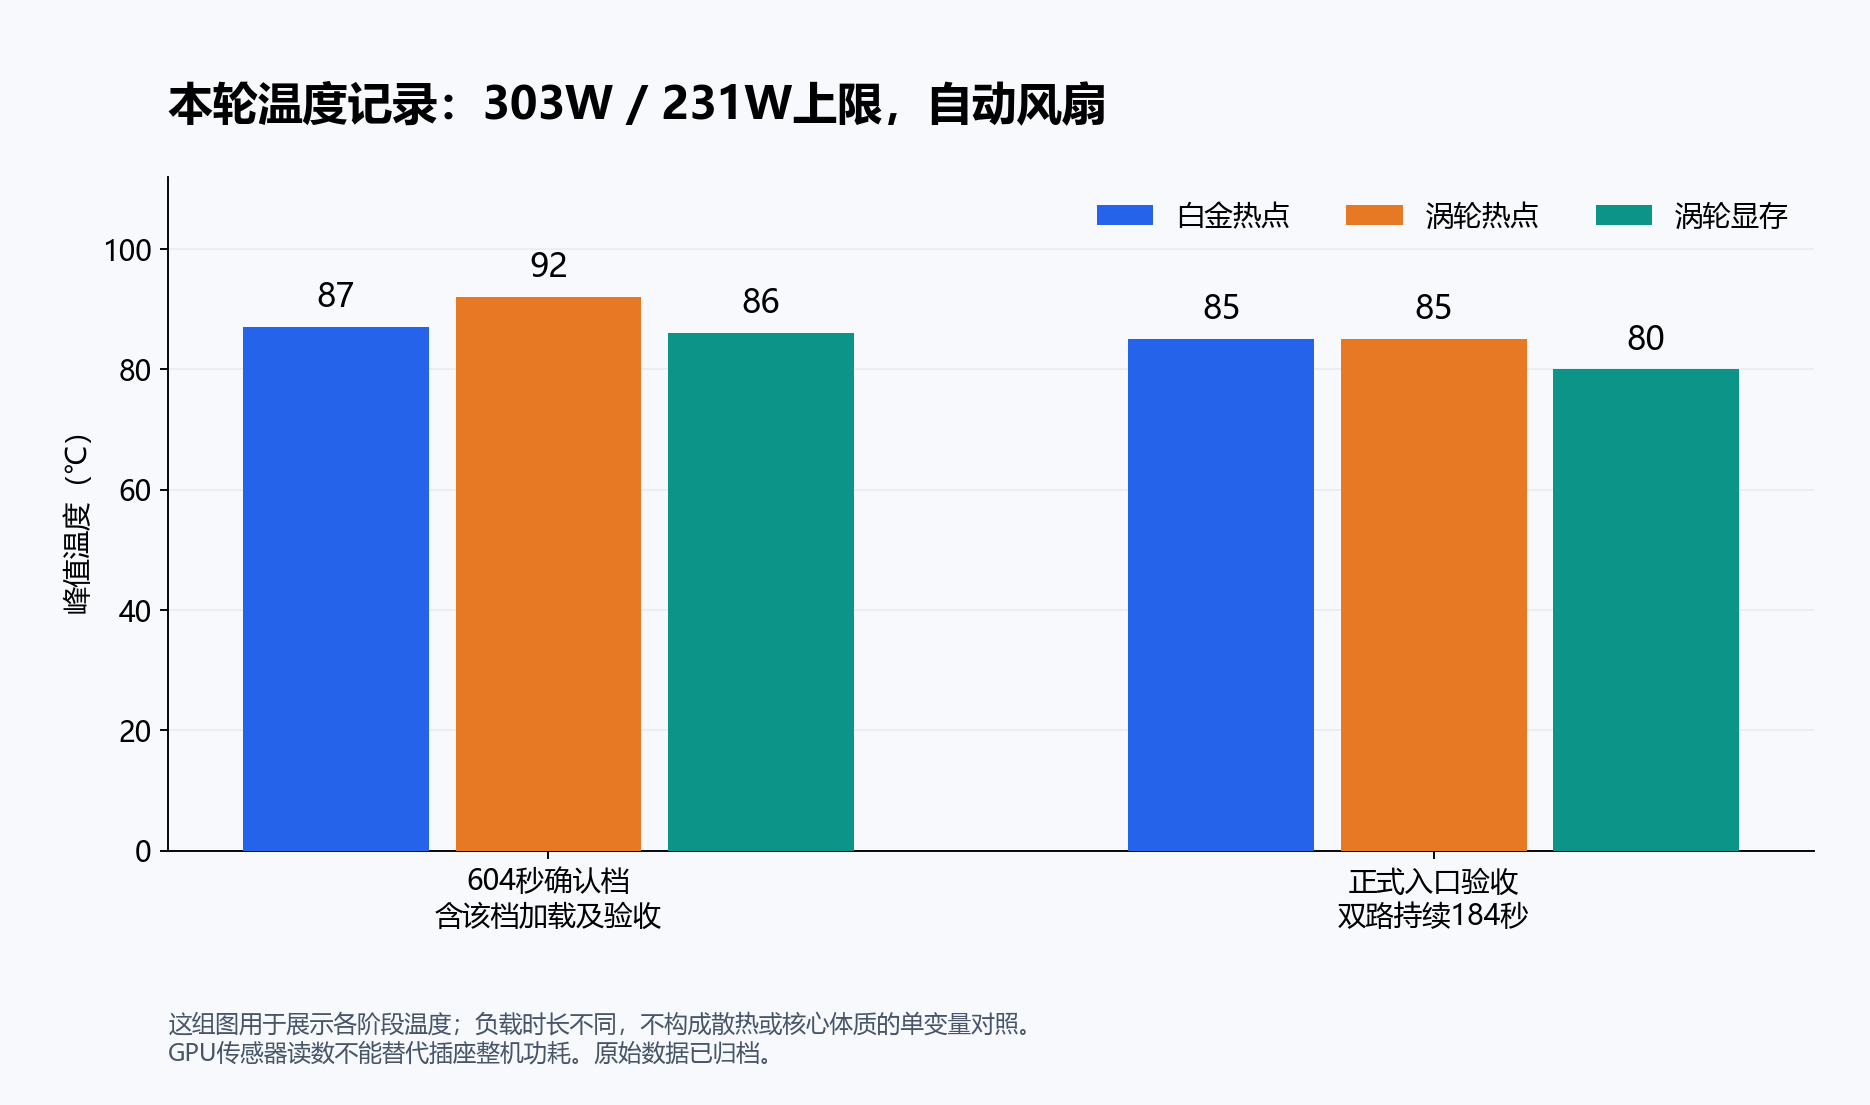
阶段 白金热点峰值 涡轮热点峰值 涡轮显存峰值 最低可用内存 604秒确认档,包含该档加载及验收 87℃ 92℃ 86℃ 17.38 GiB 正式入口验收 85℃ 85℃ 80℃ 13.13 GiB 本轮没有新增amdgpu fault/reset/timeout,测试后两张卡利用率回到0。GPU传感器功率读数不等于插座整机功耗;这次没有用它推算整机功耗。
自定义版检查了:128K单路与双路、三次生成中途1→2→1切换、64K历史增长和分支、取消后恢复、第三路排队、GPU识图、中文输出。另外以temperature 0.7、presence penalty 1.5抽查两路中文生成,标记检查通过。
这些说明功能路径和基本请求隔离检查通过,不是模型质量基准测试,也没有证明所有提示词都与原串行路径逐字一致。这轮功率上限也不同于双卡均默认功率的测试,不能据此比较两张卡的核心体质。
6. 失败记录与限制
强惩罚数字列表探针的两次串行参考本身就不相同,流水输出也不同,所以严格逐字一致性没有得到证明。604秒速度长测已经完成,但随后一个串行参考自然短答触发了测试脚本的长度断言;整套case仍保留失败状态,后续才对同一二进制补跑实际功能验收。
更早还有输出长度超过128K边界而主动停止、测试目录写权限、batch接口不支持
logit_bias返回400、自然EOS触发不合理长度断言等失败。第一次正式接入的验收脚本也出现初始化错误并自动回退;修正脚本后的第二次接入才成功。不能把这些失败省略后说“全程一次通过”。上述记录保留在本地,公开归档包含相应说明和数值结果。原引擎、配置及回退办法也已保留。
7. GitHub代码与数据
主线草稿PR:Strata #4909:为双阶段流水传递逐窗口惩罚历史。
上游已有#3095处理单流流水与batch共存,另有#2940讨论模型卡惩罚导致串行回退。因此这次提交聚焦新增的惩罚历史处理,没有再提一份重复的共存方案。
主线移植使用默认关闭的
STRATA_PIPELINE_PENALTIES=1,目前CUDA/HIP头文件配置下的改动文件主机编译、两项相关主机测试通过;尚未完成该主线移植版的完整引擎构建、GPU执行与默认路径逐字一致性验证,所以仍是草稿PR。本文速度不能套到这个新PR版本上。公开实测归档:对照表、305份数值请求记录、日志摘录、设置、补丁和SHA256。
上述链接是历史数值归档;完整源码、依赖锁和独立构建方法已在下面新增的完整实验分支中公开。模型权重和编译二进制不随源码分发。
此前的显卡对比讨论:蓝宝石7900 XTX BLOWER与白金版。这次是软件方案的补测,不把框架/调度表现概括成“双卡普遍无收益”或某张卡的硬件结论。
8. 补充:完整代码已公开,可以独立构建
之前的#4909只是主线惩罚历史移植PR,单独下载它不能得到本文完整方案。现在已将实际使用的RDNA3引擎、DIRECT/锁页复制、双流流水MTP、单/双流共存、惩罚历史处理和完整HTTP服务放到自己的仓库,不用再手工拼#4909或#3095。
固定提交:
3eb5752b18c30e633e144511d919b95bd64e1959。包含依赖版本及SHA256、从零编译脚本、模型/MTP准备步骤、两路各128K配置生成器、公开合成输入和测速脚本。主模型、MTP和mmproj权重按说明另下;可选识图reader使用固定官方组件,来源与哈希单独列明。按中文说明构建,不要运行setup.sh自动下载另一版引擎。为确认源码能跑,本次完整重编了主引擎及HIP内核,没有复用旧对象或静态库。调度、行边界测试及两张卡各5053项逐字节复制检查通过;配置生成器输出的引擎参数和环境开关也与实测配置核对一致。
本次同日对照 单请求三次均值 双请求合计吞吐 双请求测量时长 原部署二进制 122.68 t/s 156.43 t/s 32.73秒,5批 完整源码重建 113.29 t/s 158.09 t/s 123.07秒,19批 两者均用公开的130020token合成输入,每请求输出512token,统计缓存命中后的端到端速度,包含首字等待;双路数字是两路合计。历史正文116.48/161.08那轮多了固定实验前缀,输入130037token,因此保留为历史结果,不冒充本轮相同输入对照。
双路重建结果接近,单路仍有差异;本轮次数有限、双路持续时间不同,不据此断言重建使性能变快或变慢,也不保证换机器必然达到相同数字。验证范围是本机Linux、两张7900XTX、既有ROCm 10开发环境;其他后端未验证。该分支仍是实验版,质量与逐字一致性限制沿用正文说明。
重建测试后已恢复原正式服务,原配置、功耗上限与风扇策略均未改动。群友建议用独立目录和配置尝试,保留原部署便于回退。
9. 补充:同模型单路、双路与独立双副本的实测
看了评论,确实要区分两个问题:①一个模型跨两张卡,分别接1个/2个请求;②两张卡各跑一份模型,同时各接1个请求。下面整理已有实测,本次没有重跑GPU测试。
一个跨卡模型的单/双请求: 同一IQ3_XXS、26/22层,白金303W/涡轮231W;每路上限131072,实际输入130020token、输出512token,统计缓存命中后的端到端速度,包含首字等待。单请求用route0;双请求同时用route0和route1这两份固定合成文档。
同轮版本 单请求均值 双路请求0均值 双路请求1均值 双路合计持续 合计吞吐相对单路 原部署二进制 122.68 t/s 79.06 t/s 79.84 t/s 156.43 t/s +27.5% 完整源码重建 113.29 t/s 80.73 t/s 80.06 t/s 158.09 t/s +39.5% 单请求各测3次;原部署版双路32.73秒5批,重建版双路123.07秒19批。每路是各请求自己的端到端速度均值;合计是整段总输出/整段墙钟,含慢路等待及批次间开销,所以不能简单把每路均值相加。请求0/1也不对应某一张显卡。两行持续时间不同,不能用来证明哪个二进制更快。
换句话说:这里单请求已经使用两张卡;变成双请求后,每路约80、总吞吐约156–158,吞吐增加,但单个请求完成速度下降。它不是“一张卡120,所以两张应该240”。历史正文116.48/161.08属于另一轮130037token输入。
两卡各跑一个独立副本:也有本机历史数据,尚非当前版本的同日同参架构A/B。 10月30日的replica-pin12-q6使用同一IQ3_XXS、共享约39.97GiB专家arena、每卡solo MTP、每路128K,实际输入130041token,各输出512token。
历史独立双副本指标 实测 持续双路批次 23批,批次墙钟之和179.96秒 各批合计吞吐中位数 132.87 t/s 总输出/各批墙钟之和 130.88 t/s 路0/路1端到端速度中位数 86.96 / 66.49 t/s 候选阶段最低可用主存 4.27 GiB 130.88不含批次间控制器间隔,不等于本帖整段持续吞吐;132.87是批次中位数。那轮涡轮257W、队列6、每引擎arena锁页上限12GiB、各4GiB会话缓存,当前则是涡轮231W等另一组设置,二进制与输入前缀也不同,不能拿132.87和161.08直接除算成架构加速比。以上是64GB主机记录,没有128GB实机成绩。
因此,现有记录能回答当前单/双请求的变化,也能证明独立双副本跑通过;对评论中“128GB+双XTX,独立副本还是跨卡更划算”,仍缺同日、同权重/输入/采样/功耗的完整架构A/B,不能提前下结论。
完整对照说明;逐批数值与输入/原文件SHA256。历史独立副本23批已公开数值字段,未公开对话正文或私有路径。标记通过不代表全面模型质量评测。
-
-
-
我先跑跑看,
这个切入点还真是个痛点,视角犀利,good job
-
-
我先跑跑看,
这个切入点还真是个痛点,视角犀利,good job@xiongjie-gao https://github.com/cennac/Strata/tree/community/dual-7900xtx-repro-20261101 完整代码,原分支不支持双卡开MTP,这次一个是开双卡mtp,后开单卡mtp

 版主审定:本帖设为精华,作者 +6 积分奖励,希望再接再厉!


