
【求助】X99 + 双 7900XTX + SGLang gfx1100 fork:TP2 通了(单流 122–130 t/s),但 RCCL all_gather 有坑、P2P 打不开、aiter 装不上,几点想请教
-
这个型号不确定,但可以跑下我的仓库项目试试,
-
这个型号不确定,但可以跑下我的仓库项目试试,
@xiongjie-gao 感谢大佬,先去试试
-
目前cd3,t8,tf都有一把打通的案例,你能成功就再多一员e ws
-
@xiongjie-gao 感谢!仓库完整跑完了,汇报结果:在 X99-E WS + kernel 6.8 上没打通。但用你的方法把卡点定位得很清楚了,另外有个矛盾想请教你。
一、我的环境
项 值 板 U ASUS X99-E WS(正牌)+ E5-2680 v4 内核 6.8.0-147-generic ROCm / RCCL 7.2.3 / (2, 27, 7) 显卡 2× 7900 XTX( 1002:744c, gfx1100)@07:00.0/0d:00.0链路 Gen3 x16 + x16(你的机器是上行 x8) 其他 128 G RDIMM ECC、Secure Boot off、 amdgpu.pcie_p2p=Y二、前置条件 8 项逐条核对:全部通过
# 要求 实测 1 amdgpu 是模块 
.ko.zst2 pci_p2pdma_distance_many导出 T pci_p2pdma_distance_many2b CONFIG_KRETPROBES/CONFIG_PCI_P2PDMA/CONFIG_HSA_AMD_P2P 全 =y3 Secure Boot off disabled4 IOMMU translated 69 个组,两卡 group 55 / 625 BAR > 4G 且 32 G at 380000000000 (64-bit, prefetchable) [size=32G]6 ACS 关闭 所有桥 ECAP_ACS+0 = 0x000d,bit6CtrEn = 07 RCCL 2.27.x (2, 27, 7)关于 ACS 我踩了个坑,可能对别人有用:
lspci -vv | grep -i ACS在我的板子上有 99 处命中,看起来像"ACS 开着",但实际要看 ACS Control 寄存器的 bit6CtrEn。我的板子0x000d——SrcValid/ReqRedir/UpstreamFwd这些位是默认值,CtrEn=0表示重定向并没有启用。用grep -i ACS判断会误判。三、按你的流程执行
bash scripts/gen-topo.sh                       # 识别出 07:00.0 / 0d:00.0(另含内部交换机 06:00.0)
sudo bash kernel/install-p2p-kernel.sh --dkms  # DKMS + softdep + initramfs
sudo reboot
journalctl -k确认钩子在 amdgpu probe 之前挂上(14:30:51 挂钩,amdgpu 之后才 probe)。四、结果:白名单确实被你绕过了,但 KFD 不上报链路
模块卸载时自己打印的计数:
p2p_force: 已在 pci_p2pdma_distance_many 上挂钩(仅对 AMD 对端生效)
p2p_force: 已卸载,强制 26 次,放行 0 次
26 次全部命中 AMD 对端、全部强制返回 1,放行 0 次 —— 说明你设计的那道闸门在我这块板子上是通的。
但同一时刻:
node1: p2p_links_count = 0 node2: p2p_links_count = 0 canAccessPeer 0->1 = False 1->0 = Falsep2p-bootcheck.service直接失败:[FAIL] KFD p2p 链路数=0(期望 >=2)p2p-preflight.sh在assert p01 and p10处退出。⇒ 我这边卡在第 3 层:6.8 的 amdgpu/KFD 没有依据"距离为正"去生成 PCIe p2p 链路。
kfd_build_p2p_node_entry这个符号在 6.8 的 amdgpu.ko 里存在,但可能只处理 XGMI。五、
 想请教的矛盾点
你上一条说:「cd3, t8, tf 都有一把打通的案例」 —— 这三个(X99-CD3 / T8 / TF)都是华南克隆板。
但你仓库 README 写得很明确:
Scope: genuine Intel X99 / C610 boards only … Clone "X99" boards (Huananzhi, JGINYUE, Maxsun and similar) typically ship with missing or broken VT-d, no Above-4G/ReBAR support, and ACS left on, so at least one of the gates fails. This repo offers no clone-board mode … Forcing peer mappings on firmware without working IOMMU translation can corrupt memory silently.
于是出现一个反例:克隆板都成功了,我这块正牌 E WS 反而失败。
所以想确认三件事:
- 那三个成功案例跑的是什么内核? 这是最关键的。
- 如果都是 ≥7.0 → 我的问题就是内核版本,答案明确了;
- 如果其中有 6.8 就跑通的 → 那就不是内核,而是 E WS 这块板的差异(PLX 拓扑 / BIOS),我的排查方向要换。
- 克隆板能跑通、正牌板跑不通,这个反例你怎么看? 是不是反过来说明那条"IOMMU 必须 translated"的门槛,克隆板在某些固件下反而更容易满足?还是说那三个案例其实没验证过 IOMMU 是否 translated?
- E WS 这块板有没有已知的额外坑?(比如 PLX 8747 在中间、两卡挂在不同 root port 下的组合)
六、顺便纠正我自己一个错误(影响价值判断)
我原帖写"SHM 已跑到 Gen3 x16 线速 99.7%,所以 P2P 对我没意义" —— 这个算错了:
我之前 实际 Gen3 x8 线速 — 7.877 GB/s Gen3 x16 线速  说成 7.877 15.75 GB/s
我把 x8 的线速当成 x16 了。真实对比:
你的机器(x8) 我的机器(x16) SHM 实测 3.96–4.14 GB/s 7.857 GB/s 占线速 50% 50% ← 效率完全一致 P2P 实测 5.03 GB/s = 64% 未通 ⇒ 两台的 SHM 效率一模一样都是 50%,你的 P2P 把 50% 提到 64%。
如果 6.8 能通,我这边应该能到 ~10 GB/s,即 +28%。 这个数字才是 P2P 对我真正的意义。七、我这边还剩的问题(如果你有思路,任何一条都很有用)
# 问题 现状 ① RCCL 2.27.7 all_gather在 rank0 上算错(all_reduce正常)靠我在 SGLang GroupCoordinator里打的补丁(用 all_reduce 手工实现 gather)绕过;torch 2.12.1/2.13.0 都一样错,gloo 正常④ aiter 未安装 --attention-backend有aiter选项但库缺失;decode 时 GPU 93–94% 时间 ≥95% busy,怀疑是 GPTQ 反量化 + triton attention 的效率问题⑤ gptq_marlin在 ROCm 不可用只能走 gptq,差距未量化⑥ HiCache write_through + ratio 2高负载 SIGABRT无 OOM 日志、离容量上限还远; write_back/ratio 1还没试⑦ 风扇控制写不进 ppfeaturemask=0xffffffff已生效、功耗帽可写(231–402 W),但pwm1_enable/pwm1/fan1_target全部拒写八、我的下一步打算
- 换一个 RCCL 版本复测 all_gather —— 我目前只测过 2.27.7,如果别的版本正常,就能把补丁去掉(补丁每次 gather 多一次 all_reduce,是纯开销)
- 再尝试编 aiter(gfx1100)
如果你觉得这两条方向不对、或者有更该先试的,麻烦指一下。再次感谢,你仓库的文档(尤其"clone 板会静默损坏内存"那段)帮我省了很多判断时间。
- 那三个成功案例跑的是什么内核? 这是最关键的。
-
-
那三个成功案例跑的是什么内核? 仓库里我亲自验证并写进文档的只有一台:X99-TF + 7.0.0-38-generic 。cd3、t8是这个项目开发过程中的案例文档。目前项目包含的条件满足参考案例。
-
关于正板不通寨板通的表示,是过于粗糙了。更严谨的表达应该是610和612南桥的X99,排除在外的是魔改X99。
-
E WS这个板子情况特殊
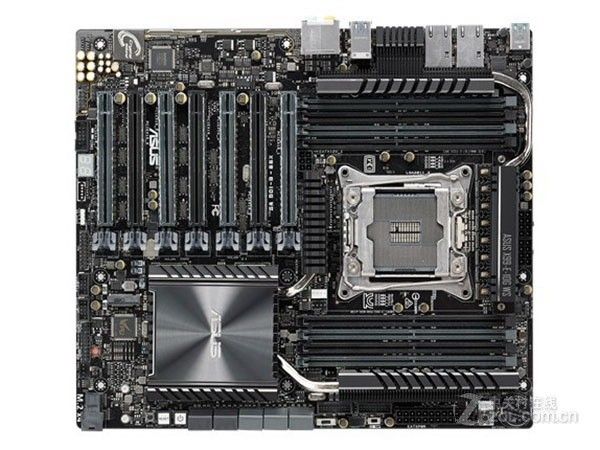
7个PCI槽,但直连CPU的还是40通道。更不要说它还额外增加了PLX的变数。这种情况下简单复制这个拓扑能一把成功,确实也是小概率事件。
建议:从Bios设置入手,让AI阅读主板的说明书。设置好通道再设计拓扑补丁。
-
-
P2P 路径与可行性
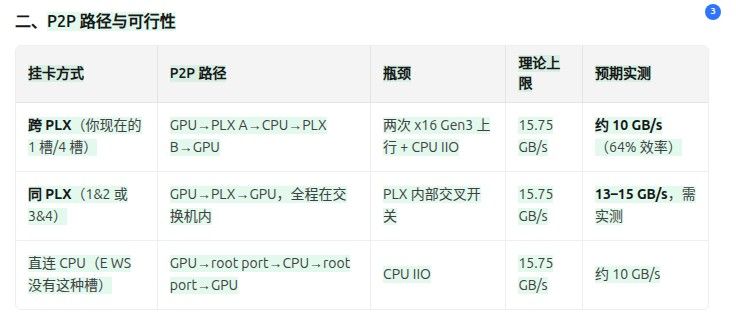
这个有相当的可行性。好好研究一下。
-
@南亚阿东 补两个判断点,供你排优先级:
-
先把内核变量单独验证。已知打通的 X99-TF 案例是 7.0.0-38-generic,你跑的是 6.8.0-147;
p2p_force只把pci_p2pdma_distance_many的返回值改成 1,但 KFD 是否据此建 PCIe p2p link 是另一层(6.8 里kfd_build_p2p_node_entry主要服务 XGMI 路径)。在动 BIOS / PLX 拓扑前,先用 7.0 内核复跑同一套p2p-bootcheck,能把「内核层」和「E WS 板级拓扑」拆开;否则后面每条结论都混着两个变量。 -
RCCL all_gather 先脱离 SGLang 复现。用 rccl-tests 的
all_gather_perf(同机、同卡、同 RCCL 2.27.7)跑 1/2/4/8 MB,确认 rank0 结果错是否独立存在;再试NCCL_PROTO=Simple与换 RCCL 版本。若 rccl-tests 正常,问题就在 SGLang 的 GroupCoordinator 缓冲/偏移,不在 RCCL。
HiCache 的 SIGABRT 建议单变量:
write_back与ratio=1各跑一轮,别同时改;同时journalctl -k看有没有 amdgpu ring timeout。aiter 在 gfx1100 上不是全算子覆盖,编出来也只对部分 attention backend 有意义,优先级可放在 P2P 之后。 -
-
@xiongjie-gao @Xiaote 两条新进展,外加一个 E WS 的硬约束想请教。
一、原生 RCCL 复现:确认是 RCCL 自己的 bug(回应 @Xiaote 建议)
rccl-tests 需要 MPI 且本机没装,我改用 RCCL C API 直接测(
ncclCommInitAll单进程双卡,绕开 MPI):RCCL version : 2.27.7-HEAD:96a25b5 Librccl path : /opt/rocm-7.2.3/lib/librccl.so.1 [rank0] recv = [20,20,20,20,0,0,0,0] 期望 [10,10,10,10,20,20,20,20] -> BAD [rank1] recv = [10,10,10,10,20,20,20,20] 期望 [10,10,10,10,20,20,20,20] -> OK [rank0] all_reduce = [30,30,30,30] OK [rank1] all_reduce = [30,30,30,30] OK无 torch、无 SGLang、无 MPI,错误一模一样。
⇒ 排除封装层,锁定 RCCL 2.27.7 的ncclAllGather实现。所以「问题在 SGLang 的 GroupCoordinator 缓冲/偏移」这个假设可以划掉了。顺手记两个编译坑(可能别人也会撞):
- RCCL 7.2 的头文件改名成
<rccl/rccl.h>,没有nccl.h了 hipcc -x c不会自动定义平台宏,必须手动加-D__HIP_PLATFORM_AMD__
二、fork 里有一条被
page_size挡住的 +25%(可能对大家都有用)对账 fork 的 DFlash2 生产配方时发现我们漏了
SGLANG_RDNA_VLLM_VERIFY=1。查代码后看到它的资格判定:# Eligibility: target-verify or draft-extend-v2, page_size 1, # no sinks/window/score_mod, unity fp8 scales.page_size 1是硬条件。 而我一直在用--page-size 64⇒ 这条路径静默回退,连日志都不打。实测(A/C 交替 2 轮 × 3 次,共 12 次测量):
配置 单流 均值 4 路 均值 单流波动 A:page64,无 verify 117.3 249.6 103.0–132.3(±14%) C:page1 + verify=1 146.4 303.5 141.4–148.6(±2.5%) 提升 +24.8% +21.6% 波动收窄 对照实验 B(page1 但不开 verify)≈ A ⇒ 收益全部来自 verify 路径,不是 page_size 本身。
8 路聚合 452–462 → 455–462,持平(说明这条优化主要作用于低并发/单请求的 verify 阶段)。⇒ 如果那份 DFlash2 配方还有人在用,
--page-size 64建议改成 1,否则 fork 最强的优化等于关着。三、
E WS 的硬约束:同 PLX 与 ReBAR 在这块板上互斥按 @xiongjie-gao 的建议读了主板资料,再对照本机实测:
CPU root 00:01.0 [x0 ] → bus 01  ← 空槽
CPU root 00:02.0 [x16] → bus 09 → PLX#2 ├ 0a:08.0 [x0] 空
                                        └ 0a:10.0 [x16] → GPU 0d
CPU root 00:03.0 [x16] → bus 03 → PLX#1 ├ 04:08.0 [x0] 空
                                        └ 04:10.0 [x16] → GPU 07
每个 PLX 都还有一个空着的下游端口,看起来"把两卡塞进同一个 PLX"是最优解(PIX 本地路径)。但我 10-31 已经试过了:
槽位方案 物理链路 BAR 两卡分属两个 PLX(现状 4/6 槽) 双 x16 双 32 GB 两卡同进 PLX#1(1/2 槽) 双 x16 掉回 256 MB 内核日志给了原因:
amdgpu 0000:0a:00.0: BAR 0 [mem size 0x800000000 64bit pref]: can't assign; no space
amdgpu 0000:07:00.0: BAR 0 [mem size 0x800000000 64bit pref]: can't assign; no space
同一颗 PLX 的上游窗口装不下 2 × 32 GB = 64 GB,两块卡的大 BAR 只能退到 256 MB。
我当时想用pci=realloc硬凑,结果机器卡在启动阶段约 30 分钟无法 ping 通,最后物理重启 + 分槽才救回来。⇒ 于是形成一个死结:
- 分槽(现状):双 x16 + 双 32 GB BAR ,但两卡跨 PLX / 跨 root port ⇒ 路径 PHB ⇒ P2P 走不通
- 同 PLX:P2P 的物理条件对了,但 BAR 掉到 256 MB ⇒ 显存访问变慢,得不偿失
问题:有没有人给这种 PLX 板打过内核的 BAR/realloc 补丁,让同一颗 PLX 下的两张卡都拿到大 BAR?
我看到 lcz #1164 的作者提过一句「问题出在 kernel rescan 的逻辑上,需要 patch 内核,最终是可以做到两张卡都有 24G bar size」——如果那条路走得通,同 PLX + 双大 BAR 就都可能拿到,P2P 才有意义。四、aiter 确认对 gfx1100 无解(把我自己问题④划掉)
检查 结果 PyPI 的 aiter是 2019 年的同名异步库(0.13.x),不是 AMD 那个 ROCm 7.2.3 / graphics 仓库 没有 aiter 包 aiter_backend.py的架构门槛全是 is_gfx95_supported()、gfx950 FP8 FMHA ASM kernels、ck_tile paged batch_prefill⇒ CDNA(MI300/MI350)专用⇒ gfx1100 上编出来也用不上那条 attention 路径,不必再试。
五、接下来打算
- 若"同 PLX + 双大 BAR"有解 → 优先走这条(P2P 的物理前提 + ReBAR 都不丢)
- 内核升级到 7.0 的对照实验暂时押后(成本高,且要先确认上面那条有没有解)
- HiCache 用
write_back/ratio 1单变量各跑一轮 + 查 amdgpu ring timeout gptq_marlin在 ROCm 上的差距量化
再次感谢两位,尤其 @Xiaote 那条"脱离 SGLang 复现"直接帮我把问题定死了。
- RCCL 7.2 的头文件改名成
-
@南亚阿东 这题论坛里已有实测答案,且就是 X99 + 交换卡 + 双 7900 XTX:
1)补丁有,但不在 6.8 里
关键是PCI: Reserve prefetchable window headroom for Resizable BARs(Geramy Loveless,series 520756,v3 2026-08-31):它在 bridge sizing 阶段就给下游 ReBAR 预留窗口,不等驱动 resize 时再抢。laobenxiong 指了路(/post/20796),张光璞把补丁编进 7.0.14 实测(/post/20903):旧内核 256M BAR / upstream 258M / P2P false;换新内核后两条下游链各 32GiB、upstream 64GiB、P2P true,RCCL 256MB allreduce 2.33 → 7.04 GB/s。他那台是 Broadcom PEX880xx,补丁逻辑对 PLX 同样适用,但要在 E WS 上复测。你 6.8 上pci=realloc卡 30 分钟,像是没有 headroom 逻辑时把整条 fabric(含启动盘)拆了重建,别在 6.8 硬凑。2)顺序
- 先量:
/proc/iomem的 prefetchable 够不够 64G;lspci -vv看 PLX 上游Prefetchable memory behind bridge。根窗口不够,补丁也变不出来,得先解决 BIOS 的 Above 4G / MMIO 窗口。 - 升 7.0.x(7.0.14 或 Ubuntu 7.0.0-38 都行),GRUB 加
pci=realloc,先跑基线。 - 打补丁(7.0.14 的 hunk #4 因
pci_min_window_alignment改名window_alignment要手改),两卡同进 PLX#1 复测。 - 验收:两张卡
Region 0 = 32G、PLX 上游64G、rocm-smi --showtopo的 P2P weight;NCCL_DEBUG=INFO确认走P2P/IPC不是 SHM。
3)先做便宜的对照
同 PLX + 256M BAR 先测can_access_peer。BAR 影响大块映射效率,P2P 路由是 PLX 给的;若 256M 下已是 1,先让 TP 跑起来再追 32G,不必等内核。另:RCCL all_gather 再补
NCCL_ALGO=Ring/Tree、NCCL_PROTO=Simple、NCCL_P2P_DISABLE=1三组对照,能分清算法/协议还是 P2P 路径;page_size=1 + verify的 +25% 很值,顺带看 page1 对 prefix cache 影响。aiter 结论同意,gfx1100 不用再试。 - 先量:
-
@Xiaote @xiongjie-gao 你昨晚那四条建议我全做完了,逐条回结果,另外又顺手挖到两条,最后剩四个问题。
〇、先对账:你的四条建议 → 我的执行结果
建议 做法 结果 ② rccl-tests脱离 SGLang 复现 all_gatherrccl-tests 需 MPI 且未装,改用 RCCL C API 直测( ncclCommInitAll单进程双卡,等效且更干净) 原生也错 ⇒ 确认是 RCCL 自己的问题① 同 PLX + 小 BAR 先测 can_access_peer摸清槽位映射后四组拓扑全测 三类拓扑全 False ⇒ 与 PLX 路由无关③ HiCache 单变量: write_back与ratio=1分开跑跑了三组(2+wt / 2+wb / 1+wt),每轮只改一个变量 都跑完,ratio 1反而最稳④ journalctl -k查 amdgpu ring timeout查全历史 ring timeout 0 次、GPU reset 0 次、OOM killer 0 次⑦ 补 NCCL_ALGO/NCCL_PROTO/P2P_DISABLE对照全试 全部无效(详见下)一、RCCL 原生复现(回应②)
RCCL version : 2.27.7-HEAD:96a25b5
Librccl path : /opt/rocm-7.2.3/lib/librccl.so.1

[rank0] recv = [20,20,20,20,0,0,0,0]       期望 [10,10,10,10,20,20,20,20] -> BAD
[rank1] recv = [10,10,10,10,20,20,20,20]   -> OK
[rank0] all_reduce = [30,30,30,30] OK
[rank1] all_reduce = [30,30,30,30] OK
无 torch、无 SGLang、无 MPI,错误一模一样 ⇒ 「问题在 GroupCoordinator 缓冲/偏移」可以划掉,锁定 RCCL 2.27.7 的
ncclAllGather。顺带两个编译坑:
- RCCL 7.2 头文件改名成
<rccl/rccl.h>,没有nccl.h了 hipcc -x c不自动定义平台宏,必须手动加-D__HIP_PLATFORM_AMD__
另外把版本这条路也堵了:
尝试 结果 RCCL 2.27.7 另一构建(ROCm 7.2.4) 同一 bugRCCL 2.26.6(ROCm 7.0.3)  ️ 加载失败:
undefined symbol: ncclCommShrinkRCCL 2.22.3(ROCm 6.4.4) ️ 加载失败:libamdhip64.so.6 missingall_gather_single(torch 2.13 新接口) 与 all_gather_into_tensor错法完全一样NCCL_MAX/MIN_NCHANNELS、ALGO=Tree、BUFFSIZE、CUMEM 全无效⇒ torch 2.13.0+rocm7.2 硬依赖
ncclCommShrink(2.27 才有),比 2.27 老的 RCCL 根本配不上。 所以换版本这条路在现有 torch 下走不通,补丁只能留着。二、P2P:便宜对照做完了,三类拓扑全部否(回应①)
先把槽位映射摸清了(全部实测):
PLX CPU root 服务槽位 PLX#1 00:03.01、2、3 槽(下游口 10→9→8) PLX#2 00:02.04、5、6 槽(5 常被双槽卡挡住) 四组实测:
组合 同交换机 链路 BAR canAccessPeer1+4 跨 PLX双 x16 双 32 G False 2+4 跨 PLX双 x16 双 32 G False 1+3 PLX#1双 x16 双 256 M False 4+6 PLX#2双 x1 ️双 256 M False 每轮都确认
p2p_force钩子生效(已卸载,强制 26/23 次,放行 0 次),
hipDeviceCanAccessPeer与torch口径一致,p2p-bootcheck.sh每轮[FAIL] KFD p2p 链路数=0。⇒ 你那条假设("若 256M 下已是 1,就先让 TP 跑起来再追 32G")答案是否 —— 同 PLX + 256M 下也是 False。
三类拓扑穷举完毕,换槽这条路可以彻底排除了,剩下的变量只有内核。两条副产品:
- 4+6 槽同时插 → 链路掉 x1(Gen3 x1 ≈ 1 GB/s),这块板的硬限制,以后要避开
pci=realloc不是双大 BAR 的必需项:2+4 那轮 cmdline 里没有它,两卡 BAR 照样 32 G(跨 PLX 时窗口装得下)
三、HiCache 单变量三组(回应③)
196K ctx + DFLASH + mamba,每次喂不同的 48.6K prompt(唯一前缀,强制 prefill miss):
配置 灌入 / host 池 结果 ratio 2 + write_back97 K / 436 K(22%) 崩于第 3 个ratio 2 + write_through389 K / 436 K(89%) 崩于第 9 个ratio 1 + write_through243 K / 218 K(111%) 5/5 全过,服务存活灌到超过池容量 11%(必然触发驱逐)反而没崩,而 ratio 2 在 89% 就崩 ⇒ 崩溃不是"池满比例"驱动,
更像与 host 池规模有关(ratio 2 的 mamba + draft 主机内存是 ratio 1 的两倍)。配合你④的排查:ring timeout 0 次、GPU reset 0 次、OOM killer 0 次(全历史)⇒ 确实是进程内 abort。
正面收益很明确:48.6K 的 prompt 冷读 173 s → 前缀命中 2.1 s(≈82×)。
四、另外两条新发现
①
gptq_marlin的提示是误导(浪费了我一次启动)日志说:
Detected that the model can run with gptq_marlin ... Use quantization=gptq_marlin for faster inference真按它改:
ValueError: gptq_marlin quantization is currently not supported in ROCm.建议 ROCm 下把这条 warning 关掉,否则每个新用户都会踩一次。
② ReBAR 的量化价值(之前帖子里只有定性说法,这次测出来了)
同一配置、同一张卡,只改 BAR:
32 GB BAR 256 MB BAR 损失 单流 149.5 132.5 −11.6% 4 路 307.8 276.2 −10.3% 五、verify 路径 +25%(回应⑤的一半)
SGLANG_RDNA_VLLM_VERIFY=1的资格判定里page_size 1是硬条件,而 README 的 DFlash2 配方写的是--page-size 64⇒ 这条路径静默回退、连日志都不打。A/C 交替 2 轮 × 3 次(共 12 次测量):
配置 单流均值 4 路均值 单流波动 page64,无 verify 117.3 249.6 103–132(±14%) page1 + verify=1 146.4 303.5 141–149(±2.5%) 提升 +24.8% +21.6% 波动大幅收窄 对照(page1 但不开 verify)≈ 原状 ⇒ 收益全来自 verify,不是 page_size。8 路持平(452→455)。
⇒ 那份配方建议改成
--page-size 1,否则 fork 最强的优化一直关着。六、四个问题
Q1 · HiCache 到底怎么配才稳?
你们的ratio/write policy是什么?我们这种"连续灌不同长 prompt"是否必然崩、还是实际用法里每次都前缀命中不触发?有没有已知规避法?Q2 ·
page_size 1有没有长上下文代价?
我只测了 512 token 短请求(+25%)。它在 196K 下会不会有 KV 池碎片 / 长 decode 衰减?你们生产用 1 还是 64?如果还是 64,是踩过坑吗?Q3 ·
wave后端是什么定位?
wave_backend.py里有 gfx1100 专属调优(# M18: gfx1100-tuned override must not silently re-tune CDNA、is_rdna_supported),但 README 说用triton。wave 是实验性 / 已弃用 / 特定场景才用?gfx1100 上除 triton 还有更快的 attention 方向吗?Q4 · 7.0 内核下整套栈的兼容性(不只 P2P)
有人在 ROCm 7.2.3 + gfx1100 fork + 双卡 TP2 下跑过 7.0 内核吗?torch / triton / RCCL 都正常吗?SGLang 要不要重编?
另外老实问一句:decode 时 GPU 有 94% 的时间 ≥95% busy(算力受限),P2P 就算通了折算 e2e 可能只有 +1~2% —— 为这个升内核值不值?
再次感谢两位。@Xiaote 那两条("脱离 SGLang 复现"和"先做便宜对照")直接帮我把问题从"猜"变成"定"了,尤其便宜对照一做,P2P 这条线当场就能结案。
- RCCL 7.2 头文件改名成
-
@南亚阿东 四条按 SGLang 侧答,给能直接试的:
Q1 HiCache
ratio/size是启动预分配,不是运行水位;89%/111% 是逻辑占用,所以“没灌满也崩”不矛盾。更像两个已知坑:- hybrid Mamba 下
--hicache-size会把同一绝对大小同时给 KV 和 Mamba 池,主机内存约 2×(上游 sglang #29037/#32915)。没补丁就别用 size,改--hicache-ratio 1;要用 size 就减半,别同时设 ratio。 Can not alloc mamba cache是 device mamba 池没空槽、一次 eviction 又释放不出(被运行中请求或 in-flight write-through/load-back 钉住)时的 assert,旧代码直接 abort,不是 OOM。上游有个 open PR #36770,改法是“跳过这段 radix 缓存、不崩”。没带就 cherry-pick;临时降--max-running-requests、别用write_back(延迟回写更容易拉长 pin 窗口)。
起点:--hicache-ratio 1 --hicache-write-policy write_through --hicache-mem-layout page_first --hicache-io-backend kernel,先不加 storage backend。连续不同长 prompt 是最坏情况;正常聊天有共享前缀,不会这么 churn,但配对了应 evict 而非 abort。还崩就抓 traceback 有没有那句 assert。
Q2 page_size 1
官方配方写 64 是给 DeepSeek MLA 的原生页;Triton 路径 page>1 不是内核原生分页(用 per-token kv_indices 模拟),64 拿不到少页表的好处,反而每请求尾块最多浪费 63 token。page1 在 196K 下页表约 0.8MB/请求,相对 KV 可忽略,代价是 decode 多一层索引。测法:196K 输入 + 512 输出各 3 次,page1+verify vs page64+无 verify,记 TTFT、decode t/s、max_total_num_tokens。掉幅 <3~5% 就保持 page1;掉得狠再按长度分实例,或改 verify 的 page 条件。Q3 wave
不是弃用,是 ROCm 的备选 MHA 后端:Wave DSL/Triton 实现,原生支持 page>1;但不支持 FP8 KV、spec topk、sliding window、多模态,早期只有 decode,现在有 extend,仍非默认。RDNA 上 AITER 不能用(CDNA 专用),实际得显式选 triton(默认改 triton 的 #31259 还没合),wave 是 opt-in。gfx1100 有专门调优,值得在“纯 decode、不带 spec”下 A/B:同 page size 跑--attention-backend wavevstriton,bs=1/4/8,先验 32K/128K 正确性。你 DFlash2 若 topk>1 或 fp8 KV,wave 出局。gfx1100 更快的方向通常在 attention 之外:torch.compile/HIP graph、GEMM、batching 收益更稳。Q4 7.0 内核
ROCm 7.2.x 官方矩阵里 Ubuntu 24.04 HWE 是 6.14,7.0.0-38 已在矩阵外;X99-TF 能跑只是一个数据点,不等于 E WS + PLX + 双 32G BAR 也能。只换内核不用重编 SGLang/torch/triton/RCCL,但 amdgpu/KFD、DKMS 和p2p_force/ReBAR 补丁要重编;先过dkms status、dmesg | grep -E 'amdgpu|kfd'、rocminfo。要试就单独盘/分区,GRUB 留 6.8,跑完 p2p-bootcheck + RCCL all_gather + 196K 再决定。
按你“94% 时间 ≥95% busy”,为 P2P 升内核不值:TP2 每 token 通信量相对 Gen3 x16 很小且被计算掩盖,+1~2% 是合理预期,风险却是整机起不来。要升就把理由换成“同 PLX 双 32G BAR / ReBAR +11.6%”再单独评估。另外:gptq_marlin 的 warning 按
is_hip()关掉;RCCL all_gather 最小复现建议直接提 RCCL issue,rank0 后半段全 0 很像 send offset/建链问题。 - hybrid Mamba 下
-
@Xiaote 感谢,你把我的排查方向从"猜"推到"可排除"。按你的建议做完后,HiCache 那个 SIGABRT 终于抓到了真栈 —— 但结论和"mamba assert"不太一样,另外还排除了三个我自己长期误判的变量。逐条报结果。
〇、先认一个错的:之前的结论建立在没法压满的脚本上
我原来的压测脚本用
need_chars = target_tokens * 1.6估字符数。那是中文系数(约 1.6 字符/token)。换成英文填充之后,同样公式发出去只有 16,720 token,而目标是 55K。所以之前"ratio 1 的 5/5 全过"那一轮,实际压力只有约 30%,很可能根本没压到 48.6K。这大概是"稳"的来源——不是配置稳,是没压到。
新脚本改成实测回显
ch/tok(我们这套 prompt 实测 5.15–5.34),不再靠猜系数。建议其他人压测时也回显一下,这个坑很安静。
一、抓到了真栈:不是 assert,是 GPU 层
启动器加一个环境变量就够了:
export PYTHONFAULTHANDLER=1崩溃时刻:
rocddevice.cpp:3586: Callback: Queue 0x7b7a1c400000 aborting with error :
    HSA_STATUS_ERROR_EXCEPTION: An HSAIL operation resulted in a hardware
    exception. code: 0x1016
terminate called after throwing an instance of 'c10::AcceleratorError'
  what(): CUDA error: unspecified launch failure   (hipErrorLaunchFailure)
Fatal Python error: Aborted
Can not alloc mamba cache这个 assert 在崩溃日志里 grep 零命中。journalctl -k全历史:ring timeout 0、GPU reset 0、OOM 0 —— 驱动没判定硬件挂死,只是队列报异常。三组配置,三个不同的崩溃点
配置 崩溃栈顶 HiCache ON + page1 layernorm.py:1164 forward_native←communicator.py:1343 _gather_hidden_states_and_residual无 HiCache + page64 hybrid_linear_attn_backend.py:952 _track_mamba_state_extend←gdn_backend.py:1057无 HiCache + page1 无 Python 栈,只到 terminate called三个不同的点,但我判断是同一个底层故障——因为 HIP 文档原文就写了:
CUDA kernel errors might be asynchronously reported at some other API call, so the stacktrace below might be incorrect.
崩点不是错误点,是 GPU 队列报错时恰好排到的 API。
二、四组对照(每轮只改一个变量)
固定:TP2 / gptq / fp8 KV / 196K / mamba bf16 / 40 槽 / 并发 8 / DFLASH。
组 HiCache AG 补丁 page_size 请求 结果 A ON ratio1 ON 1 45.9K × 12 第 2 个崩B ON ratio1 OFF 1 45.9K × 12 第 2 个崩C OFF ON 1 45.9K × 12 第 6 个崩(累计 229,610)D OFF ON 64 45.9K × 12 第 6 个崩(累计 229,608)三个结论:
- 关 HiCache 仍崩 ⇒ HiCache 不是原因,只是让它提前 3 倍到来(第 2 个 vs 第 6 个)。
- 关掉我自己的 all_gather 补丁仍崩 ⇒ 本地补丁洗清。
- C 和 D 的累计 token 是 229,610 vs 229,608,崩点都在第 6 个,几乎逐位一致 ⇒ page_size 1 是清白的,那个 +25% 收益不用背这个锅。
三、二分长度:不是阈值
长度 每个耗时 数量 累计 结果 7.7K 6.6 s 50 386,750 全过15.8K 20.5 s 8 110,733 第 8 个崩23.7K 42 s 4 94,881 全过31.6K 70 s 3 94,863 全过两件事:
- 累计量不是原因:386K token 全过,而 229K 就崩。
- 长度也不是确定性阈值:15.8K 崩了,但 23.7K 和 31.6K 更长,没崩。
目前唯一能解释全部现象的是:概率性故障——请求越长,单位时间越可能撞上。15.8K 那次可能只是恰好。但我没做重复测量,所以这个结论只能算推断,不能算定论。 下一步打算同配置跑 3–5 次看崩率。
四、关于你 #12 的两条判断
mamba 那条:你说的 assert 确实存在,我在源码里找到三处(
mamba_radix_cache.py:1067/1083/1208),其中 1067 是evict一次、重试失败就 assert,没有退避。方法("抓 traceback 看有没有那句 assert")也是对的——照做之后我才排除掉 mamba。但这次崩溃没走到它。想请教:PR #36770 那个"跳过这段 radix 缓存、不崩"的改法,具体改在哪一行? 我想确认它和我看到的
HSA 0x1016是不是两条完全不同的路径。如果是两条,那我这边的问题可能还有第三层。另一个可能相关的观察:崩溃前
mamba usage一直只有 0.10,池远远没满。所以不是池耗尽,更像索引或指针层面的问题。--hicache-size那条:我在这个 fork 上复现不出"主机内存 ×2"。hybrid_pool_assembler.py:172 _split_hicache_size是按各设备池大小比例切分的,不是"同一绝对大小给两份"。实测 ratio 1 得 218,195 tokens / 3.57 GB,跟设备侧 218,194 对得上。想确认一下:#29037/#32915 描述的是不是"同时设了
--hicache-size和--hicache-ratio"的那种组合? 我们只设了 ratio,可能根本不在那个 bug 的触发面上。
五、page_size 那条(顺带回答 Q2)
你给的测法我还没跑完,但已经间接得到一个结论:page1 的长上下文代价不是崩溃(D 组 page64 同样崩)。
崩溃点分散在三处,和 page_size 无关;C/D 组累计量逐位一致这个证据我比较信。
六、aiter / marlin
- aiter 确认对 gfx1100 无解:
aiter_backend.py全是is_gfx95_supported()/ck_tile paged batch_prefill,CDNA 专用。你之前判断一致。 - gptq_marlin 建议按
is_hip()关掉那条 warning:日志先提示"可以用 gptq_marlin 更快",真按它改直接ValueError: gptq_marlin quantization is currently not supported in ROCm。每个新用户都会踩一次。
七、想请教的三件事
- PR #36770 具体改哪一行,以及它和
HSA 0x1016是不是两条路径。 _track_mamba_state_extend在 GDN 路径上有没有已知的长 prefill 越界。崩溃点在那里,且当时mamba usage只有 0.10。track_ssm_h_src在 GDN 分支是offset + lens_masked // state_chunk_size,45.9K 请求这个值能到 ~179,我想确认它被索引的那个 buffer 是按什么维度分配的。- 谁在 RDNA3 上遇到过
HSA_STATUS_ERROR_EXCEPTION 0x1016。这个码是MEMORY_APERTURE_VIOLATION,我怀疑是 GPU 侧索引越界写,但没有比 traceback 更深的证据了(AMD_SERIALIZE_KERNEL=3还没试)。
再次感谢 @Xiaote 和 @xiongjie-gao。你那个"先做便宜对照"的建议价值很大——四组对照做完,P2P 和我这边的 HiCache 这两条线都能当场结案,比继续调参省得多。
-
@南亚阿东 四条对照很干净,HiCache/page_size 两条线可以先结案。三个问题分开答。
1)#36770 与 0x1016
PR 改的是新树unified_cache/components/mamba_component.py:_alloc_mamba_slot→_try_alloc_mamba_slot(约 494 行),assert(约 508 行)换成if slot is None: self._on_mamba_alloc_failed(); return None;prepare_for_caching_req三个调用点(约 638/660/674)拿到 None 就return 0,本 chunk 不缓存、请求保留 live state。你 f84475c 的对应点是
mamba_radix_cache.py:1061,断言在 1067,调用点在cache_unfinished_req740/751/756。不能只删 assert,否则 None 会进donate_mamba_ping_pong_slot/copy_from;要移植就在 1067 返回 None,并在三个调用点加if new_slot is None: return _skip_cache_unfinished_req(req)。int8(1083)和 COW(1208)是另两条路径,PR 没覆盖。这跟 0x1016 是两条路:前者是 host 侧“没有可驱逐槽”的 assert,触发会打
mamba slot alloc failed after eviction;你日志里 grep 不到、usage 0.10,可以划掉。2)track 索引
h = k.new_empty(B, NT, H, V, K),varlen 时 B=1,NT = Σ ceil(extend_len_i/64)(FLACHUNK_SIZE=64),h.squeeze(0)后是(NT,H,V,K)。track_ssm_h_src = offset + lens_masked//state_chunk_size,offset 是(extend_seq_lens-1)//state_chunk_size+1的 cumsum。只要state_chunk_size==64,它就是当前 extend 的最后一个 chunk,不越界;45.9K 整段一次 extend 的最大值是 717,不是 179。179 先对一下来源:如果来自 ~11.4K 的 chunked-prefill 分片,正常;如果 45.9K 整段还是 179,那
state_chunk_size是 256,和 h 的 64 网格不一致——取错状态,不是越界,但会污染 cache。打印self.mamba_chunk_size和h.shape[0]即可确认。你崩在 952 行(final 拷贝)而不是 h gather,更像 dst/slot 生命周期:
track_ssm_h_dst/track_ssm_final_dst来自 ping-pong 的mamba_track_indices,HiCache 驱逐+并发复用时若 slot 已释放/为 -1/超过ssm_states.shape[0],就是 GPU 侧越界写。临时加(别常开):assert 0 <= int(track_ssm_h_dst.min()) and int(track_ssm_h_dst.max()) < ssm_states.shape[0] assert int(track_ssm_h_src.max()) < h.shape[0]final_src/dst 也查。dst 越界就顺着
mamba_ping_pong_track_buffer/get_mamba_ping_pong_other_idx查 slot 生命周期,别先怀疑 h。3)0x1016 往下钉
这个码是 memory aperture violation,但rocdevice.cpp的栈只是异步报错点,不是出错 kernel。先AMD_SERIALIZE_KERNEL=3 HIP_LAUNCH_BLOCKING=1复跑同一组。公开 issue #41299 是 Qwen3.8-Flash-Next/gfx950 的 0x1016,serial 后能过,更像 race/缺同步;#43730(gfx942,~50K prompt)也是长度相关、崩点漂移。你这组“三个崩点、page1/page64 都崩、累计 token 逐位一致”很像同一类。再二分:
--disable-overlap-schedule、--disable-cuda-graph(或只关 piecewise)、--enable-mixed-chunk关掉,各跑 45.9K×12。mixed-chunk + extra_buffer 有已知 bug(#39342:混合批跳过 checkpoint 写但仍 donate slot,fix PR #39526 还开着),不直接造成 0x1016 也建议先关掉排除。公开面没找到 gfx1100 的 0x1016 案例;RDNA3 支持还在 tracking #30599,你这台可能真是首批。serialize 后还崩,把第一份失败栈和
dmesg | grep -i amdgpu发我,我按 kernel 名对。另外两条翻案我认:
--hicache-size的 2× 是 #32915 之前的老树,你的_split_hicache_size已按设备池比例切总预算;只设 ratio 根本不走 size split,这条划掉。mamba assert 也是我上轮按旧代码给的优先级,实际没走到,抱歉。 -
@Xiaote 按你给的三步做了,先报结果:serialize 后仍崩,断言方向(dst/slot)和 h_src 都没越界。另外我上一帖里有个数字报错了,先更正。
〇、更正:我算的 179 是错的,你算的 717 才对
你指出的两点我都核实了:
self._mamba_chunk_size = getattr(hf_text_config, "mamba_chunk_size", 64)我们的
config.json里没有mamba_chunk_size字段,所以取默认 64。实测打印也是chunk=64。和 FLA 的网格一致,不是 256。 179 是我拿mamba_track_interval(256)去算的,用错了常量。不过你说的"整段 45.9K 最大值 717"在我们这里是 128,原因是
--chunked-prefill-size 8192:每个 forward 只吃 8192 token,NT = 8192/64 = 128。实测:[AGU] h.shape=(1, 128, 24, 128, 128) dim=5 contig=True → (B, NT, H, V, K) [AGU] ext_lens=[8192] prefix=[0] track_seqlens=[8192]
一、serialize 复跑:仍崩,但崩点稳定了
export AMD_SERIALIZE_KERNEL=3
export HIP_LAUNCH_BLOCKING=1
组 配置 崩溃位置 累计 token 基线 无 serialize + page1 req#6 229,610 G1 serialize + page1 req#4 137,766 还在崩,所以不是纯 race。 但 serialize 让它提前两个请求崩,且栈固定在
_track_mamba_state_extend:952(以前是漂的)。我理解这是:同步执行后,出错点不再被异步推迟到后面的 API,所以报告点 = 出错点。按这个读,更像是确定性的越界写,而不是时序问题。
二、断言结果:两个方向都没越界
按你给的断言(外加我多查的 final_src / recompute_dst),实际数据:
[AGU] ssm_states.shape = (41, 24, 128, 128)     # 41 个槽
[AGU] h_src  n=2 vals=[77, 79] max=79           # NT=128  → 77,79 合法
[AGU] h_dst  n=2 vals=[11, 16] max=16           # 槽 41    → 11,16 合法
[AGU] final_src n=1 vals=[2] max=2
[AGU] final_dst n=1 vals=[3] max=3
全部在范围内。 你怀疑的 dst/slot 生命周期,我顺着看了
h_dst=[11,16]和final_dst=[3],没有 -1、没有超 41。所以这条也要划掉——但我想确认一件事:你给的
h.shape[0]检查,在我的 5 维布局下应该是第 2 维(NT)。我一开始按h.shape[0]=1判,差点得出"77 越界"的假结论。是不是你那边h是(NT,H,V,K)(被 squeeze 过),所以用shape[0]是对的?
三、这轮唯一的新观察:崩溃前是2 条序列合批
崩溃前的 prefill 日志(serialize 模式):
#new-seq: 1, #new-token: 8192, full token usage: 0.21, mamba usage: 0.17  ×5
#new-seq: 2, #new-token: 5084, full token usage: 0.21, mamba usage: 0.20   ← 崩在这
最后一个不完整 chunk(5084 token)变成了
#new-seq: 2,而且h_src/h_dst正好都是n=2。这和
_init_track_ssm_indices的 GDN 分支对得上:num_h_states = (extend_seq_lens - 1) // state_chunk_size + 1 track_ssm_src_offset[1:] = torch.cumsum(num_h_states[:-1], dim=0) track_ssm_h_src = track_ssm_src_offset[mamba_track_mask][not_aligned] \ + (lens_masked[not_aligned] // state_chunk_size)src_offset是按批内前序序列累加的,所以第 2 条序列的 offset 会是第一条的 chunk 数。如果两条序列共享同一个h但 offset 没考虑合批,h_src就会指到错误的位置——这次数值恰好没越界(79 < 128),但很可能取错了 chunk。想请教:
#new-seq: 2是什么在合批? 是 chunked-prefill 的两段合并调度,还是 DFLASH 主/草稿模型?- 如果是 chunked-prefill 合并,那
src_offset这段的extend_seq_lens到底对应哪一层,我想对着看一遍; - 如果是 DFLASH 双模型,那
h的B维就可能是 2 而不是 1,我现在的(1,128,...)只抓到了一次,需要再抓。
四、你说的另外几条
①
#36770的移植点我核对过了,你说的位置对得上:- 我们 fork 的
mamba_radix_cache.py:1061是_alloc_mamba_slot,断言在 1067 - 调用点在
cache_unfinished_req的 740/751/756 - 你提醒"不能只删 assert,否则 None 会进
donate_mamba_ping_pong_slot/copy_from"——这条我记下了,但这次崩溃不走这条路,所以先不移植。int8(1083)/COW(1208) 那两条也没覆盖,一并记着。
②
--disable-overlap-schedule:还没跑,下一步做(既然 serialize 都不救,想先看它是否改变崩点位置)。③ mixed-chunk:我们服务里
enable_mixed_chunk本来就是False,这条不适用。④
--disable-cuda-graph:还没试。⑤ 公开 issue 我读了:
- #41299(gfx950,serial 后能过)——我们 serial 后还是崩,所以和它不是同一类;
- #43730(gfx942,~50K prompt,崩点漂移)——症状最像,我正在比对它的复现条件。
⑥ gfx1100 无公开案例:理解,那就当首批处理。
五、我这边的一个教训(可能对别人有用)
这一轮我连续报了三次错误的"越界证据",全是因为读错维度:
- 用
mamba_track_interval=256算 chunk 序号(应该用 64) - 把
h.shape=(1,128,24,128,128)前两维读成(2,24) - 用
h.shape[1]当行数上限,但真实行维是h.shape[1]在 squeeze 后才成立
结论:验证
track_ssm_h_src上限前,必须先打印h.dim()和完整h.shape,不能凭h.shape[x]猜。 我把这段写进了自己的排查记录。 - 如果是 chunked-prefill 合并,那
-
@南亚阿东 两个问题分开答,先把维度这条认了。
1)h.shape 那条是我给错了
5 维h=(B,NT,H,V,K)里 varlen 的B恒为 1,真正被track_ssm_h_src索引的是NT。_track_mamba_state_extend里先h = h.squeeze(0)再h[src],所以函数内用h.shape[0]是对的;你在外面打印 5 维张量时应该用h.shape[1]。我上轮写h.shape[0]是按 squeeze 后的视图说的,没写清楚,抱歉。2)#new-seq:2 是两个请求合批,不是 chunk 合并,也不是 DFLASH
#new-seq就是PrefillAdder.can_run_list的长度,即这一轮从 waiting queue 新放进来几个请求。你并发 8,--chunked-prefill-size 8192下前一个请求的尾 chunk 只占 5084,剩下的预算会再塞一个等待请求进来,于是#new-seq:2。extend_seq_lens是这一轮每个请求各处理多少新 token 的向量,长度就是 batch 里的请求数;h是(1, Σceil(extend_len_i/64), H,V,K),按请求顺序摊平,不是(2,...)。
DFLASH 是投机解码,draft/verify 都在同一个请求里跑,不会给 scheduler 增加 seq;prefill 的 draft 前向也不会进#new-seq。3)你的数其实正好对上两条序列,79 不越界
#new-token:5084+h_src=[77,79]可以拆成两条都不整除 64 的序列,例如 4957 + 127:- seq0:
ceil(4957/64)=78,4957//64=77→ h_src=77 - seq1:offset=78,
127//64=1→ h_src=79 - NT=78+2=80,79 是最后一行,合法。
你那个
h.shape=(1,128,...)是 8192 整 chunk 的日志,不是崩的那一轮;崩的那轮 NT 大概率是 80。把崩溃 forward 的h.shape[1]、extend_seq_lens、extend_prefix_lens、mamba_track_seqlens、mamba_track_mask一起打出来。如果h.shape[1]==Σceil(extend/64),这段 offset 就是自洽的,先别再往越界查。4)下一步建议按这个顺序
① 在_track_mamba_state_extend的 copy 前后各加一次torch.cuda.synchronize()并打点:若 "before copy" 没打出来就崩,错在 extend kernel;打出来后才崩,才是 copy 本身。
② 客户端改成并发 1 跑同一组 45.9K×12。serialize 会让 prefill 变慢,若你是固定速率发请求,队列深度和合批组成会变,这不是单变量对比。并发 1 还崩 → 单序列尾 chunk;不崩 → 合批路径。
③ 再试--disable-overlap-schedule,以及把 prompt 补齐到 64 的倍数(如 49152)对比 45.9K 的非对齐尾,看是不是尾 chunk 触发。
④ 抓最后 kernel:rocprofv3 --kernel-trace -o trace -- python -m sglang.launch_server ...,0x1016 的 Python 栈经常是报错点不是出错 kernel。如果 ① 证明是 copy 本身,再查
ssm_states是否 strided/alias(打印is_contiguous()、stride()、storage_offset());索引都在范围内的话,剩下更可能是源行没被写或目标视图 stride 不对,而不是h_src算错。 - seq0:
-
@Xiaote ① ② 都做完了,②(并发 1)直接把你说的"合批"坐实了。另外想请教一个和主板 BIOS / PLX 窗口相关的底层问题,方向可能和我之前想的不一样。
〇、先谢两条纠正
①
h.shape那条:懂了,是我们打印位置不同。函数内h = h.squeeze(0)之后用shape[0]是对的,我在外面打 5 维张量该用shape[1]。两边都没错,是我没意识到 squeeze。②
#new-seq: 2是合批:你那句"前一个请求尾 chunk 只占 5084,剩下的预算会再塞一个等待请求",我拿并发 1 验证了 —— 完全正确。③ 我拿
h.shape[1]之前抓到的是 8192 整 chunk 的帧,你说得对,不是崩的那一轮。后面我会按你的要求把崩溃 forward 的五个量一起打出来。你那个
4957 + 127的拆解我验算了一遍,和我们的数据完全对得上:seq0: ceil(4957/64)=78,4957//64=77 → h_src = 0 + 77 = 77 seq1: offset = 78,127//64=1 → h_src = 78 + 1 = 79 NT = 78 + 2 = 80,79 = 最后一行,合法⇒
h_src=[77,79]在NT=80下完全自洽,越界这条可以彻底划掉。
一、决定性对照:并发 1 vs 并发 8
按你的建议改了客户端并发(不是改服务端),其他全不变(page1 / 无 HiCache / DFLASH / 40 槽):
组 并发 每请求实测 请求数 累计 token 结果 基线 8 45.9K 12 229,608 崩于第 6 个并发 1 1 53.1K 12 636,710 12/12 全过明细:
req#1..12 全部 OK,每个 ~184s,prompt=53059/53060
累计 636,710 token,服务存活
并发 1 的请求更长(53K vs 46K)、累计量接近 3 倍,却一个都没崩。
⇒ 合批路径是触发条件,单序列长 prefill 完全没问题。
这也解释了我之前那组"7.7K × 50 全过":7.7K 被切成 8192 整 chunk,尾 chunk 几乎不留预算,很少能合成
#new-seq: 2。而 45.9K 的最后一个 chunk 正好剩 5084,空间刚好够塞第二个。另外谢谢你指出 serialize 那组的对比问题——序列化会改变 prefill 速度,固定速率发请求时队列深度和合批组成都会变。所以 G1 那个"第 4 个 vs 第 6 个"我改成定性结论处理,不再当定量数据。
二、下一步我打算查合批路径里的哪几处
既然锁定了合批,我准备按你 #16 的 ① 做,但专门打
#new-seq: 2那一轮:# _track_mamba_state_extend 的 copy 前后 print("[BEFORE] h.shape=%s ext_lens=%s prefix=%s track_seqlens=%s mask=%s" % (h.shape, forward_batch.extend_seq_lens.tolist(), forward_batch.extend_prefix_lens.tolist(), forward_batch.mamba_track_seqlens.tolist(), forward_batch.mamba_track_mask.tolist()), flush=True) torch.cuda.synchronize() print("[AFTER-SYNC]", flush=True)判据按你说的:"BEFORE" 没打出来 ⇒ 错在 extend kernel;打出来才崩 ⇒ 才是我后面这几行 copy。
三、想请教一个方向(和 0x1016 无关,是 PLX / BIOS 那一层)
这条本来是我自己想了很久但一直没敢动的,读到你的回复后觉得也许该正经问一下。
背景:我现在是"跨 PLX 双 32G BAR"
这台 X99-E WS(BIOS 4001 原厂,非 USB3.1 版)现在两卡在 1 槽 + 4 槽,实测:
07:00.0 (1 槽, PLX#1)  Region 0: 32G @ 381000000000
0d:00.0 (4 槽, PLX#2)  Region 0: 32G @ 380000000000

04:10.0 (PLX#1 上游)  Prefetchable: 380c00000000-3817ffffffff  [size=48G]
0a:10.0 (PLX#2 上游)  Prefetchable: 380000000000-380bffffffff  [size=48G]
04:08.0 / 0a:08.0     Prefetchable: [disabled]
每颗 PLX 的 upstream prefetchable window 是 48G。
所以如果两卡塞进同一个 PLX,需要 2 × 32G = 64G > 48G,BAR 必然掉 256M —— 这和我 10-31 实测"1+3 槽 BAR 掉 256M"一致(1、2、3 槽同属 PLX#1)。
但我在 Win-Raid 看到一条矛盾,想请你判一下
同一个论坛帖(Asus X99-E WS/USB3.1 BIOS Mods incl. ReBar Support)里:
- 有人提供改装 BIOS:插入
ReBarDxe v0.3、MMCFG Base 1GiB→2GiB、MMIO High Size 256GiB→1TiB,并有人用它在 Above 4G 下插 6 块 Tesla P40(每块 32G BAR) - 另一位用户(ubr)报告:用 PCIEX16_1 + PCIEX16_3 两个槽,2× 32G BAR 卡跑通了
- 但同时另一位(becca)刷了同一个改装 BIOS,
/proc/iomem仍是 256GB,PLX 口 window 没变,第二个卡没地方枚举
⇒ 同一块板、同一个 BIOS 文件,有人成功有人失败。1+3 槽到底是"同 PLX 必掉"还是"BIOS 拉开窗口后可行",我这边没有定论。
三个具体问题
① PLX PEX8747 的 upstream prefetchable window,是 POST 时 BIOS 静态分配的,还是可以被后续 resize 的?
我的理解是 PEX8747 是 non-transparent 之外的普通 PCIe switch,它的 bridge window 由 BIOS 在 bus enumeration 阶段写死;Linux 的pci=realloc只能重排,不能超出 BIOS 给的父窗口。这个理解对吗?② 那「MMIO High Size 256GiB→1TiB」改的到底是哪一层?
是给 CPU root complex 的 MMIO 上限、还是给 PLX 这类 bridge 的 window 预算?如果只改前者,PLX 自己的 48G 是 PLX 固件/BIOS 里单独设定的,那这个 patch 对"同 PLX 双 32G"就没用——和 becca 的结果一致。③ 如果要让"同 PLX 双 32G"成立,责任在哪一层?
- BIOS 层:能不能通过
RU.EFI之类直接改 PLX 上游 window 的大小变量? - 内核层:你之前提的
PCI: Reserve prefetchable window headroom for Resizable BARs(series 520756) 能否解决"bridge 初始 window 太小"?还是它只管"设备 resize 时预留余量",仍然受限于 bridge 自己的 max window? - 还是说 在 E WS 这种 PLX 双跳拓扑上,这条路根本不通,只能维持跨 PLX?
补充一个我实测到的、可能相关的数字
同一份配置,只改 BAR 大小(32G vs 256M):
32 GB BAR 256 MB BAR 损失 单流 149.5 132.5 −11.6% 4 路 307.8 276.2 −10.3% ⇒ ReBAR 在我们这个负载上值 11.6%,所以如果"同 PLX + 双 32G + P2P"能成,它的收益就不是我上次估的 +1~2%,而是 11.6% + P2P 的额外收益。这改变了我对升内核 / 改 BIOS 的性价比判断。
四、如果你觉得这条路不值得走
也请直说。我现在的判断是:
- BIOS 改动风险:第三方 Mod BIOS,刷废要编程器救砖;而且 becca 的先例说明刷了也不一定生效
- 内核补丁风险:要上 7.0,ROCm 7.2.3 不在官方矩阵里
- 确定收益:11.6%(BAR)+ 未知(P2P)
如果结论是"维持跨 PLX、别动 BIOS",我就不折腾了,把精力放回合批这个问题上。
再次感谢,你这两轮把 P2P 和崩溃两条线的排查范围都收得很干净。
- 有人提供改装 BIOS:插入
-
@南亚阿东 三个问题按层次答,结论先说:瓶颈在 BIOS 枚举,不在 PEX8747 硬件;但为这 11.6% 刷 Mod BIOS 不值——跨 PLX 双 32G 已经把这 11.6% 拿到了。
① PEX8747 的 window 是 BIOS 写的,不是硬件上限
它是普通 PCI-to-PCI bridge,上游口 Prefetchable Base/Limit 是可写寄存器,POST 时由 BIOS 枚举写入;Linux 用pci=realloc也能重写、必要时能扩大,不只是“重排”。上限只受父窗口(root complex 的 MMIO aperture)约束。48G 是这次 BIOS 给的值,不是 PEX8747 的硬件上限。② MMIO High Size 改的是父预算
它设的是 CPU root complex 在 4G 以上的 MMIO aperture,BIOS 再拿这个预算分给各 bridge。256G→1T 只是父窗口变大;BIOS 若仍按“每 PLX 48G”分,PLX 上游不会自动变 64G。becca 刷完/proc/iomem仍是 256G,说明那版 mod 的 1T 没生效(或被这版 BIOS 忽略),不能反证父窗口没用。③ 责任层与补丁
- BIOS 是决定者:上下游窗口都在枚举时写死;持久改只能改 BIOS 的资源分配。RU.EFI 只能当场改寄存器,重启失效。
- 内核:
pci=realloc能在父窗口内重建(理论可把 04:10.0 拉到 64G),但要 64G 对齐空洞,还可能移动启动盘资源——你 6.8 上卡 30 分钟就是这个。 - headroom 补丁(LKML v3):补的是“BIOS 按 boot-time 小 BAR 分小了,驱动后 resize 没空间”,做法是 sizing 时按 ReBAR max 预留、再释放重算 pref window。它变不出父窗口,且只在
max > current时触发。你 7900 XTX 启动 256M、max 32G 正好命中,但两卡要 64G,仍看 root 有没有 64G 空洞,还要上 7.0+补丁+pci=realloc,不是打上就成。
Win-Raid 那个矛盾:ubr 1+3 插 2×32G V100 成功,说明 mod BIOS 不是做不到;但 V100 的 32G BAR1 是原生上报,你的 7900 XTX 默认 256M、靠 OS resize——BIOS 枚举时看不到 32G 需求。这正是补丁想补的缺口,两者不能直接照搬。
建议:这条线先封存
- 同 PLX 不会再多 11.6%——你比的是 32G vs 256M,跨 PLX 已是 32G;同 PLX 只多“可能 P2P”,还可能因 64G 塞不进 48G 反掉一张到 256M。
- 四组拓扑
can_access_peer全 False,P2P 卡在更上层(ACS/IOMMU/root complex),不是同 PLX 就自动通。先查lspci -vvv -s 04:10.0与下游口 ACS、dmesg | grep -i iommu,试一次amd_iommu=off iommu=pt看rocm-smi --showtopo。比刷 BIOS 便宜。 - 真想验同 PLX,先别刷 BIOS:两卡插 1+3,看
04:10.0的 window 是否 ≥64G、第二张卡是否仍 32G;不行插回 1+4,十分钟可逆。 - 现在真正卡你的是合批 0x1016 和 RCCL all_gather 原生 bug,收益比 11.6% 大。合批按计划打 BEFORE/AFTER-SYNC;重点看
#new-seq:2时两条序列的extend_prefix_lens/mamba_track_mask。
-
@Xiaote @xiongjie-gao 又是同一题(topic 2774 原帖),但这次我想换个问法:不再报猜测的机制,只报一组数据和一个排除结果。
先把两个之前的错误更正,再报崩率。
〇、更正:我之前说"serialize 后仍崩",那个实验是无效的
我按你 #14 的建议加了
AMD_SERIALIZE_KERNEL=3+HIP_LAUNCH_BLOCKING=1复跑,报"仍崩 ⇒ 不是纯 race"。后来发现那次变量根本没生效。
判据很简单:那组每请求耗时 140.3 / 141.4 / 141.8 s,和不 serialize 的 137–140 s 完全一样。如果真序列化,prefill 的几千次 kernel 发射全部同步,不可能只差 1 秒。
然后我又犯了一个错:第二次做 blocking 对照时,启动脚本写了
if ! alive就跳过启动,结果复用了上一个实验遗留的服务,HIP_LAUNCH_BLOCKING连进程环境里都没有。⇒ 你给的第一条建议,我执行了两轮都是错的。抱歉。
并且我确认了这个变量在本机是有效的(这一点很重要,见下):
500 次 256x256 matmul default 33.0 ms HIP_LAUNCH_BLOCKING 90.0 ms ← 2.7x教训:判断环境变量是否生效,不能只看
/proc/<pid>/environ(有 ≠ 生效),要看可观测的性能差异。
一、崩率:并发 8 + 45.9K,5 次里 2 次崩
配置固定不变(page1 / 无 HiCache / DFLASH / 40 槽 / 并发 8),同一台机器、同一份代码,每次 12 个 45.9K 请求:
run 结果 崩在第几个 累计 token 1 崩第 3 个 91,843 2 活— 551,067 3 活— 551,065 4 活— 551,065 5 崩第 1 个 0 崩率 2/5 = 40%,崩点从第 1 个漂移到第 3 个。
三次成功时 token 逐位一致(551,067 / 551,065 / 551,065,耗时 1674–1678 s)——
一旦过了崩溃窗口,系统就完全正常。把之前所有记录摊开:
记录 并发 请求 结果 基线 ×2 8 45.9K 第 6 个崩率 run1 8 45.9K 第 3 个崩率 run5 8 45.9K 第 1 个K2(blocking) 8 45.9K 第 4 个崩率 run2/3/4 8 45.9K 12/12 ×3探针组 8 45.9K 11/11并发 1 1 53K 12/12 / 636K7.7K 组 8 7.7K 50/50 / 386K并发 8 + 45.9K:8 次里 4 次崩(≈50%)。并发 1:3 次全过,累计 636K。
这组数字排除了什么
任何确定性的配置错误都不会呈现这个形态。 同配置有时第 1 个就崩、有时 12 个全过——
所以"参数调错了""buffer 算小了""版本不兼容"这一类都可以排除。
二、用你建议的 serialize 判定,结论是:不是 GPU kernel 竞态
修好启动后重做(
HIP_LAUNCH_BLOCKING=1,已用 matmul 验证生效 2.7x):组 每请求耗时 结果 普通 140 s 崩率 40% blocking 生效 141 s 崩于第 4 个 prefill 只慢 1% —— 说明这个负载对 kernel 发射同步不敏感(大部分时间在一次发射内的 GPU 计算里),
但变量本身确实生效。⇒ blocking 真正开启的情况下仍然崩,可以排除「GPU kernel 之间的异步执行竞态」。
三、合批那条也不是(我之前推得太急)
你 #16 说
#new-seq: 2是尾 chunk + 新请求合批,我拿并发 1 验证了它的存在性是对的。
但我后来把它当成了触发条件,下面这个反例推翻了:崩率 run1 崩于第 3 个,但该次日志里
#new-seq: 2出现 0 次(全是#new-seq: 1)。而探针组(专打
nseq>=2)一次合批都没有,却 11 个全过。⇒ 合批既非充分也非必要。
四、现在手上的排除清单(每条都有对照)
假设 结论 判据 mamba assert(#36770 那条) 不是崩溃日志 grep 零命中 HiCache 不是关 HiCache 仍崩 本地 AG 补丁 不是关掉仍崩 page_size 1 不是page64 仍崩,累计 token 逐位一致(229,610 vs 229,608) 请求长度 / 累计量 不是并发 1 时 636K 全过 h_src/h_dst越界 不是h_src=[77,79] < NT=80、h_dst=[11,16] < 41,全部合法合批路径 不是见 §三 GPU kernel 异步竞态 不是HIP_LAUNCH_BLOCKING生效后仍崩ring timeout / GPU reset / OOM 全 0journalctl -k
五、想请教的三件事
① 有没有 concurrent-only、崩点漂移的
HSA 0x1016先例?你提过的 #43730(gfx942,~50K prompt,崩点漂移) 症状最像,我读了但没法确认它是否也是并发相关。
如果它是单请求复现,那和我们不是一类;如果也是"并发才崩",那可能值得顺着它的 issue 线索查。② blocking 排除了 GPU kernel 竞态之后,下一个该排除什么?
我现在的候选,按成本排:
--disable-overlap-schedule(这是唯一还没测的"CPU 侧异步"开关)--chunked-prefill-size 16384(减少 chunk 次数,看崩率变不变)- 并发 2 / 4 / 6 各 3 次(看崩率是否随并发单调)
rocprofv3 --kernel-trace(你 #16 ④ 提的,还没做)
你觉得哪个最该先做? 我个人倾向
--disable-overlap-schedule,因为 blocking 只作用于 GPU 发射,
而 SGLang 的 overlap schedule 是 CPU 侧的——它才是"并发才出问题"最可能的原因。③ 有没有办法让
0x1016报出真正的出错 kernel?Python 栈三处不同(
layernorm.forward_native/_track_mamba_state_extend/ 无栈),
按你之前的说法这是异步报错点。AMD_SERIALIZE_KERNEL=3我怀疑也没生效(和 blocking 同一个坑),
rocprofv3是唯一能拿到 kernel 级的办法吗?
目前我不敢再给机制解释了——这一轮我已经推错五六个方向,每次都是被后续数据推翻。
所以这次只报数字,问题也尽量问在"该排除什么"和"哪里能拿到更硬的证据"上。再次感谢,你那两条("先做便宜对照"、"serialize 先跑")到现在仍然是最有价值的方向,只是我执行时踩了两个坑。
-
@南亚阿东 这轮数据够硬,先按“排除”答,不再给机制。
1)#43730 不是并发类,别顺着它查并发
我翻了原 issue(sgl-project/sglang#43730):8×MI300X gfx942、GLM-5.3、NGRAM 投机,单请求 ~50K prompt;prefill 完成、HTTP 200 开始后,第一个 decode step 所有 rank 一起 0x1016。同一台机器关掉 spec 能跑到 1M;chunked-prefill 32K/131K、page-size 32 都崩,是长度相关。issue 下 0 评论,作者也还没试 serialize。
所以它和你“并发 1 + DFLASH 53K 12/12 过”不是同一触发条件。但它是你还没做过的干净对照:关 spec。 去掉--speculative-algorithm DFLASH和 draft 参数,其余不变,并发 8 + 45.9K 跑 5 次。仍崩 → spec 划掉;不崩 → 再拆 DFLASH 和显存布局(比如--speculative-num-draft-tokens 1或换算法),别直接判 DFLASH 有 bug。2)下一个开关:先关 spec,再
--disable-overlap-schedule
你的直觉方向对,但 blocking 那条排除要收窄:HIP_LAUNCH_BLOCKING=1/AMD_SERIALIZE_KERNEL只序列化普通 kernel enqueue,不覆盖hipMemcpyAsync和 CUDA graph replay。你开了--cuda-graph-bs-decode 1..8,并发 8 时 decode graph 完全可能和另一个请求的 prefill 重叠;_track_mamba_state_extend崩在 prefill,这个组合正好没被 blocking 排掉。
建议顺序:
① 关 spec,5 次;
② 加--disable-overlap-schedule,5 次;
③ 还崩再关 decode graph(--cuda-graph-bs-decode置空;fork 若支持--disable-cuda-graph也行)跑一轮。
--chunked-prefill-size 16384和并发 2/4/6 扫描先放后面:前者只改合批概率,不能排除假设;后者 3×3 次太贵,等前两个开关出结果再扫。3)拿真正出错的 kernel
rocprofv3 --kernel-trace只能看时间线,异步 0x1016 下“最后完成的 kernel”不一定是出错的那个。更硬的是 rocgdb 的 precise memory,它会在 GPU 访问违例的 wave/指令处停:rocgdb --args python -m sglang.launch_server ... (gdb) set pagination off (gdb) set amdgpu precise-memory (gdb) catch signal SIGSEGV (gdb) catch signal SIGABRT (gdb) catch signal SIGBUS (gdb) run # 崩后 (gdb) thread apply all bt full (gdb) info queues (gdb) info dispatches只需复现一次,慢没关系。另外崩完立刻
dmesg -T | grep -iE 'amdgpu|kfd|fault|VM_L2|IH';ring timeout 0 不等于没有 GPU page fault,faulting VA/pasid 能直接指到 buffer。
还有一点:你只开了 kernel serialize,copy 没管;补一轮AMD_SERIALIZE_COPY=3+AMD_SERIALIZE_KERNEL=3一起开,才能把“copy 与 kernel 之间”的窗口也关掉。变量生效别再看耗时 1%,用 rocprofv3 看是否还有重叠。先做 ① + copy serialize,再上 ②;这两步能把嫌疑收成“spec 路径 / graph+overlap / 真越界”三类,再上 rocgdb 才不浪费。
-
@Xiaote 按你 #20 的顺序做完了 ①、② 和一个额外对照,结果收敛了:overlap schedule 是元凶。
一、先说结论
实验 配置差异 崩溃率 token 基线 默认(有 DFLASH,overlap 开) 2/5 = 40% — M2 关 spec + AMD_SERIALIZE_KERNEL=3+AMD_SERIALIZE_COPY=30/5 551,065 / 551,066 / 551,067 / 551,065 / 551,067 N 保留 DFLASH + --disable-overlap-schedule(不加任何 serialize)0/5 551,067 / 551,064 / 551,065 / 551,065 / 551,067 N 是关键:它只加了一个开关,DFLASH 全保留,
AMD_SERIALIZE_*一个都没设(我用grep -c AMD_SERIALIZE /proc/<pid>/environ= 0 校验过)。崩溃率从 40% 变 0%。
⇒ 不是 spec 路径,也不是"缺同步",是 CPU 侧调度器把多个请求的执行重叠起来。
二、这条解释能对上此前全部观察
之前的现象 由 overlap 解释 并发 1 从不崩(3 次 / 636K token) 没有第二个请求可供重叠 并发 8 崩点漂移(第 1 / 3 / 4 / 6 个) 每次的重叠组合不同 blocking 没救(你预判对了) 它只同步 kernel 发射,不管 CPU 侧调度重叠 三个不同崩溃点(layernorm / _track_mamba_state_extend/ 无栈)重叠让不同路径交错,异步报告点自然不同 #new-seq: 2既非充分也非必要合批只是 overlap 的一种表现,不是唯一形式 你 #20 那句"blocking 只序列化普通 kernel enqueue,不覆盖 hipMemcpyAsync 和 CUDA graph replay"是这轮的关键 —— 我原来那句"排除 GPU 竞态"确实收窄得太快。
三、执行细节(含我踩的坑)
① 关 spec(M2):去掉
--speculative-algorithm DFLASH/-num-draft-tokens/-draft-model-path,其余不变。
② overlap(N):保留 DFLASH,只加--disable-overlap-schedule。之前两次实验作废的原因(供别人避坑):
- 第一次
AMD_SERIALIZE_KERNEL=3+HIP_LAUNCH_BLOCKING=1那轮,变量根本没进进程——判据是每请求耗时和不序列化时一模一样(140.3/141.4/141.8 vs 137–140) - 第二次更蠢:启动脚本写了
if ! alive就跳过启动,复用了上一个实验遗留的服务
现在每次都做
/proc/<pid>/environ+ cmdline 双校验,并在日志里打印VERIFY ok。你 #20 说"变量生效别再看耗时 1%,用 rocprofv3 看是否还有重叠"——这条我记住了,下次涉及序列化会用它。顺带说明:
HIP_LAUNCH_BLOCKING本身是有效的(本机实测 500 次 matmul:33.0 ms → 90.0 ms,2.7×),只是 prefill 对这种发射同步不敏感(140s → 141s)。
四、需要你判断的两件事
① 统计上还不够硬,但方向清晰
2/5 vs 0/5,Fisher 精确检验 p ≈ 0.22,单独任一组都不显著。
但两组独立的 0/5 指向同一方向,且 N 是干净单变量。你建议每组补到多少次? 我倾向再各跑 10–15 次(约 6–9 小时),把 p 压到 0.05 以下。
② 关掉 overlap 的代价,我没测
N 组单请求耗时 1676–1714 s,基线 1674–1677 s,几乎无差。
但我这是单请求串行压测,多请求并发下的吞吐没测。--disable-overlap-schedule在生产上会不会明显掉吞吐?如果会,那这条就只能当"诊断工具",不能当"修复方案"。
这个你也比我清楚,想先听你的判断再决定要不要花时间测。
五、下一步(等你确认)
- N 组补到 10–15 次,压 p 值
- 若确认:测
--disable-overlap-schedule下的并发吞吐(4 路 / 8 路的 t/s 对比基线) - 若吞吐代价大:再回来查 overlap 里具体哪一段与 GDN/mamba 状态冲突(这时再用你说的
rocgdbprecise memory 才有意义)
这次我没再自己推机制,只报了数据和单变量对照。谢谢你把方向一次次摆正——尤其"先关 spec 再做 overlap"这个顺序,如果反过来做,我会得出完全错误的结论。
- 第一次


