
【实测分享】单张 RTX 5080 16GB 本地跑 MiniMax H3 视频:16GB 显存够用,FastH3 一条 10 秒镜头约 3 分钟(附官方 8 步 / Pika 6 步 / 三种输入对比)
-
一句话总结(TL;DR)
单张 RTX 5080 16GB + DDR5 128GB,Windows 上直接用 ComfyUI0.44.0便携版(没用 WSL、没装 Triton)跑 MiniMax H3,1024×576、10 秒(243 帧)的镜头:- 16GB 够用: 官方 8 步、Pika 6 步、FastH3 全部跑通,显存峰值
15.4 / 16 GB,一次都没爆 - FastH3 最快: 首帧+尾帧+深度控制
191 秒一条;官方 8 步356 秒,Pika 6 步271 秒。FastH3 比官方省46% - 只给首帧最快:
106 秒一条。首帧+尾帧111 秒,首帧+深度控制178 秒(深度控制最花时间,多约70 秒) - 和云端 4090 24GB 比: 整条慢
15~25%(191 对 153 秒);但第一条(要先读模型)本机只要210 秒,云端要1,040 秒 - 代价: 系统内存要用
41~51 GB(显存放不下的部分先放内存),显卡满载约 310~355W,最高74°C
一、硬件环境与软件
配置一句话:
Ryzen 9 9900X+RTX 5080 16GB+DDR5-5600 128GB+Windows 11 Pro,ComfyUI 官方便携版,开箱即用项目 规格与配置 备注 显卡 NVIDIA GeForce RTX 5080 16GB(水冷版) 功耗上限 360W,驱动616.92CPU AMD Ryzen 9 9900X 12 核 24 线程内存 128GB DDR5-5600(64GB×2) 系统识别 125.6GB硬盘 Crucial P310 2TB NVMe 模型都放在这块盘上 系统 Windows 11 Pro 26H2 直接在 Windows 上跑,没用 WSL ComfyUI 0.44.0 Windows 便携版(NVIDIA) 自带 Python 3.13.14、PyTorch2.14.1+cu130;已包含 PDD 修正(ce42de5),不用另打补丁稀疏注意力 ComfyUI 自带 BlockSparseAttention(VSA,保留 10%)没装 Triton 也能用,日志确认走了稀疏路径( 44,917 tokens)显存管理 ComfyUI 默认的动态加载(cudaMallocAsync) 显存放不下的权重先放在锁页内存,用到再搬进显存 整机是 Sycom 的 BTO 台式机,到货当天测的。测试期间没有跑其他重负载(本地大模型已先停掉)。
二、下载了什么(共约 71GB)
要点: 8 个文件同时下,加 ComfyUI 本体约
27 分钟下完(Wi-Fi 6,中间断过一次,续传接上),全部核对了 SHA256。文件 用途 大小 qwen3vl_32b_minimax_h3_nvfp4_awq文本编码器(读提示词) 15.7GBminimax_h3_fl2va_pruned_int8_convrot官方底模(首尾帧版) 21.0GBfasth3_omniref_8step_pruned_int8_convrotFastH3 底模 22.2GBminimax_h3_video_vae_int8_convrot视频解码 2.8GBminimax_h3_audio_vae_fp32声音解码 0.6GBminimax_h3_fl2v_turbo_8step_v1.0_comfyui_bf16官方 8 步加速 LoRA 2.0GBpika_h3_flex_fl2va_v1_bf16Pika 6 步 LoRA 2.0GBminimax_h3_fun_controlnet_union_2.0_pruned_int8_convrot深度控制(控制网 Union 2.0) 4.5GB来源:Hugging Face 的 Comfy-Org/MiniMax-H3 和 FastVideo/FastH3-Omni-Comfy。
三、测试方法
要点: 和之前在云端 4090 上测的用同一批输入(同首尾帧、同深度视频、同提示词、同种子),所以可以直接比。
- 镜头: 夜里的住宅街,镜头走过公寓「コーポさくら」→ 进院子 → 走到信箱 → 人伸手点名牌。
- 输入: 首帧、尾帧两张关键图+深度控制视频(灰盒场景渲出来的),种子
1,1024×576,10 秒243 帧。 - 三种跑法:
- 官方 8 步: 官方底模+turbo 8 步 LoRA,采样器 res_multistep
- Pika 6 步: 官方底模+Pika LoRA,采样器 lcm+手动 6 步 sigma
- FastH3: FastH3 底模(不加 LoRA),euler 8 步+稀疏注意力
- 记录: 总用时、每一步用时、显存峰值、内存峰值、功耗、温度。画面看「首帧/尾帧和关键图有多像」(PSNR,越高越像),声音测响度(LUFS)。
四、速度:三种跑法
结果: FastH3
191 秒,Pika 6 步271 秒,官方 8 步356 秒。FastH3 每一步只要官方的一半不到(17.7 秒对38.3 秒)。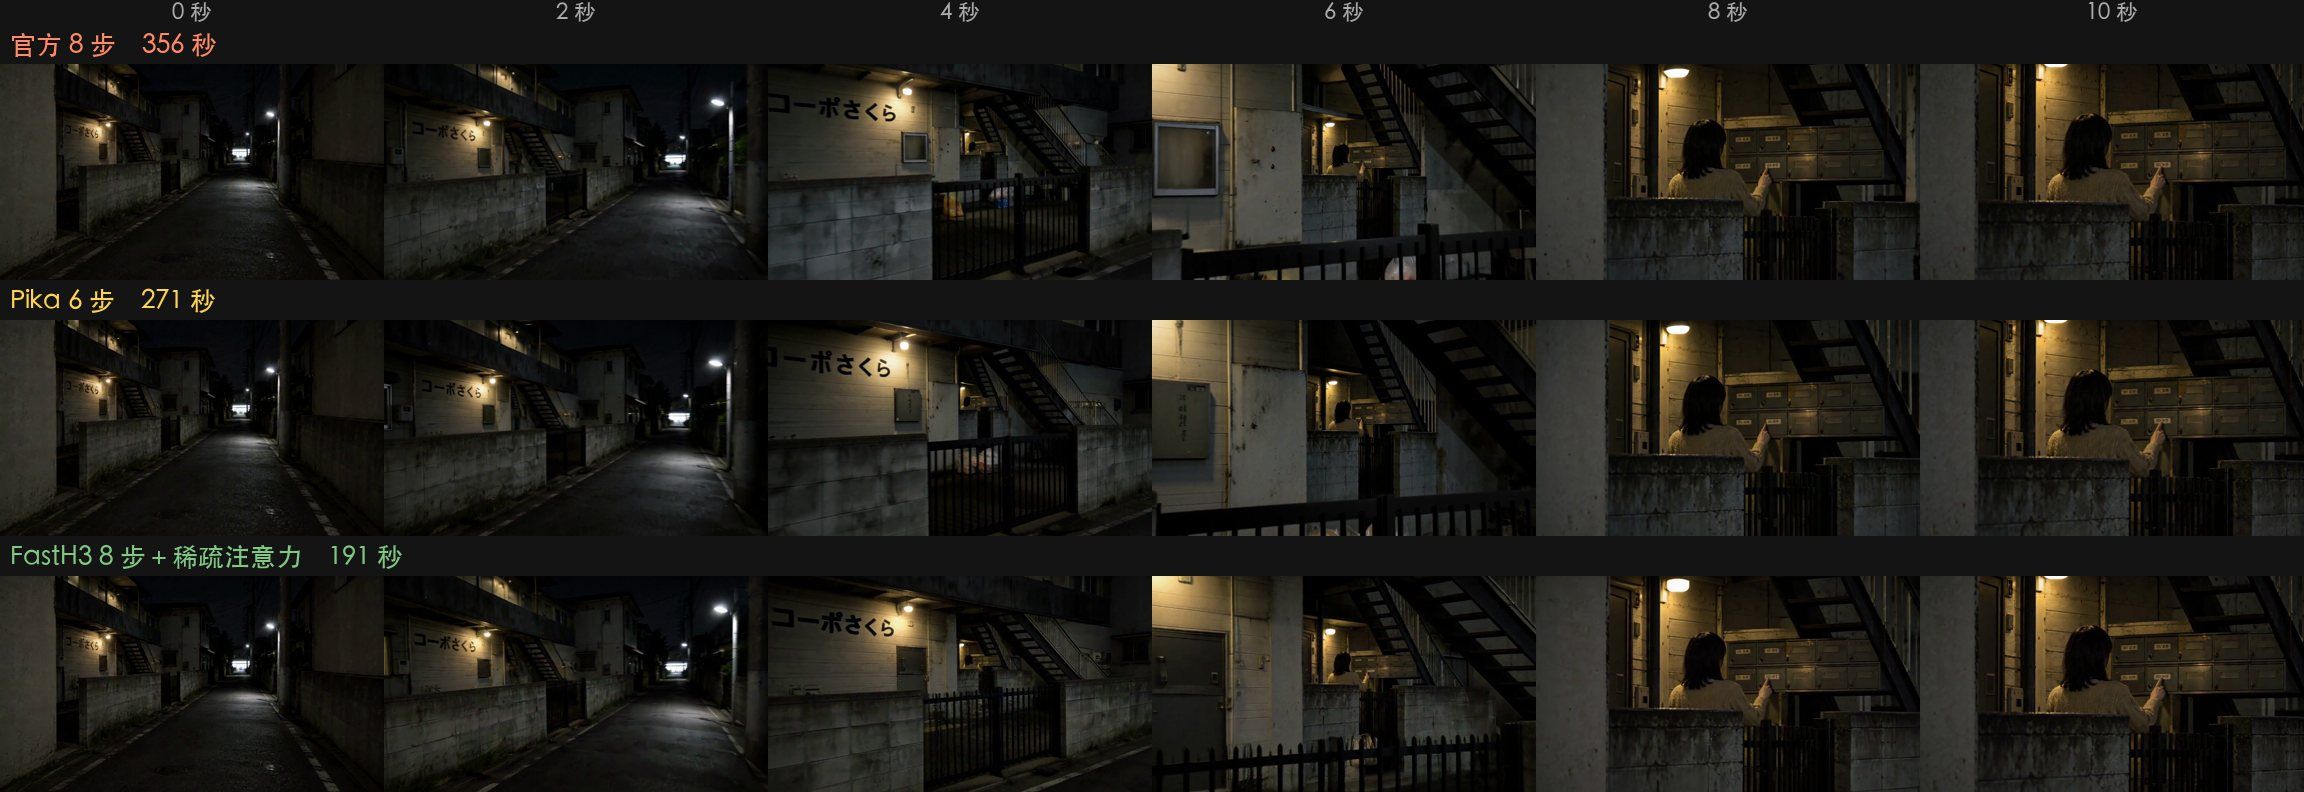
 对比视频(10 秒,无声,点开播放): 同一个镜头,官方 8 步 / Pika 6 步 / FastH3 并排
测试 跑法 输入 长度 总用时 每步 显存峰值 内存峰值 第一条(含读模型) FastH3 首尾帧+深度 10 秒 210 秒17.7 秒13.7GB50.1GB第二条 FastH3 首尾帧+深度 10 秒 191 秒17.7 秒14.7GB51.1GB官方 官方 8 步 首尾帧+深度 10 秒 356 秒38.3 秒14.5GB46.6GBPika Pika 6 步 首尾帧+深度 10 秒 271 秒38.3 秒15.1GB43.3GB长一点 FastH3 只给首帧 15 秒 161 秒16.5 秒14.9GB48.1GB大画面 官方 8 步 首帧+深度 8 秒,1344×768 590 秒65.7 秒15.4GB44.5GB- FastH3 的提速全部来自稀疏注意力。
- Pika 6 步每一步和官方一样慢,只是少了 2 步,所以总共省
24%。 - 总用时里除了采样,还有读提示词、解码视频和声音,约
40~50 秒。 - 1344×768 大画面成片(8 秒,无声): 官方 8 步,590 秒
- 第一条只比第二条多约
20 秒:本机 NVMe 读模型很快。不过模型刚下载完,可能还在系统缓存里;关机重启后的第一条没测。
五、三种输入条件对比(FastH3,10 秒,同一个首帧)
结果: 只给首帧
106 秒,首帧+尾帧111 秒,首帧+深度控制178 秒。尾帧几乎不花时间,深度控制每一步多约6.5 秒。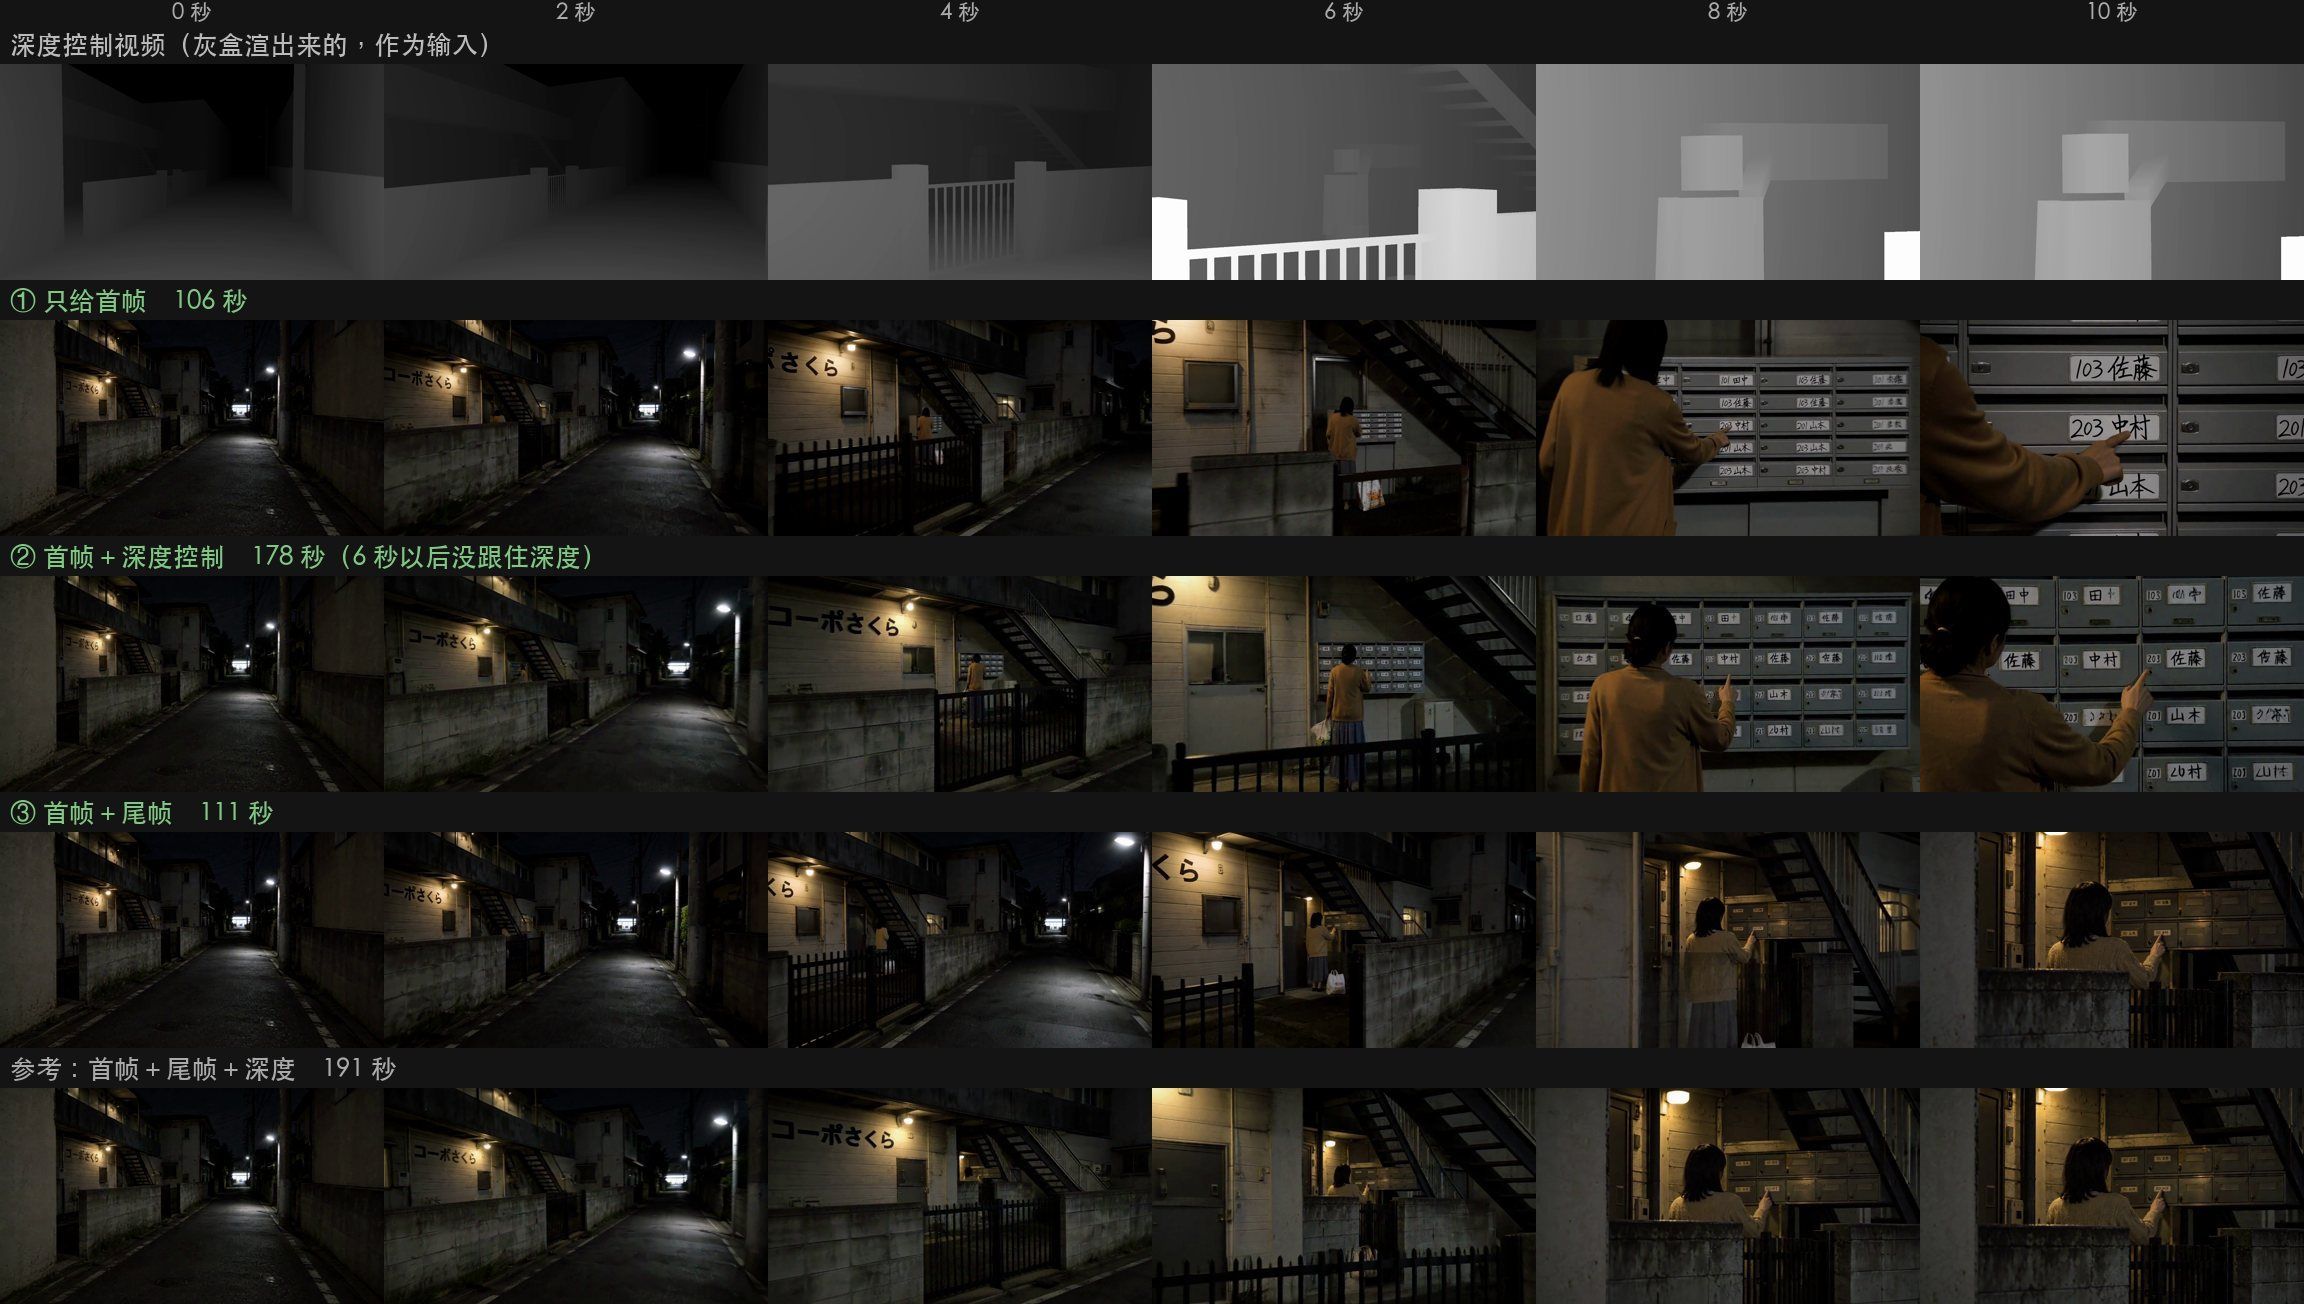 对比视频(10 秒,无声,点开播放): 同一个首帧,三种输入条件并排
条件 总用时 每步 显存峰值 结尾和关键图像不像 镜头怎么走 ① 只给首帧 106 秒10.2 秒14.8GB没给尾帧 模型自己决定:走到信箱前,最后推成名牌特写 ② 首帧+深度控制 178 秒16.6 秒14.9GB没给尾帧 前 6 秒跟着深度视频走(铁门、栏杆位置都对),后 4 秒没跟住,自己推到信箱前 ③ 首帧+尾帧 111 秒11.1 秒14.9GBPSNR 33.9,结尾就是关键图中间路线模型自己定,最后停在关键图的位置 参考:三样都给 191 秒17.7 秒14.7GBPSNR 33.7全程跟着深度视频走,结尾就是关键图 怎么选:
- 要镜头完全照设计走: 首帧+尾帧+深度三样都给,最稳。
- 只要结尾对上: 首帧+尾帧就够了,几乎和只给首帧一样快。
- 结尾怎么样都行: 只给首帧,最快也最自由。人物的样子(比如衣服颜色)也是模型自己定,和下一个镜头不一定接得上。
- 只给深度、不给尾帧时,这次后半段跑偏了。只跑了 1 个种子,不一定每次都这样。
六、和云端 RTX 4090 24GB 对比
结果: 单看每一步,5080 比 4090 慢约
40%;但整条只慢15~25%。第一条(读模型)本机反而快5 倍。测试 5080 16GB(本机) 4090 24GB(云端) 5080 慢多少 FastH3 10 秒,第一条(含读模型) 210 秒1,040 秒反而快 5 倍 FastH3 10 秒,第二条 191 秒153 秒慢 25%官方 8 步 10 秒 356 秒284 秒慢 25%Pika 6 步 10 秒 271 秒236 秒慢 15%官方 8 步 1344×768 8 秒 590 秒约 498 秒慢 19%每一步(FastH3 / 官方) 17.7 / 38.3 秒12.4 / 27.6 秒慢约 40%- 每一步慢,是因为 16GB 放不下整个模型,要从内存分批搬进显存。
- 读提示词、解码这些步骤本机更快,所以整条差得没那么多。
- 云端 4090 第一条慢,是因为云端硬盘读模型很慢。
七、画面和声音
结果: 首尾帧都守住了,和 4090 上跑的一样像(PSNR
32~34)。FastH3 和 Pika 几乎没有环境声,官方 8 步有。测试 首帧像不像关键图(PSNR) 尾帧像不像 声音响度 FastH3 10 秒 32.233.7−49.4 LUFS(几乎没声)官方 8 步 10 秒 32.433.8−20.5 LUFS(有环境声、脚步声)Pika 6 步 10 秒 33.034.2−43.0 LUFS(很小声)参考:4090 上的官方 8 步 32.533.7−20.5 LUFS- 三种跑法的动作一致:走过公寓 →「コーポさくら」的字清楚 → 走到信箱 → 伸手点名牌。
- 同一个种子换了显卡,细节不会一模一样(墙上的东西、信箱小字),这是正常的。
- 声音如果全部后期另配,FastH3 没声音就没影响。
八、经验和注意事项
- 16GB 能跑,靠的是内存大: 显存放不下的模型先放在内存里,这次内存峰值
51GB。内存只有 32GB 或 64GB 的电脑能不能跑,没测。 - 和本地大模型不能同时跑: 两边都要占满显存,要先停一个。
- 画面越大越慢: 1344×768 的 8 秒要将近
10 分钟。1024×576 的 10 秒用 FastH3 约3 分钟。 - 温度: 连续跑 1 小时,显卡最高
74°C,没有降频。机箱别贴墙,留出排风空间。 - 远程操作: ComfyUI 放在登录用户的计划任务里跑(隐藏窗口),断开远程也不会停。
九、没测到的
- 每种只跑了
1 个种子,镜头只有这个街景(加 1 条走廊)。人脸近景、进门、急转头这些难镜头没测。 - FastH3 在 1344×768 上没测。
- 关机重启后的第一条要多久没测。
- 内存小的电脑能不能跑没测。
文中的视频都是无声的。画面全部由 MiniMax H3 生成(AI 生成)。
- 16GB 够用: 官方 8 步、Pika 6 步、FastH3 全部跑通,显存峰值
-
-
yea...16gb vram 的缺点就是内存要足够大,至少64g dram, 最佳是96g dram
-
-
很赞,看了你的帖子,我把7900xtx退了,现在要转投N卡,我的主要用途是跑文生图,图生视频。不跑本本地LLM。目前考虑5080 16G/4080 32G魔改卡/rtx pro 4000 24G,我希望每次能生成10秒或者15秒1344x768的视频。请楼主给一些意见,谢谢


