[H3剑心比赛] RTX 3080 20G 魔改 单卡|1344×768 / 12 秒|20 步稠密
-
[H3剑心比赛] RTX 3080 20G 魔改 单卡|1344×768 / 12 秒|20 步稠密,不挂加速 LoRA
一、口径
按题目统一前提:MiniMax H3、1344×768、12 秒、统一提示词、6 张参考图,3D 一个 2D 一个。
提示词正文一字未改,没有加参考图绑定说明、没有加负面词、没有加
<Picture N>引用句,两版只换第一行的风格描述。人物身份完全交给 Ref2VA 的参考 latent 在每一步注入。成片:
二、硬件
- GPU:NVIDIA RTX 3080 20G(GA102 魔改显存 20480 MiB,sm_86),非原厂 10G
- 驱动:580.178.04 / CUDA 12.6;功耗上限 320 W(实测负载 306~318 W,SM 频率 1635~1830 MHz 掉频)
- 链路:PCIe 3.0 × 16(空闲降速至 Gen1)
- 显卡补丁:gpu_unlock v2.0.0(解除 GeForce FP16/BF16 半速限制;实测 fp16/bf16 均 106 TFLOPS)
- 平台:华南金牌 X99-TF + Xeon E5-2696 v3(18C/36T,无 AVX-512)+ 128 GB 内存(4/24 槽)
- 系统:Ubuntu 24.04.5 LTS / 内核 7.0.0-42-generic
- 显存峰值:8,852 MiB(3D)/ 8,828 MiB(2D)——不是卡的上限,是切片节点主动留的余量(见第四节与第八节)
三、模型与工作流
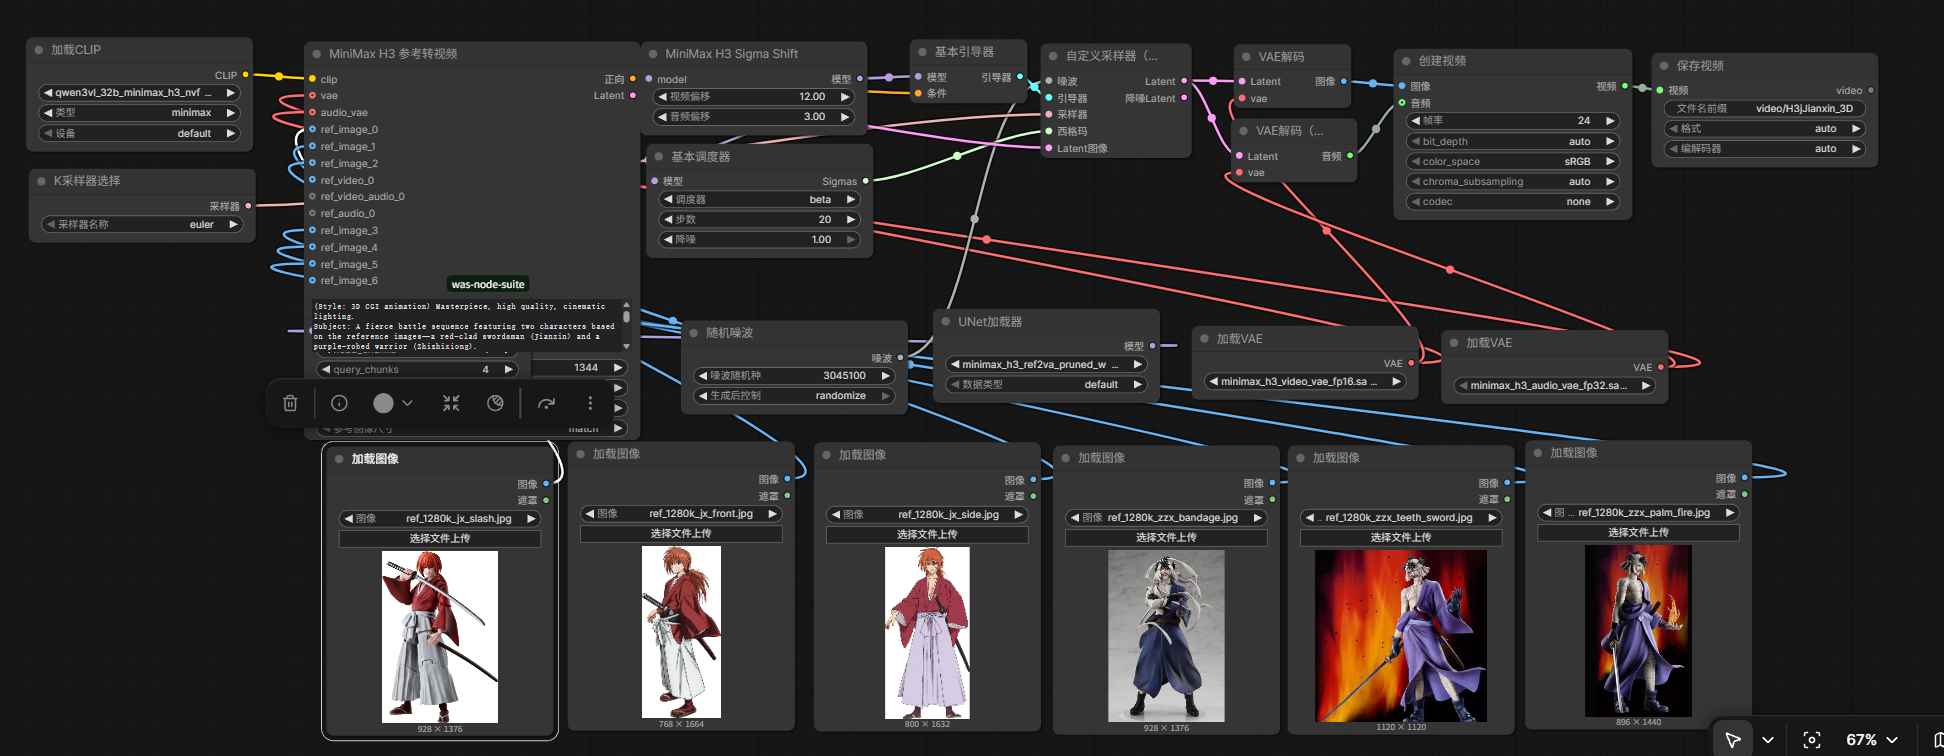
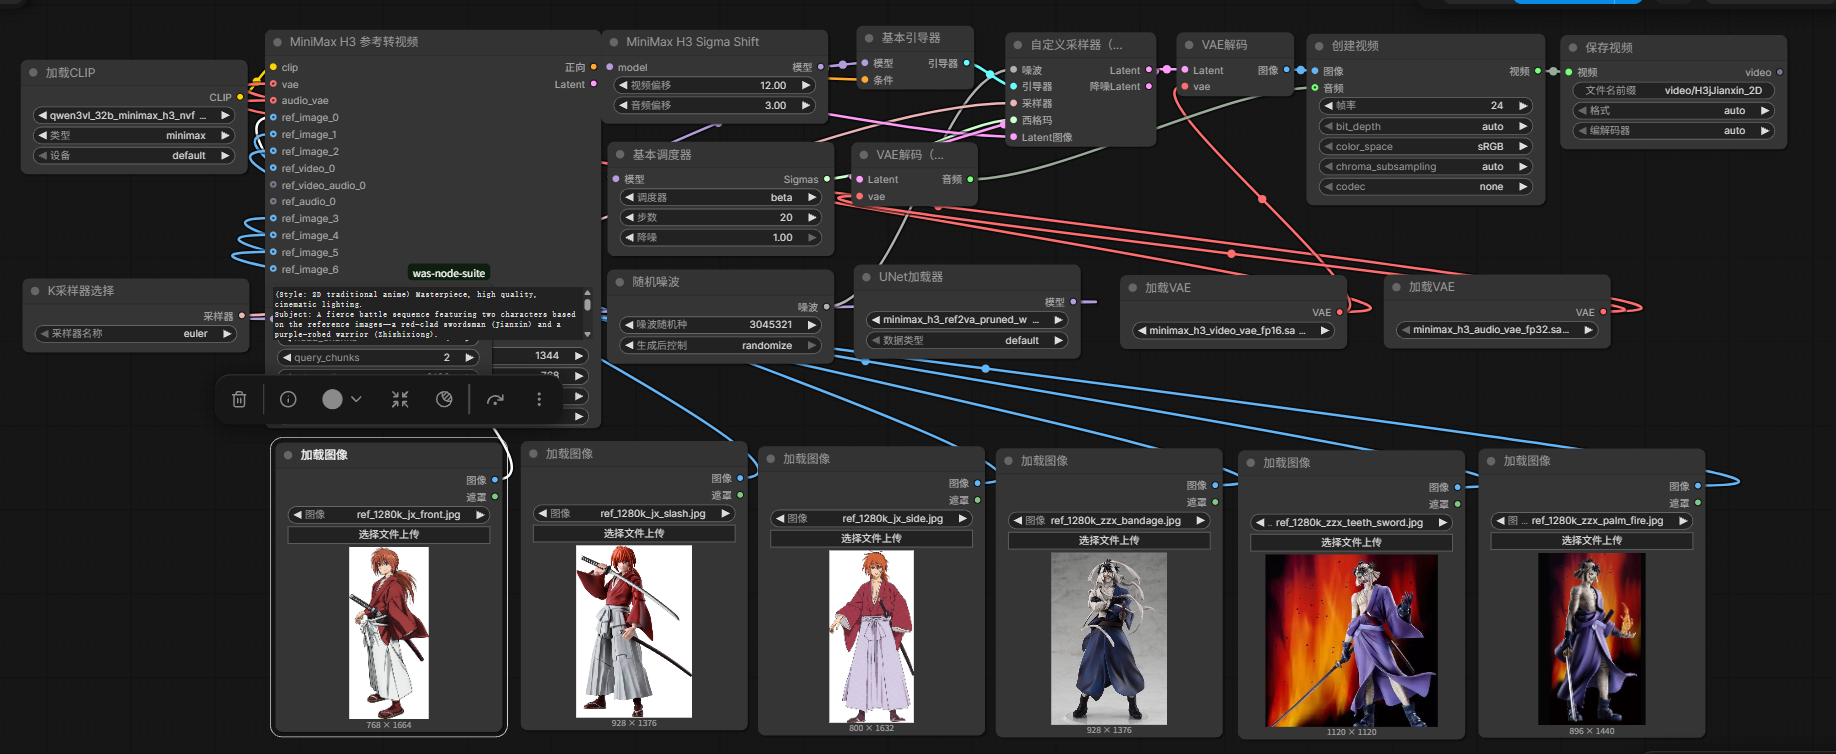
- DiT:
minimax_h3_ref2va_pruned_w6a8.safetensors(官方 Comfy-Org repack,w6a8 量化,15.98 GB) - 文本编码器:
qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors(15.69 GB) - VAE:
minimax_h3_video_vae_fp16(5.21 GB)+minimax_h3_audio_vae_fp32(0.61 GB) - 采样:
euler+beta调度器,20 步稠密,不挂任何加速 LoRA - SigmaShift:video 12.0 / audio 3.0
- 参考图:Ref2VA 挂 6 张,
ref_image_size=match - 帧数:294(17n+5 对齐,24fps 下 12.25 秒,非硬填,导出不裁)
- 种子:3D 3045100 / 2D 3045200,均固定
- 框架:ComfyUI 0.44.2(e6515b16),PyTorch 2.14.0+cu126,Python 3.11.16
主链:
UNETLoader(ref2va w6a8)
 → WASH3LowVRAM(token_slice, query_chunks, head_chunks)   ← 20G 卡保命节点
 → MiniMaxH3SigmaShift(12 / 3)
 → BasicScheduler(beta / 20 步 / denoise 1.0) ─┐
 → BasicGuider ← MiniMaxH3ReferenceToVideo     ├→ SamplerCustomAdvanced(euler)
                  ↑ 6 张参考图 + 统一提示词原文 │
                                                ↓
                                 VAEDecode / VAEDecodeAudio → CreateVideo(24fps) → SaveVideo
工作流原件(API 格式,可直接
POST /api/prompt复现):见附件工作流_3D.json、工作流_2D.json。参考图预处理(身份能不能对上的关键,务必照做):论坛原图只有 0.27~0.44 MP(350×760、438×700、564×562…),直接原样喂进去,参考 token 信息量不够,生成的人会变成"按文字自己编的红衣剑客"。本工作在喂入前统一重采样到 约 1.28 MP(lanczos,长宽比保持,边长对齐 32 的倍数;等效 LayerUtility: ImageScaleByAspectRatio V2 的
total_pixel 1280档):槽位 原始 处理尺寸 内容 ref_image_0 350×760 768×1664 剑心 正面立绘·白底 ref_image_1 976×1456 928×1376 剑心 横刀/拔刀·白底 ref_image_2 1378×2821 800×1632 剑心 侧面/前伸·白底 ref_image_3 550×800 928×1376 志志雄 绷带正面·灰底 ref_image_4 564×562 1120×1120 志志雄 露齿+持刀·火焰背景 ref_image_5 438×700 896×1440 志志雄 手持火焰 3D 版把 3D 手办图放主槽(ref_image_0),2D 版把 2D 动漫立绘放主槽;两版六张图全用满。
四、加速手段
- 量化算子:comfy_kitchen 原生 int8 路径;日志
Native ops: w6a8_int8, int8_tensorwise, asym_w4a8_int8, convrot_w4a4,emulated: nvfp4, mxfp8, float8_* - 权重:w6a8(6 bit 权重 + 8 bit 激活),比 int8 convrot 版少 5 GB
- 低显存补丁:WAS Node Suite
WASH3LowVRAM(除注意力外全部按 token 切片,数学等价) - 启动参数:
--cache-none --disable-dynamic-vram --lowvram - 显存分配:
PYTORCH_CUDA_ALLOC_CONF=expandable_segments:True - 未使用 SageAttention / SOL / flash-attn / CK-flash
- 未使用 任何 turbo / LCM / 蒸馏 LoRA,也未降分辨率、未二次超分、未补帧
切片档位:
版本 token_slice query_chunks head_chunks 3D 4096 4 4 2D 8192 2 4 五、生成速度(1344×768 / 294 帧 / 20 步稠密)
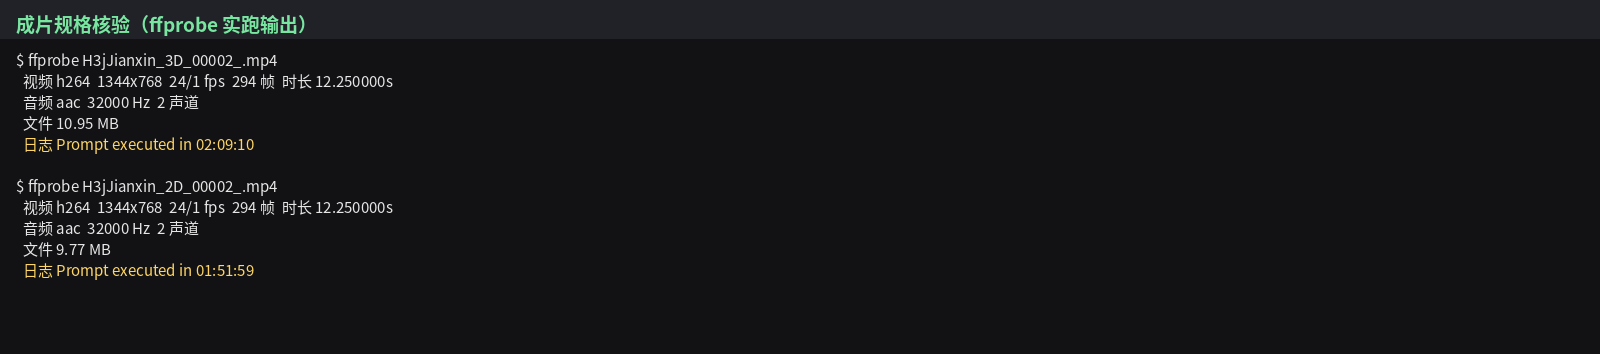
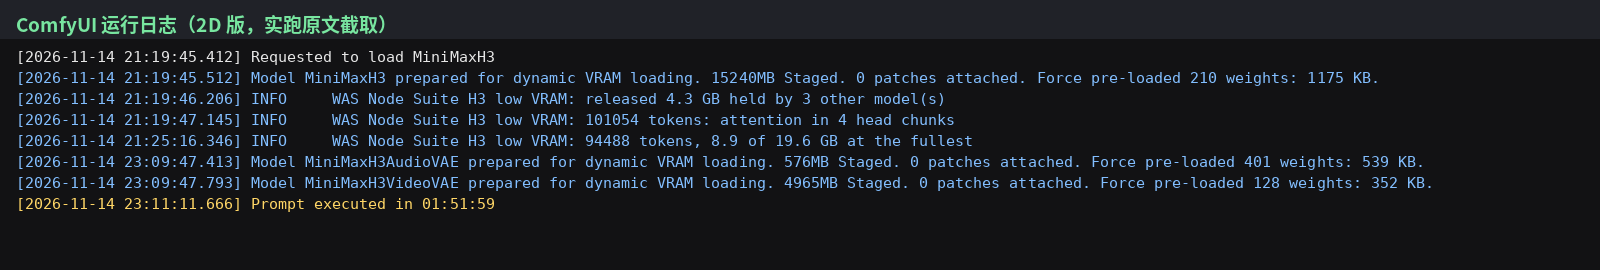
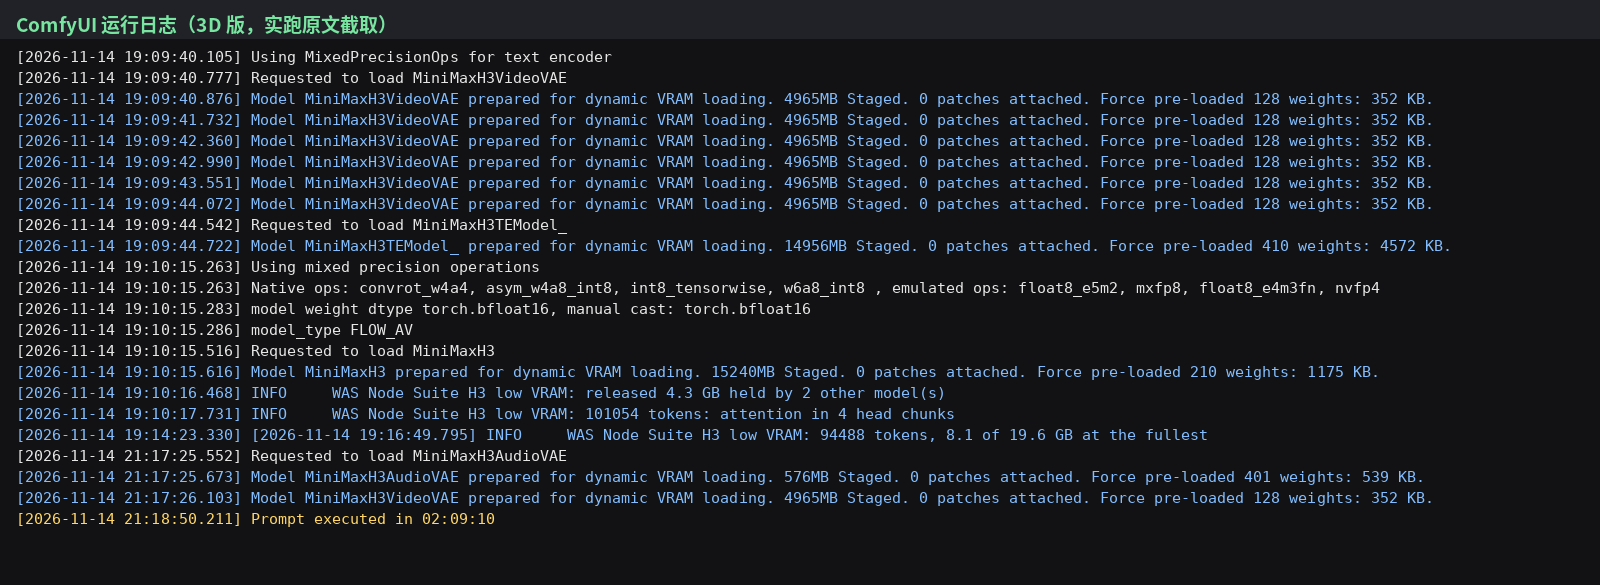
版本 端到端 日志 Prompt executed in采样段 折算每步 显存峰值 3D 7,749 秒 02:09:107,630 秒 381.5 s/it 8,852 MiB 2D 6,719 秒 01:51:596,602 秒 ≈328 s/it 8,828 MiB - 非采样部分:3D 约 119 秒(DiT 15.98 GB + 文本编码器 15.69 GB 冷加载 + VAE 解码),2D 约 117 秒
- 参考 token 总量:94,488 tokens(294 帧视频 + 6 张 1.28 MP 参考图),切片节点自报
94488 tokens, 8.9 of 19.6 GB at the fullest - GPU 全程 100% 利用率、306~318 W / 320 W、59~61 °C
- CPU 单核被打满(101%) —— 切片是 Python 侧循环,这是本机的重要瓶颈
切片档位对速度的影响(同卡同分辨率):4096/4 → 8192/2,129 分钟降到 112 分钟,快 13%,再往上收益有限。
六、同口径对照
步数不是题目规定的,各人自选,所以只看总时间没有可比性。按"同等步数"和"同等显存档"各取一组参照。
同等步数(20 步稠密)
4090 D 48G(3053 帖,20 步 + 两档 sigma 精修 ≈22 次前向) 4080 SUPER 16G(3063 帖,20 步稠密) 本机 3080 20G 魔改(20 步稠密) 端到端 9 分 15 秒 / 9 分 30 秒 20 分 51 秒 / 20 分 52 秒 2 小时 09 分 / 1 小时 52 分 折算单步 约 25 秒 59.8 秒 381.5 / 328 秒 倍数 1× 2.4× 15.3× / 13.1× 显存峰值 48 GB 卡整只装入 15.9 GB(贴边) 8.85 GB(主动留余量) 同等显存档(8 步):7900 XTX 24G 单卡(3049 帖)报 201.63 s/it、纯采样 26 分 53 秒、端到端 29 分 30 秒。本机没跑过 8 步档,不硬换算。
这个差距怎么来的(能测的部分)
- 切片开销(本机自测):同一张卡、同分辨率、294 帧,不挂切片时的 4 步档实测约 175 秒/步;挂上 WAS token 切片 + 参考图后是 381 秒/步。切片约带来 2.2 倍单步成本。它是 Python 侧循环,CPU 单核被打满,这是最直接的一条。
- 没有 SageAttention:3063 帖同卡自测 Kitchen 比 Sage 慢 16.6%。我们跑的是 comfy_kitchen eager 后端,且
nvfp4 / float8_*在 sm_86 上走模拟(日志原文),不是原生。 - w6a8 vs int8 convrot:20 GB 卡装不下 int8 convrot 版 DiT(20.97 GB)。实测它加载后即 OOM:
Currently allocated 18.48 GiB / Requested 124.36 MiB / Device limit 19.58 GiB。只能退到 w6a8,6 bit 权重每层都要反量化。 - 架构与功耗:3080(sm_86)对 4080 SUPER(sm_89),fp16 吞吐差约 1.6 倍、int8 差约 2 倍;本卡功耗墙 320 W,负载下 SM 频率在 1635~1830 MHz 来回掉。
- 平台不是差异来源:3063 帖是同一块 X99-TF + 同一颗 E5-2696 v3,PCIe 3.0 x16、H2D 约 10.1 GB/s,与本机同档,所以差距主要不在内存/PCIe 上,而在上面 1~4 条。
一个反向数据点:本机之前用 KJNodes 分块(head_chunks=8 / FF 4)跑过一条 294 帧 4 步片子,端到端 13 分 39 秒(175 s/step)。也就是说这张卡在 4 步档能跑到 13 分钟量级,2 小时的代价是"20 步稠密 + 参考图真正生效 + 切片保命"三者叠加出来的,不是卡本身只能这么慢。
七、三个坑,报给社区
-
H3 Ref2VA 的参考图在 API 提交时必须用点分扁平键:
"ref_images.ref_image_0": ["30", 0]。写成嵌套字典{"ref_images": {...}}时不报错、任务成功、日志干净,但参考图被静默丢掉。
本机验证方法:同一 seed/提示词/尺寸,分别喂(A)6 张真参考图、(B)6 张纯色块、(C)完全不喂图,三组成片帧级 MD5 完全相同;改成点号键后,探针才打出minimax_refs=6 / with_latent=6,红发白袴、绷带、露齿这些参考图独有特征才开始出现。这与 3063 帖的结论一致(他用 SSIM 1.000000 判定),可互证。 -
参考图分辨率必须补上来。原图 0.27~0.44 MP 太糊,参考 token 不够;重采样到约 1.28 MP 后,同 seed 下人物外形与参考图的对应关系肉眼可见地变好。注意
ref_image_size=match这档是"只缩不放",救不了小图,必须先自己做重采样。 -
20 GB 卡专属:294 帧 + 6 张参考图时,qkv/fc 这类线性层会一次性申请 4.05 GiB 连续显存,必爆。KJNodes 的 head 分组 + FFN 分块切不掉这一块,必须上 token 维度切片(本机用 WAS
WASH3LowVRAM)。
八、如实说明(别被我这楼带偏)
- 本机没做过"换灰图"对照,所以不声称"参考图是身份还原的唯一来源"。但修复点号键之后,参考图独有特征(剑心红发/白袴、志志雄绷带/露齿)确实出现了,修复前完全是另一批"国风帅哥"——这是 A/B 实测,不是印象。
- 3D 版是半 3D:电影级光影与材质,但人物五官仍是动画式,不是写实 CG。
- 两条末帧都是两人正面持械,绷带头、碎发、白飘带肉眼可辨;剑心左颊十字疤、志志雄锯齿刀在 1344×768 下抽帧看不清。
- 2D 版中段有约 2 秒停留在刀刃相抵的构图(有火花与镜头抖动,不算卡死),节奏偏慢。
- 显存峰值 8.85 GB 不是这张卡的上限,而是切片节点按
192 KB/token × 切片 + 3 GB 固定开销 + 768 MB 余量自己定的保守预算——还有约 11 GB 没用上,所以这条时间数据偏保守,不代表 20G 卡的极限。
九、附件
文件 说明 工作流_3D.json/工作流_2D.jsonAPI 格式工作流,可直接提交复现 提示词_3D.txt/提示词_2D.txt逐字提示词原文 运行日志_3D.png/运行日志_2D.png完整运行日志截图,含 Prompt executed in 02:09:10与01:51:59规格核验.pngffprobe 实跑输出(1344×768 / 294 帧 / 24fps / 12.25s / AAC 32kHz 立体声) 参考图_1.28MP.zip6 张重采样后的实际入参图 成片_3D.mp4/成片_2D.mp4成片原文件(与 YouTube 同源) 十、结论
20 GB 单卡在 20 步稠密 + 6 张参考图真实生效的前提下,1344×768 / 12 秒 H3 单条约 2 小时,单步 328~382 秒。
同口径对照显示,这个数字的主因不是"3080 算力只有 4090 的十五分之一",而是三层叠加:
- 显存不够 → 必须 token 切片 + 权重流式换入(约 2.2 倍单步成本,本机实测)
- 没有 SageAttention、sm_86 上 nvfp4/fp8 走模拟、只能用 w6a8 而非 int8 convrot
- 320 W 功耗墙 + sm_86 与 Ada 的代差
这张卡在 4 步档能跑到 13 分钟/条(本机实测 13 分 39 秒),说明它并非不能干活;想在这种卡上进到十几分钟,只能压步数或降分辨率二次超分——那是另一种口径,我没在这两条片子上这么做。
-
,X xbinb0 引用了 此主题
-
-
-
-
-
-
-
-
-


 版主审定:本帖设为优秀,作者 +3 积分奖励,继续加油!