
【H3剑心比赛】R9700 32 GB 单卡|MiniMax H3 3D / 2D
-
志在参与学习,不太懂怎么调整影片,请大家多多指教!
一、视频链接
二、软硬件配置
项目 配置 GPU AMD Radeon AI PRO R9700 32 GB,gfx1201(单卡) 功耗上限 230 W CPU / 内存 Xeon E5-2696 v4 / 125 GB ComfyUI 0.41.0 ROCm 7.2.4 PyTorch 2.12.1+rocm7.2 comfy-kitchen 0.2.38 三、工作流
- 3D:[ui_workflow_lcz3045_3d.json] ui_workflow_lcz3045_3d.json
- 2D:[ui_workflow_lcz3045_2d.json] ui_workflow_lcz3045_2d.json
(两份都是 ComfyUI 里 File → Open 直接开的前端工作流,22 节点;2D 与 3D 只差提示词第一行的风格描述)
四、加速手段
- 4-bit W4A8 权重(11.68 GiB,官方 int8 版 19.53 GiB 在此画布会 OOM)
- 4 步 Turbo ref2v LoRA(0.70)
- comfy kitchen attention(同一台机实测:115.6 s/it;换回 SDPA/AOTriton flash 是 359.9 s/it,差 3.1×)
- 文字编码器
device=cpu+ 图上挂VRAMCleanup,采样前腾出 15 GB 显存
五、生成速度
第一轮(3D 风格) 第二轮(2D 风格) 每步耗时 115.8 s/it 115.6 s/it 纯采样 7 分 43 秒 7 分 42 秒 端到端 11 分 52 秒 11 分 48 秒 文件 final_1344x768_288f_12s.mp4(18.3 MB) final_1344x768_288f_12s.mp4(20.3 MB)
- 日志截图(ComfyUI 服务端 stdout,含每步 s/it 与
Prompt executed)
第一轮(3D 风格)
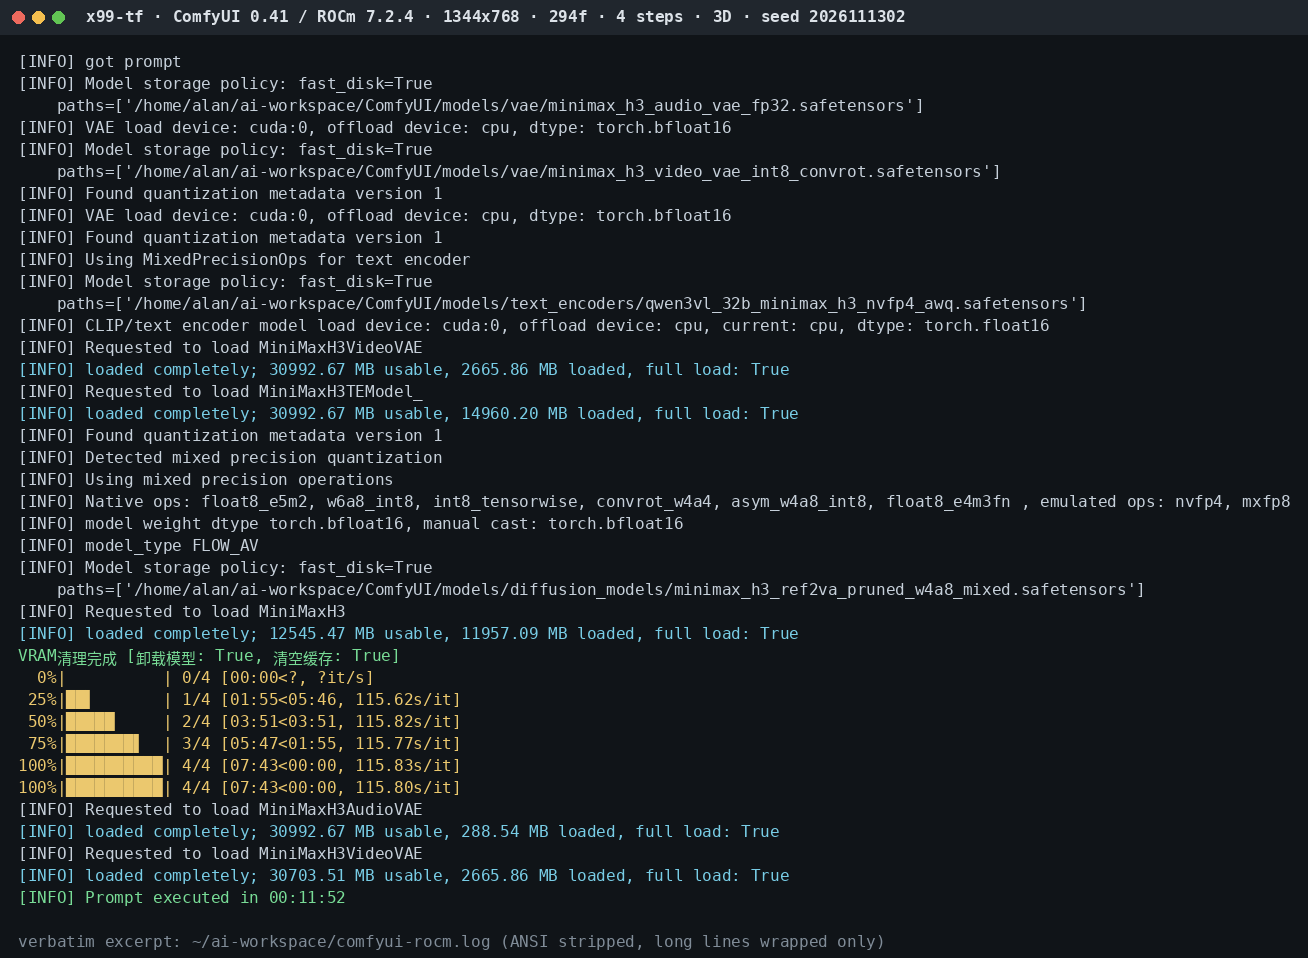
第二轮(2D 风格)
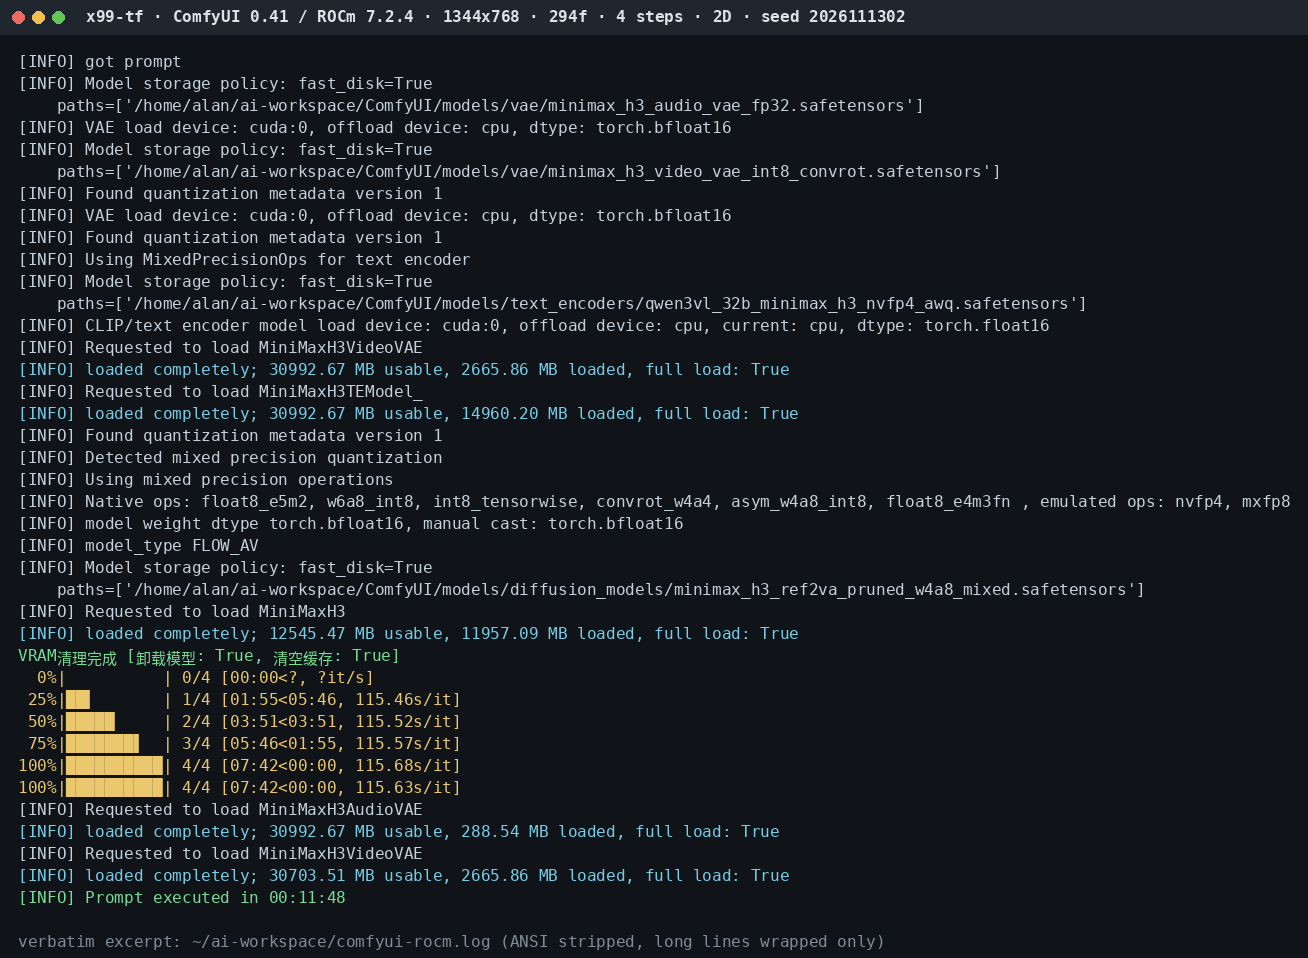
-
,
 A alan.lgv60 引用了 此主题
-
-
【H3剑心比赛】R9700 32 GB 单卡 20 步重发|MiniMax H3 3D / 2D
这是重发。上一帖(topic/3089)的评审原话是:「太糊了,不予通过,重发可以继续评审」。
特别是快速动作时,画面特别糊,试着改善动态模糊的情况。
上一版的配置是 4-bit W4A8 权重 + 4/8 步蒸馏 LoRA + kitchen INT8 注意力,11:52/条。
这一版改成官方 int8 权重 + 20 步、不用蒸馏 LoRA,端到端 2:23:04(3D)/ 2:22:43(2D)——慢 12 倍,换取细节。
两版的差别在细节清晰度;快动作拖影两版都有,第六节只写已确认的事实与我未确认的部分。一、视频链接
- 3d风格:
<YouTube 链接·3D> - 2d风格:
<YouTube 链接·2D>
二、软硬件配置
项目 配置 GPU AMD Radeon AI PRO R9700 32 GB,gfx1201(单卡) 功耗上限 230 W CPU / 内存 Xeon E5-2696 v4 / 125 GB ComfyUI 0.41.0 ROCm 7.2.4 PyTorch 2.12.1+rocm7.2 comfy-kitchen 0.2.38 三、工作流
- 3D:[ui_workflow_lcz3045_3d.json]ui_workflow_lcz3045_3d.json
- 2D:[ui_workflow_lcz3045_2d.json]ui_workflow_lcz3045_2d.json
(两份都是 ComfyUI 里 File → Open 直接开的前端工作流,21 节点:官方 int8 权重、20 步、无蒸馏 LoRA;
2D 与 3D 只差提示词第一行的风格描述。回读验证过节点与1344 / 768 / 294 / match全部正确。)四、加速手段
不用加速。这一版走画质优先,做法与 topic/3105、3114 相同:
- 官方 int8 权重
minimax_h3_ref2va_pruned_int8_convrot(19.53 GiB),不用 4-bit、不用蒸馏 LoRA - 20 步,
res_multistep+simple,BasicGuider(无 CFG 第二趟) - Dynamic VRAM 异步卸载(
--reserve-vram 4,不加--disable-smart-memory):19.5 GiB 权重放不进 32 GB,
日志原文是loaded partially; 7796.80 MB loaded, 12199.34 MB offloaded(其余权重在主机内存,
由 ComfyUI 的 Dynamic VRAM 机制按需调度) - 视频 VAE 用 fp16、音频 VAE 保持 fp32
五、生成速度
第一轮(3D 风格) 第二轮(2D 风格) 每步耗时 357.6 s/it 356.9 s/it 纯采样 1 小时 59 分 11 秒 1 小时 59 分 06 秒 端到端 2 小时 23 分 04 秒 2 小时 22 分 43 秒 显存 权重 7,796 MB 驻留 / 12,199 MB 卸到内存 同 文件 final_1344x768_288f_12s.mp4(18.1 MB) final_1344x768_288f_12s.mp4(20.7 MB) 两条都是 seed 2026111402、20 步、6 张官方参考图全用、无蒸馏 LoRA。
音轨峰值 3D −0.53 dBFS / 2D −0.59 dBFS,无削波(解成 float 再量)。
比加速版慢 12 倍(11:52 → 2:23),这是「画质优先」的代价——与 topic/3114 作者那句「我选的是画质,不是速度」同一路线。
- 日志截图(ComfyUI 服务端 stdout,含每步 s/it 与
Prompt executed)
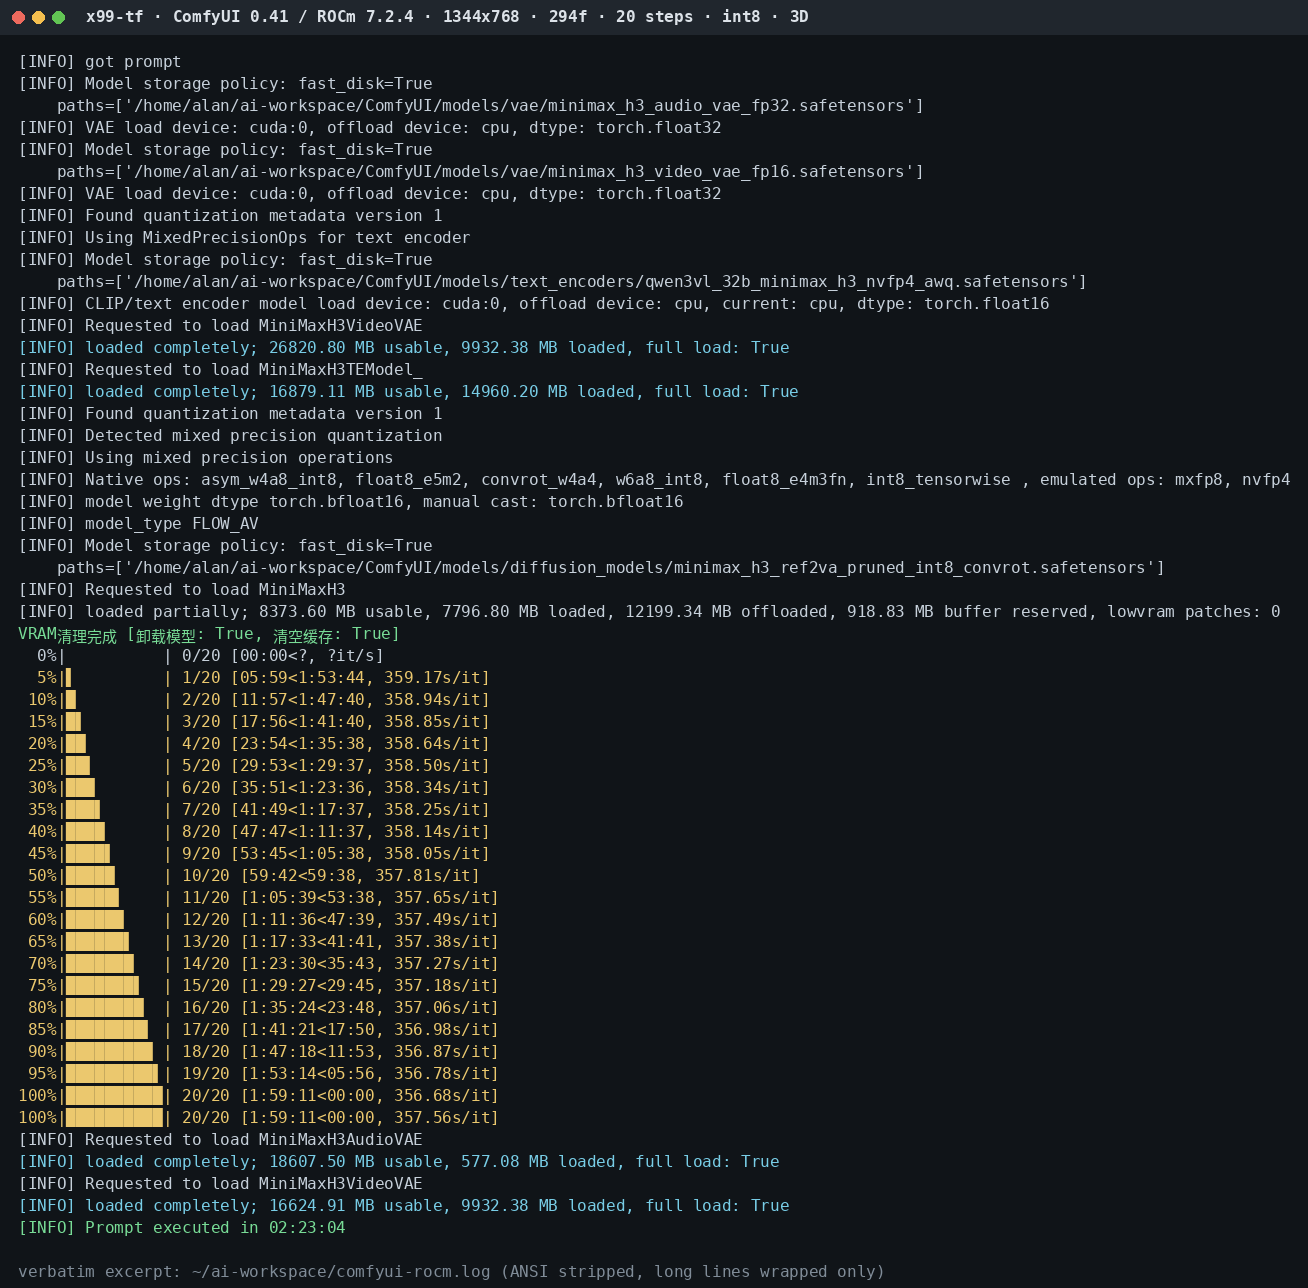
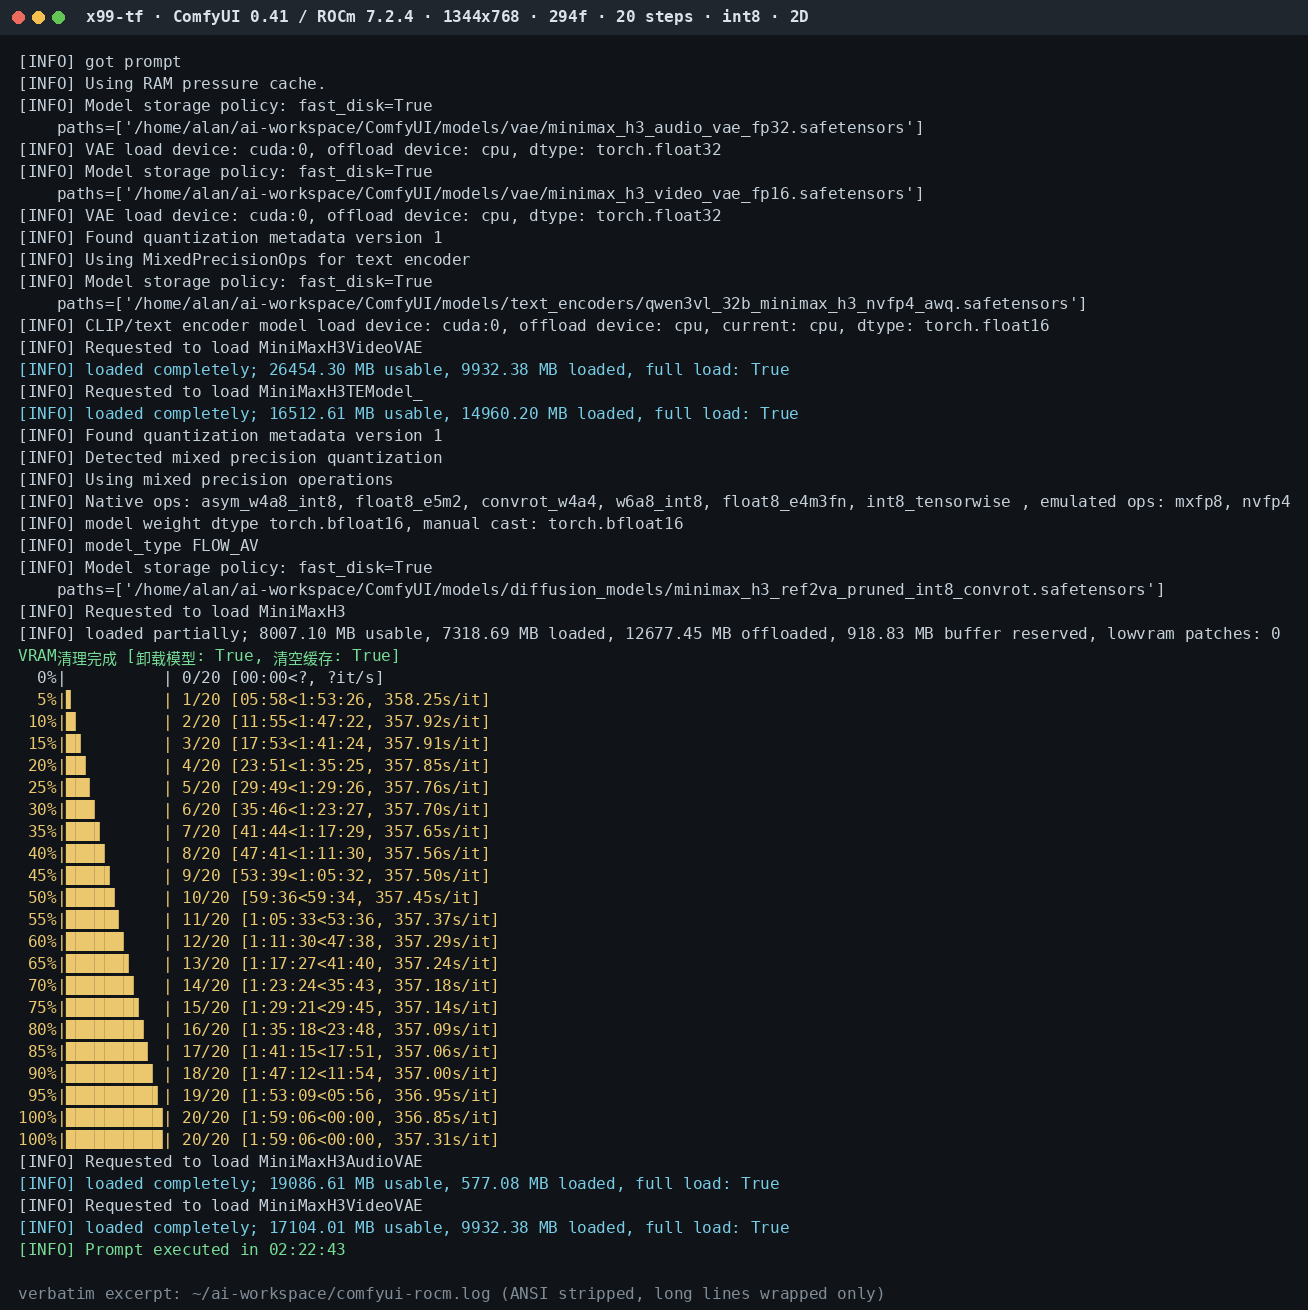
六、快动作拖影:已确认的事实与未确认的部分
结论先讲:这一版的快速动作段仍然有拖影。我没有查出确切成因。
下面是已经验证的事实、做过的尝试,以及我无法确定的地方。6.1 已确认(可在代码/日志里核对)
- H3 的时序压缩比:
comfy/sd.py里 H3 视频 VAE 的定义是
downscale_ratio = (lambda a: max(1, (a - 5) // 17 * 5 + 2), 16, 16),注释写「frames 17k+5 <-> latents 5k+2」。
按此计算,294 帧 87 个 latent 帧,平均每个 latent 帧对应 3.38 个画面帧。
- 这一版的成片:1344×768 / 288 帧 / 24 fps / 12.000 s / AAC 32 kHz,
ffprobe与compliance.txt均通过;
20 步、357 s/it、端到端 2:23:04(3D)/ 2:22:43(2D)。 - 满速拖影是肉眼可见的:在 0.75–1.0 秒的突进段,刀身与衣摆呈现两三个姿势叠合、带笔触状纹理的画面。
6.2 已尝试、肉眼上没有明显改善(同机、同 seed 或同参数对照)
变量 试过的值 观察 注意力后端 comfy kitchen(INT8)/ SDPA-AOTriton flash 画面对比无差别 调度器 simple / beta / normal / res_multistep 无差别 步数 4 / 8 / 20(含关掉蒸馏 LoRA) 步数越高细节越好,但快动作拖影仍在 蒸馏 LoRA ref2v 4step v0.1 / 8step v1.0 / larryvrh pruned EMA / turbo v4-600 细节有差,拖影无差 动作 LoRA Combat V2 @0.3 / Motion_Repair_V2 @0.3 静态帧细节提升,动态拖影仍在 参考图数量 6 张 / 2 张(模仿 topic/3049) 2 张反而更差 VAE int8 convrot / fp16 无差别 关于量化指标的说明:过程中我用「Laplacian 方差」当锐利度指标,后来发现它不可靠——
干净平滑的画面分数低(例如官方 int8 版 32–57),糊掉带噪的画面分数反而高(211–306)。
上表结论以肉眼对成片的判断为准,不引用该指标。6.3 尝试过但未完成的修复路线
我安装了 ComfyUI-MAINodes 的 Motion Lab(de-rope:
把快动作段按整数倍撑开重画,再用精确抽帧回到原速,不做补帧/变速),并接到 Ref2VA 图上跑通到倒数第二步:- 56 帧 / 640×352 的测试在 2,431 秒后于
H3ExactRecover断言失败:撑开后长度 80 帧不在 H3 的17k+5
网格上(合法值是 73 或 90),需要把expand_to_end设为 True 才能对齐。 - 更关键的成本问题:撑开后的 VAE 编码在 32 GB 卡上约 7 秒/帧,2.3 秒的测试片段就吃掉 40 分钟;
12 秒全长外推需要数小时,且几乎必然 OOM。该套件在 RTX PRO 6000 / 96 GB 上的公开数据是 12 分钟。
6.4 我不确定的部分
拖影的确切成因,我没有验证出来。 目前有两种解释,我的数据不足以区分:
- 时序容量不足:3.38 帧/latent 的压缩比起伏,快动作段需要在一个 latent 里表达多个姿势。
这是 MAINodes 文档给出的解释(原文:「One latent token spans four pixel frames…the missing poses were
never generated in the first place」),我只是引用,没有证明。 - 模型学到的动态模糊:H3 可能被训练成快动作自带电影式动态模糊,那它是风格而非缺陷。
能区分两者的实验我还没做:需要在相同的每帧位移量下改变时长/帧率来分离「位移/帧」与「位移/latent」。
- 3d风格:
-
-


 版主审定:本帖设为优秀,作者 +3 积分奖励,继续加油!