[H3 剑心比赛] 双 R9700,ComfyUI+Radiance TP2,INT8 QK+FP8 PV,2D/3D 各约 8 分 29 秒
-
一、视频预览
1. 3D 视频
2. 2D 视频
配套材料: https://codeberg.org/Bunsei/ComfyUI-H3-RDNA4/releases/tag/v0.1.0
项目仓库: https://codeberg.org/Bunsei/ComfyUI-H3-RDNA4二、硬件和环境
两张 Radeon AI PRO R9700,每卡 32GB,功耗上限各 300W。CPU 为 Ryzen 7 9700X,系统可见内存约 89.7 GiB。
Ubuntu 26.04.1、ComfyUI 0.45.0、Python 3.14.4、PyTorch 2.12.0+rocm7.14.0、Comfy Kitchen 0.2.41。节点首次公开版本为 0.1.0,源码、工作流与环境清单随材料提供。
三、生成配置
- 模型:minimax_h3_ref2va_pruned_int8_convrot,Qwen-VL 同样使用 INT8 ConvRot 权重。
- 视频 VAE 为 FP16,音频 VAE 为 FP32。
- 六步 LoRA:pika_h3_flex_ref2va_v1_bf16,强度 1。
- 1344×768,种子 42,LCM,CFG 1,视频/音频 shift 为 12/3。
- 注意力:INT8 QK+FP8 PV。参考图尺寸:适应,即原生 match。
- 成片为 24 fps、288 帧、12 秒,包含原生生成音频。
六步时间表为:1.0, 0.972973, 0.923077, 0.8, 0.571429, 0.333333, 0.0。
四、完整耗时
单位为秒,总耗时取自 ComfyUI 原始日志。
阶段 2D 3D 素材与提示词预处理 50.85 50.85 采样节点,含权重准备和启动 395.46 395.22 音频解码 2.42 2.53 视频解码 46.46 46.46 视频编码与保存 13.13 13.31 完整耗时 509.44 509.45 计时从 ComfyUI 接收完整工作流到文件保存完成,覆盖预处理、权重准备、采样、解码和保存,也包含其他小节点与调度。两段各在新进程中运行,使用已经建立的有效权重缓存,不含安装、编译、下载和首次建立该缓存。各一次后端启动重试已计入总时间。
控制器独立计时为 509.654 和 509.668 秒。六次主干计算合计约 376.84 和 376.44 秒,已包含在采样节点中。
五、加速方式
ComfyUI 负责模型和 LoRA、参考条件、随机噪声、时间表与采样器。Radiance 通过本机内存 IPC 执行 DiT 的 50 层主干,双卡按线性层、注意力头和前馈宽度做 TP,结合行分块与通信流水线。
主干线性层使用 INT8 ConvRot256,注意力使用 Radiance 原生稠密算子:QK 为 INT8,PV 为 FP8,softmax 与浮点累加为 FP32,保留完整输入序列。
预处理将六张图的 Qwen 视觉块分给两卡,视觉精度沿用原生。Qwen 语言注意力使用 BF16 高低分量与 FP32 累加,输入输出保持 FP32。参考图片的 VAE 编码走原生,视频解码按原生独立时间窗分给双卡,音频解码使用原生 FP32 VAE。
LoRA 由原生加载器管理。有效主干权重准备好后缓存复用,并随 TP 分片计算,文本精炼部分继续由原生处理。
六、所用工作流、节点及生成日志
1. 自定义节点
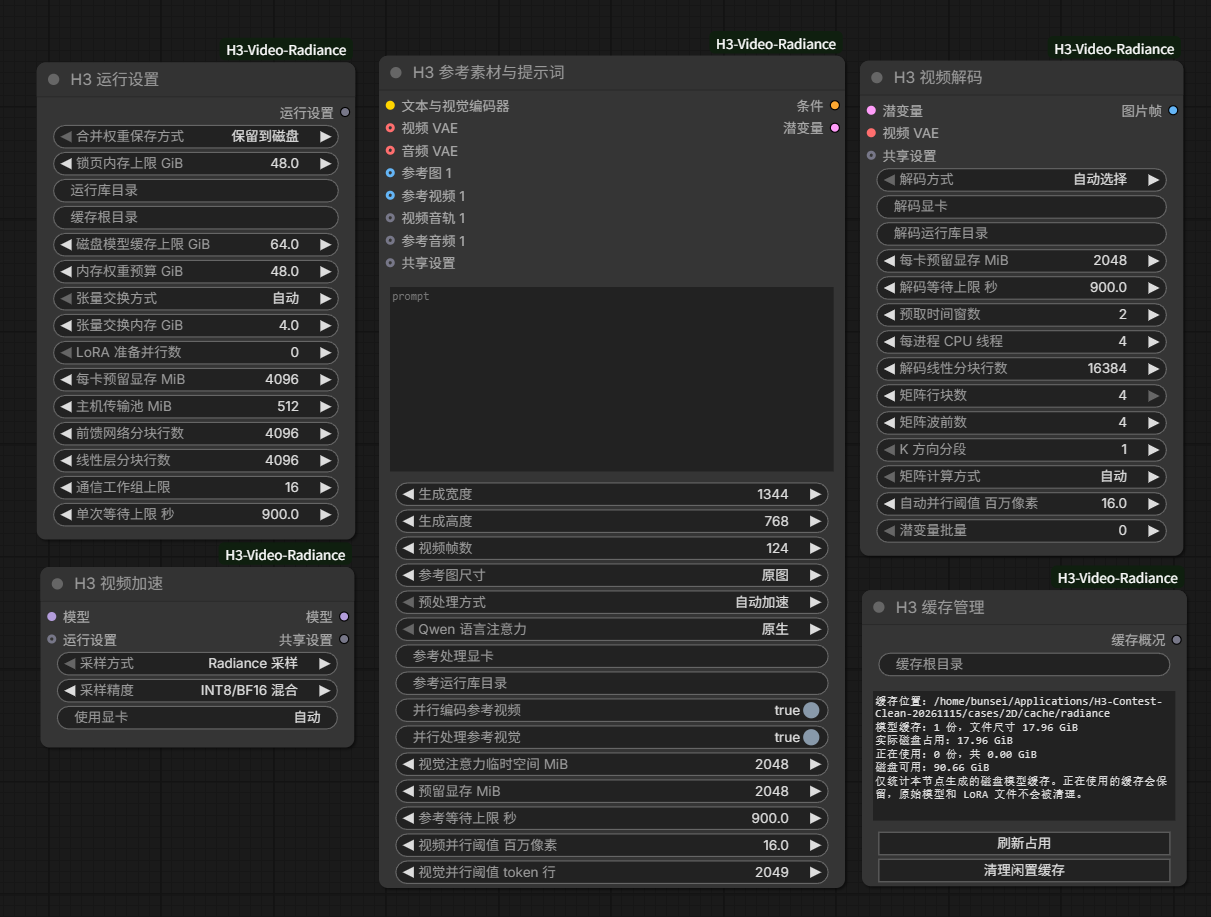
2. 工作流
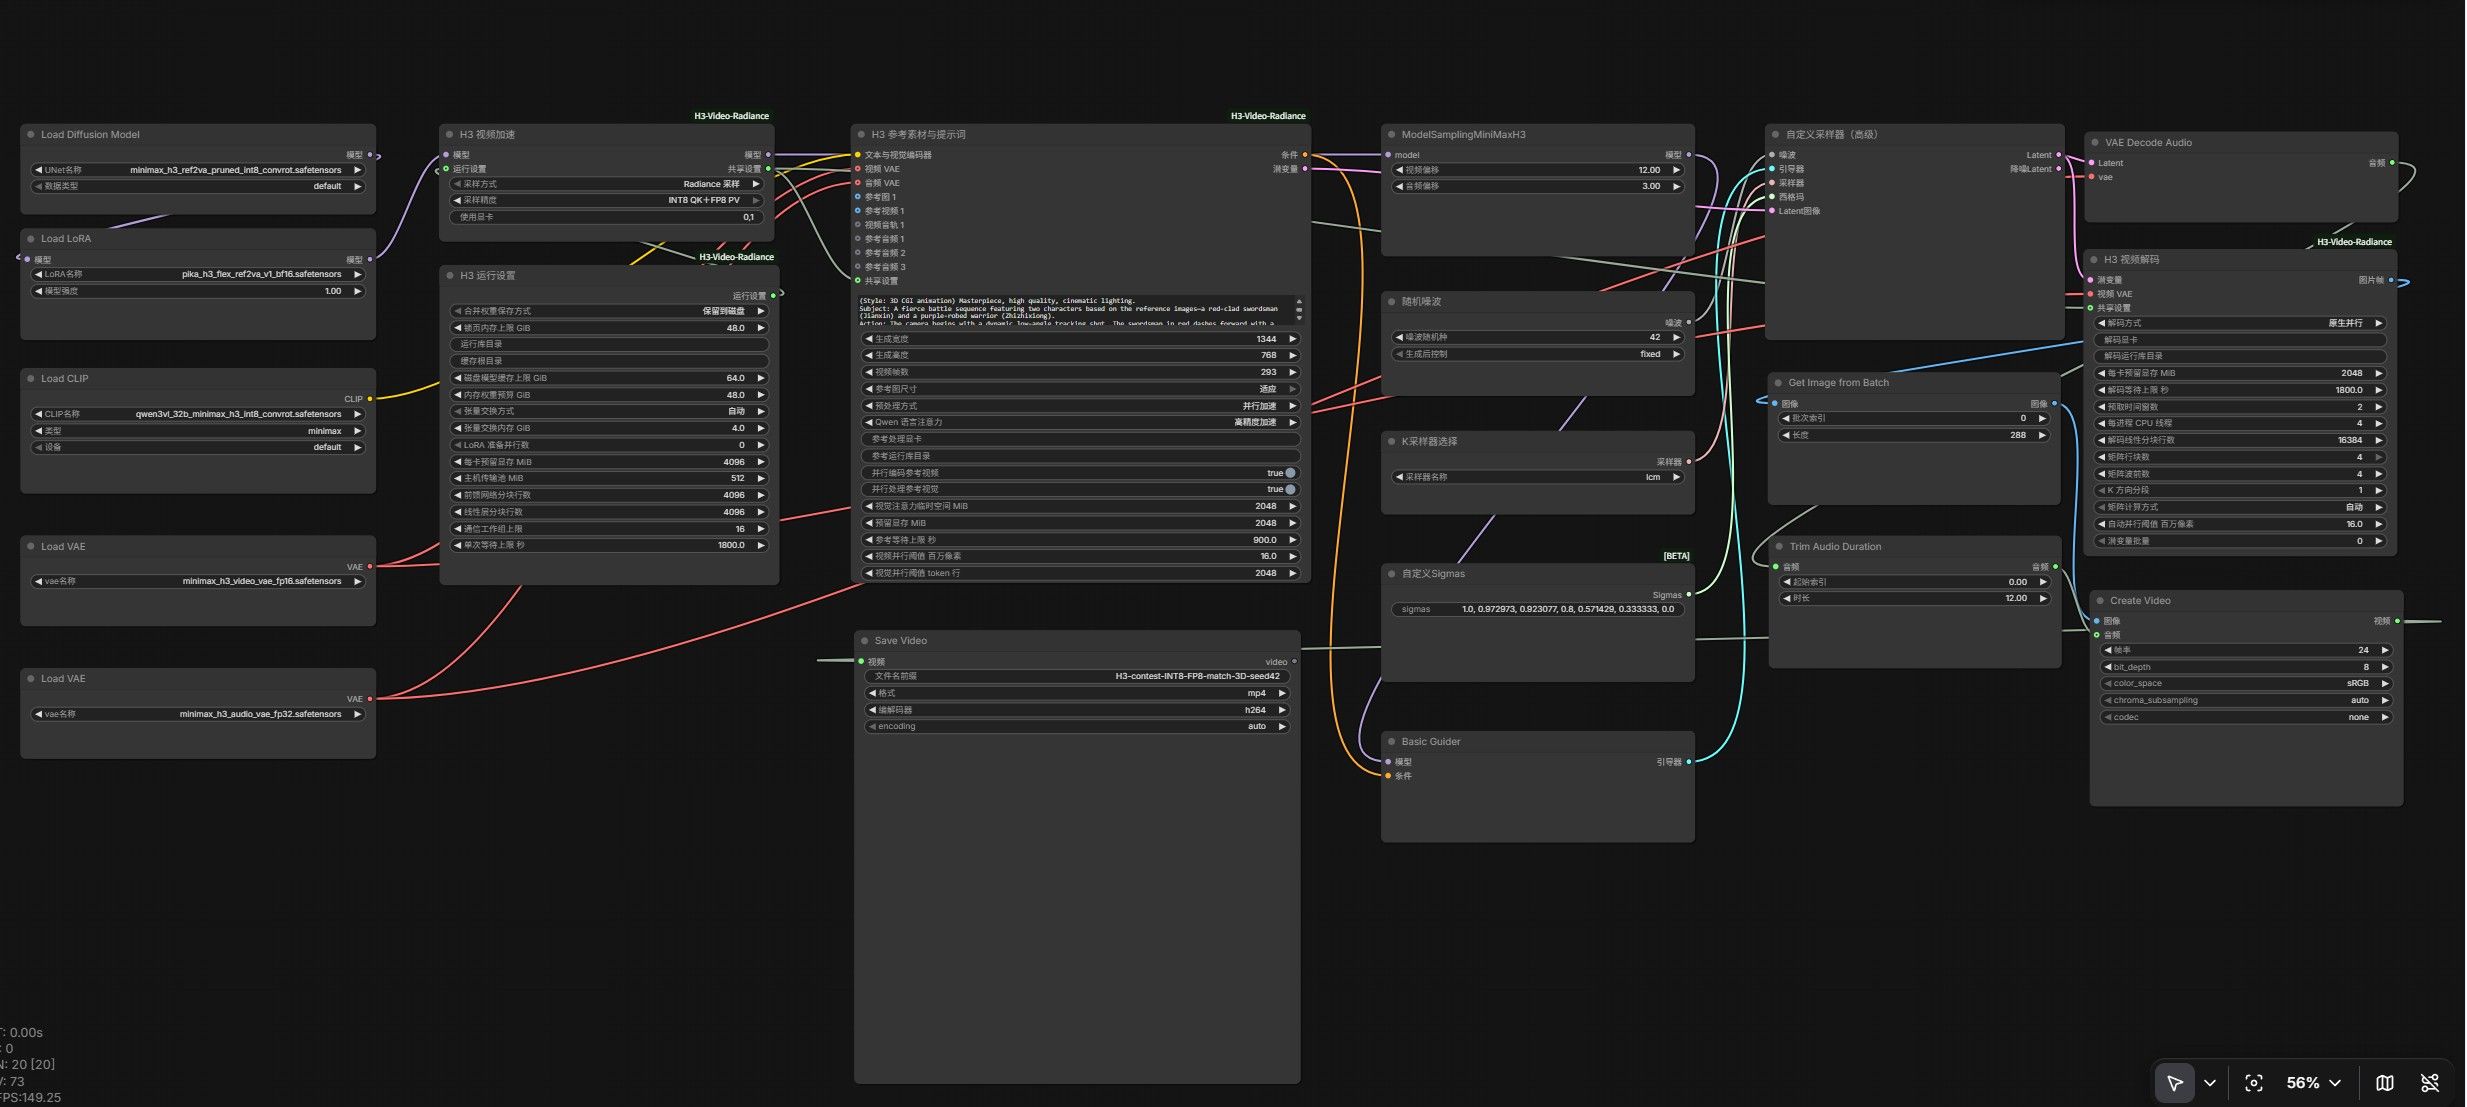
文件:
3. 生成日志
-
-
-
,
 B Bunsei 引用了 此主题
-
-
-

 版主审定:本帖设为优秀,作者 +3 积分奖励,继续加油!