各位大神,求一个最合适的模型
-
双 3090、128GB DDR4 3600MHz 内存、3950X、4TB PCIe SSD。
在这套配置下,Strata 可以运行 QFN IQ4,解码速度能达到每周期 100–150 bit,prefill 速度超过 3000
但我只是一个人用。感觉这点速度其实没多大用。我希望能把速度换成智力
有没有大神推荐其他引擎或模型, 可以保持 decode 在 70-80就行, 但智力可以提升一大截的?
deepseek v4 flash , glm 5.3 flash 等我也试过了, 速度还到不了这么高, 有没有更好的推荐?
-
-
DSH 陪 DeepSeek
-
-
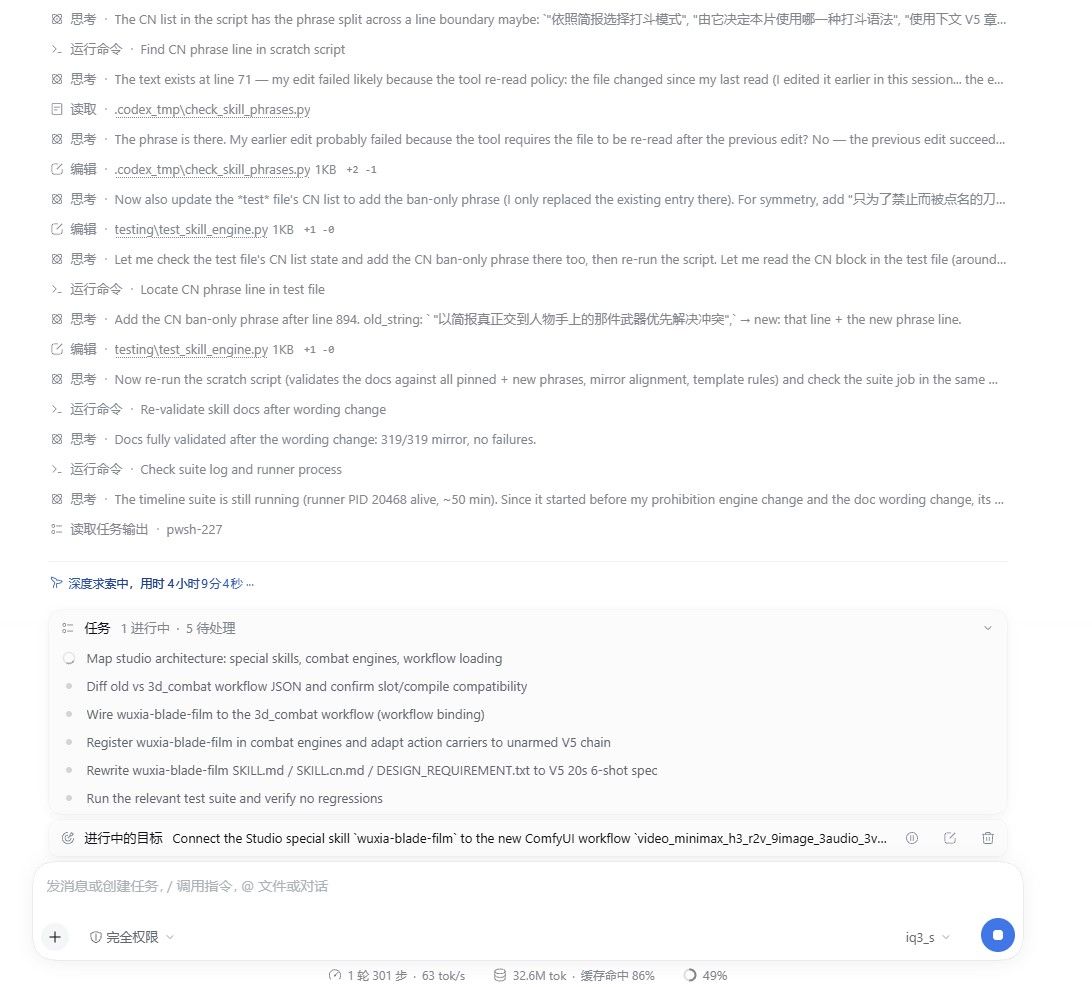
这是我的真实在开发的事情。。。。黄果短剧乱78糟的全部在这里
最近我的codex 都没有什么动,排队白送我几个reset ,我都还没开始消耗
-
本地大模型能當工具用的, 我相信你已經試過了。
QFN或27B的智力已經夠。我建議你應該研究如何用足夠細節的prompt令大模型能夠生產出你要結果。
如果你只會說:"AI, 你跟我做好它" 之類的prompt,
即使給你用美國的A跟O公司最貴的模型, 那出來的結果你也不會滿意的。現在AI還不能取替人類的工作流程只有2個:
1: 提出人類想要的概念
2: 驗收AI出來的結果 -
DSH 陪 DeepSeek
人家明显说的是本地
-
-
可能是数据BUG了。我这你发的是个空贴。
已经告诉小特维护了。 -
-
-
双 3090、128GB DDR4 3600MHz 内存、3950X、4TB PCIe SSD。
在这套配置下,Strata 可以运行 QFN IQ4,解码速度能达到每周期 100–150 bit,prefill 速度超过 3000
但我只是一个人用。感觉这点速度其实没多大用。我希望能把速度换成智力
有没有大神推荐其他引擎或模型, 可以保持 decode 在 70-80就行, 但智力可以提升一大截的?
deepseek v4 flash , glm 5.3 flash 等我也试过了, 速度还到不了这么高, 有没有更好的推荐?
-
-
-
- SGLang/Qwen-3.8-27B:生产级推理引擎,配上蒸馏后的稠密模型,支持 256 长上下文,多并发,表现稳定,但是知识广度不行
- Strata/Qwen-Flash-Next:实验本地推理引擎,让消费级显卡也能用上 100B+ 的 MOE 模型,支持 256 长上下文,只能单卡单开,并发限制很多,指令遵循明显不如27B, 不能用于主流的 Agent 多并发生产,但是,虽然参数量大,知识广度和工具调用能力更强,可以用抗审查版本来做一些偏 Chatbot、调研或者黄果短剧的剧情类的事情。
期待下Qwen-4.0-27B
-
双 3090、128GB DDR4 3600MHz 内存、3950X、4TB PCIe SSD。
在这套配置下,Strata 可以运行 QFN IQ4,解码速度能达到每周期 100–150 bit,prefill 速度超过 3000
但我只是一个人用。感觉这点速度其实没多大用。我希望能把速度换成智力
有没有大神推荐其他引擎或模型, 可以保持 decode 在 70-80就行, 但智力可以提升一大截的?
deepseek v4 flash , glm 5.3 flash 等我也试过了, 速度还到不了这么高, 有没有更好的推荐?
双 3090、128GB DDR4 3600MHz 内存、3950X、4TB PCIe SSD。
在这套配置下,Strata 可以运行 QFN IQ4,解码速度能达到每周期 100–150 bit,prefill 速度超过 3000
但我只是一个人用。感觉这点速度其实没多大用。我希望能把速度换成智力
有没有大神推荐其他引擎或模型, 可以保持 decode 在 70-80就行, 但智力可以提升一大截的?
deepseek v4 flash , glm 5.3 flash 等我也试过了, 速度还到不了这么高, 有没有更好的推荐?
双卡27B Q5 或者Q6 ,试过吗? EXL H5 H6的,应该是速度和智力的均衡了。 各种实力接近原版。 如果你只是写代码。 今天刚出了PI的LORA, https://huggingface.co/harness-hub/Qwen3.8-27B-pi-adapted-GGUF 用它来配 最新的UNSLOTH UD3.1 Q4KM 单卡应该可以了,55T/S的样子,140K左右上下文。 双卡我没试过,我的HERMES告诉我加了MTP和LORA就不能用视觉。
-
-
- SGLang/Qwen-3.8-27B:生产级推理引擎,配上蒸馏后的稠密模型,支持 256 长上下文,多并发,表现稳定,但是知识广度不行
- Strata/Qwen-Flash-Next:实验本地推理引擎,让消费级显卡也能用上 100B+ 的 MOE 模型,支持 256 长上下文,只能单卡单开,并发限制很多,指令遵循明显不如27B, 不能用于主流的 Agent 多并发生产,但是,虽然参数量大,知识广度和工具调用能力更强,可以用抗审查版本来做一些偏 Chatbot、调研或者黄果短剧的剧情类的事情。
期待下Qwen-4.0-27B
-
双 3090、128GB DDR4 3600MHz 内存、3950X、4TB PCIe SSD。
在这套配置下,Strata 可以运行 QFN IQ4,解码速度能达到每周期 100–150 bit,prefill 速度超过 3000
但我只是一个人用。感觉这点速度其实没多大用。我希望能把速度换成智力
有没有大神推荐其他引擎或模型, 可以保持 decode 在 70-80就行, 但智力可以提升一大截的?
deepseek v4 flash , glm 5.3 flash 等我也试过了, 速度还到不了这么高, 有没有更好的推荐?
双卡27B Q5 或者Q6 ,试过吗? EXL H5 H6的,应该是速度和智力的均衡了。 各种实力接近原版。 如果你只是写代码。 今天刚出了PI的LORA, https://huggingface.co/harness-hub/Qwen3.8-27B-pi-adapted-GGUF 用它来配 最新的UNSLOTH UD3.1 Q4KM 单卡应该可以了,55T/S的样子,140K左右上下文。 双卡我没试过,我的HERMES告诉我加了MTP和LORA就不能用视觉。
-
Q5/Q6 提升的主要是「保真度」,不是模型本身的智力上限。Q4/IQ4 的量化误差会先伤指令遵循和长链推理,所以从 Q4 换到 Q5_K_M、Q6_K 常常感觉「变聪明了」,本质是把底座原有的能力补回来;如果 IQ4_XS 在你的任务上已经很稳,这一步的收益会小于换更大/更强的底座。
双 3090 48G 上 27B 的可行档位:Q5_K_M 约 18–19G,配 32K 左右上下文比较稳;Q6_K 约 21–22G,KV 只剩很少,长上下文会掉,70–80 decode 也更吃紧。想保速度又提质量,优先 Q5_K_M + 32K;官方 FP8 27B 双卡 TP 也能放,但 3090 没有原生 FP8 算力,decode 会明显降。
真要跨档提升,还是等 Qwen4 或走云端;这套硬件在本地性价比最高的点就在 Q5 这一档。



 本帖参与讨论人数已达 10+,入选热议,作者 +3 积分奖励!