ComfyUI-H3-RDNA4(Radiance 后端)R9700 实测:H3 R2V 采样 2.01×
-
-
-
-
-
@bunsei 双卡 TP 的数据出来了,如下:
结论:同一台华南金牌 X99-TF GAMING V6.0 + 单路 E5-2696 v3(Haswell-EP)+ 双 R9700 32G,不打内核补丁,跑通了跨 Root Port Direct P2P(单向 10.20 GB/s),并让 ComfyUI-H3-RDNA4(Radiance)双卡 TP 真正可用:H3 参考图生视频全流程 4650 s → 1596 s,加速 2.91×(单卡 Radiance 2.01×,原生基线 1×)。
视频对比:原生 https://youtu.be/7dSj4cW1PaE | 单卡 Radiance https://youtu.be/t-0brZVj774 | 双卡 TP https://youtu.be/Tv_HHYlM71M
背景
接上一篇《ComfyUI-H3-RDNA4 R9700 实测》。单卡 Radiance 采样 101.5 s/步之后,双卡 TP 一度病态慢(内存档首步 1037 s、混合档首步 25 分钟未完成),当时判了「平台判死」。对照 PhoenixRise2026 的 P2P 项目(github.com/PhoenixRise2026/x99-amd-gpu-p2p,MIT)逐层排查后发现判断错了:卡点不是硬件,是一个环境变量 + IOMMU 配置 + 激活缓冲位置三件事。
平台核对(diagnose.sh 实测)
检查项 结果 说明 CPU E5-2696 v3,单路 Haswell-EP,主机桥 8086:2f00 GPU 2× R9700 32G,PCIe 4.0 x16(LnkSta 32GT/s) 同 CPU 不同 Root Port(00:02.0 / 00:03.0),无 switch BIOS Above 4G + ReBAR 已生效 两卡 BAR0 = 32G 完整显存 BAR,地址 0x380800000000(46 位空间) DMA mask 44-bit(amdgpu 原生,无自定义补丁) BAR 地址超出 44 位 → 必须靠 IOMMU 翻译 IOMMU VT-d Translated(默认配置) 必需品,不是开销 P2PDMA 白名单 Haswell-EP 8086:2f00/2f01 stock 内核原生放行 白名单补丁只补 Broadwell-EP 6f00,我们不需要 内核日志 0 AER / 0 DMAR / 0 GPU reset 干净 关键认知:X99 是 Intel 平台。BAR 在 46 位物理地址上,超出显卡 44 位 DMA 寻址范围,GPU 根本无法直接寻址对端 BAR——必须靠 VT-d 把对端 BAR 重映射进紧凑 IOVA。没有 IOMMU(intel_iommu=off)时
can_device_access_peer直接返回 false;开着时返回 true 且实测能到 10 GB/s。三态实测(同一台机器,同一个 Radiance 双卡 TP 工作流)
配置 首步/稳定步时 结论 IOMMU 默认 + 无 HSA 变量 + 激活缓冲在内存/混合 首步 1037 s ~ 25 分钟+ P2P 走了 IOMMU 翻译路径 + 激活流量绕主机,双层慢 intel_iommu=off直接报 The selected GPUs cannot use peer accessGPU 寻址不了 46 位对端 BAR,P2P 不可达 IOMMU 默认 + HSA_ENABLE_IPC_MODE_LEGACY=0+ 激活缓冲=显存首步 77 s,稳定 64.4 s/步 Direct P2P 真直连 最终可用配置
层 配置 BIOS Above 4G Decoding ON、ReBAR ON、CSM OFF 内核 stock 内核即可(Haswell-EP 白名单原生支持;无需 6.8.12-r9700-p2p-dma44,那是 Broadwell 补丁) GPU0 实例启动 HSA_ENABLE_IPC_MODE_LEGACY=0 PYTORCH_CUDA_ALLOC_CONF=expandable_segments:True+--reserve-vram 22,不带 CUDA_VISIBLE_DEVICES(否则GPU 1 is not visible to ComfyUI)Radiance 采样精度 INT8 QK+FP8 PV 激活缓冲位置 显存 每卡预留显存 2048 MiB 张量交换内存 2 GiB 每卡主机权重池 12288 MiB 暂存线性权重 / 复用主干输入缓冲 关(显存激活缓冲模式下先求稳定,后续可对照) devices 0,1 实测数据(参赛内容同参数:1344×768 / 294帧 / 20步 / seed 12345 / 6参考图)
指标 原生 Radiance 单卡 Radiance 双卡 TP 全流程 4650 s 2314 s 1596 s 采样每步 ≈210 s 101.5 s(零衰减) 64.4 s(零衰减) 对原生加速 1× 2.01× 2.91× 出片规格 1344×768 / 294帧 / 12.25s 一致 一致 像素质检(边缘密度,6 帧) 8.02~17.09% 7.48~15.95% 6.73~16.73% 三版同带无 latent 崩坏。同 seed 下 INT8 QK+FP8 PV 与原生精度数值不逐像素一致,构图/动作一致。
P2P 链路实测(torch 跨卡 copy 1 GiB,等价 hipMemcpyPeerAsync / SDMA 路径)
can_device_access_peer 0→1 / 1→0:  True / True
GPU0→GPU1:  10.20 GB/s
GPU1→GPU0:  10.21 GB/s
与项目作者参考机(E5-2697A v4)的 TransferBench 单向 10.29 GB/s 基本重合。跨 Root Port P2P 经 root complex 路由的吞吐上限就在 10 GB/s 级,链路速率(Gen4 x16)不是限制因素。
坑(现象 / 根因 / 解法)
现象 根因 解法 TP 首步 1037 s、混合档 25 分钟不出第一步 未设 HSA_ENABLE_IPC_MODE_LEGACY=0(IPC 走 legacy 路径)+ 激活缓冲放内存/混合(激活流量绕主机内存)GPU0 实例启动加 HSA 变量,激活缓冲=显存 The selected GPUs cannot use peer access; select a single GPUintel_iommu=off后 GPU 无法寻址 46 位的对端 BAR不要关 IOMMU,VT-d Translated 是这套平台 P2P 的必需品 GPU 1 is not visible to ComfyUI实例带 CUDA_VISIBLE_DEVICES=0双卡模式去掉该环境变量 amd_iommu=off写进 cmdline 后 IOMMU 照样在X99/E5 是 Intel 平台(VT-d/DMAR), amd_iommu=off是 AMD 参数用 intel_iommu=off(本次已验证后又回退,最终保留默认配置)单卡速度 256~419 s/步 激活缓冲挪内存 + 未开暂存/复用缓冲 见上篇:显存激活缓冲 + weight_staging+reuse_hidden_buffer经验
- 判「硬件不支持」之前先把软件层变量清干净——本项目作者和我们都走过同一个弯路。
- 排查顺序照 PhoenixRise2026 的验收阶梯:BIOS → 拓扑 → BAR/DMA → 内核 → HIP IPC → TransferBench → 上层应用,每层单独取证。
- P2P 通了不等于 TP 必然快:激活缓冲位置、IPC 模式、预留显存都在同一张账本上,启动报错里的精确显存核算(card total / already held / arena / short by)是最好的排障入口。
- 双卡 TP 跑时 GPU1 的 ComfyUI 实例记得停(抢显存)。
- 上篇单卡配置与本篇双卡配置可按任务切换:单卡跑小任务更省心,双卡 TP 跑长序列大任务收益最大。
以上。参考:PhoenixRise2026/x99-amd-gpu-p2p(github,MIT)、ComfyUI-H3-RDNA4(codeberg.org/Bunsei)。有同款平台的欢迎对数据。
-
@bunsei 双卡 TP 的数据出来了,如下:
结论:同一台华南金牌 X99-TF GAMING V6.0 + 单路 E5-2696 v3(Haswell-EP)+ 双 R9700 32G,不打内核补丁,跑通了跨 Root Port Direct P2P(单向 10.20 GB/s),并让 ComfyUI-H3-RDNA4(Radiance)双卡 TP 真正可用:H3 参考图生视频全流程 4650 s → 1596 s,加速 2.91×(单卡 Radiance 2.01×,原生基线 1×)。
视频对比:原生 https://youtu.be/7dSj4cW1PaE | 单卡 Radiance https://youtu.be/t-0brZVj774 | 双卡 TP https://youtu.be/Tv_HHYlM71M
背景
接上一篇《ComfyUI-H3-RDNA4 R9700 实测》。单卡 Radiance 采样 101.5 s/步之后,双卡 TP 一度病态慢(内存档首步 1037 s、混合档首步 25 分钟未完成),当时判了「平台判死」。对照 PhoenixRise2026 的 P2P 项目(github.com/PhoenixRise2026/x99-amd-gpu-p2p,MIT)逐层排查后发现判断错了:卡点不是硬件,是一个环境变量 + IOMMU 配置 + 激活缓冲位置三件事。
平台核对(diagnose.sh 实测)
检查项 结果 说明 CPU E5-2696 v3,单路 Haswell-EP,主机桥 8086:2f00 GPU 2× R9700 32G,PCIe 4.0 x16(LnkSta 32GT/s) 同 CPU 不同 Root Port(00:02.0 / 00:03.0),无 switch BIOS Above 4G + ReBAR 已生效 两卡 BAR0 = 32G 完整显存 BAR,地址 0x380800000000(46 位空间) DMA mask 44-bit(amdgpu 原生,无自定义补丁) BAR 地址超出 44 位 → 必须靠 IOMMU 翻译 IOMMU VT-d Translated(默认配置) 必需品,不是开销 P2PDMA 白名单 Haswell-EP 8086:2f00/2f01 stock 内核原生放行 白名单补丁只补 Broadwell-EP 6f00,我们不需要 内核日志 0 AER / 0 DMAR / 0 GPU reset 干净 关键认知:X99 是 Intel 平台。BAR 在 46 位物理地址上,超出显卡 44 位 DMA 寻址范围,GPU 根本无法直接寻址对端 BAR——必须靠 VT-d 把对端 BAR 重映射进紧凑 IOVA。没有 IOMMU(intel_iommu=off)时
can_device_access_peer直接返回 false;开着时返回 true 且实测能到 10 GB/s。三态实测(同一台机器,同一个 Radiance 双卡 TP 工作流)
配置 首步/稳定步时 结论 IOMMU 默认 + 无 HSA 变量 + 激活缓冲在内存/混合 首步 1037 s ~ 25 分钟+ P2P 走了 IOMMU 翻译路径 + 激活流量绕主机,双层慢 intel_iommu=off直接报 The selected GPUs cannot use peer accessGPU 寻址不了 46 位对端 BAR,P2P 不可达 IOMMU 默认 + HSA_ENABLE_IPC_MODE_LEGACY=0+ 激活缓冲=显存首步 77 s,稳定 64.4 s/步 Direct P2P 真直连 最终可用配置
层 配置 BIOS Above 4G Decoding ON、ReBAR ON、CSM OFF 内核 stock 内核即可(Haswell-EP 白名单原生支持;无需 6.8.12-r9700-p2p-dma44,那是 Broadwell 补丁) GPU0 实例启动 HSA_ENABLE_IPC_MODE_LEGACY=0 PYTORCH_CUDA_ALLOC_CONF=expandable_segments:True+--reserve-vram 22,不带 CUDA_VISIBLE_DEVICES(否则GPU 1 is not visible to ComfyUI)Radiance 采样精度 INT8 QK+FP8 PV 激活缓冲位置 显存 每卡预留显存 2048 MiB 张量交换内存 2 GiB 每卡主机权重池 12288 MiB 暂存线性权重 / 复用主干输入缓冲 关(显存激活缓冲模式下先求稳定,后续可对照) devices 0,1 实测数据(参赛内容同参数:1344×768 / 294帧 / 20步 / seed 12345 / 6参考图)
指标 原生 Radiance 单卡 Radiance 双卡 TP 全流程 4650 s 2314 s 1596 s 采样每步 ≈210 s 101.5 s(零衰减) 64.4 s(零衰减) 对原生加速 1× 2.01× 2.91× 出片规格 1344×768 / 294帧 / 12.25s 一致 一致 像素质检(边缘密度,6 帧) 8.02~17.09% 7.48~15.95% 6.73~16.73% 三版同带无 latent 崩坏。同 seed 下 INT8 QK+FP8 PV 与原生精度数值不逐像素一致,构图/动作一致。
P2P 链路实测(torch 跨卡 copy 1 GiB,等价 hipMemcpyPeerAsync / SDMA 路径)
can_device_access_peer 0→1 / 1→0:  True / True
GPU0→GPU1:  10.20 GB/s
GPU1→GPU0:  10.21 GB/s
与项目作者参考机(E5-2697A v4)的 TransferBench 单向 10.29 GB/s 基本重合。跨 Root Port P2P 经 root complex 路由的吞吐上限就在 10 GB/s 级,链路速率(Gen4 x16)不是限制因素。
坑(现象 / 根因 / 解法)
现象 根因 解法 TP 首步 1037 s、混合档 25 分钟不出第一步 未设 HSA_ENABLE_IPC_MODE_LEGACY=0(IPC 走 legacy 路径)+ 激活缓冲放内存/混合(激活流量绕主机内存)GPU0 实例启动加 HSA 变量,激活缓冲=显存 The selected GPUs cannot use peer access; select a single GPUintel_iommu=off后 GPU 无法寻址 46 位的对端 BAR不要关 IOMMU,VT-d Translated 是这套平台 P2P 的必需品 GPU 1 is not visible to ComfyUI实例带 CUDA_VISIBLE_DEVICES=0双卡模式去掉该环境变量 amd_iommu=off写进 cmdline 后 IOMMU 照样在X99/E5 是 Intel 平台(VT-d/DMAR), amd_iommu=off是 AMD 参数用 intel_iommu=off(本次已验证后又回退,最终保留默认配置)单卡速度 256~419 s/步 激活缓冲挪内存 + 未开暂存/复用缓冲 见上篇:显存激活缓冲 + weight_staging+reuse_hidden_buffer经验
- 判「硬件不支持」之前先把软件层变量清干净——本项目作者和我们都走过同一个弯路。
- 排查顺序照 PhoenixRise2026 的验收阶梯:BIOS → 拓扑 → BAR/DMA → 内核 → HIP IPC → TransferBench → 上层应用,每层单独取证。
- P2P 通了不等于 TP 必然快:激活缓冲位置、IPC 模式、预留显存都在同一张账本上,启动报错里的精确显存核算(card total / already held / arena / short by)是最好的排障入口。
- 双卡 TP 跑时 GPU1 的 ComfyUI 实例记得停(抢显存)。
- 上篇单卡配置与本篇双卡配置可按任务切换:单卡跑小任务更省心,双卡 TP 跑长序列大任务收益最大。
以上。参考:PhoenixRise2026/x99-amd-gpu-p2p(github,MIT)、ComfyUI-H3-RDNA4(codeberg.org/Bunsei)。有同款平台的欢迎对数据。
-
-
@风满楼 你的节点配置能发一下吗?采样速度应该差不多20*65 1300 ,但是预处理、编解码有点久了。
我的这里是:
预处理 51.8 秒
视频解码 46.5 秒按照你的这个DDR3的平台来看,150S以内应该没问题。
另外NVFP4这个是针对RX9070之类的卡加的,属于时间换空间,使用的是 FP16 高低双分量、FP32 累加和输出。换成INT8的应该能快。(PS:如果用INT8的VL权重,Qwen线性加速那里要选择原生)
@Bunsei 配置如下(比赛 3D 工作流骨架,双卡 TP 版):
模型:UNET
minimax_h3_ref2va_pruned_int8_convrot| CLIPqwen3vl_32b_minimax_h3_nvfp4_awq(type=minimax)| VAEminimax_h3_video_vae_int8_convrot+audio_vae_fp32Accelerator(201):Radiance 采样 | INT8 QK+FP8 PV | devices 0,1
Tuning(200):激活缓冲=显存 | headroom 2048 | IPC 2 GiB | 主机权重池 12288 | ffn/linear 分块 4096 | collective_blocks 16 | staging/reuse/gather/release 全关 | 缓存=保留到磁盘
References(20):1344×768 / 288帧 | 并行 video VAE + 并行 Qwen vision 都开 | quality=适应 | processing=自动加速 | language=高精度加速
Decode(110):headroom 2048 | linear_chunk_rows 16384 | gemm 4×4×1 默认
实例:
HSA_ENABLE_IPC_MODE_LEGACY=0+--reserve-vram 22,不带 CUDA_VISIBLE_DEVICES采样:res_multistep / simple / 20 步 / seed 12345
采样账和你估的对:20×64.4 = 1288 s。拆账:预处理 172.0 + 采样 1288 + 解码 76.8,平台是 2696 v3(DDR4-2133 四通道),比你估的 150 s 确实还有距离。
NVFP4 那条收到——我们是从比赛工作流照搬的 32B NVFP4-AWQ,已换官方
qwen3vl_32b_minimax_h3_int8_convrot(SHA256 与仓库一致)、Qwen 线性走原生,双卡 TP 复测数据:预处理 170.1 s(NVFP4 172.0 s,持平)、采样 67.4 s/步(64.4 s/步,噪声内)、全流程 26:53(26:36,持平)。结论:在我们平台(gfx1201 32G×2)编码器格式对预处理无收益,170 s 的大头在参考图 VAE 编码与视觉处理;已保留 INT8 版(4-bit→8-bit,编码精度更高,显存也够)。预处理比您慢 3.3× 应该是平台内存带宽/CPU 差异,不是权重格式问题。 -
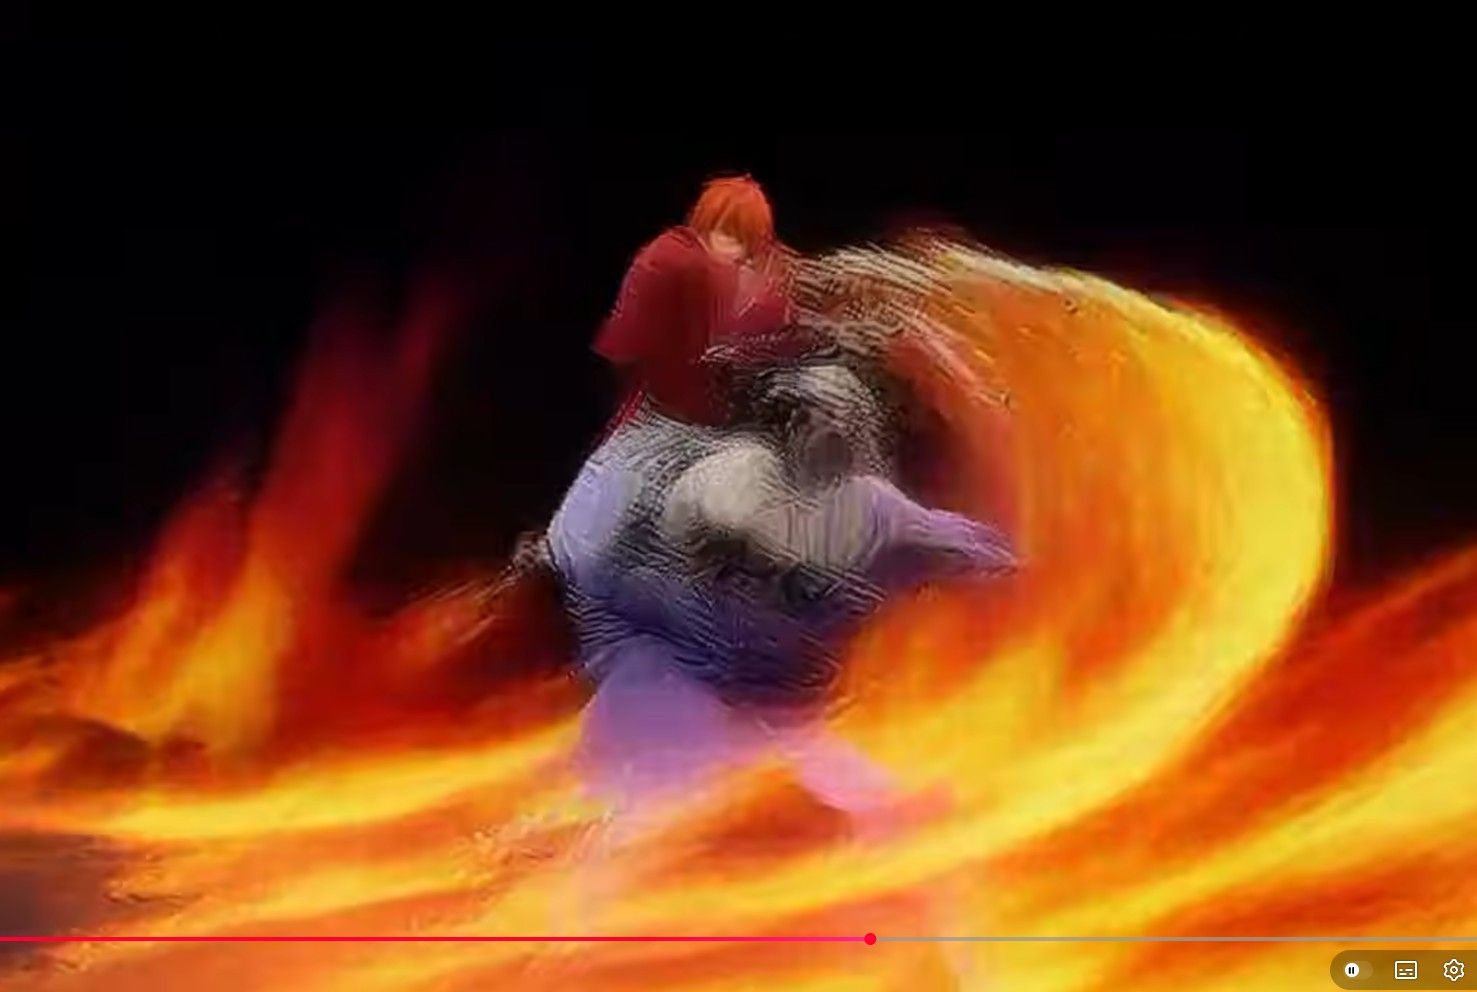
我一直很好奇,到底是什么问题会造成画面出现残影
-
,
 风 风满楼 引用了 此主题
-
@imbiplaza-ASUS 刚接触视频生成,纯新手,还不清楚具体的原因。有好的经验望指点一二