32G内存不能打?本帖会让你惊掉下巴!
-
两台机器 Strata 长上下文实测:7900 XTX + 256GB(IQ3_S)对比 RTX 3080 20GB + 32GB(TQ2_0 + gyro pack)。一个是 AMD GPU decode、一个是 NVIDIA GPU decode,内存差 8 倍。
硬件 / 软件环境
项目 A:7900 XTX B:RTX 3080 CPU 双路 Intel Xeon E5-2696 v3 @ 2.30GHz,每颗18核,共36核72线程,Haswell AVX2 Intel Core Ultra 7 270K Plus,8P+16E共24核24线程(无超线程),最大睿频5.5GHz GPU AMD RX 7900 XTX,24GB,gfx1100 NVIDIA RTX 3080,20GB(魔改),sm_86 内存 256GB DDR3 ECC(8×32GB,1866 MT/s),系统识别约251GiB;专家常驻约46.84GiB page-locked 2×16GB DDR5 6000;常驻后约30GiB在用,贴着上限跑 模型存储 PCIe SSD 953.9GB PCIe SSD 953.9GB 系统 Ubuntu 24.04.4 LTS,Linux 6.8.0-149 Ubuntu 24.04.4 LTS,Linux 6.8.0-149 GPU栈 ROCm(pip SDK),HSA_OVERRIDE_GFX_VERSION=11.0.0,hipBLASLt调优表 gfx1100-100200 CUDA 13,驱动595.99.02;引擎实测PCIe 25.4 GB/s 推理后端 Strata RDNA3 fork(自编译) Strata 0.1.60 cuda13构建 GPU队列 GPU_MAX_HW_QUEUES=6 默认 文件体积与速度总表
PP = prefill,TG = decode,速度单位均为 tokens/s;每格按 PP / TG 排列。GB按10⁹字节。
配置 模型 GB pack + MTP GB 合计 GB 4K PP/TG 16K PP/TG 32K PP/TG 64K PP/TG 128K PP/TG A:IQ3_S(GSQ-RCO)+ iq3_s pack,7900 XTX 83.62(2分片,含IQ4_NL PLE表28.80) 1.55 + 0.82 86.00 690 / 116.2 2268 / 112.6 2959 / 108.2 2480 / 115.5 2905 / 119.2 B:TQ2_0 + gyro-gyro-m pack,3080 20GB 91.97(含包内PLE表) 33.58 + 0.82 126.37 2011 / 98.9 2375 / 98.7 2478 / 96.4 2449 / 101.0 2355 / 87.3 两行速度均为冷启动新输入(prompt cache reused=0)口径,同档位可比。
体积口径:模型 GB 为 GGUF 分片之和(含包内 N-gram/PLE 表);pack 为 APR 包,MTP 为 rt 格式 draft。合计为磁盘文件之和,不等于 RAM 占用。A 机专家常驻 46.84GiB + GPU缓存 17.35GiB(9146 experts);B 机专家常驻 23.26GiB page-locked + GPU缓存 1071 slots(1.30GiB),其余走文件层。
测速口径:统一按 4K / 16K / 32K / 64K / 128K 五档、每档 3 次,全部取冷启动新输入(prompt cache reused=0)的引擎日志记录,temperature=0、输出 ≤256 tokens,按档位取中位数。A 机为刚才实跑的同语料基准(合成 CJK 填充语料,实际 prompt token 2,201 / 8,558 / 17,021 / 33,947 / 67,801);B 机取自生产引擎日志中同口径的历史记录(prompt 落在各档 ±12% 内、输出 ≥200 tokens,n=6~29/档)。语料不完全相同,数字作整套配置参考。
解码与缓存
指标 A:7900 XTX B:3080 TG @4K(冷启动) 116.2 98.9 TG @128K(冷启动) 119.2 87.3 PP @4K(冷启动) 690 ~2011 PP @128K(冷启动) 2905 2355 专家缓存 hit 中位 97%~98%(本次基准全程) 88%;高负载请求 93~95% 两台都是 MTP spec=4、spec-min-p 0.5。A 机 hit 常年 96%+,基本纯显存+RAM 推理,TG 全程 100+ 不随上下文衰减;B 机 RAM 只有 32GB,hit 低一档,长上下文时 PCIe 补传成为瓶颈,128K 档 TG 掉到 87。
启动参数
A(7900 XTX / IQ3_S):
--serve \
--pack "$PACK_DIR" \
--native "$GGUF_00001" \
--ple-gguf "$GGUF_00002" \
--expert-profile "$EXPERT_PROFILE" \
--expert-cache auto \
--prefill auto:32768 \
--spec 4 \
--spec-min-p 0.5 \
--mtp "$MTP_RT_DIR" \
--mtp-window 4096 \
--max-context 262144 \
--ple-io direct \
--kv int8 \
--vram-reserve-mib 768 \
--kv-resident 32768 \
--pcie-frac 0 \
--pool-workers 24 \
--mtp-q4 all \
--vision \
--conversation-cache-mib 98304 \
--conversation-cache-slots 64 \
--conversation-cache-min-tokens 2000 \
--conversation-cache-min-free-mib 8192
A 机环境变量要点:
HSA_OVERRIDE_GFX_VERSION=11.0.0、GPU_MAX_HW_QUEUES=6、STRATA_HIPBLASLT_TUNING=gfx1100表、RDNA kernel 开关一批(GR_RDNA / GDN / PF_FUSED 系列)、STRATA_SH_STREAM=0(实测开=掉15%)。B(3080 / TQ2_0):
--serve \
--pack "$PACK_DIR" \
--native "$MODEL_GGUF" \
--ple-gguf "$MODEL_GGUF" \
--expert-profile "$EXPERT_PROFILE" \
--expert-cache auto \
--prefill auto \
--spec 4 \
--spec-min-p 0.5 \
--mtp "$MTP_RT_DIR" \
--max-context 262144 \
--kv int8 \
--mmap-experts \
--resident-experts \
--vram-reserve-mib 768 \
--ple-io mmap \
--ple-row-cache 4000000
B 机非默认环境变量只有三项:
STRATA_NO_ACQUIRE=1、CUDA_DEVICE_ORDER=PCI_BUS_ID、STRATA_RESIDENT_HEADROOM_GIB=3;引擎自动项:CPU pool 22 workers、prefill chunk 自动降到 8192(RAM 不够常驻专家+大块)、batch 2 slot。视觉助手两台都放 CPU(strata-vision,不占显存)——小显存卡的必要配置;B 机因此腾出的显存全部给了专家缓存。
智能程度对比(量化档差异)
两台同底模 Qwen3.8-Flash-Next,只差量化档:A = GSQ-RCO-IQ3_S(约3bit),B = Gyro-M TQ2_0(约2bit)。14 题混合卷(算术、逻辑、代码阅读、中文填空/常识、指令格式、信息抽取),两台同题同参、同轮并行各跑一遍:
reasoning_effort = medium(两台统一,不用 xhigh)max_tokens = 32768,保证思考链+正文都装得下,不靠截断逼答案temperature = 0,只采信finish_reason=stop的完整回答
指标 A:IQ3_S B:TQ2_0 得分(14题) 13/14 13/14 有效13题输出 tokens 1,834 2,047(多12%) 有效13题思考字符 3,417 3,670(多7%) 平均单题耗时 2.9s 2.4s 长生成(宫殿题)耗时 225s 108s 唯一未通过的是数列题(2,3,5,11,31),我把这题标为作废——它本身有歧义(多种规律都能自圆其说),两台也给出了不同答案。但两台的失败方式有区别,值得记下来:A 思考了 46,764 字符、撞满 32,768 token 上限(finish=length),一个字的答案都没吐出来;B 在 24,598 token 时自行收尾、答了 106(错)。A 这种"思考跑飞"是真实存在的稳定性差异,B 没有出现。
除此之外 13 题两台全对,正确率没有可测差距。可测的差异是 token 效率与速度:A 每题省约 12% token,B 平均快 0.5 秒/题,长任务上快一倍。
长任务对比(宫殿设计,medium 档重测)
11-18 晚在干净状态下用 medium 档把宫殿题在两台重跑了一遍(原 xhigh 数据按要求全部弃用)。题目:明清官式「承天宫」设计说明书,12 项硬约束 + 术语解释 + 工序顺序 + 2500 字下限,
max_tokens=24000:方案 输出tokens 思考字符 耗时 正文字数 12项硬约束 术语3项 工序顺序 建筑尺度 A:IQ3_S(medium) 23,365 29,799 225s 4,764 12/12 3/3 正确 崩 B:TQ2_0(medium) 13,060 12,528 108s 3,029 12/12 3/3 正确 合理 两台的硬约束、斗拱/顶型解释、工序顺序都满分,差别全在尺度校验上:
- A 照字面执行模数,算出了荒谬的尺寸:题面给「斗口=0.1米,主殿明间取7斗口」,A 老老实实做成 0.70 米/间,于是九间主殿面阔总长只有 4.30 米,整座宫城 18 米 × 14 米——比一间农舍还小,却写着"皇家宫殿"。
- B 看出尺度不对,自己把模数改了:把"7斗口"理解成"七十斗口=7米",主殿面阔总长 47 米,宫城 120 米 × 70 米,尺度站得住;代价是违反了题面的字面约束,而且没有说明为什么改。
所以这题的真实结论是没有谁全面胜出:A 更"听话"但不会做常识校验,B 会做常识校验但擅自改条件。顺带说明,这题的条件本身自相矛盾(斗口 0.1 米 × 7 斗口 = 0.7 米/间,凑不出九间宫殿),严格说这是出题方的锅。
另:宝光寺扩建(9座建筑)那题之前只跑过 xhigh 档,按要求一并弃用,这轮没重测,所以本文不含该题数据。
补充一个校验器口径:自动校验器把两台的"工序顺序"都判false,是误判——它取全文首次出现位置,而前面的说明章节早就提过"台基""柱""梁",真正的施工工序章里两台都是 基础→台基→柱网→梁架→屋面→装修→彩画 的正确顺序,我逐段人工核对过。
几点经验
- 内存比 GPU 更决定上限:A 机 256GB RAM 让 IQ3_S 专家全驻留(hit 97%+),128K 档 TG 还有 119;B 机 32GB 只装得下 23.26GiB 常驻,128K 档 hit 掉下来 TG 掉到 87。
- 短输入的 PP 看 CPU 路径:4K 冷启动 A 机只有 690 tok/s(Xeon Haswell 的 AVX2 首块 prefill 拖底),B 机靠 270K Plus 跑到 ~2011;长输入两边都走 GPU fused kernel,A 机反而更高。
- swap 必须彻底关掉:MoE 专家被换页到磁盘会让 decode 成倍变慢,宁可 OOM。
- B 机短请求 PP 只有几百 tok/s 是 prompt cache 复用后的增量口径,别拿去和冷启动比。
- A 机
--pcie-frac 0+--kv-resident 32768:专家全驻留后不需要按比例预取,KV 常驻换长上下文稳定性。
项目:Strata;模型:Qwen3.8-Flash-Next GGUF(A:GSQ-RCO-IQ3_S;B:Gyro-M TQ2_0 abliterated + gyro pack)。
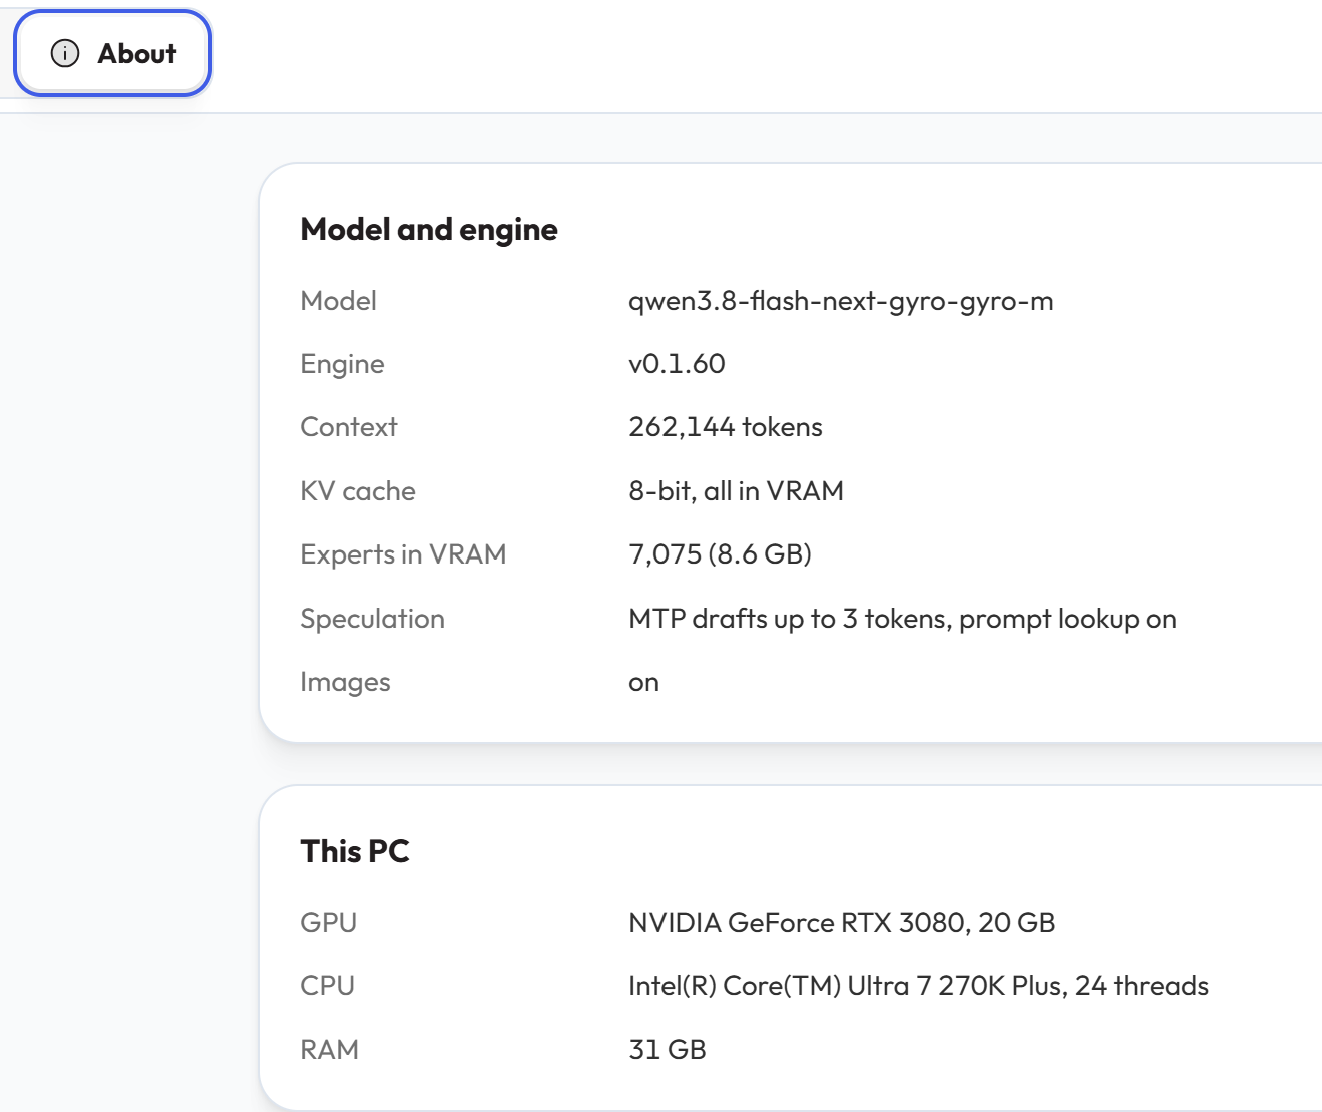
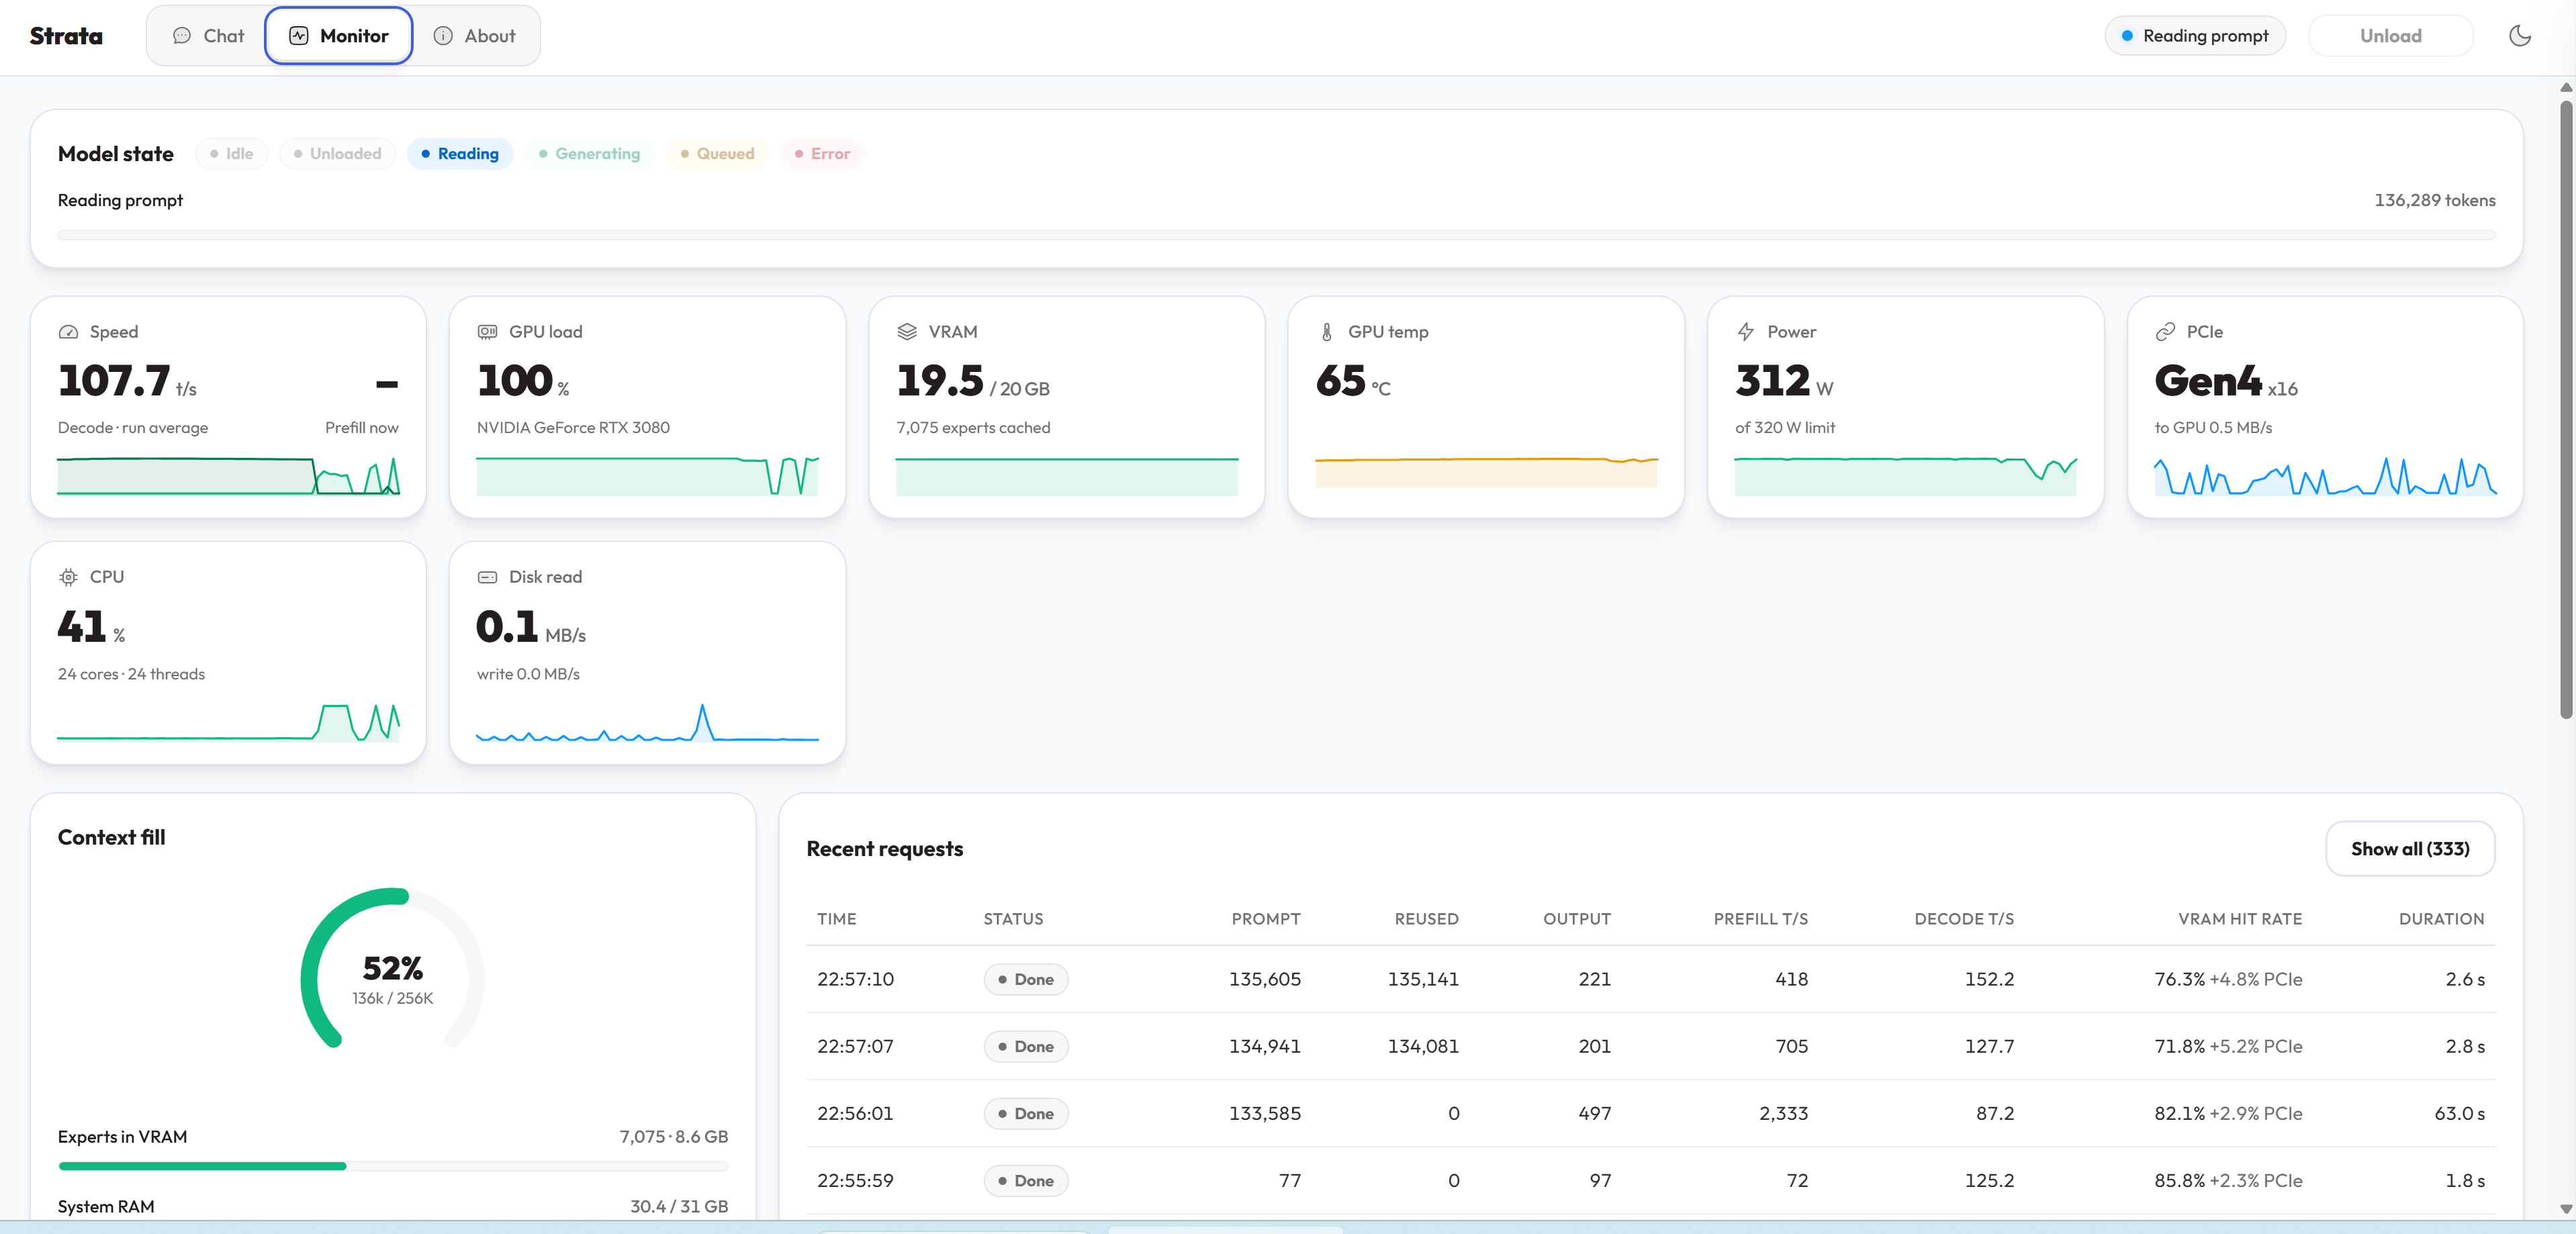
其实做agent的时候,decode的速度基本都没有下过100,很多时候都是跑到120以上,峰值最高曾经有169
-
-
哥们,亮点呢?此文发的没什么问题。存刷分?
@williamlouis 纯经验分享呀,刷啥分?没必要
-
哥们,亮点呢?此文发的没什么问题。存刷分?
@williamlouis 至于您提到了亮点,那不是显而易见的吗?32G的内存跑出如此的prefill和decode,智能度上也并不差IQ3 S ,我是非常满意了。
-
你满意就好。我看了就是交作业流派。
惊掉下巴 的意义没找到!