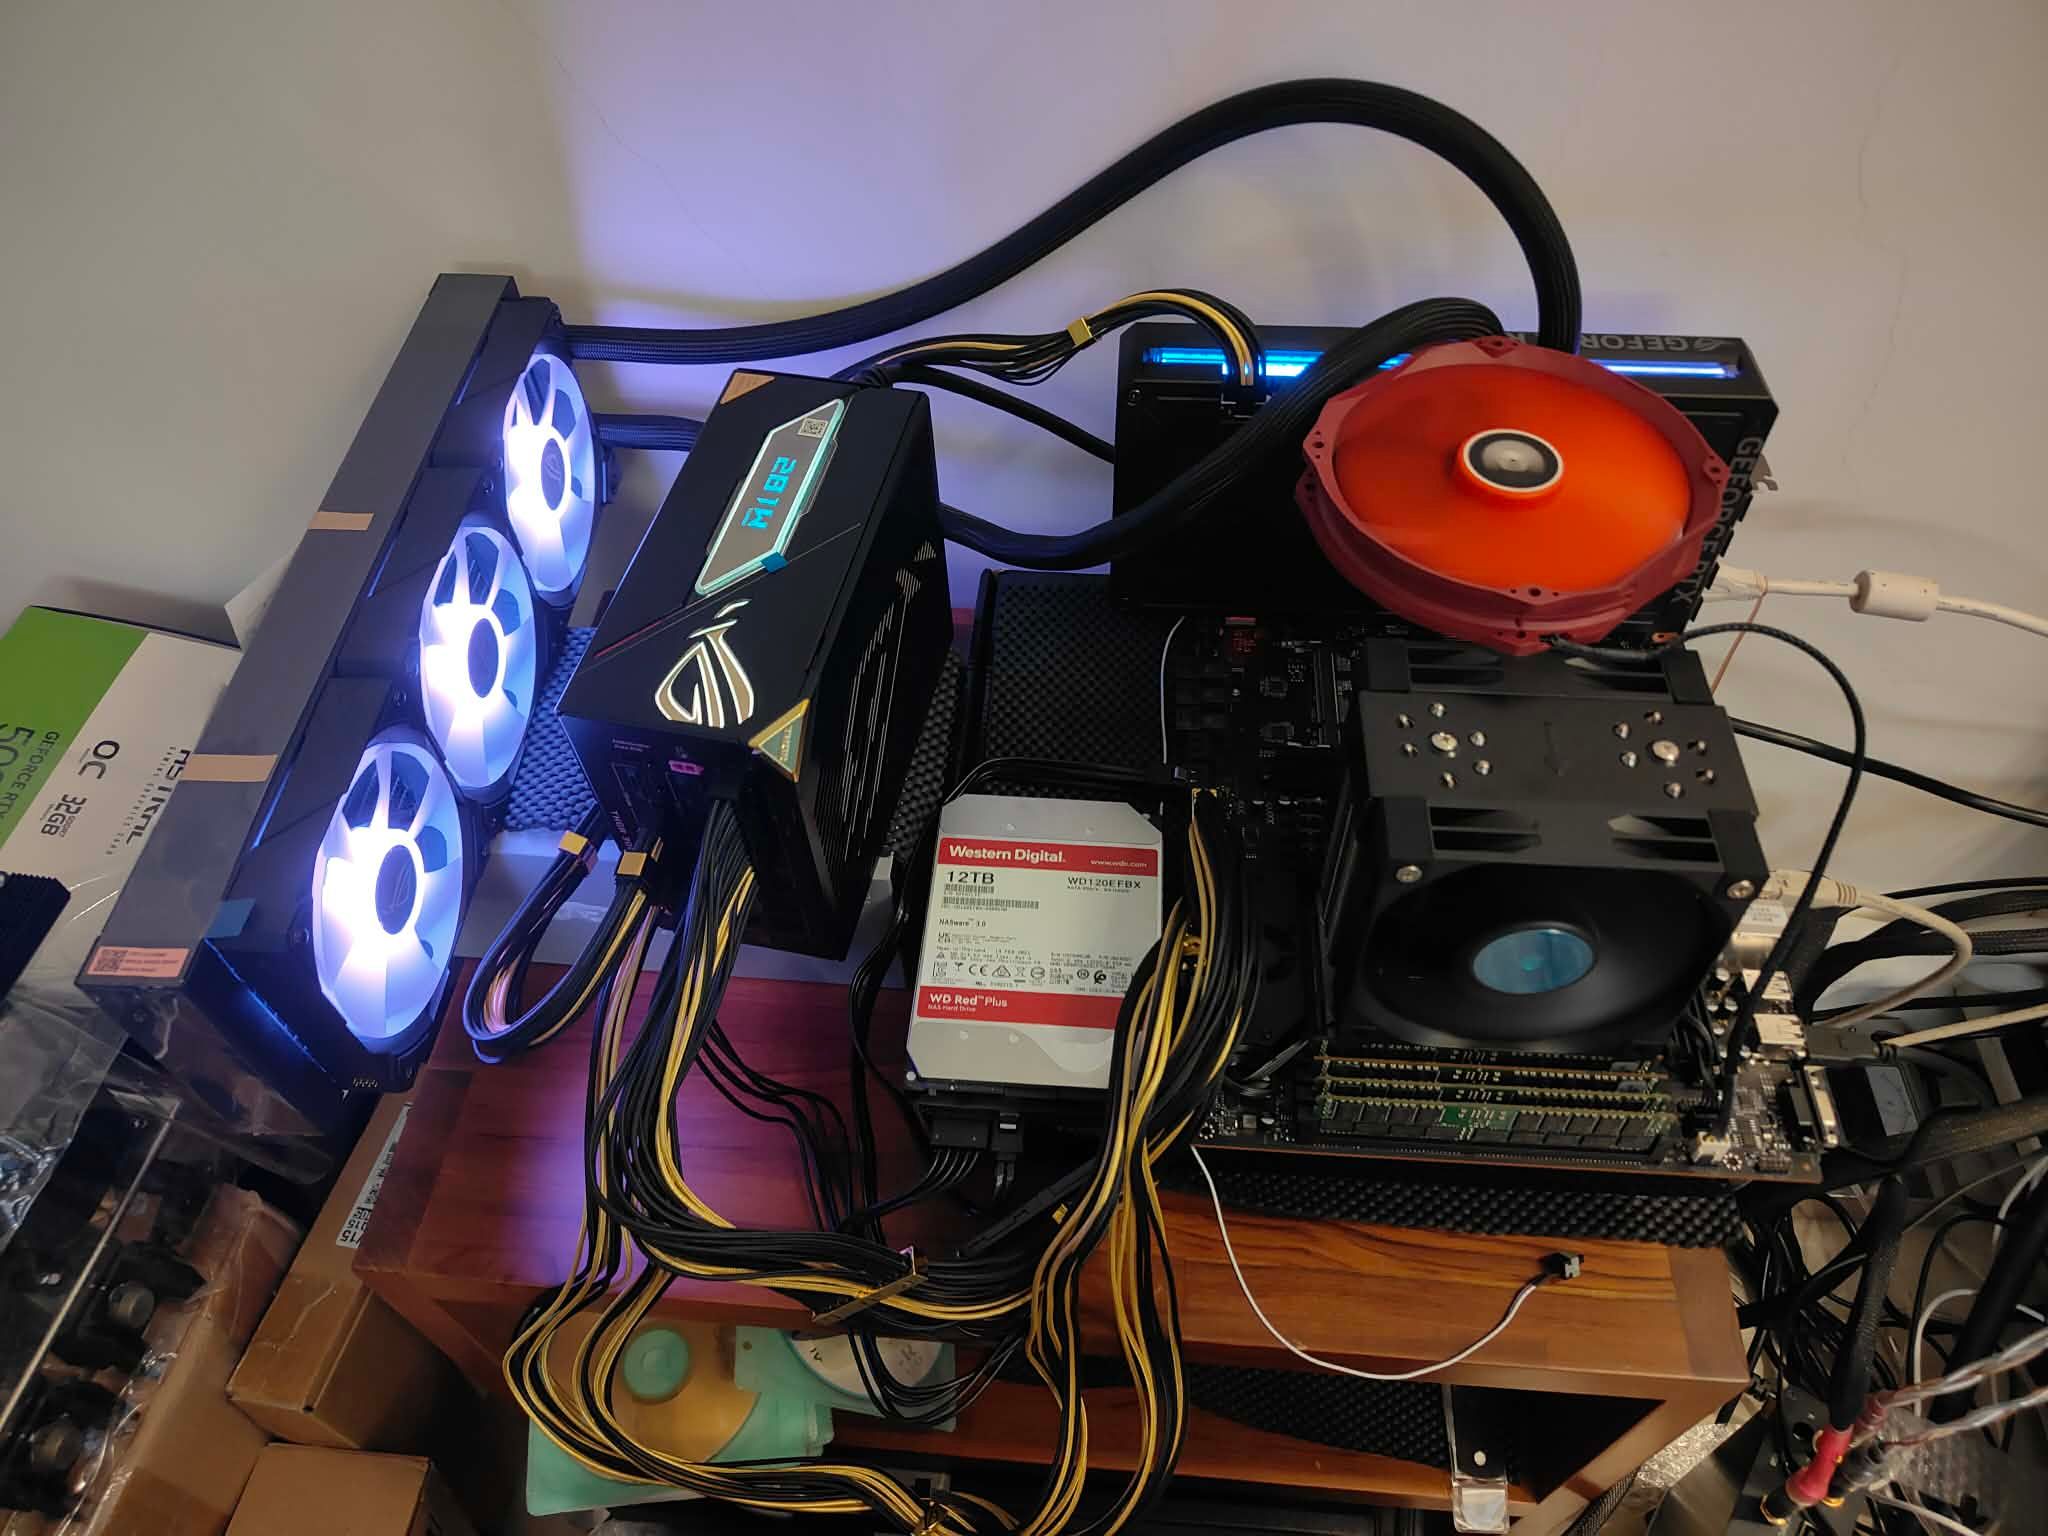
我的本地+雲端人工智慧工作站:單路 64 核心、八通道 256gb 記憶體、5090水夜神,三路 27B+120B/284B
分享一下我的硬體配置、模型部署及實際用途。這台電腦主要用於期貨報表分析、下載教學影片轉成逐字稿,以及整理重點與學習筆記。同時搭配兩個雲端模型協助研究與程式開發,未來希望逐步寫出自己的選股器與自動交易機器人。
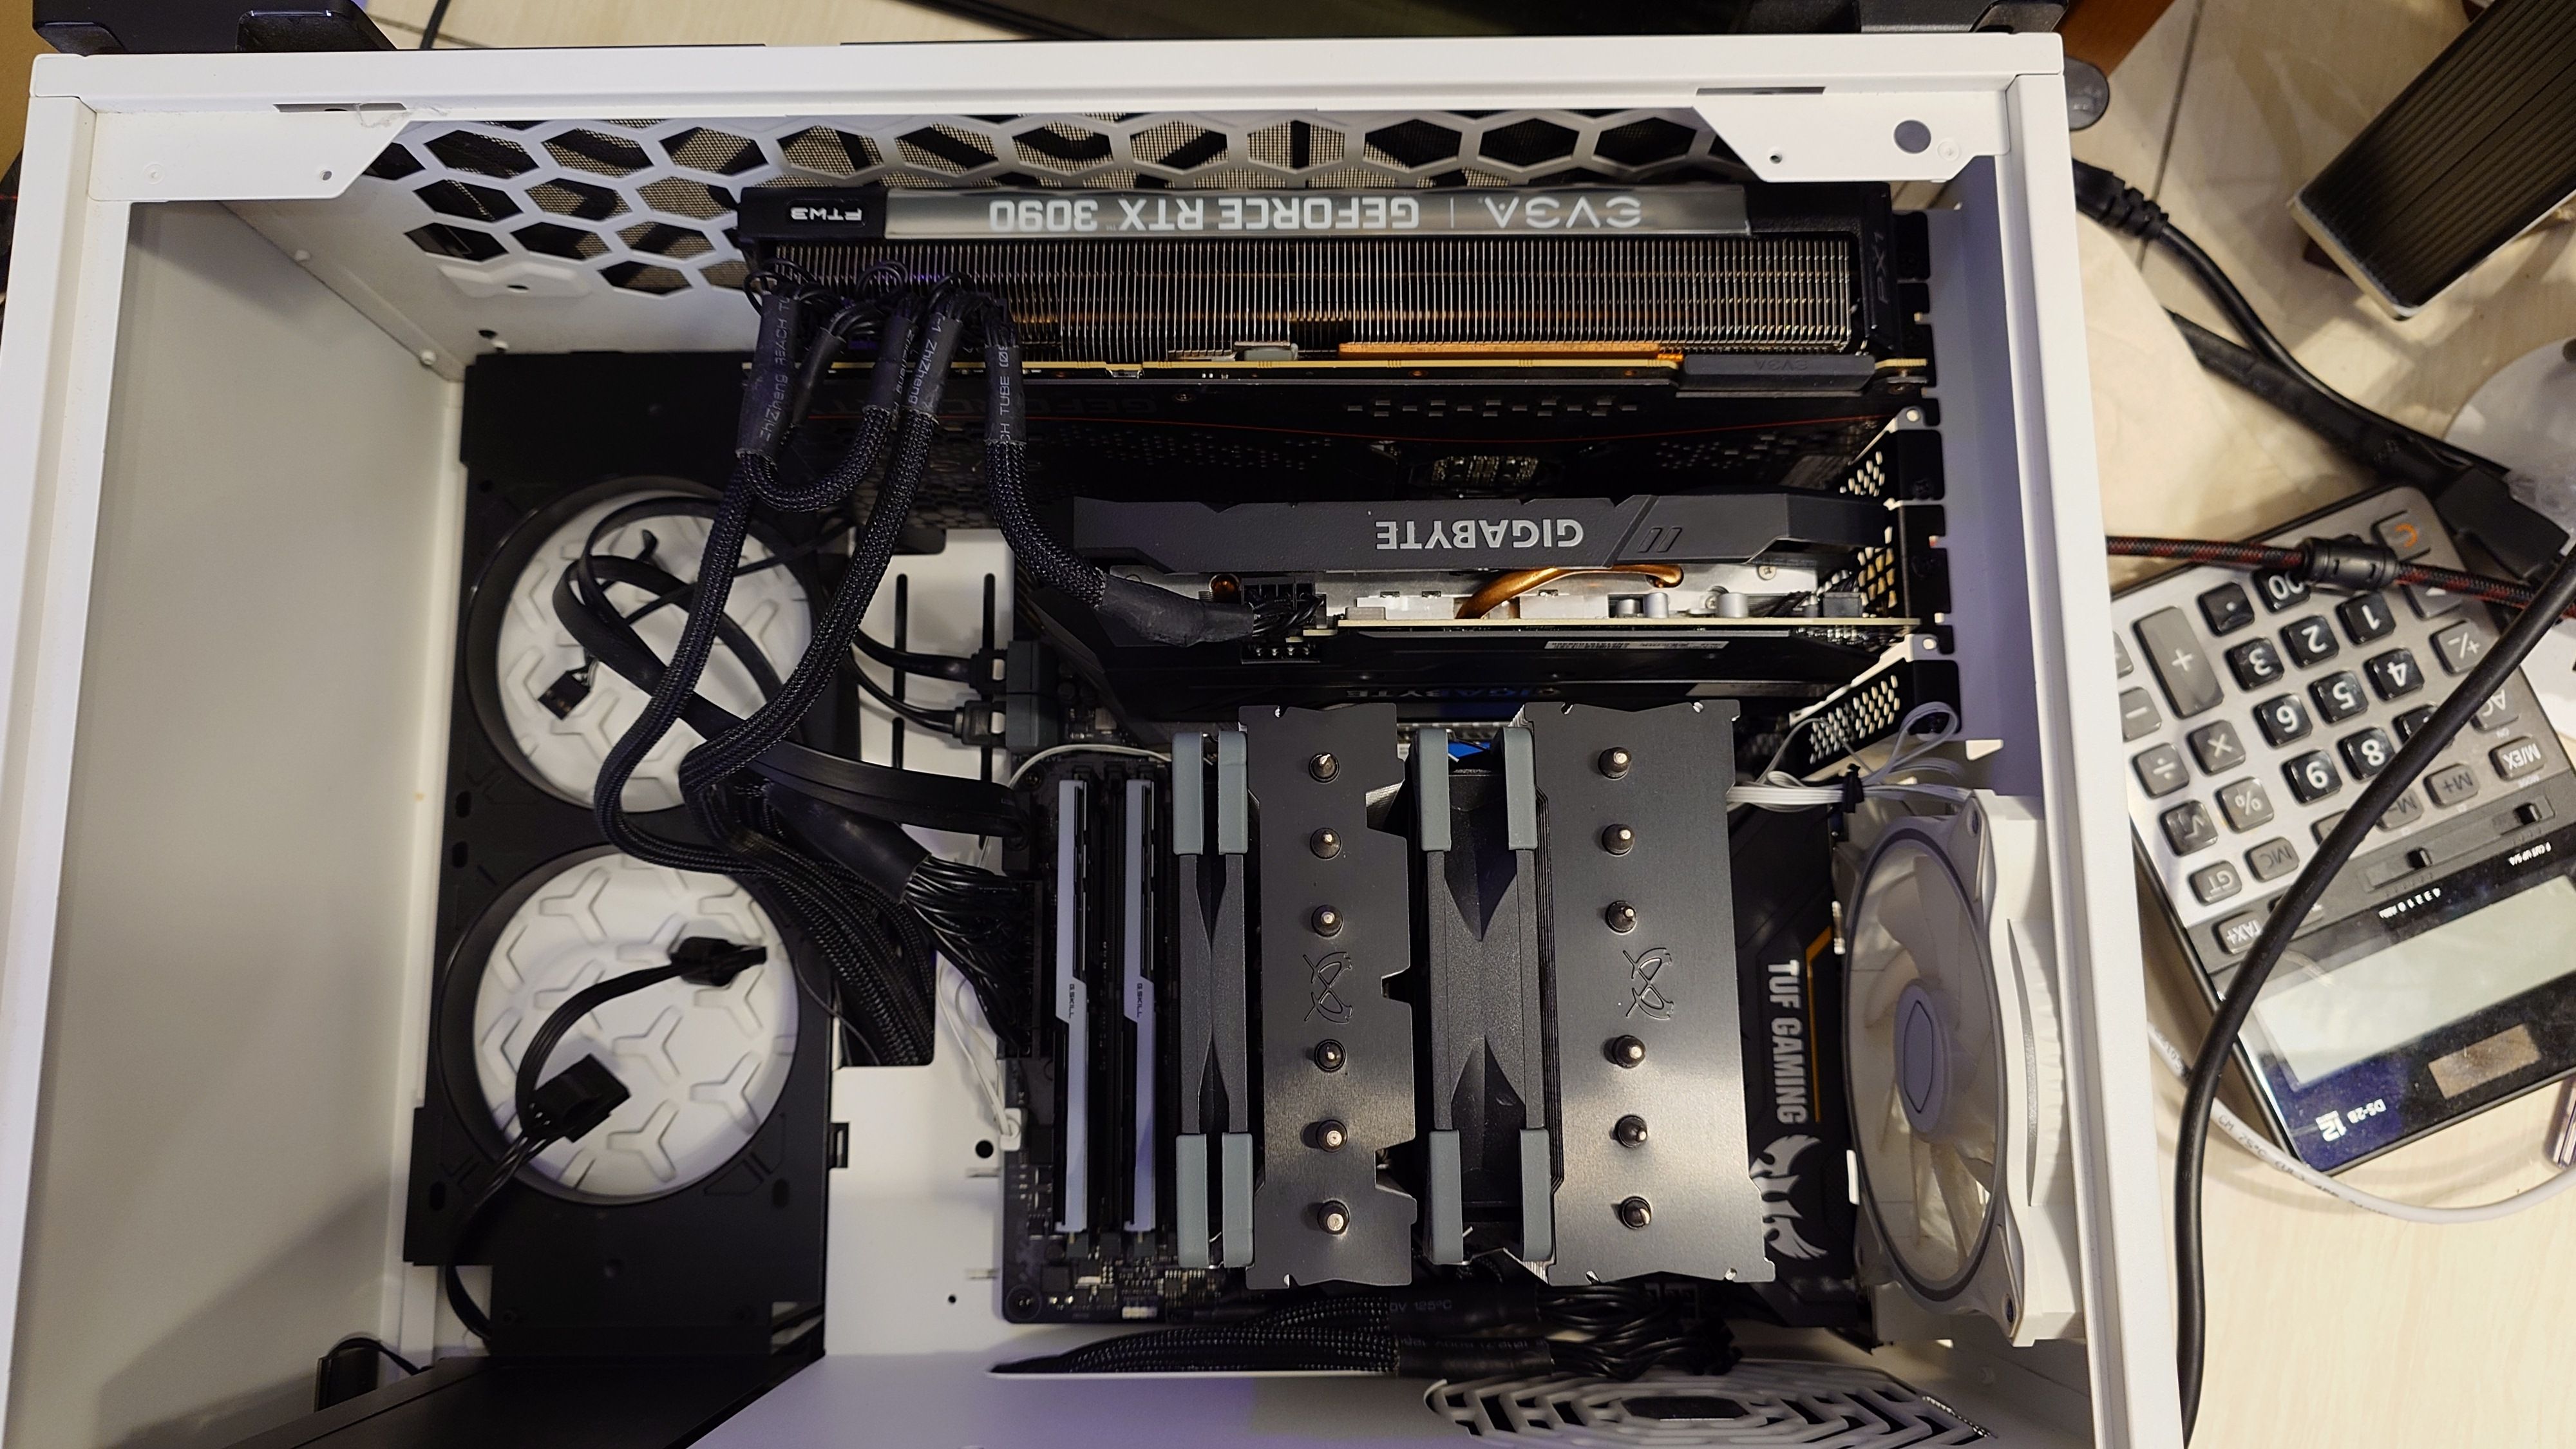
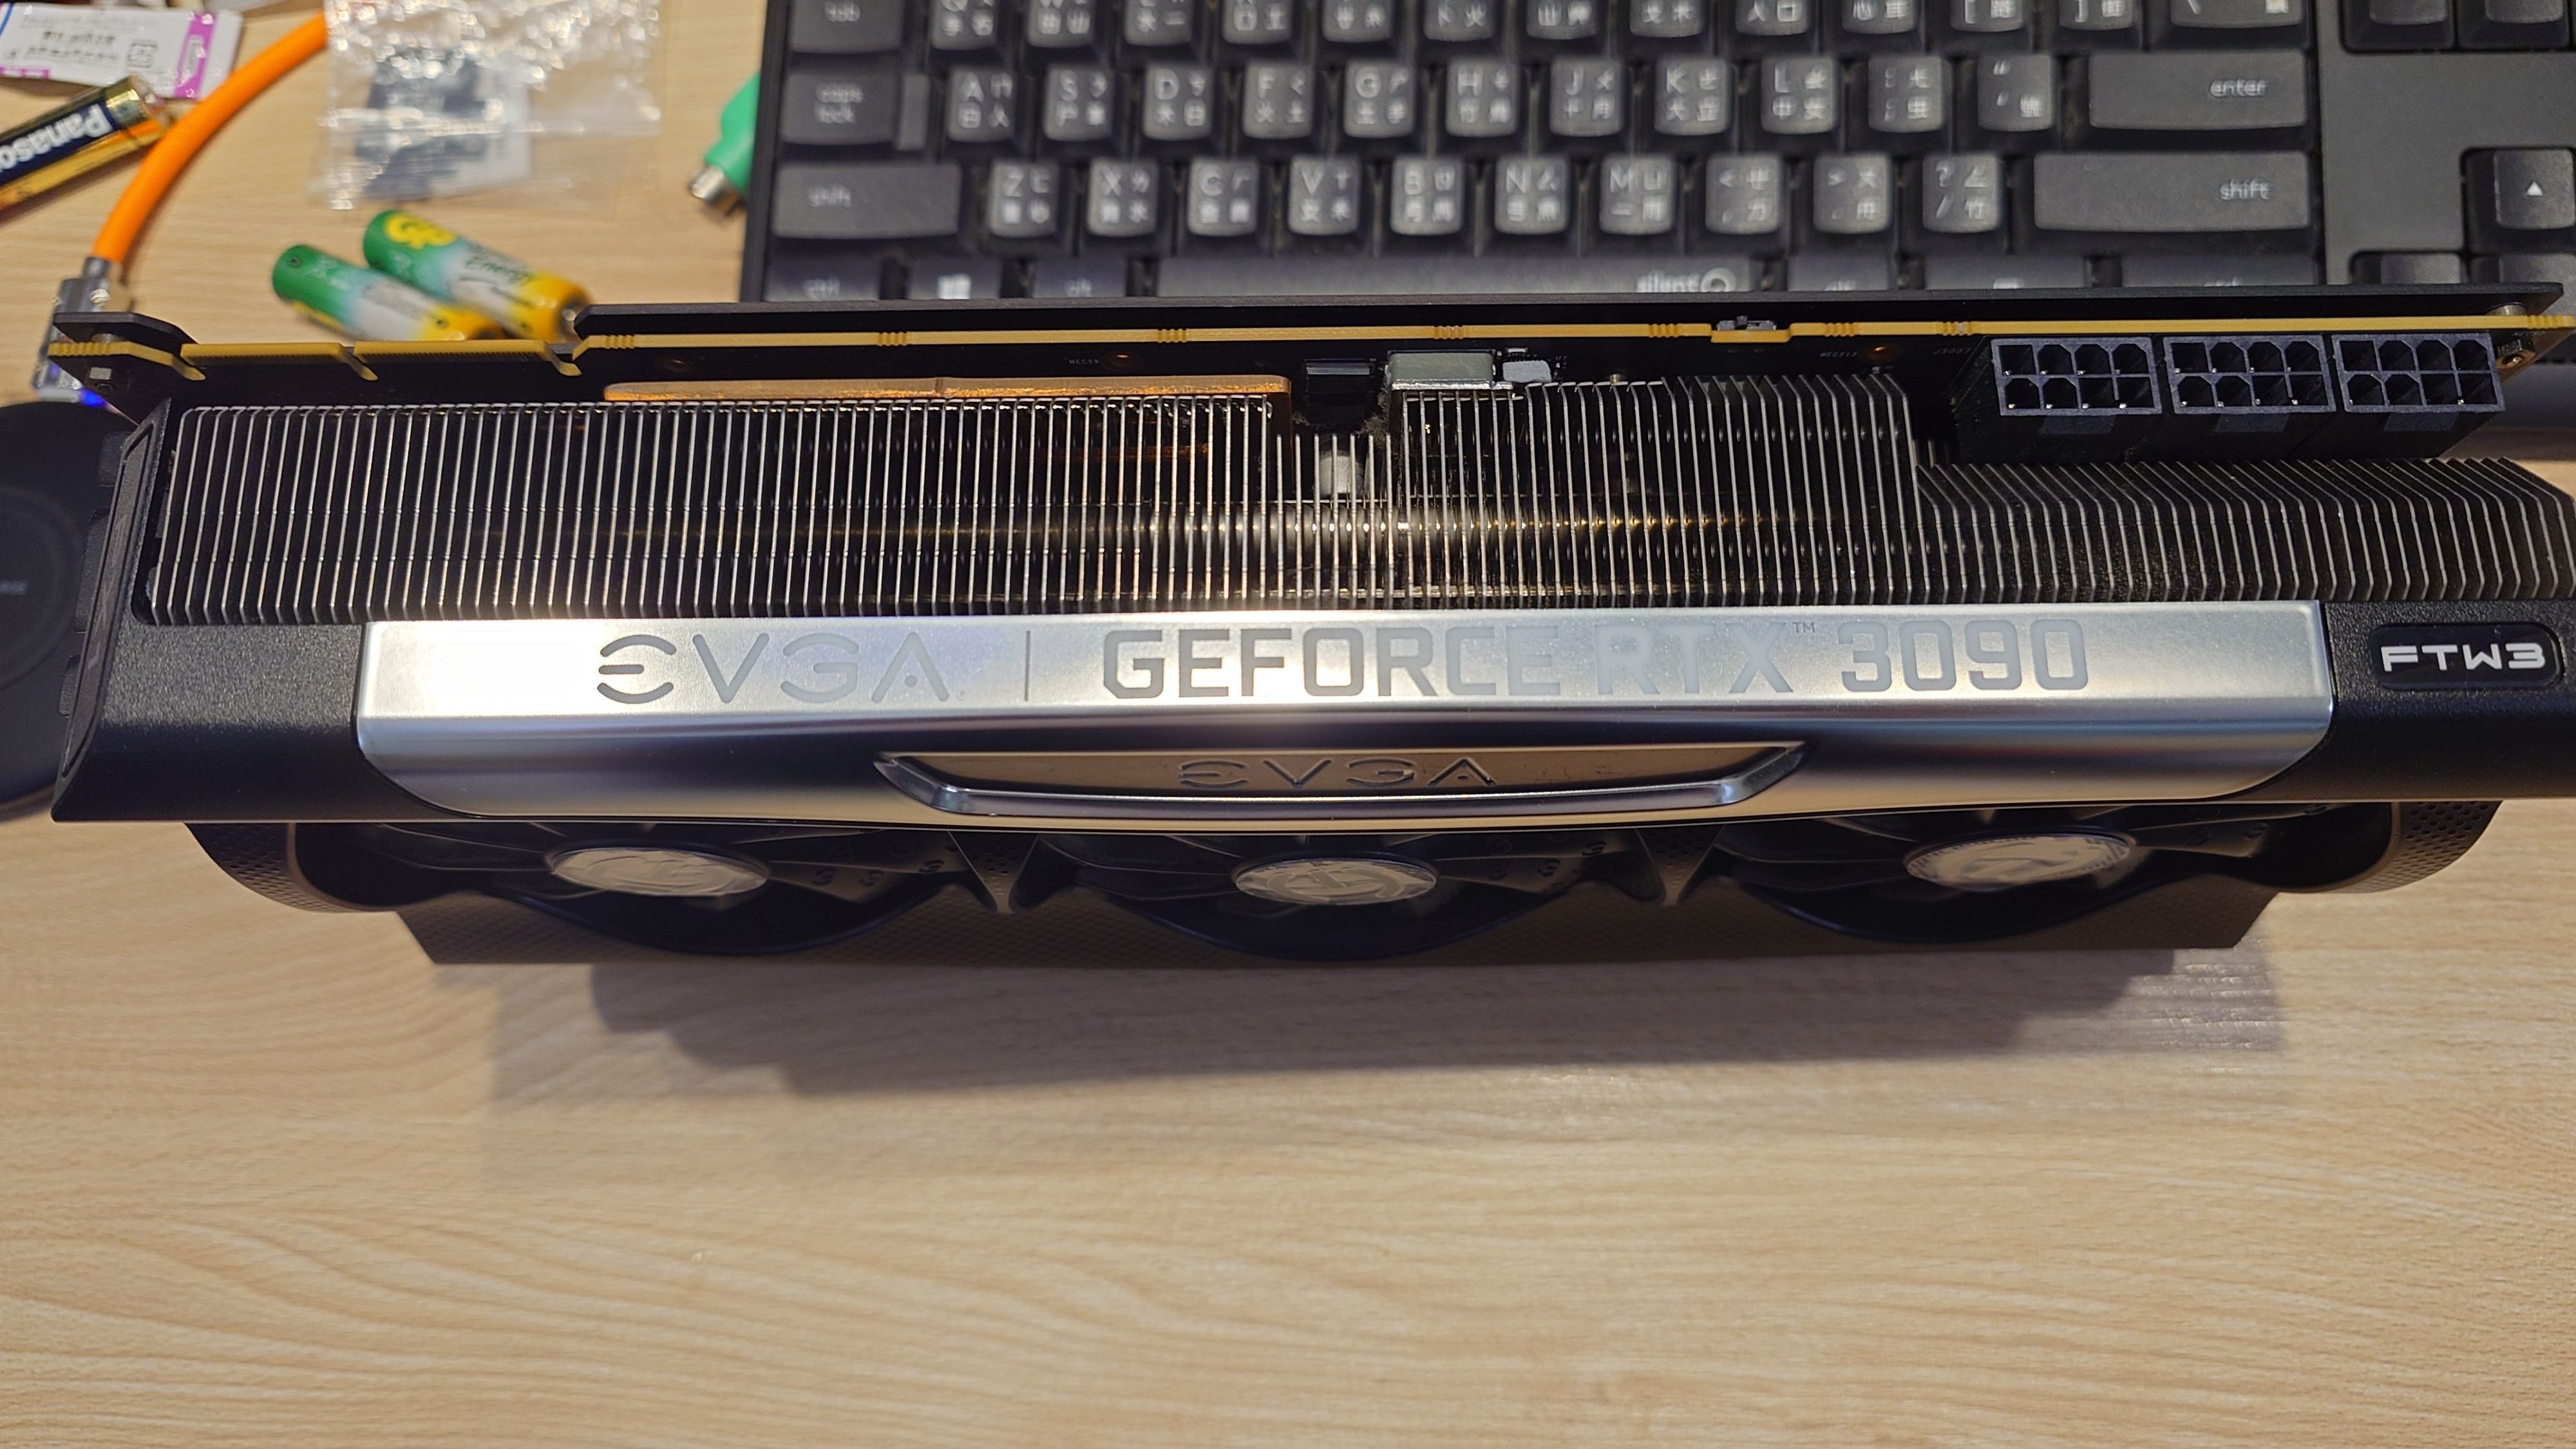
硬體方面,後續預計增加兩張魔改 48gb 的 4090,提升 120B/284B 的顯示卡運算比例。
一、主機硬體配置
| 項目 | 配置 |
|---|---|
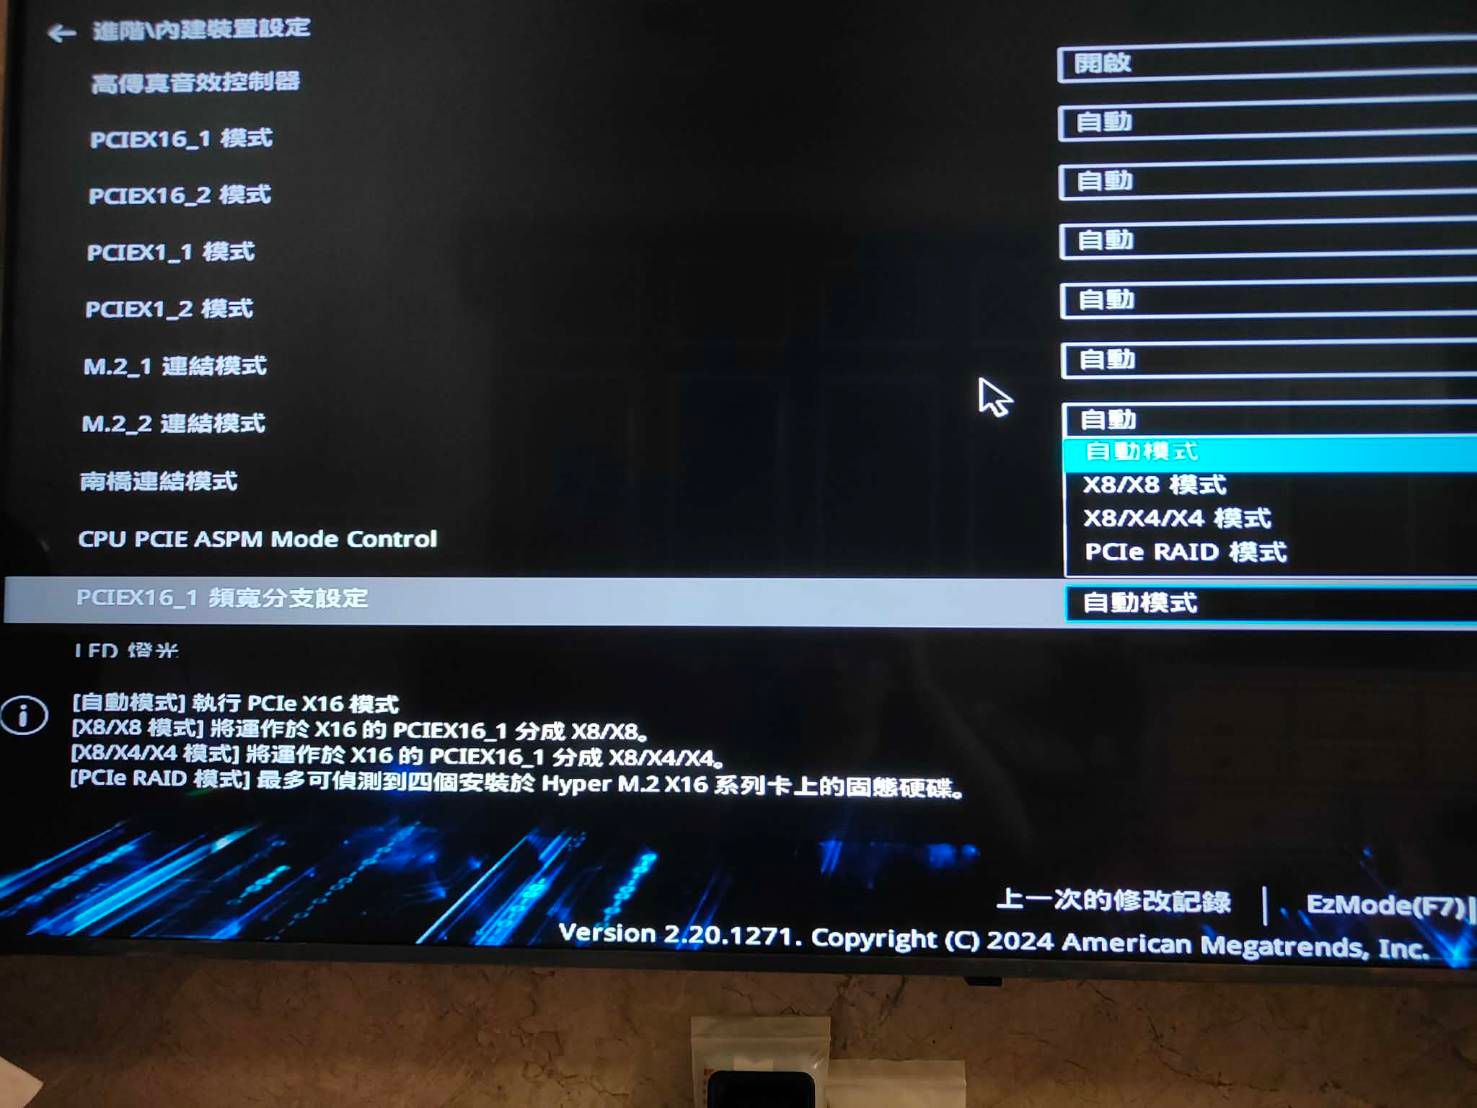
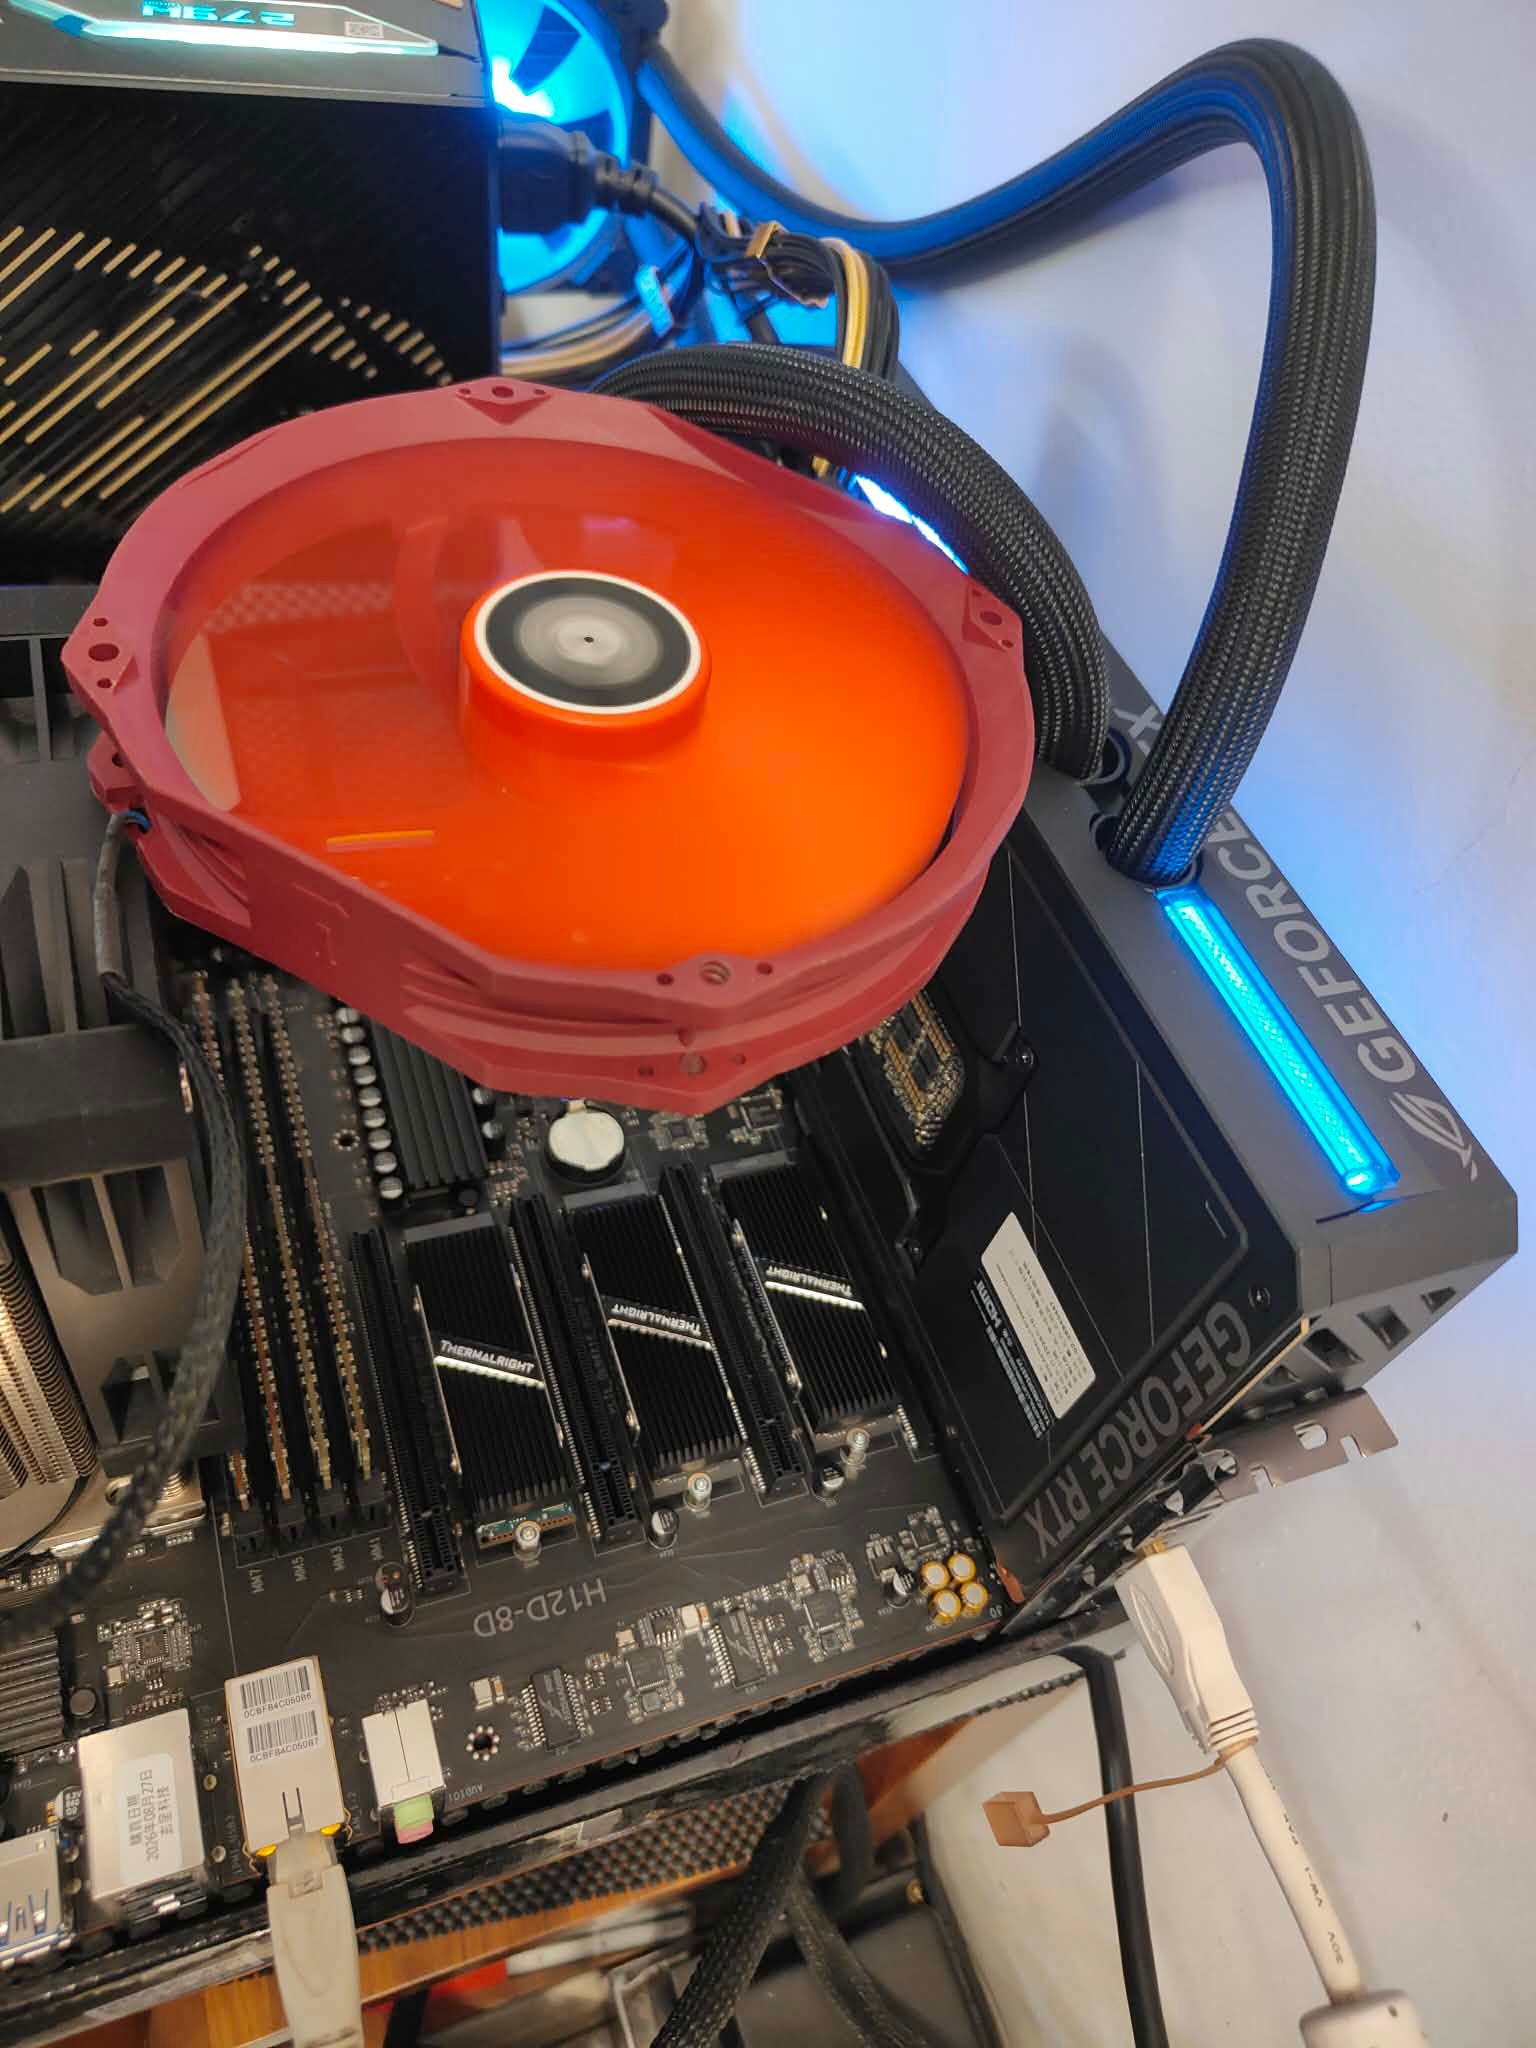
| 主機板 | HUANANZHI H12D-8D V2.0(華南金牌單路伺服器主機板) |
| 處理器 | AMD EPYC 7B12(超微伺服器處理器),單顆 64 核心、128 執行緒 |
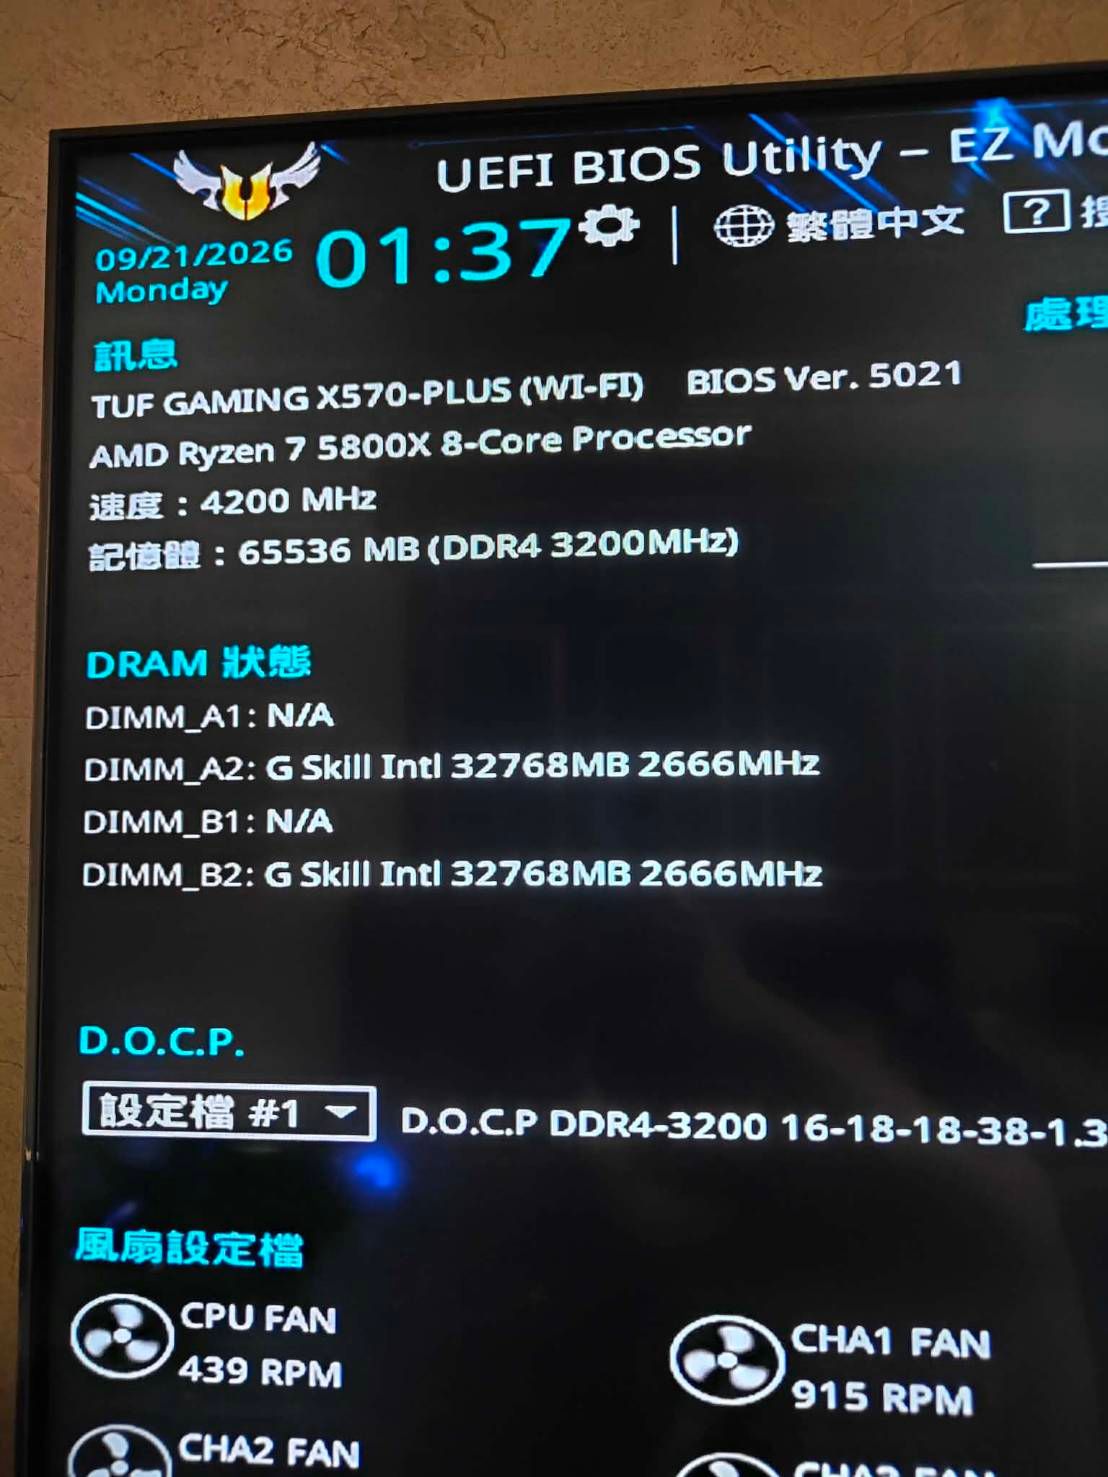
| 系統記憶體 | 256gb,8 條各 32gb,八通道配置 |
| 記憶體規格 | DDR4-2400 ECC RDIMM(第四代雙倍資料率、具錯誤修正功能的暫存式伺服器記憶體) |
| 記憶體組合 | Kingston(金士頓)HP24D4R7D4MAI-32 ×4;Micron(美光)36ASF4G72PZ-2G3B1 ×4 |
| 顯示卡 | NVIDIA GeForce RTX 5090(輝達顯示卡),32gb 顯存 |
| 顯示卡驅動 | 596.49 |
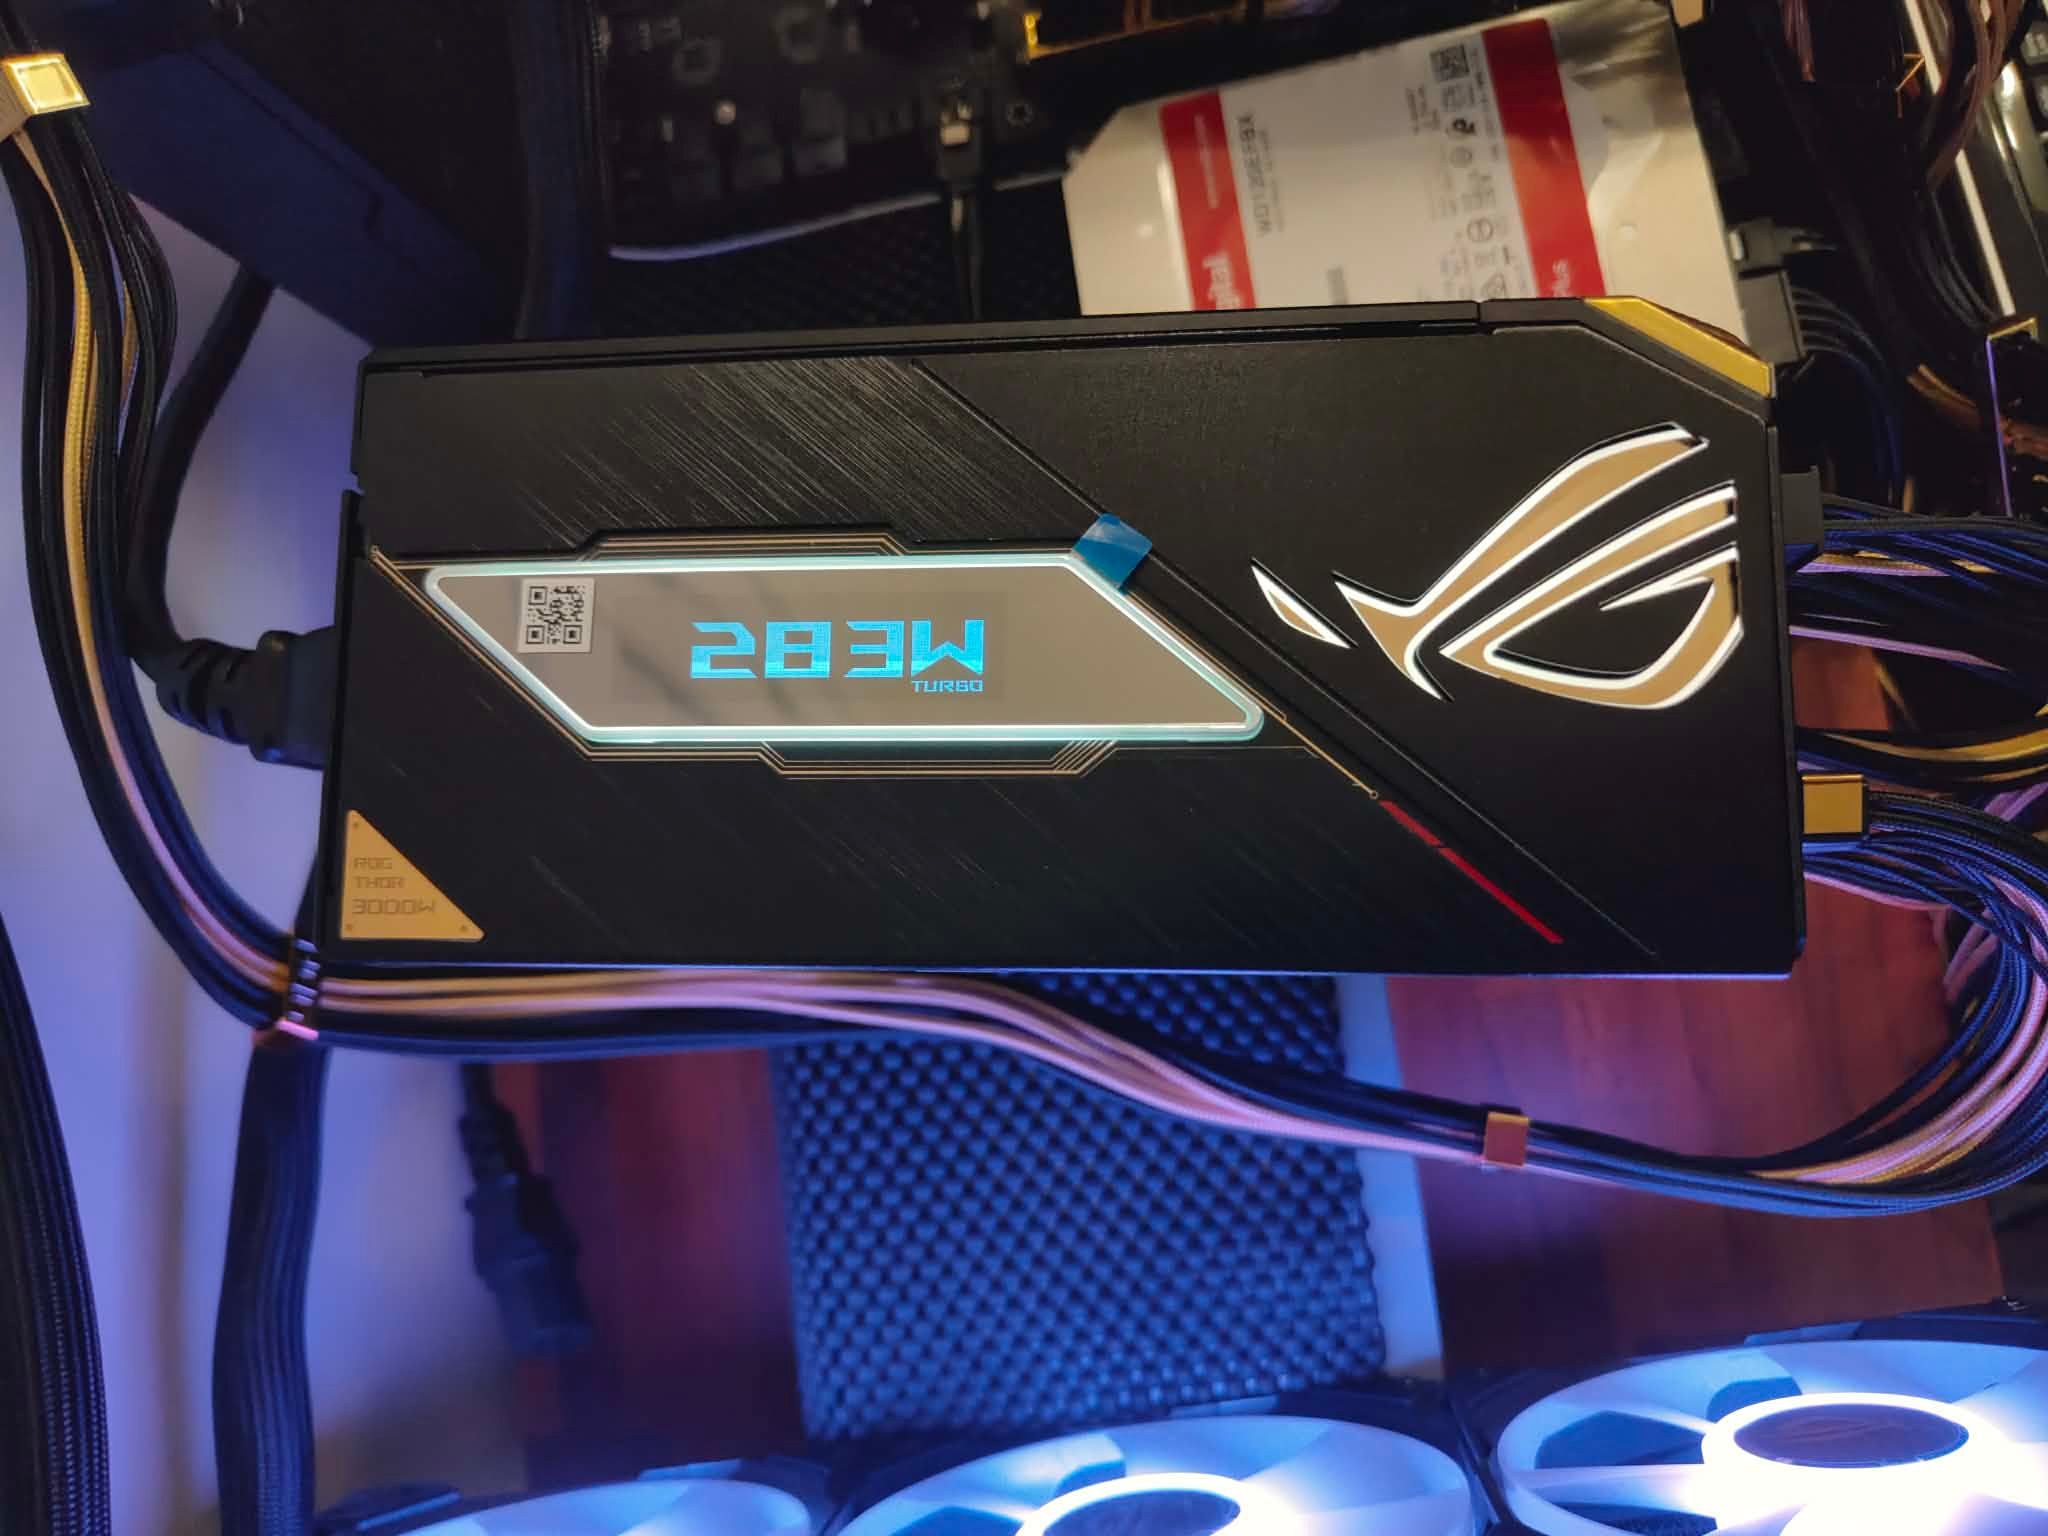
| 電源 | ROG(玩家國度)20 周年,3000 瓦 |
| 高速儲存 | 三張各 4,000gb 固態硬碟,其中兩張組成 RAID 0(條帶磁碟陣列),標稱合計約 8,000gb |
| 系統碟 | Kingston(金士頓)240gb 固態硬碟 |
| 大容量資料碟 | Western Digital(威騰電子)12,000gb 硬碟 |
| 作業系統 | Windows 10 Professional(視窗作業系統專業版),組建 19045 |
| 主機板韌體 | AMI(安邁)2.2,系統回報日期為 2026-01-06 |
這是單路、單顆處理器平台。主機板提供四個 PCIe 4.0 x16(第四代高速擴充介面、十六通道)插槽,以及三個 M.2(固態硬碟模組介面)插槽,可作為多卡與高速儲存擴充的基礎。
三張大容量固態硬碟的配置依實際裝機資料列示,個別品牌與完整型號尚未全部列齊;機殼、散熱器、風扇及顯示卡板卡品牌也未列入這份清單。
二、八通道記憶體與頻寬
八通道除了提供 256gb 容量,也讓處理器可以透過更多記憶體通道讀取資料。依目前每秒 2400 百萬次傳輸的速率計算:
每通道理論資料頻寬=2400 百萬次傳輸/秒 × 8 位元組=19.2gb/秒。
八通道理論總頻寬=19.2 × 8=153.6gb/秒。
| 相同記憶體速率下的配置 | 理論總頻寬 |
|---|---|
| 雙通道 | 38.4gb/秒 |
| 四通道 | 76.8gb/秒 |
| 八通道 | 153.6gb/秒 |
以上是十進位理論資料頻寬,實際持續頻寬會受到存取模式、執行緒配置及其他工作負載影響。
目前 120B/284B 使用處理器與系統記憶體執行,因此記憶體頻寬會影響權重讀取與推理效率。不過,八通道理論頻寬是雙通道的四倍,不代表模型生成速度必然提高四倍。
三、儲存與資料分工
三張各 4,000gb 固態硬碟中,兩張組成 RAID 0(條帶磁碟陣列),提供大型工作空間;另一張作為獨立儲存。
主要保存:
- 大型模型與模型分片。
- 影片下載、音訊及逐字稿處理資料。
- 期貨行情、交易紀錄與分析中間資料。
- 程式環境、專案與工作檔案。
目前主要磁碟區包括系統用的 C 槽、大容量資料用的 D 槽,以及模型與工作資料所在的 Y 槽。B 槽用於人工智慧產出資料與報告,E 槽則為其他系統與資料分區。
條帶陣列主要改善大型檔案讀寫與模型載入效率。模型載入後,生成速度仍主要受運算裝置、記憶體頻寬與推理引擎影響。
四、本地+雲端模型架構
| 模型 | 執行位置 | 配置與用途 |
|---|---|---|
| Qwen3.8-27B(通義千問模型) | 本地 5090 | 三路併發,共用 96k 快取池,日常互動與工具工作 |
| gpt-oss-120b(開放權重文字模型) | 本地處理器+系統記憶體 | 一路,服務端 128k,文字與程式分析 |
| DeepSeek-V4-Flash-Vision-Exp(深度求索視覺實驗模型) | 本地處理器+系統記憶體 | 一路,服務端 512k,大型文件與視覺分析 |
| Astra(雲端模型) | Codex(程式開發與工作代理工具) | 程式開發、複雜問題分析與專案整合 |
| DeepSeek V4(深度求索第四代雲端模型) | DSH(人工智慧工作介面) | 資料分析、長文整理與交叉檢查 |
「三路 27B」指同一份模型權重承接三路併發工作,三路共用 96k 快取池,並非載入三份完整模型,也不是每一路都有獨立的 96k。
以下本地模型名稱與量化版本依本機檔案、啟動設定及服務回報列示。雲端的具體子版本則依當次選用設定為準。
五、27B 詳細設定
模型:Qwen3.8-27B(通義千問模型)。
使用 NVFP4(輝達四位元浮點量化)版本,由 Ninfer(本地推理引擎)執行。
本機檔案:
qwen3_8_27b_nvfp4.ninfer
檔案約 21.49gb,這是十進位磁碟檔案大小,不等於服務啟動後的顯存占用。
| 設定 | 數值 |
|---|---|
| 運算裝置 | 5090,32gb 顯存 |
| 後端/客戶端轉接埠 | 8083/8084 |
| 最大上下文 | 96k |
| 共用快取容量 | 96k |
| 最大併發 | 3 |
| KV(鍵值快取)格式 | FP8(八位元浮點) |
| 裝置狀態槽設定 | 3 |
| 主機狀態槽/主機快取設定 | 0/0 |
| 推測解碼 | MTP(多詞元預測) |
| 每輪草稿詞元 | 3 |
| 思考模式 | 關閉 |
| 客戶端最大輸出設定 | 8k |
這一路主要承接日常互動、工具呼叫、程式協作,以及逐字稿與資料的初步整理。
六、120B 詳細設定
模型:gpt-oss-120b(開放權重文字模型)。
量化版本:Q4_K_M(混合四位元量化,中等配置)。
模型共有兩個分片,首個分片為:
openai_gpt-oss-120b-Q4_K_M-00001-of-00002.gguf
兩個分片合計約 62.84gb,採十進位計算。
| 設定 | 數值 |
|---|---|
| 推理引擎 | llama.cpp(本地模型推理程式),版本 b10766 |
| 客戶端/後端服務埠 | 11453/19453 |
| 服務端上下文 | 128k |
| 客戶端目錄上下文 | 64k |
| 推理/批次處理執行緒 | 16/16 |
| 網路處理執行緒 | 2 |
| 平行工作槽 | 1 |
| 微批次大小 | 64 |
| 鍵快取/值快取 | Q8_0(八位元量化) |
| 顯示卡卸載層數 | 0 |
| 載入方式 | mmap(記憶體映射) |
| 額外提示快取容量設定 | 0 |
| 客戶端最大輸出設定 | 8k |
目前以處理器與系統記憶體運算,定位為較複雜的期貨報表解讀、文字分析與程式協作。
服務端設為 128k,但客戶端目錄仍登錄 64k,實際使用時須考慮入口本身的限制。
七、284B 詳細設定
模型:DeepSeek-V4-Flash-Vision-Exp(深度求索視覺實驗模型)。
本機檔案版本:
DeepSeek-V4-Flash-Vision-Exp-UD-Q4_K_XL
模型共有五個分片,另帶視覺投影檔:
mmproj-F16.gguf
模型與視覺投影檔合計約 156.03gb,採十進位計算。
檔名保留原始量化後綴;服務端另外回報 MXFP4 MoE(微縮放四位元浮點、混合專家)類型,因此不將全部張量描述成使用相同的四位元格式。
| 設定 | 數值 |
|---|---|
| 推理引擎 | llama.cpp(本地模型推理程式),版本 b10766 |
| 客戶端/後端服務埠 | 11452/19452 |
| 服務端上下文 | 512k |
| 推理/批次處理執行緒 | 24/24 |
| 網路處理執行緒 | 2 |
| 平行工作槽 | 1 |
| 微批次大小 | 64 |
| 鍵快取/值快取 | Q8_0(八位元量化) |
| 顯示卡卸載層數 | 0 |
| 視覺投影運算 | 處理器 |
| 載入方式 | mmap(記憶體映射) |
| 額外提示快取容量設定 | 0 |
| 客戶端最大輸出設定 | 8k |
主要定位為大型文件、跨文件比對、圖片資料與長上下文分析。512k 是目前配置容量,尚未完成填滿上下文的長時間穩定性驗證。
八、三種模型的實測速度
以下為 2026 年 9 月 13 日的本機測試,當時同時執行 27B 三路、120B 一路、284B 一路,共五路工作。
速度單位為 tok/s(每秒生成詞元数),不等於每秒中文字數。
| 模型/工作路 | 30 分鐘測試生成速度中位數 | 5 分鐘複測生成速度中位數 |
|---|---|---|
| 27B 第 1 路 | 24.53 tok/s(每秒詞元) | 22.30 tok/s(每秒詞元) |
| 27B 第 2 路 | 24.50 tok/s(每秒詞元) | 22.67 tok/s(每秒詞元) |
| 27B 第 3 路 | 24.58 tok/s(每秒詞元) | 21.99 tok/s(每秒詞元) |
| 120B | 11.42 tok/s(每秒詞元) | 11.66 tok/s(每秒詞元) |
| 284B | 4.71 tok/s(每秒詞元) | 4.44 tok/s(每秒詞元) |
120B 與 284B 使用服務端生成計時;27B 使用客戶端首段至末段輸出的時間估算,包含與其他請求交錯的等待,計時口徑並非完全相同。
若把提示處理、排隊、輪次間隔與收尾全部計入,30 分鐘測試的整體輸出效率約為:
| 模型 | 整體輸出效率 |
|---|---|
| 27B 三路合計 | 49.63 tok/s(每秒詞元) |
| 120B | 8.94 tok/s(每秒詞元) |
| 284B | 3.74 tok/s(每秒詞元) |
各路生成速度的中位數不能直接相加,當成整段測試的總吞吐量;批次工作效率應參考整體輸出。
測試條件:
- 30 分鐘測試完成 440 個請求,失敗 0 個。
- 5 分鐘複測完成 69 個請求,失敗 0 個。
- 27B 每路輸入約 31k,三路共用快取池最高配置約 97.85%,其中包含保留頁。
- 120B/284B 每筆輸入約 0.27k。
- 每筆輸出為 0.25k。
- 120B/284B 雖分別配置 128k/512k,但測試未填滿其上下文。
30 分鐘測試的系統記憶體峰值約 222.38gb,顯存峰值約 28.05gb,這兩項沿用測試報告的二進位容量口徑。
這些是歷史測試結果。後續狀態檢查中,120B/284B 健康檢查正常,但該次未取得 27B 的健康回應,因此不將歷史五路同時運作結果當成每個時間點的即時狀態。
九、三種模型如何解碼
解碼是模型讀取輸入後,逐步生成回答的過程。權重量化與快取格式影響儲存及運算方式,解碼策略則決定如何產生下一段回答。
| 模型 | 解碼策略 | 執行位置 |
|---|---|---|
| 27B | MTP(多詞元預測)推測解碼,每輪草稿 3 個詞元 | 5090 |
| 120B | 一般自回歸解碼,目前未配置草稿模型或推測解碼 | 處理器+系統記憶體,16 執行緒 |
| 284B | 一般自回歸解碼,目前未配置草稿模型或推測解碼 | 處理器+系統記憶體,24 執行緒 |
27B 會先提出一小段候選詞元,再由主模型驗證。接受率高時,一輪運算可以推進多個詞元;草稿長度設為 3,不代表每輪一定接受 3 個,也不代表固定加速三倍。
三路 27B 由引擎調度,共用權重與快取池,因此每路速度會隨其他請求的輸入長度與負載改變。
120B/284B 則根據已知內容逐步預測下一個詞元,再接回上下文繼續生成。測試配置中,120B 使用 16 個實體核心,284B 使用另外 24 個實體核心,核心不重疊,但仍共用系統記憶體頻寬。
十、兩個雲端模型如何配合
本地模型之外,我也使用:
- Codex(程式開發與工作代理工具)搭配 Astra(雲端模型)。
- DSH(人工智慧工作介面)搭配 DeepSeek V4(深度求索第四代雲端模型)。
預定分工是讓本地模型承接日常資料與批次工作;需要更複雜的分析、程式整合或交叉檢查時,搭配雲端模型協助。
雲端推理本身不占用本機顯存。實際速度受到模型版本、服務負載、網路與請求內容影響,目前未做相同條件的雲端測速,因此不與本地數據直接比較。
十一、主要用途:期貨報表分析
目前最主要的工作是整理期貨交易明細、帳戶紀錄及相關行情資料,協助比較不同期間的結果,並產出分析報表。
工作流程是:
資料匯入與清理 → 程式計算與統計 → 模型解讀 → 報表與筆記整理。
數值統計以程式計算結果為依據,模型協助解釋、歸納與撰寫。希望逐步把重複的資料處理步驟固定下來,建立可持續使用的分析流程。
十二、教學影片轉逐字稿與重點筆記
另一個主要用途是處理 YouTube(影音平台)教學影片:
下載影片 → 抽取音訊 → 語音轉文字 → 校對與分段 → 整理重點 → 產出學習筆記。
整理內容包括:
- 依主題與時間段拆分教學內容。
- 歸納期貨、股票與技術分析觀念。
- 整理操作條件、案例、例外情況與講師提醒。
- 將多部影片整合成主題筆記。
- 保留來源與時間位置,方便回看。
語音轉文字由對應的語音辨識工具處理,本地文字模型再接續整理逐字稿與筆記;有需要時,使用雲端模型協助校對與交叉檢查。
十三、未來目標:選股器與自動交易機器人
未來希望利用這套環境,逐步開發符合自己需求的選股器與自動交易機器人。
選股器預計從資料取得、條件篩選與結果報表開始,把研究整理出的條件寫成程式,再利用歷史資料檢查結果,建立自己的觀察清單。
自動交易機器人則希望逐步串接:
行情資料 → 策略訊號 → 風險限制 → 模擬交易 → 下單介面 → 交易紀錄與績效檢討。
本地與雲端模型協助撰寫程式、解釋策略、檢查邏輯及分析執行紀錄。數值計算、策略條件與下單規則則落實為可測試、可追蹤的程式。
這兩項目前屬於未來開發目標,尚未描述為已完成或已實盤運作。
十四、未來擴充:兩張魔改 48gb 4090
預計加入兩張 RTX 4090(輝達顯示卡),每張魔改為 48gb 顯存。
| 顯示卡 | 顯存 | 預定用途 |
|---|---|---|
| 現有 5090 | 32gb | 27B 三路服務 |
| 第一張魔改 4090 | 48gb | 大型模型運算 |
| 第二張魔改 4090 | 48gb | 與另一張共同承接大型模型 |
| 三張合計 | 128gb | 由推理引擎分配使用 |
預計讓 5090 繼續承接 27B,兩張 4090 作為 120B/284B 的加速資源。
120B 的權重容量低於兩卡合計顯存,有機會將較完整的模型放上顯示卡;實際上下文容量還需計入快取與運算緩衝區。
284B 的現有模型容量超過三卡顯存總量,維持目前版本時,仍需要 256gb 系統記憶體協助。八通道記憶體在升級後依然是大型模型混合運算的重要資源。
兩張 4090 尚未安裝,因此目前沒有升級後的速度數據。後續會實測模型卸載比例、長文件處理時間、生成速度,以及 120B/284B 切換或同時運作的配置,讓這台工作站持續支援期貨分析、教學筆記及交易程式開發。
本機最大好處!CPU跟RAM很難用到100% ^^" 目前平常運轉約200-450W 滿載測試約950-1100W


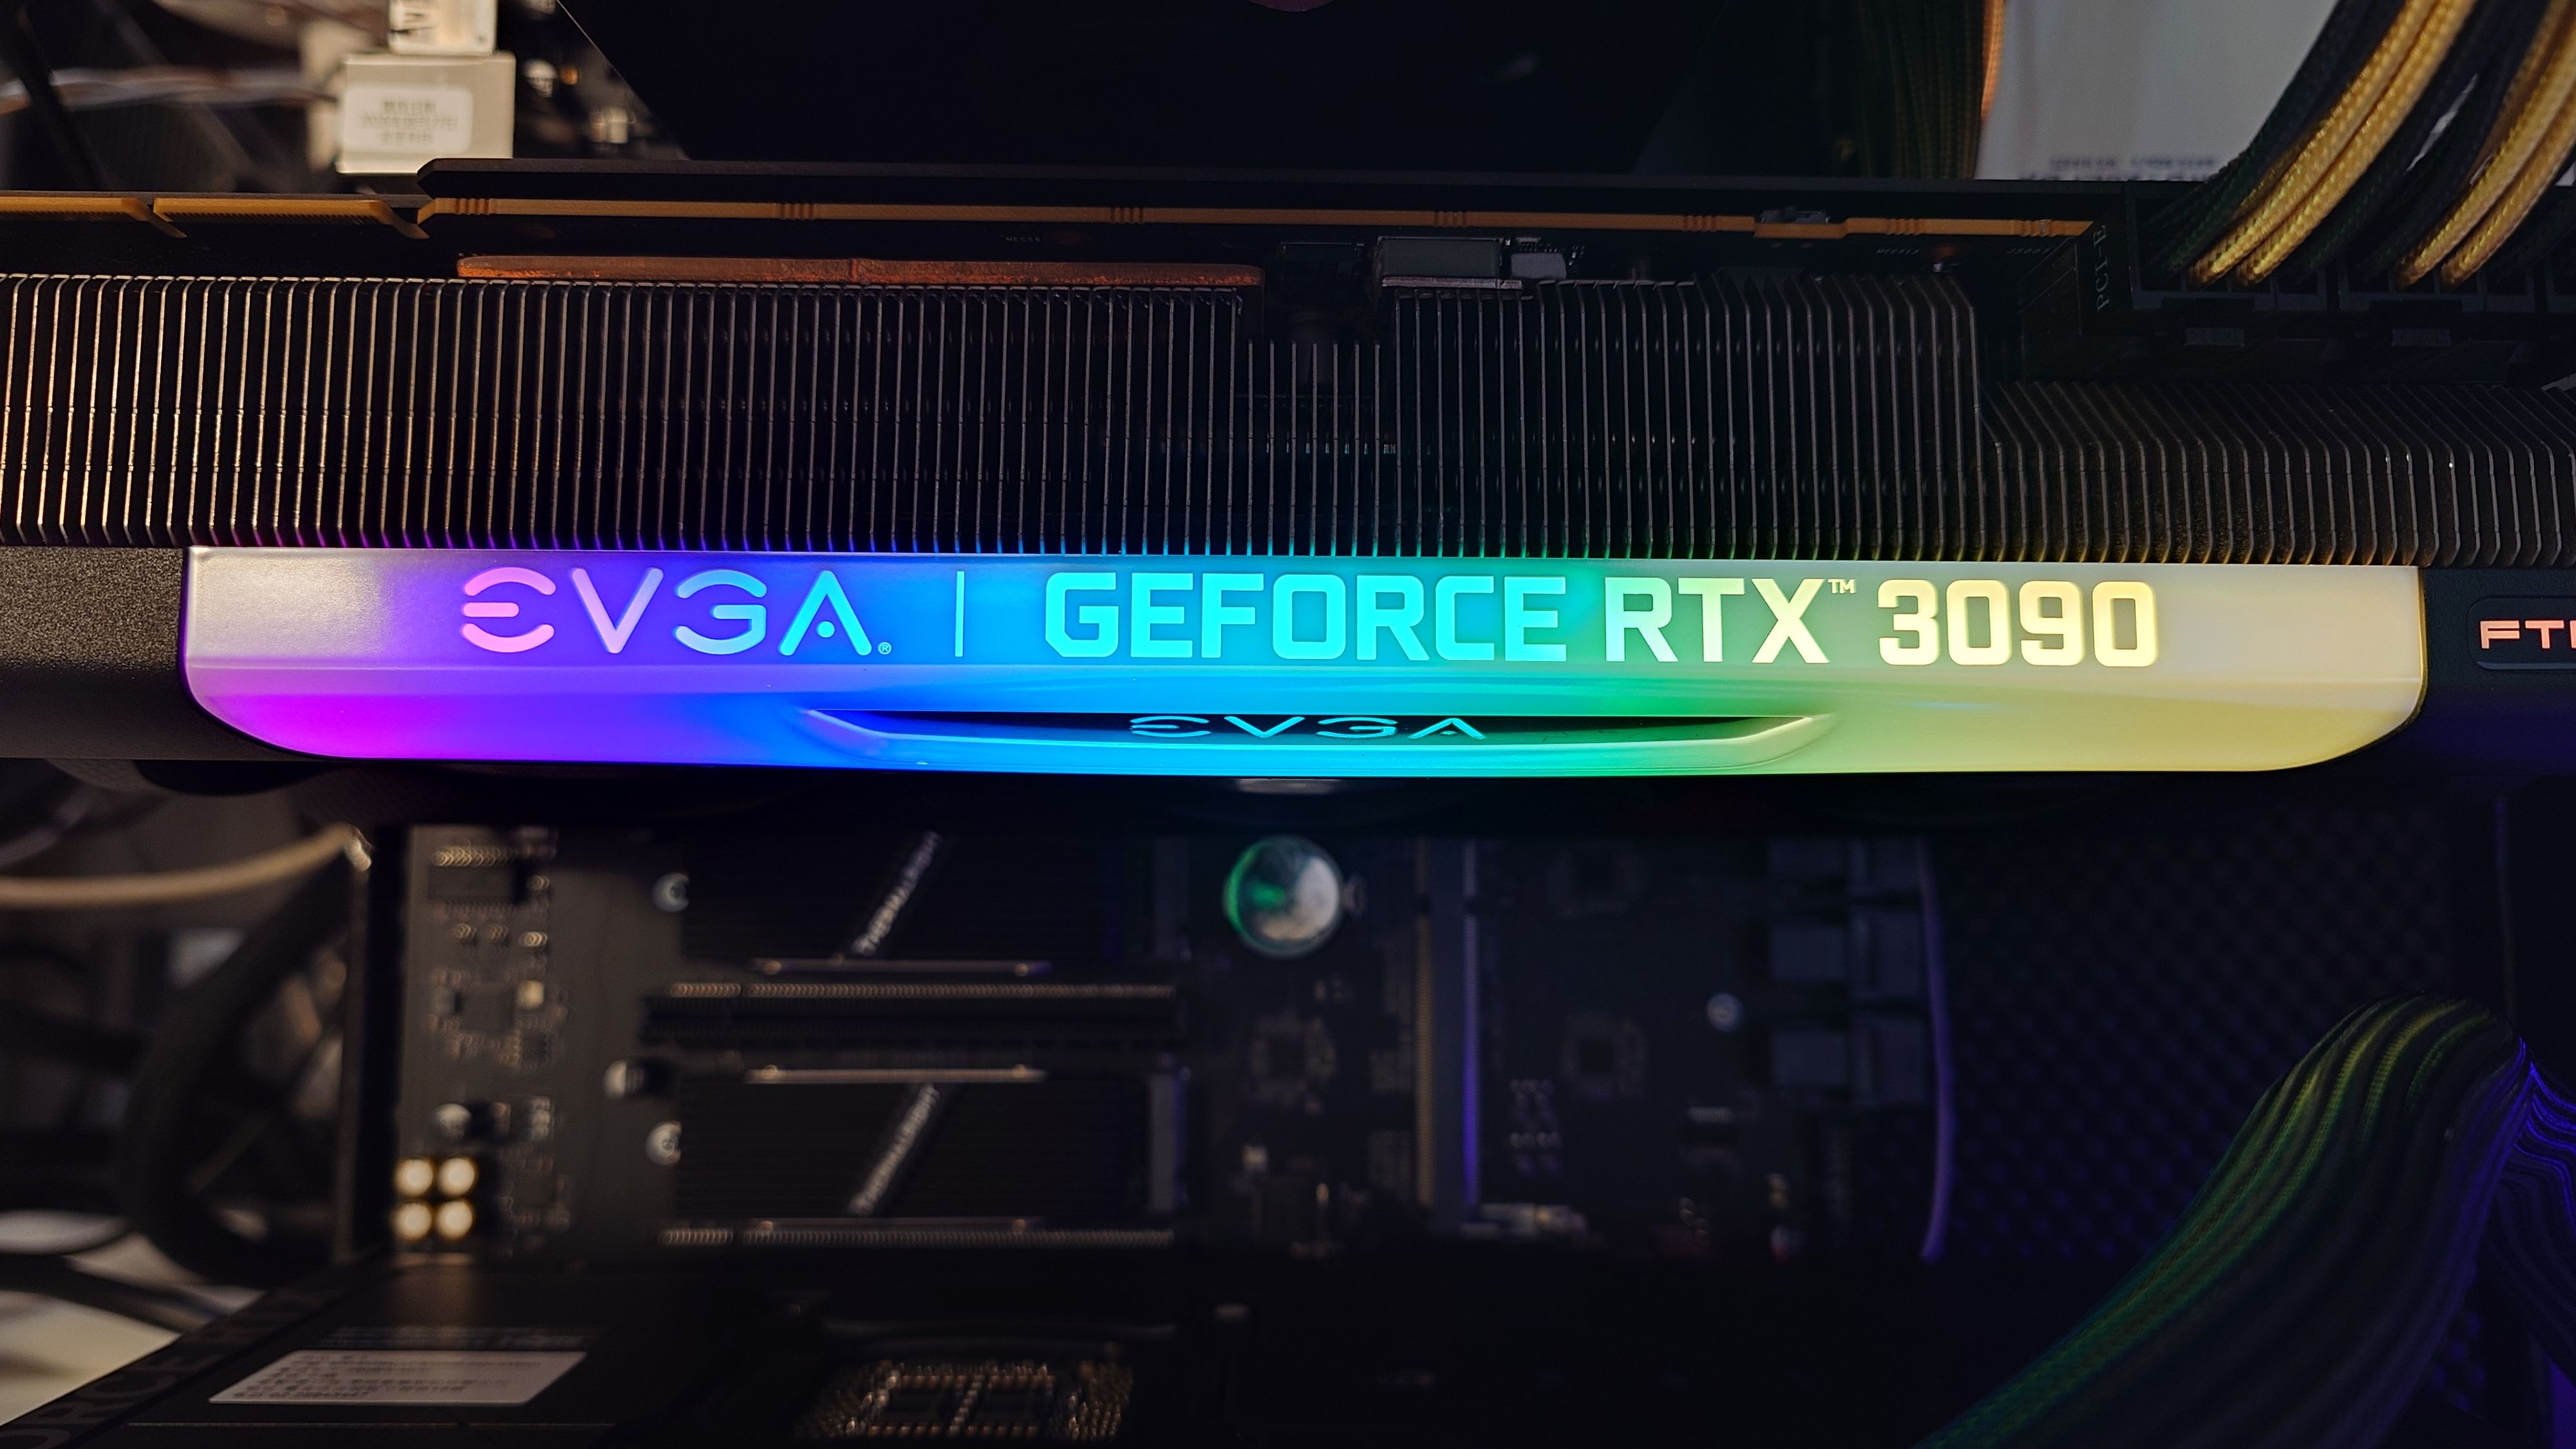
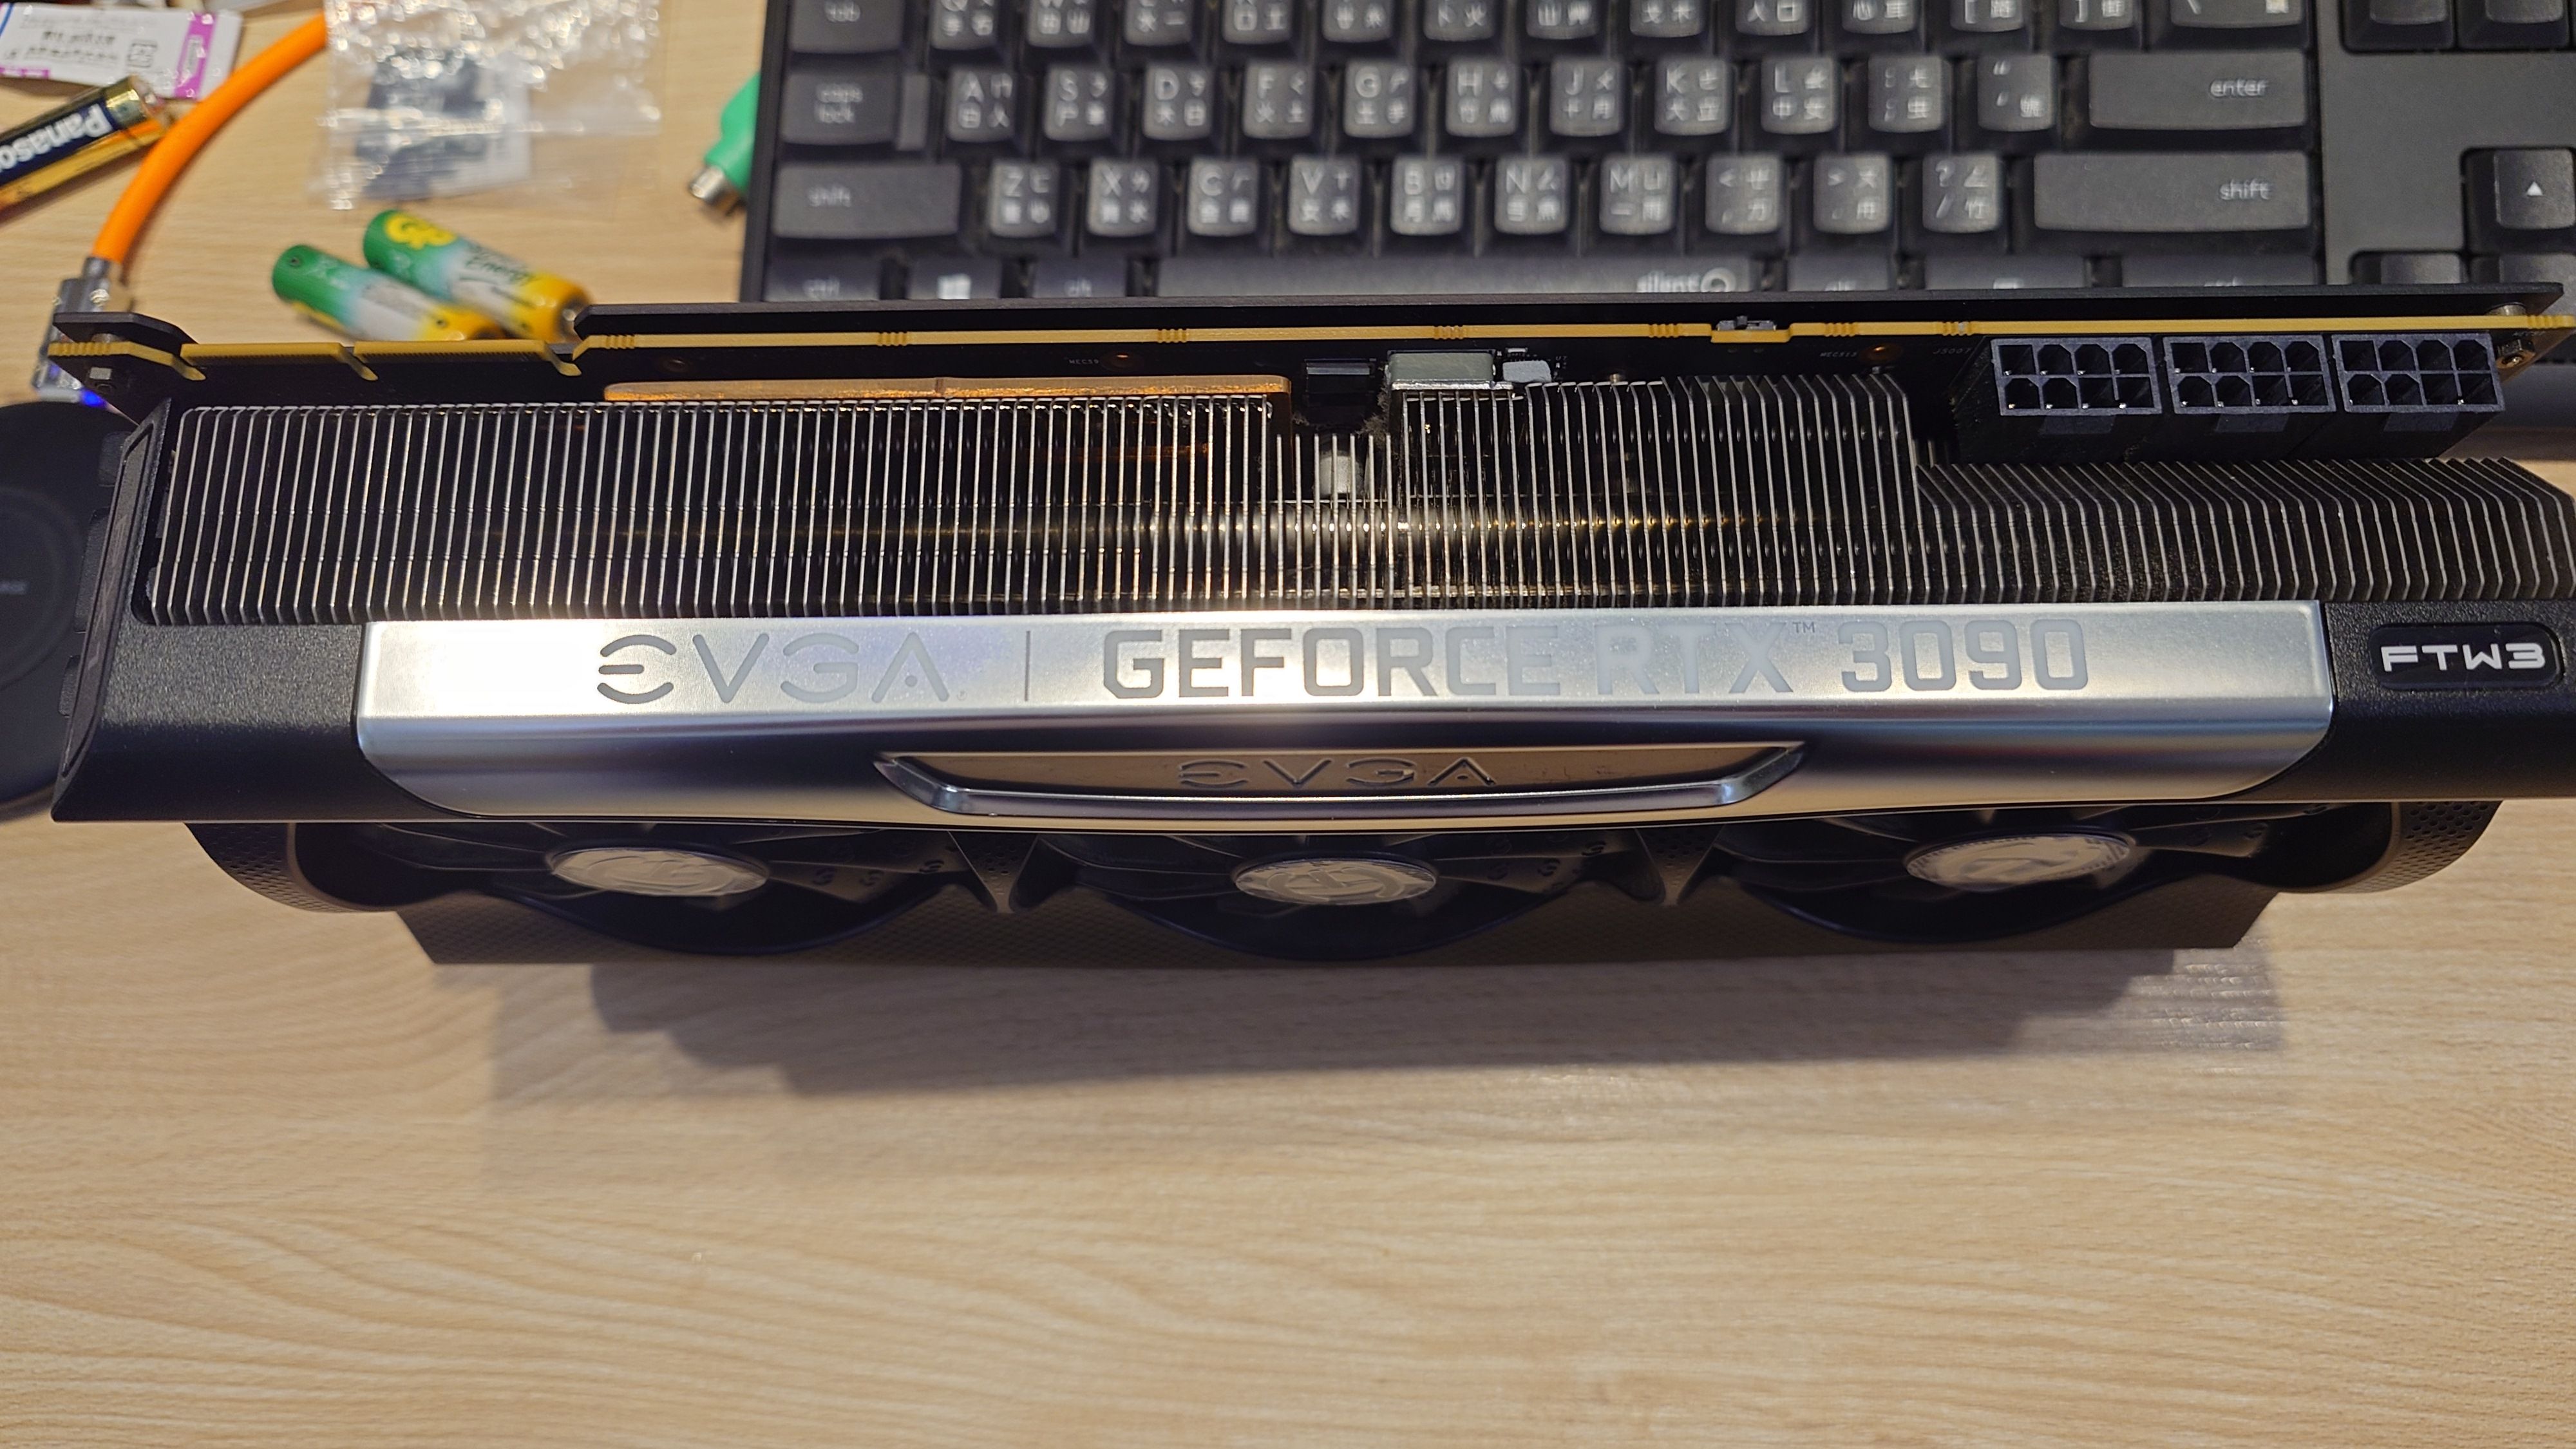
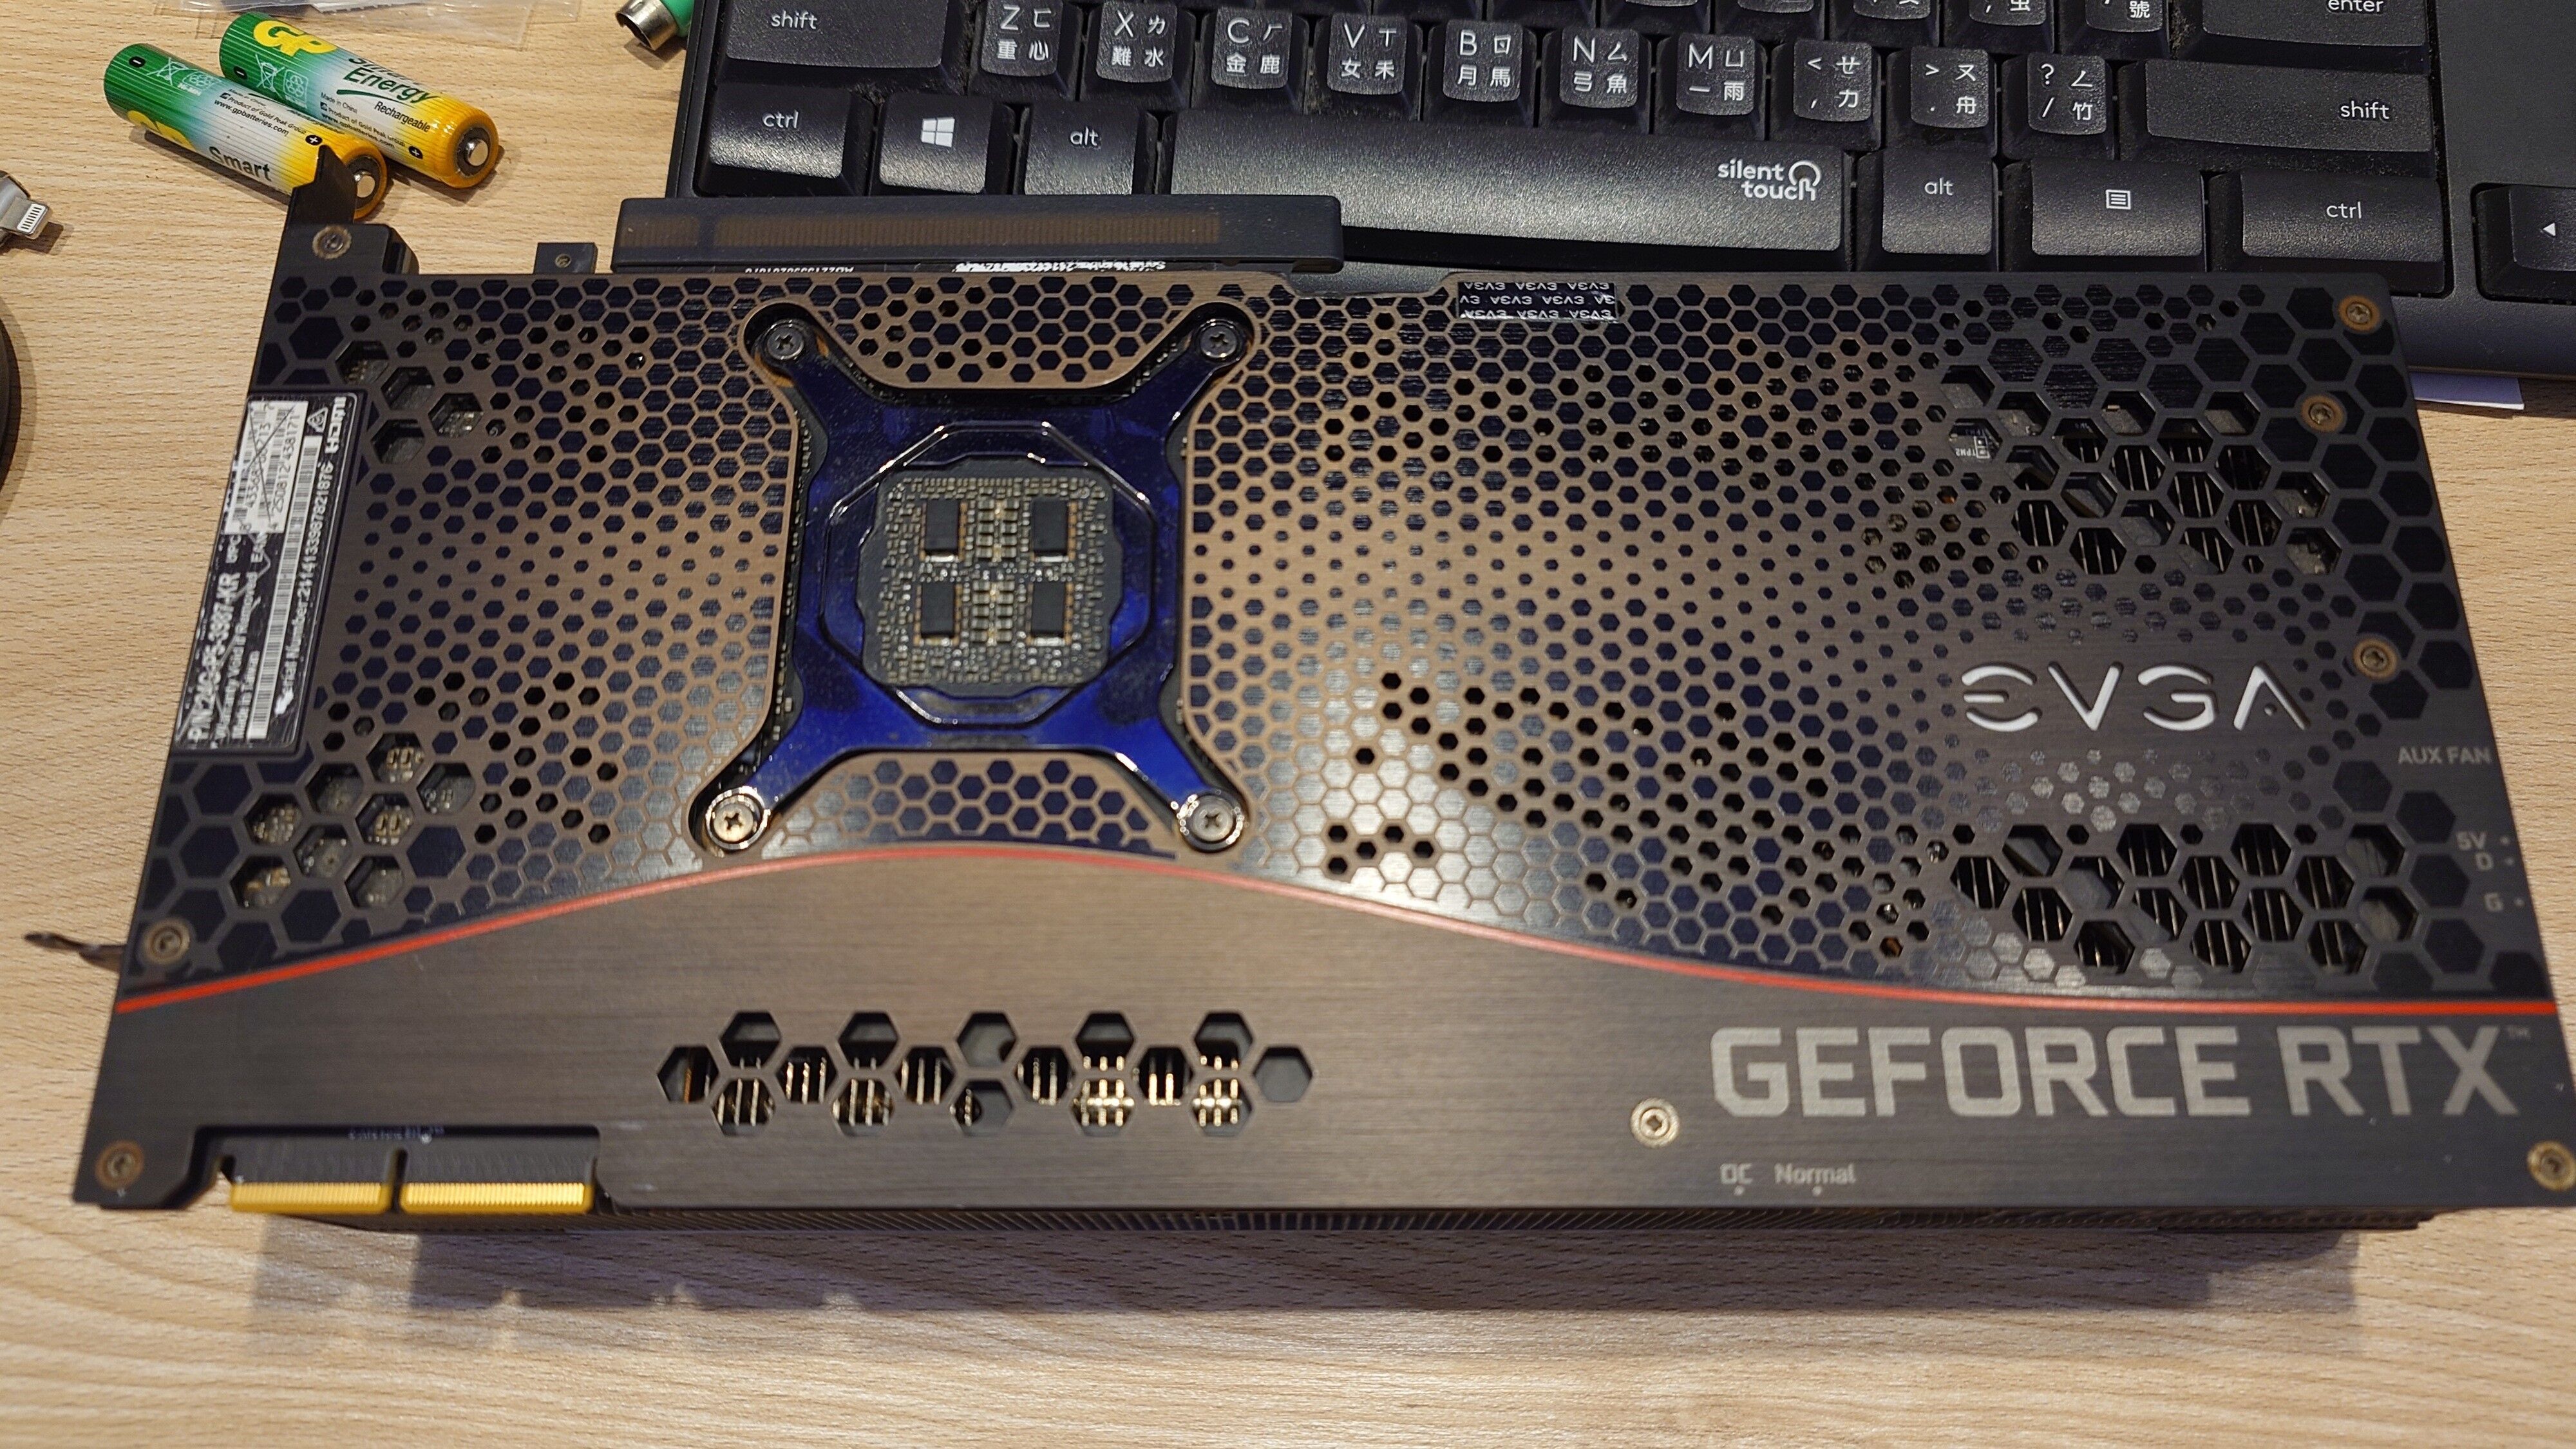
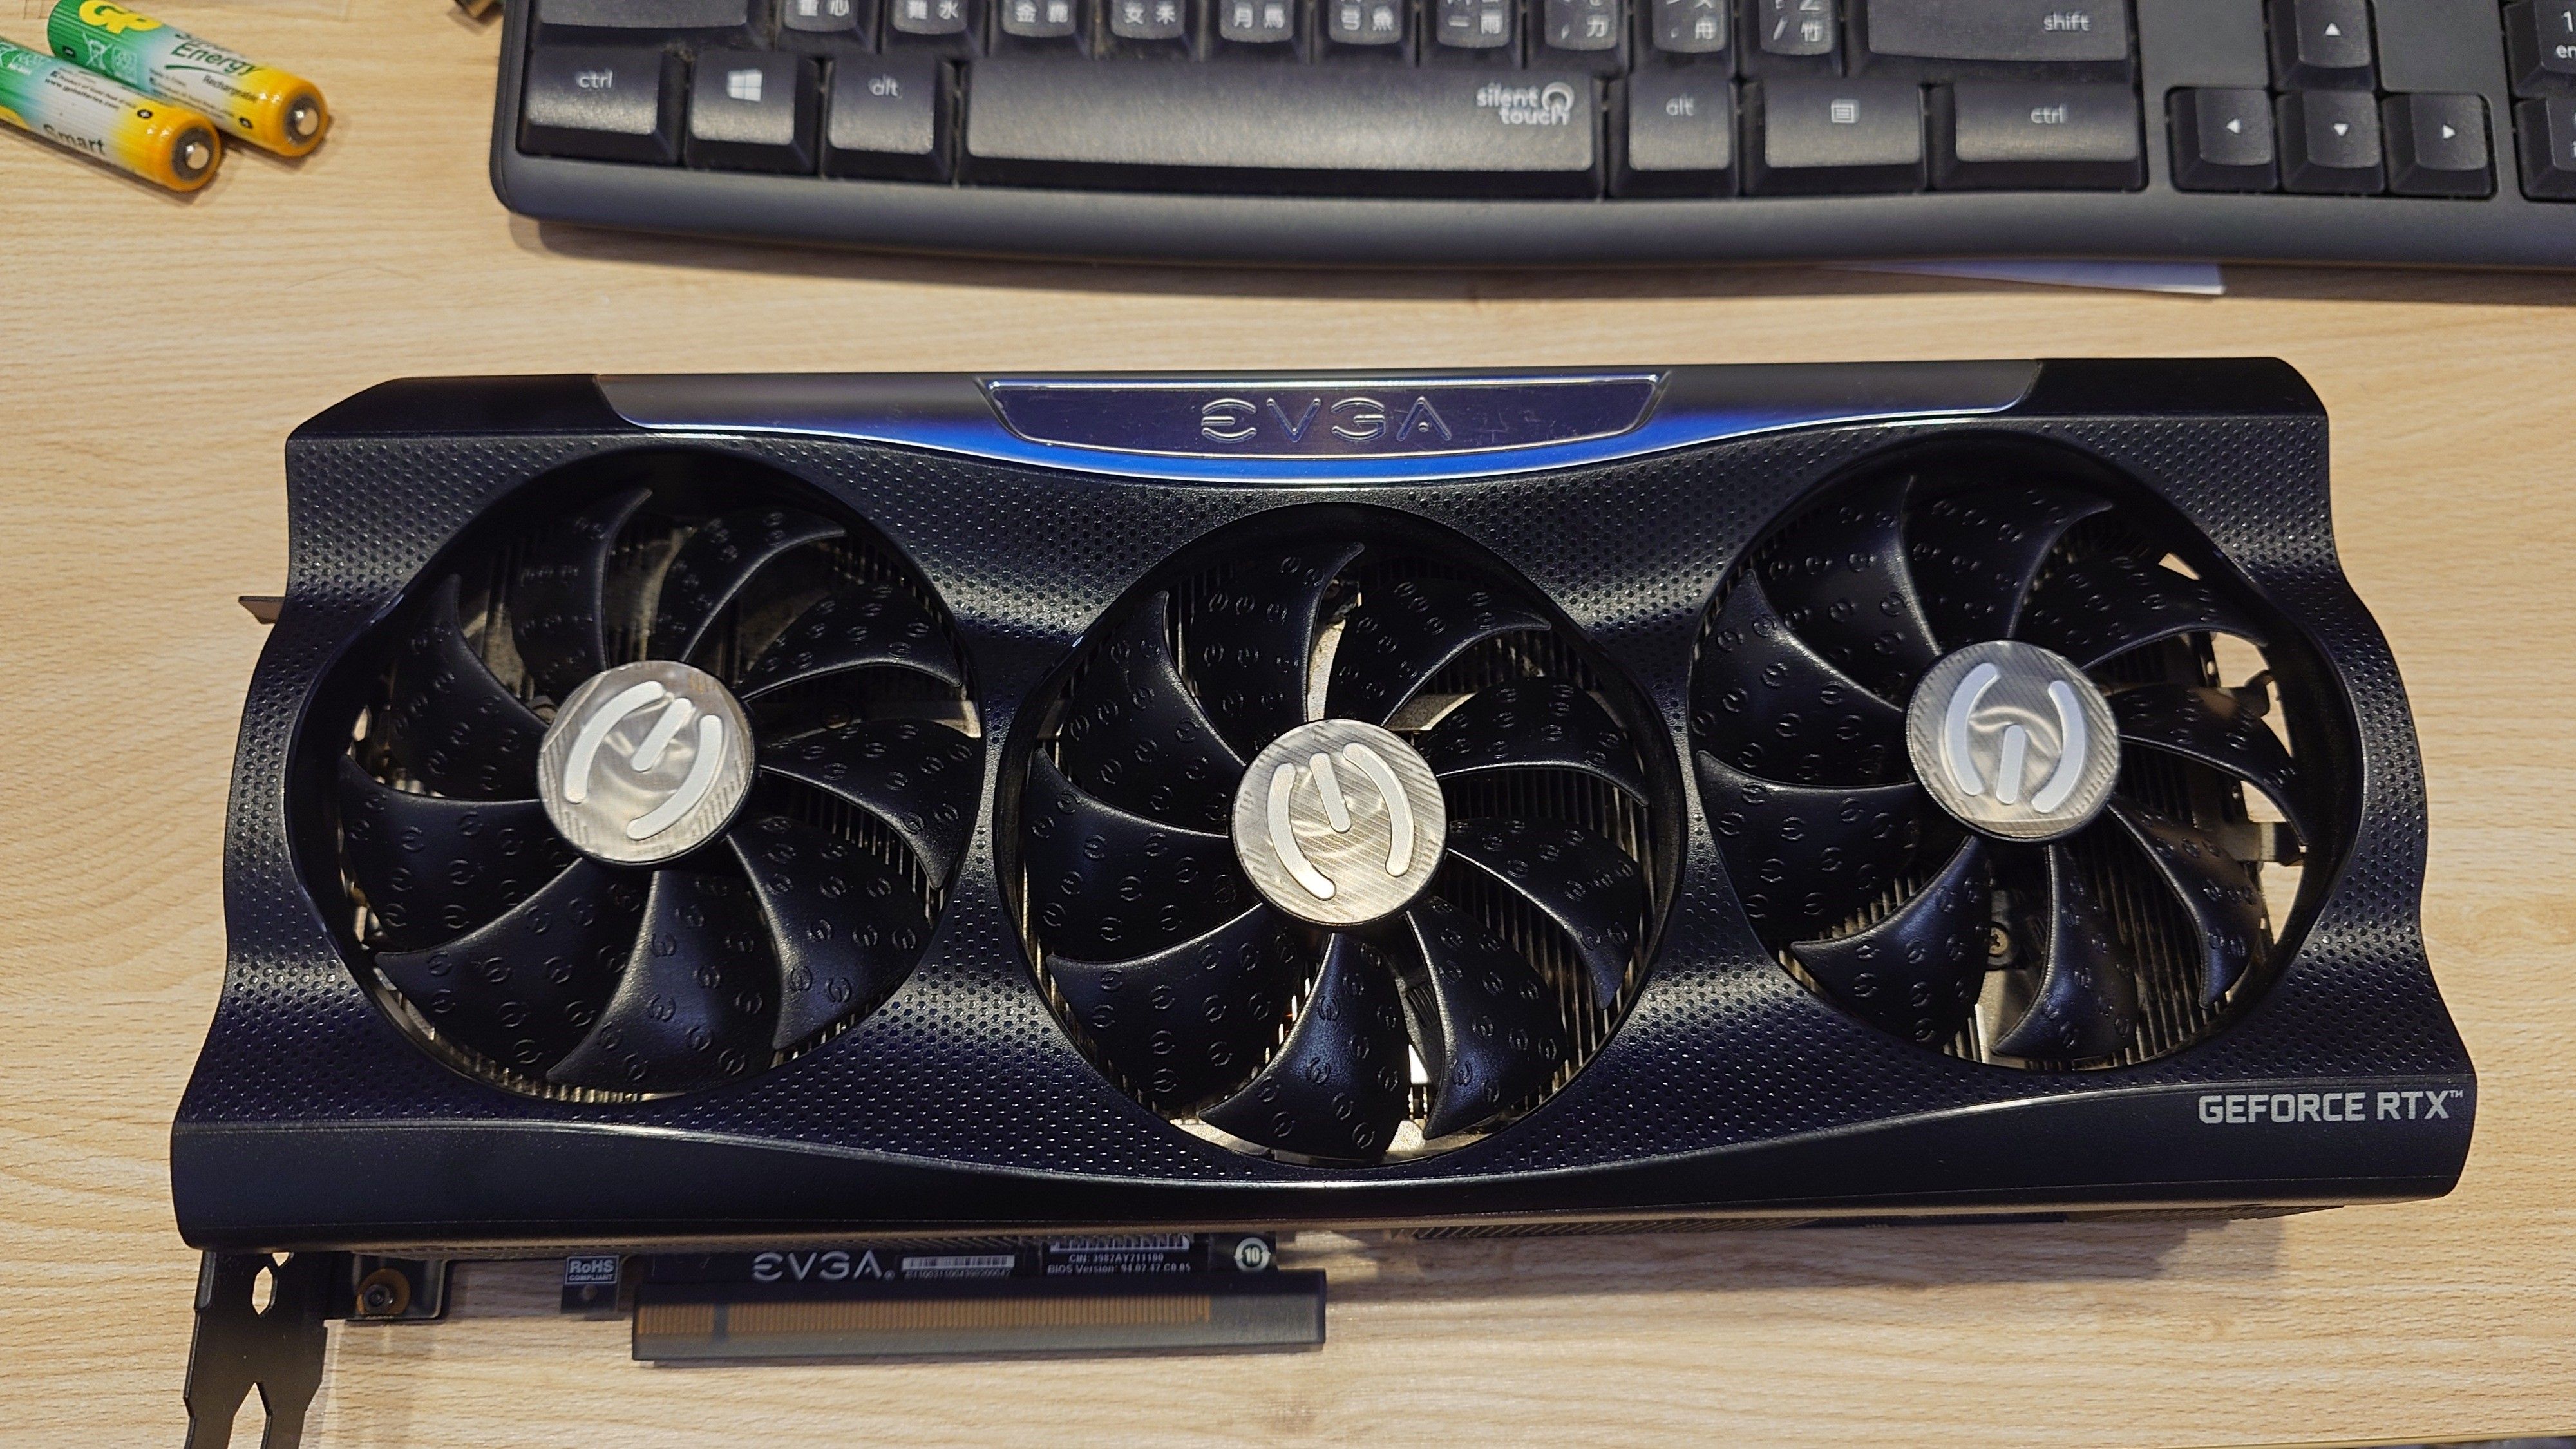
 回報(模型:deepseek-284b|台北時間:2026-09-15 14:10)
 找到並啟動本機視覺模型:Qwen3.8-27B-VL(llama-server,:11438,純 CPU+RAM,16.5GB)
 關鍵證據:我把先前「五檔報價」截圖送 VL,它回:「這是一張教學影片截圖,畫面中央是一位亞洲男性在說話(白 Polo 衫、戴眼鏡),背景是淺灰磚牆,下方疊加文字『判斷買賣意圖』」——我的截圖根本是講者口播畫面,不是五檔報價圖! 完全印證您說「截圖都不是重點」。