疑問:內存已經足夠了,為何不選擇iQ4 或是Q4呢?
实测区别并不大,IQ3_S的速度比4快20token,而且首字响应速度快10%;由于主要都是办公场景,不是code场景,足够了。看个人取舍吧。
疑問:內存已經足夠了,為何不選擇iQ4 或是Q4呢?
实测区别并不大,IQ3_S的速度比4快20token,而且首字响应速度快10%;由于主要都是办公场景,不是code场景,足够了。看个人取舍吧。
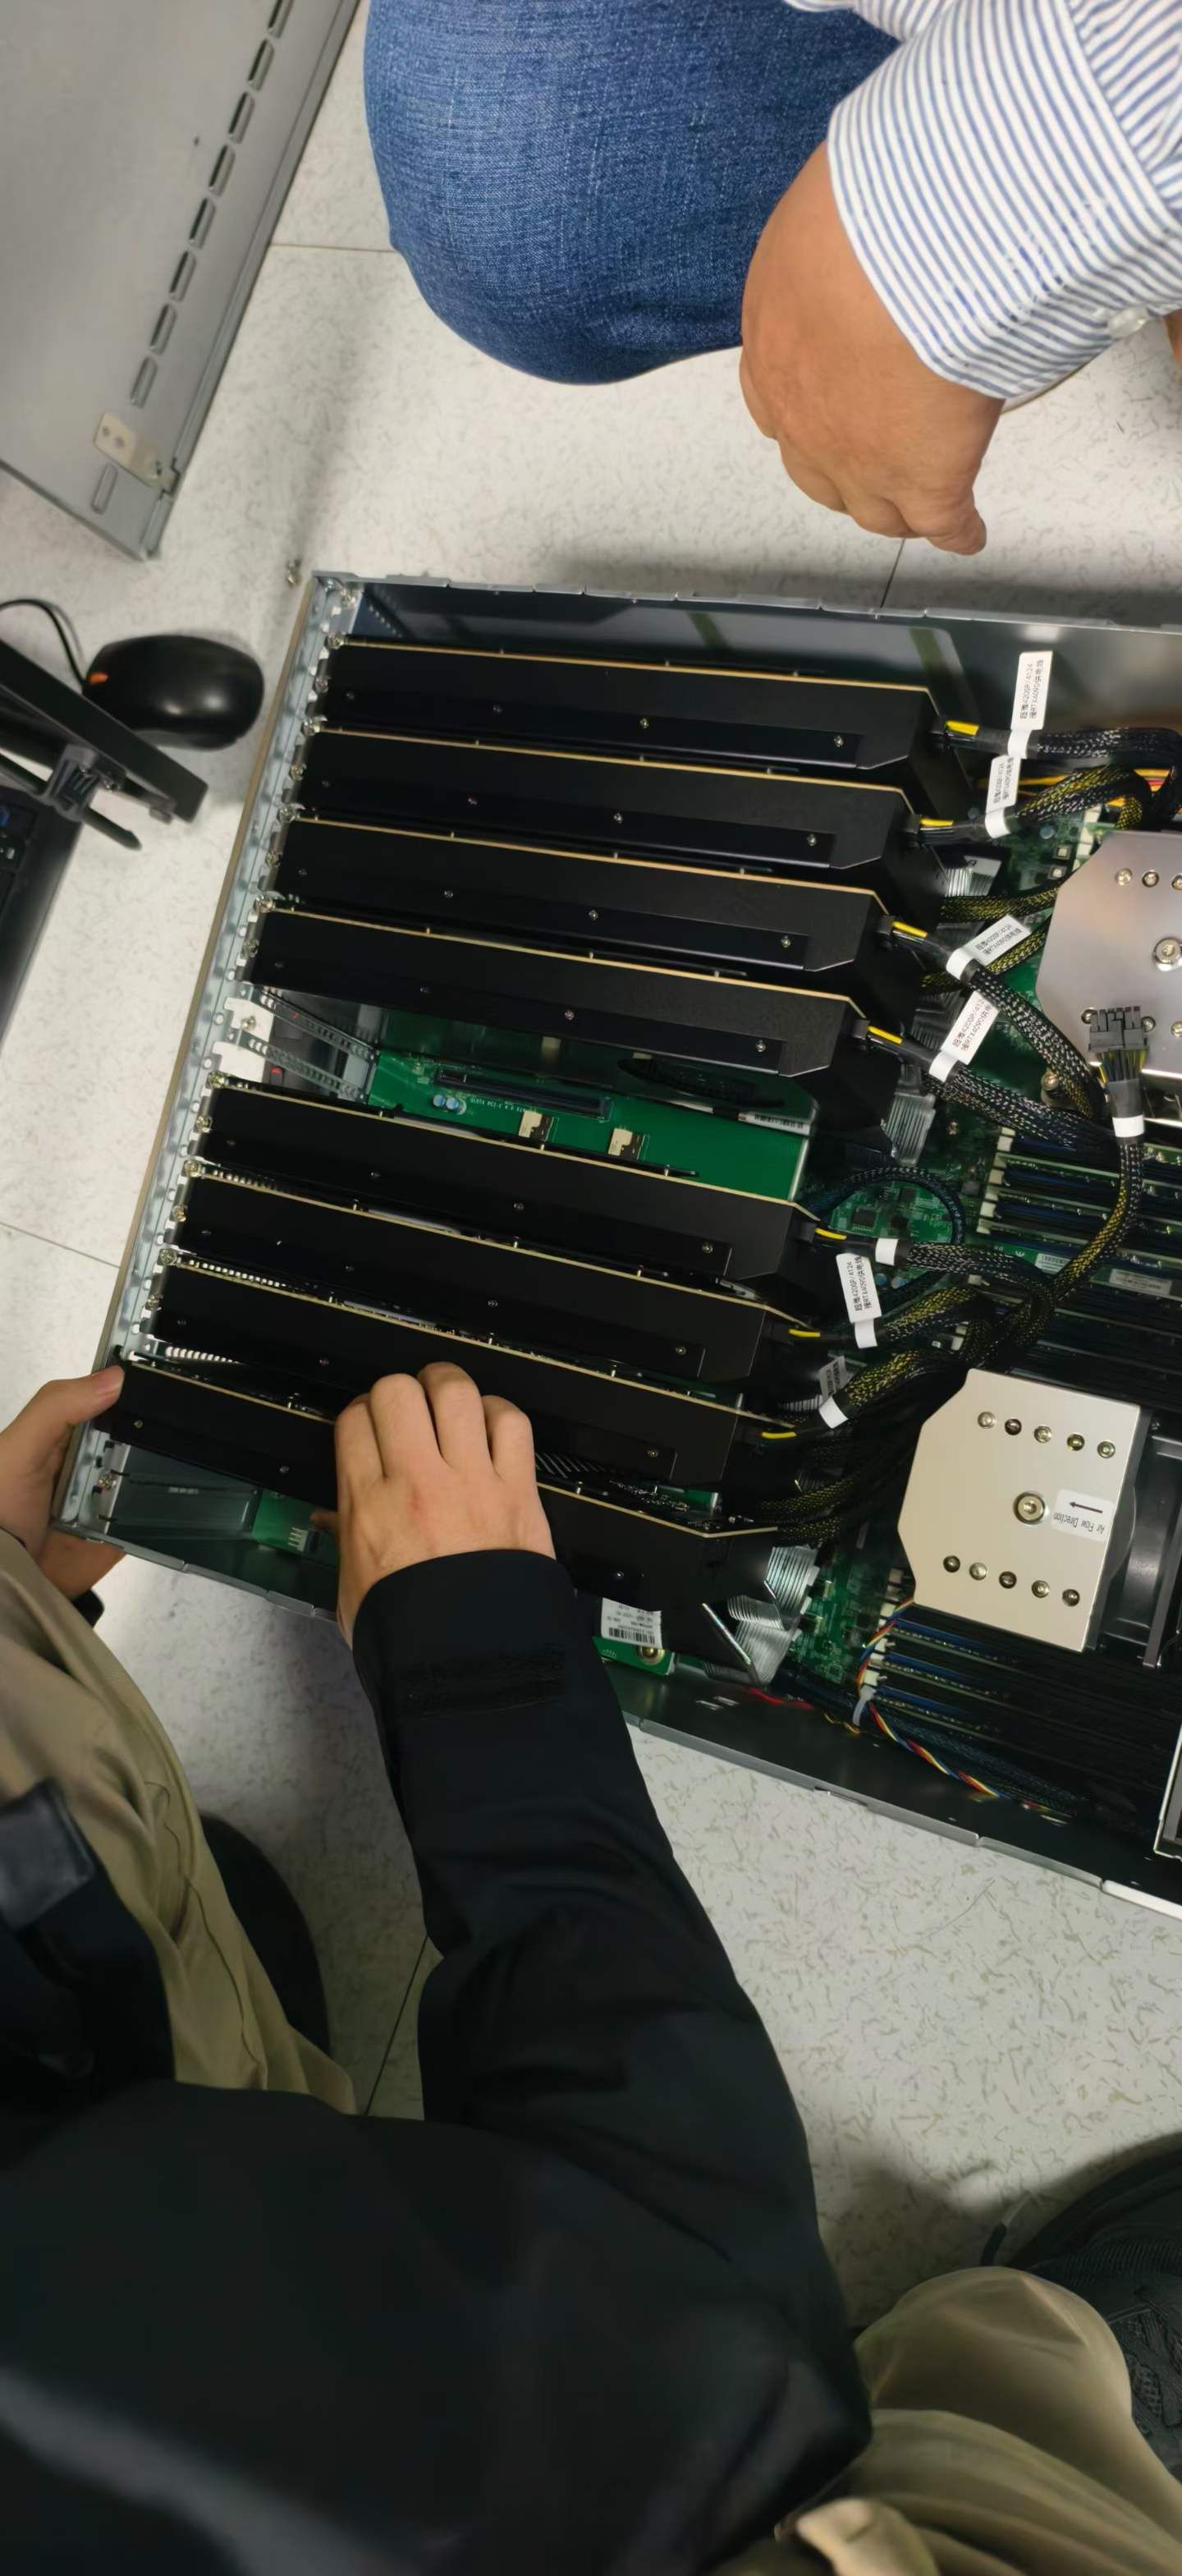
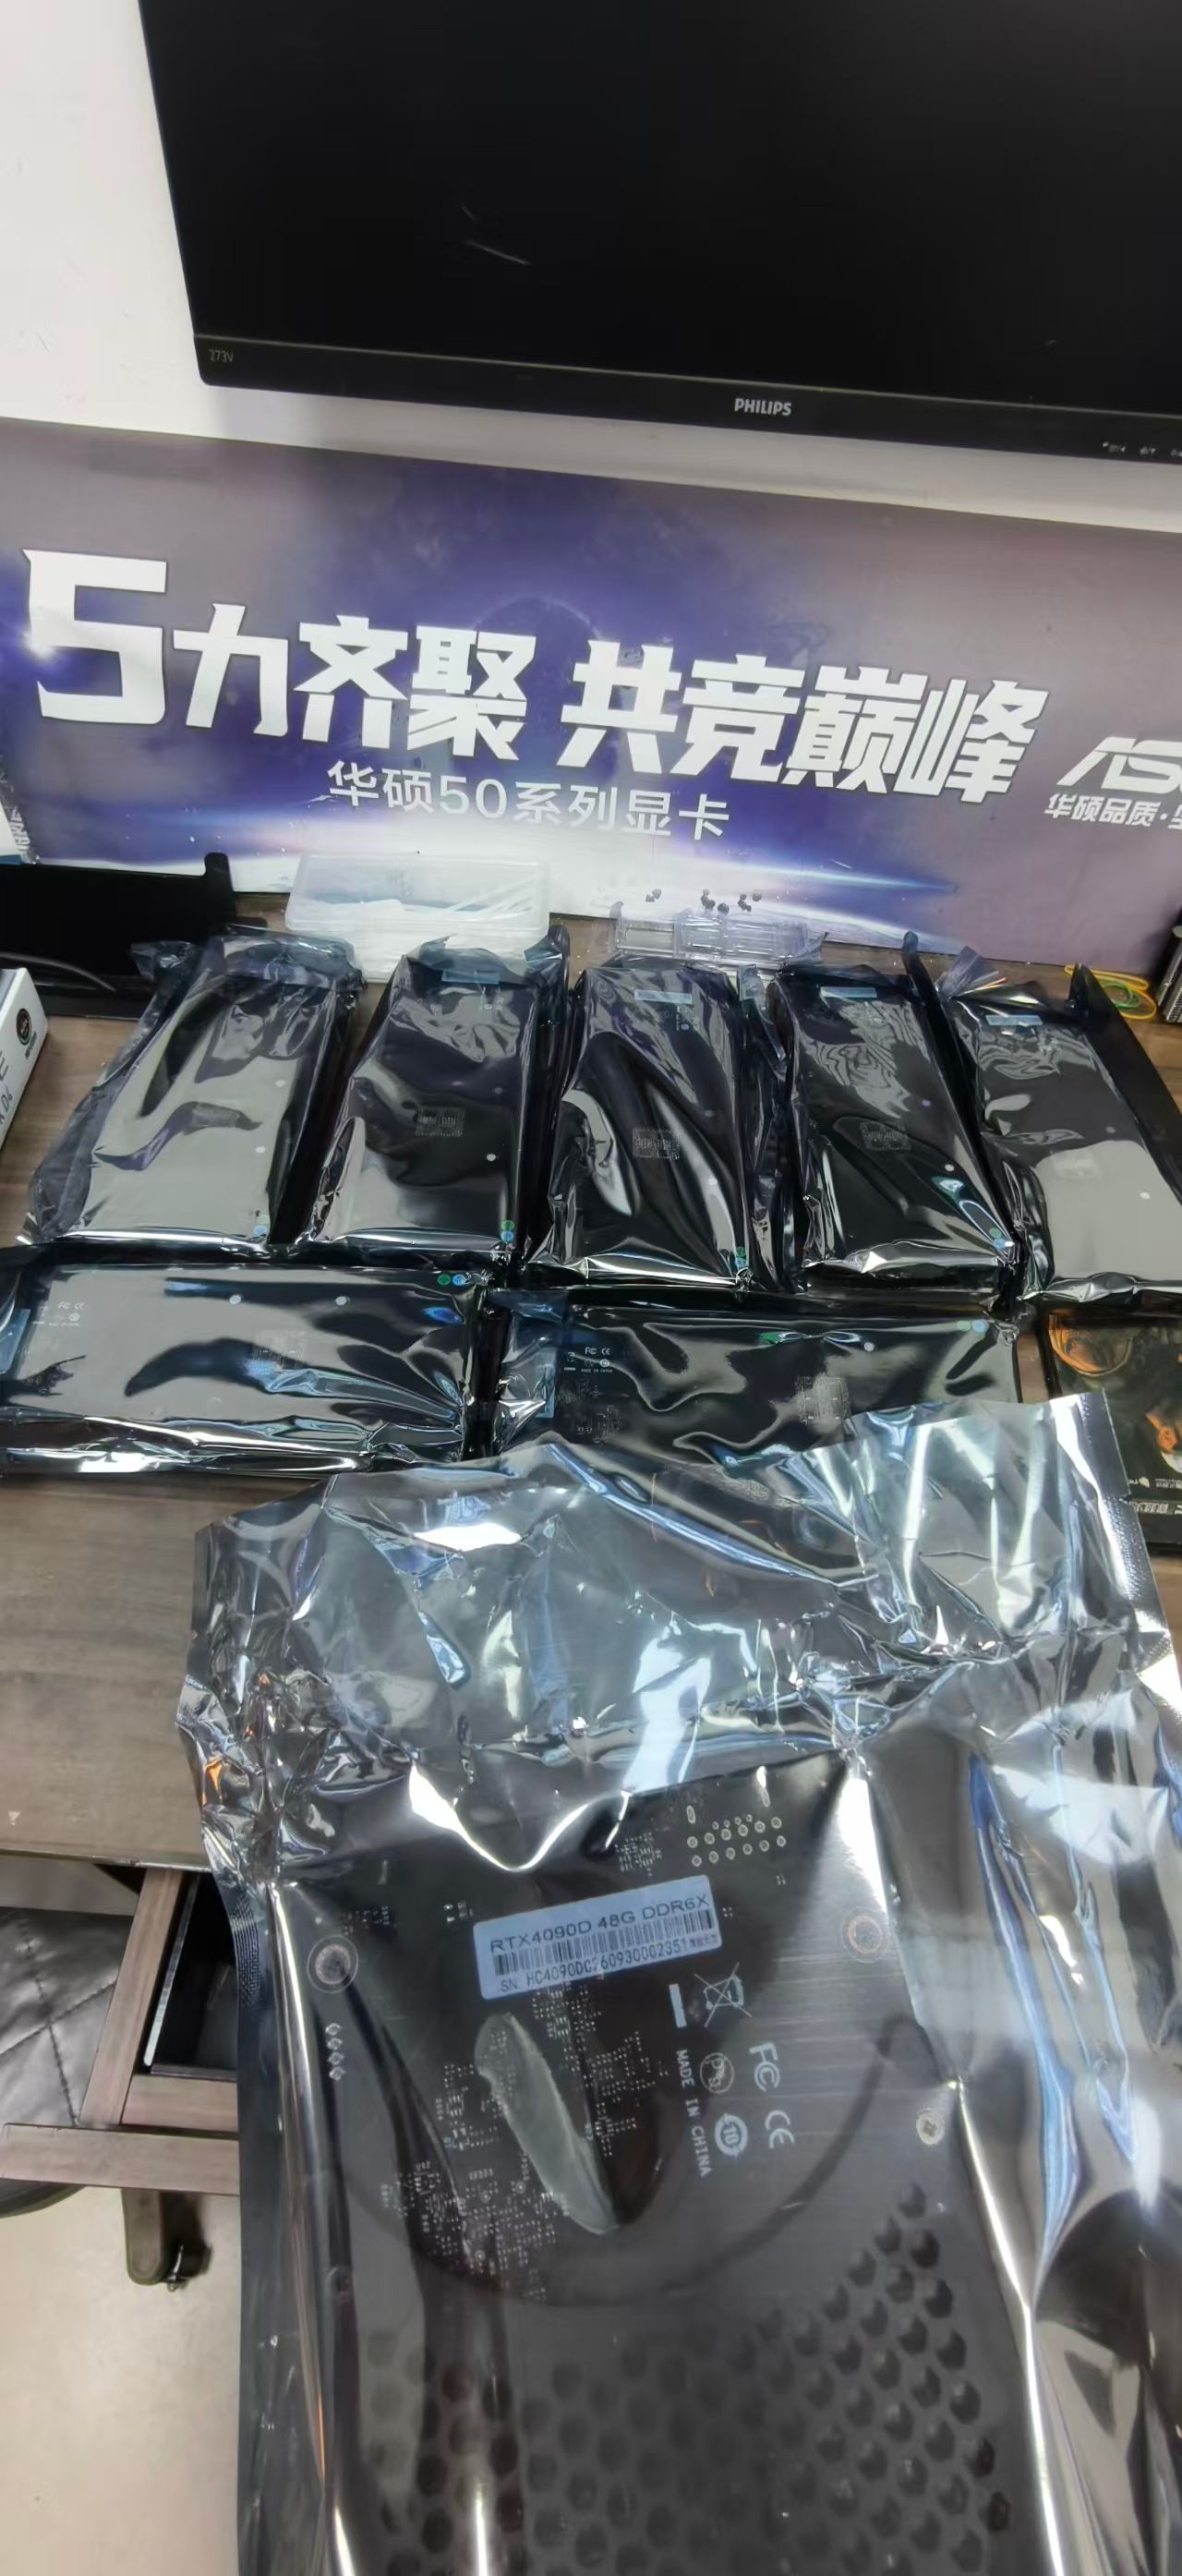
各位,我就是之前在论坛发帖的那个 8 卡 4090D 菜鸡新手。
之前老特还在视频里说过,我这部署能力堪忧。说实话,看完有点扎心,但回头看看自己当时的玩法,确实也不能全怪人家。
于是闭关反思了一段时间,边补课边折腾,推翻了几轮方案,也做了不少大胆测试。现在终于端出一套自己比较满意的成果,回来交个作业,顺便允许菜鸡小小地膨胀一下。
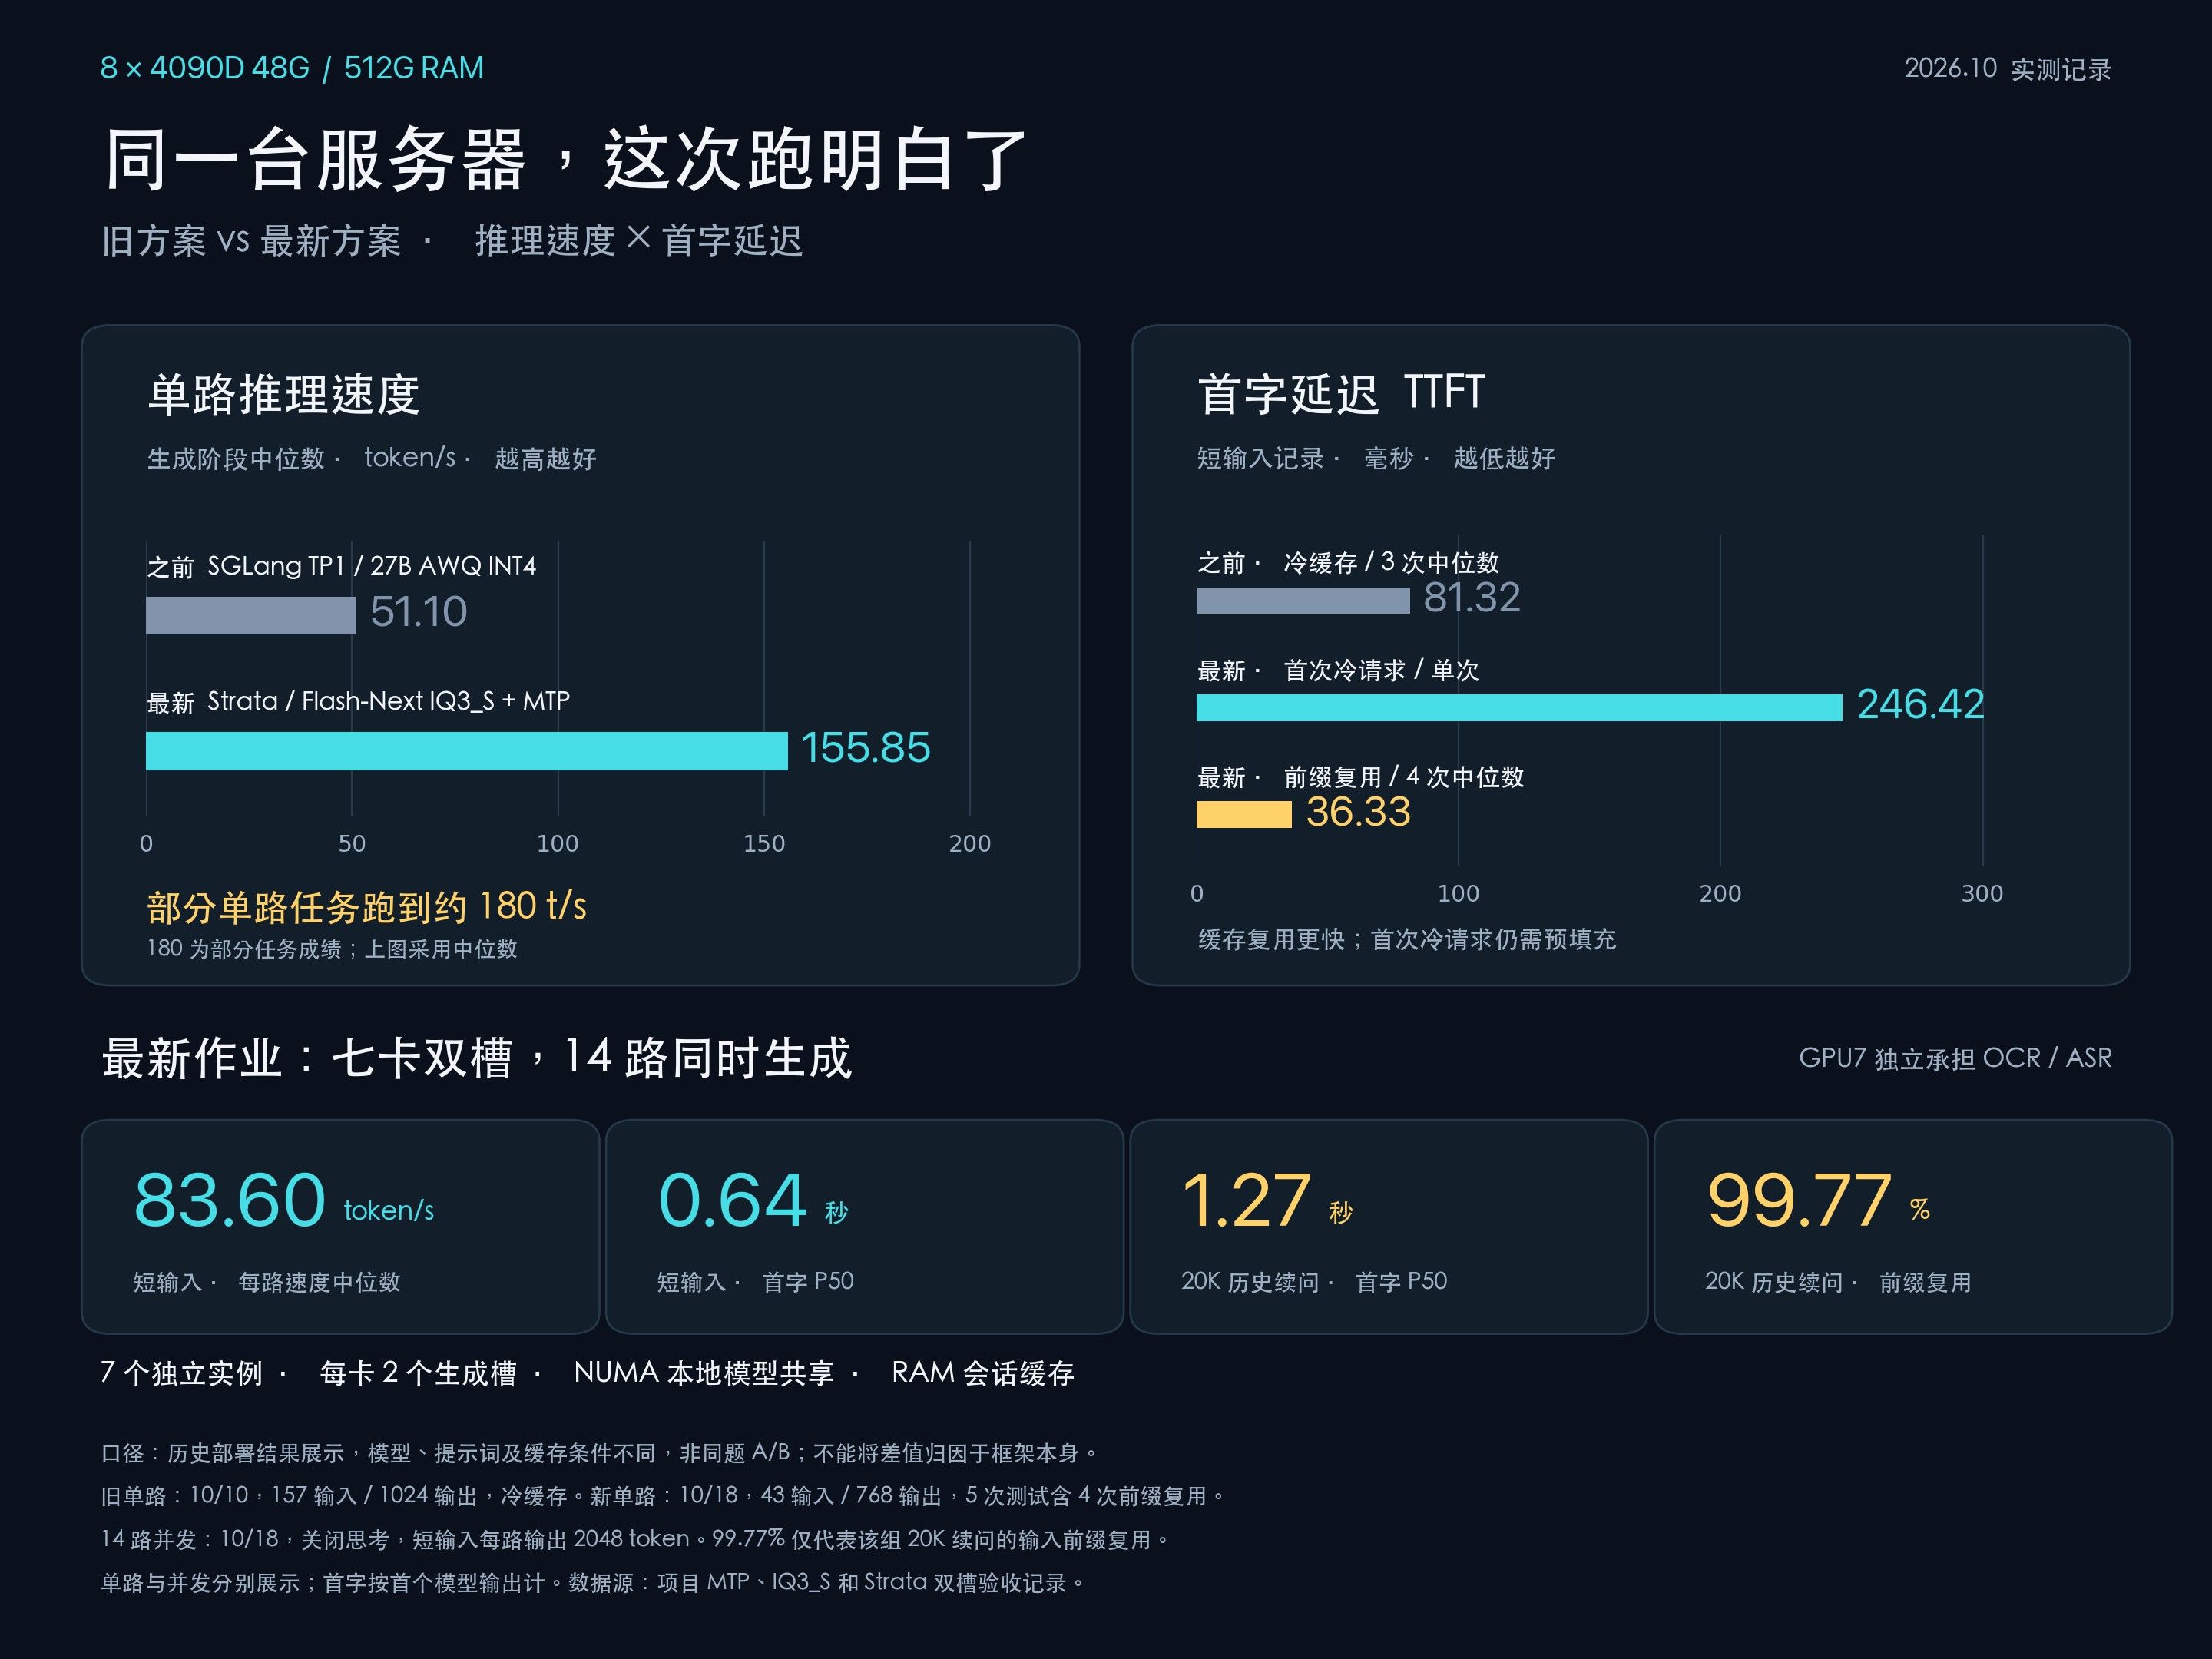
目前单卡单路实测跑到约 180 token/s,同卡双并发每路约 80 token/s,缓存复用和首字延迟也做出了效果。更关键的是,模型在我日常任务里的表现,比之前的 27B 更合我意。
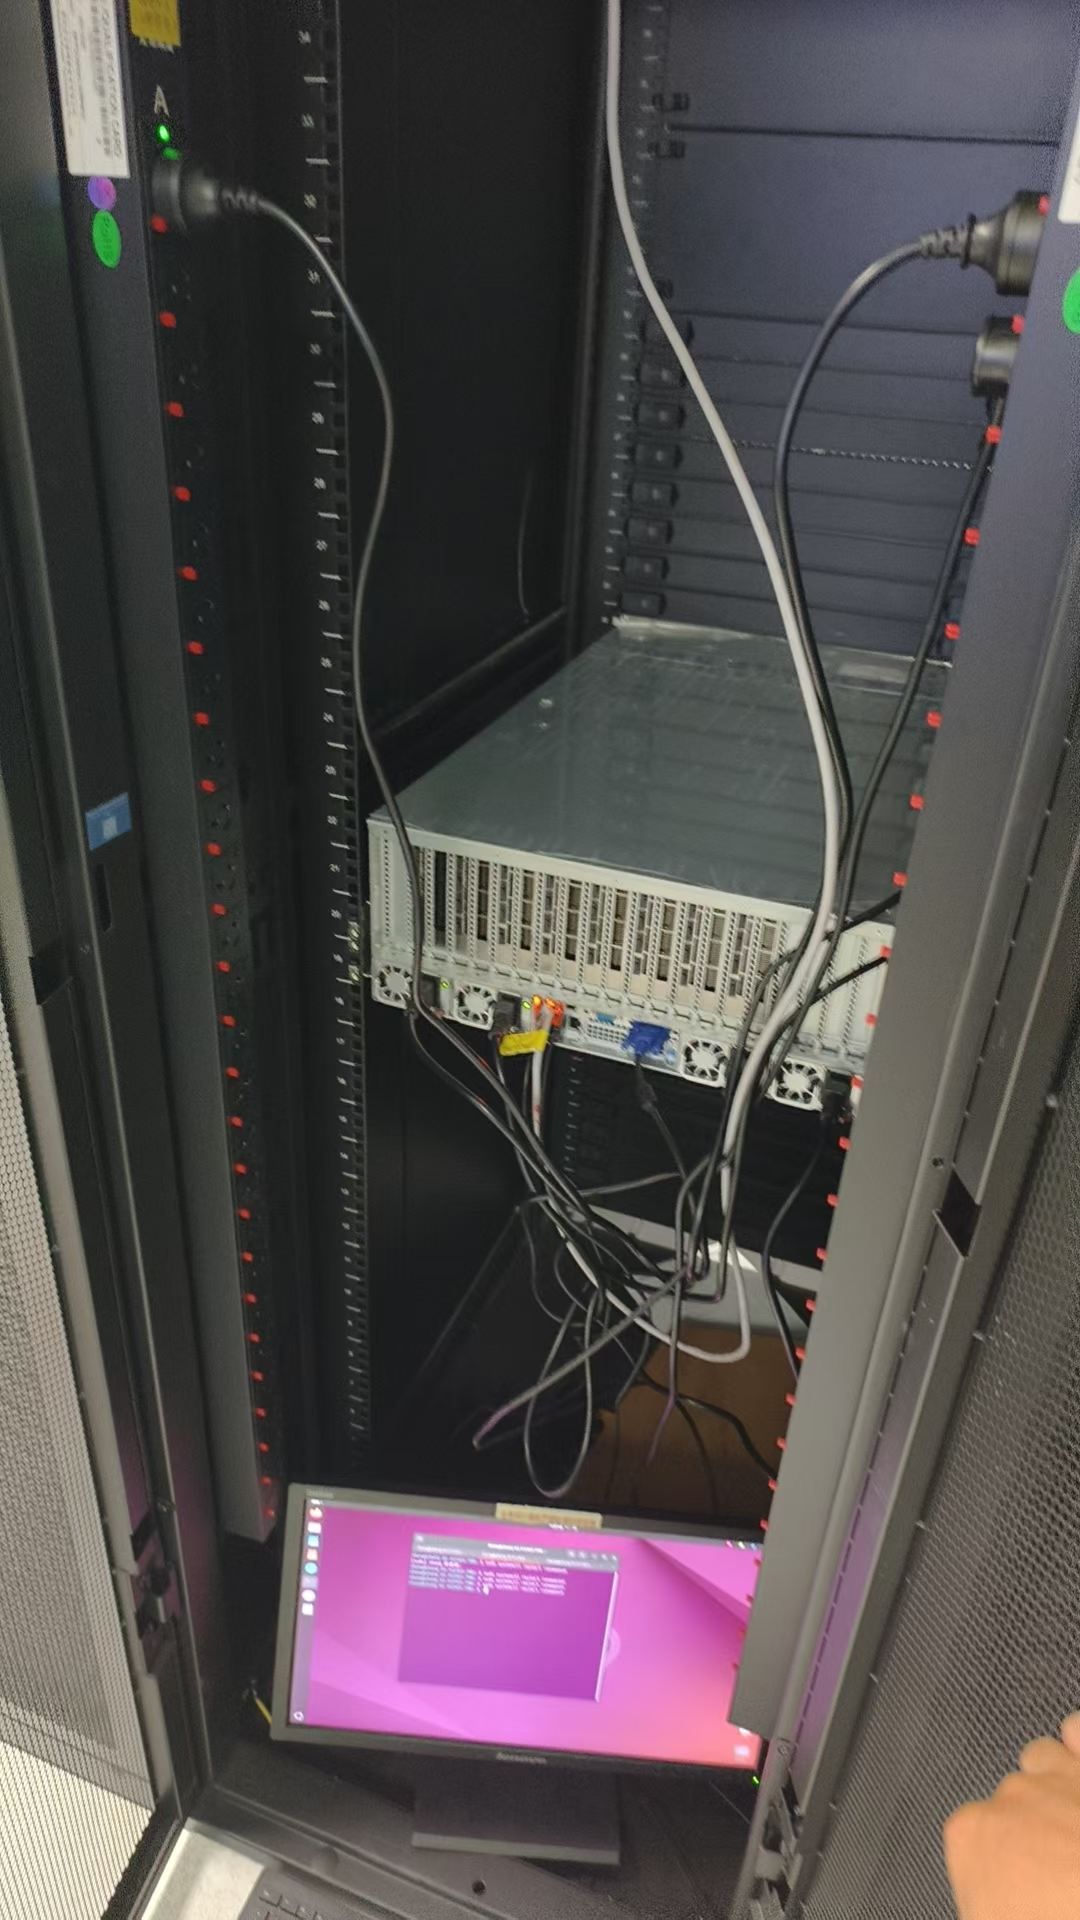
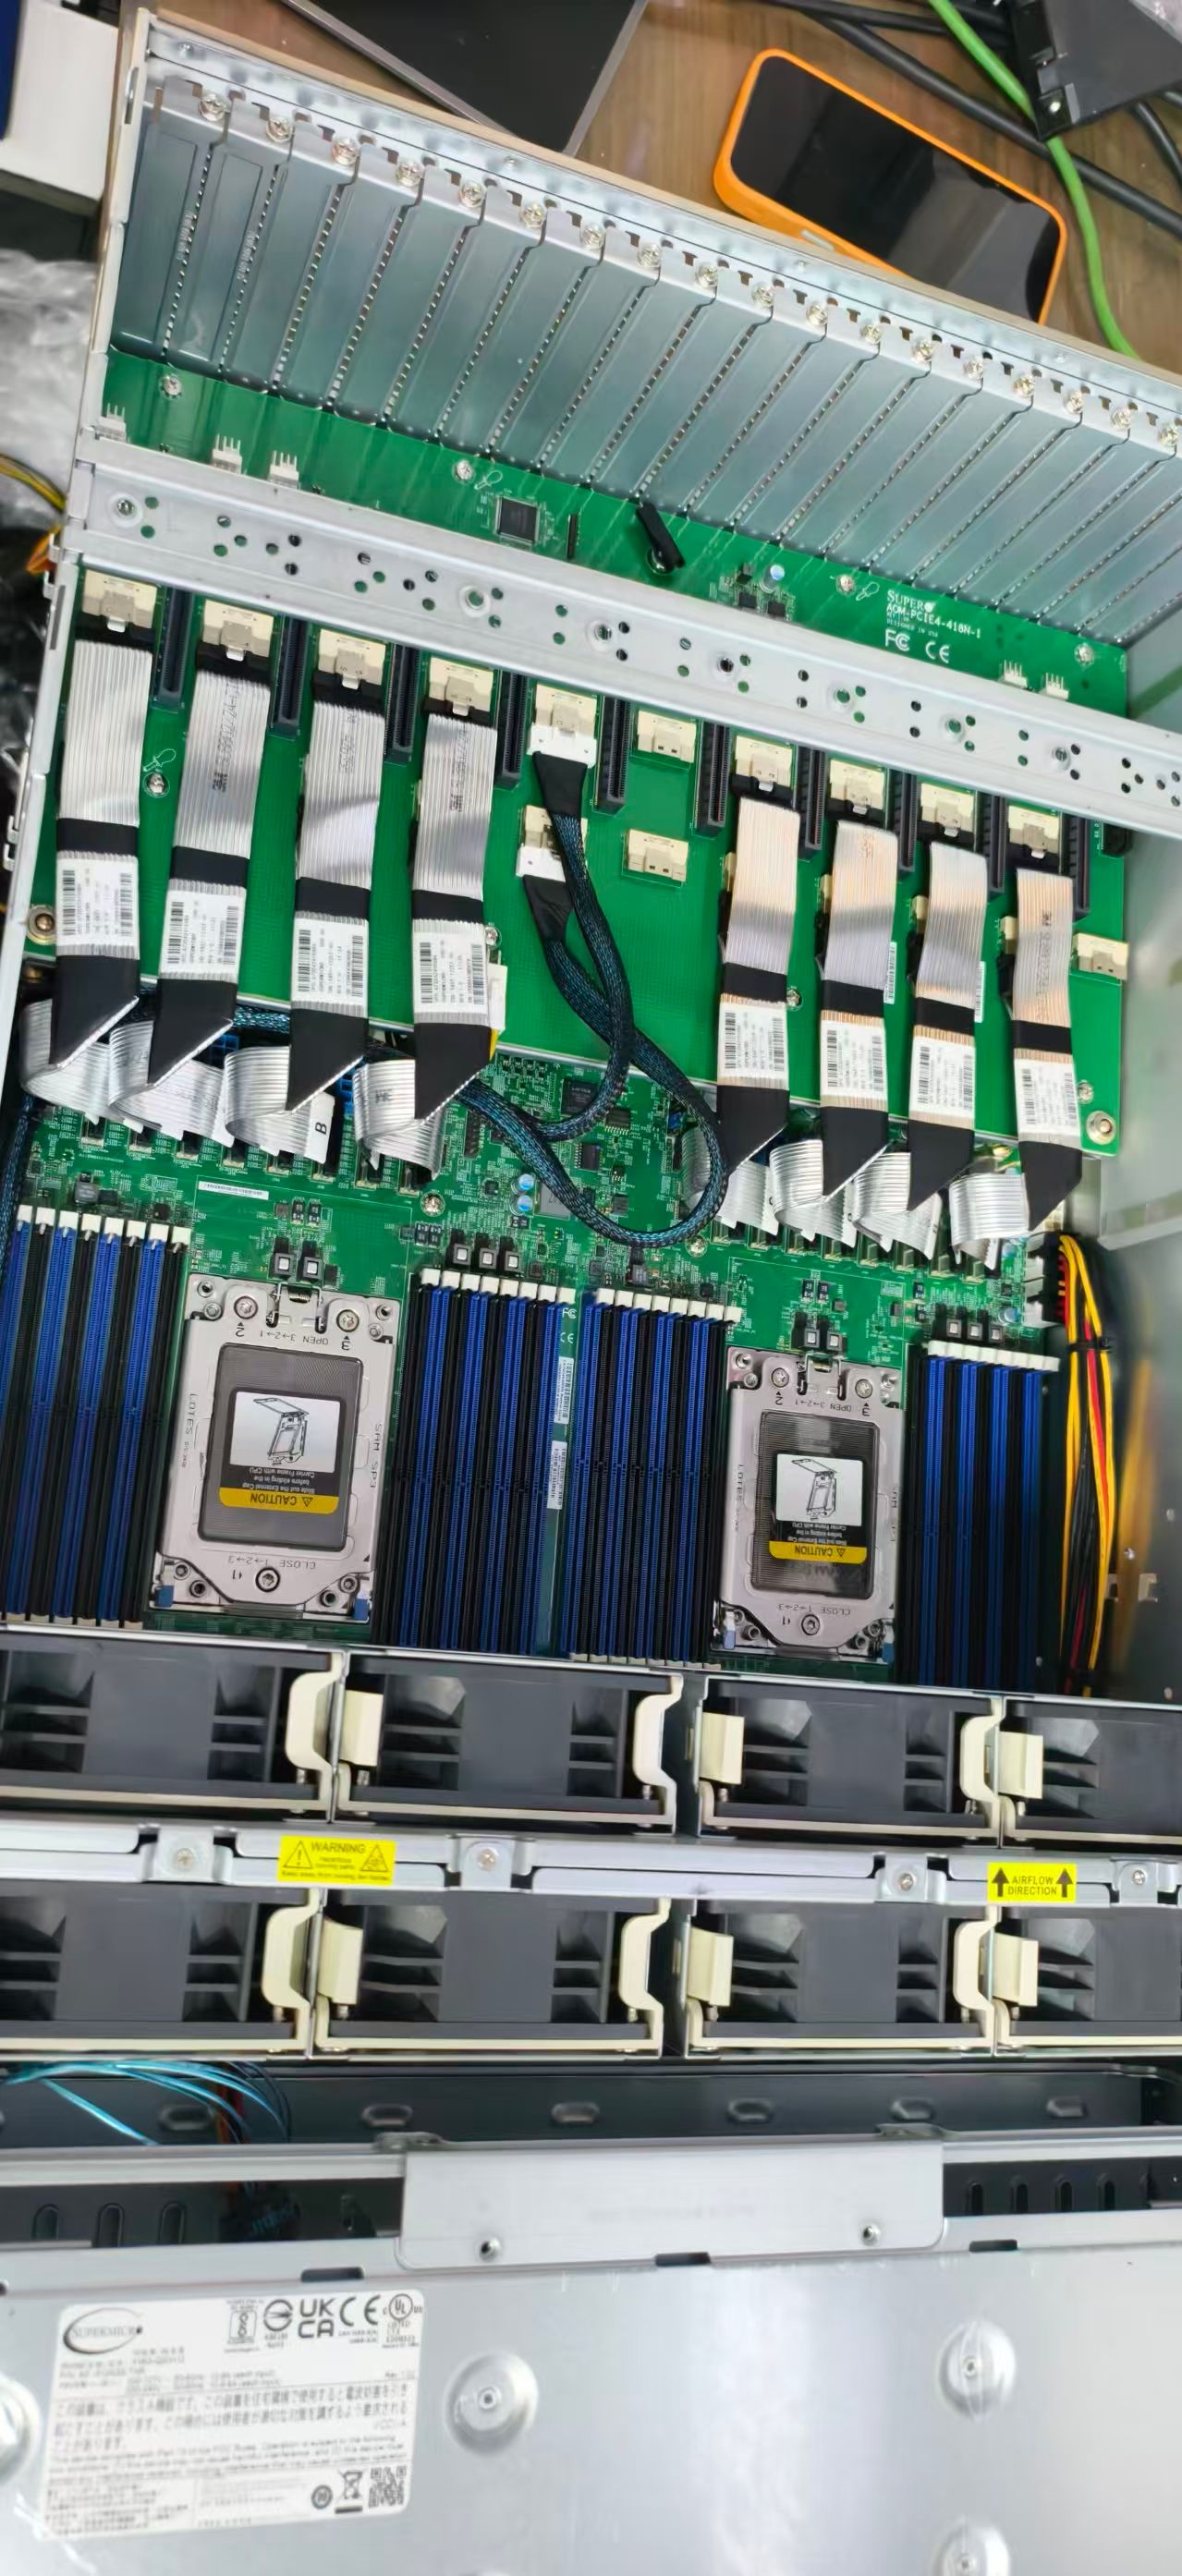
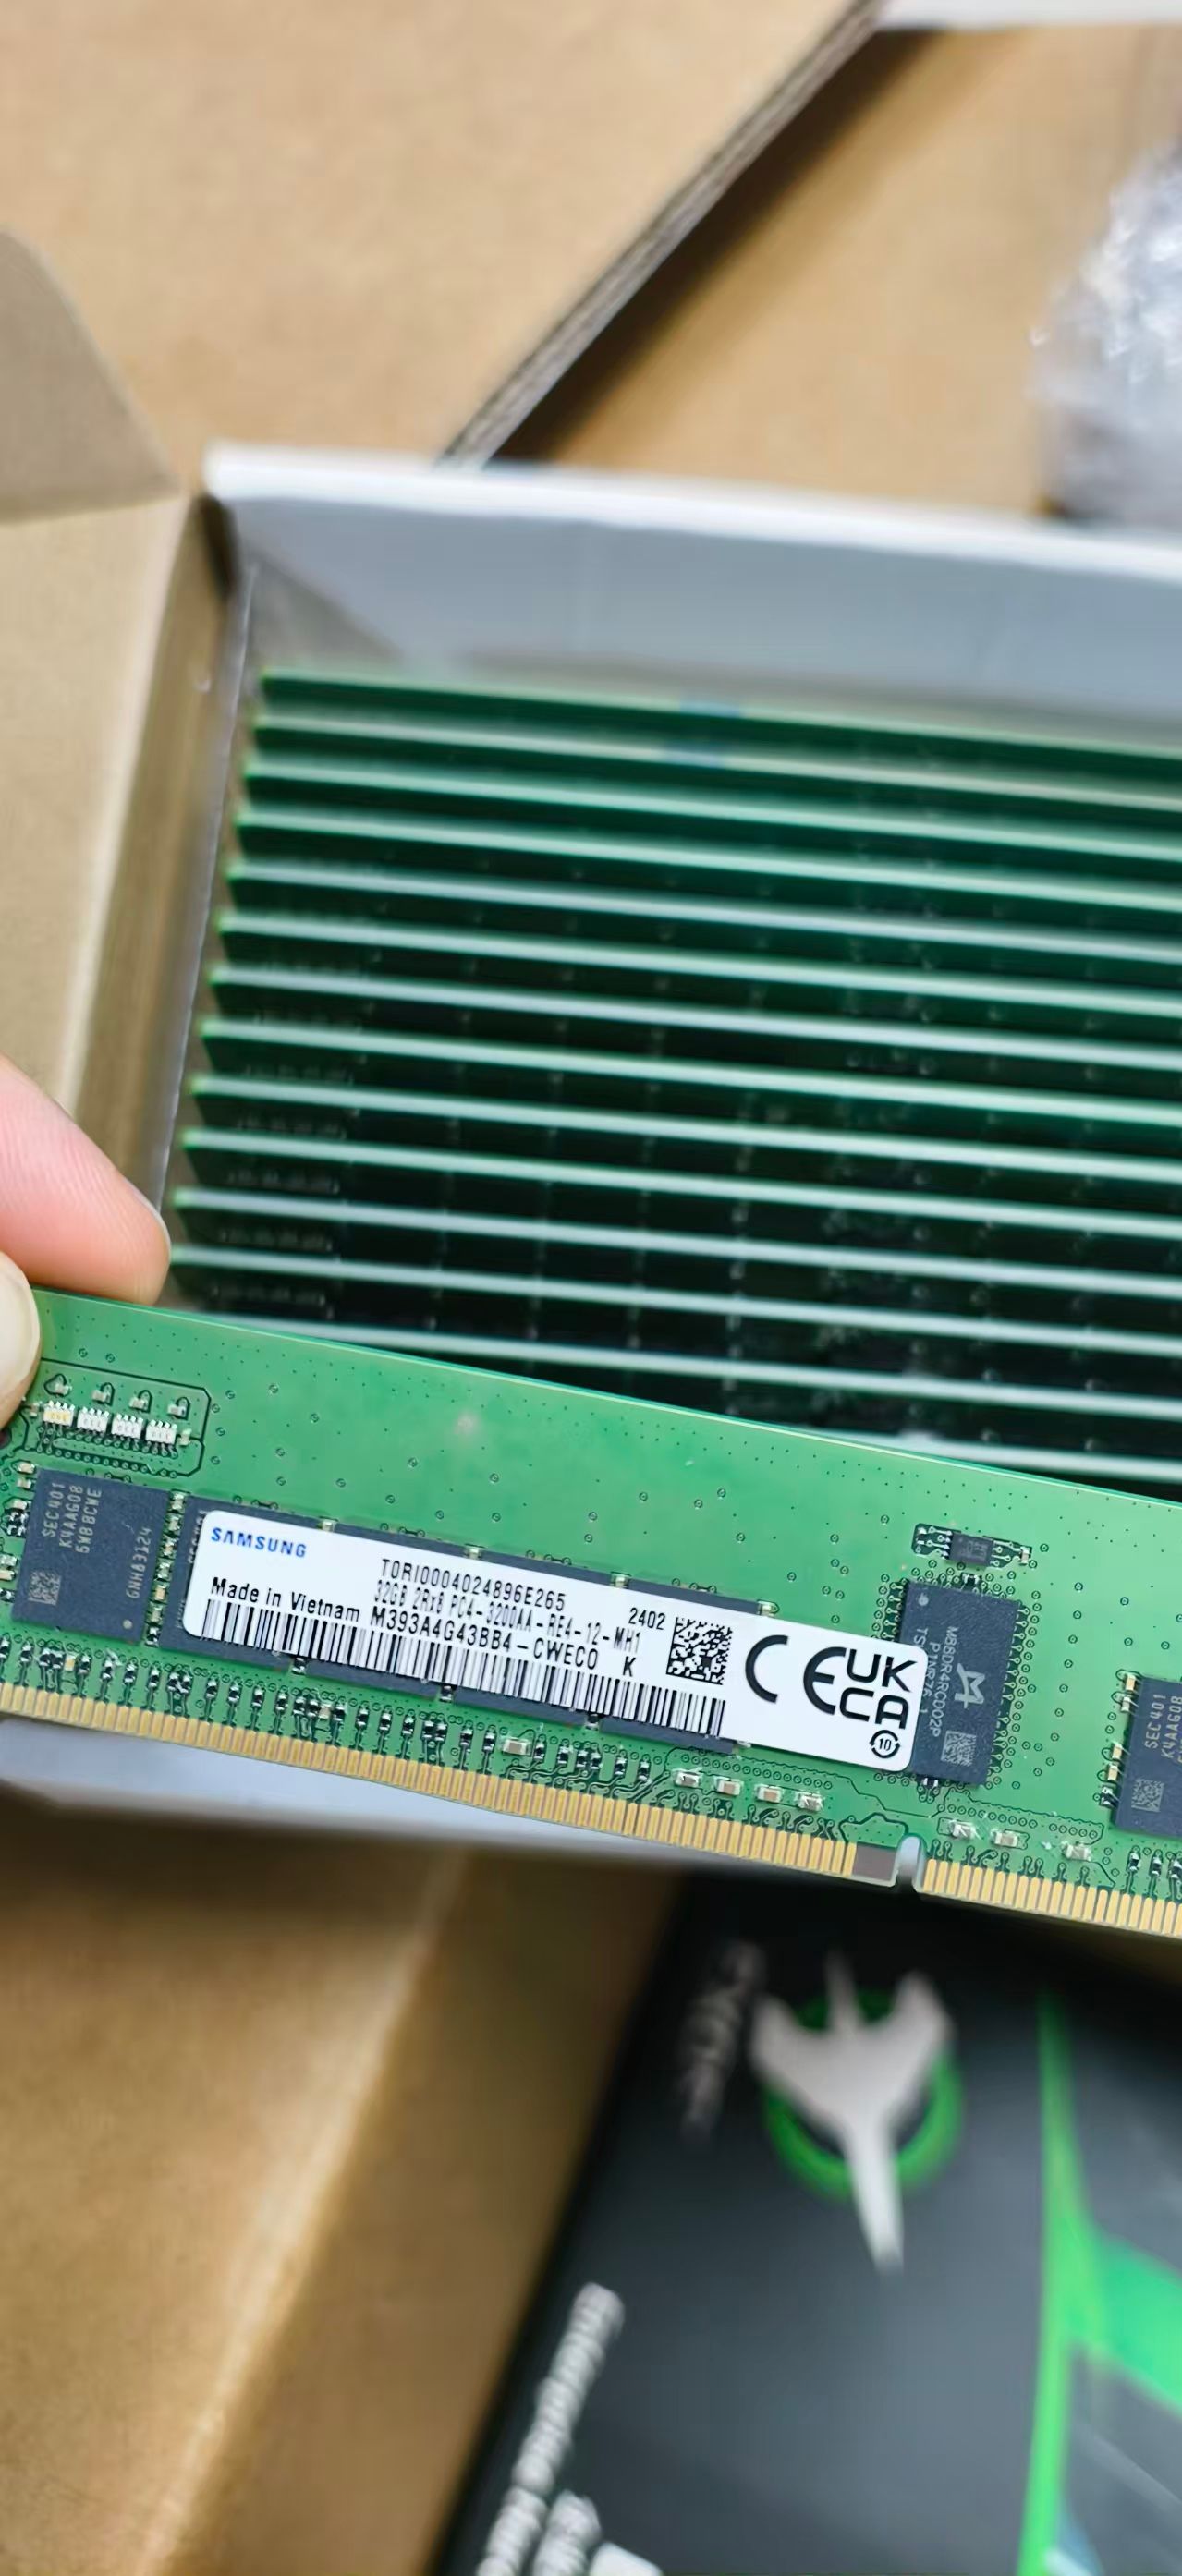
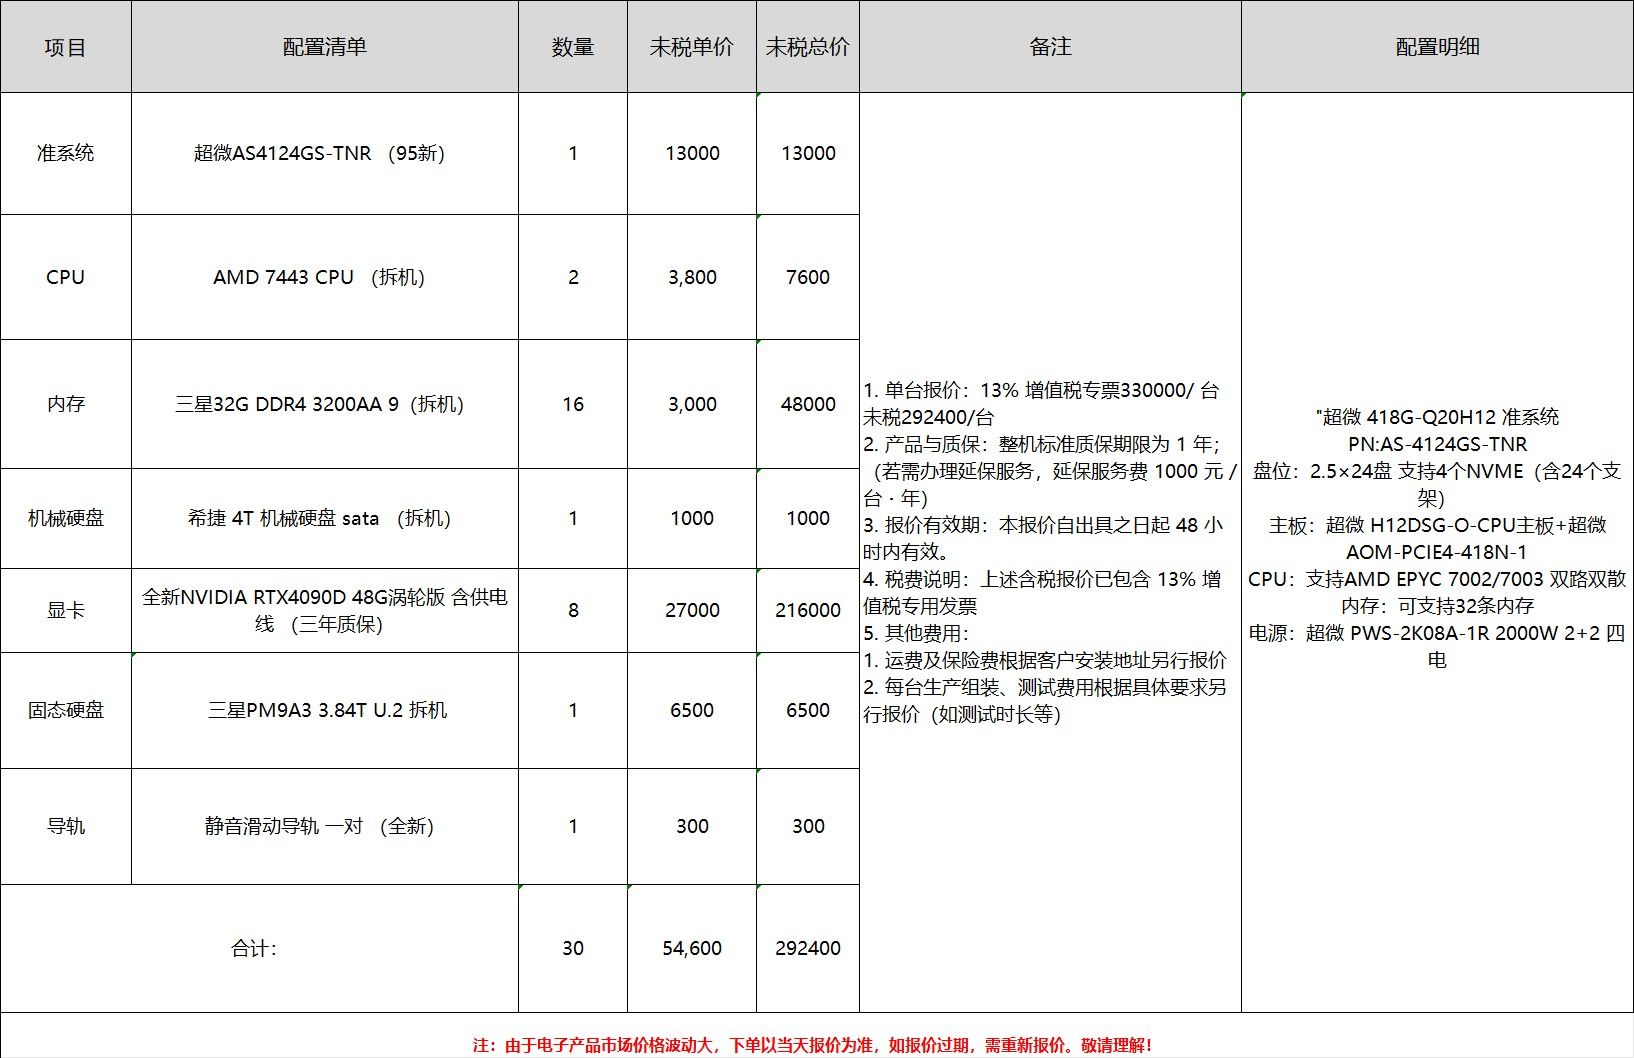
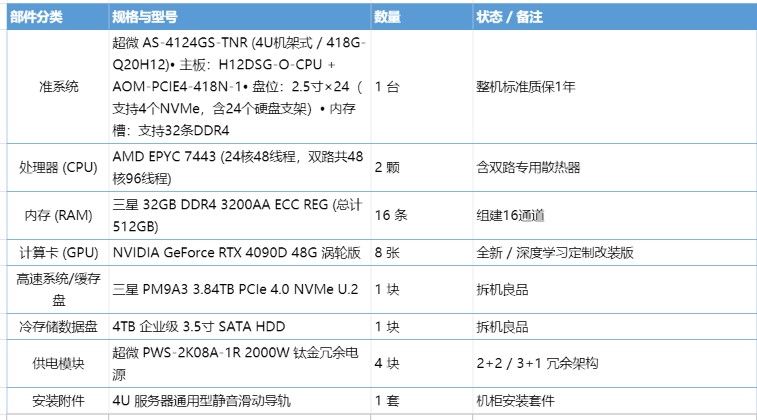
先报一下家底:8 × 4090D 48G、双路 EPYC 7443、512G DDR4 内存。 还是那台机器,这次主要升级的是我的折腾方式。
一开始,我用 SGLang,以 TP1 跑 Qwen3.8 27B。
能跑,速度也还可以。但用着用着,总觉得哪里不对:显卡在忙,512G 主机内存却基本没在核心推理链路里发挥价值。花钱买了半个 T 的内存,结果请回来一群观众。
当时的我:八张卡,豪华配置。
实际的我:模型启动了,部署结束了。
后来试了 Strata,终于看到了让显存和主机内存一起发挥作用的路子。但我的目标是多个人同时使用 Agent,单人聊得飞快只是第一关。按最初的部署方式,多卡怎么分配请求、会话怎么复用缓存、工具调用回来找谁、长短任务怎么安排,都得继续解决。
至少在我当时测试的版本和部署方式下,Strata 直接拿来承担整台多卡服务器的并发服务,还没达到我想要的效果。
所以,我围绕 Strata 又补了一层调度和资源管理,最后留下了现在这套方案:
七个独立单卡实例 + 每卡两个原生生成槽 + 会话固定路由 + NUMA 本地模型共享 + RAM 会话缓存。
这串名词看着长,拆开其实很直白。
七张卡负责主模型,第八张卡负责 OCR 和语音转写。
GPU0–6 各跑一个独立 Strata 实例,当前使用 Strata 0.1.45,模型换成了 Qwen3.8-Flash-Next 的 ISTA-DASLab GSQ-RCO IQ3_S 版本。第八张卡承担文档识别和语音转写,给 Agent 配齐输入能力。
先把空闲卡用起来,再开同卡第二路。
新会话优先分配到完全空闲的卡,七张卡都有任务之后,再使用每卡的第二个生成槽。全机最多 14 路同时生成,满了就排队。单路保留 MTP 推测解码,同卡双路使用原生 batch-MTP 路径。
同一段对话认准原来的卡。
一段对话固定交给同一个实例,调用工具、拿回结果、继续回答,都尽量沿用已有状态。少折腾一次上下文,就少交一次重复读取的时间税。当然,这也有取舍:原卡两槽都忙时,老会话会等原卡。
512G 内存正式上岗,而且按 NUMA 分工。
两个 NUMA 节点各保留一份本地只读模型副本,同一节点内的实例共享模型文件页。CPU 核心、显卡和私有内存也按节点安排,减少跨节点访问。两份模型相关锁页合计约 161.84 GiB,验收时两边都达到了 100% 本地页。
聊过的长对话,给它留个位置。
主机内存还用于会话状态停放和恢复。每个实例最多配置 8 个缓存槽,按实例分配 24/32 GiB 预算,全机预算合计 192 GiB,按需使用。这里的“缓存槽”是保存会话的地方,同时生成仍然是每卡两路,实际能保留多少历史也受长度和内存预算限制。
以前 512G 内存在旁边看热闹,现在它负责共享模型、接住会话状态、减少重复读取,终于成了这套架构里的主力。
这也是这轮折腾最让我爽的地方:同一台机器,终于开始像一台完整的推理服务器了。
数字也摆出来,光说爽没意思。
| 测试场景 | 实测表现 |
|---|---|
| 单卡单路部分任务 | 跑到约 180 token/s |
| 七卡、每卡双路,14 路短输入生成 | 每路速度中位数 83.60 token/s |
| 上述并发测试记录的总吞吐 | 约 1102.54 token/s |
| 14 路短输入正文首字延迟 | P50 0.64 秒,P95 0.67 秒 |
| 14 路、各约 20K 历史的缓存续问 | 每路速度中位数 80.73 token/s |
| 上述 20K 历史续问的正文首字延迟 | P50 1.27 秒,P95 1.79 秒 |
双并发的“80 t/s”,说的是同一张卡上两路各自约 80 t/s。
缓存也有具体记录:在这组 14 路约 20K 历史的连续追问测试里,按“已缓存输入 token / 总输入 token”计算,输入前缀复用比例约 99.77%。对 Agent 来说,能把前面读过的东西接着用,体验提升很实在。
口径顺手说清:180 t/s 是部分任务跑到过的成绩,单路速度会随任务波动;表里的并发性能测试关闭了思考,短输入每路输出 2048 token。99.77% 是这组连续追问的前缀复用比例,不能当成所有用户、所有请求的长期命中率。长文首次读取仍需要时间,也没有拿 14 路满 256K 同时生成来套这张表。
能晒出来的成绩,测了什么就说什么,这样吹起来才踏实。
再说我自己最在意的一点:脑子好不好使。
我现在用的是 Qwen3.8-Flash-Next IQ3_S,与之前的 Qwen3.8 27B 已经是不同模型,不能只盯着 IQ3_S、FP8、INT4 这几个量化名字比较。
就我自己的日常任务实测而言,这个 IQ3_S 版本的理解和完成任务能力,整体强于我之前部署的 Qwen3.8 27B FP8 和 AWQ INT4。
这句话是我的使用结论,任务范围就是我平时拿它干的那些活。尤其是指令遵循、工具调用、拿到工具结果后继续往下做,整体效果让我比较满意。
我用的是 Agent。模型会不会按要求做事,能不能把工具用明白,前后几轮能不能接得住,比单纯把字吐得快更影响体验。
所以这次让我愿意长期用下去的,是几件事终于凑到了一起:
当然,Strata、模型量化和推测解码这些核心能力,功劳属于上游作者。我做的是在自己的硬件上反复测试,把调度、内存、会话和 Agent 使用流程组合起来,调到适合自己的业务。
菜鸡没发明发动机,但这回总算把车装得像样了一点。
之前老特说我部署能力堪忧,我认。闭关这段时间也算没白折腾。
现在回来交作业:还是那八张 4090D,单路能跑到 180 t/s,同卡双路各约 80 t/s,512G 内存终于从观众席走上了赛场。
允许我先叉会儿腰。大佬们继续挑毛病,我继续改。
看到最新一期的老特说,老师说我眼泪掉下来,全程用CODEX部署,兄弟们说的多卡方案,包括deepseek等我都理解,但是目前我只能跑单卡,因为并发非常高,可能超过20个并发,而且是多人办公场景,不是一般问答, 所以智能TP1走单卡推理跑7副本的27B和一张卡单独OCR跑的paddle 1.6vl(ocr需求很大所以单独一张卡)一下是当前我的配置参数,希望有大神能指点一下:
以下是 2026-10-10 最后部署、读回并保存的配置。当前离开服务器局域网,没有重新连接服务器;以下不是实时状态。连接地址、账户、API 密钥和 GPU UUID 均已省略。
硬件与软件
shm_size=8gb。七份独立模型副本,TP=1;不是七卡 TP=7。e00930c5489053f26d86b179cee0d087f846acbb,固定镜像 CUDA 13.0.3。lmsysorg/sglang:v0.5.21;实际固定来源为 docker.io/lmsysorg/sglang@sha256:b1259f3ea3275f66237c498ea388919729018bc9f01c3d638391e06e2cf3f469。本地加载标签为 llm-inference/sglang:prepared-20261003。cyankiwi/Qwen3.8-27B-AWQ-INT4;revision:6e134bae811fb5adac50ee042ae5f029ac6779aa。卡片分配与关键差异
GPU0–5 是六个普通 128K 副本,通过网关分配请求。GPU6 是独立的 256K 服务,只有获管理员授权并在当前对话打开 256K 的账户使用;不加入普通网关轮询。GPU7 独立运行 OCR,不参与 LLM 的 TP 或 MTP。
| 参数 | 普通 GPU0–5 | 长上下文 GPU6 |
|---|---|---|
| tensor-parallel-size | 1 | 1 |
| context-length | 131072 | 262144 |
| SGLANG_MAX_NEW_TOKENS_LIMIT | 32768 | 65536 |
| max-running-requests | 4 | 1 |
| max-total-tokens:配置目标 | 262144 | 262144 |
| 实际 KV token pool:代表卡运行读回 | GPU0:186700 | 262144 |
| mem-fraction-static | 0.88 | 0.93 |
| cuda-graph-max-bs-decode | 4 | 1 |
| max-mamba-cache-size | 20 | 6 |
| 代表卡实际 KV 池显存 | GPU0:11.395 GiB | 16.000 GiB |
| 代表卡短题期间常驻显存 | GPU0:40631 MiB | 42225 MiB |
上下文是输入、思考和最终回答的合计预算。32K/64K 是最大输出预算,包含思考,并不保证每次都输出这么多。普通卡的 4 个运行槽位不代表能同时容纳 4 个完整 128K 请求;配置 max-total-tokens=262144 也不能替代实际分配的 token pool 数值。
普通 128K 实例实际启动参数
每个普通容器分别运行以下命令。LLM_API_KEY 为私有环境变量,这里没有给出其值。
export SGLANG_MAX_NEW_TOKENS_LIMIT=32768

python3 -m sglang.launch_server \
  --model-path /models/Qwen3.8-27B-AWQ-INT4 \
  --served-model-name Qwen3.8-27B-AWQ-INT4 \
  --host 0.0.0.0 --port 30000 \
  --tensor-parallel-size 1 \
  --dtype bfloat16 \
  --kv-cache-dtype auto \
  --context-length 131072 \
  --max-running-requests 4 \
  --max-total-tokens 262144 \
  --mem-fraction-static 0.88 \
  --chunked-prefill-size 2048 \
  --prefill-decode-interval 1 \
  --cuda-graph-max-bs-decode 4 \
  --max-mamba-cache-size 20 \
  --mamba-ssm-dtype float32 \
  --attention-backend triton \
  --quantization compressed-tensors \
  --reasoning-parser qwen3 \
  --tool-call-parser qwen3_coder \
  --log-level warning \
  --api-key "$LLM_API_KEY" \
  --enable-metrics \
  --speculative-algorithm EAGLE \
  --speculative-draft-model-path /models/Qwen3.8-27B-AWQ-INT4 \
  --speculative-num-steps 1 \
  --speculative-eagle-topk 1 \
  --speculative-num-draft-tokens 2 \
  --speculative-draft-attention-backend triton \
  --mamba-radix-cache-strategy extra_buffer
其他容器环境:HF_HUB_OFFLINE=1、TRANSFORMERS_OFFLINE=1、HF_HOME=/cache/huggingface、OMP_NUM_THREADS=2、TOKENIZERS_PARALLELISM=false。模型目录只读挂载,各容器有独立缓存目录。
GPU6 的 256K 实例
与上面的普通启动参数相同,只有下面六项变化;其余参数,包括 served model name、主/draft 路径、精度和 MTP 参数都保持相同。该实例在独立容器中运行,不与普通实例占用同一卡。
SGLANG_MAX_NEW_TOKENS_LIMIT=65536
--context-length 262144
--max-running-requests 1
--mem-fraction-static 0.93
--cuda-graph-max-bs-decode 1
--max-mamba-cache-size 6
两类服务 kv-cache-dtype=auto 实际采用 BF16,Mamba SSM 状态为 float32,没有使用 FP8 KV。CUDA graph 没有禁用(运行读回 disable_cuda_graph=false);LLM 未启用 mixed-chunk。GPU6 保存的 CUDA graph 分配记录包含 target verify 0.105GiB、draft extend 0.002GiB;1 step 下 draft decode 记录为 0。分配记录不能证明每一步都成功 replay,也不能把 draft decode=0 单独当成未启用 CUDA graph 的证据。
第八卡 OCR,仅供了解是否有资源干扰
GPU7 使用 SGLang 运行 PaddleOCR-VL-1.6-0.9B,TP1、BF16、context=16384、max-running-requests=32、max-queued-requests=128、max-total-tokens=524288、mem-fraction-static=0.68、chunked-prefill-size=8192、max-prefill-tokens=16384、enable-mixed-chunk、num-continuous-decode-steps=2、cuda-graph-max-bs-decode=32、attention-backend=triton、mm-attention-backend=triton_attn、mm-processor-worker-num=2。另有 4 个完整文档解析管线绑定同一 GPU7,文档级并发 4。OCR 没有启用本次 LLM 的 MTP。
测量方式与已观察现象
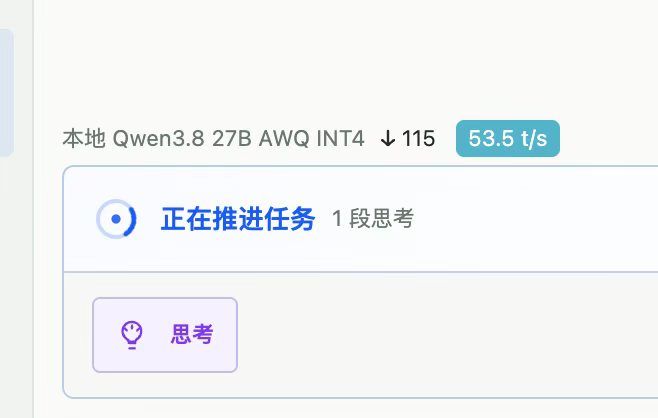
原网页用“字符数÷4”估计 token,中文速度因此明显低估。现已改为服务端真实累计 usage token 和单调时钟计量,包含思考、正文及工具参数;输出速度不包含首字等待和工具执行。不能拿旧网页的 20 多或 10 t/s 直接当作原生解码吞吐。
直接推理同题对照:关闭思考(reasoning_effort=none),temperature=0,max_tokens=2048,串行单请求,各卡 1 次预热后 3 次正式样本。每个请求使用不同 cache_salt,不清空缓存、不重启服务、不强制忽略 EOS。所有请求实际输入 118 tokens、输出 450 tokens,均正常 stop。
| 直接推理正式样本中位数 | GPU0:128K | GPU6:256K |
|---|---|---|
| 首末真实累计 token 增量/输出窗口 | 62.453 t/s | 62.485 t/s |
| 套用旧字符/4估算 | 27.262 t/s | 27.276 t/s |
| 首段正文到达 | 68.9ms | 71.1ms |
| 同批采样最高核心温度 | 56℃ | 60℃ |
Agent 全流程另有两条无工具、关闭思考的合成请求:普通实际输入 640/输出 428 tokens,网页 53.9 t/s;随后同一会话开启 256K,实际输入 1185/输出 467 tokens,网页 54.7 t/s。它们有不同输入和历史,不能当成严格同输入性能比较。服务端首段等待分别约 0.098 秒和 14.005 秒;这次 256K 的长等待尚未归因,不能据输出阶段吞吐宣称首字已经解决,也不能从单样本断言是 MTP 或 256K 参数导致。
此前独立 GPU0-MTP / GPU1-无MTP 对照,三种短题、每种 3 次正式样本、1024 token 上限:无 MTP 约 51 t/s,MTP 约 67–71 t/s,提升约 31%–40%;首个原始模型 chunk 增加约 7–12ms。该旧对照输出以 length 截断,不能证明完整回答质量相同,也不能替代长上下文性能结论。
用户体感:较强思考时正文首字等待更长。实际 Agent 请求可能带有系统提示、工具定义和工具返回,“空聊天窗口”不等于模型实际输入为空。曾观察到真实 Agent 输入 10894–19117 tokens;没有导出真实用户问答。
希望请教
@farmer-node 现在中标了 不响应就要被罚款