那个 8 卡 4090D 的菜鸡回来了:单路跑到 180 t/s,512G 内存终于不用当摆设了
各位,我就是之前在论坛发帖的那个 8 卡 4090D 菜鸡新手。
之前老特还在视频里说过,我这部署能力堪忧。说实话,看完有点扎心,但回头看看自己当时的玩法,确实也不能全怪人家。
于是闭关反思了一段时间,边补课边折腾,推翻了几轮方案,也做了不少大胆测试。现在终于端出一套自己比较满意的成果,回来交个作业,顺便允许菜鸡小小地膨胀一下。
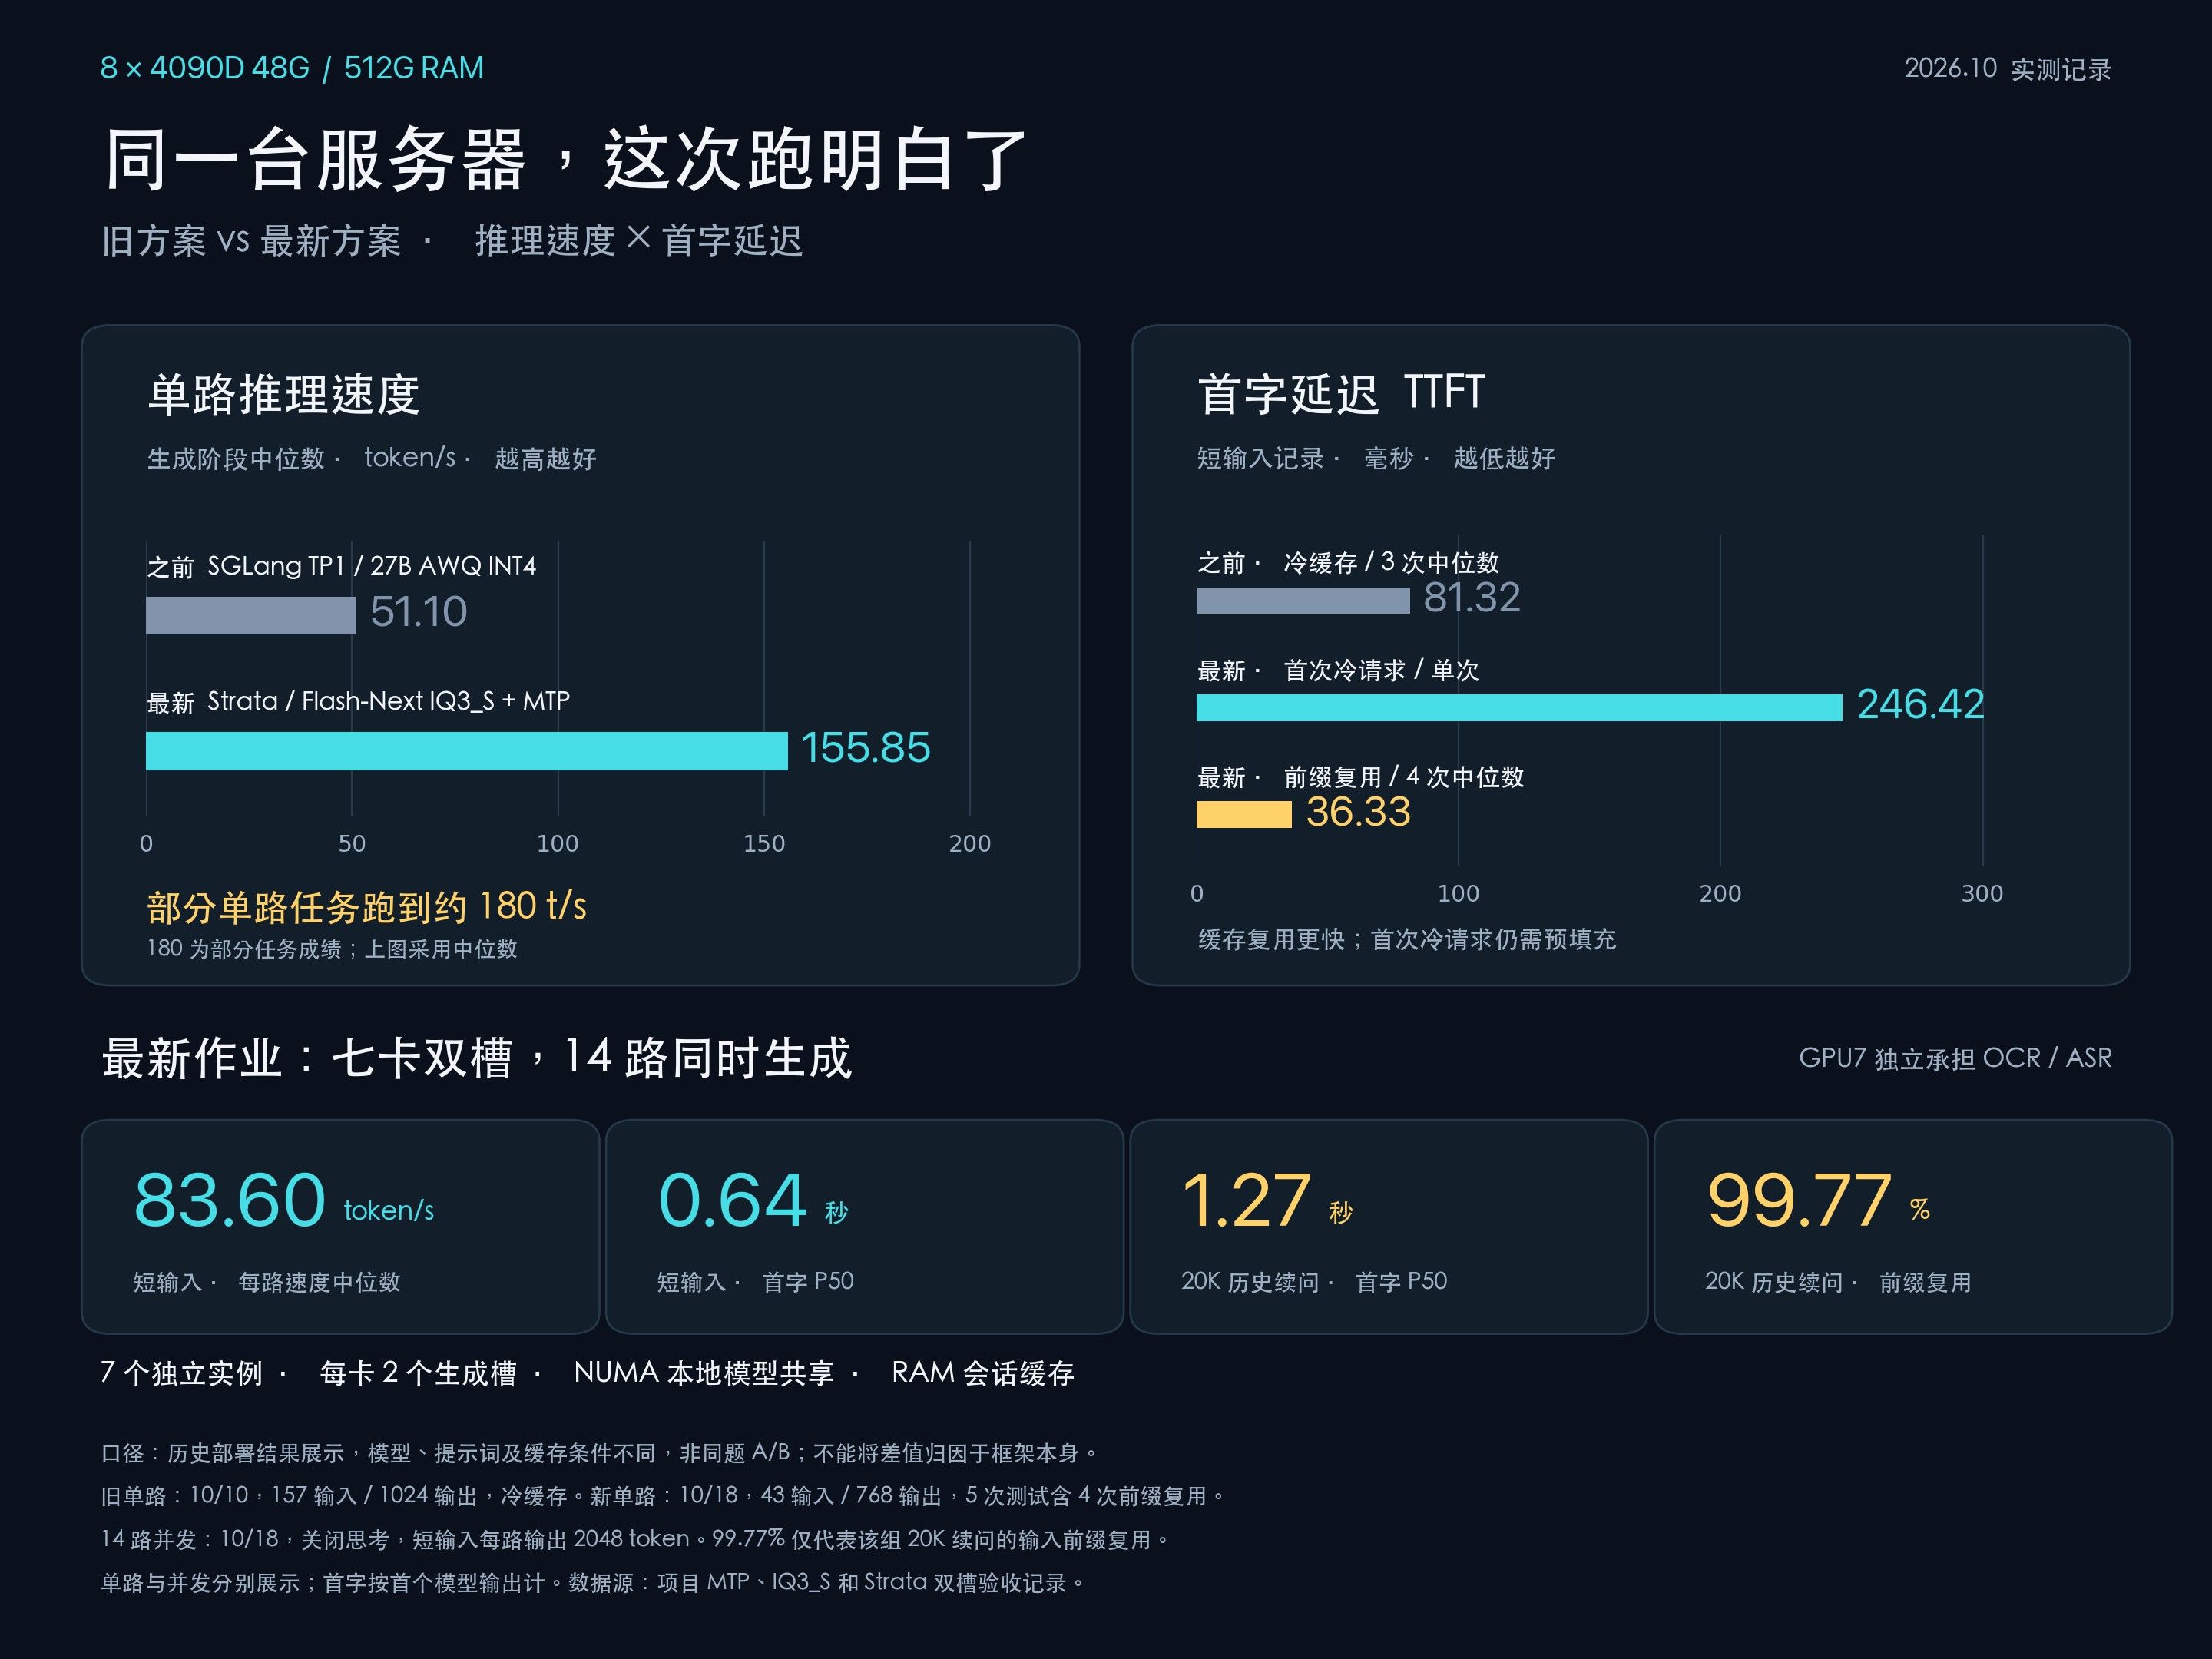
目前单卡单路实测跑到约 180 token/s,同卡双并发每路约 80 token/s,缓存复用和首字延迟也做出了效果。更关键的是,模型在我日常任务里的表现,比之前的 27B 更合我意。
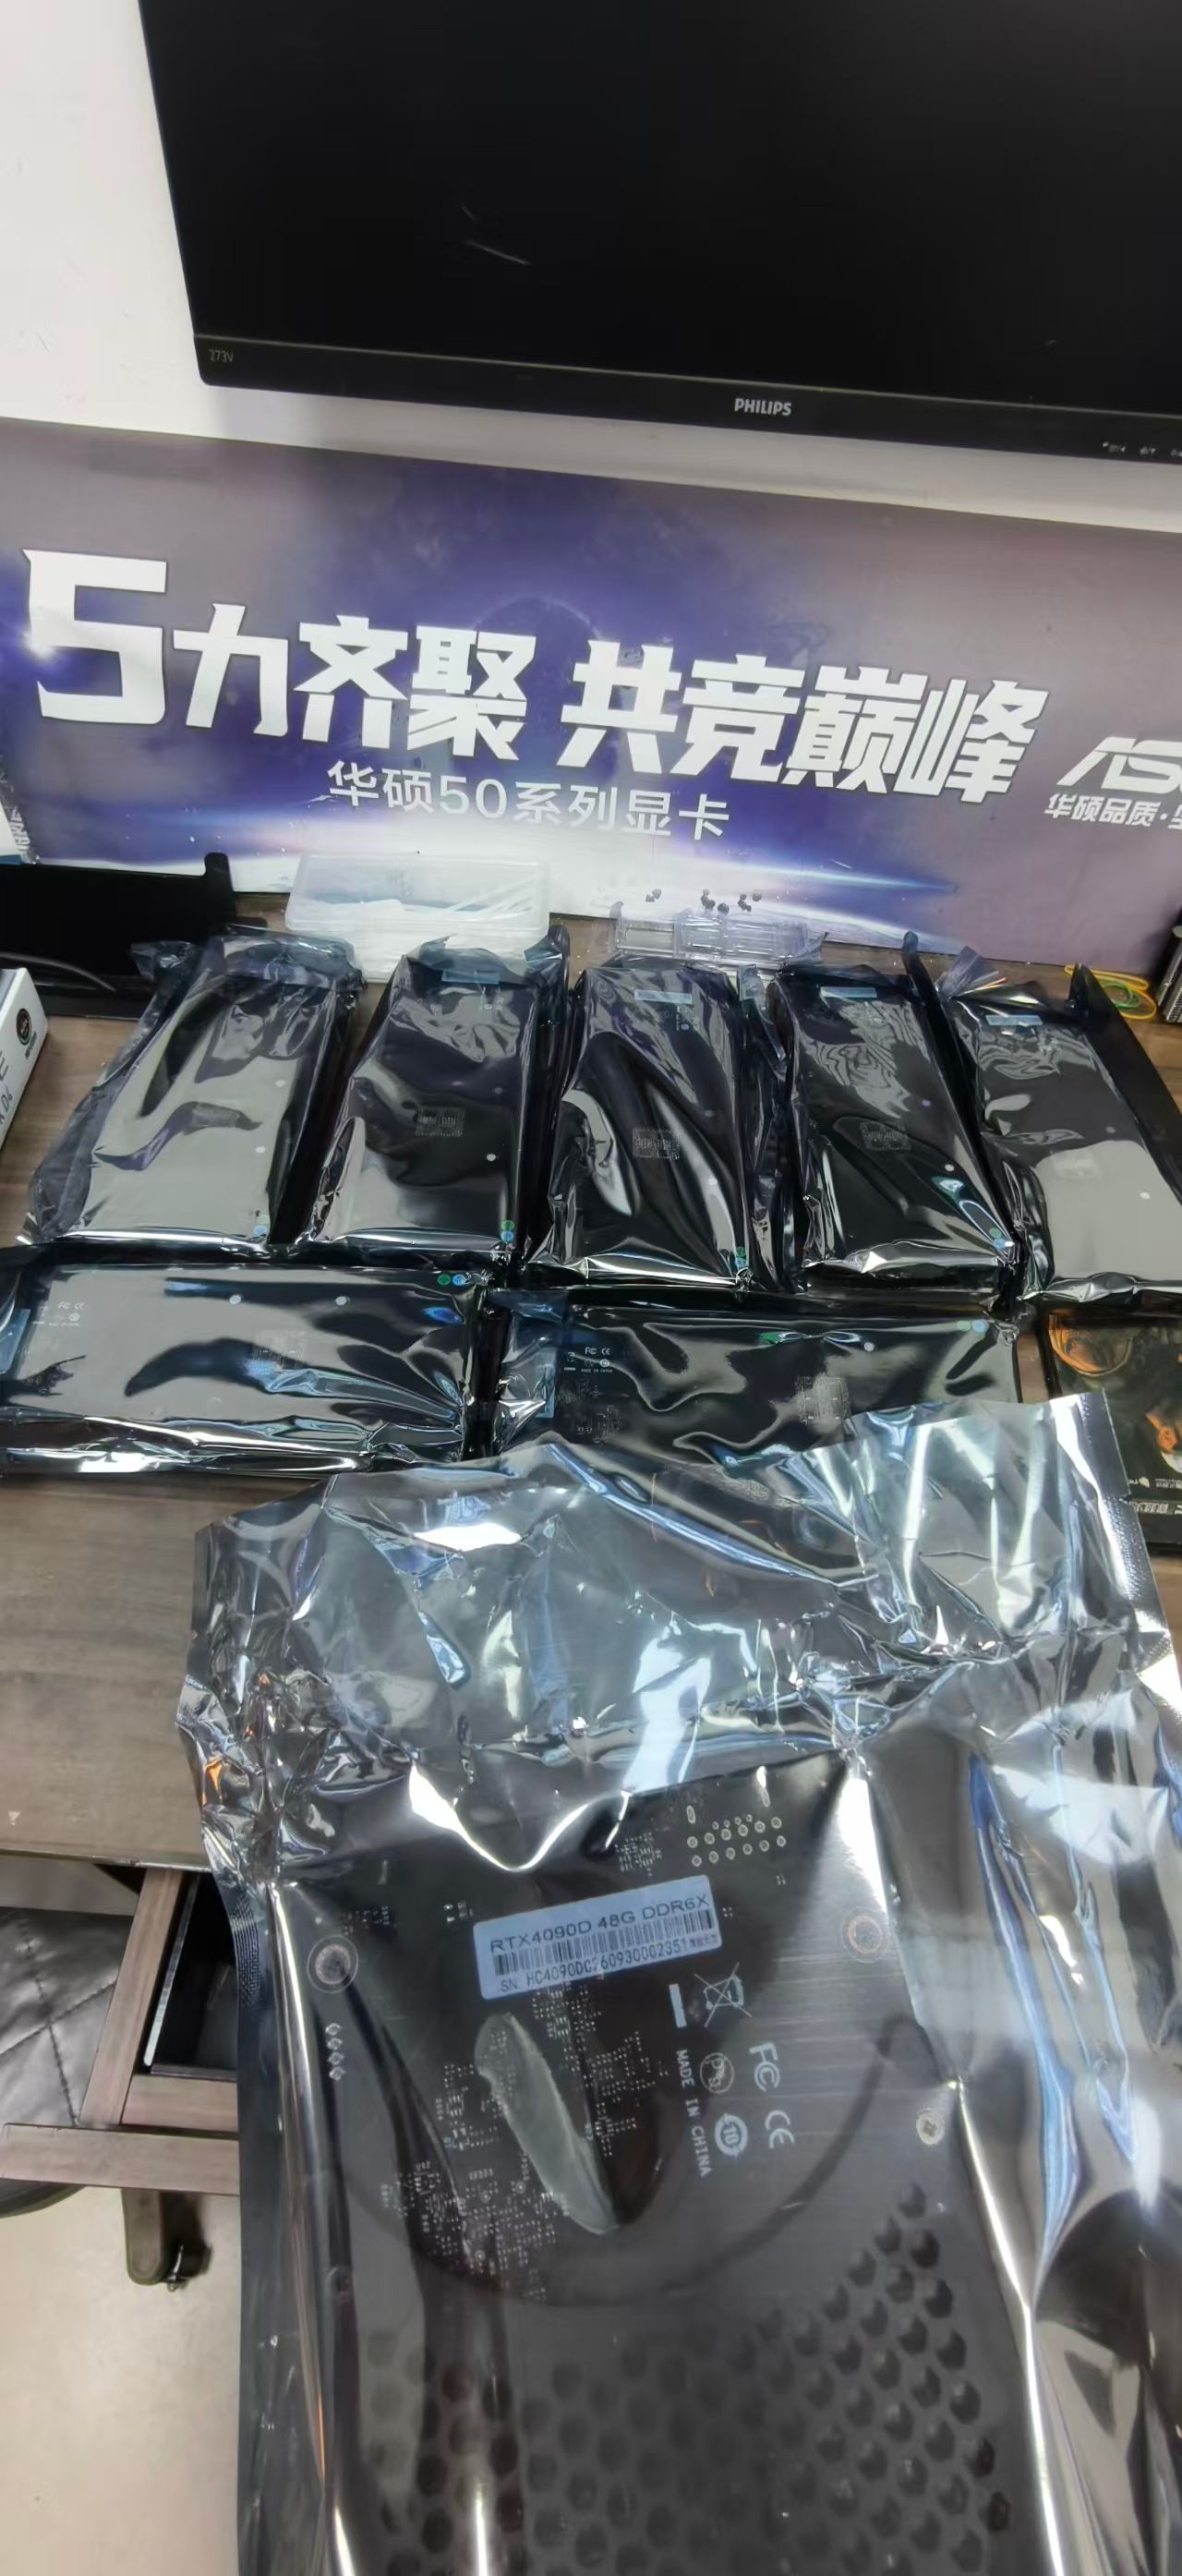
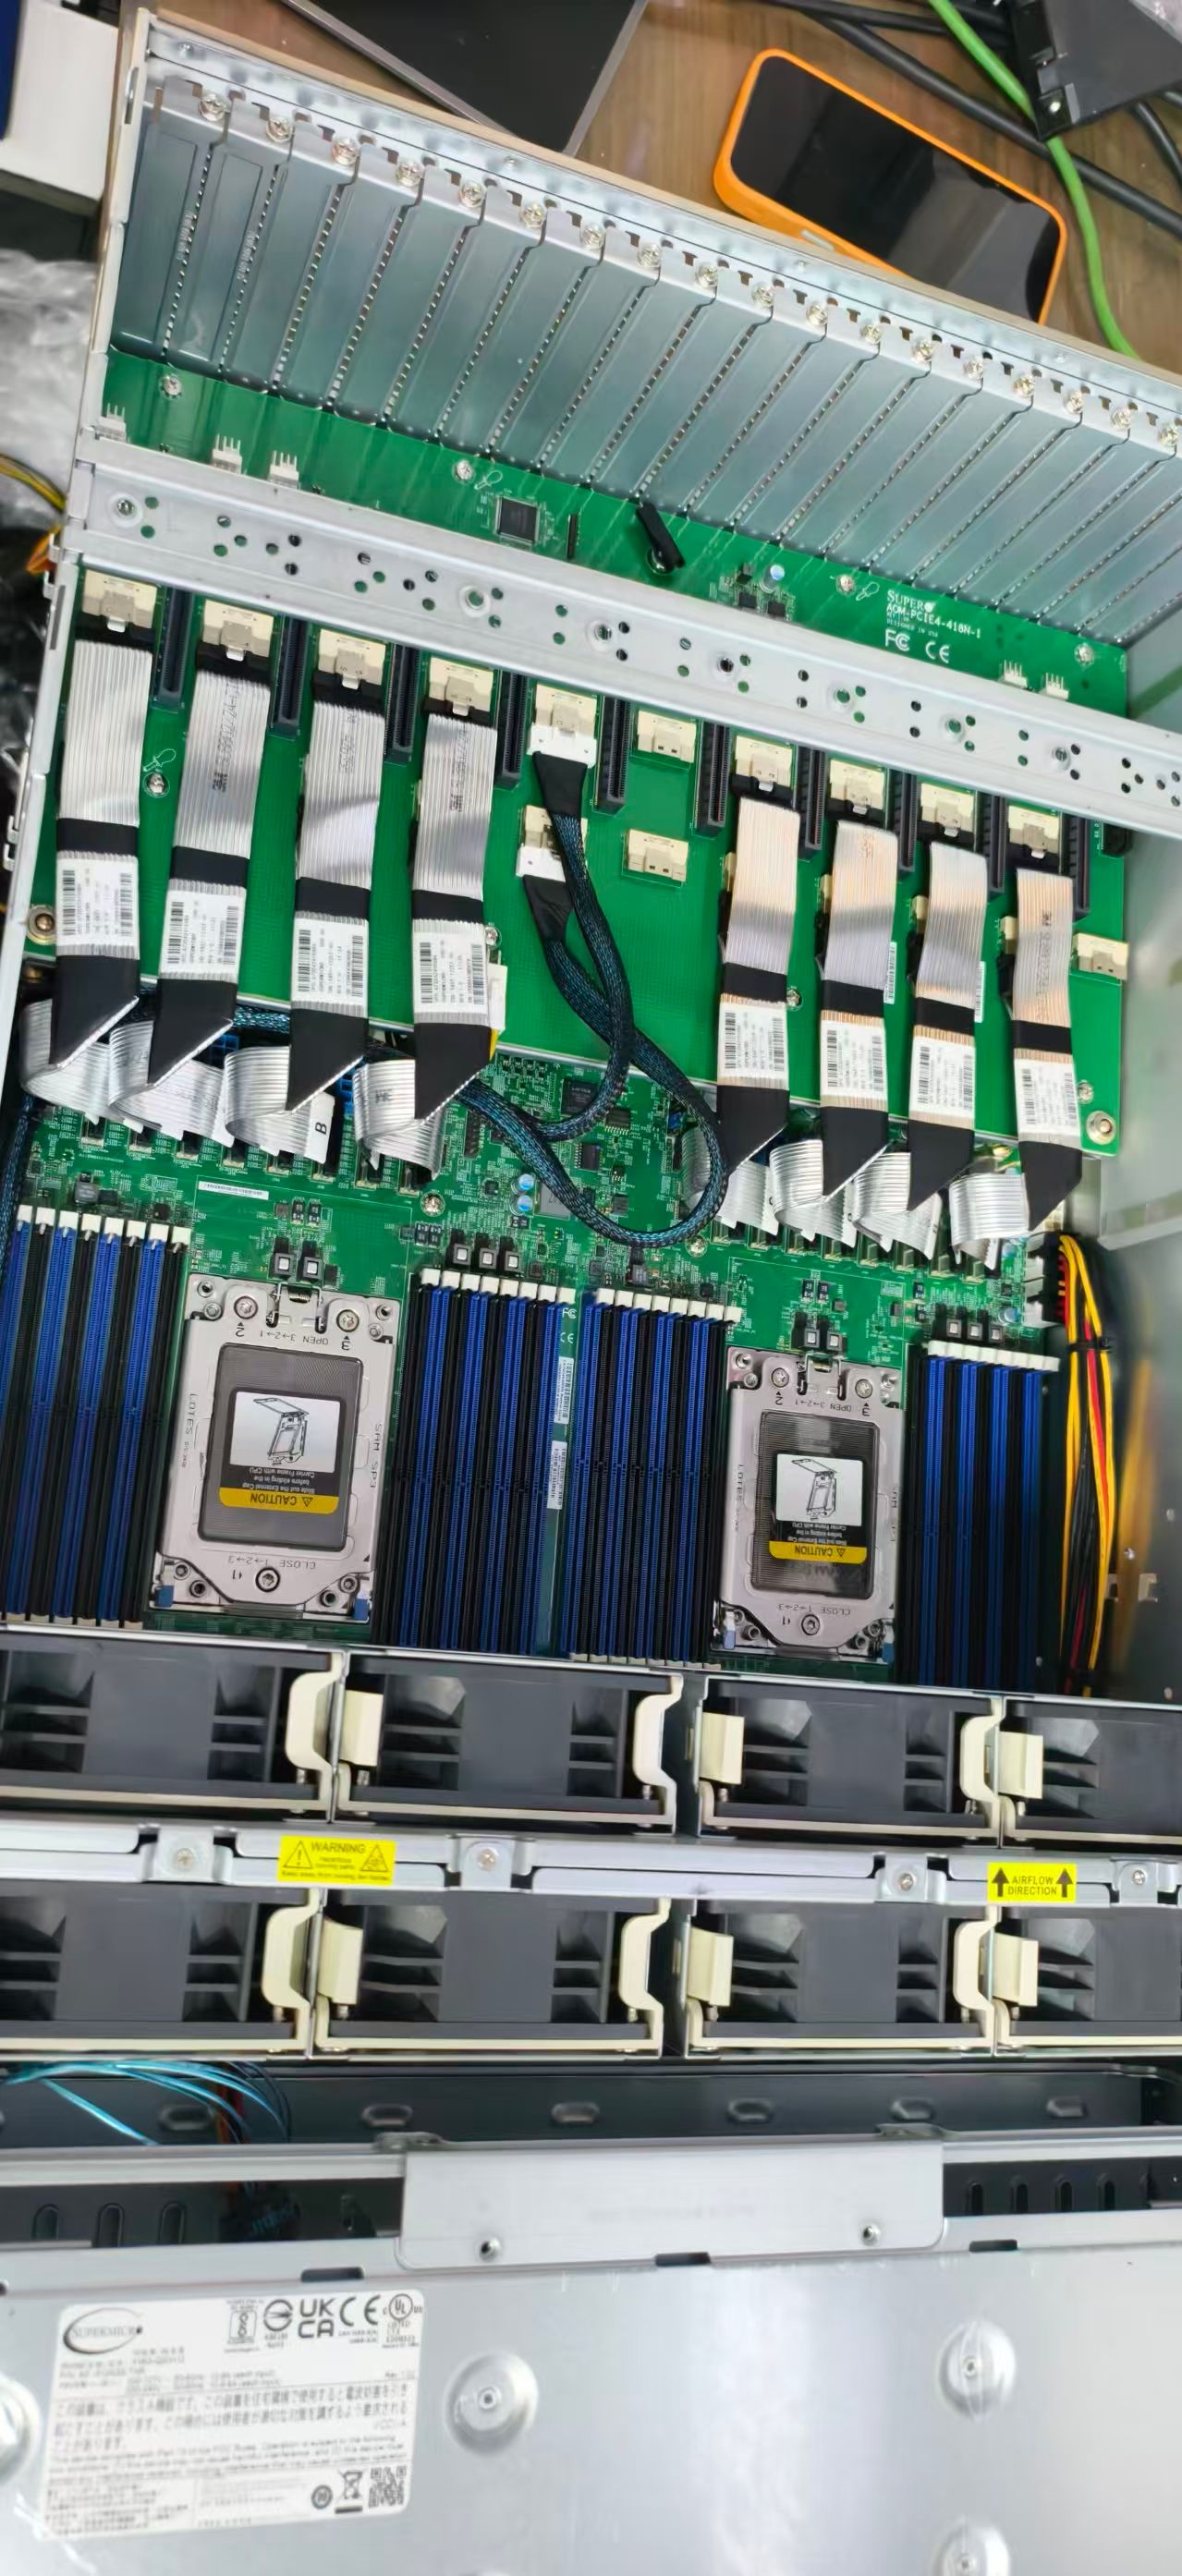
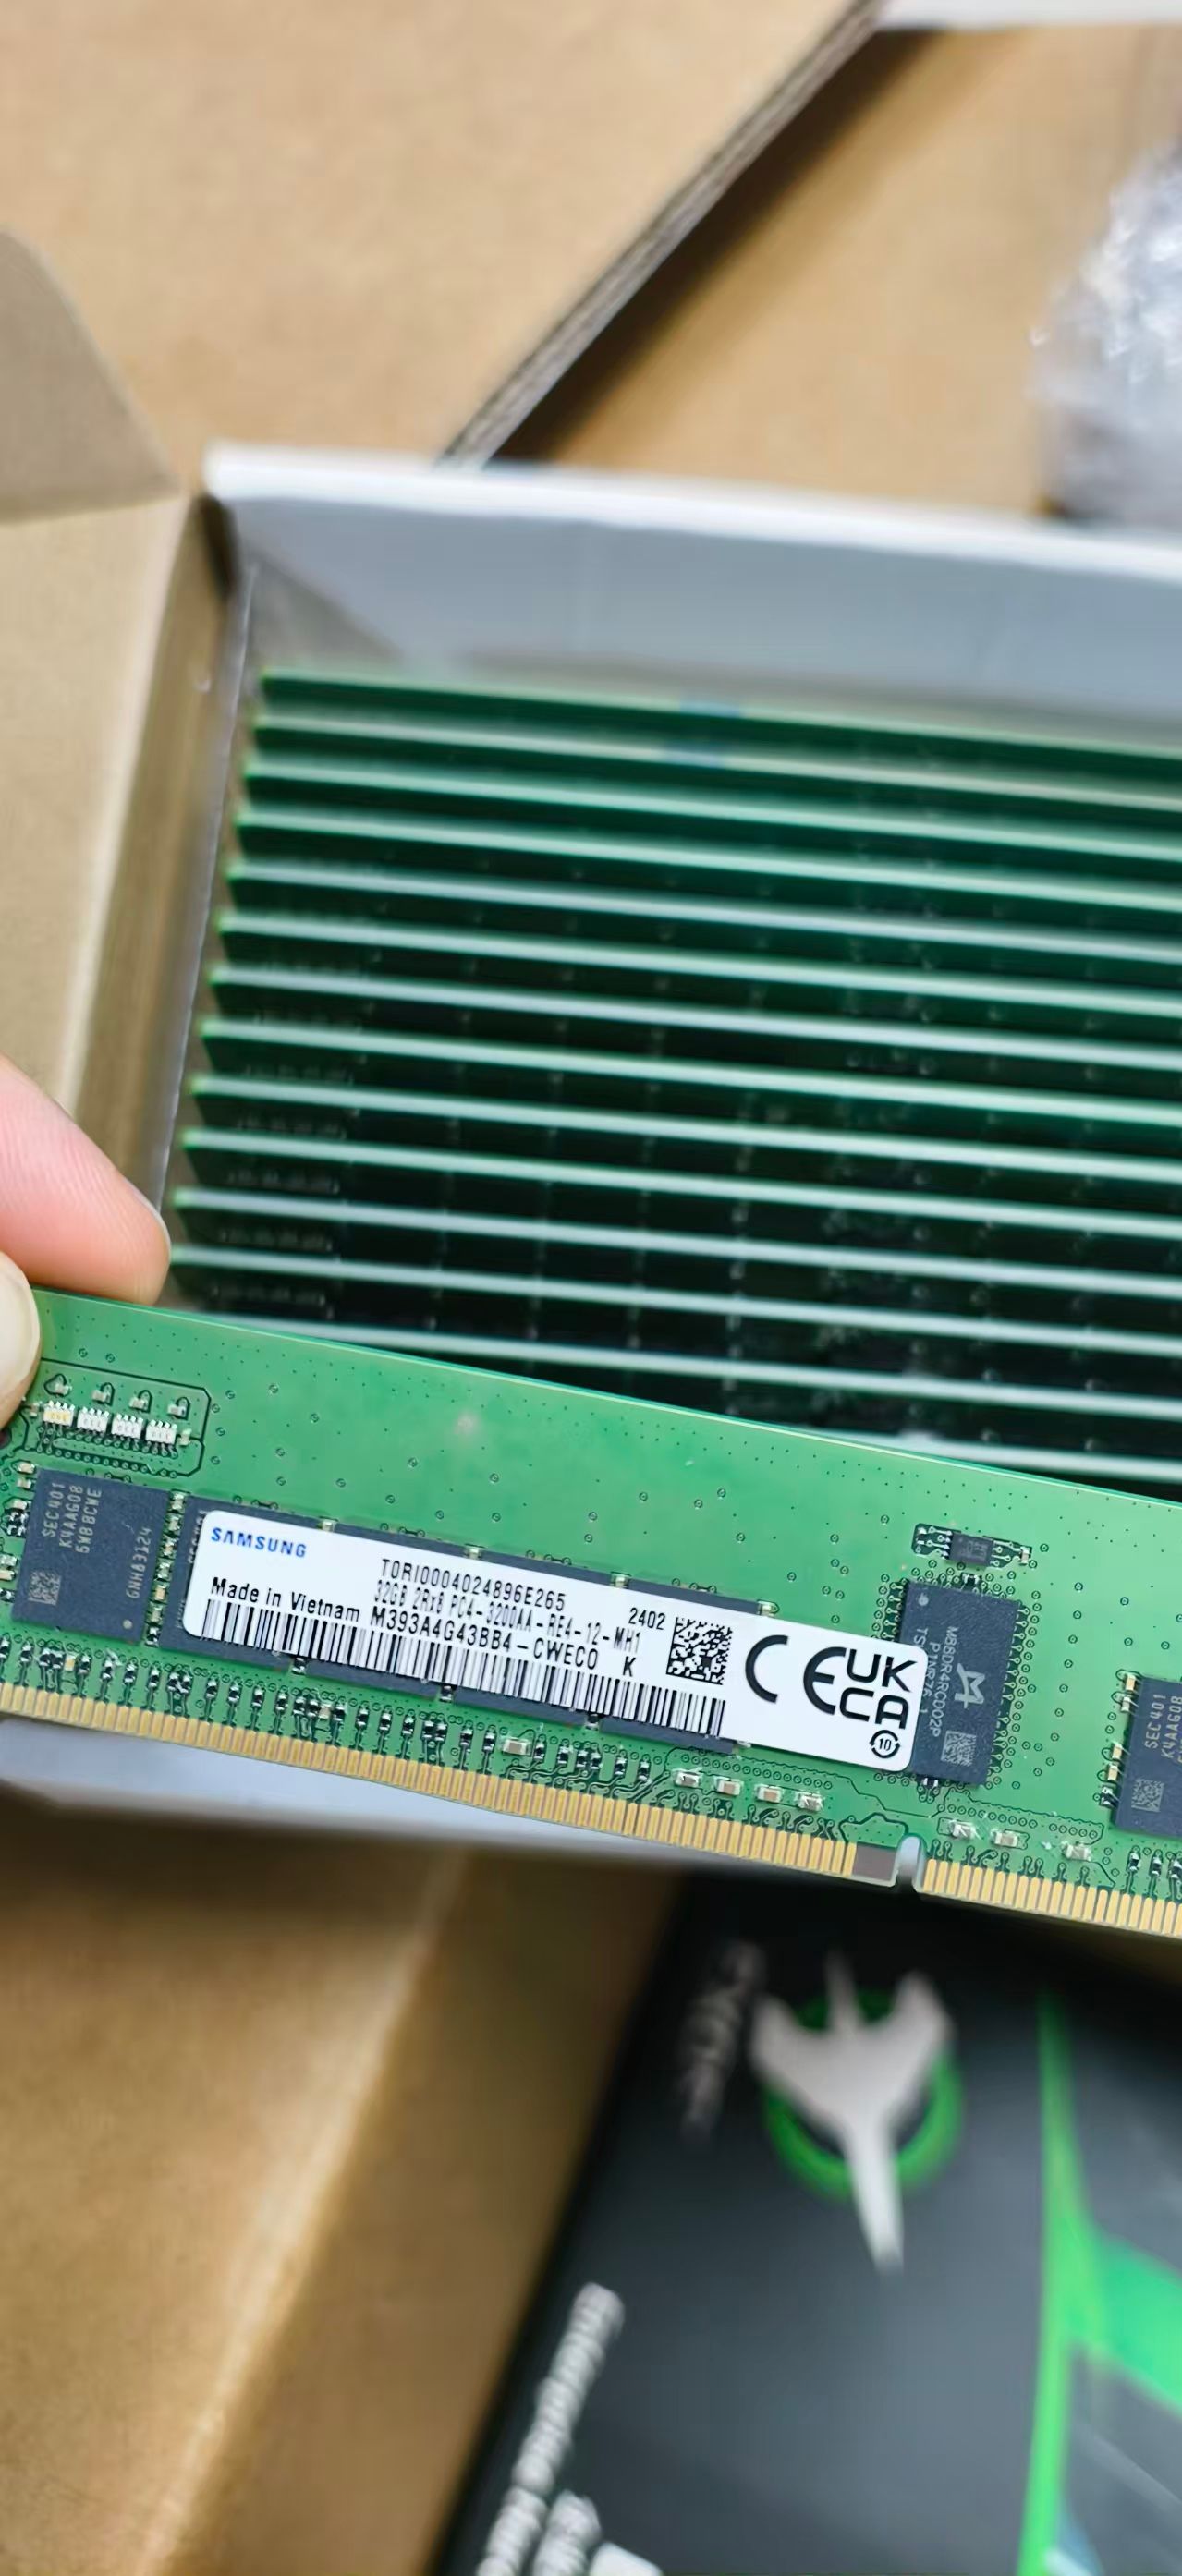
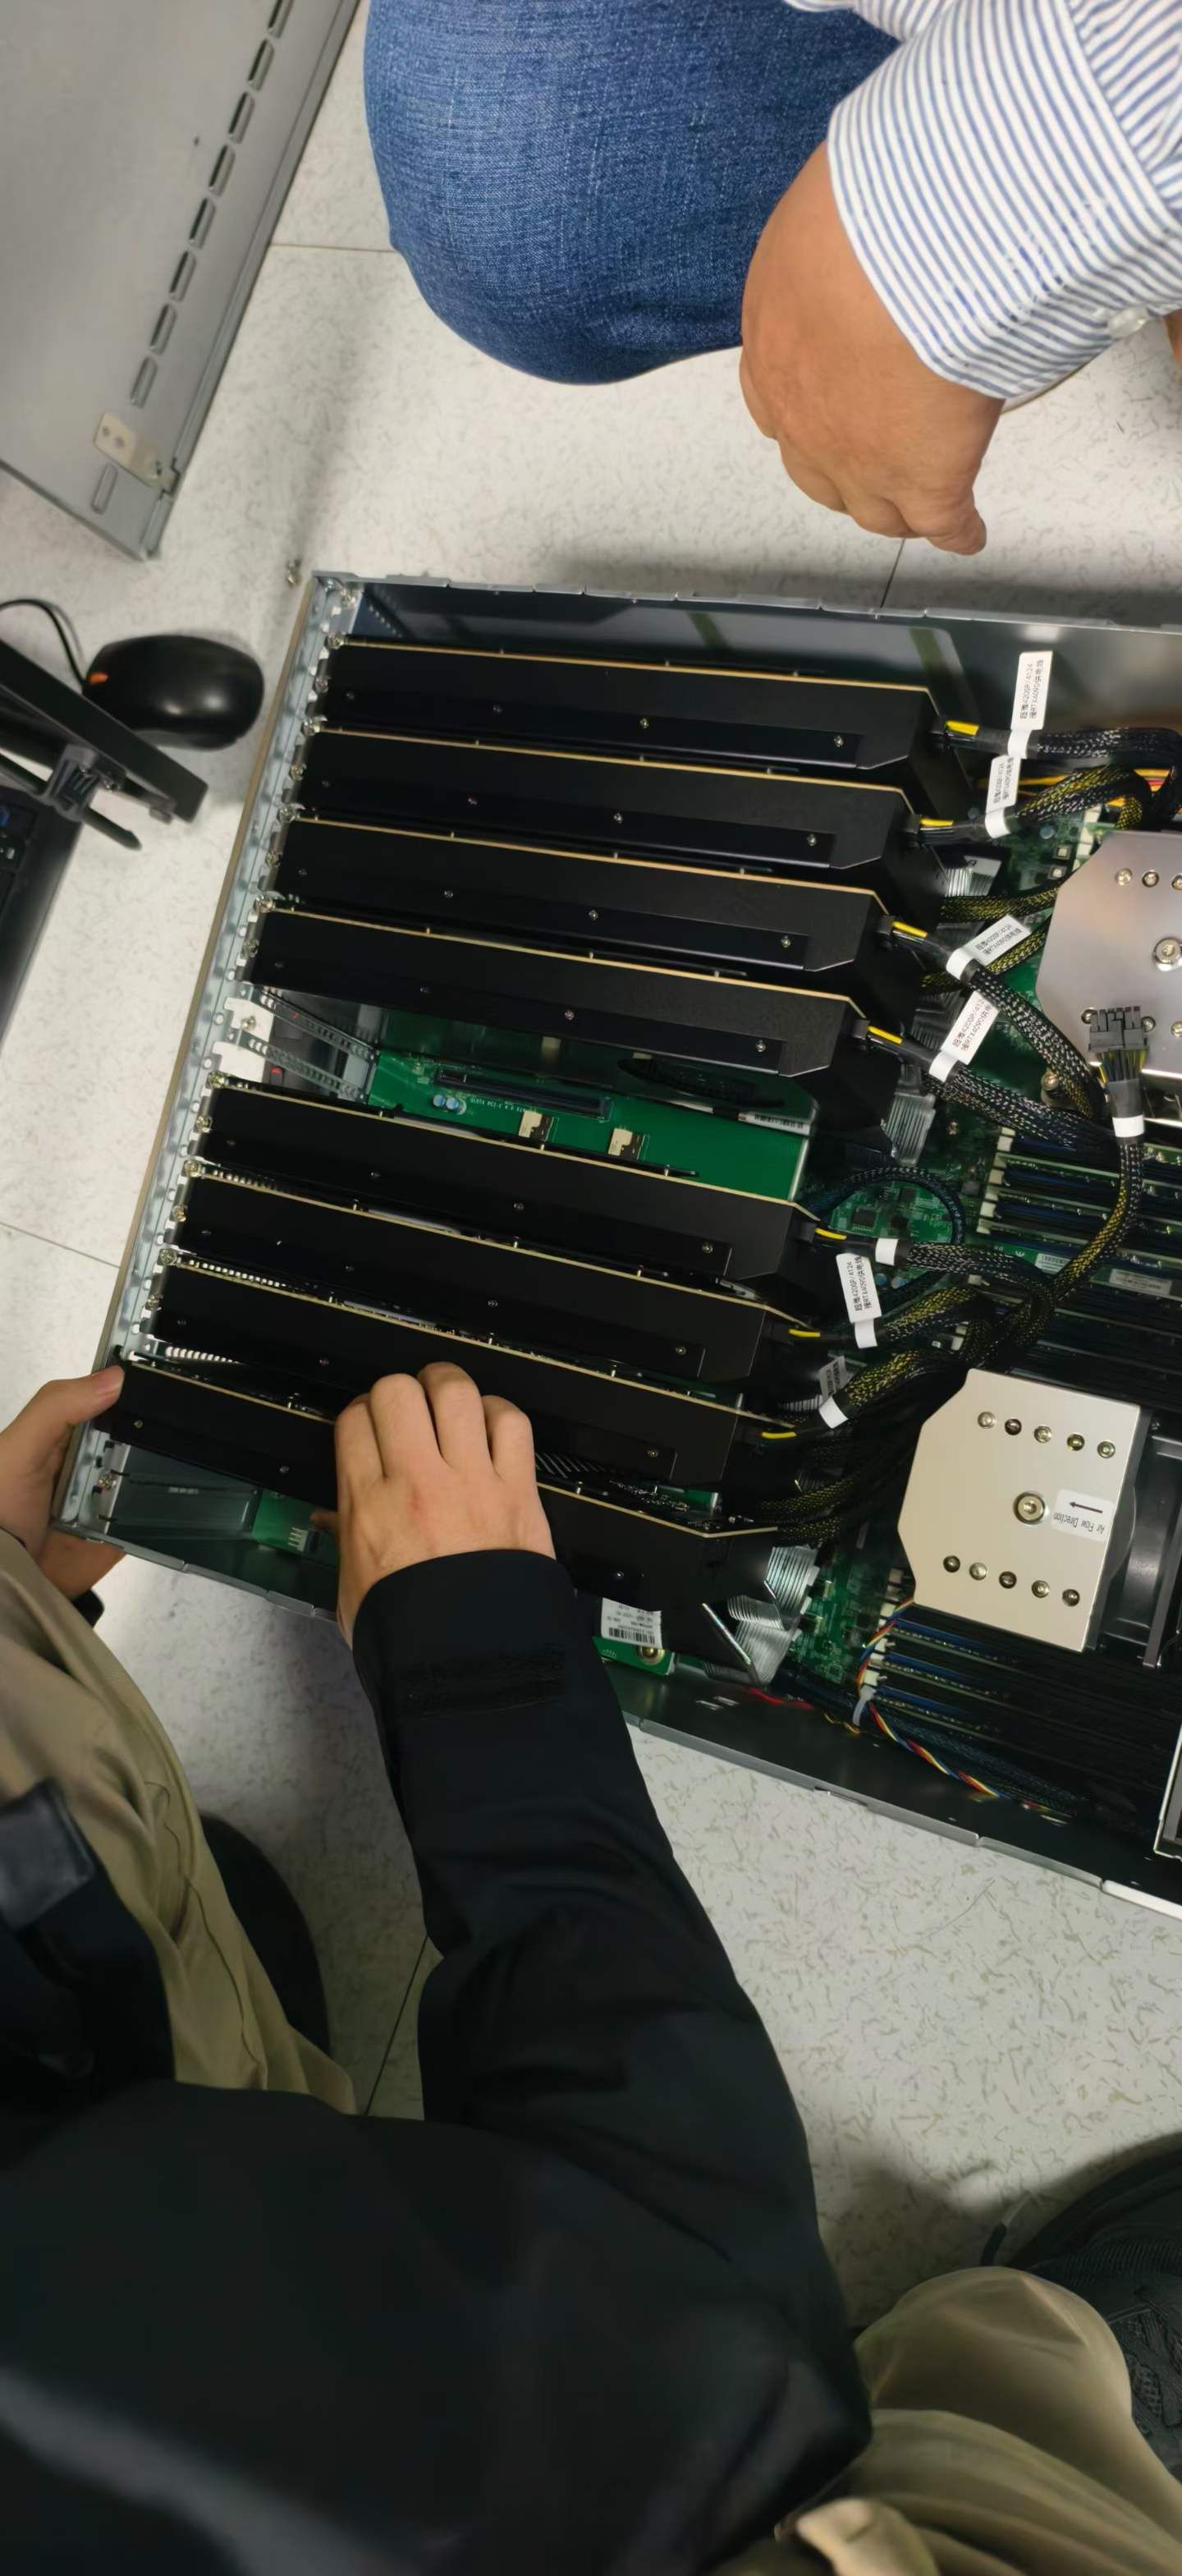
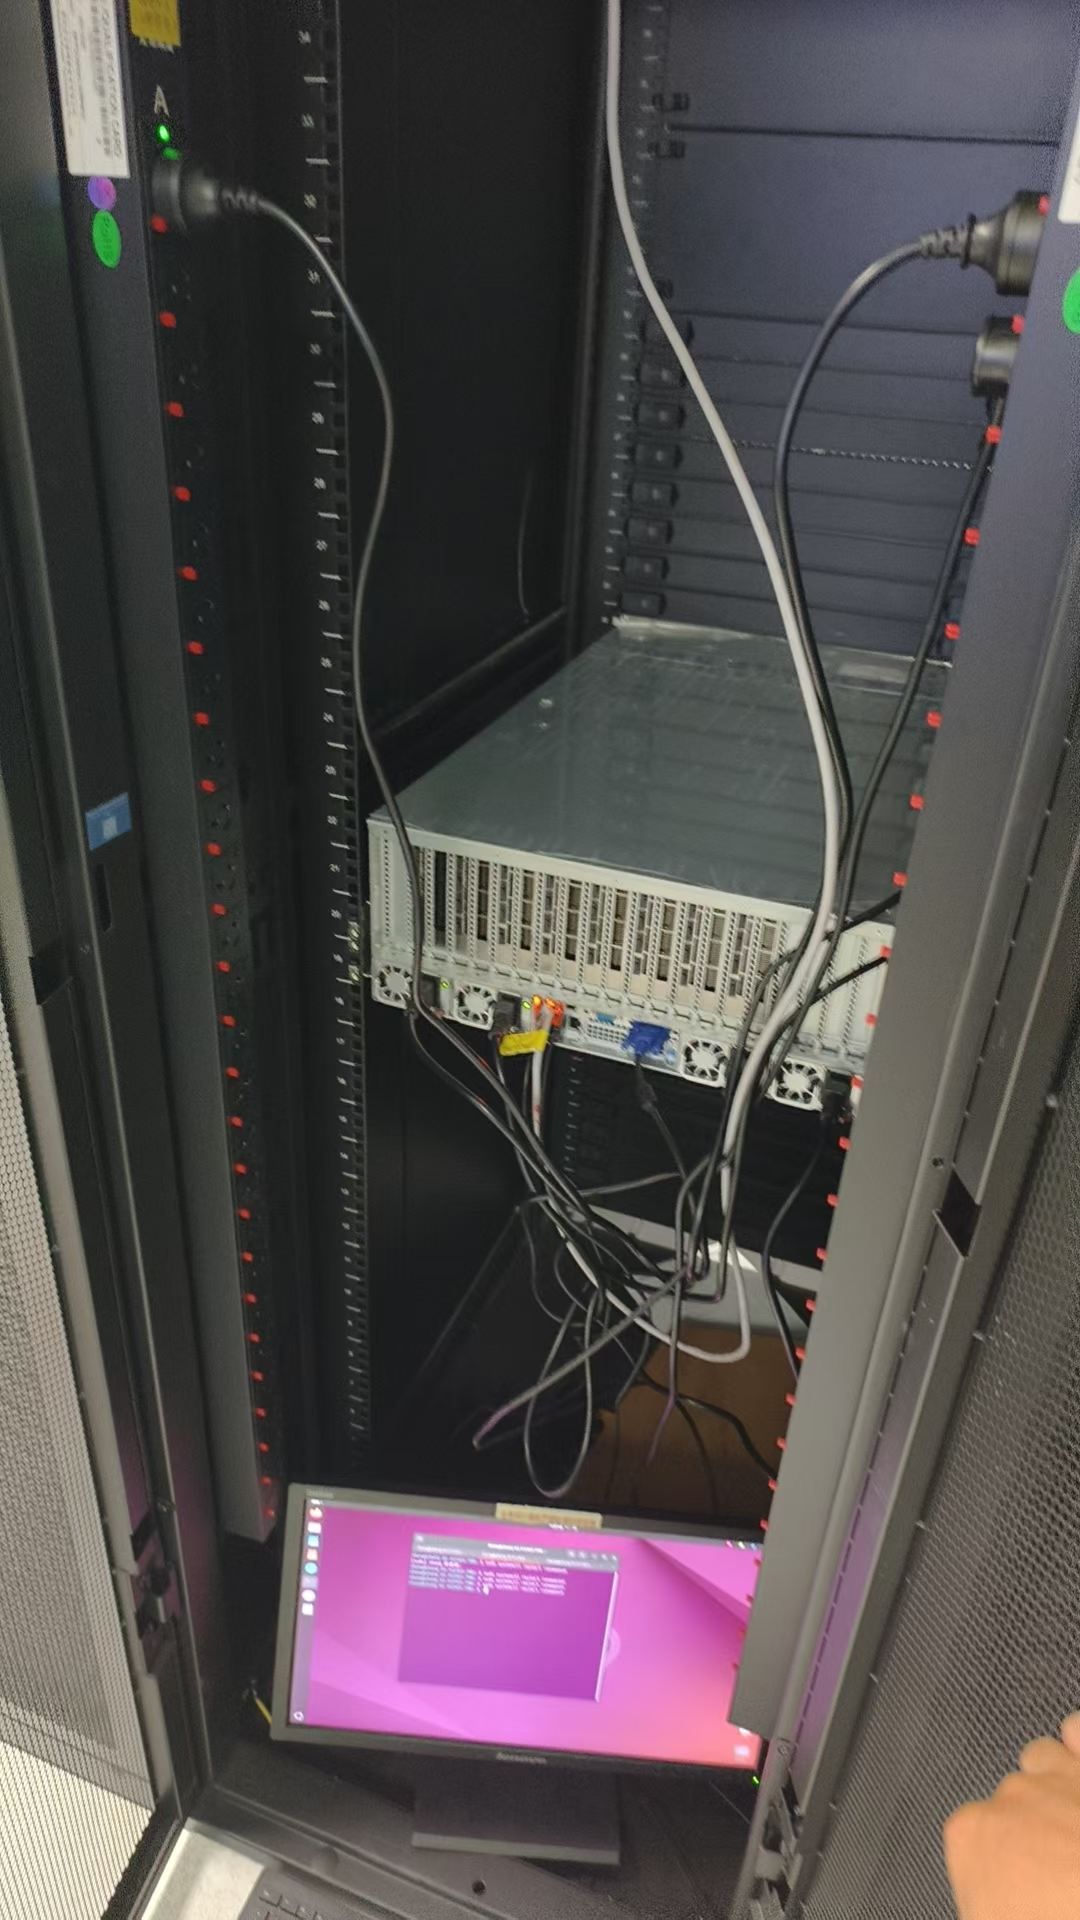
先报一下家底:8 × 4090D 48G、双路 EPYC 7443、512G DDR4 内存。 还是那台机器,这次主要升级的是我的折腾方式。
一开始,我用 SGLang,以 TP1 跑 Qwen3.8 27B。
能跑,速度也还可以。但用着用着,总觉得哪里不对:显卡在忙,512G 主机内存却基本没在核心推理链路里发挥价值。花钱买了半个 T 的内存,结果请回来一群观众。
当时的我:八张卡,豪华配置。
实际的我:模型启动了,部署结束了。
后来试了 Strata,终于看到了让显存和主机内存一起发挥作用的路子。但我的目标是多个人同时使用 Agent,单人聊得飞快只是第一关。按最初的部署方式,多卡怎么分配请求、会话怎么复用缓存、工具调用回来找谁、长短任务怎么安排,都得继续解决。
至少在我当时测试的版本和部署方式下,Strata 直接拿来承担整台多卡服务器的并发服务,还没达到我想要的效果。
所以,我围绕 Strata 又补了一层调度和资源管理,最后留下了现在这套方案:
七个独立单卡实例 + 每卡两个原生生成槽 + 会话固定路由 + NUMA 本地模型共享 + RAM 会话缓存。
这串名词看着长,拆开其实很直白。
-
七张卡负责主模型,第八张卡负责 OCR 和语音转写。
GPU0–6 各跑一个独立 Strata 实例,当前使用 Strata 0.1.45,模型换成了 Qwen3.8-Flash-Next 的 ISTA-DASLab GSQ-RCO IQ3_S 版本。第八张卡承担文档识别和语音转写,给 Agent 配齐输入能力。 -
先把空闲卡用起来,再开同卡第二路。
新会话优先分配到完全空闲的卡,七张卡都有任务之后,再使用每卡的第二个生成槽。全机最多 14 路同时生成,满了就排队。单路保留 MTP 推测解码,同卡双路使用原生 batch-MTP 路径。 -
同一段对话认准原来的卡。
一段对话固定交给同一个实例,调用工具、拿回结果、继续回答,都尽量沿用已有状态。少折腾一次上下文,就少交一次重复读取的时间税。当然,这也有取舍:原卡两槽都忙时,老会话会等原卡。 -
512G 内存正式上岗,而且按 NUMA 分工。
两个 NUMA 节点各保留一份本地只读模型副本,同一节点内的实例共享模型文件页。CPU 核心、显卡和私有内存也按节点安排,减少跨节点访问。两份模型相关锁页合计约 161.84 GiB,验收时两边都达到了 100% 本地页。 -
聊过的长对话,给它留个位置。
主机内存还用于会话状态停放和恢复。每个实例最多配置 8 个缓存槽,按实例分配 24/32 GiB 预算,全机预算合计 192 GiB,按需使用。这里的“缓存槽”是保存会话的地方,同时生成仍然是每卡两路,实际能保留多少历史也受长度和内存预算限制。
以前 512G 内存在旁边看热闹,现在它负责共享模型、接住会话状态、减少重复读取,终于成了这套架构里的主力。
这也是这轮折腾最让我爽的地方:同一台机器,终于开始像一台完整的推理服务器了。
数字也摆出来,光说爽没意思。
| 测试场景 | 实测表现 |
|---|---|
| 单卡单路部分任务 | 跑到约 180 token/s |
| 七卡、每卡双路,14 路短输入生成 | 每路速度中位数 83.60 token/s |
| 上述并发测试记录的总吞吐 | 约 1102.54 token/s |
| 14 路短输入正文首字延迟 | P50 0.64 秒,P95 0.67 秒 |
| 14 路、各约 20K 历史的缓存续问 | 每路速度中位数 80.73 token/s |
| 上述 20K 历史续问的正文首字延迟 | P50 1.27 秒,P95 1.79 秒 |
双并发的“80 t/s”,说的是同一张卡上两路各自约 80 t/s。
缓存也有具体记录:在这组 14 路约 20K 历史的连续追问测试里,按“已缓存输入 token / 总输入 token”计算,输入前缀复用比例约 99.77%。对 Agent 来说,能把前面读过的东西接着用,体验提升很实在。
口径顺手说清:180 t/s 是部分任务跑到过的成绩,单路速度会随任务波动;表里的并发性能测试关闭了思考,短输入每路输出 2048 token。99.77% 是这组连续追问的前缀复用比例,不能当成所有用户、所有请求的长期命中率。长文首次读取仍需要时间,也没有拿 14 路满 256K 同时生成来套这张表。
能晒出来的成绩,测了什么就说什么,这样吹起来才踏实。
再说我自己最在意的一点:脑子好不好使。
我现在用的是 Qwen3.8-Flash-Next IQ3_S,与之前的 Qwen3.8 27B 已经是不同模型,不能只盯着 IQ3_S、FP8、INT4 这几个量化名字比较。
就我自己的日常任务实测而言,这个 IQ3_S 版本的理解和完成任务能力,整体强于我之前部署的 Qwen3.8 27B FP8 和 AWQ INT4。
这句话是我的使用结论,任务范围就是我平时拿它干的那些活。尤其是指令遵循、工具调用、拿到工具结果后继续往下做,整体效果让我比较满意。
我用的是 Agent。模型会不会按要求做事,能不能把工具用明白,前后几轮能不能接得住,比单纯把字吐得快更影响体验。
所以这次让我愿意长期用下去的,是几件事终于凑到了一起:
- 单人用起来快;
- 多人同时用也有可用的速度;
- 长对话能复用状态,续问不用总从头读;
- 指令遵循和工具调用够实用;
- GPU、CPU、512G 内存终于都有明确分工。
当然,Strata、模型量化和推测解码这些核心能力,功劳属于上游作者。我做的是在自己的硬件上反复测试,把调度、内存、会话和 Agent 使用流程组合起来,调到适合自己的业务。
菜鸡没发明发动机,但这回总算把车装得像样了一点。
之前老特说我部署能力堪忧,我认。闭关这段时间也算没白折腾。
现在回来交作业:还是那八张 4090D,单路能跑到 180 t/s,同卡双路各约 80 t/s,512G 内存终于从观众席走上了赛场。
允许我先叉会儿腰。大佬们继续挑毛病,我继续改。