跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场
  1. 主页
  2. 版块
  3. AI硬件
  4. 装备秀
  5. 秀一下我的装备,某保密机关ai本地主机

秀一下我的装备,某保密机关ai本地主机

已定时 已固定 已锁定 已移动 装备秀
rtx4090sg-lang多卡部署
11 帖子 7 发布者 323 浏览
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • 胡适之胡
    胡适之胡
    胡适之
    编写于 最后由 编辑
    #1

    09edb519aa809fb299372ba77354a29f.jpg
    699d216c22e34d8dab5d521edcb42283.jpg
    6f6e681a5baf73dd213509b39e2db8ec.jpg

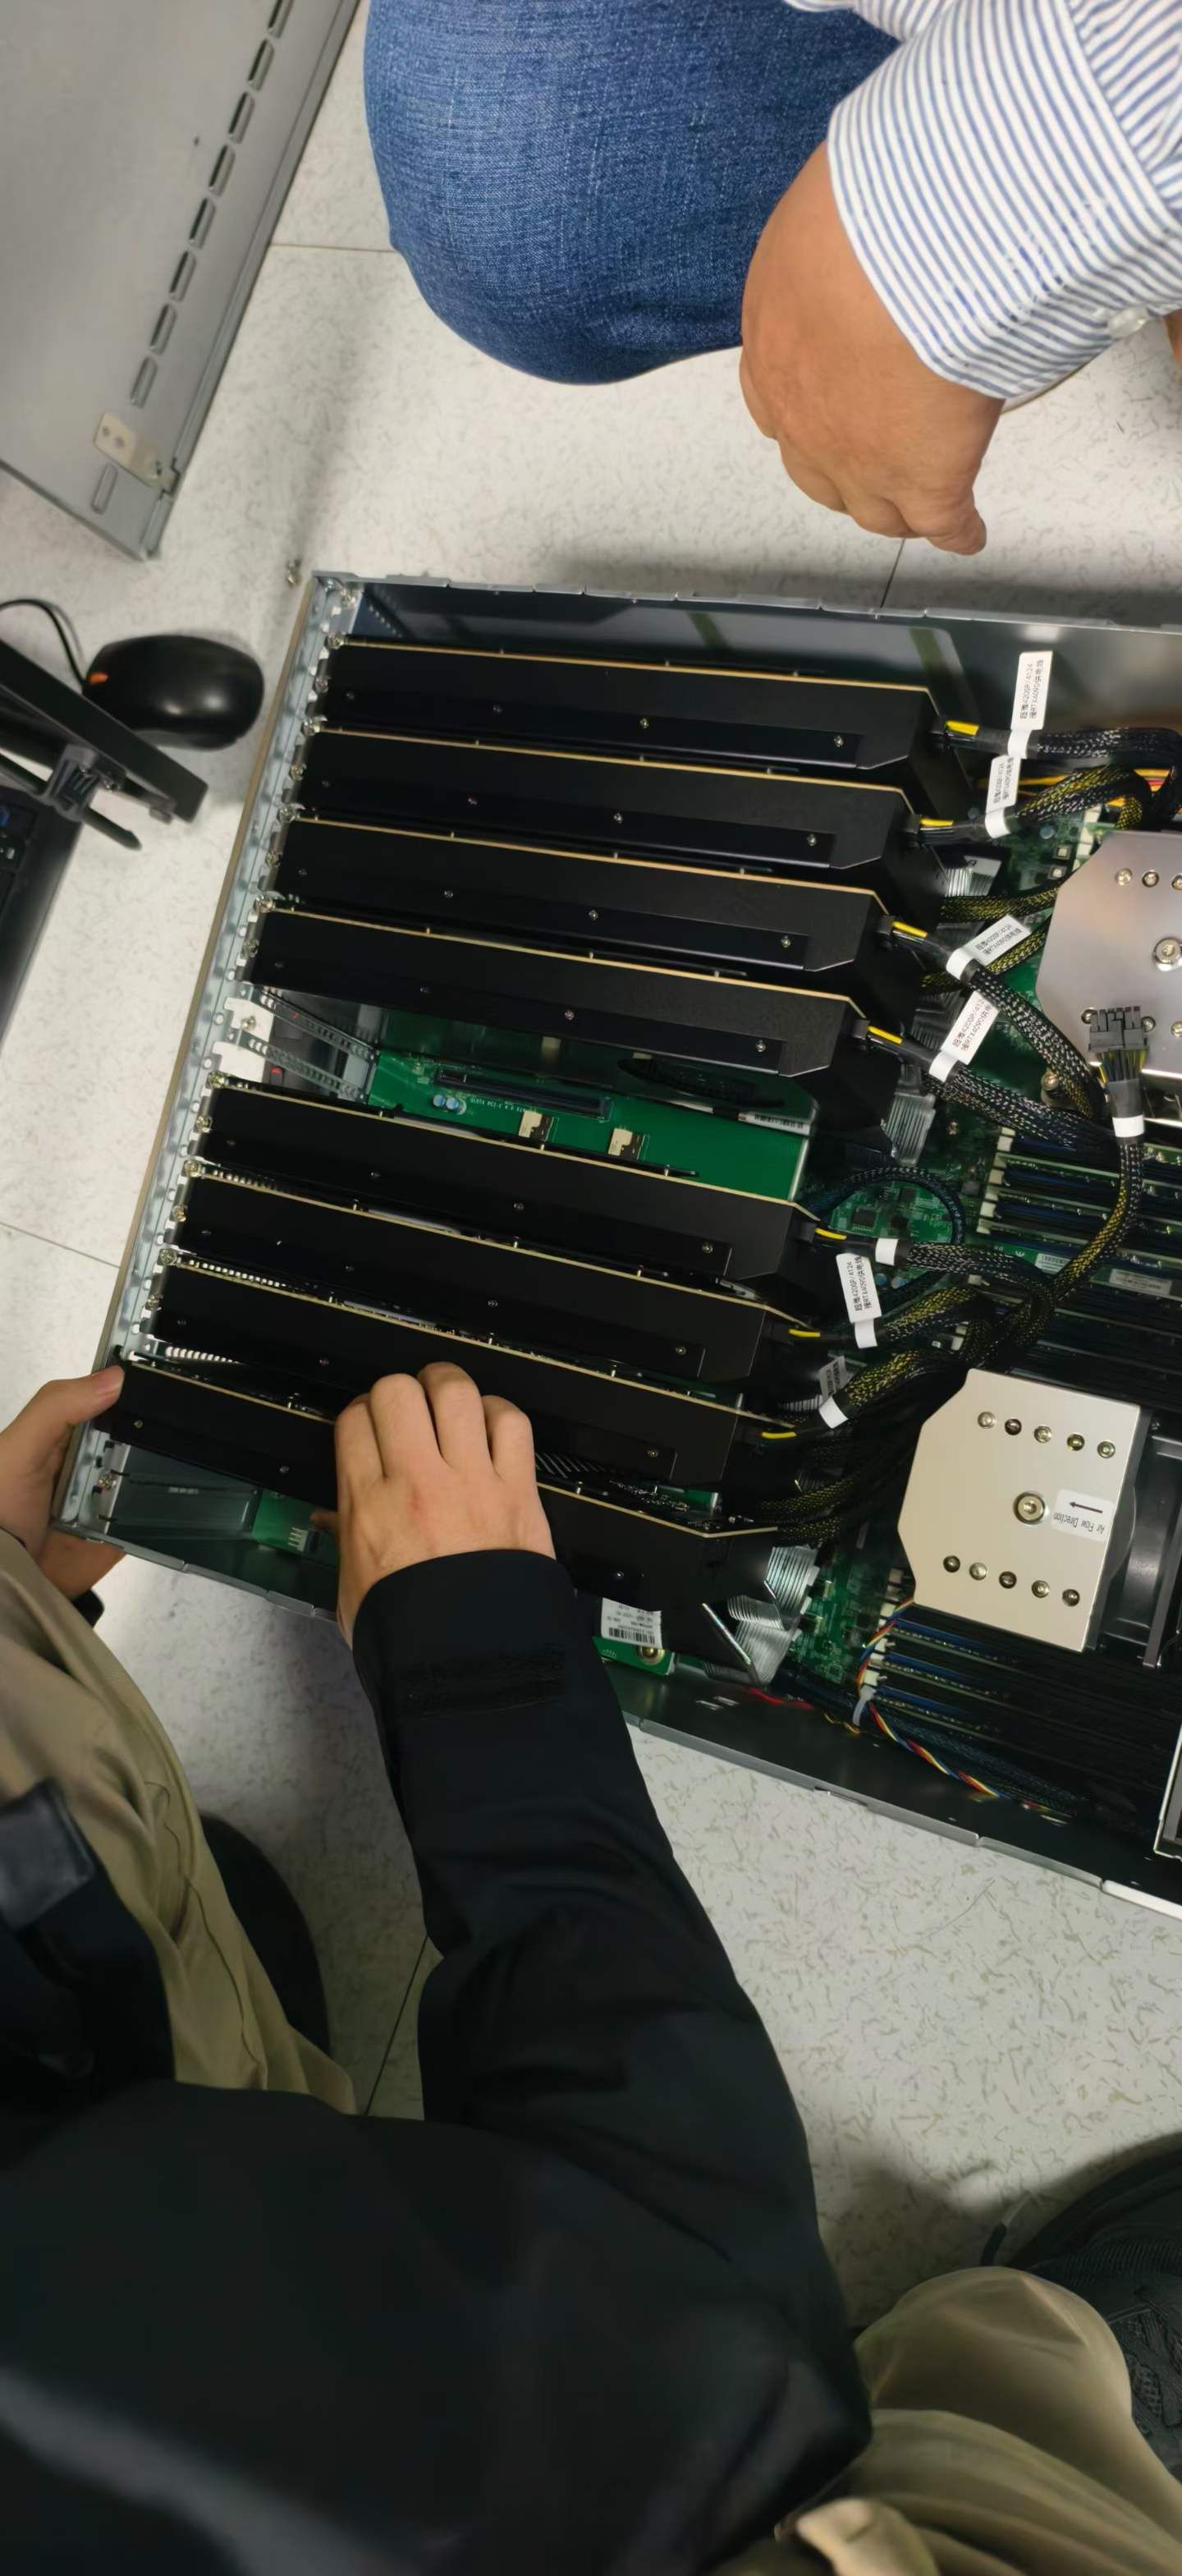
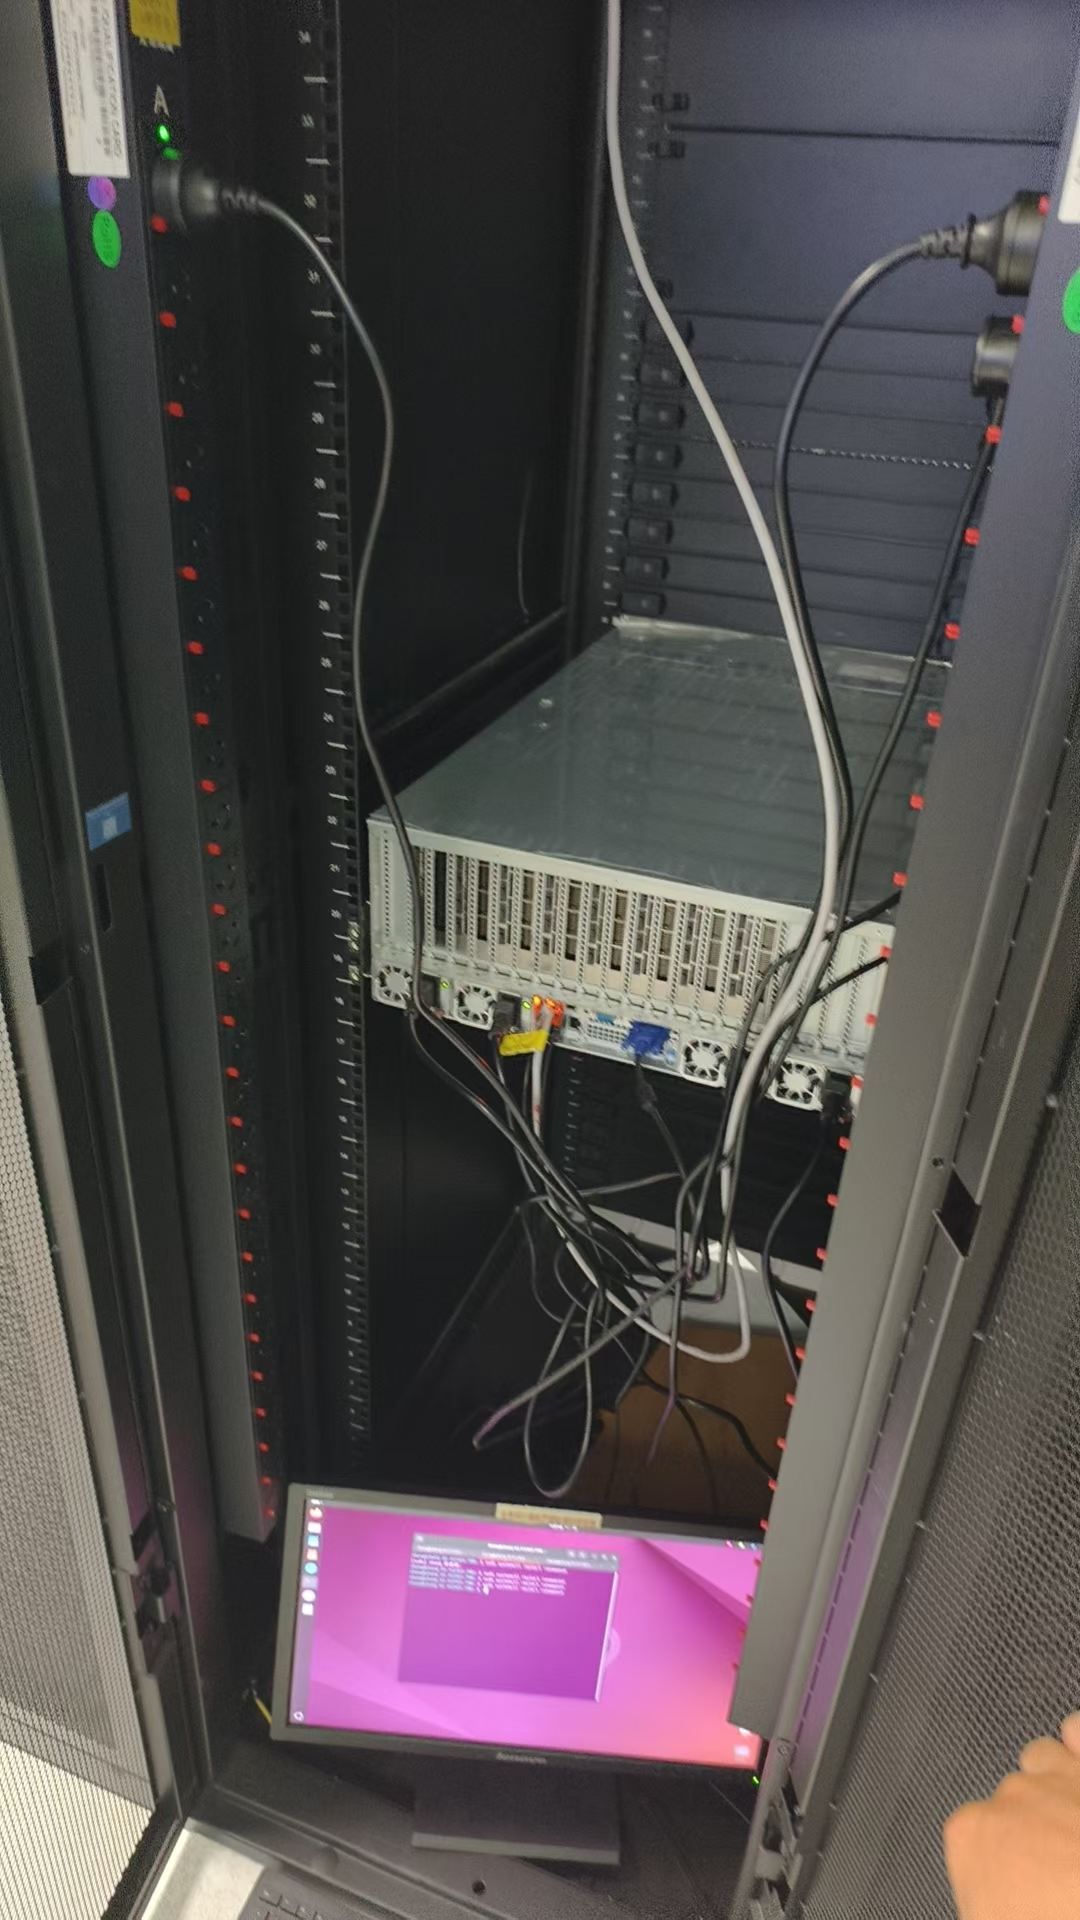
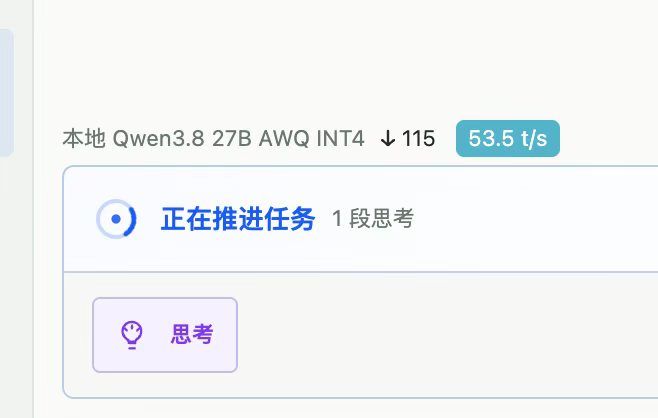
    目前没开MTP,单人只能跑到50T,tp1多人并发部署,用的SGlang,上下文128K,最大输出32K,KV缓存16没改8,锤友们也提提建议,如何能提高并发,我把4090的单卡功耗卡在350了,我想他们寿命长一些。

    1 条回复 最后回复
    1
    • terryT
      terryT
      terry
      超级版主
      编写于 最后由 编辑
      #2

      啊,你这个配置跑这个数据简直是受罪,认真优化下啊我哥,8张4090 48G,这得多土豪的装备。显卡特写下。

      油管:https://www.youtube.com/@抡锤者

      胡适之胡 1 条回复 最后回复
      1
      • kos orK
        kos orK
        kos or
        超凡大师
        编写于 最后由 kos or 编辑
        #3

        4090 48G 都被你買光了~~~難怪缺貨 (誇飾法)

        用AI助理有個矛盾
        AI太厲害,老闆會感覺不需要這麼多員工了,
        從員工的角度AI工具介於好用與不好用的中間可能是最佳配置?

        1 条回复 最后回复
        0
        • terryT terry

          啊,你这个配置跑这个数据简直是受罪,认真优化下啊我哥,8张4090 48G,这得多土豪的装备。显卡特写下。

          胡适之胡
          胡适之胡
          胡适之
          编写于 最后由 编辑
          #4

          @terry 说:

          啊,你这个配置跑这个数据简直是受罪,认真优化下啊我哥,8张4090 48G,这得多土豪的装备。显卡特写下。

          咋优化哦,开个MTP? 我是单张卡跑 TP1兄弟 不是8张跑一个副本

          terryT 1 条回复 最后回复
          0
          • 胡适之胡 胡适之

            @terry 说:

            啊,你这个配置跑这个数据简直是受罪,认真优化下啊我哥,8张4090 48G,这得多土豪的装备。显卡特写下。

            咋优化哦,开个MTP? 我是单张卡跑 TP1兄弟 不是8张跑一个副本

            terryT
            terryT
            terry
            超级版主
            编写于 最后由 编辑
            #5

            @胡适之 你单卡48G跑Dflash2 SGLang,速度也会快得多。

            油管:https://www.youtube.com/@抡锤者

            1 条回复 最后回复
            0
            • N
              N
              neo
              德高望重 劳动模范
              编写于 最后由 编辑
              #6

              如果想提高并发数,可以把:
              1、mamba-ssm-dtype改为bfloat16,
              2、speculative-draft-kv-cache-dtype改为fp8_e4m3,
              这应该是最直接和收益最大的方式了

              1 条回复 最后回复
              1
              • matrix 0M
                matrix 0M
                matrix 0
                编写于 最后由 编辑
                #7

                这是土豪啊 有钱啊

                1 条回复 最后回复
                0
                • kop wangK
                  kop wangK
                  kop wang
                  超级版主
                  编写于 最后由 编辑
                  #8

                  4090 48G?,这东西开的出发票来吗?

                  玩笑归玩笑。
                  现在你们打算计划多少并发?因为sglang有个memba池和kvcache池均衡换算的问题。
                  kvcache肯定是要8bit的。

                  具体的配置方案可以参考sglang官方的cookbook:https://lmsysorg.mintlify.app/cookbook/autoregressive/Qwen/Qwen3.8-27B#hw=h200&variant=default&quant=fp8&nodes=single&spec=none&tier=low-latency&ssmDtype=float32

                  虚心交流,一起进步

                  1 条回复 最后回复
                  0
                  • BunseiB
                    BunseiB
                    Bunsei
                    技术大牛 劳动模范
                    编写于 最后由 Bunsei 编辑
                    #9

                    1、可以参考一下这个: https://duanyll.com/2026/7/13/4090-48G-P2P/ 处理好后可以尝试一下TP。
                    2、 https://hudeqi.github.io/ai-learning-blog/10-vllm-scheduler.html 参见这个文章让gpt给你写一个靠谱点的调度器脚本,来平衡并发的吞吐量(主要是平衡预填充速度,最好增加额外的优先级进行加权调度策略)。
                    3、你这个配置适合使用Qwen3.8-Flash-Next or DSV4.1,性能更好吞吐量更大。
                    4、让AI协助你,进行KV缓存的量化测试,单独尝试BF16K-INT8V之类的设置,尝试在不影响实际推理效果的前提下提高并发or上下文的长度。
                    5、测试投机解码或者DFlash2技术对解码速度的影响。
                    6、实际使用的时候不要让vllm推理服务直接暴露给客户端,最好再搭建网关or反代。

                    不过2、3、4都是建立在1的基础上的XD...😂, 这一套流程下来十几二十路长程代理任务是没问题的。

                    1 条回复 最后回复
                    0
                    • 胡适之胡
                      胡适之胡
                      胡适之
                      编写于 最后由 编辑
                      #10
                      此主題已被删除!
                      1 条回复 最后回复
                      0
                      • 胡适之胡
                        胡适之胡
                        胡适之
                        编写于 最后由 编辑
                        #11

                        看到最新一期的老特说,老师说我眼泪掉下来,全程用CODEX部署,兄弟们说的多卡方案,包括deepseek等我都理解,但是目前我只能跑单卡,因为并发非常高,可能超过20个并发,而且是多人办公场景,不是一般问答, 所以智能TP1走单卡推理跑7副本的27B和一张卡单独OCR跑的paddle 1.6vl(ocr需求很大所以单独一张卡)一下是当前我的配置参数,希望有大神能指点一下:
                        以下是 2026-10-10 最后部署、读回并保存的配置。当前离开服务器局域网,没有重新连接服务器;以下不是实时状态。连接地址、账户、API 密钥和 GPU UUID 均已省略。

                        硬件与软件

                        • Ubuntu 24.04.3,NVIDIA 驱动 580.178.04。
                        • 双路 AMD EPYC 7443,合计 96 逻辑 CPU;安装内存约 512GB。
                        • 8 × RTX 4090D 48GB 改装卡;每卡 nvidia-smi 显存总量 49140 MiB,requested/enforced 功耗上限均为 350W。
                        • Docker Linux amd64 部署,每个 LLM 容器只绑定一张物理卡,shm_size=8gb。七份独立模型副本,TP=1;不是七卡 TP=7。
                        • SGLang 0.5.21,固定源码 commit:e00930c5489053f26d86b179cee0d087f846acbb,固定镜像 CUDA 13.0.3。
                        • 上游镜像标识 lmsysorg/sglang:v0.5.21;实际固定来源为 docker.io/lmsysorg/sglang@sha256:b1259f3ea3275f66237c498ea388919729018bc9f01c3d638391e06e2cf3f469。本地加载标签为 llm-inference/sglang:prepared-20261003。
                        • 模型:cyankiwi/Qwen3.8-27B-AWQ-INT4;revision:6e134bae811fb5adac50ee042ae5f029ac6779aa。
                        • checkpoint 实际为 compressed-tensors / pack-quantized,W4A16、INT4 权重、group size 32、非对称量化;运行 dtype=BF16。不能仅根据 AWQ 仓库名把加载参数改写成 awq 或 awq_marlin。
                        • checkpoint 自带一层原生 MTP;draft 路径与主模型相同。相关 MTP 线性权重在 INT4 量化的 ignore 清单中,不能描述为全模型 INT4 或全模型 BF16。

                        卡片分配与关键差异

                        GPU0–5 是六个普通 128K 副本,通过网关分配请求。GPU6 是独立的 256K 服务,只有获管理员授权并在当前对话打开 256K 的账户使用;不加入普通网关轮询。GPU7 独立运行 OCR,不参与 LLM 的 TP 或 MTP。

                        参数 普通 GPU0–5 长上下文 GPU6
                        tensor-parallel-size 1 1
                        context-length 131072 262144
                        SGLANG_MAX_NEW_TOKENS_LIMIT 32768 65536
                        max-running-requests 4 1
                        max-total-tokens:配置目标 262144 262144
                        实际 KV token pool:代表卡运行读回 GPU0:186700 262144
                        mem-fraction-static 0.88 0.93
                        cuda-graph-max-bs-decode 4 1
                        max-mamba-cache-size 20 6
                        代表卡实际 KV 池显存 GPU0:11.395 GiB 16.000 GiB
                        代表卡短题期间常驻显存 GPU0:40631 MiB 42225 MiB

                        上下文是输入、思考和最终回答的合计预算。32K/64K 是最大输出预算,包含思考,并不保证每次都输出这么多。普通卡的 4 个运行槽位不代表能同时容纳 4 个完整 128K 请求;配置 max-total-tokens=262144 也不能替代实际分配的 token pool 数值。

                        普通 128K 实例实际启动参数

                        每个普通容器分别运行以下命令。LLM_API_KEY 为私有环境变量,这里没有给出其值。

                        export SGLANG_MAX_NEW_TOKENS_LIMIT=32768
                        
                        python3 -m sglang.launch_server \
                          --model-path /models/Qwen3.8-27B-AWQ-INT4 \
                          --served-model-name Qwen3.8-27B-AWQ-INT4 \
                          --host 0.0.0.0 --port 30000 \
                          --tensor-parallel-size 1 \
                          --dtype bfloat16 \
                          --kv-cache-dtype auto \
                          --context-length 131072 \
                          --max-running-requests 4 \
                          --max-total-tokens 262144 \
                          --mem-fraction-static 0.88 \
                          --chunked-prefill-size 2048 \
                          --prefill-decode-interval 1 \
                          --cuda-graph-max-bs-decode 4 \
                          --max-mamba-cache-size 20 \
                          --mamba-ssm-dtype float32 \
                          --attention-backend triton \
                          --quantization compressed-tensors \
                          --reasoning-parser qwen3 \
                          --tool-call-parser qwen3_coder \
                          --log-level warning \
                          --api-key "$LLM_API_KEY" \
                          --enable-metrics \
                          --speculative-algorithm EAGLE \
                          --speculative-draft-model-path /models/Qwen3.8-27B-AWQ-INT4 \
                          --speculative-num-steps 1 \
                          --speculative-eagle-topk 1 \
                          --speculative-num-draft-tokens 2 \
                          --speculative-draft-attention-backend triton \
                          --mamba-radix-cache-strategy extra_buffer
                        

                        其他容器环境:HF_HUB_OFFLINE=1、TRANSFORMERS_OFFLINE=1、HF_HOME=/cache/huggingface、OMP_NUM_THREADS=2、TOKENIZERS_PARALLELISM=false。模型目录只读挂载,各容器有独立缓存目录。

                        GPU6 的 256K 实例

                        与上面的普通启动参数相同,只有下面六项变化;其余参数,包括 served model name、主/draft 路径、精度和 MTP 参数都保持相同。该实例在独立容器中运行,不与普通实例占用同一卡。

                        SGLANG_MAX_NEW_TOKENS_LIMIT=65536
                        --context-length 262144
                        --max-running-requests 1
                        --mem-fraction-static 0.93
                        --cuda-graph-max-bs-decode 1
                        --max-mamba-cache-size 6
                        

                        两类服务 kv-cache-dtype=auto 实际采用 BF16,Mamba SSM 状态为 float32,没有使用 FP8 KV。CUDA graph 没有禁用(运行读回 disable_cuda_graph=false);LLM 未启用 mixed-chunk。GPU6 保存的 CUDA graph 分配记录包含 target verify 0.105GiB、draft extend 0.002GiB;1 step 下 draft decode 记录为 0。分配记录不能证明每一步都成功 replay,也不能把 draft decode=0 单独当成未启用 CUDA graph 的证据。

                        第八卡 OCR,仅供了解是否有资源干扰

                        GPU7 使用 SGLang 运行 PaddleOCR-VL-1.6-0.9B,TP1、BF16、context=16384、max-running-requests=32、max-queued-requests=128、max-total-tokens=524288、mem-fraction-static=0.68、chunked-prefill-size=8192、max-prefill-tokens=16384、enable-mixed-chunk、num-continuous-decode-steps=2、cuda-graph-max-bs-decode=32、attention-backend=triton、mm-attention-backend=triton_attn、mm-processor-worker-num=2。另有 4 个完整文档解析管线绑定同一 GPU7,文档级并发 4。OCR 没有启用本次 LLM 的 MTP。

                        测量方式与已观察现象

                        原网页用“字符数÷4”估计 token,中文速度因此明显低估。现已改为服务端真实累计 usage token 和单调时钟计量,包含思考、正文及工具参数;输出速度不包含首字等待和工具执行。不能拿旧网页的 20 多或 10 t/s 直接当作原生解码吞吐。

                        直接推理同题对照:关闭思考(reasoning_effort=none),temperature=0,max_tokens=2048,串行单请求,各卡 1 次预热后 3 次正式样本。每个请求使用不同 cache_salt,不清空缓存、不重启服务、不强制忽略 EOS。所有请求实际输入 118 tokens、输出 450 tokens,均正常 stop。

                        直接推理正式样本中位数 GPU0:128K GPU6:256K
                        首末真实累计 token 增量/输出窗口 62.453 t/s 62.485 t/s
                        套用旧字符/4估算 27.262 t/s 27.276 t/s
                        首段正文到达 68.9ms 71.1ms
                        同批采样最高核心温度 56℃ 60℃

                        Agent 全流程另有两条无工具、关闭思考的合成请求:普通实际输入 640/输出 428 tokens,网页 53.9 t/s;随后同一会话开启 256K,实际输入 1185/输出 467 tokens,网页 54.7 t/s。它们有不同输入和历史,不能当成严格同输入性能比较。服务端首段等待分别约 0.098 秒和 14.005 秒;这次 256K 的长等待尚未归因,不能据输出阶段吞吐宣称首字已经解决,也不能从单样本断言是 MTP 或 256K 参数导致。

                        此前独立 GPU0-MTP / GPU1-无MTP 对照,三种短题、每种 3 次正式样本、1024 token 上限:无 MTP 约 51 t/s,MTP 约 67–71 t/s,提升约 31%–40%;首个原始模型 chunk 增加约 7–12ms。该旧对照输出以 length 截断,不能证明完整回答质量相同,也不能替代长上下文性能结论。

                        用户体感:较强思考时正文首字等待更长。实际 Agent 请求可能带有系统提示、工具定义和工具返回,“空聊天窗口”不等于模型实际输入为空。曾观察到真实 Agent 输入 10894–19117 tokens;没有导出真实用户问答。

                        希望请教

                        1. 对这个 compressed-tensors 非对称 W4A16 模型和改装 4090D 48GB,当前 Triton 后端、MTP 和缓存参数是否有可验证的优化空间?
                        2. 保持 128K/32K、256K/64K、350W 上限,以及目前 KV/SSM 精度时,哪些设置值得优先做单变量对照?
                        3. 如何进一步区分上述 256K Agent 首段约 14 秒是队列、预填充、编译/缓存还是应用侧等待?应追加采集哪些日志或指标?
                        4. 怎样进一步确认原生 MTP 接受率和 CUDA graph replay,而不把缓存容量、chunk 字符估算或思考结束时间误当成解码速度?
                        1 条回复 最后回复
                        0

                        你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                        厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                        有了你的建议,这篇帖子会更精彩哦 💗

                        注册 登录
                        回复
                        • 在新帖中回复
                        登录后回复
                        • 从旧到新
                        • 从新到旧
                        • 最多赞同


                        • 登录

                        • 登录或注册以进行搜索。
                        • 第一个帖子
                          最后一个帖子
                        0
                        • 版块
                        • 最新
                        • 标签
                        • 热门
                        • 用户
                        • 群组