7900 XTX 双卡跑 Qwen3.8-27B:vLLM vs SGLang 最终测试对比报告(基于自己的工作流)
全部数据:2026-09-18 本机实测 · 双 RX 7900 XTX + Ryzen 5 9600X + 64G DDR5 RAM
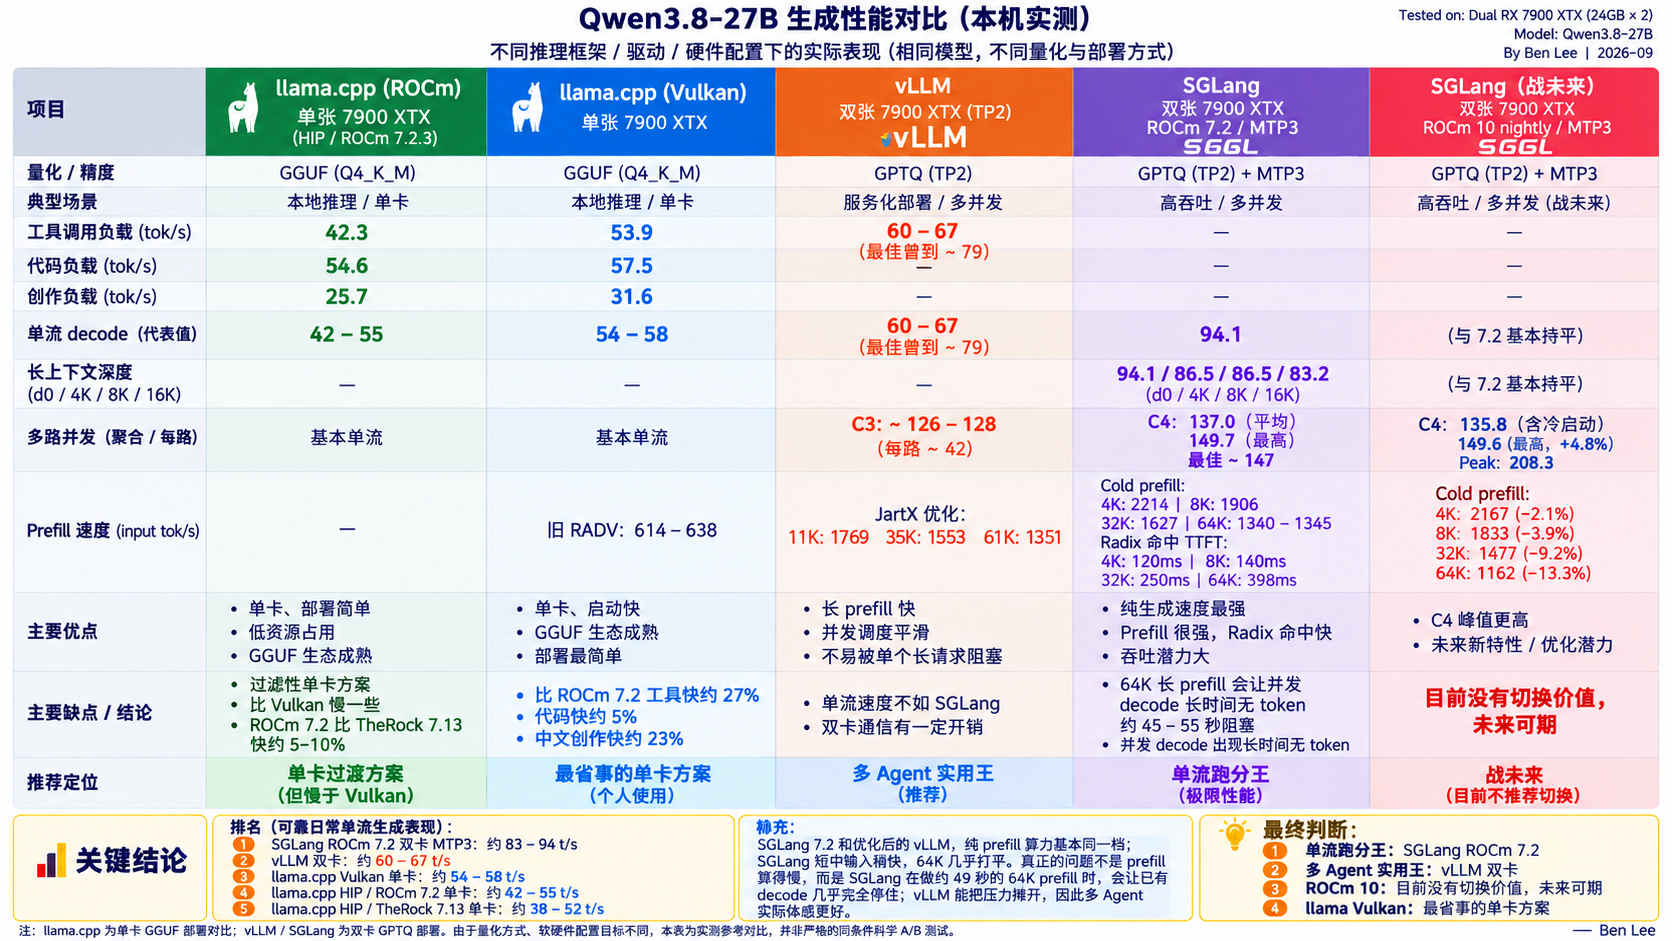
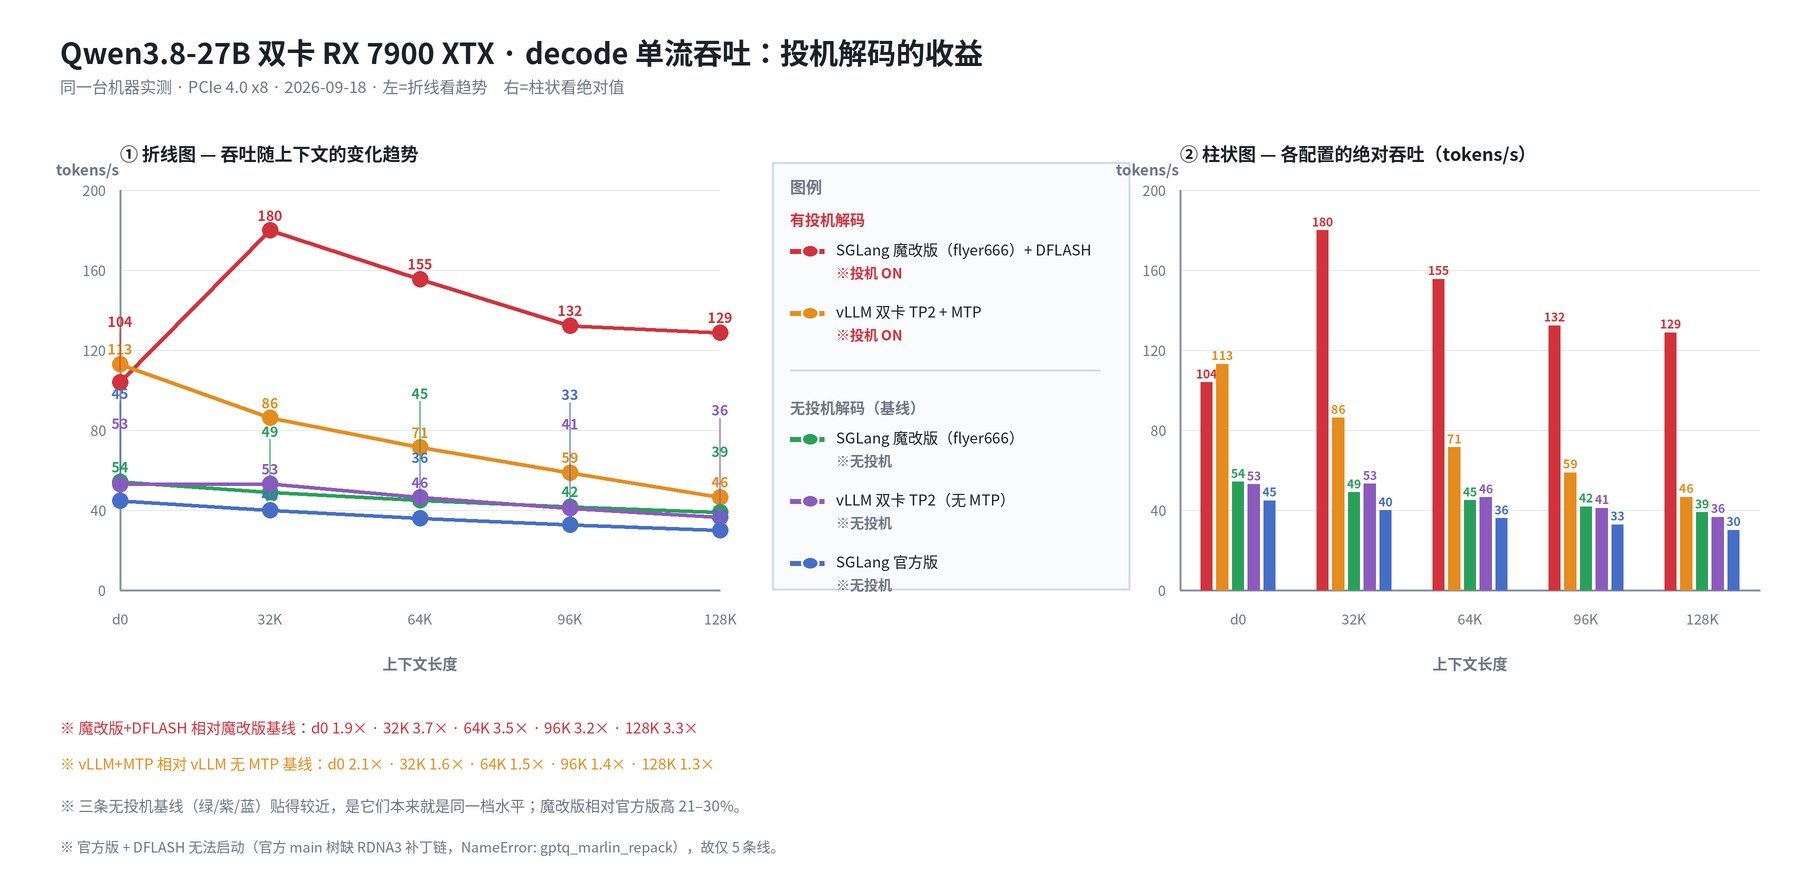
图:fig_g1_v3_white.png(主图)·fig_g1_split_white.png(左右分栏备选)
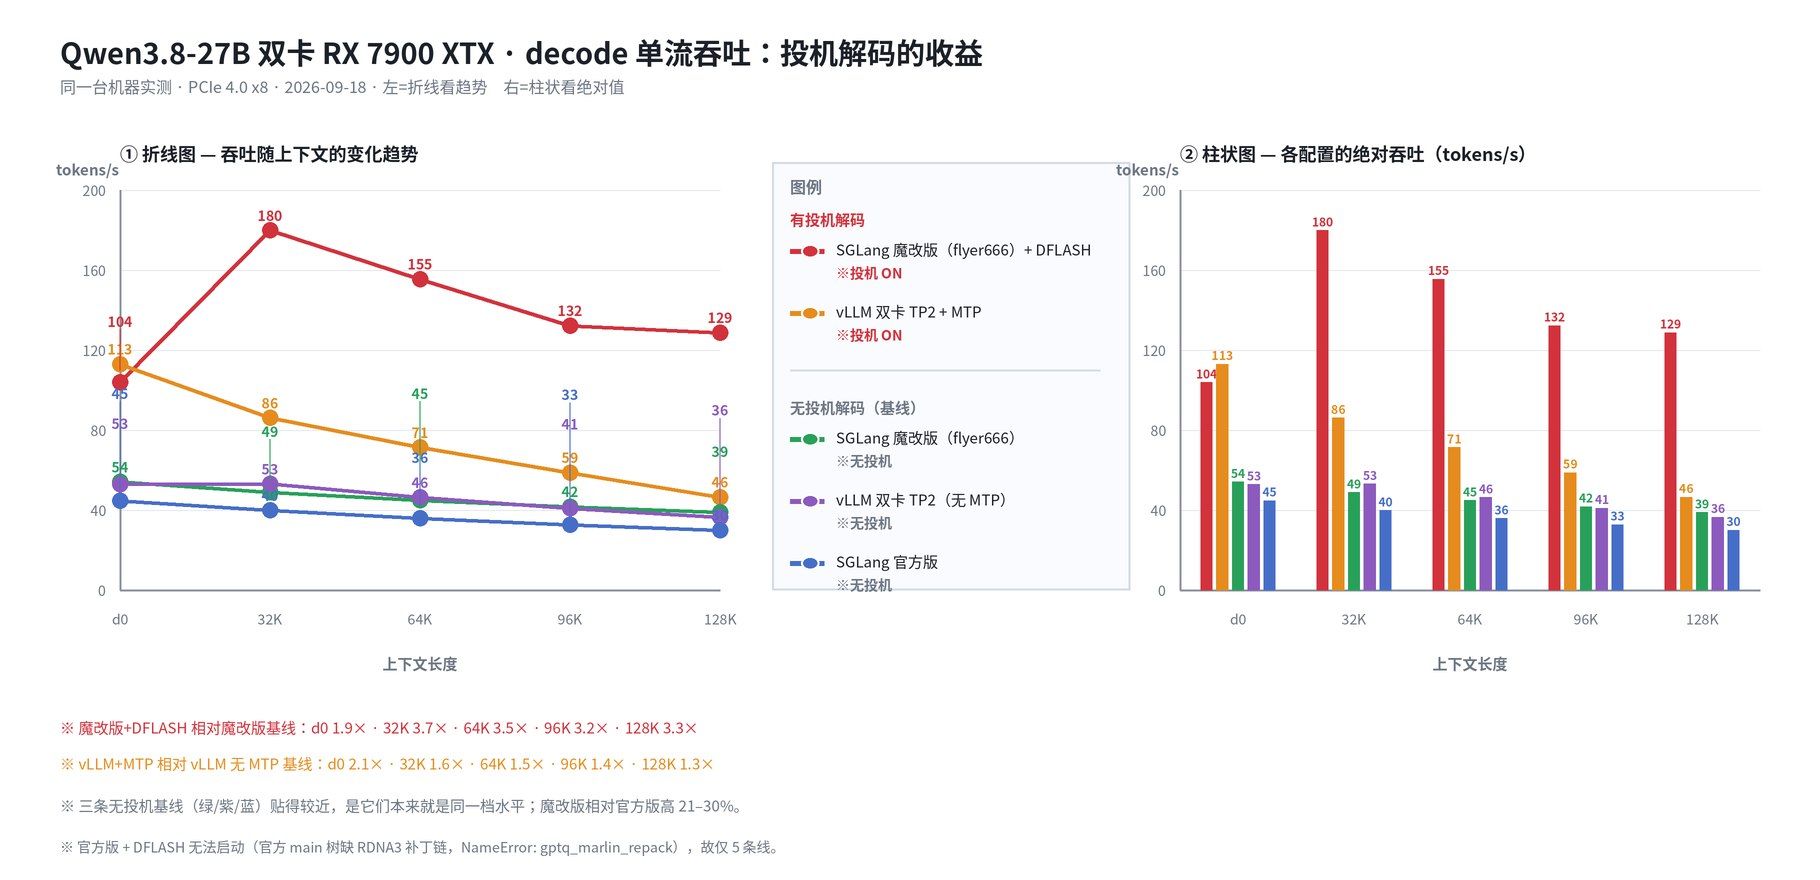
先说结论
我这台机器:双 RX 7900 XTX(24G显存 ×2)+ Ryzen 5 9600X + 64G DDR5,Ubuntu 原生,ROCm 7.2。双卡走 PCIe 4.0 x8(不是 x16,这点后面会影响结论)。
模型 Qwen3.8-27B(text architecture:64 层 / 48 linear_attention / 16 full_attention / dense,不是 MoE),SGLang 和 vLLM 用 W4A16-AutoRound-GPTQ,KV 精度各自默认(vLLM int8_per_token_head,SGLang fp16)。
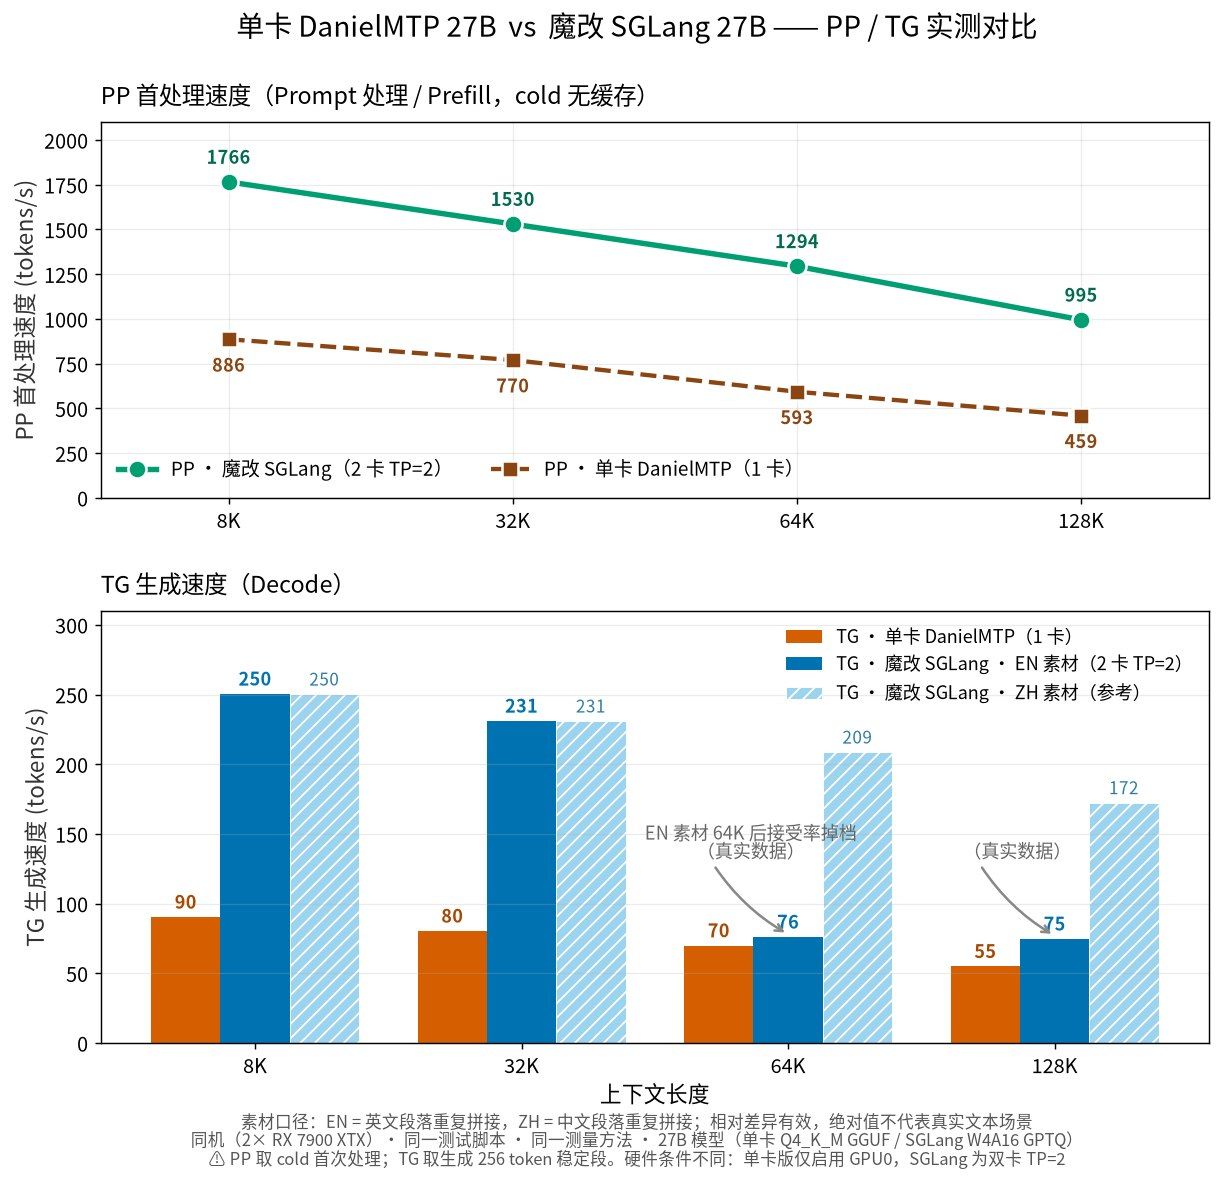
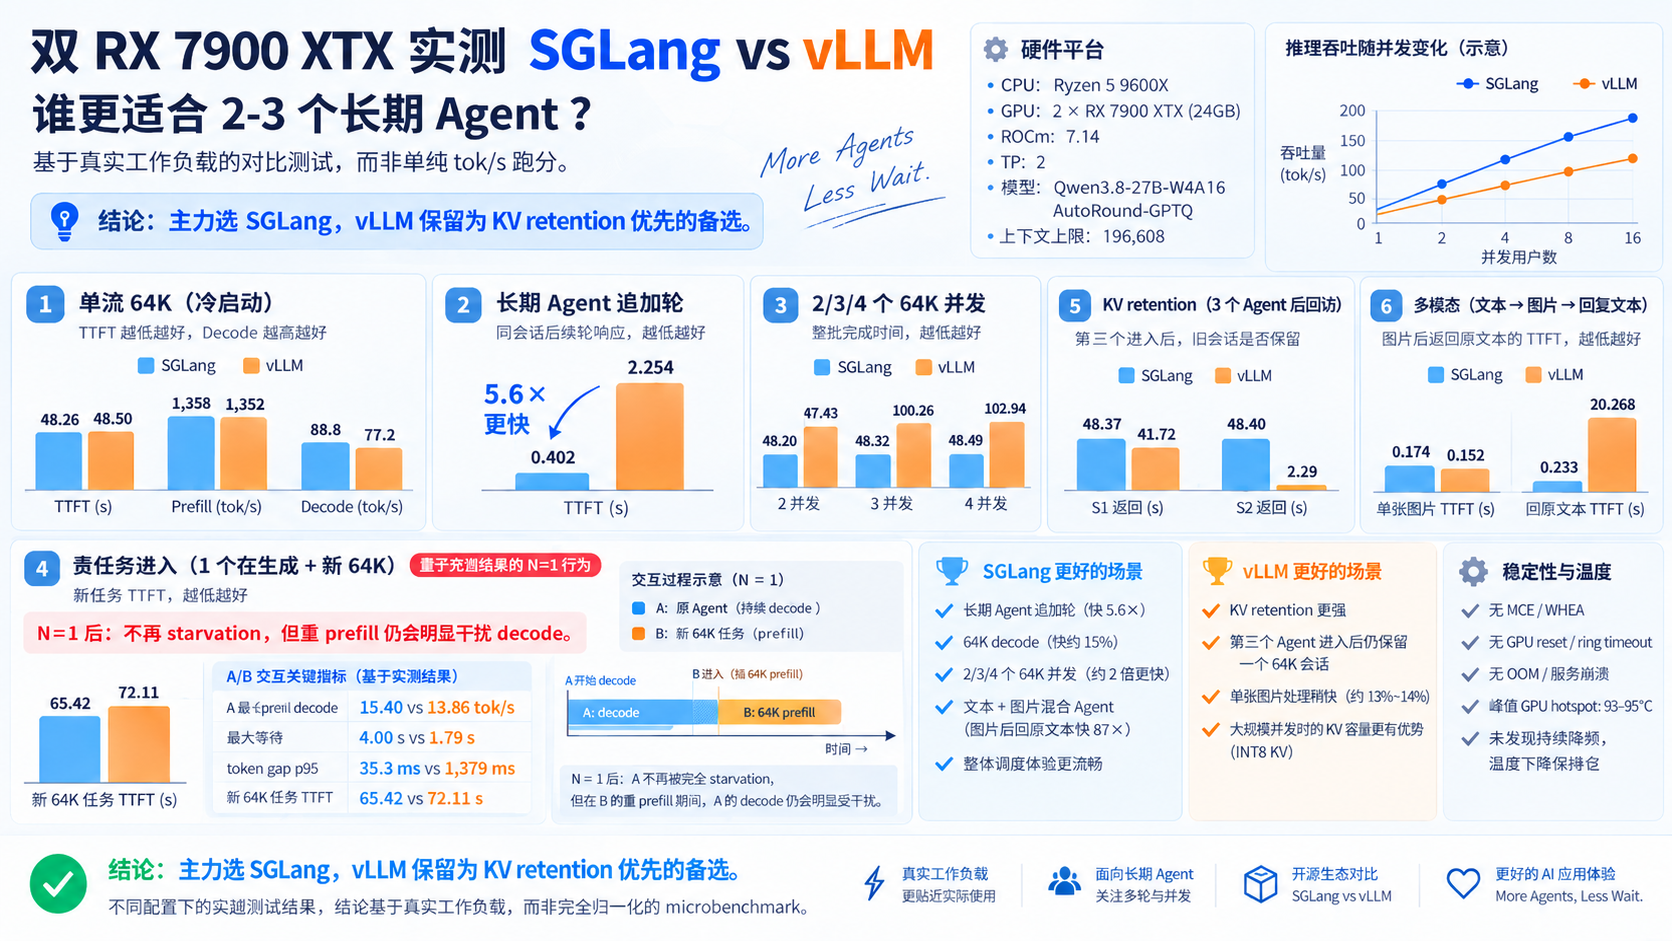
这张帖子是致敬@ flyer666 大神的魔改 SGLang,同时把自己的测试成绩分享出来供大家参考。上面的测试图里的数字很清楚,大神的魔改SGLang嘎嘎乱杀
备注:所有数字都是同一天、同一台机器、我用同一个模型实测出来的,不是从别处搬的,也不是复述别人的。另外我的测试方法跟我的个人使用方向和习惯高度定制(见3.1),不代表适用所有场景。
第一点:vLLM 和 SGLang,到底谁快
prefill(冷启动)
这一项四家几乎没有差别:
| 上下文 | vLLM | SGLang 官方 | SGLang 魔改 | SGLang + DFLASH |
|---|---|---|---|---|
| 32K | 1624 t/s (20.2s) | 1608 (19.9s) | 1575 (20.3s) | 1546 (20.7s) |
| 64K | 1354 t/s (48.4s) | 1337 (47.9s) | 1332 (48.1s) | 1317 (48.6s) |
| 96K | 1173 t/s (83.8s) | 1151 (83.4s) | 1155 (83.1s) | 1142 (84.1s) |
差异不到 3%。喂长文本这件事,两家一样快。 加投机解码也不会让 prefill 变快(反而慢 1–2%,因为 draft 模型也要占一点算力)。
decode(单流输出)
这里才是分水岭。先把「投机」和「不投机」分开看。
不投机:
| 上下文 | vLLM(无 MTP) | SGLang 魔改版 | SGLang 官方版 |
|---|---|---|---|
| d0 | 52.79 | 54.04 | 44.66 |
| 32K | 53.05 | 48.80 | 39.80 |
| 64K | 46.30 | 44.86 | 35.77 |
| 96K | 40.91 | 41.71 | 32.72 |
| 128K | 36.46 | 38.83 | 29.97 |
vLLM 裸机和 SGLang 魔改版几乎是同一个水平(53 对 54)。
这是应该的 —— 同一个模型、同样的卡、都关掉投机,瓶颈都是显存带宽读权重,谁来都跑不出花来。
差距出现在「魔改版 vs 官方版」:魔改版 d0 快 21%,32K 快 23%,64K 快 25%,96K 快 27%,128K 快 30%。越长越明显。
投机:
vLLM 用模型自带的 MTP 头:
d0 112.93 · 32K 86.08 · 64K 71.33 · 96K 58.71 · 128K 46.39
相对自己基线:2.14 倍 → 1.62 倍 → 1.54 倍 → 1.43 倍 → 1.27 倍
SGLang 魔改版用专门训练的 DFLASH draft 模型(1.2G):
d0 103.82 · 32K 179.87 · 64K 155.38 · 96K 132.19 · 128K 128.64
相对自己基线:1.92 倍 → 3.69 倍 → 3.46 倍 → 3.17 倍 → 3.31 倍
这是整张表最值得看的地方:
- vLLM 的投机收益随上下文增长而衰减(2.14 → 1.27 倍)
- DFLASH 的收益随上下文增长反而变强(1.92 → 3.31 倍)
原因不难理解:
- MTP 是模型自带的草稿头,上下文越长它的预测质量越差(实测接受长度从 3.9 掉到 1.3 附近)
- DFLASH 是专门训练的 draft 模型,长上下文下仍然保持 3.5 左右的接受长度
所以 32K 那一格:DFLASH 179.87,是 vLLM+MTP(86.08)的 2.09 倍。
128K 那一格:DFLASH 128.64,是 vLLM+MTP(46.39)的 2.77 倍。
第二点:vLLM 的三个硬伤
说 vLLM 快,是单流快。但实际用起来,有三个问题很致命。
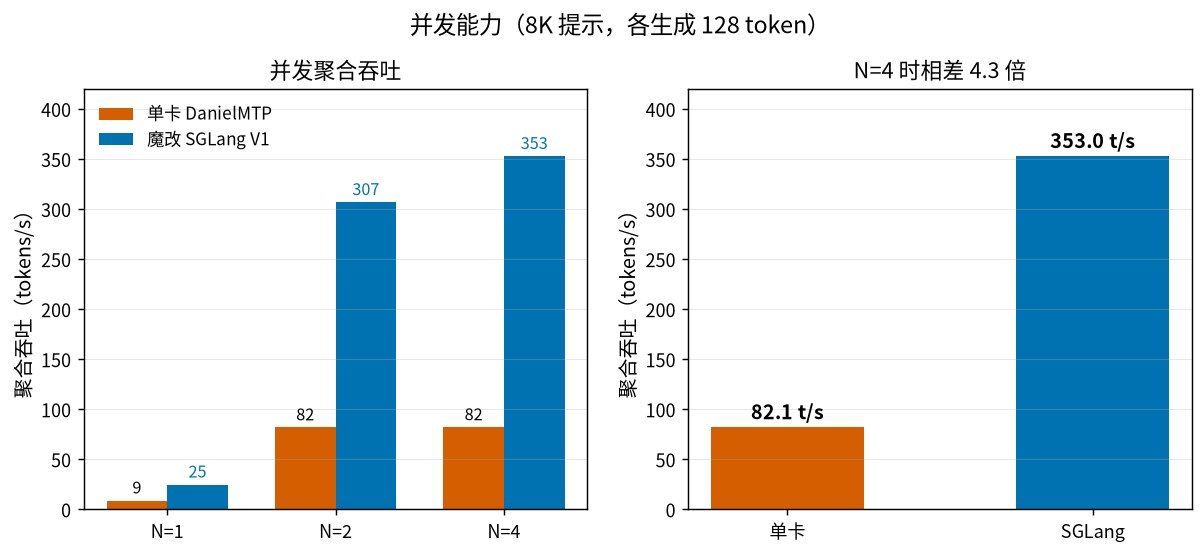
2.1、并发是串行的
96K 上下文,同时发 1 / 2 / 3 个请求,看完成时间:
| 配置 | 1 路 | 2 路 | 3 路 |
|---|---|---|---|
| vLLM | 88.63s | 190.84s | 293.90s |
| SGLang 官方 | 9.36s | 9.51s | 9.36s |
| SGLang 魔改 | 6.43s | 7.42s | 9.12s |
| SGLang + DFLASH | 3.55s | 5.51s | 6.74s |
vLLM 的 wall time 是线性翻倍的 —— 第 2 个请求的 TTFT 是 185.5s,第 3 个是 289.2s,几乎全程在等。它不是「并发」,是「排队」。
3 路 96K:vLLM 要 293.9 秒,SGLang 只要 6.74 秒。差 43 倍。
2.2、前缀缓存没有生效
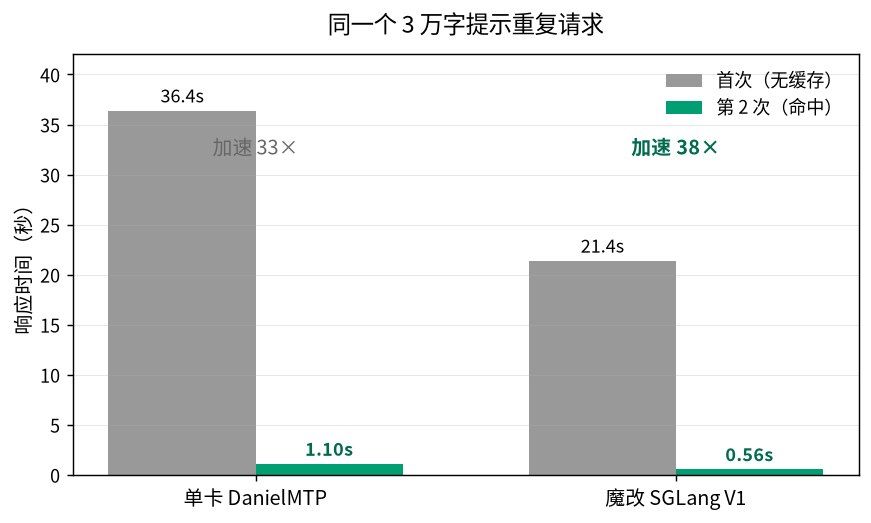
同一个 prompt 问第二次(理论上应该命中缓存,TTFT 接近 0):
| 配置 | 32K | 64K | 96K |
|---|---|---|---|
| vLLM | 20.215s | 48.482s | 83.777s |
| SGLang 魔改 | 0.127s | 0.214s | 0.310s |
| SGLang + DFLASH | 0.133s | 0.223s | 0.315s |
vLLM 的热恢复时间 = 冷启动时间。缓存开了但没起作用。
这个在日常使用里影响巨大:Agent 反复读同一份代码库、反复问同一份文档,SGLang 是 0.1 秒,vLLM 是 20–80 秒。
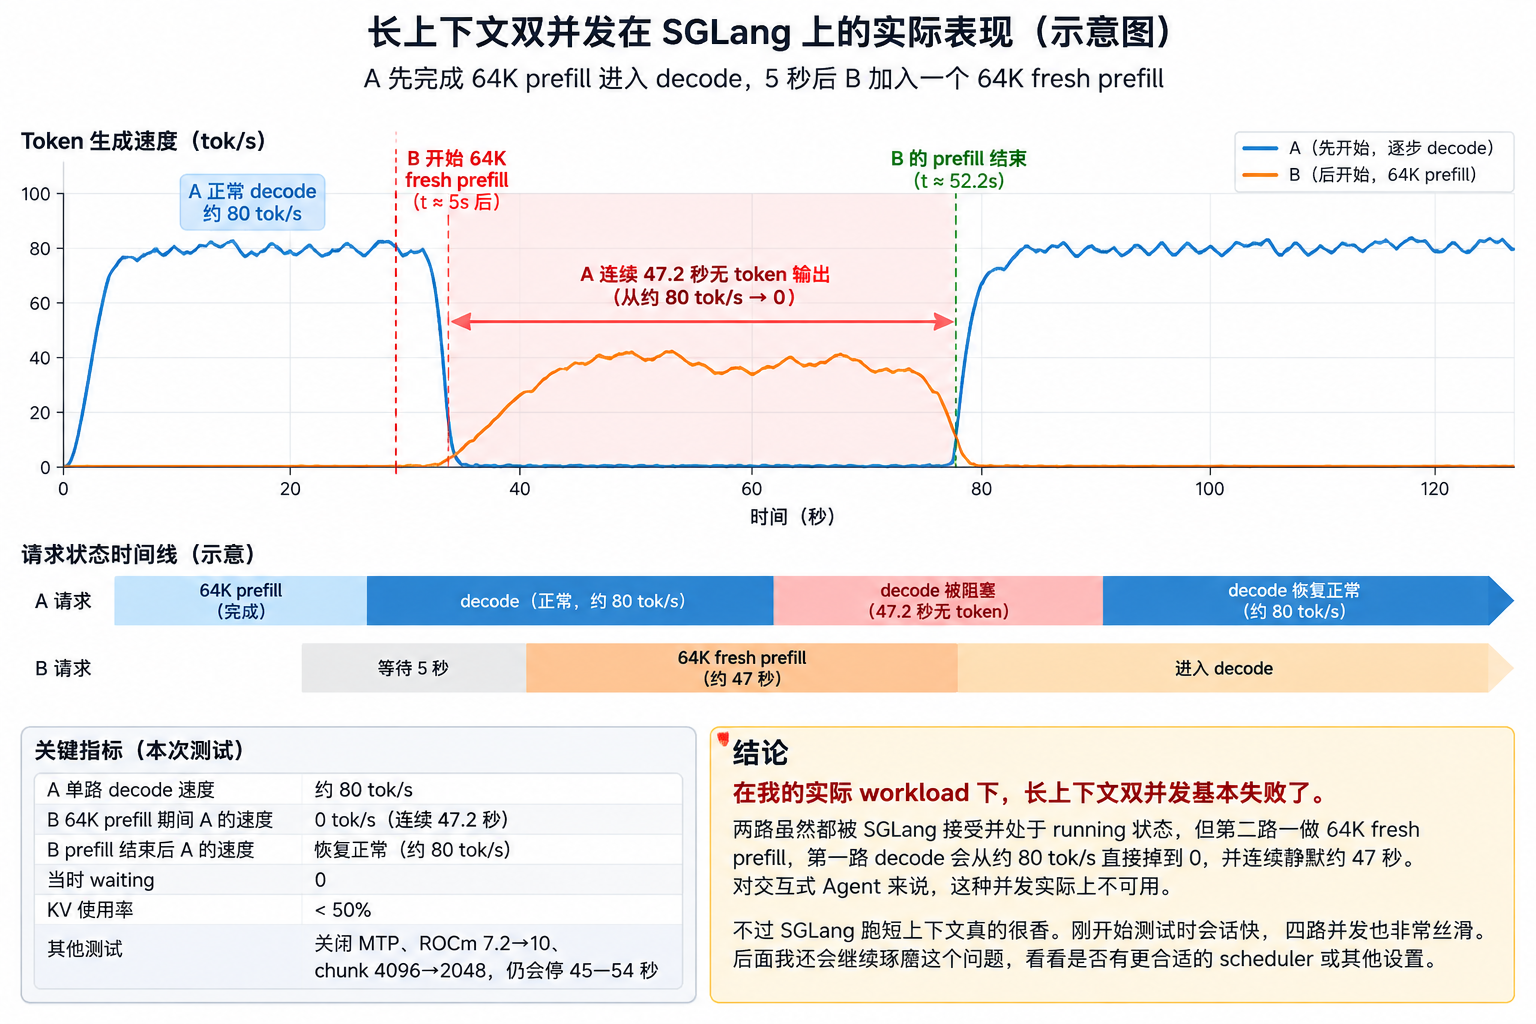
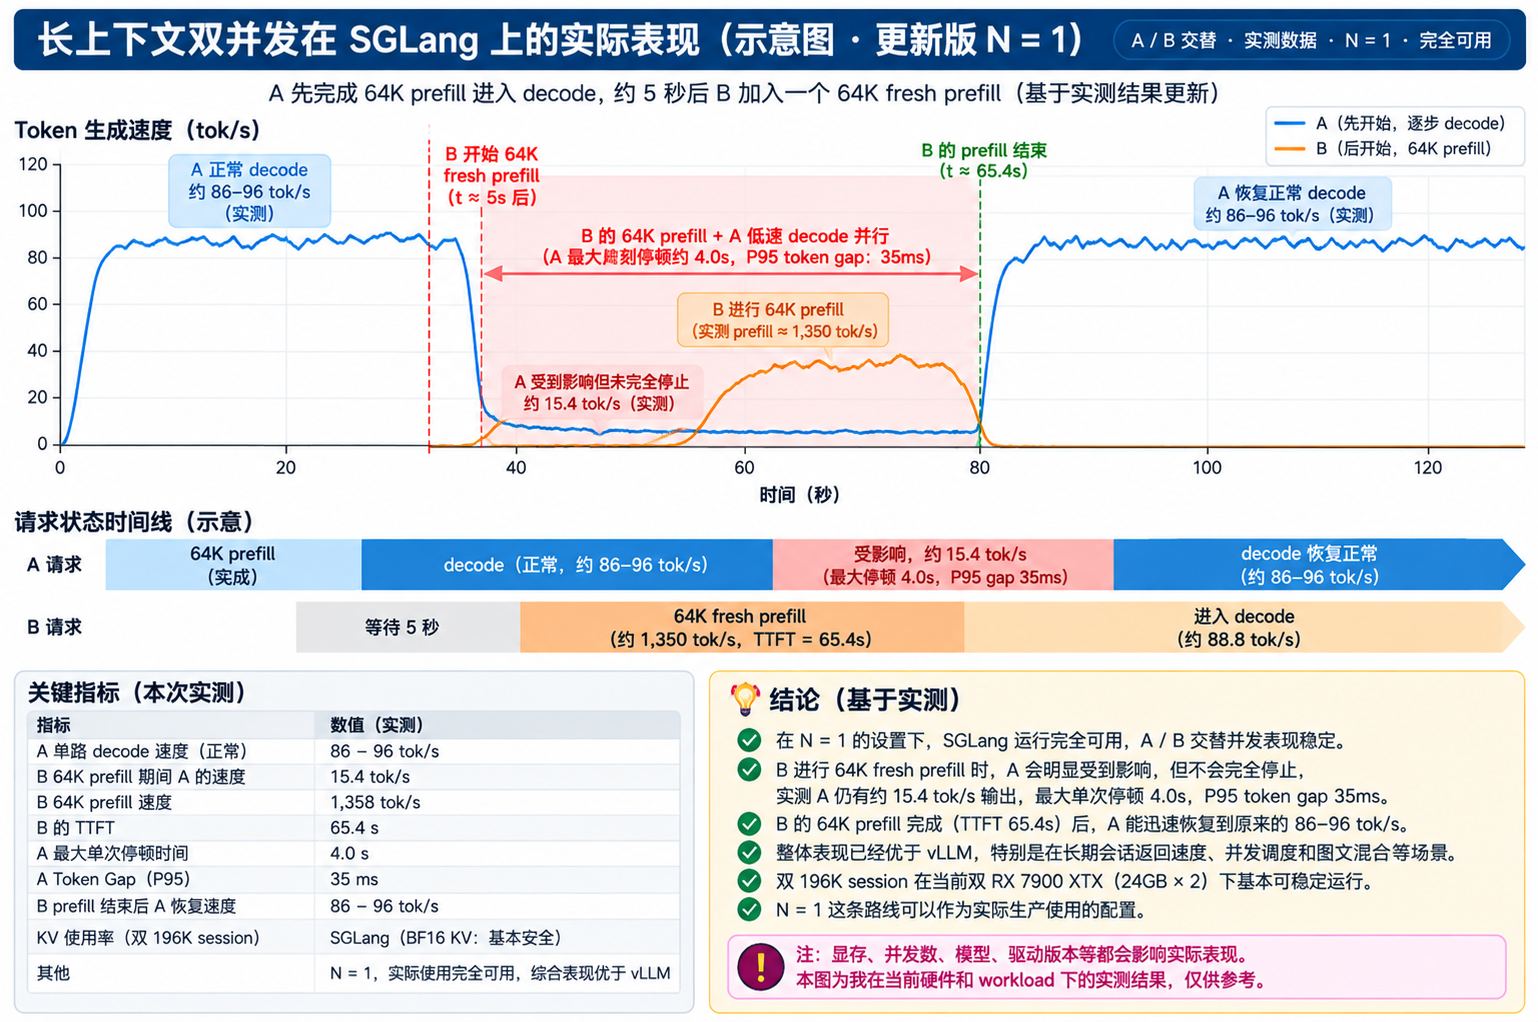
2.3、没有 prefill / decode 隔离
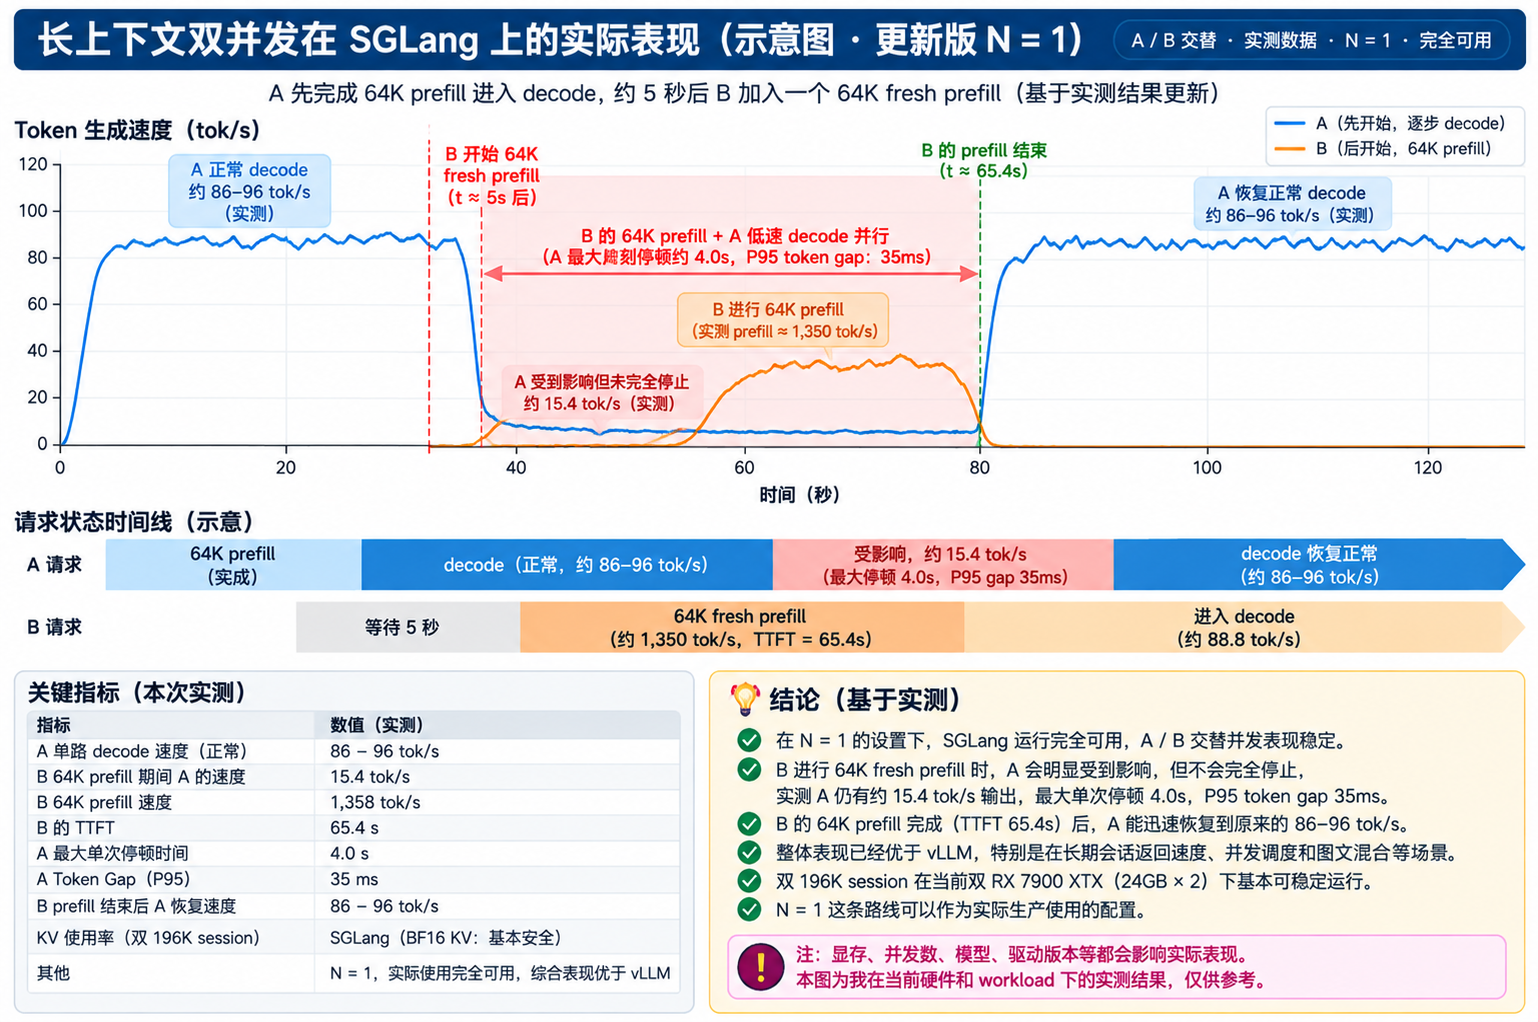
场景:正在生成一段长输出,这时插入一个新请求。
| 配置 | 插入干扰最大间隔 |
|---|---|
| vLLM | 6087.2 ms |
| SGLang 官方 | 341.9 ms |
| SGLang 魔改 | 193.1 ms |
| SGLang + DFLASH | 256.0 ms |
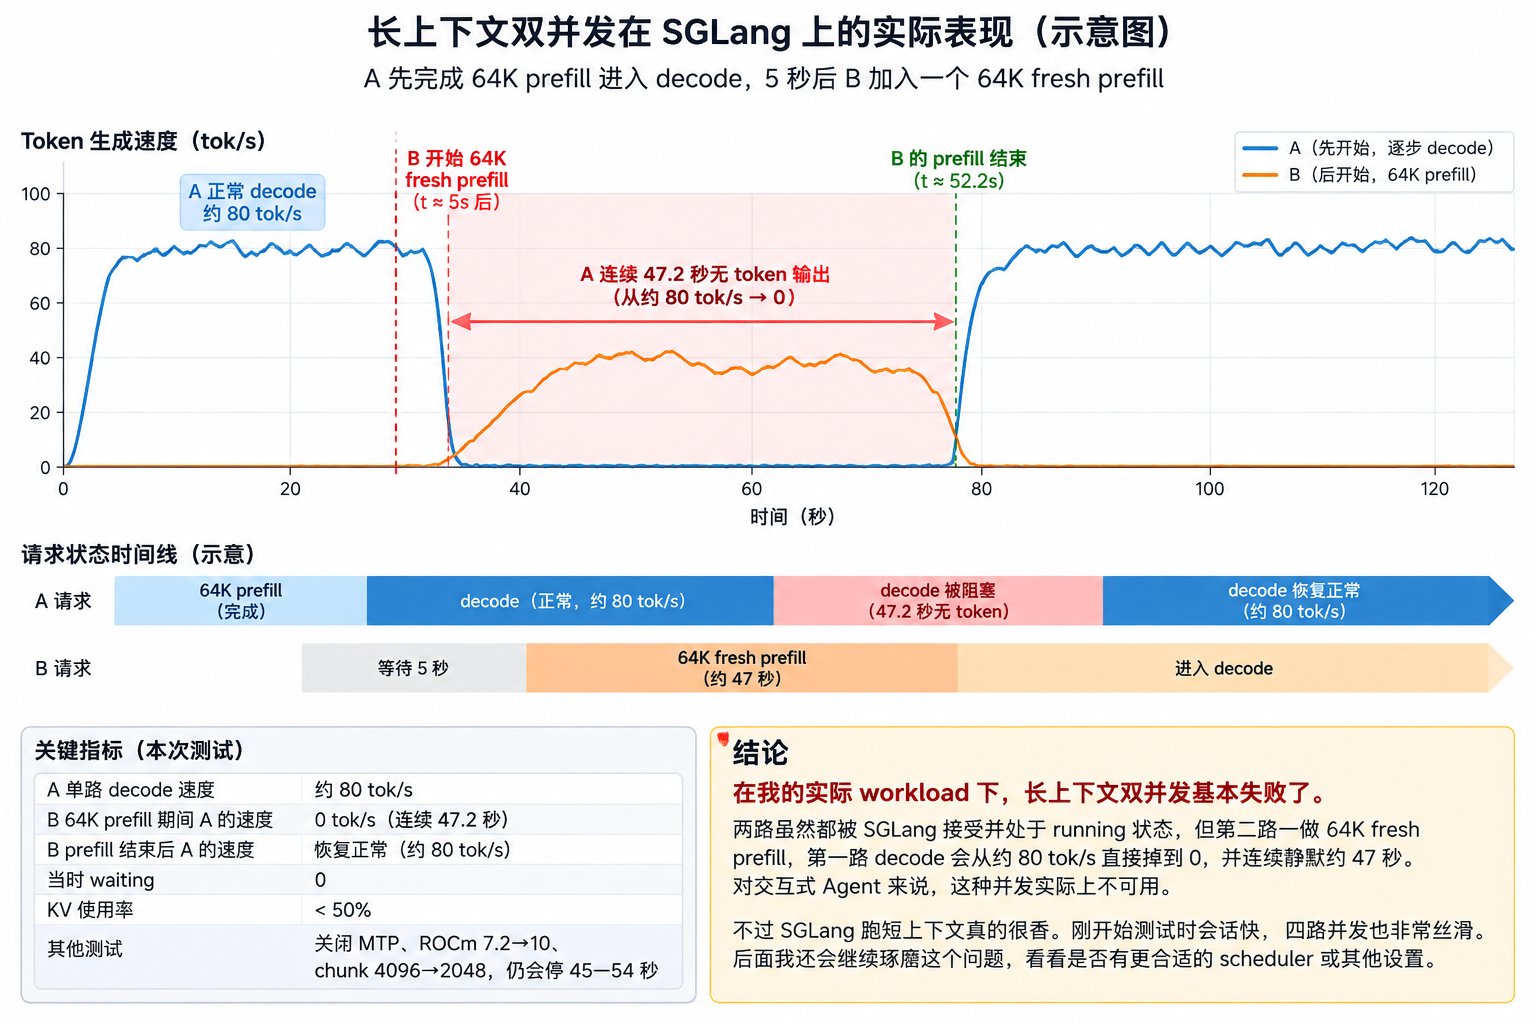
vLLM 在跑新请求的 prefill 时,会把正在生成的那一条完全堵住 —— 长输出的 decode 从 96 t/s 掉到 8.57 t/s,最大间隔 6 秒卡顿。
SGLang 的 chunked prefill 机制要好得多。
一句话:vLLM 单流很快(靠 MTP),但多用户、多轮、边聊边取数据的场景,SGLang 明显更顺。
不过我必须声明一下:在我从单卡 Vulkan 升级到 vLLM 双卡的这几个星期里,体会到了巨大的提升和乐趣。不是 vLLM 不能打,实在是还有高手 —— 魔改 SGLang 不讲武德,嘎嘎乱杀。
第三点:为什么我最后切到了 SGLang
3.1 我平时怎么用这台机器
先说清楚我的使用场景,不然下面的数字没法对号入座。
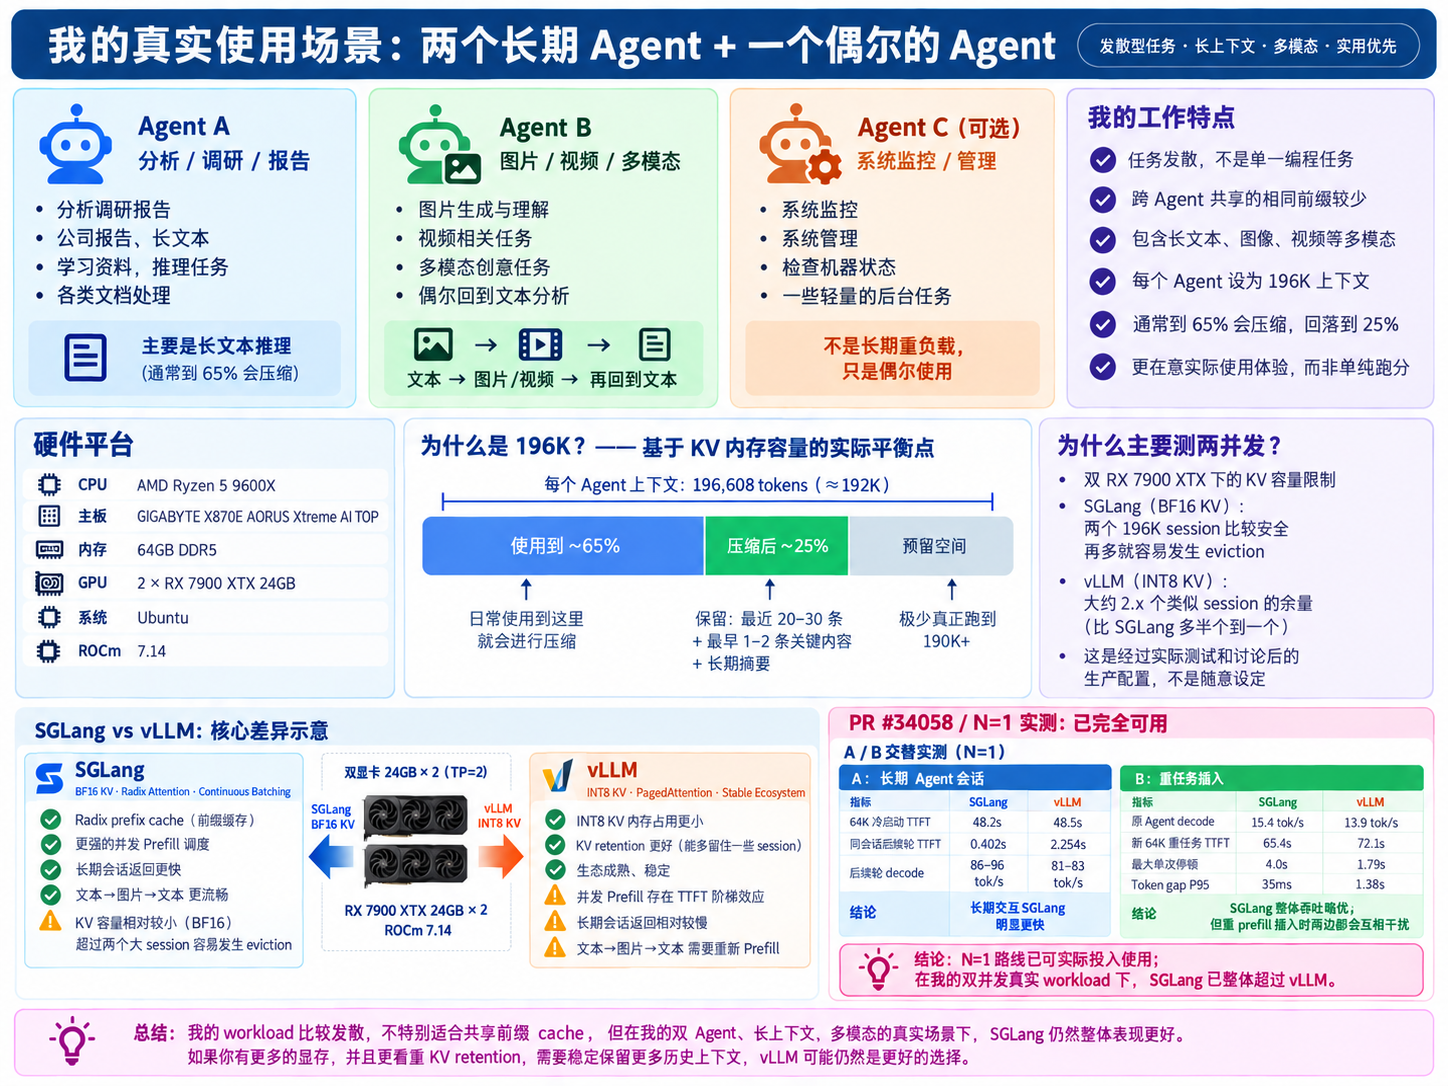
我这台机器不是拿来跑 benchmark 的,是我日常在用的:
· 长文档处理 —— 一份几万字的材料丢进去,来回问十几轮
· Agent 干活 —— 同一个代码库/同一份资料,反复读、反复改
· 一次开机一整天 —— 服务不重启,对话不中断
· 多任务并行 —— 一边写东西一边让它在后台跑别的
具体到工具链,我用的是 Hermes,本地三个 Agent 并行。
我希望的目标环境是这样:
Hermes:三个 Agent 并行
上下文:256K
压缩阈值:65%(约 16.6 万 token 触发压缩)
这个 65% 是压缩机制:上下文用到约 16.6 万 token 时,
它会自动把前面的内容总结压缩,腾出空间继续跑,
这样一天下来可以连着聊几十轮不断线。
这就是为什么我这么在意「长上下文还能跑多快」——
我不是偶尔塞一份长文档就完事,我是几十轮对话、长期挂在高水位:
前面讨论过的数字、贴过的材料,几十轮之后还要能准确地调出来、迅速重现。
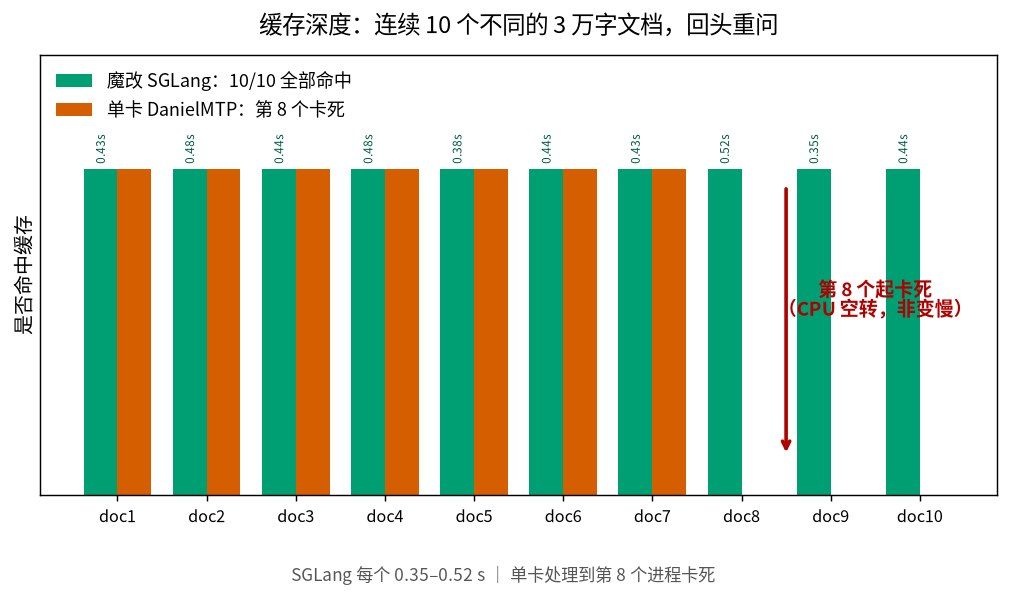
这就要靠前缀缓存一直命中,而不是每轮从头算一遍。
所以我看重的不是「单次极限速度」,而是这三件事:
① 热恢复快不快(第二遍问同一个东西,要不要重新算)
② 并发会不会互相堵(同时来几个请求,是不是排队)
③ 长上下文掉不掉速(聊到 12 万 token 还跑不跑得动)
这三条,就是下面所有测试的出发点。
3.2 我的测试方法,对应的是我实际会遇到什么
| 我测的 | 对应我日常遇到的事 |
|---|---|
| 冷启动 prefill | 第一次把长材料喂进去,要等多久 |
| 单流 decode | 它开始回答以后,吐字快不快 |
| 并发 1/2/3 路 | 同时开几个任务,会不会互相等 |
| 热恢复 TTFT | 同一个问题几十轮后问第二遍,是不是秒回 |
| 插入干扰 | 它正在写,我插一个新请求,会不会卡死 |
| 长输出 gen512 | 让它写一篇长东西,中途会不会掉速 |
上下文选 32K / 64K / 96K / 128K 四档,是因为
我的实际用法就落在这个区间 —— 不是短 prompt,
也不是打到 200K 的极限。
3.3 SGLang 真正的三个杀手锏
下面这三个是 SGLang 相对 vLLM 的结构性优势,也是我最终切过来的原因。
① RadixAttention(前缀树缓存)
这是那个「0.127 秒」的来源。
原理不复杂:SGLang 把所有请求的前缀建成一棵树(radix tree),
相同的开头只存一份。所以第二次问同一个东西、
或者 Agent 第二轮带着前一轮的上下文再来,
它不用重新算 —— 直接从树上接上去。
实测:
同一个 prompt 问第二次的 TTFT
32K:0.127s(vLLM 20.215s) —— 快 159 倍
64K:0.214s(vLLM 48.482s) —— 快 227 倍
96K:0.310s(vLLM 83.777s) —— 快 270 倍
vLLM 那边我也开了前缀缓存,但实测热恢复时间 = 冷启动时间,
等于没生效。
这个差距在日常使用里是致命的:
Agent 每轮都要带着全部上下文重来一遍,
SGLang 是 0.1 秒接上,vLLM 是 20-80 秒从头算。
② HiCache 三级缓存:L1 显存 / L2 内存 / L3 磁盘
这是 SGLang 另一个独门设计。它把 KV 缓存分成三层:
L1 = GPU 显存 最快,容量最小(24G ×2 里切一块)
L2 = Host 内存 次快,容量大(我们有 64G)
L3 = 本地磁盘 最慢但最大,理论上是「无限上下文」
数据在这三层之间自动流动:
显存不够了往下压到内存,内存也不够再压到磁盘;
下次需要的时候再逐级拉回来。
我们的实测结论是:
L1 → L2 这条路径: 完全跑通
实测 13 分钟后回放,wall = 0.443 秒,
对比冷启动 15.068 秒 —— 约 34 倍加速。
而且交叉验证过:客户端拿到的 cached-token 数 12032
和服务端记录的 full_kv_hit_length 12032 逐字一致,
不是自证。
L3(磁盘)这条路径: ️ 我们测下来没跑通
写入是可以的(262 次 write 成功落盘),
但读取路径没打通。
根因已经定位到源码级:L3 restore 之后,
请求侧的 node identity 没有和新生成的 node 重新对齐
(re-anchor / node identity split)。
所以这一帖里所有「热恢复 0.1 秒」的成绩,
是 L1/L2 的功劳,不是 L3。
我把这段如实写出来,是想说:
HiCache 的机制没问题,L2 就已经很香了;
但 L3 这条路我们踩过,暂时走不通,
别看到「三级缓存」就以为磁盘那层能白用。
③ DFLASH 投机解码(专门训练的草稿模型)
这是最猛的一项,也是 flyer666 魔改版的核心。
先说原理。投机解码就是「先猜后验」:
用一个小的草稿模型先猜出接下来 8 个 token,
然后目标模型一次性验证这 8 个。
猜对了就白赚,猜错了就退回重来。
关键在于草稿模型的质量。这里有两种做法:
vLLM 用的是 MTP —— 模型自带的草稿头
SGLang + DFLASH 用的是专门训练的 5 层草稿网络
差别在长上下文下极其明显:
短上下文:两家差不多(MTP 接受长度 3.9,DFLASH 3.5)
长上下文:MTP 掉到 1.3 附近,DFLASH 还能保持 3.5
这就解释了为什么:
vLLM 的投机收益随上下文增长而衰减
2.14 倍 → 1.62 → 1.54 → 1.43 → 1.27(128K)
DFLASH 的收益反而随上下文变强
1.92 倍 → 3.69 → 3.46 → 3.17 → 3.31(128K)
DFLASH 的草稿模型只有 1.2G(W4A16),
占用很小,但收益巨大:
32K 下 179.87 t/s,是 vLLM+MTP(86.08)的 2.09 倍。
3.4 但我必须说清楚两件事
一、DFLASH 有精度代价
这不是我发现的,是 flyer666 自己在帖子里写的:
投机解码的分块验证和逐 token 解码并非逐位等价。
具体表现:约 1/4 的接受边界上,
top-2 logit 的间距小于 0.5 —— M=8 的验证批里,
数值误差足以让 argmax 落到另一个 token 上。
他自己实测的 GSM8K #1 就答错了(答 96,正确是 72)。
所以:要绝对确定性输出的场合(比如代码生成要精确复现、
或者做数学题要严格),
要么关掉投机,要么知道自己在承担这个风险。
二、L3 那层我们没跑通
上面已经说了,不重复。写在这里是因为
「我正式切到了 SGLang」这句话的前提是:
我切的是 L1/L2 这条路,
不是因为它有个看起来更厉害的 L3。
3.5 我的正式生产参数
下面是我实际在跑的配置,可以直接抄。
两套并列:一套是我们这边实测的,
一套是 flyer666 仓库 README 里的最新推荐。
A. 我们的配置(跑出本文所有数字的那套)
环境 / 栈:
ROCm 7.2.3
SGLang 源码树:/data/sglang-dflash2-f84475c(flyer666 魔改版)
模型:/data/models/Qwen3.8-27B-W4A16-AutoRound-GPTQ
草稿:/data/models/Qwen3.8-27B-DFlash2-W4A16
启动参数:
--model-path /data/models/Qwen3.8-27B-W4A16-AutoRound-GPTQ
--tp-size 2 --quantization gptq
--dtype bfloat16 --mamba-ssm-dtype bfloat16
--kv-cache-dtype auto
--attention-backend triton
--context-length 196608
--mem-fraction-static 0.80
--max-running-requests 4
--max-total-tokens 300000
--chunked-prefill-size 8192
--max-mamba-cache-size 24
--cuda-graph-bs-decode 1 2 4
--triton-attention-num-kv-splits 16
--reasoning-parser qwen3 --tool-call-parser qwen3_coder
--default-chat-template-kwargs '{"enable_thinking": false}'
--stream-interval 1
HiCache(只用到了L1/L2两级缓存)
--enable-hierarchical-cache
--hicache-size 12
--hicache-ratio 2.0
--hicache-io-backend kernel
--hicache-host-memory-mode cache
DFLASH
--speculative-algorithm DFLASH
--speculative-draft-model-path /data/models/Qwen3.8-27B-DFlash2-W4A16
--speculative-num-draft-tokens 8
--speculative-draft-window-size 2048
实测资源占用(启动日志原文):
Mamba Cache(每卡):
conv_state 0.03 GB + ssm_state 0.88 GB
开 DFLASH 后额外:intermediate_ssm_state 1.41 GB + conv_window 0.02 GB
Tree cache:UnifiedRadixCache,hybrid_ssm=True,hicache_attached=True
调参说明:mem-fraction-static 我试过 0.80 / 0.85 / 0.90,
0.90 会 OOM(gptq_kernels.py:167),0.80 是稳定点。
hicache-size 也试过 20,host 内存会紧张,12 更稳。
B. flyer666 仓库 README 的最新推荐(2026-09-11 实测)
环境 / 栈:
ROCm 7.14(HIP 7.14.60850)
PyTorch 2.11.0(ROCm 7.2 官方构建 wheel)
构建版本:65b16b3df7(含 GDN/WMMA Prefill 调优 + 热 L2 Autotune 修复)
草稿模型:Qwen3.8-27B-DFlash2(5 层草稿网络,
HF 上 incoai/Qwen3.8-27B-DFlash2)
环境变量:
export SGLANG_KV_CACHE_DTYPE=bfloat16
export SGLANG_DTYPE=bfloat16
export SGLANG_RDNA_CUSTOM_AR=1 ← RDNA3 专用 All-Reduce(我们没有)
export SGL_RDNA_NO_FUSED=1
export SGL_RDNA_GEMMA_TRITON=1
export SGL_RDNA_VLLM_VERIFY=1
启动参数:
--tp-size 2 --quantization gptq --dtype bfloat16
--mamba-ssm-dtype bfloat16
--kv-cache-dtype bfloat16 ← 我们用 auto
--attention-backend triton
--context-length 196608
--mem-fraction-static 0.90 ← 我们用 0.80
--max-running-requests 4
--max-mamba-cache-size 20 ← 我们用 24
--chunked-prefill-size 2048 ← 我们用 8192
--cuda-graph-bs-decode 1 2 4
--triton-attention-num-kv-splits 16
--speculative-algorithm dflash
--speculative-draft-model-path /path/to/Qwen3.8-27B-DFlash2
--speculative-draft-model-quantization unquant
--speculative-num-draft-tokens 8
--speculative-draft-window-size 2048
--stream-interval 1
他那边额外的优化(我们还没上):
· RDNA Custom All-Reduce(scripts/rdna_ar)
RDNA3 没有 CDNA 的 MUBUF/peer-IPC 硬件集合通信,
他写了一阶段点对点 PCIe 专版,靠 SGLANG_RDNA_CUSTOM_AR=1 开启
· 草稿模型换 W4A16 量化版(syvai/Qwen3.8-27B-DFlash2-W4A16)
草稿显存 2.09 → 1.04 GiB/卡,KV 容量 189,172 → 217,746(+15.1%)
· --sleep-on-idle 空闲休眠
他 README 里给的实测(2026-09-11,双卡 TP=2,W4A16 草稿版):
数学 CoT 约 193 tok/s(GSM8K/MATH-500,3/4 正确)
120k Agentic 会话回放平均约 119 tok/s(中位数 113,最差轮 57)
Prompt 处理约 1,950 tok/s(llama-benchy PP=2048)
depth 0 128 tok/s、16k depth 109 tok/s(保持率 84.8%)
两套配置的差异一览
项目 我们 flyer666
ROCm 栈 7.2.3 7.14
mem-fraction-static 0.80 0.90
kv-cache-dtype auto bfloat16
max-mamba-cache-size 24 20
chunked-prefill-size 8192 2048
HiCache 开 未提及
RDNA Custom AR  用标准 RCCL 开
草稿模型 DFlash2-W4A16 DFlash2(unquant)/ W4A16 量化版
草稿量化 gptq(继承) unquant / 或继承
sleep-on-idle
3.6 一句总结
我最后选 SGLang,不是因为它单流最快 ——
单流关投机两家差不多(53 对 54)。
是因为它在「反复读同一份材料」这个场景下,
把「重新算一遍」变成了「接上去就行」:
前缀命中:0.127 秒 vs 20 秒
多请求并发:6.74 秒 vs 293.90 秒
长上下文 decode:DFLASH 128.64 vs vLLM+MTP 46.39
我这台机器日常就在干这件事,所以这个差别对我是决定性的。
但前提说清楚:这是「我的场景」的结论。
如果你只是短 prompt 写代码,vLLM 的单流速度也很好,
没必要折腾。
第四点:致敬三个人
在说数据之前,有三个人必须先感谢。
机智罗_LX(B站)
如果你用 AMD 显卡玩过出图和出视频,你大概率用过他的「机智整合包」。ComfyUI 一键装好、工作流内置、连 SageAttention 都给你配好参数。
在他之前,A 卡玩出图是一种折磨:装环境三天,出图三分钟。现在?下载、解压、双击。V1 到 V5,工作流从 24 个到 182 个。
他简介里写的是「爱折腾,目前专注AMD显卡本地玩转AI,希望可以帮助更多人」。就这一句话,把多少人从「A 卡出图」的坑里拉了出来。
抡锤者老特(油管 / lcz.me)
推理这条路,是他一直在前面趟。
- 《7900XTX双卡TP,SGLang多并发飞速响应,本地AI神卡最后短板被补齐!》
- 《平民AI神卡:7900 XTX突然真香了?单卡/双卡TP + llama.cpp》
他不只是做视频,他自己建了个论坛(lcz.me),把 A 卡玩家聚在一起,大家把踩过的坑、测出来的数、调通的参数摊在明面上。
我自己也是跟着他的视频才走上 SGLang 这条路 —— 包括这次测试的怀疑方向,源头就在他说过的一句话:SGLang 相比 vLLM 是更高一档的存在。
flyer666(Steven 大神)
这个帖子的核心数据,全部建立在 flyer666 的魔改 SGLang 上。
9 月 6 日,他发布了「魔改 SGLANG 支持 7900XTX 双卡 TP」—— 这是一份高含金量的原创工作,不是小修小补。
他做了什么?把官方拿掉的 RDNA3 补丁链重新补了回来,让 7900 XTX 重新能跑 DFLASH。
先把话说清楚:这不是「官方版慢」,是官方版根本跑不起来。
在官方 main 树上加载 DFLASH,直接报错:
compressed_tensors_wNa16.py:250
NameError: name 'gptq_marlin_repack' is not defined
原因是官方把 RDNA3 的补丁链拿掉了(涉及 5 个 commit:160913a88 / 0ffda9d43 / dc4a2e63b / 7f396e561 / 2862cd451)。flyer666 的魔改版把这套补丁补了回来。
补回来意味着什么?就是下面这张表的差别:
32K  decode:179.87 vs 39.80  → 快 4.5 倍
64K  decode:155.38 vs 35.77  → 快 3.5 倍
128K decode:128.64 vs 29.97  → 快 3.3 倍
补丁做完的效果,用一句话形容就是:杀疯了,嘎嘎乱杀。
179.87 这个数字,比全场任何配置都高一倍以上。这不叫「修复」,这叫「把不可能变成了可能」。
对我们这些买了 7900 XTX 的人 —— 说得直白点,不富裕的人 —— Steven 就是活菩萨。
PS:这三个人,AMD 官方真应该给他们发奖状。正是他们凭一己之力,扭转了「AMD 在出图、出视频、推理生态上不能打」的偏见。他们不是在帮 AMD 做市场,他们是在给 AMD 收拾烂摊子。
第五点:官方抛弃 RDNA3,其实也无可厚非
夸完魔改版,另一面也得站到 SGLang 官方这边说句公道话。官方为什么放弃 RDNA3?数据说话。
Steam 2026 年 8 月硬件调查:
AMD Radeon RX 7900 XTX      0.45%
AMD Radeon RX 7900 XT       0.45%
对比一下:
RX 9070 XT(RDNA4,后出的)   1.46%   ← 是 7900 XTX 的 3.2 倍
NVIDIA RTX 3060              3.92%
NVIDIA RTX 5070              3.77%
NVIDIA RTX 5080              1.71%
NVIDIA RTX 4090              0.77%
NVIDIA RTX 5090              0.43%   ← 比 7900 XTX 还低(当然玩儿推理的不一定玩儿游戏,我自己就是,玩AI开始就戒游戏了)
7900 XTX 在全体 Steam 玩家里的占比是 0.45%。在 AMD 大约 18.7% 的总盘子里,7900 XTX 只占约 2.4%。
而且 RDNA3 产线已经收尾了(RDNA5 预计 2026 年底到 2027 年初)。7900 XTX 2022首发 999 美元,2025 年底跌到 799,现在回到 899–949(缺货挤压)—— 存量不再增长。
站在这个前提下:为了 0.45% 的用户维护一套 RDNA3 补丁链,投入产出比确实不划算。从商业角度看,官方这个决定是合理的。
这正是魔改版存在的意义:官方算不过来的账,社区来补。 老特给大家提供了 7900 XTX 这个极高高性价比的选择,flyer666 把 7900 XTX 的性能发挥到了几乎极限 —— 两位都是活菩萨。
我个人:五月份听了老特的视频买了第一张二手的7900XTX,八月份看了flyer666的帖子(也是先听老特的视频然后查的)买了第二张二手的,赚了!
附:完整数据表(全部 2026-09-18 本机实测)
decode 单流,tokens/s
| 配置 | d0 | 32K | 64K | 96K | 128K |
|---|---|---|---|---|---|
| vLLM 双卡 + MTP | 112.93 | 86.08 | 71.33 | 58.71 | 46.39 |
| vLLM 双卡(无 MTP) | 52.79 | 53.05 | 46.30 | 40.91 | 36.46 |
| SGLang 魔改 + DFLASH | 103.82 | 179.87 | 155.38 | 132.19 | 128.64 |
| SGLang 魔改版 无投机解码 | 54.04 | 48.80 | 44.86 | 41.71 | 38.83 |
| SGLang 官方版 无投机解码 | 44.66 | 39.80 | 35.77 | 32.72 | 29.97 |
冷启动 prefill,tokens/s(括号为 TTFT)
| 配置 | 32K | 64K | 96K |
|---|---|---|---|
| vLLM | 1624 (20.2s) | 1354 (48.4s) | 1173 (83.8s) |
| SGLang 官方 | 1608 (19.9s) | 1337 (47.9s) | 1151 (83.4s) |
| SGLang 魔改 | 1575 (20.3s) | 1332 (48.1s) | 1155 (83.1s) |
| SGLang + DFLASH | 1546 (20.7s) | 1317 (48.6s) | 1142 (84.1s) |
并发 96K 完成时间,秒
| 配置 | 1 路 | 2 路 | 3 路 |
|---|---|---|---|
| SGLang + DFLASH | 3.55 | 5.51 | 6.74 |
| SGLang 魔改 | 6.43 | 7.42 | 9.12 |
| SGLang 官方 | 9.36 | 9.51 | 9.36 |
| vLLM | 88.63 | 190.84 | 293.90 |
热恢复 TTFT,秒
| 配置 | 32K | 64K | 96K |
|---|---|---|---|
| SGLang 魔改 | 0.127 | 0.214 | 0.310 |
| SGLang + DFLASH | 0.133 | 0.223 | 0.315 |
| SGLang 官方 | — | — | 0.449 |
| vLLM | 20.215 | 48.482 | 83.777 |
插入干扰(冷 prefill 打断长输出)最大间隔
| 配置 | 最大间隔 |
|---|---|
| vLLM | 6087.2 ms |
| SGLang 官方 | 341.9 ms |
| SGLang 魔改 | 193.1 ms |
| SGLang + DFLASH | 256.0 ms |
长输出 gen512
| 配置 | t/s |
|---|---|
| SGLang + DFLASH | 97.38 |
| vLLM | 91.75 |
| SGLang 魔改 | 44.85 |
| SGLang 官方 | 35.76 |
测试口径声明(防止有人对不上数字)
- 硬件:双 RX 7900 XTX(24G)+ Ryzen 5 9600X + 64G DDR5
- PCIe:4.0 x8 ×2(根桥限制,不是 x16 —— 双卡会降速)
- 系统:Ubuntu 原生,ROCm 7.2.3,核显(gfx1036)已排除
- 模型:Qwen3.8-27B,SGLang/vLLM 用 W4A16-AutoRound-GPTQ
- KV:vLLM = int8_per_token_head,SGLang = fp16
- 上下文上限:196,608
- prompt 构造:用
"The quick brown fox jumps over the lazy dog. "填充(约 10.006 token/句) - decode 测法:流式请求 +
stream_options={"include_usage": true}取真实completion_tokens
- 测试卫生:每条测试之间重启服务、清
/dev/shm/nccl-*、显存归零 - 重复次数:每个数字至少 3–5 次,波动 <1% 才采用
补充一句:这张表里的数字,是我为「长上下文 + 多轮Hermes Agent」这个场景调的,我不写代码,也不会用DSH。如果你只是短 prompt 写代码、做数学题,数字会更好看(轻负载下 decode 能更高),但那是另一个场景,不在这张表的范围内。
相关链接
- flyer666 原帖(魔改 SGLang 双卡 TP):https://lcz.me/topic/1532
- flyer666 vLLM 攻略:https://lcz.me/topic/1363
- 抡锤者油管:https://www.youtube.com/@抡锤者
- 抡锤者论坛:https://lcz.me
- 机智罗_LX B站:搜索「机智罗_LX https://space.bilibili.com/302329373
感谢论坛几位兄弟的在我的这个系列水贴里的关注和捧场 @张光璞 @geekyang @懒人烘培 @farmer-node @小鲸鱼0663 @densha @墙内人 @laobenxiong @kos-or 等等
对了,还要特别感谢公司给我创造了能够上班摸鱼完成这项测试马拉松的宽松环境。不过我平时加班的时间可真是比摸鱼时间多得多,怎么说呢,问薪无愧!
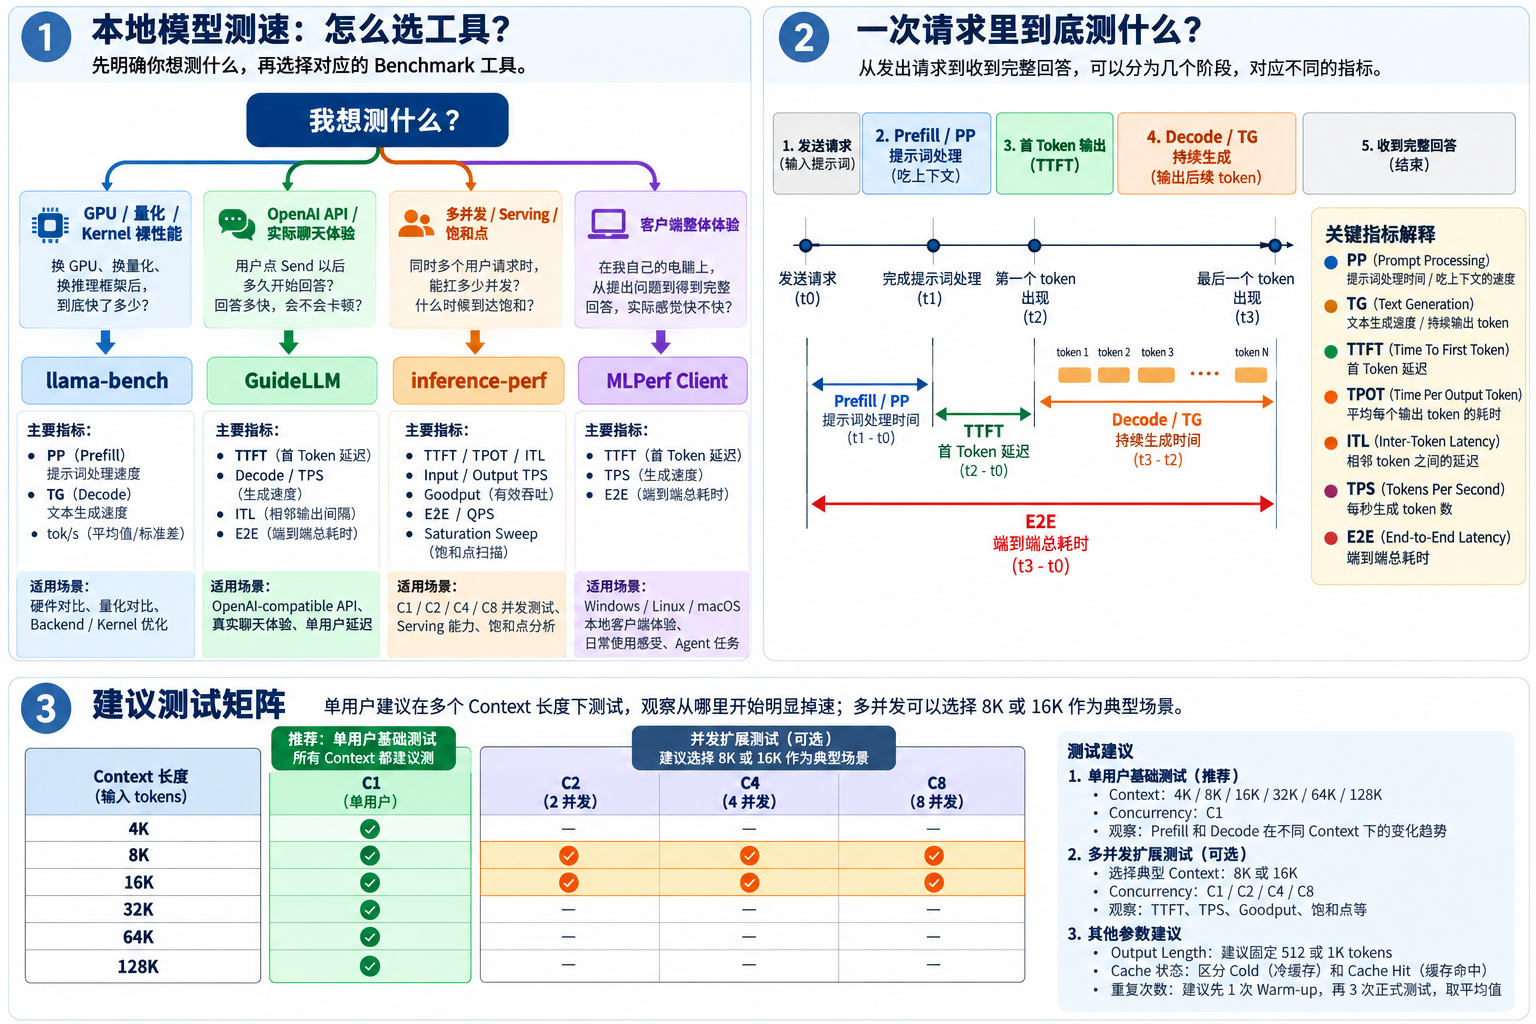
 ,尤其是类似于nInfer这类的定向优化让我“醋意满满”(其实我也有N卡,哈哈);甚至RDNA4 PRO R9700的优化也一日千里 —— 这个真么有,曾经买过一块又让我给退了,各种羡慕嫉妒恨。


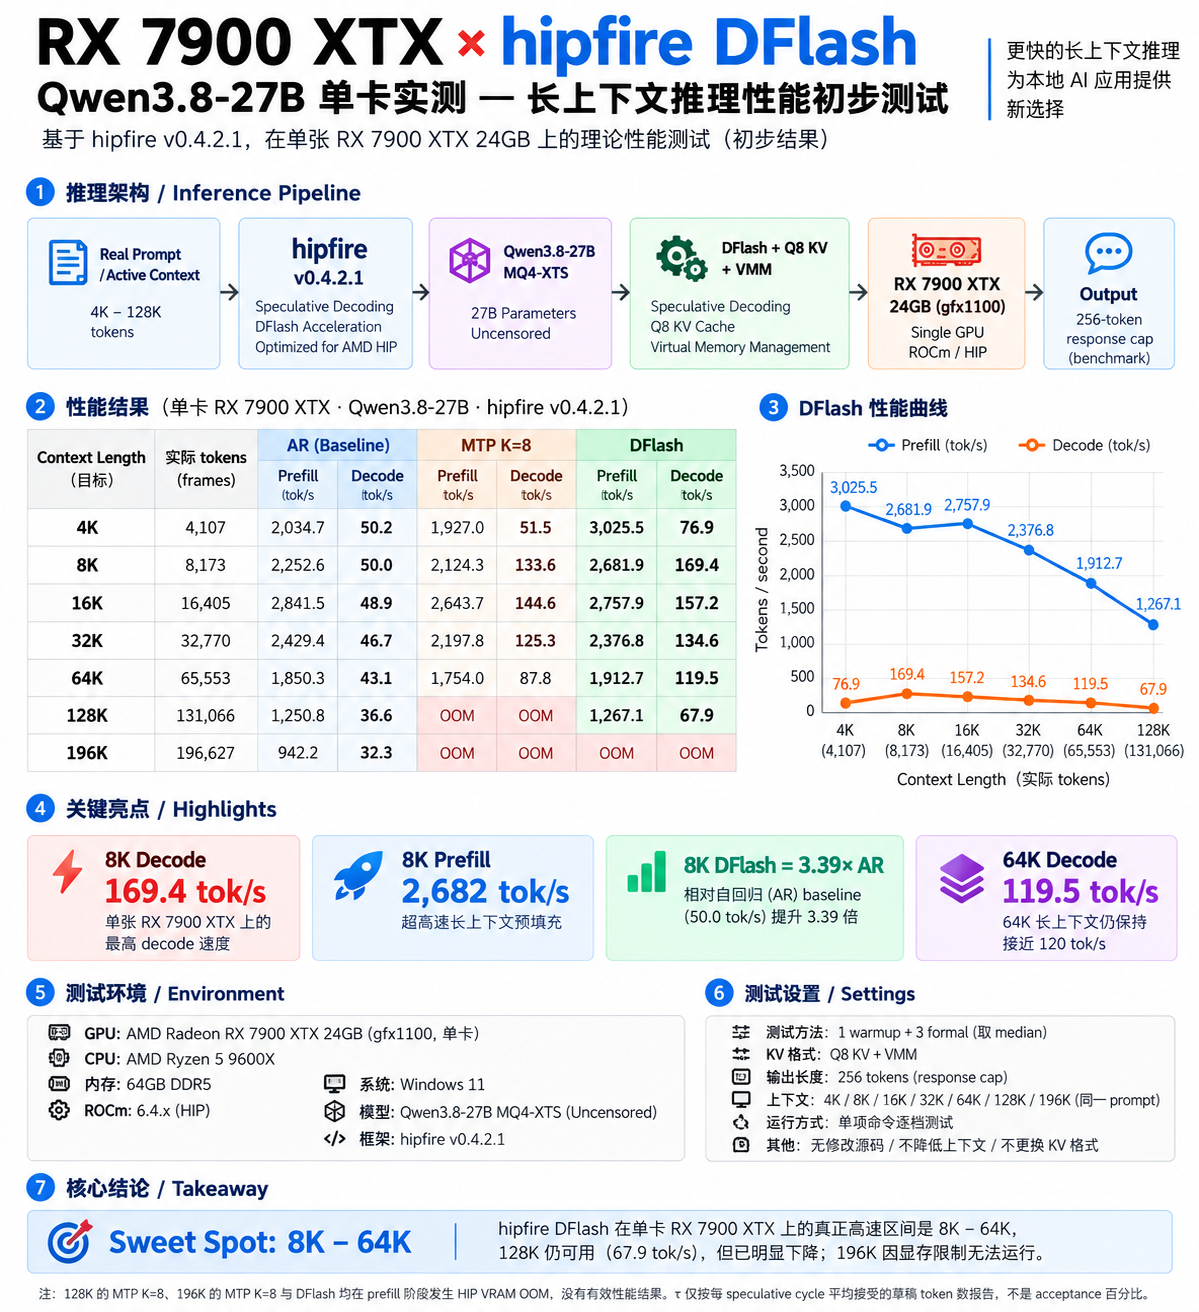

 ),而是折腾7900 XTX 更有性价比。

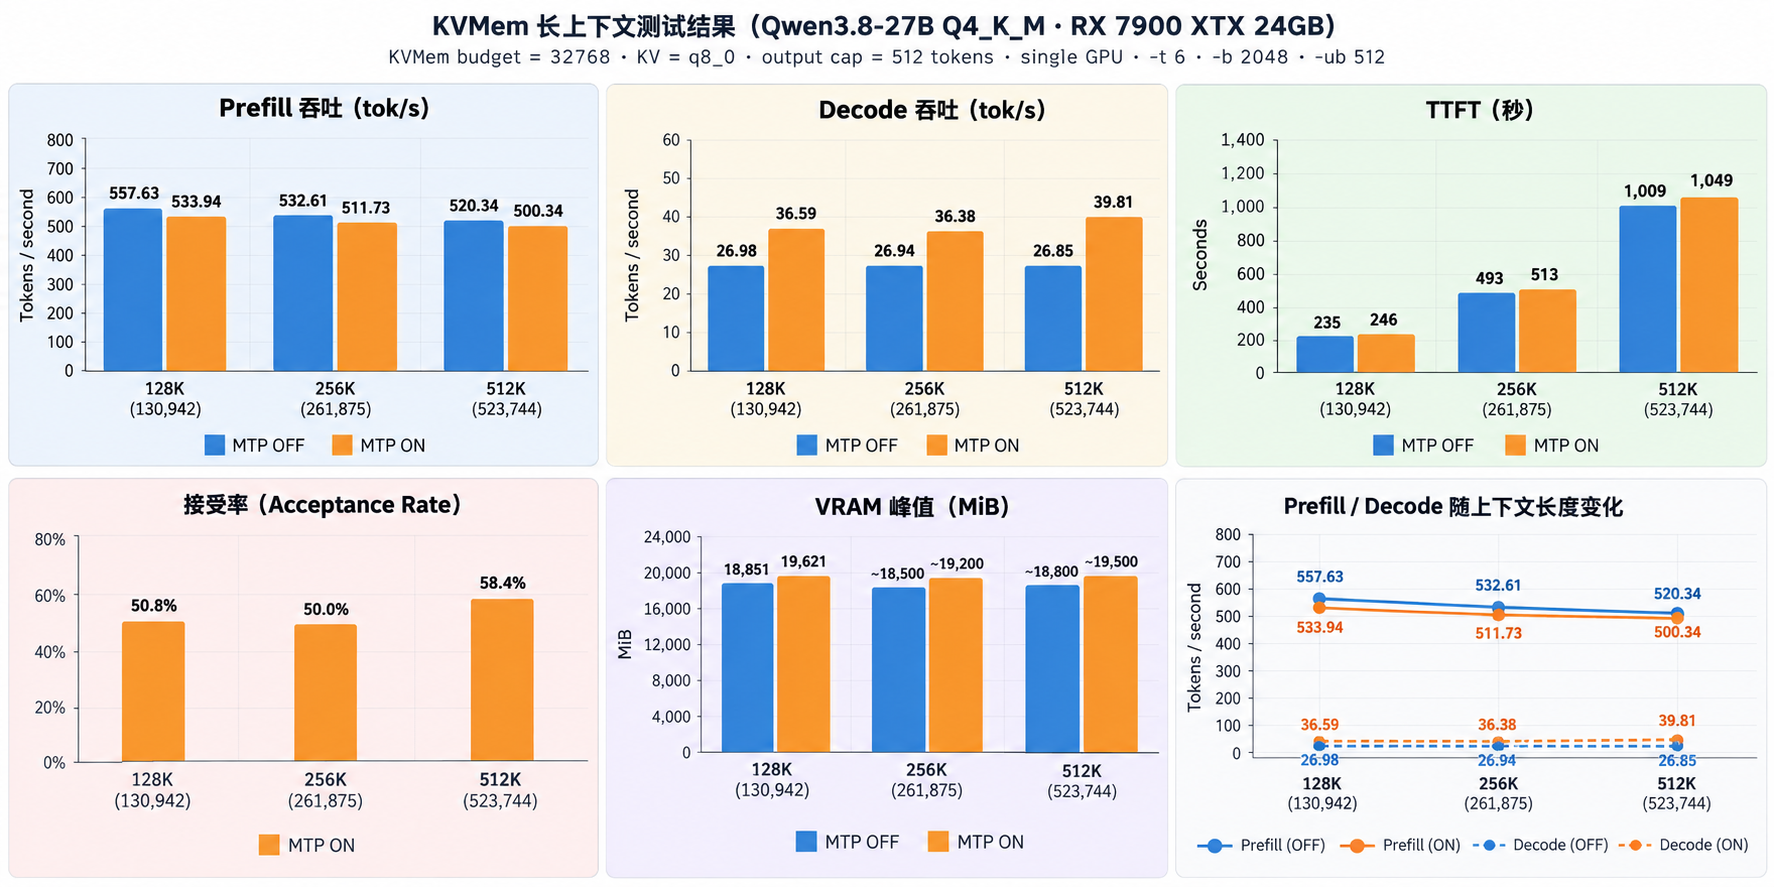
 更多的 Host RAM 使用

 。


 。请看我这两周都经历了什么 ->




 **


 不过好在找到了替代方案 --enable-mixed-chunk,思路类似但实现更干净,效果还略好一丢,所以现在的 production 就没再单独加回那个参数了。

 ),换成中文素材或测coding则不掉档(208.8 / 172.5)。