

@kos-or 老特这是搞封建复辟啊,你是第一受益人,黄袍加身
 后宫团什么时候放出来给兄弟们解解馋
-
🎉 恭喜 @kos-or 晋升「至尊王者」! -
# Strata Qwen3.8 Flash Next IQ3_S:單張 3060、雙張 3060、單張 7900 XTX 實測 繼續分享把手邊硬件都測一輪 讓論壇帖子豐富起來@CHIA-AN-YANG 请教一下7900XTX Strata Qwen3.8 Flash Next IQ3_S 你这边的思考模式是怎么设置的。我这边但凡开了思考,哪怕是low都是雷霆大思考,时间花的别27B的低思考模式还长
-
Qwen3.8-27B 长上下文实测:5060 Ti NInfer 对比 7900 XTX Vulkan / ROCm -
7900 XTX 的可能性探索|单卡篇(五)续:Hipfire 27B 的生产部署、模型质量与 Agent 实战 -
🎉 恭喜 @applejuice 晋升「超凡大师」! -
7900 XTX 的可能性探索|单卡篇(五)续:Hipfire 27B 的生产部署、模型质量与 Agent 实战上一篇介绍了 Hipfire 在 RX 7900 XTX 上的推理性能,单卡 8K 上下文实现了 2682 t/s Prefill 和 169.4 t/s Decode,64K 上下文仍有 119.5 t/s Decode。
部署到实际使用环境后,这次继续测试四个方面:框架功能与限制、Hermes Agent 实际运行、标准题集质量,以及不同思考档位的效果。最后再让模型交几份有趣的编程作业。
结论优先,跑了三天测试,没有出现死循环,未发现影响主要功能的严重 Bug,能用,够用,单卡7900XTX好用
,我已经把自己单卡的生产环境换了这个推理框架。一、Hipfire 框架与专属 MQ4-XTS 模型
1. 测试环境
项目 配置 GPU RX 7900 XTX 24GB,单卡 GPU 架构 AMD RDNA3 / gfx1100 推理框架 Hipfire v0.4.2.1 Commit 6b363a56a1ae模型 Qwen3.8-27B MQ4-XTS KV Cache Q8 显存管理 HIP VMM 推测解码 DFlash API OpenAI-compatible Agent Hermes Hipfire 是针对 AMD GPU 优化的推理框架。与常见的通用模型运行方案相比,其特色是专属 MQ4-XTS 模型格式、VMM 显存管理和 DFlash 推测解码。
这里测试的不是普通 GGUF Q4 文件,而是 Hipfire 框架与 MQ4-XTS 模型组合的整体表现。
2. 主要功能和实测情况
功能 测试情况 DFlash 推测解码 8K 下 169.4 t/s,约为 AR 的 3.39 倍 Q8 KV Cache 已用于所有主要长上下文性能测试 VMM 显存管理 已启用,支持按需映射 上下文 128K、160K 实测成功,约 176K OOM Prompt Cache 前缀复用已验证 视觉输入 简单图片、色块和示意图测试通过 Tool Calling 已接入 Hermes 并完成实际工具调用 思考档位 支持请求 Off / Low / Medium 并发 主要性能测试为 C1,尚无充分多并发验收 3. Prompt Cache
早期测试中,曾关注过 Hipfire 的前缀缓存能力。
后续生产环境验证确认,重复请求能够复用前缀 KV。在一次测试中:
指标 首次请求 重复请求 命中缓存 tokens — 6656 墙钟耗时 约 2.9s 约 0.3s 这是一次特定测试的结果,不代表所有任务都能获得相同加速,也不意味着模型具备无限容量的历史 KV 存储。
4. 实际限制

KV 显存硬边界
当前单卡 24GB、MQ4-XTS、Q8 KV 配置下:
- 128K:通过
- 160K:通过
- 约 176K:OOM (Q8KV下24G显存有点捉襟见肘这是硬伤,但是实测Q4 KV会严重损失速度,只能Q8)
因此,较高的逻辑上下文配置不等于对应长度一定能够实际运行。这个边界是当前模型及显存配置的实测限制,而不是 Hipfire 框架通用的固定上限。
并发能力
已有吞吐成绩主要来自 C1 单并发、Cold Context 测试。多并发吞吐、延迟以及显存压力尚无充分验证。
量化格式与兼容性
MQ4-XTS 是这套框架的专属模型格式。普通 Q4/GGUF 量化和 MQ4-XTS 不能直接等同;此前其他四位量化路径的失败现象也不能据此归因于 MQ4-XTS。
二、部署生产环境:Hermes Agent 能不能真正干活?
完成性能测试后,将 Hipfire 27B 接入 Hermes,作为实际 Agent 的推理后端。
这部分没有停留在简单问答,而是测试文件读写、工具调用、调查分析、代码调试、多轮执行和视觉输入。
1. 基础功能验收
测试 结果 基础 Tool Calling PASS 文件读取与调查 PASS 多步骤工具调用 PASS Coding / Debug PASS 视觉图片输入 PASS Prompt Cache 命中 PASS 动态思考请求 PASS(请求切换) 多轮 Agent 工作流 PASS 2. Coding / Debug
在预设问题的代码与配置调查中,模型成功定位三处缺陷。
一次 Medium 测试记录:
指标 实测 找到的问题 3 处 思考 tokens(测试记录) 约 10,558 墙钟时间 约 34s 3. 多轮 Agent 工作流
一次完整任务的执行记录:
指标 结果 LLM 调用 5 次 工具调用 6 次 工具重试 0 次 总耗时 413s 最终状态 PASS 这一结果说明模型能够驱动 Hermes 完成多轮工具链任务,但单次成功不能等同于长期 Agent 可靠性统计。
4. 视觉能力
启用视觉组件并设置
vision_mode=auto后:任务 结果 耗时 纯红图片识别 PASS — RGB 三色带识别 PASS 2.5s 双框技术示意图 PASS 5.31s
三、模型质量:标准题集实测
本次使用五套标准题集,共 3,711 道题,考察数学、知识、科学推理及代码生成能力。测试使用本地固定题集和自定义评分脚本。
1. 题集及特点
题集 测试重点 GSM8K 多步骤数学应用题 MMLU 多学科知识与理解能力 GPQA 高难度科学知识与推理 AIME 2025 竞赛级数学推理 HumanEval Python 代码生成与实际执行 2. 已完成成绩
题集 Hipfire 27B MQ4-XTS 说明 GSM8K 1283/1319,97.3% 完整评分 MMLU 1773/2000,88.7% 固定 2000 题子集 GPQA 158/194,81.4% 198 题中 4 题未评分 AIME 2025 26/30,86.7% 4 题截断 HumanEval 153/164,93.3% 修正执行评分,Off 测试方法说明:
- temperature = 0
- 原始输出上限 = 16,384 tokens
- GPQA/AIME 部分原始截断题选择性以 32,768 tokens 补测
- 历史全量运行缺少逐请求思考档位记录
- 使用本地题集及自定义评测脚本
因此,GPQA 和 AIME 表中的成绩含有混合输出预算,不应理解成全部题目在完全统一的 16K 上限下取得。
四、这个27B模型思考档位差别有多大?Off、Low、Medium
为了观察开启思考后的收益,又进行了两组独立测试。
1. 60 题综合推理专项
包括数学、知识、科学推理及部分代码生成题。五道代码生成题没有在这一组执行评分。
指标 Off Low Medium 正确/有效评分 42/55 49/54 50/54 正确率 76.4% 90.7% 92.6% 中位耗时 1.6s 17.8s 15.4s P90 耗时 97.8s 85.2s 99.0s 中位 completion tokens 71 372 439 Off 到 Low 提升明显,Low 到 Medium 的正确率差距较小。
2. HumanEval 164 题完整测试
同一套 164 道编程题分别使用 Off、Low、Medium 生成,并用修正后的同一评分器执行。
指标 Off Low Medium 通过数 153 156 157 Pass@1 93.3% 95.1% 95.7% 中位耗时 0.79s* 2.69s 3.04s P90 耗时 1.46s* 5.20s 6.67s 中位 completion tokens 151 527 633 请求错误 0 0 0 输出截断 0 0 0 Off 耗时来自服务恢复后保存完整计时记录的 143 题,正确率按完整 164 题统计。
逐题比较:
对比 前者独胜 后者独胜 同分 Off vs Low 4 7 153 Off vs Medium 3 7 154 Low vs Medium 1 2 161 Low 比 Off 多通过 3 题,Medium 比 Low 再多通过 1 题。
Medium 的中位 completion tokens 比 Low 增加约 20%,中位耗时增加约 13%。
对于这组编程题,Low 显示出比较好的质量与耗时平衡。但独立函数生成不能代替长期 Agent 工程任务测试。
总体来看,模型质量符合一款 27B、约 4-bit 量化模型的正常预期水平。Hipfire 更突出的优势仍然是释放了7900XTX单卡推理性能并提高了实际运行效率。
五、实际案例:让 Hipfire 27B 画图、编程,做游戏
标准题集之外,还让模型生成一些可以直接在浏览器中查看和运行的作品。
这些测试更直观,也能暴露单纯选择题不容易发现的问题。
可视化 Agent 实战总结
最后使用 Hermes Agent,让 Hipfire 27B 完成四类可视化编程任务:模拟时钟、鹈鹕骑自行车、贪吃蛇游戏和动态太阳系。
每项分别请求 Off、Low、Medium 三档,共进行 12 项独立测试。
项目 Off Low Medium 模拟时钟 PASS(修复后) PASS PASS 鹈鹕骑自行车 PASS(两轮修复) PASS(修复后) PASS(修复后) 贪吃蛇游戏 PASS PASS PASS 动态太阳系 PASS(8 行星) PASS(6 行星) PASS(8 行星) 最终 12/12 项通过,成功率 100%。
这些作品均由 Hermes Agent 使用文件工具生成,并在离线 Chromium 中进行结构、视觉或功能验收。贪吃蛇的增长、计分、碰撞及重启逻辑通过测试;动态太阳系的行星运动、暂停、继续和速度调节同样通过。
需要说明,测试发送了不同的思考档位请求,但未获得实际生效档位的充分证明,因此不依据这 12 项结果判断 Off、Low、Medium 的真实性能差异。
这组结果主要说明:Hipfire 27B 已能够驱动 Hermes 完成具有一定复杂度的可视化开发任务,包括生成文件、调用工具和自主修复。
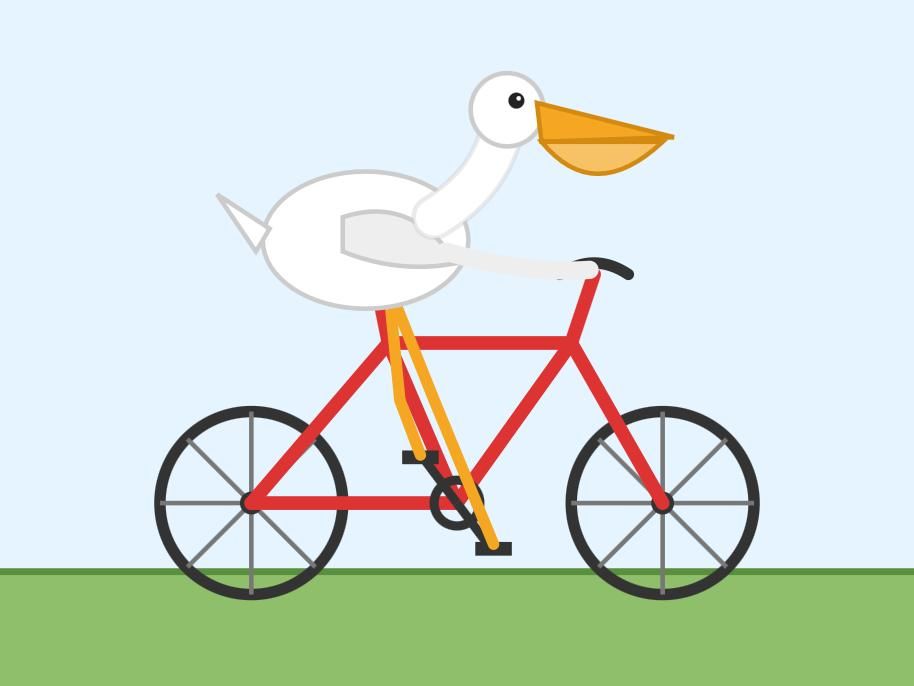
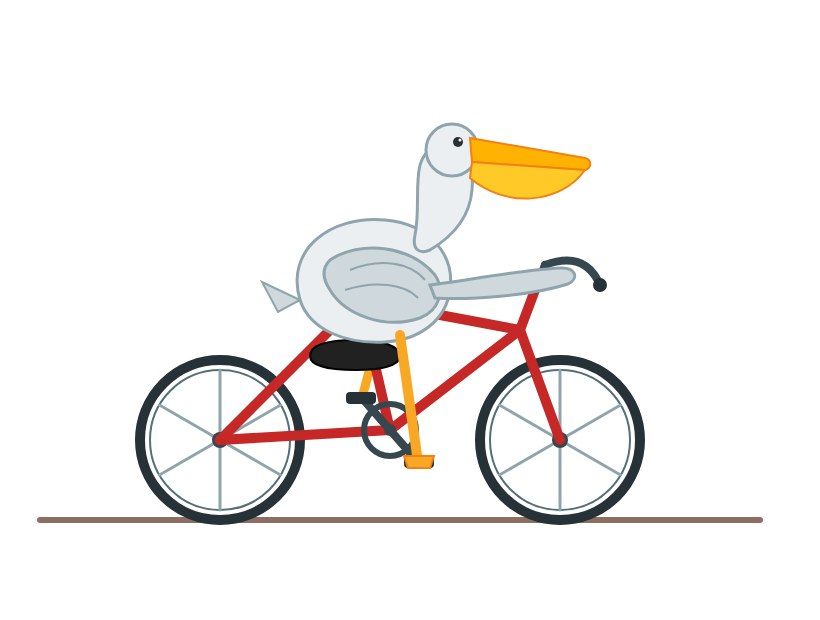
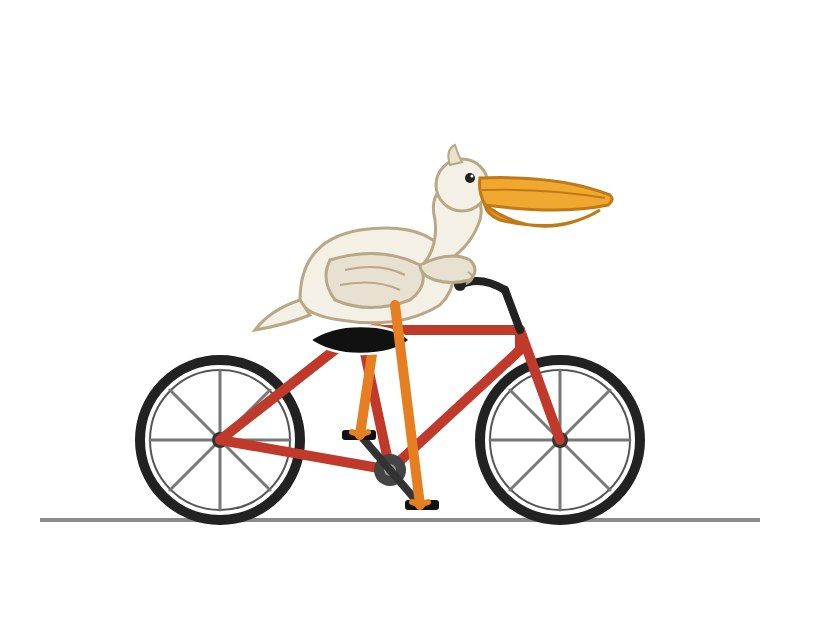
1. 鹈鹕骑自行车:SVG 与 HTML 动画
首先要求模型画一只骑自行车的鹈鹕。
静态 SVG 测试:
指标 Thinking Off Thinking Medium 生成耗时 13.65s 28.11s Completion tokens 2372 3942 文件大小 4617 B 4538 B 渲染 PASS PASS 两个版本都具备基本的鹈鹕与自行车结构。Medium 版本增加了更完整的车架、车座、双踏板与背景元素。
以下插图从上到下分别是 思考模式 off,low,medium
随后要求模型生成动态 HTML 页面。
指标 结果 生成耗时 44.98s Completion tokens 5578 HTML 大小 约 5.97 KB 外部依赖 无 SVG + JavaScript 是 Chromium 截帧 PASS 动画实现了车轮旋转、双腿踩踏板、车辆横向移动和鹈鹕身体轻微起伏。
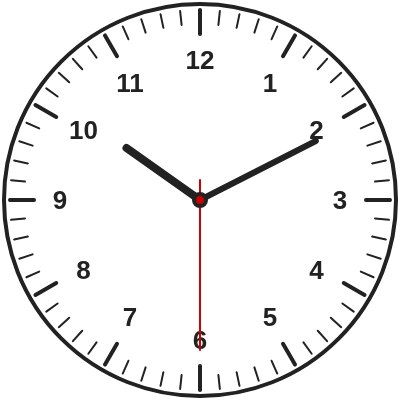
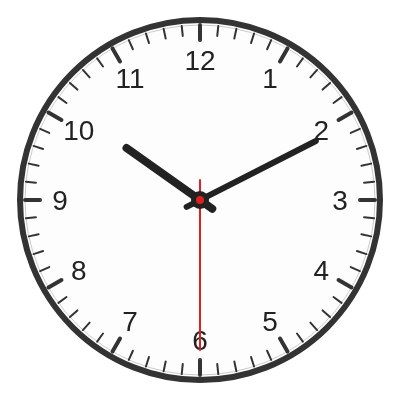
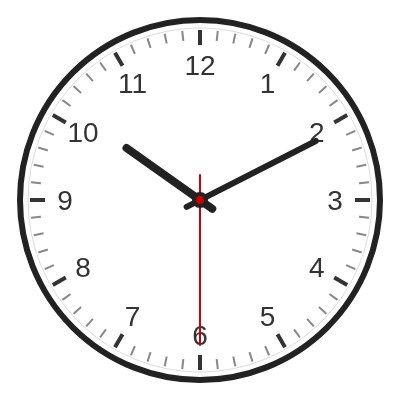
2. SVG 模拟时钟:10:10:30
让 Hermes Agent 生成一个带 12 个数字、60 个刻度以及时分秒三根指针的模拟时钟。
模型档位 最终结果 备注 27B Off PASS 修复后通过 27B Low PASS 144 秒,6 次文件工具调用 27B Medium PASS 结构和视觉检查通过 三个版本均已完成渲染验收。验收标准包括刻度数量、数字位置与指针角度。
3. 贪吃蛇:从代码到可玩的游戏
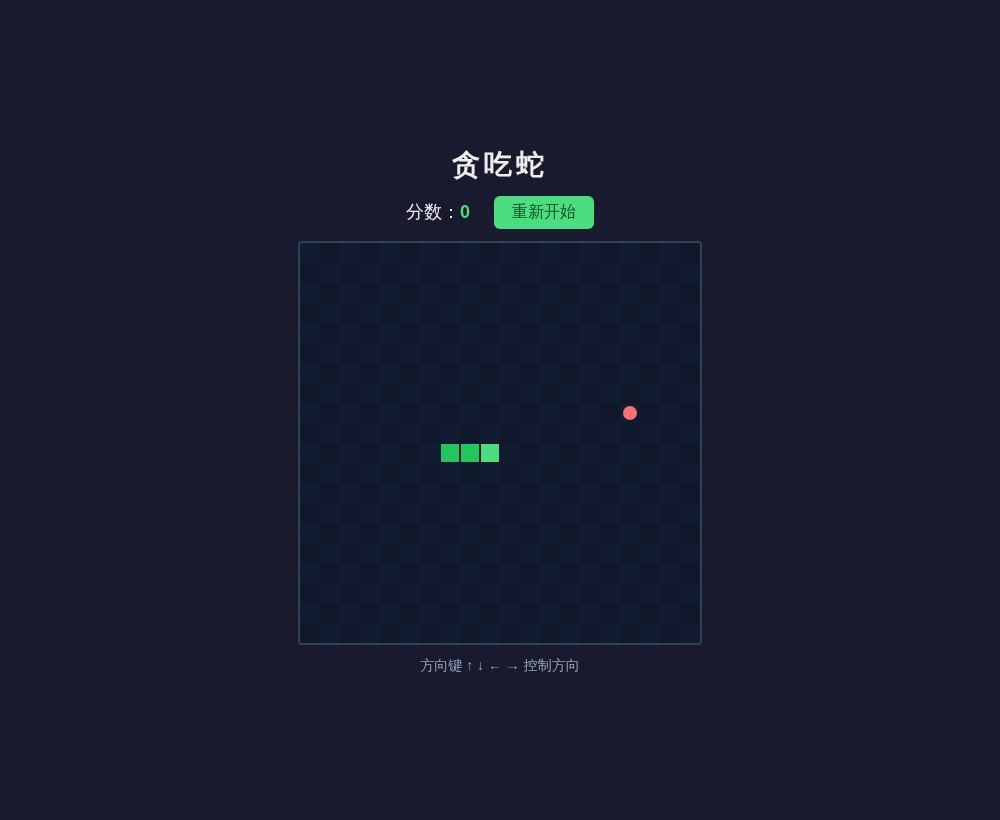
接下来是经典的 Snake 游戏。
要求生成单文件 HTML,支持方向键控制、随机食物、蛇身增长、得分、碰撞判断和重新开始。
指标 Off Low Medium 最终结果 PASS PASS PASS 总耗时 43s 125s 76.31s 工具调用 3 次 4 次 3 次 输出 tokens 3,784 4,012 7,609 离线 Chromium 验收确认两个版本的游戏逻辑能够运行。
测试为可重复验证碰撞与计分,采用手动推进游戏步进的方法,不作为真实连续帧率测试。
snake_27b_off.html
snake_27b_low.html4. 动态太阳系
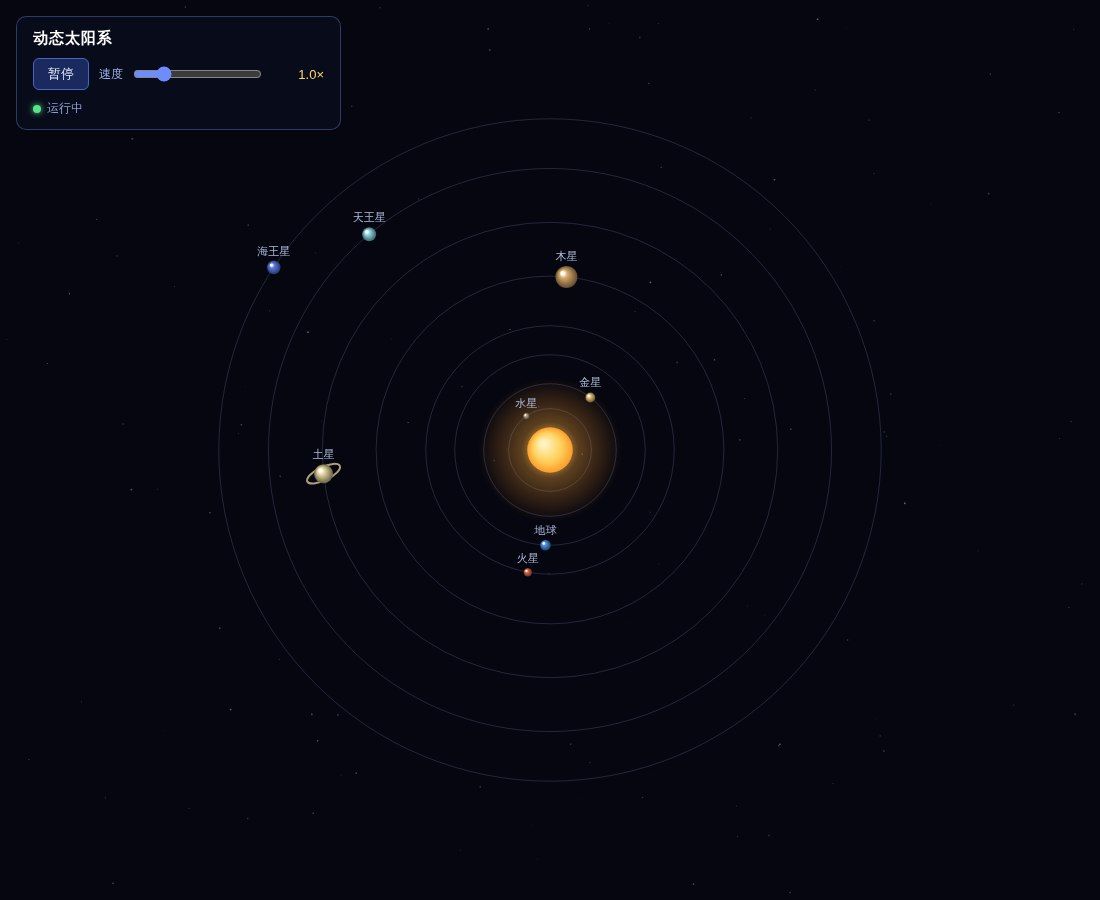
最后一项要求生成动态太阳系页面,包含多个行星、不同轨道半径与运动速度,以及暂停和速度调节功能。
27B_Off_Solar_System.html
27B_Low_Solar_System.html
27B_Medium_Solar_System.html注:搞笑啦,居然是思考off模式最好,图像好看,行星速度差值表现也靠谱的多。这道题上,开思考没带来更好的成品。
结语
从最初的 Prefill、Decode 性能测试,到生产环境部署、Hermes 工具调用、标准题集及实际编程作品,Hipfire 27B MQ4-XTS 在单张 RX 7900 XTX 上展现了相当完整的本地推理能力。
最有代表性的几个数字:
- 2682 t/s Prefill、169.4 t/s Decode:8K 上下文 DFlash 实测
- 160K:当前 Q8 KV 配置下的已验证长上下文长度 (据此我设的Hermes 192K 上下文, 75%压缩阈值。DSH则自用许多)
- 97.3% GSM8K、88.7% MMLU
- 93.3% / 95.1% / 95.7%:HumanEval Off / Low / Medium
- Hermes 工具调用、Coding/Debug、多轮任务和基础视觉均已通过验证
与此同时,长上下文显存边界、多并发能力、特定量化路径兼容性、服务异常及长期 Agent 稳定性仍存在明确的工程限制。
对 RX 7900 XTX 而言,Hipfire 的价值不只是某一个 Benchmark 数字,而是通过针对 gfx1100 的软件优化,让一张 24GB RDNA3 显卡在速度、模型质量和实际应用之间取得了新的平衡。
-
🎉 恭喜 @kos-or 晋升「至尊王者」! -
7900 XTX 的可能性探索|单卡篇(五):与时俱进!hipfire DFlash 实测 Qwen3.8-27B MQ4-XTS:8K Decode 169.4 tok/s,Prefill 2682 tok/s -
7900 XTX 的可能性探索|单卡篇(五):与时俱进!hipfire DFlash 实测 Qwen3.8-27B MQ4-XTS:8K Decode 169.4 tok/s,Prefill 2682 tok/s -
strata并发成功,双7900xtx , 单流70-80token/s , 双流聚合 160 token/s@applejuice 收到。确实是这样的,我用了一阵子发现两个模型还是各有特点,可以结合起来使用,互为补充。
-
strata并发成功,双7900xtx , 单流70-80token/s , 双流聚合 160 token/s@applejuice 这个图应该怎么解读?27B跟GPT5.6 能力区间这么接近吗?
-
7900 XTX 的可能性探索|单卡篇(五):与时俱进!hipfire DFlash 实测 Qwen3.8-27B MQ4-XTS:8K Decode 169.4 tok/s,Prefill 2682 tok/s -
7900 XTX 的可能性探索|单卡篇(五):与时俱进!hipfire DFlash 实测 Qwen3.8-27B MQ4-XTS:8K Decode 169.4 tok/s,Prefill 2682 tok/s -
7900 XTX 的可能性探索|单卡篇(五):与时俱进!hipfire DFlash 实测 Qwen3.8-27B MQ4-XTS:8K Decode 169.4 tok/s,Prefill 2682 tok/s7900 XTX 的可能性探索|单卡篇(五):与时俱进!hipfire DFlash 实测 Qwen3.8-27B MQ4-XTS:8K Decode 169.4 tok/s,Prefill 2682 tok/s
前言/致谢
首先真心感谢 hipfire 团队为 AMD / RDNA 社区做出的贡献。(还有hipEngine,BridgeSpec,llama-cpp-rdna-boosts,KVMem,MoE4All,AMD-AIM / sglang-radeon,Paiton vLLM plugin,以及更多长期为 AMD 本地 AI 推理生态默默投入时间和精力的开发者、研究者和社区大神们)
项目地址:https://github.com/warpfront/hipfire
最近感受到了来自于N卡阵营满满的“敌意”
 ,尤其是类似于nInfer这类的定向优化让我“醋意满满”(其实我也有N卡,哈哈);甚至RDNA4 PRO R9700的优化也一日千里 —— 这个真么有,曾经买过一块又让我给退了,各种羡慕嫉妒恨。

昨天终于等到了 hipfire 的更新。连夜在单张 RX 7900 XTX 上测试 Qwen3.8-27B,hipfire DFlash 的表现惊艳,也让我感觉7900XTX终于又可以扬眉吐气,与时俱进了。

测试摘要
参考我之前关于本地模型测速口径的帖子:https://lcz.me/topic/2303
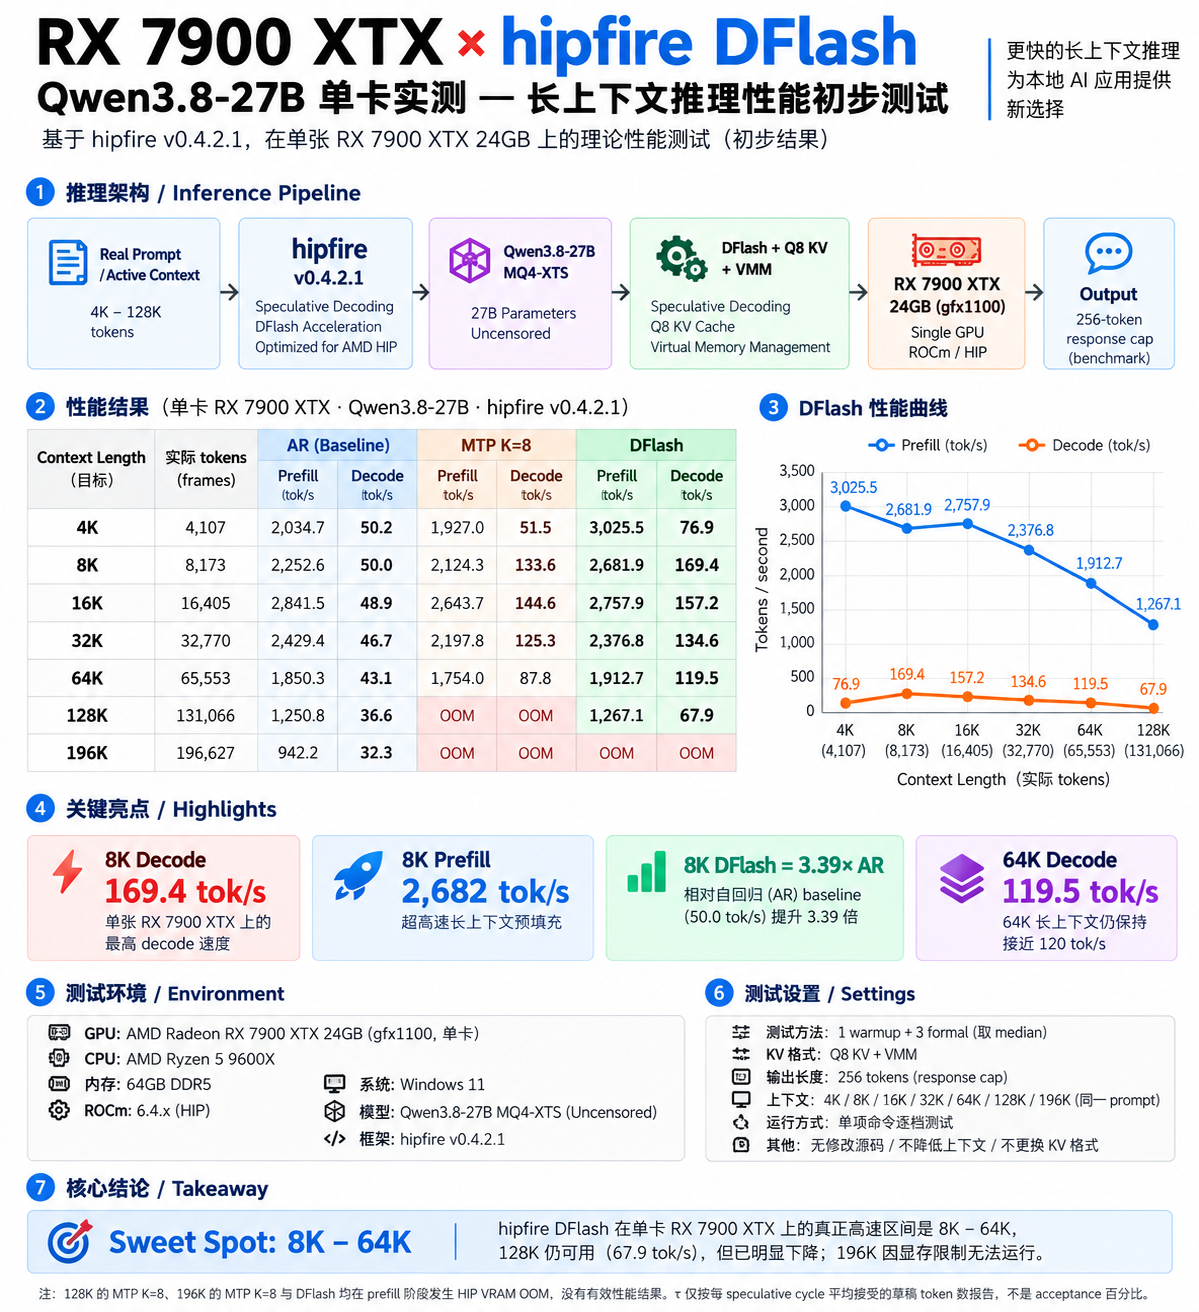
Model Quant Engine GPU Context Output C Cache Prefill TTFT Decode VRAM Qwen3.8-27B MQ4-XTS hipfire DFlash RX 7900 XTX ×1 4K 256 C1 Cold 3026 1.36s 76.9 ~17.5GB Qwen3.8-27B MQ4-XTS hipfire DFlash RX 7900 XTX ×1 8K 256 C1 Cold 2682 3.05s 169.4 ~17.9GB Qwen3.8-27B MQ4-XTS hipfire DFlash RX 7900 XTX ×1 16K 256 C1 Cold 2758 5.95s 157.2 ~17.6GB Qwen3.8-27B MQ4-XTS hipfire DFlash RX 7900 XTX ×1 32K 256 C1 Cold 2377 13.79s 134.6 ~17.6GB Qwen3.8-27B MQ4-XTS hipfire DFlash RX 7900 XTX ×1 64K 256 C1 Cold 1913 34.27s 119.5 ~17.7GB Qwen3.8-27B MQ4-XTS hipfire DFlash RX 7900 XTX ×1 128K 256 C1 Cold 1267 103.44s 67.9 ~17.9GB Qwen3.8-27B MQ4-XTS hipfire DFlash RX 7900 XTX ×1 196K 256 C1 Cold OOM OOM OOM OOM Highlights
- 8K:2682 tok/s Prefill + 169.4 tok/s Decode
- 32K:2377 tok/s Prefill + 134.6 tok/s Decode
- 64K:1913 tok/s Prefill + 119.5 tok/s Decode
- 8K DFlash 相对 AR:3.39×
- 高速甜点区:8K–64K
叠甲:本帖首先看的是推理引擎本身的 Cold Context 性能,不代表长期 Agent 的最终实际体验。实际 Agent 测试会另开一帖。
一、测试环境
项目 设置 GPU AMD Radeon RX 7900 XTX 24GB ×1 GPU Arch gfx1100 模型 Qwen3.8-27B Quant MQ4-XTS Engine hipfire v0.4.2.1 KV Cache Q8 VMM Enabled Speculative DFlash Output Length 256 tokens Concurrency C1 Cache Cold / 无跨请求 Prefix Cache 命中 Warm-up 1 Formal Runs 3 / 档 结果 Formal median 注:同一 Context 档三条路线使用完全相同的 Prompt;表中 Actual Prompt 为 hipfire daemon 最终报告的 framed prompt_tokens。
二、DFlash 单卡完整结果
Context Actual Prompt Prefill TTFT Decode τ¹ VRAM sampled peak 4K 4,107 3,025.5 tok/s 1.36 s 76.9 tok/s 6.00 约 17.5 GB 8K 8,173 2,681.9 tok/s 3.05 s 169.4 tok/s 8.80 约 17.9 GB 16K 16,405 2,757.9 tok/s 5.95 s 157.2 tok/s 8.80 约 17.6 GB 32K 32,770 2,376.8 tok/s 13.79 s 134.6 tok/s 8.80 约 17.6 GB 64K 65,553 1,912.7 tok/s 34.27 s 119.5 tok/s 11.25 约 17.7 GB 128K 131,066 1,267.1 tok/s 103.44 s 67.9 tok/s 8.80 约 17.9 GB 196K 196,627 OOM OOM OOM N/A N/A ¹ τ(tau)为 官方hipfire daemon 报告的“每个 speculative cycle 平均接受的草稿 token 数”。数值越高,通常表示 speculative decoding 一次能连续接受更多草稿 token,但它 不等同于 acceptance rate,也不是 acceptance 百分比。
三、AR / MTP / DFlash 横向对比
为了看清 speculative decode 到底带来了多少提升,我同时测试了普通 AR 和 Native MTP K=8。
Decode
Context AR Decode MTP K=8 Decode DFlash Decode 4K 50.2 51.5 76.9 8K 50.0 133.6 169.4 16K 48.9 144.6 157.2 32K 46.7 125.3 134.6 64K 43.1 87.8 119.5 128K 36.6 OOM 67.9 196K 32.3 OOM OOM Prefill
Context AR Prefill MTP K=8 Prefill DFlash Prefill 4K 2,034.7 1,927.0 3,025.5 8K 2,252.6 2,124.3 2,681.9 16K 2,841.5 2,643.7 2,757.9 32K 2,429.4 2,197.8 2,376.8 64K 1,850.3 1,754.0 1,912.7 128K 1,250.8 OOM 1,267.1 196K 942.2 OOM OOM 几个比较明显的现象:
- AR 的基础 Decode 随 Context 增长下降得比较平缓;
- MTP 在 128K 已经因为 VRAM OOM 无法完成;
- DFlash 在 128K 仍然能维持 67.9 tok/s;
- 到 196K,MTP 和 DFlash 都在 Prefill 阶段 OOM,只有 AR 仍能运行;
- DFlash 的优势最明显地集中在 8K–64K;
- Prefill 并不是所有档位都由 DFlash 领先,16K 和 32K 的 AR Prefill 略高,但 DFlash 的整体 Decode 优势非常明显。
四、长上下文表现
从实测来看,我会把这套 DFlash 的高速甜点区暂时定在:
8K–64K
其中:
- 8K:169.4 tok/s
- 16K:157.2 tok/s
- 32K:134.6 tok/s
- 64K:119.5 tok/s
尤其是 64K,单卡 RX 7900 XTX 仍然可以做到:
1913 tok/s Prefill + 119.5 tok/s Decode
我认为这一点比单纯的 8K 峰值更有意义。
128K 仍然可以正常运行:
1267 tok/s Prefill + 67.9 tok/s Decode
不过从 64K 到 128K 已经出现明显掉速。
196K 下 DFlash 在 Prefill 阶段发生 HIP VRAM OOM,因此没有有效性能结果。本轮也没有通过降低 KV 精度、修改量化格式或源码来进一步压缩显存。实际生产环境里,可以把 Agent 的最大上下文限制在一个低于 OOM 边界的值;目前已确认 128K 可以正常运行,128K–196K 之间的具体安全上限后续还可以继续摸索,配合合理的 Context 压缩机制即可避免 Agent 撞上显存墙。
五、关于 τ、VRAM 和测试口径
这里特别说明几个口径问题。
1. τ 不是 Acceptance Rate
hipfire daemon 报告的 τ 是:
每个 speculative cycle 平均接受的草稿 Token 数
它不是 Acceptance 百分比。
当前
hipfire bench汇总 JSON 没有提供 drafted / accepted 的原始总数,因此本文不推算 Acceptance Rate。2. VRAM 是采样参考值
本文 VRAM 来自 hipfire daemon 遥测采样中的最大值。
它可以作为不同配置之间的参考,但:
不是独立高频显存监控得到的绝对峰值。
3. 测试是 Cold Context
这次主要测试模型和推理引擎本身的性能。
没有依赖 Radix Cache、Prefix Cache 或类似 KVMem 的跨请求上下文复用机制。
因此这些结果更接近:
一次新的真实 Prompt 送进模型后,Engine 本身能够做到什么速度。
这一点对后续 Agent 实测非常重要。
因为真实长期 Agent 场景下,除了 Prefill 和 Decode,本质上还要看:
- Prefix reuse
- Cache hit
- 多轮历史复用
- Tool latency
- 整体任务 wall time
这也是我准备下一篇实际使用测试重点看的内容。
六、部署与启动参数
参见附件:
7900 XTX 的可能性探索 单卡篇(五) 之 部署与启动参数.md
七、最后的说明和一点个人感想
单张 RX 7900 XTX,在 hipfire 的专项优化下,Qwen3.8-27B 的跑分表现达到了我历次 7900 XTX 单卡测试中的新高度。
从 Benchmark 看,目前数字确实相当惊艳:
8K Decode 169.4 tok/s,64K 仍有 119.5 tok/s;8K Prefill 2682 tok/s。
不过 Benchmark 成绩当然不等于真实生产体验。
本帖首先测试的是 Cold Context 下推理引擎本身的性能。下一步我会把这套模型真正接入 Agent 工作流,再单独分享实际使用中的表现,包括:
- Tool Calling
- Coding / Debug
- 多轮任务
- 实际任务完成时间
- 长上下文下的响应体验
- Prefix / Cache 缺失对实际 Agent 的影响 (注:官方已经有 PR 在提升 Prefix/Cache)
- 与我目前另一套单卡 FN IQ3 Agent 方案进行 A/B 对比
到时候再继续更新。
个人一点感想
先看看 RX 7900 XTX 和 RTX 3090 的硬件底子:
规格 RX 7900 XTX RTX 3090 架构 RDNA 3 / Navi 31 Ampere / GA102 显存 24GB GDDR6 24GB GDDR6X 显存位宽 384-bit 384-bit 显存带宽 960 GB/s 936 GB/s FP32 约 61.4 TFLOPS 约 35.6 TFLOPS PCIe PCIe 4.0 ×16 PCIe 4.0 ×16 TBP / TGP 355W 350W AI 软件生态 ROCm / HIP CUDA 两张卡都有 24GB 显存、384-bit 总线、接近 1TB/s 的显存带宽,功耗也处于同一级别。
7900 XTX 的硬件规格本身一直不弱。过去在本地 AI 推理上的主要差距,更多来自 CUDA、Tensor Core,以及 NVIDIA 阵营长期积累的 AI kernel 和软件生态。
所以这次 hipfire 最让我欣慰的地方,是:
终于开始有软件真正把 RDNA3 本身的硬件潜力往 AI 推理方向挖出来。
Newegg 当前新卡价格参考
GPU Newegg 当前可见价格 备注 RX 7900 XTX 24GB 约 $1,399–$1,499 新卡 RTX 3090 24GB 约 $2,099–$2,399 多为老库存 / 第三方卖家 这里比较的是 当前 Newegg 新卡挂牌价,不能代表二手市场。
3090 有 NVLink 和成熟 CUDA 生态的天然优势;7900 XTX 则胜在仍有新卡保修、24GB 显存,以及相对更低的新卡价格。
而随着 Strata 的应运而生,以及 hipfire 这类面向 RDNA3 的专项优化逐渐成熟,7900 XTX 的 24GB 显存、接近 1TB/s 的显存带宽,也终于开始越来越充分地转化为实际的本地 AI 推理性能。
这也是我持续更新这个“7900 XTX 的可能性探索”系列的动力之一:把自己的折腾和测试结果分享出来,回报论坛和社区,也顺便看看这张卡的潜力究竟还能被挖到哪里。
无它,不是哥们买不起(

 ),而是折腾7900 XTX 更有性价比。
-
AI大爆发时代,本地模型和推理到底该怎么测速?——一个 GitHub 搬运工的抛砖引玉 -
AI大爆发时代,本地模型和推理到底该怎么测速?——一个 GitHub 搬运工的抛砖引玉根据Wang大的建议,修改MD再上传看效果
-
AI大爆发时代,本地模型和推理到底该怎么测速?——一个 GitHub 搬运工的抛砖引玉@Tony-Wang 学习了
-
AI大爆发时代,本地模型和推理到底该怎么测速?——一个 GitHub 搬运工的抛砖引玉@stxpnet 试试看这个能正常打开不,有问题跟我讲哈。
-
AI大爆发时代,本地模型和推理到底该怎么测速?——一个 GitHub 搬运工的抛砖引玉常用指标与术语
缩写 英文全称 中文解释 主要看什么 PP Prompt Processing 提示词处理 / Prefill 模型处理输入上下文的速度,通常以 tok/s 表示 TG Text Generation 文本生成 / Decode 模型持续生成输出 Token 的速度,通常以 tok/s 表示 TTFT Time To First Token 首 Token 延迟 从发出请求到收到第一个输出 Token 的时间 TPOT Time Per Output Token 平均每个输出 Token 的耗时 反映持续生成阶段的平均延迟,通常以 ms/token 表示 ITL Inter-Token Latency Token 间延迟 相邻流式输出之间的时间间隔,用于观察卡顿和尾延迟 TPS Tokens Per Second 每秒 Token 数 模型每秒生成多少 Token E2E End-to-End Latency 端到端总耗时 从请求发出到完整响应结束的总时间 C1 / C2 / C4 / C8 Concurrency 1 / 2 / 4 / 8 并发数 1 / 2 / 4 / 8 同时存在多少个推理请求 QPS / RPS Queries / Requests Per Second 每秒请求数 Serving 场景下单位时间能处理多少请求 Goodput Goodput 有效吞吐量 在满足延迟或 SLO 要求前提下真正有效完成的吞吐量 VRAM Video Random Access Memory 显存占用 模型、KV Cache 和推理过程占用多少 GPU 显存 简单理解:**PP 看“吃得快不快”,TTFT 看“多久开口”,TG/TPS 看“说得快不快”,ITL 看“会不会卡”,E2E 看“整件事多久做完”。
引言
今年 AI 大爆发,各种新模型、推理框架和新玩法层出不穷。
作为一个非技术专业的 AI 爱好者,我很依赖论坛里的实测数据来减少自己摸索和试错的时间。但看得越多,也越发现一个问题:
大家测速的口径并不统一。
很多时候,如果只看到一句——特别是视频网站里为了吸引眼球的标题:这个模型跑到了150 t/s
但不知道:
- Prefill 还是 Decode?
- Context 多长?
- Output 多长?
- Cache 有没有命中?
- Concurrency 是多少?
这个数字其实很难横向比较。
甚至我自己不同时期测出来的数据,Agent 都会时不时提醒我:
测试口径不同,不能直接横向比较。
于是我认真找了一圈现成方案,发现 GitHub 上其实已经有几套相当成熟的 测速Benchmark。
所以我的想法变成了:
完全没必要自己重新发明一套“大一统标准”,而应该根据不同测试目的,直接引用成熟工具。
结论先行
先看自己想测什么,再选择对应 Benchmark。
测 GPU / 量化 / Kernel 裸性能
→ llama.cpp / llama-bench

测 OpenAI API / 实际聊天体验
→ GuideLLM

测多并发 / Serving / 饱和点
→ Kubernetes SIG inference-perf

测最终客户端体验
→ MLPerf Client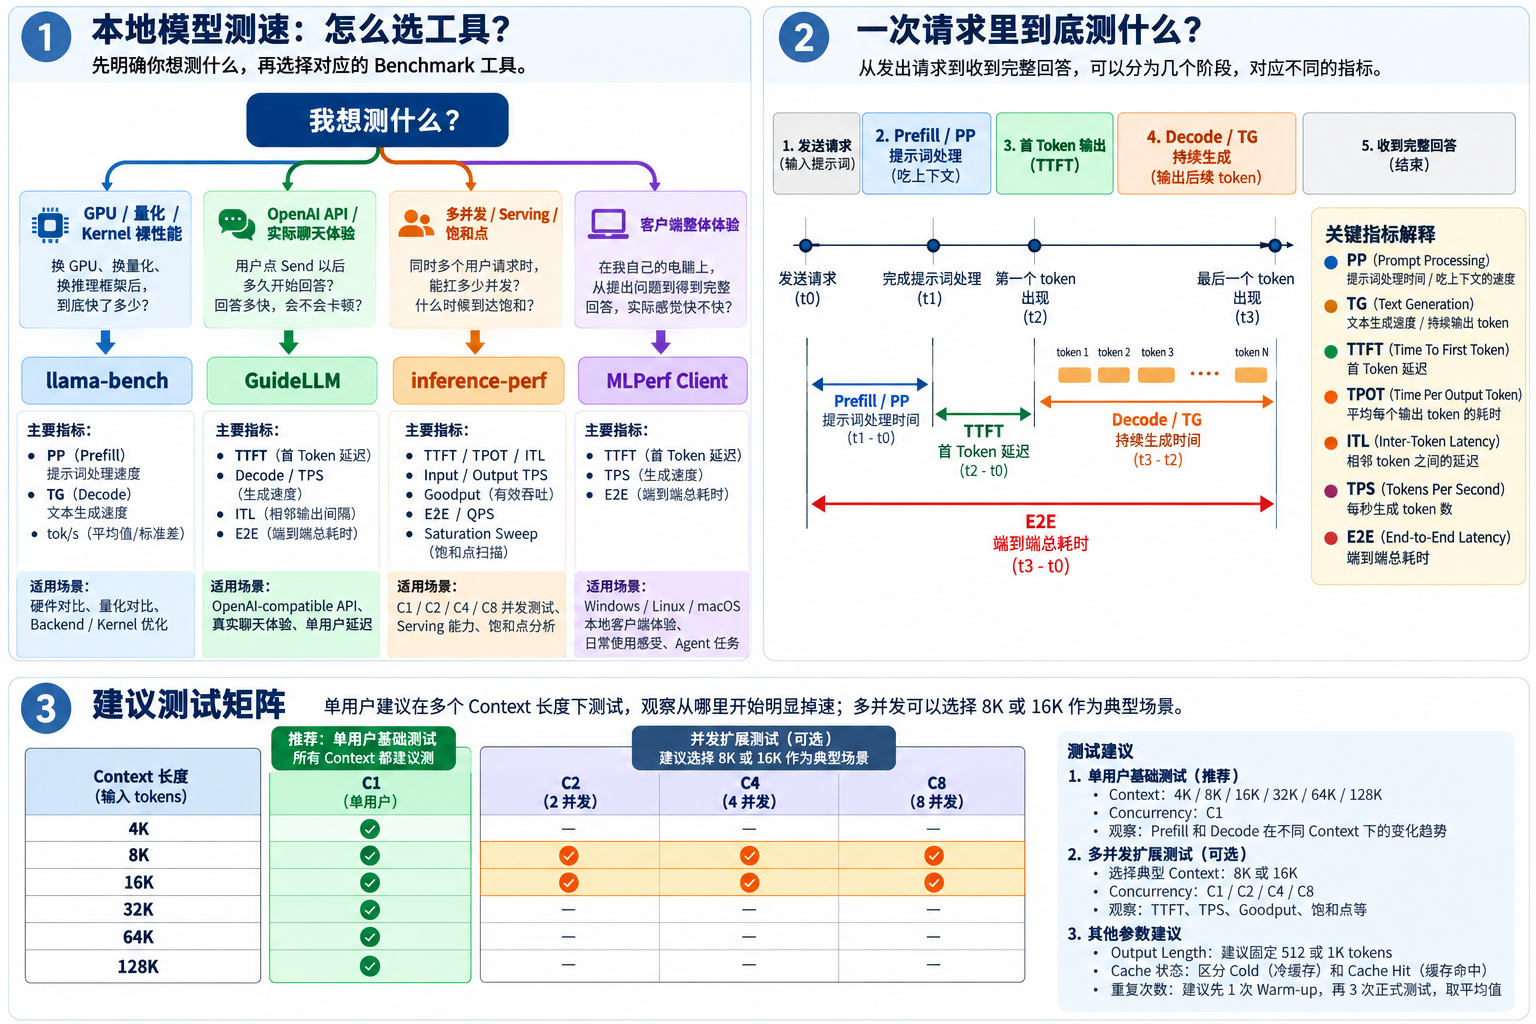
1. 裸性能:llama-bench
llama.cpp官方的llama-bench,本身就明确区分:- PP:Prompt Processing
- TG:Text Generation
支持指定 Context Depth、重复测试,并报告平均 tok/s 和标准差;默认每项重复 5 次。官方还明确说明,它不把 tokenization 和 sampling 时间计入测试。
GitHub:
llama.cpp / llama-benchhttps://github.com/ggml-org/llama.cpp/tree/master/tools/llama-bench
所以如果只是想知道:
换了 GPU、量化、Backend、Kernel 后,到底快了多少?
我觉得直接用
llama-bench最合适。报告范例
Context PP / Prefill TG / Decode VRAM 4K 3,250 tok/s 101.2 tok/s 40.8GB 8K 3,180 tok/s 100.1 tok/s 41.3GB 16K 3,020 tok/s 98.7 tok/s 42.2GB 32K 2,850 tok/s 96.4 tok/s 44.2GB 64K 2,510 tok/s 91.8 tok/s 46.0GB 128K 2,020 tok/s 82.5 tok/s 47.1GB 测试环境:
项目 设置 模型 Qwen3.8-27B 量化 Q4_K_M 推理框架 llama.cpp GPU RX 7900 XTX 24GB ×2 CPU Ryzen 5 9600X 内存 64GB Backend ROCm Output 512 tokens 重复次数 5
2. API / 实际使用:GuideLLM
GuideLLM 是 vLLM 项目下的独立 Benchmark 工具,主要面向真实 LLM Deployment 测试,支持不同 Backend、Dataset、Metrics 和输出格式。
GitHub:
GuideLLMhttps://github.com/vllm-project/guidellm
这类测试更适合看:
TTFT
Decode / TPS
TPOT
ITL
E2E
也就是:
用户点 Send 以后多久开始回答、回答多快、会不会卡顿。
报告范例
Context TTFT Decode / TPS TPOT ITL P50 ITL P99 E2E VRAM 4K 0.21s 121 tok/s 8.3ms 8.1ms 12.4ms 4.5s 41.0GB 8K 0.34s 120 tok/s 8.3ms 8.2ms 13.1ms 4.7s 41.8GB 16K 0.84s 118 tok/s 8.5ms 8.3ms 14.7ms 5.2s 43.0GB 32K 1.61s 113 tok/s 8.8ms 8.7ms 17.9ms 6.1s 44.7GB 64K 3.42s 104 tok/s 9.6ms 9.4ms 23.8ms 8.4s 46.1GB 128K 7.10s 91 tok/s 11.0ms 10.7ms 35.2ms 13.0s 47.3GB 测试条件:
项目 设置 Output Length 512 tokens Concurrency C1 Requests 10 / 档 Warm-up 1 Cache Cold API OpenAI-compatible
3. 多并发 / Serving:inference-perf
Kubernetes SIG 的
inference-perf更进一步,本身就是为了标准化推理 Benchmark 工具和指标。它直接支持:
TTFT
TPOT
ITL
Input / Output TPS
Goodput
并发 / QPS
Saturation Sweep
并支持 vLLM、SGLang、TGI 和 OpenAI-compatible Endpoint。
GitHub:
Kubernetes SIG / inference-perfhttps://github.com/kubernetes-sigs/inference-perf
如果测:
C1 / C2 / C4 / C8或者想知道一台机器到底能扛多少并发,我觉得直接用这个更合适。
报告范例
固定一个典型 Context,例如 8K 或 16K:
Concurrency TTFT Output TPS TPOT ITL P99 Goodput 备注 C1 0.42s 121 8.3ms 13ms 100% 正常 C2 0.51s 214 9.4ms 17ms 100% 正常 C4 0.93s 318 12.6ms 31ms 96% 基本稳定 C8 2.70s 352 22.8ms 86ms 71% 明显排队 测试条件:
项目 设置 Context 8K Output 512 tokens Cache Cold Test Duration 60s / 档 推理引擎 vLLM GPU RX 7900 XTX ×2 测试结论:
项目 结果 推荐稳定并发 C4 饱和区间 C4–C8 最大吞吐 352 output tok/s 明显排队开始 C8
4. 最终用户体验:MLPerf Client
MLPerf Client 是 MLCommons 面向个人电脑和客户端 AI 推理的 Benchmark,支持 Windows、Linux、macOS,也覆盖 LLM、本地硬件和不同 Execution Backend 的测试。
GitHub:
MLPerf Clienthttps://github.com/mlcommons/mlperf_client
这类测试更接近:
最终用户实际感觉到底快不快。
报告范例
项目 结果 设备 Desktop PC 操作系统 Windows 11 CPU Ryzen 5 9600X GPU RX 7900 XTX 内存 64GB Backend / Execution Provider 本地执行 Warm-up 1 Iterations 5 TTFT 0.61s TPS 82.7 tok/s E2E 7.1s 峰值 VRAM 22.6GB
那论坛大家发帖分享什么?
我个人的想法是,不管用了哪一种 Benchmark,至少把下面这些信息写出来:
类别 项目 硬件 GPU / CPU / 内存 / 主板 模型 模型名 / 量化 / 推理引擎 测试条件 Context / Output Length / Concurrency / Cache 状态 结果 Prefill / TTFT / Decode / VRAM 如果用了 MTP / Speculative Decoding,再加:
项目 结果 Acceptance Rate Accepted Tokens
Context 建议
单用户测试,我比较倾向:
4K / 8K / 16K / 32K / 64K / 128K这样不仅能看到“最高速度”,还能观察:
Context 从哪里开始明显掉速。
并发则不一定每个 Context 都跑,可以单独选一个典型 Context,比如 8K 或 16K:
C1 / C2 / C4 / C8
摘要表
无论用哪套 Benchmark,一张摘要应该是大家喜闻乐见的:
模型 Quant Engine GPU Context Output C Cache Prefill TTFT Decode VRAM Qwen3.8-27B W8A8 SGLang 7900 XTX ×2 4K 512 C1 Cold 3,250 t/s 0.22s 122 t/s 41GB Qwen3.8-27B W8A8 SGLang 7900 XTX ×2 8K 512 C1 Cold 3,180 t/s 0.35s 121 t/s 42GB Qwen3.8-27B W8A8 SGLang 7900 XTX ×2 16K 512 C1 Cold 2,900 t/s 0.84s 118 t/s 43GB Qwen3.8-27B W8A8 SGLang 7900 XTX ×2 32K 512 C1 Cold 2,730 t/s 1.62s 113 t/s 45GB Qwen3.8-27B W8A8 SGLang 7900 XTX ×2 64K 512 C1 Cold 2,410 t/s 3.41s 104 t/s 46GB Qwen3.8-27B W8A8 SGLang 7900 XTX ×2 128K 512 C1 Cold 1,980 t/s 7.08s 91 t/s 47GB 这样即使后面的完整报告格式不同,最关键的数据仍然可以快速横向比较。
总之
本地模型测速可以不需要重新发明 Benchmark。更合理的做法,是根据不同场景和需求直接引用成熟工具,再用大家喜闻乐见的基本格式分享成果。
具体怎么跑,请参见附件:
《本地模型测速一键执行指南》
本地模型测速一键执行指南_SOP完整版_2026-10-13.md
其中分别提供:
llama-bench
GuideLLM
inference-perf
MLPerf Client
的一键复制 Agent Prompt 和测试模板,其中也结合了本人在实际测试中的一些经验教训。。
友情提示:网络下载任何文件,请注意安全。
本文仅分享一些个人对本地模型测速的思考,暂不涉及模型质量评测部分。抛砖引玉,欢迎大家补充、指正和交流。
2026-10-13
-
🎉 恭喜 @imbiplaza-asus 晋升「谪仙人」!@imbiplaza-asus 恭喜恭喜,飞升大吉!
 祝贺祝贺
