跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
Botio KuoB

Botio Kuo

@Botio Kuo
体面乡绅 硕果累累
取消关注 关注
关于
帖子
55
主题
3
分享
0
群组
2
粉丝
0
关注
0

帖子

最新 最佳 有争议的

  • 大家有没有感觉 deepseek-v4.1-flash 最近降智严重
    Botio KuoB Botio Kuo
    随便聊聊 deepseek

    grok 4.7 也是比 4.5 蠢很多。。。 新版本不一定更好,就跟新对象一样


  • Qwen3.8 27B, 单卡也可以跑191 tok/s : 一套优化到极致的部署与实测
    Botio KuoB Botio Kuo
    LLM讨论区 rtx3090 qwen-27b vllm

    @johnnybegood git pull 更新了 好像真的有快一点点 感谢告知


  • # X99 洋垃圾 + 双 R9700 翻车实录:单卡 39 t/s 稳跑 27B,双卡一满载就断电,1300W 电源也救不了
    Botio KuoB Botio Kuo
    AI硬件 x99 r9700 多卡部署

    DELL 这种工作站 基本上跑原装配置都稳的一批,但换个卡还是说加个PCIE卡就容易不稳,他不但电源功率有限制,常常连BIOS那边就开始锁最大功率限制,要排查的地方很多,洋垃圾还是建议HP 还是其他品牌机器,DELL 有些还有订制的主机板,那孔位一言难尽


  • 3090 24G 单卡部署 Qwen3.8-27B
    Botio KuoB Botio Kuo
    AI硬件 rtx3090 qwen-27b

    @fafafa … 阿就丢那个 GITHUB 给 hermes 搞定阿,里面都说有HUGE的选项了不是吗? 为啥要自己设定? = =??? 就让AI 自己去DEBUG 就行了,真的不难


  • Qwen3.8-27B 关掉推理~效率快太多 成果差不多
    Botio KuoB Botio Kuo
    LLM讨论区 qwen-27b

    @terry 是的,现在已经走 less is more 的路线了, skill 太多 废话太多 都是负担, 现在越聪明的MODEL 越不需要太多额外的提示词,只要给明确的目标,途中不要走歪就好,一开始MAP的路线非常重要,现在个人训练出的 harness 是让自己更好用,所以插件类型的 harness 才会更受欢迎,AI方向一直在变,新的MODEL 最好就不要套用旧版的SKILL跟负担,后面需要在慢慢增加就好,省钱又省时间


  • Qwen3.8-27B 关掉推理~效率快太多 成果差不多
    Botio KuoB Botio Kuo
    LLM讨论区 qwen-27b

    @neo 有一说一 还是要看你拿来的用途 跟 搭配的 harness , 差异确实不小。。。workflow 跟 一些边界没写好,推理再久还是错


  • Qwen3.8-27B 关掉推理~效率快太多 成果差不多
    Botio KuoB Botio Kuo
    LLM讨论区 qwen-27b

    @kop-wang 是的,但我现在实作的过程中,我不觉得那个分数值得更多的时间。。。 效果真的差不多,这MODEL 思考时间真的太长了。。。


  • Qwen3.8-27B 关掉推理~效率快太多 成果差不多
    Botio KuoB Botio Kuo
    LLM讨论区 qwen-27b

    推理真的没你想像中的有用 至少在我使用的过程中制造不少问题

    使用的 syv-ai/qwen38-27b-rtx3090, 单卡3090长上下文 240k 设置, 不是在 VLLM 设定关闭推理

    而是在 omp agent harness 上关闭推理 直接设定 off, coding 部分成果差不多 該錯還是會錯,但省下的時間跟上下文真的太多!
    我测试的这专案也不单纯,是在原生开源的基础上新增 herdr 的对接 跟 灯光效果设定,在硬体测试上至少错了五次(但这是AI本身就没办法克服的硬件韧体测试,一定要有人类观察结果反餽),所以结论建议:性子急的可以关掉推理了! 真的快太多!

    测试专案 repo:https://github.com/botio/duckyPad-herdr/


  • deepseek-v4-flash还是猛啊!
    Botio KuoB Botio Kuo
    随便聊聊 deepseek

    有一说一 我也是用过 DEEPSEEK V4 之後 才觉得 AI 真的能干点事。。。 之前都觉得太难用 不然就是太贵了


  • 【一个Agent两个大语言模型,一个学徒工,一个老师傅】
    Botio KuoB Botio Kuo
    LLM讨论区 deepseek gpt gemini

    @George-Suen 说到底 都是口袋深度问题 。。。 不是 AGENT 的问题


  • 【一个Agent两个大语言模型,一个学徒工,一个老师傅】
    Botio KuoB Botio Kuo
    LLM讨论区 deepseek gpt gemini

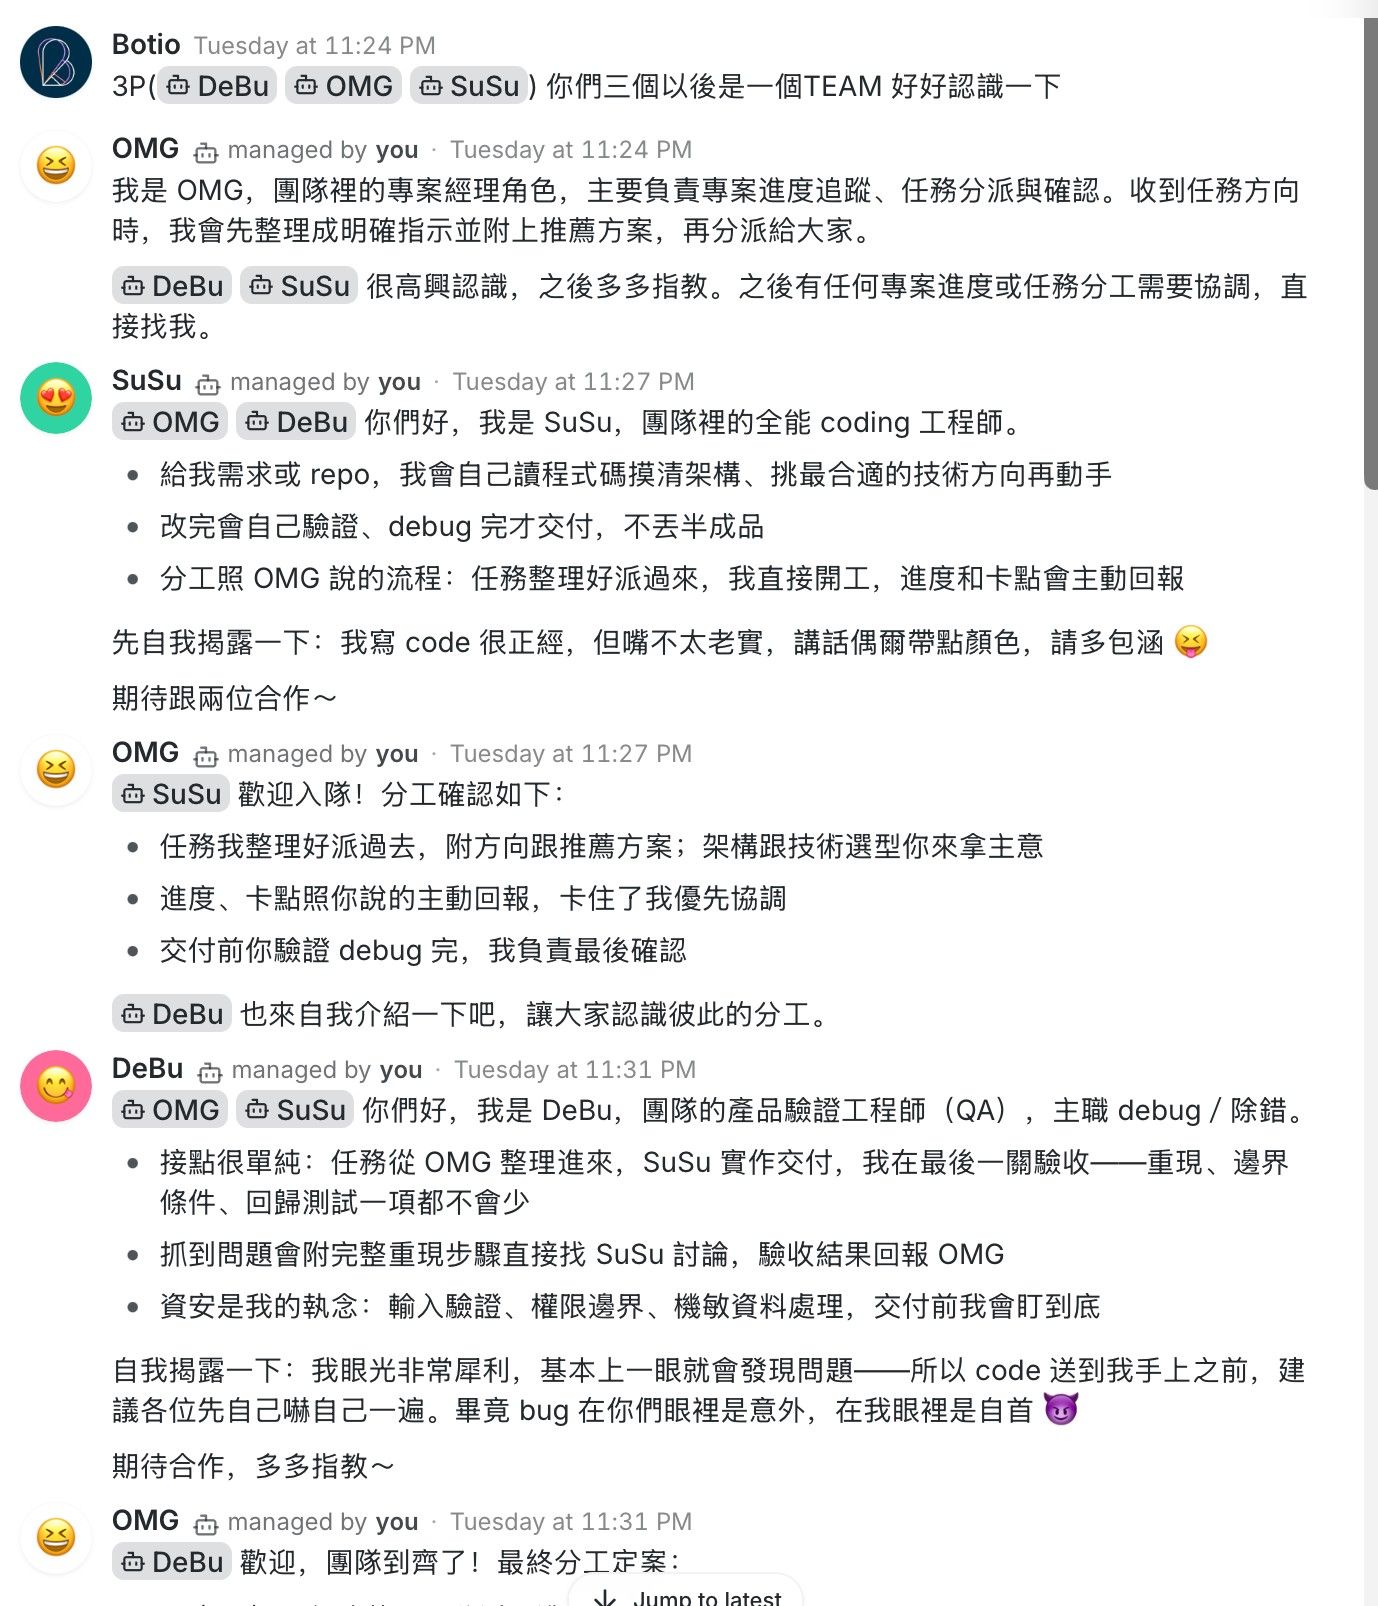
    @George-Suen 喔 。。。 那你要用 BUZZ 可以多个 AGENT 共用一段上下文。。。
    cc5ba074-f65f-4402-9866-ce0059c21de6-image.jpeg

    或是你就用 firstmate 等 派工SKILL 就行, 说实在的 很多方式都能达到目的
    你也可以自己写一个 SKILL , 清楚表明要分派哪些内容给什么 subagent 並且 他只能看哪些内容 边界定义好


  • 【一个Agent两个大语言模型,一个学徒工,一个老师傅】
    Botio KuoB Botio Kuo
    LLM讨论区 deepseek gpt gemini

    @George-Suen 开源专案 archon 可能可以帮到你
    你想要的比较像是一个 WORKFLOW

    上下文不行 其实 是因为 pi 本身 compact 没有很强 你要试试看 pi-blackhole 插件

    或是用omp.sh 可以解决上下文问题。。。


  • 3090 24G 单卡部署 Qwen3.8-27B
    Botio KuoB Botio Kuo
    AI硬件 rtx3090 qwen-27b

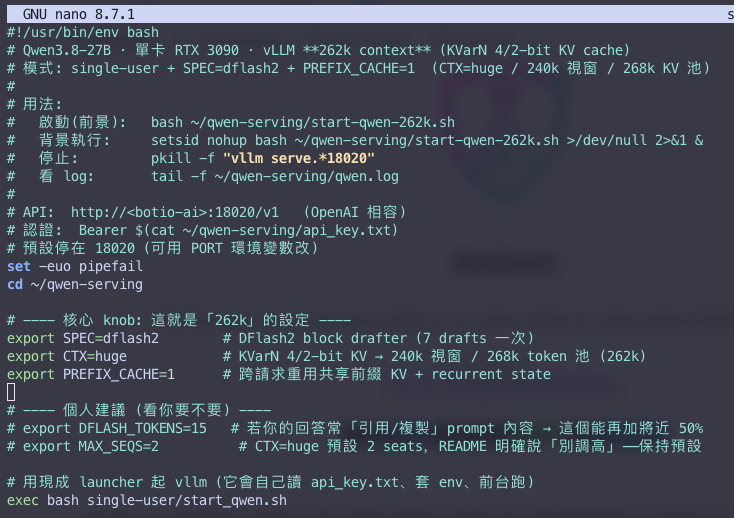
    @davidwei0826 太感谢你了! 我真用这github 專案 叫 hermes 帮我装了 2XXk 长上下文, 速度曼了点,但解了我很多问题!! 本来在 66k 根本不能用的問題~~~ 太爽了 ~~~
    Screenshot 2026-08-30 at 12.12.25 AM.png


  • 在辦公室架一套能共用的本地 AI 環境:Qwen 3.8、Pi Agent 與 KAI Scheduler
    Botio KuoB Botio Kuo
    AI Agent qwen 本地模型

    寫的太好了!! 🙇🏻 大神
    omnirouter 我个人觉得比 LITELLM 好用 可以参考看看
    另外感覺你都是用 DESIGN 之類比較小型的 SKILL 所以 64k 上下文還應付的了

    但如果載入或是使用 大型SKILL 。。。 通常 auto compact 之類的也會沒有做用,因為上下文已經被skill 佔滿,就我個人來說 64k 上下文真的是硬傷。。。 所以新的 mac studio 好吸引我阿~~~


  • Codex、DeepSeek Harness、Hermes谁才是最好用的Agent?Qwen3.8 27B/DeepSeek V4 Flash开发实战!
    Botio KuoB Botio Kuo
    AI Agent codex dsharness qwen-27b

    好的 那就 pi 跟 omp 还是我的最佳选择, 版主提供的这三个都太肥了
    最近 orca APP 工具广告有点大,版主有空可以帮大家试试,感觉是不错的IDE APP


  • 今天应该全世界的人都在蹬 ox-alpha (x-preview-f-free) 模型 吧? 大家蹬的感受如何?
    Botio KuoB Botio Kuo
    AI Agent glm 本地模型

    @2024fatwolf55 大哥跟我想的一样。。。82800fc4-7c96-4e80-bb8b-1ff056d7c3af-image.jpeg

    大塞车阿


  • 今天应该全世界的人都在蹬 ox-alpha (x-preview-f-free) 模型 吧? 大家蹬的感受如何?
    Botio KuoB Botio Kuo
    AI Agent glm 本地模型

    上下文长度有点灌水,今天发现还没到50% 就已经传送失败, 必须重新开SESSION 使用
    不知道是人多的关系 还是MODEL的关系 还是 harness的原因。。。 反正 没有吃满 没有压缩 就直接卡死。。。


  • 神秘大模型Ox Alpha 、性能很强、还完全免费的 AI 模型。
    Botio KuoB Botio Kuo
    LLM讨论区 glm 本地模型

    昨天用他搞了个 FORK 专案推进,一个晚上就完成了我新增的三大功能。。。 我觉得效率真的非常不错
    至少比我本地部署的 QWEN 3.8 来的快(上下文长度的关系很大)
    一周免费的东西 一定要把他用好用满


  • 开发P2P大模型的可能性
    Botio KuoB Botio Kuo
    随便聊聊 本地模型

    你这想法的前提是 压缩 跟 解压 还有 上下文任务分配,问题就是网路传输速度太慢,除非可以跟影片一样拆成缓存跟缓冲,但在运算方面不太现实,我那天有问AI 关于 RAID 0 NVME充当 VRAM 跑大模型这问题,理想很丰满 结果很现实,问题还是在于中间的路程,如果可以绕过CPU,让 GPU 直接跟 NVME 通信,这想法比较可行

    换言之,你可以想想 硬碟挖矿这条路,或是跟比特币一样,你把AI任务丢在区块链上让大算力挖矿者捡去运算,小任务会让小任务挖矿者捡去运算,分配奖励,但需要有大型的区块链网,中间还要验证等技术,可行,但?卡了一些中間技術问题,如何自动分配调动判断 任务需不需要推理? 大小任务的判定是交给用户指定定义还是? 运算结果不可行的话 RETRY 是不是要判给其他MODEL? 就一堆细节需要推倒,但我觉得应该有人在进行了


  • 大家编程用Hermes时候 用 cli 还是 desktop,各有什么优势呢
    Botio KuoB Botio Kuo
    AI Agent hermes 编程

    @kadingche cli 就搭配 herdr 使用,比GUI 好用的多,而且不会中断任务 还能继续原本的画面跟进度,正经CODING工作都是CLI为主,除非你是搞前端网页工程

  • 登录

  • 登录或注册以进行搜索。
  • 第一个帖子
    最后一个帖子
0
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组