

Q3 is hard, you can try q2 xxs
-
我的4060TI 16G,内存32G DDR5可以让 Strata跑qwen 3.8 flash吗? -
窮人也可以生產視頻!Google AI Pro 會員在 Colab 上零成本架設 ComfyUI 與 MiniMax H3 本地化模型@Yu-Chen-Chang 楼主是用google drive做google colab的version control吗,能接入其他的ai agent吗?Gemini太难用了。我现在是用GitHub,每次修改都要在Google Colab重新加载
-
窮人也可以生產視頻!Google AI Pro 會員在 Colab 上零成本架設 ComfyUI 與 MiniMax H3 本地化模型@terry 一个月$20 5TB云盘加YouTube免广告会员,送A100/H100的使用权限, 但是不能保证随时都可用,取决于企业用户的空余时间。
-
4× RTX PRO 6000 Blackwell Max Q车库没有240V?
-
Intel Core i5-13600KF + 64G DDR5 + NVIDIA RTX 4070 12GB + NVIDIA RTX 3060 12GB + 4TB SSD + M2 Pro MacBook Pro@kos-or 游戏机ps5
-
Intel Core i5-13600KF + 64G DDR5 + NVIDIA RTX 4070 12GB + NVIDIA RTX 3060 12GB + 4TB SSD + M2 Pro MacBook Pro我的硬件配置如下:
配件 配置 CPU Intel Core i5-13600KF,14 核 20 线程 主板 华硕 TX GAMING B760M WIFI 内存 64GB DDR5,4 × 16GB,英睿达与海盗船混插 主显卡 NVIDIA RTX 4070 12GB,PCIe 4.0 ×16 副显卡 NVIDIA RTX 3060 12GB,PCIe 4.0 ×4 NVMe SSD 英睿达 Crucial P3 Plus 1TB × 2 SATA SSD 三星 Samsung 870 QVO 1TB × 2 电源 1000W 操作系统 Windows 11 + 原生 Ubuntu 双系统 windows & Linux 推理环境和编译缓存放在 NVMe,模型文件放在共享 SATA SSD。
还有一个M2 Pro MacBook Pro 偶尔跑跑小模型
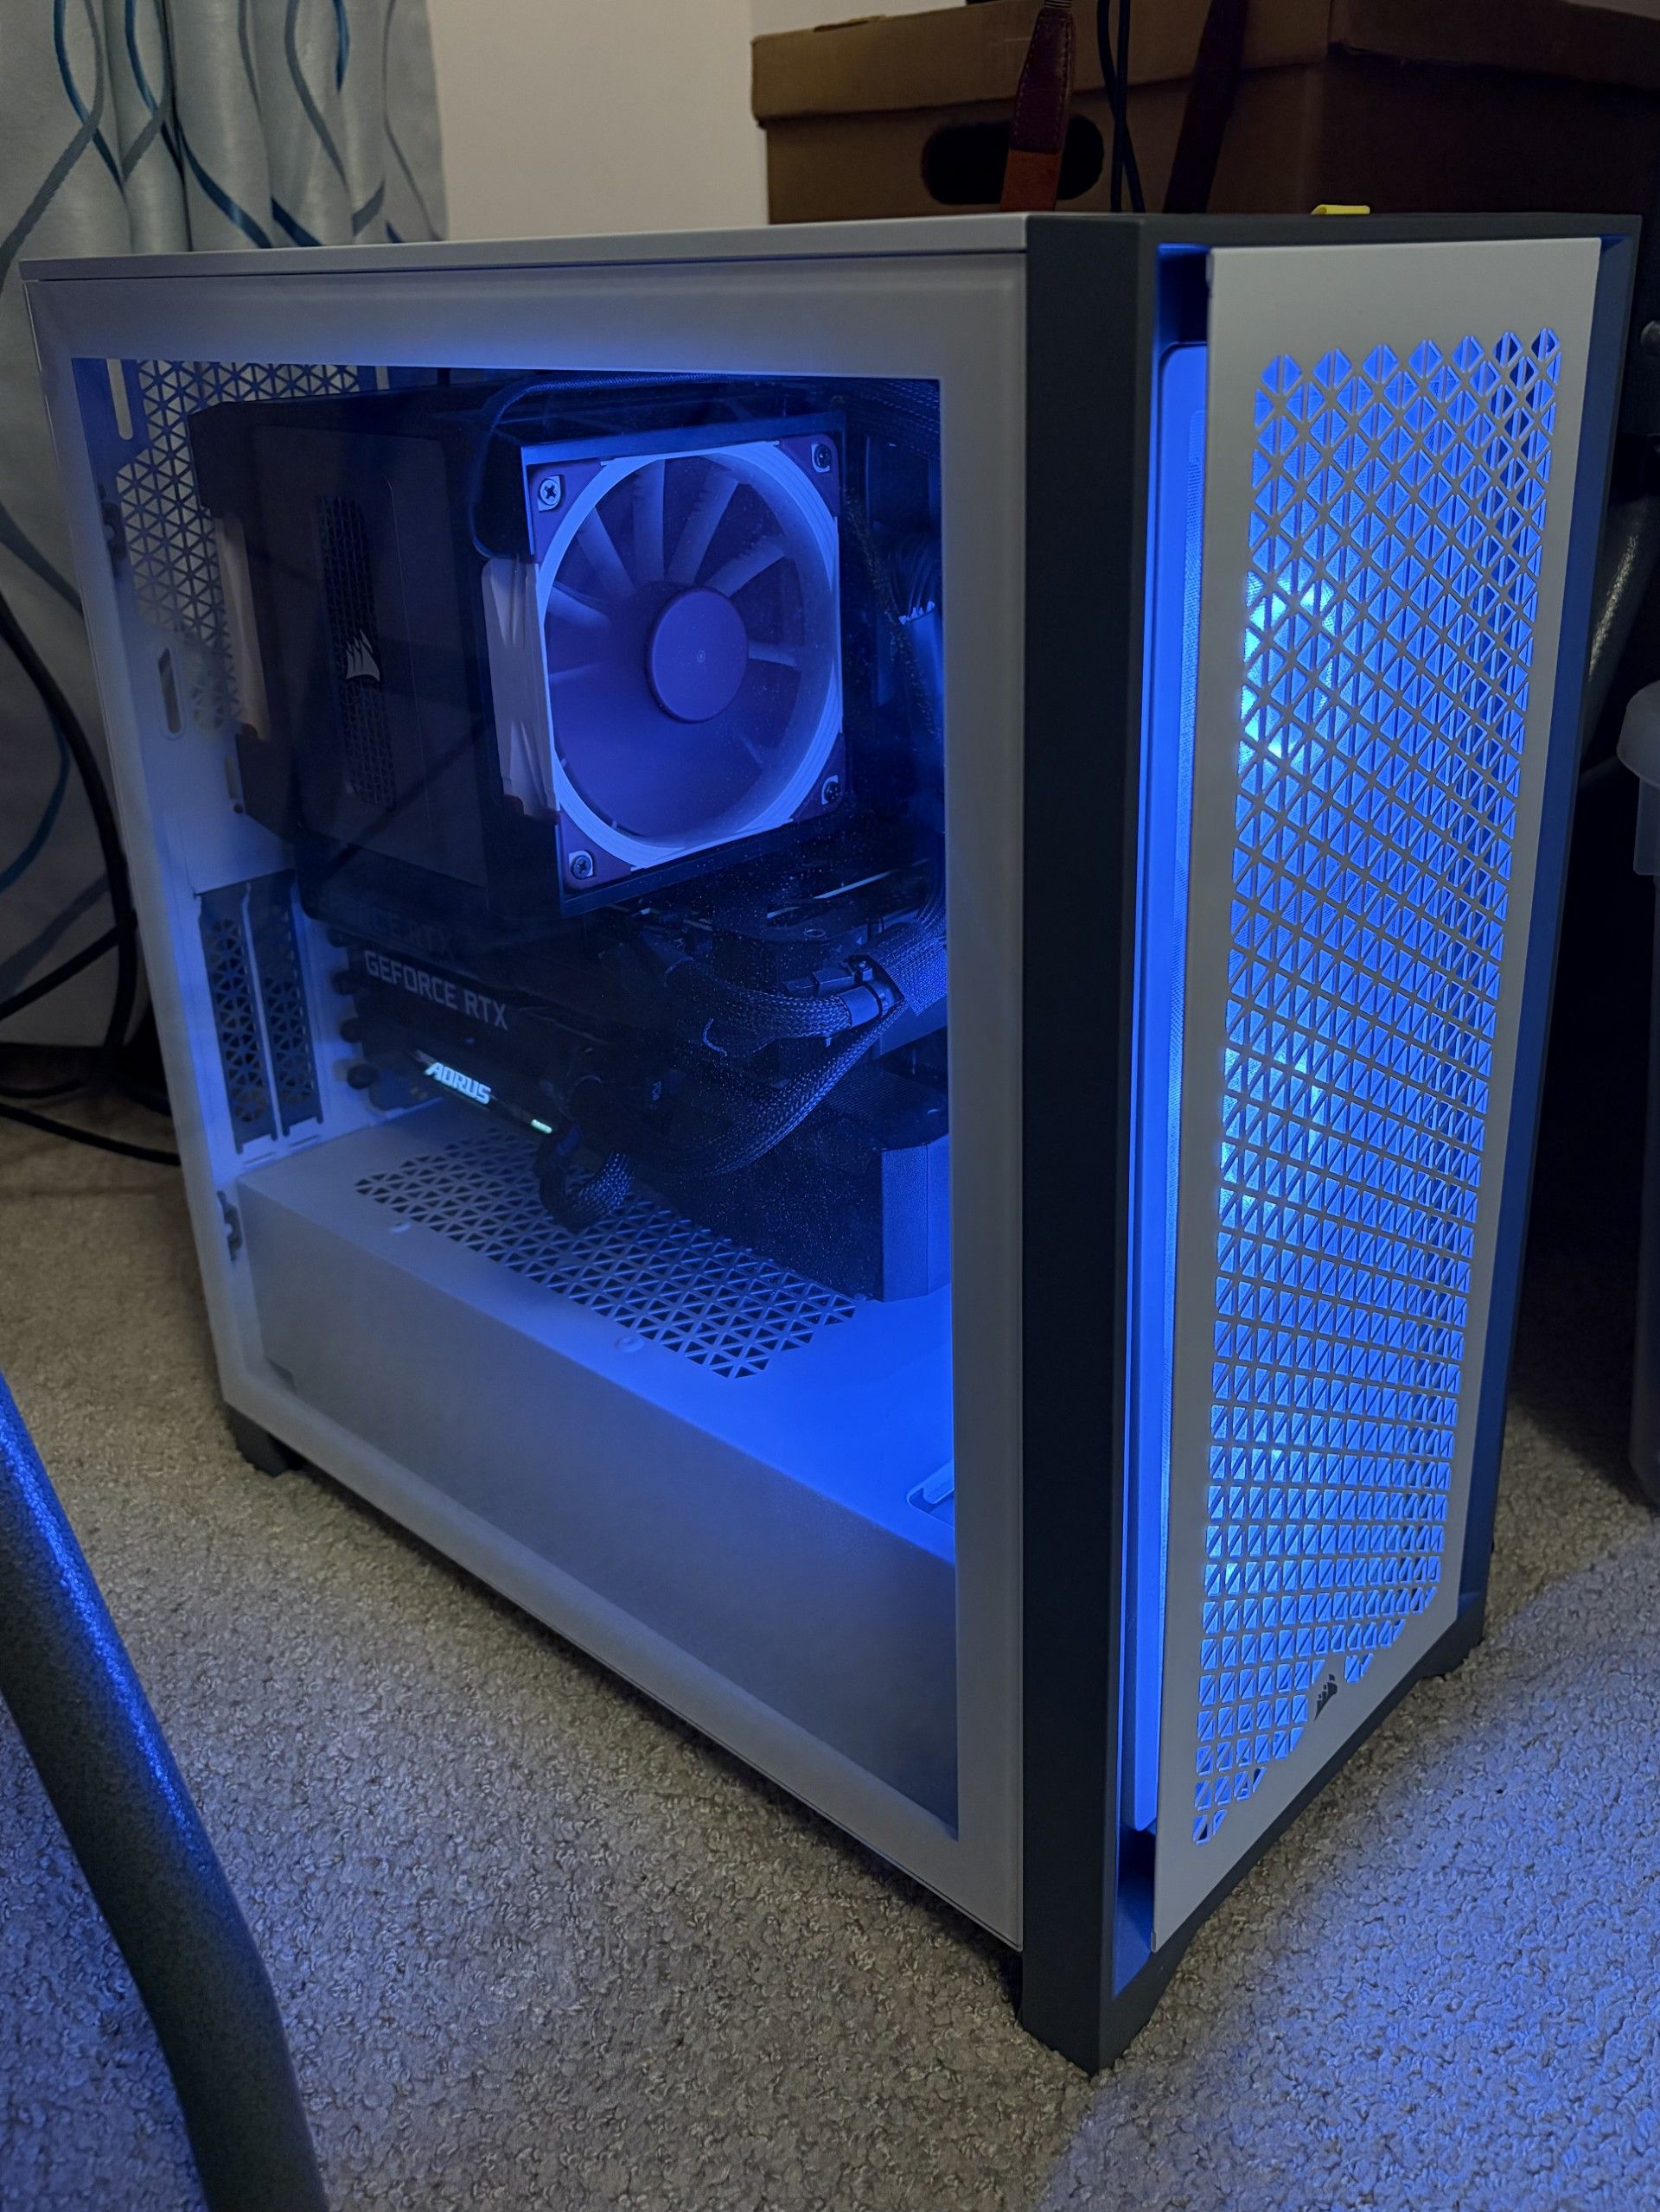
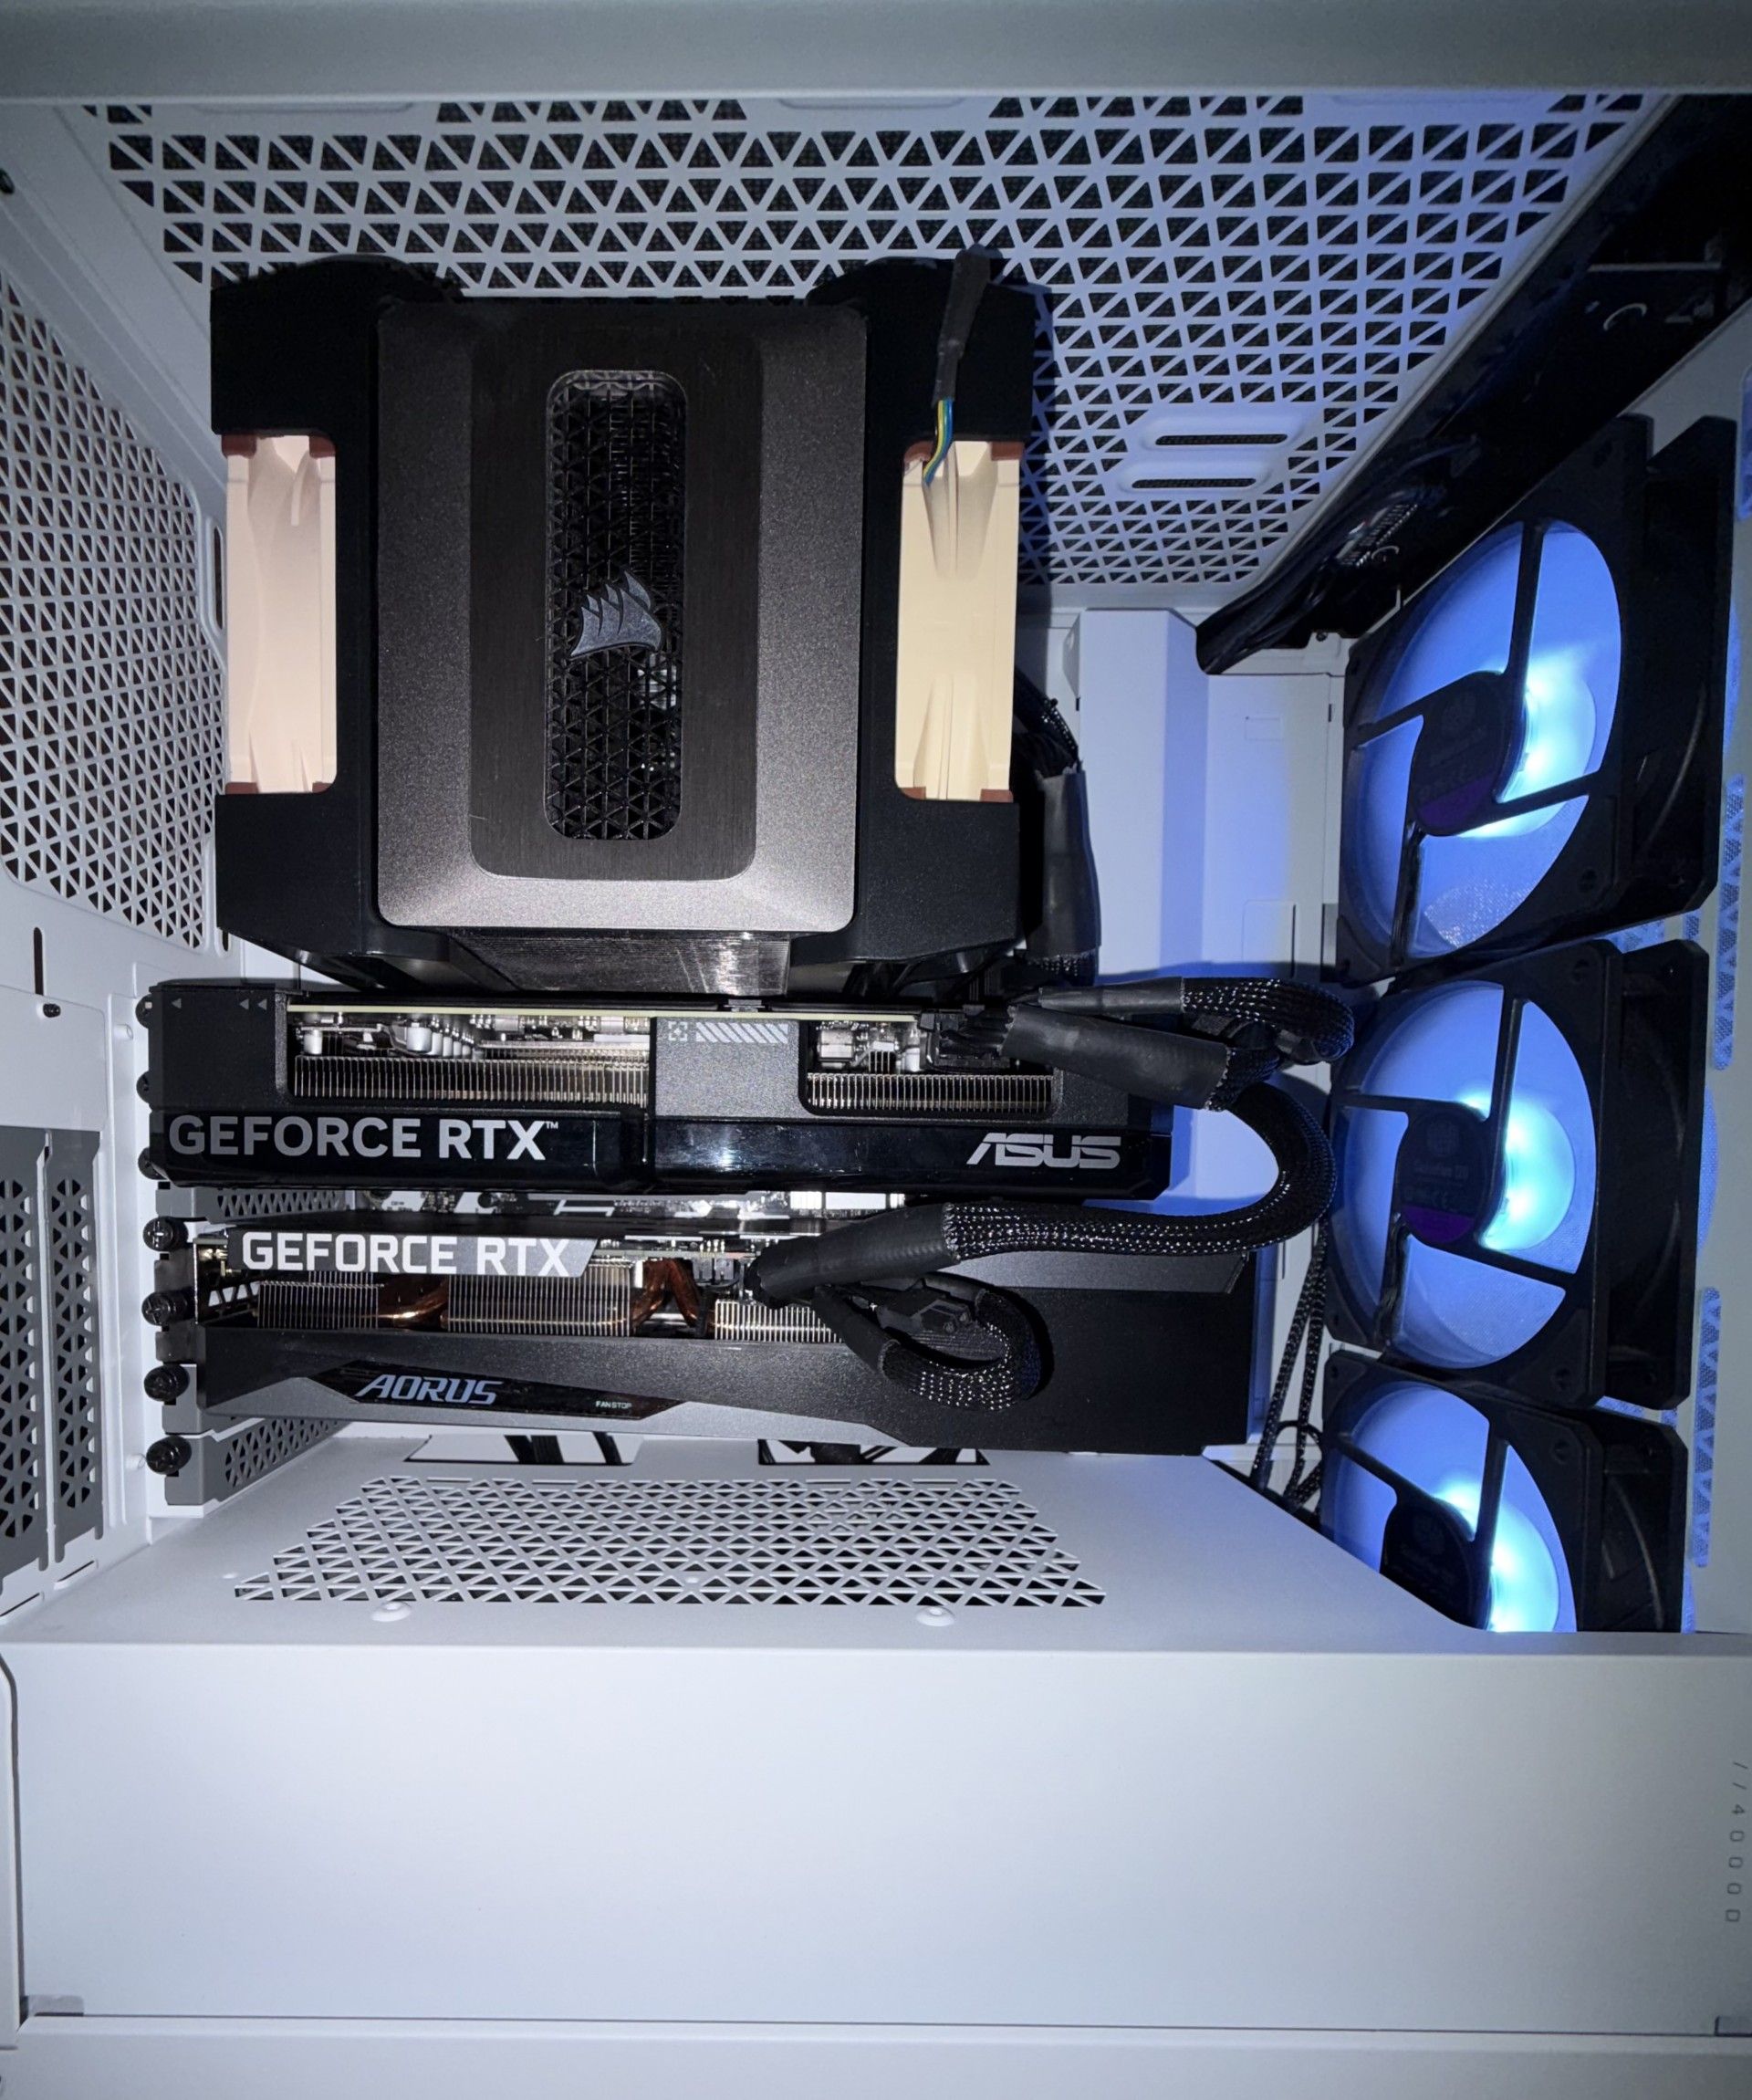
-
RTX 4070 12GB + RTX 3060 12GB:Windows 跑 Strata / Qwen3.8 Flash-Next,Linux 跑 Qwen3.8 27B 与 Flash-Next,SGLang、vLLM、Strata 配置及实测@terry
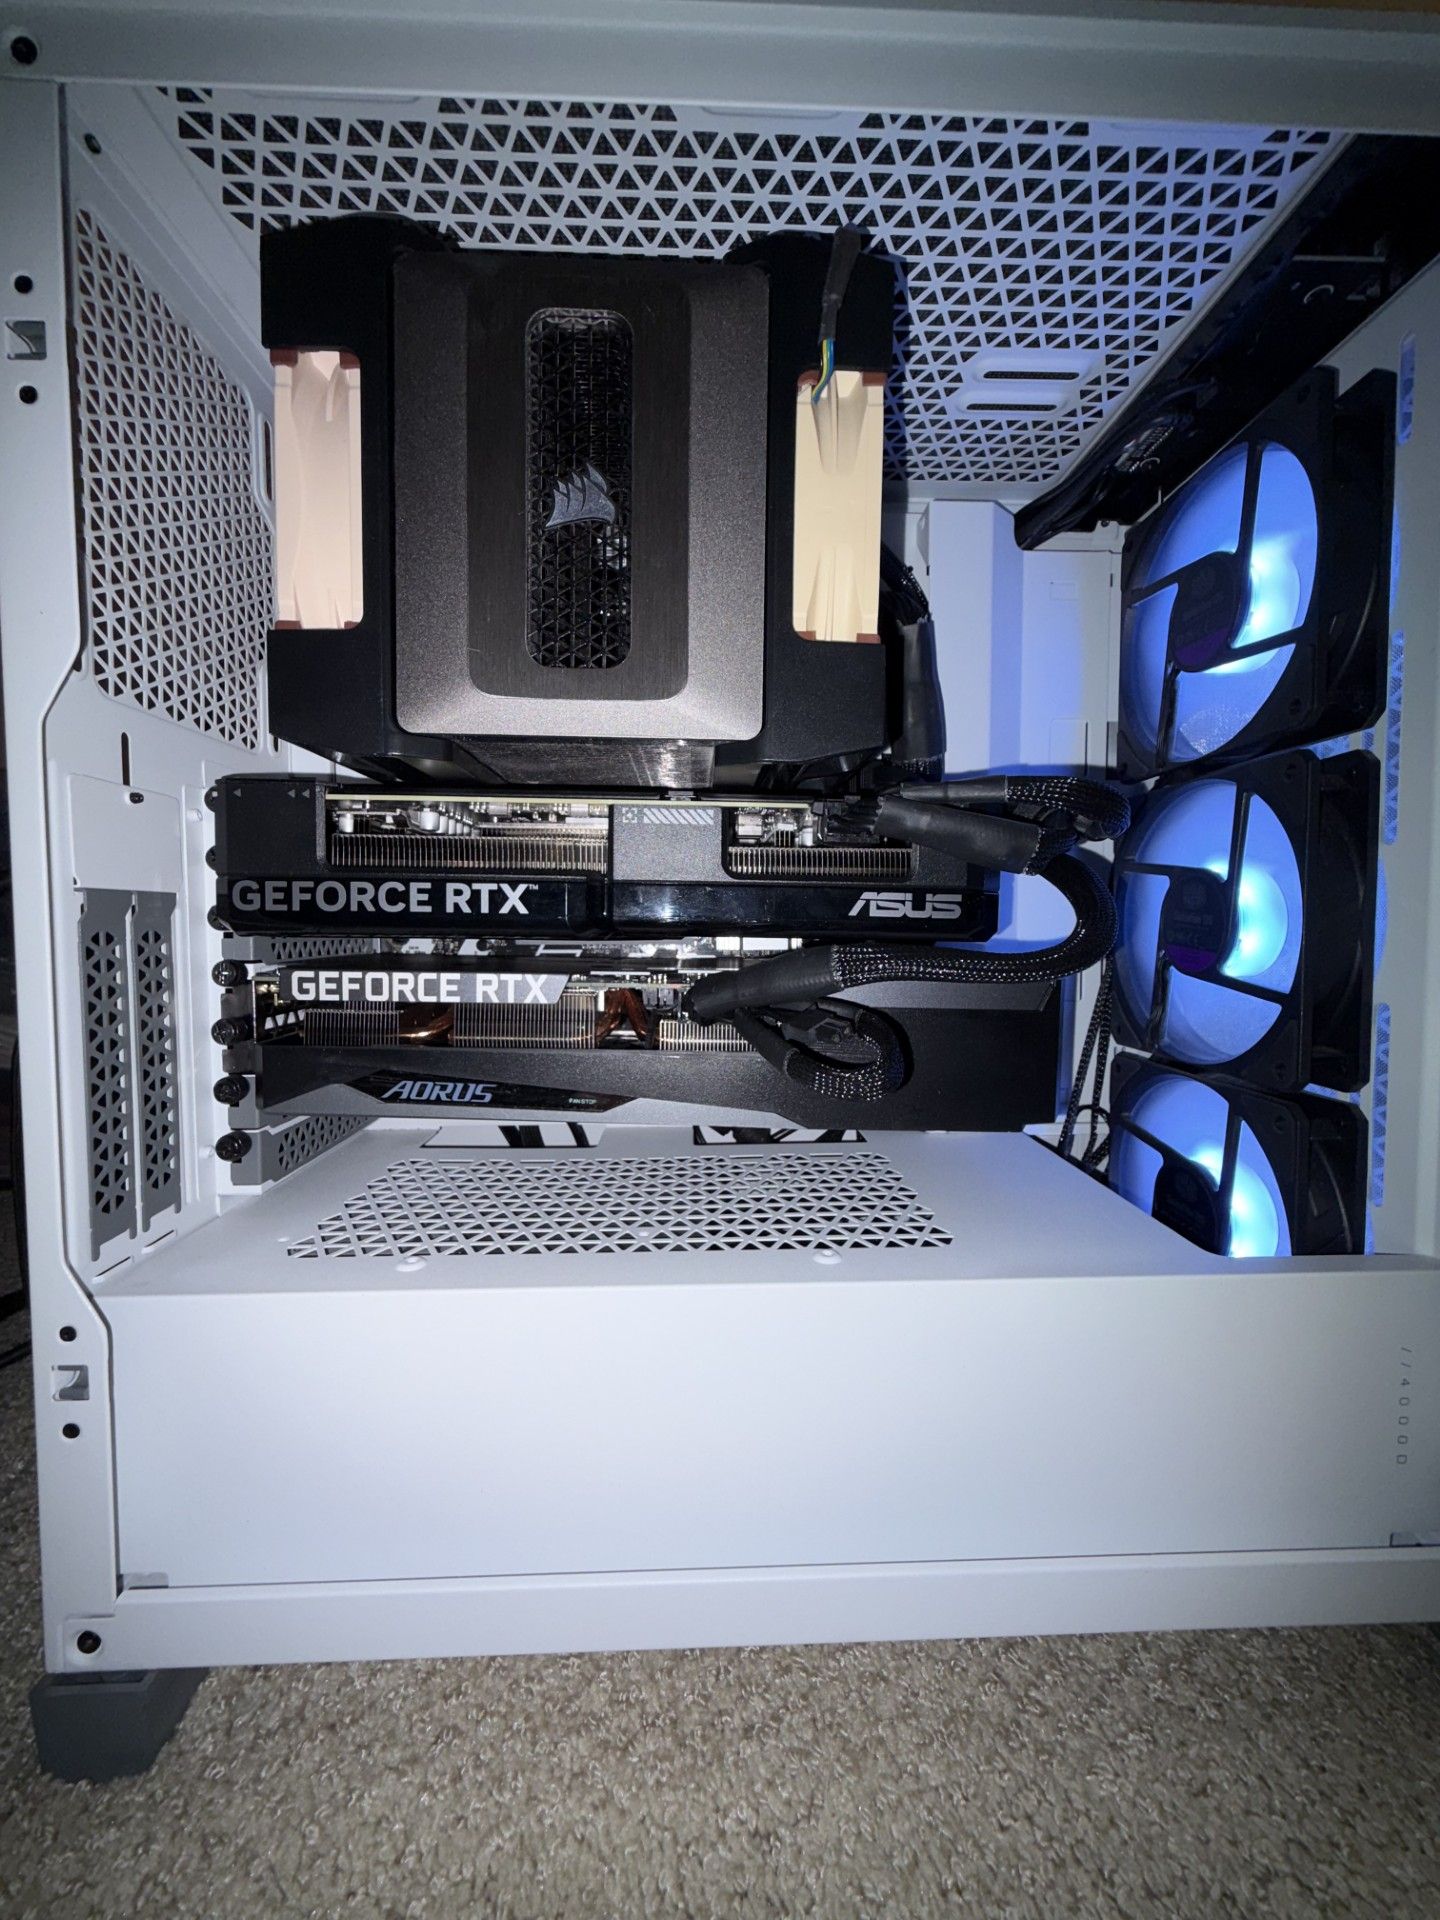
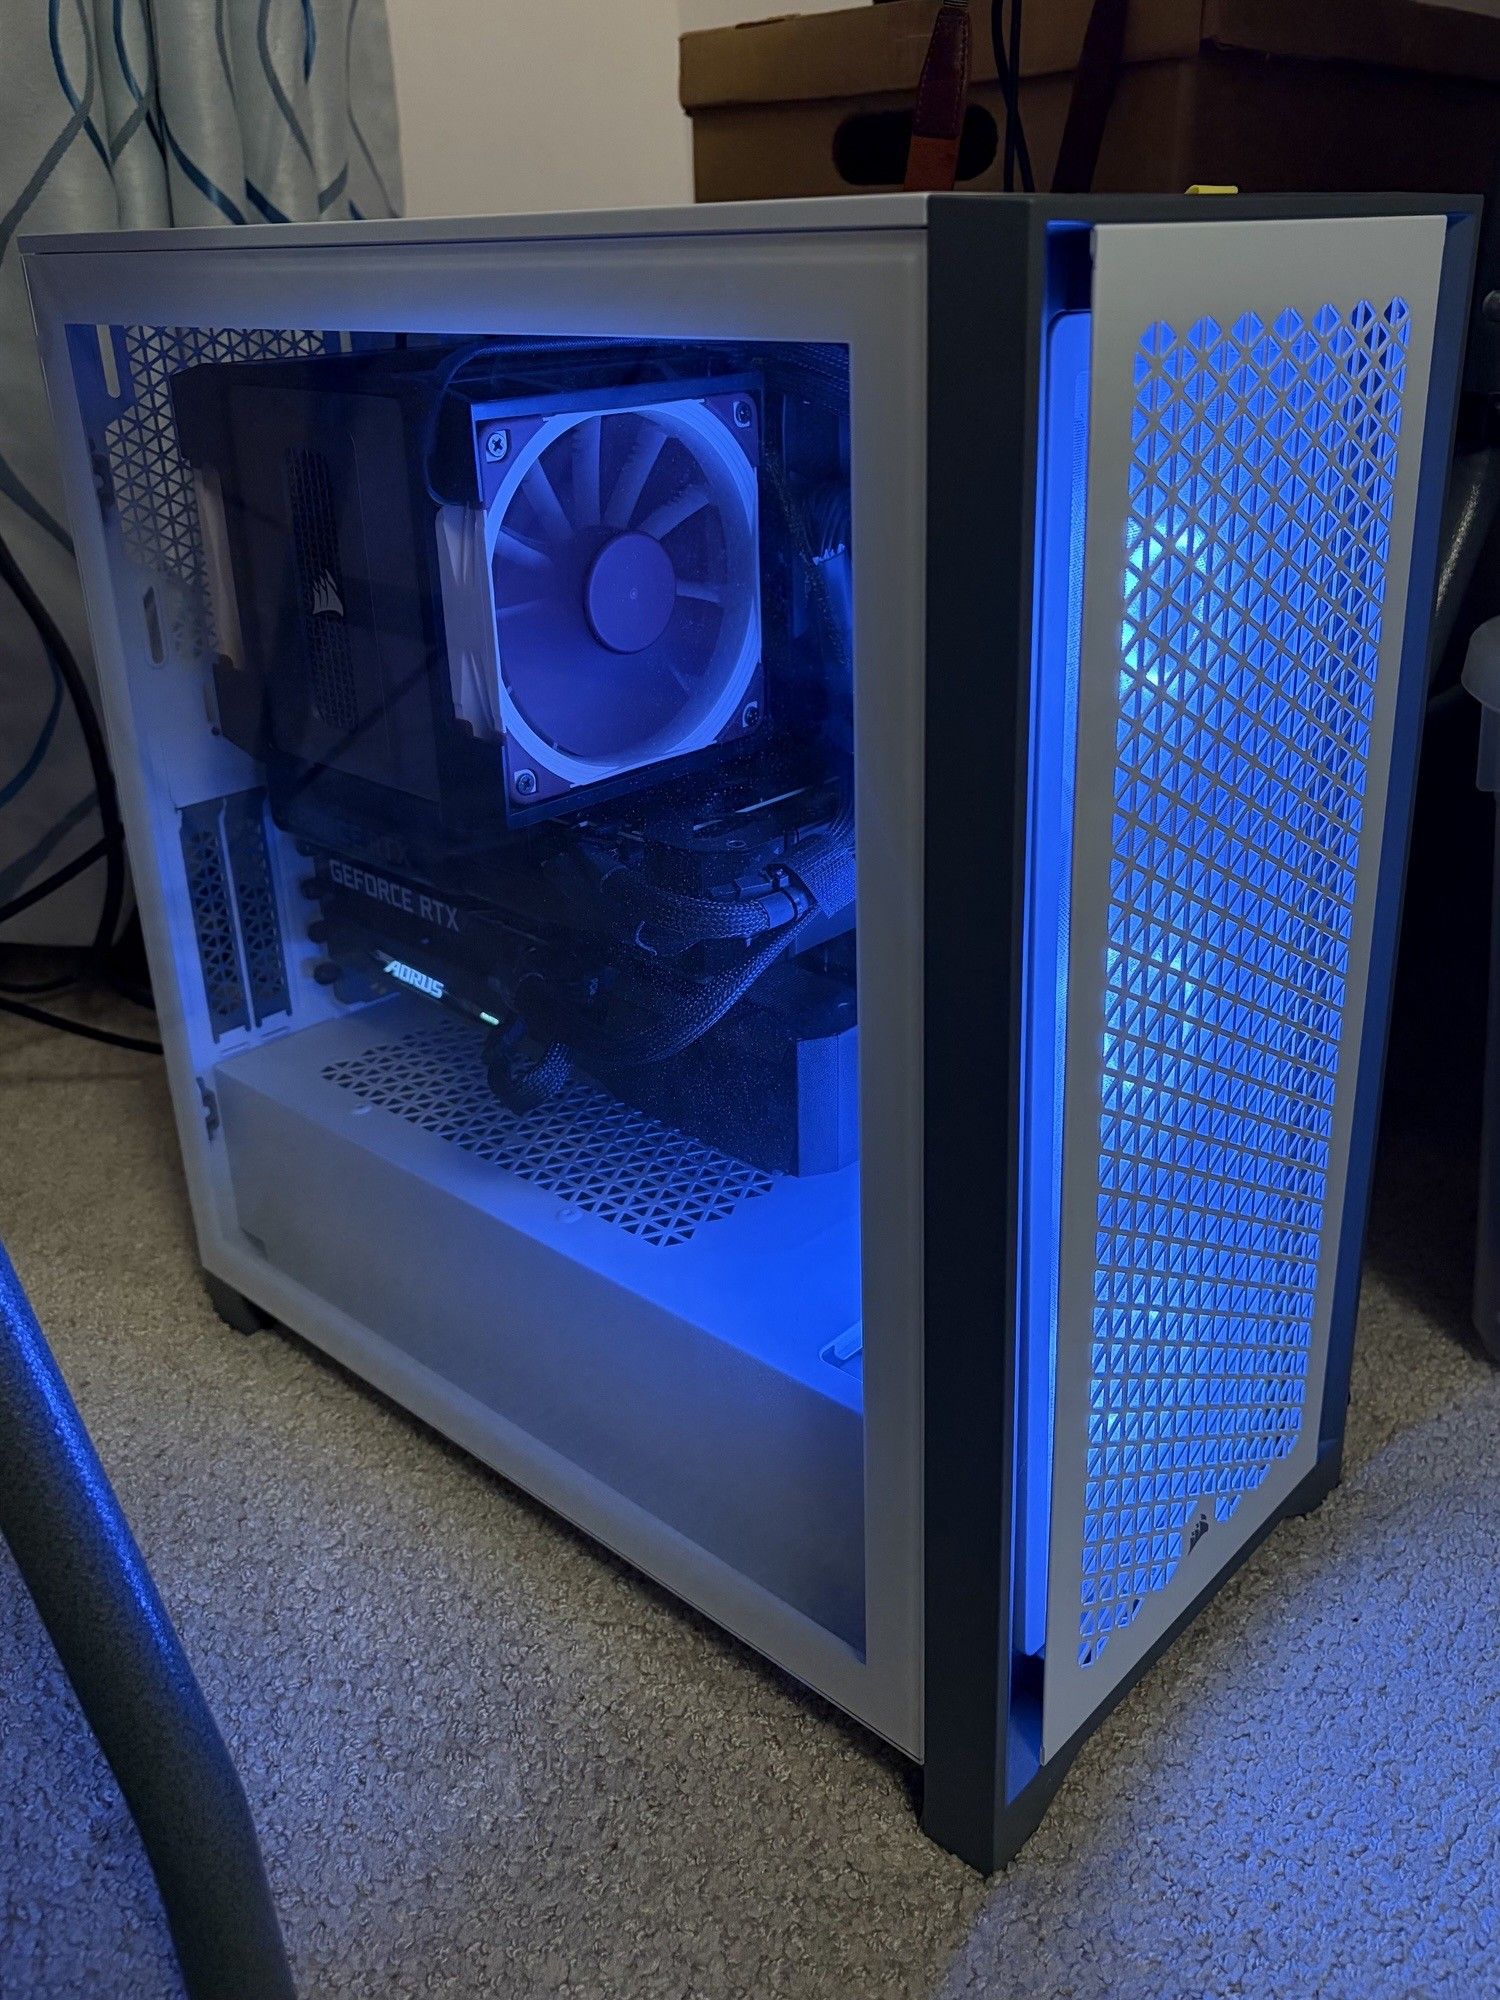
苹果相机白平衡拍蓝了, 实际上是白灯 -
RTX 4070 12GB + RTX 3060 12GB:Windows 跑 Strata / Qwen3.8 Flash-Next,Linux 跑 Qwen3.8 27B 与 Flash-Next,SGLang、vLLM、Strata 配置及实测@Thanaots 但是你的30系显卡不支持pcie5,只能走4X8
-
RTX 4070 12GB + RTX 3060 12GB:Windows 跑 Strata / Qwen3.8 Flash-Next,Linux 跑 Qwen3.8 27B 与 Flash-Next,SGLang、vLLM、Strata 配置及实测谢谢版主,一会更新一下linux sglang配置
-
RTX 4070 12GB + RTX 3060 12GB:Windows 跑 Strata / Qwen3.8 Flash-Next,Linux 跑 Qwen3.8 27B 与 Flash-Next,SGLang、vLLM、Strata 配置及实测@Thanaots 我觉得你换个主板成本最低,3080 4x4肯定是在走芯片组, 感觉跑不满。两张显卡都走cpu x16能发挥最大效率
-
體感經驗 哪一個強?? Qwen3.8-Flash vs. Qwen3.8-27BStrata backend还是llama.cpp只是优化好,多发并行请求肯定不行
-
RTX 4070 12GB + RTX 3060 12GB:Windows 跑 Strata / Qwen3.8 Flash-Next,Linux 跑 Qwen3.8 27B 与 Flash-Next,SGLang、vLLM、Strata 配置及实测@he-wanga 我现在是前面三个120进风扇, 加上两个120CPU风扇,都是往后吹
-
RTX 4070 12GB + RTX 3060 12GB:Windows 跑 Strata / Qwen3.8 Flash-Next,Linux 跑 Qwen3.8 27B 与 Flash-Next,SGLang、vLLM、Strata 配置及实测@he-wanga Q4 27B用Sglang在Linux上decode能跑到60-70t/s, windows llm.cpp 比较慢,Q4只有不到40t/s
-
RTX 4070 12GB + RTX 3060 12GB:Windows 跑 Strata / Qwen3.8 Flash-Next,Linux 跑 Qwen3.8 27B 与 Flash-Next,SGLang、vLLM、Strata 配置及实测@Xiaote 我整机峰值功耗跑到650w左右, 用的1000w电源
-
RTX 4070 12GB + RTX 3060 12GB:Windows 跑 Strata / Qwen3.8 Flash-Next,Linux 跑 Qwen3.8 27B 与 Flash-Next,SGLang、vLLM、Strata 配置及实测分享一套消费级异构双卡配置:i5-13600KF、64GB 内存,加上 RTX 4070 12GB 和 RTX 3060 12GB,在 Windows 下运行 Strata。
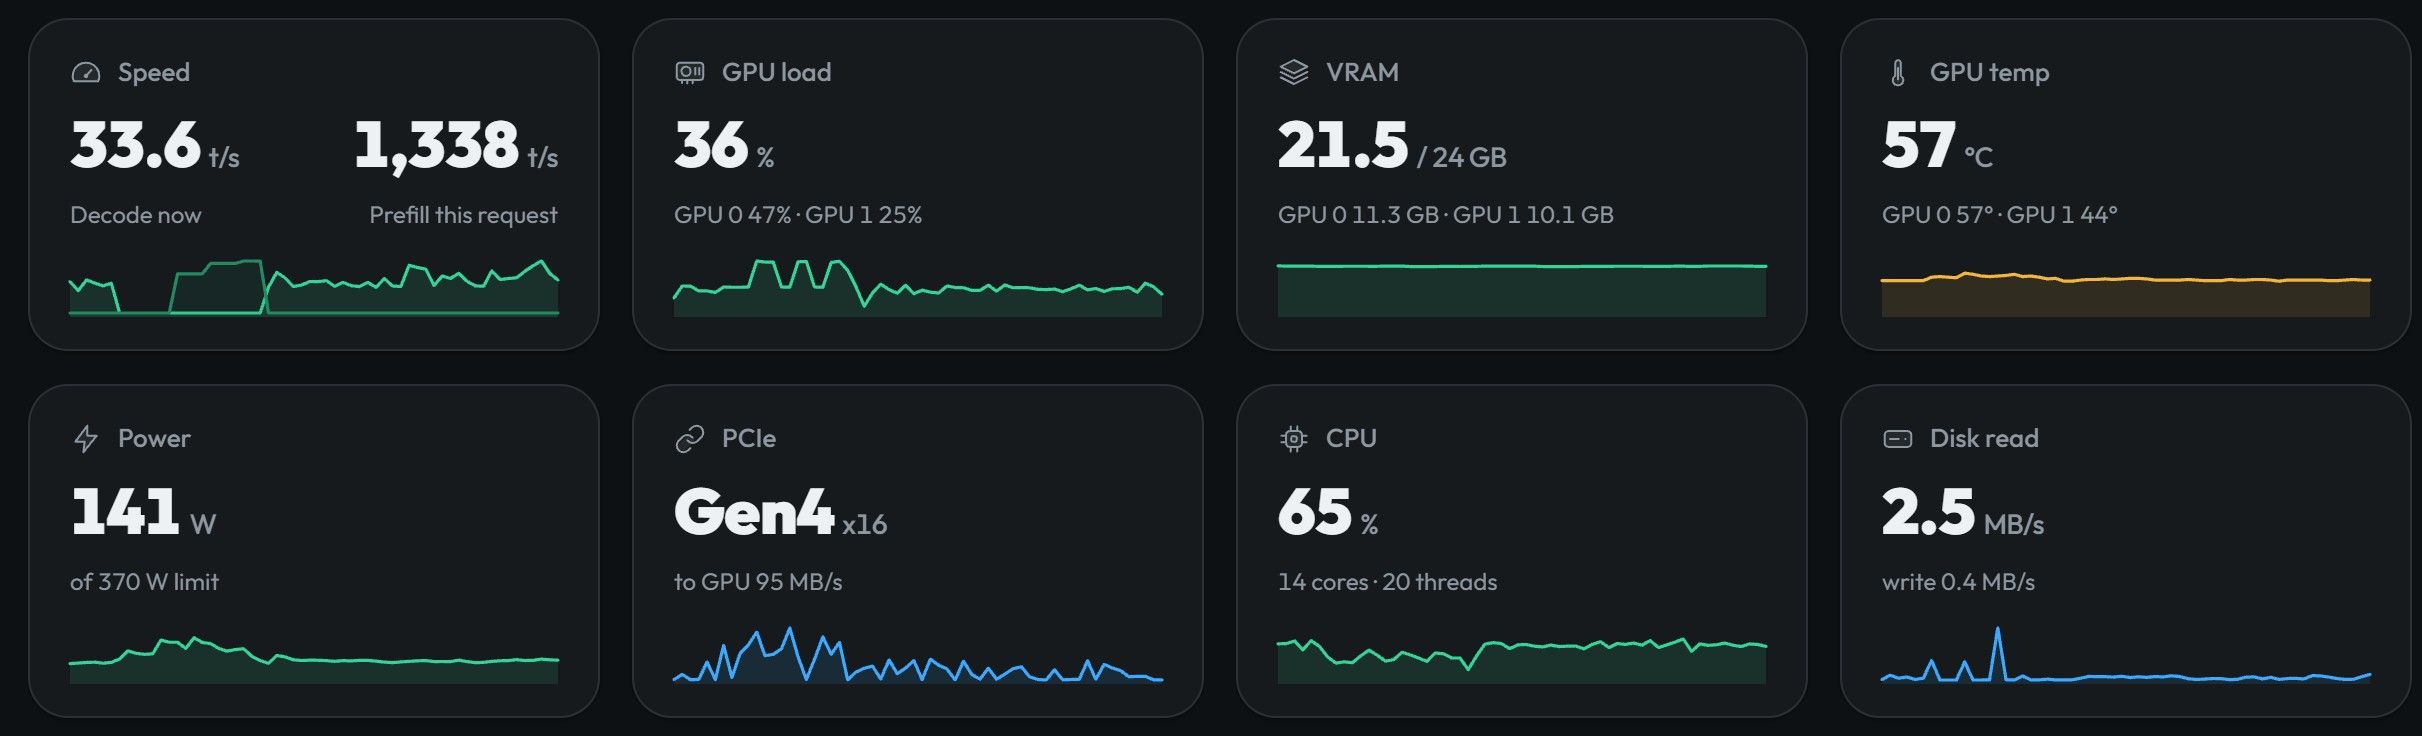
目前保留两个量化版本:IQ2_XS 日常使用,IQ3_XXS 作为备选。两者都配置了 128K 上下文、INT8 KV 流式缓存和 MTP。已有测试中,IQ2_XS 的综合生成速度约为 36–40 tok/s,IQ3_XXS 约为 28 tok/s。
先交代测试条件:测试期间有游戏在后台运行,负载没有完全控制。以下数字是这台机器上的观测结果,不能直接当成严格的性能提升比例。
一、硬件与软件
项目 配置 CPU Intel Core i5-13600KF 系统内存 64GB 主显卡 RTX 4070 12GB 副显卡 RTX 3060 12GB 操作系统 Windows 推理引擎 Strata 0.1.31 引擎 CUDA 版本 13.0 模型 原版 Qwen3.8 Flash-Next,GSQ-RCO GGUF 量化 IQ2_XS / IQ3_XXS 模型存储 SATA SSD 客户端 DeepSeek Harness Desktop,OpenAI 兼容接口 这份记录对应 2026 年 10 月 1 日的配置与测试,不代表后续版本的表现。
两张卡的连接带宽差别较大:
- RTX 4070:PCIe 4.0 ×16,实测传输带宽约 18–19.6GB/s。
- RTX 3060:PCIe 4.0 ×4,实测约 6.4GB/s。
因此,不能简单把两张卡视为一张 24GB 显卡,层分配和缓存布局仍需要单独测。
二、当前保留的两个配置
参数 IQ2_XS IQ3_XXS 上下文分配 131072 tokens 131072 tokens GPU 顺序 4070 → 3060 相同 layer_split4040KV 类型 int8int8--kv-resident3276832768--spec44--spec-min-p0.700.50--pcie-frac0.35未显式设置,运行时选择 0.55 CPU 专家工作线程 未显式设置,实际为 13 相同 --vram-reserve-mib15361536专家缓存 / Prefill auto/auto相同 MTP 词表 多语言 CJK 子集 相同 视觉 关闭 关闭 实验性速度投影 关闭 关闭 这里有两个容易混淆的地方:
layer_split=40是层边界,不是 40% 的显存比例。 当前对应:- 4070:第 0–39 层。
- 3060:第 40–47 层,以及输出头和 MTP。
Strata 的
--spec 4是包含已接受 token 的验证窗口,最多提议 3 个草稿 token。 所以这里称为 MTP-3,不是直接把参数值叫作 MTP-4。IQ2_XS 的关键引擎参数如下,仅列调优部分;模型、pack、MTP 路径及服务端 GPU 配置需要另外生成:
--max-context 131072
--kv int8
--kv-resident 32768
--expert-cache auto
--prefill auto
--spec 4
--spec-min-p 0.70
--pcie-frac 0.35
--vram-reserve-mib 1536
IQ3_XXS 使用相同的上下文、KV 和层分配,但恢复产品默认的 PCIe 分担和草稿置信度设置。
两个配置轮流使用,不会同时加载两个大模型占用这两张卡。
三、128K 是怎么放下的?
这套配置同时使用系统内存和 GPU 显存:
- 系统内存保存专家权重,CPU 参与未缓存专家的计算。
- GPU 缓存一部分常用专家。
- 完整 INT8 KV 后备缓存位于系统内存。
- 每个 QSA 层在显存中保留 32768 个驻留缓存单元。
- GDN 循环状态保留在负责对应层的 GPU 上。
因此,128K 上下文并不意味着把完整 128K KV 全部塞进显存。
也要区分两种“用内存”:专家和 KV 使用系统内存,不等于运行时持续从 SSD 读取全部专家。 本次测试用的是完整专家内存模式,没有启用 SSD 支持的专家 mmap 模式。
四、调优结果:手动层分配值得测试
五项吞吐测试均请求生成 512 tokens,温度 0、seed 42、关闭思考。其中四项是短提示,一项输入约 4437 tokens。
表中的综合速度使用“总生成 token 数 ÷ 总引擎解码时间”,不是五个速度数字的简单平均。
量化 0.1.31 自动配置 调优后 调优测试期间最低可用内存 IQ2_XS,首次调优测试 31.54 tok/s 36.23 tok/s 9.32GiB IQ2_XS,相同配置复测 使用前面的基线 39.86 tok/s 10.31GiB IQ3_XXS 23.08 tok/s 27.68 tok/s 3.31GiB 同一个 IQ2_XS 配置,前后就出现了 36.23 与 39.86 tok/s 的差异,所以不宜把某一次最高值当作稳定保证。
手动改为 40/8 层分配后,启动记录中的专家缓存槽位大致变化为:
- IQ2_XS:约 4400 → 7600。
- IQ3_XXS:约 3500 → 5600。
这使我保留了手动分配。不过,这里只比较了自动分配与 40/8,没有穷举所有层边界,不能称为全局最优。
CPU 工作线程也做过比较。IQ2_XS 在校准负载中,13、9、6 个工作线程分别约为 37.47、30.75、29.18 tok/s,最终保留默认 13 个。减少线程并没有在这轮测试里带来收益,但这也不能代替后续对 P/E 核亲和性的单独测试。
五、长提示和工具调用是否可用?
两个量化版本都通过了:
- 普通生成。
- 工具调用及工具结果回传。
- 客户端流式输出。
- 约 4419 tokens 的检索测试。
- 36919 输入 tokens 的双标记检索测试,能够取回靠近两端的验证码。
较长提示测试的结果:
项目 IQ2_XS IQ3_XXS 输入长度 36919 tokens 36919 tokens Prefill 1505.2 tok/s 1310.5 tok/s 短答案解码,输出约 18 tokens 38.3 tok/s 33.6 tok/s KV 显存块命中率 88.12% 88.89% KV 从系统内存读取量 61.5MiB 62.0MiB 这项测试超过了 32768 的驻留窗口,日志也记录了从系统内存读取 KV。
但目前最大的实测输入是 36919 tokens。128K 是分配容量,尚未验证满 128K 的检索质量、长时间稳定性或多用户并发。
首次调优吞吐测试中,MTP 草稿接受率分别约为:
- IQ2_XS:78.54%。
- IQ3_XXS:60.90%。
接受率会随任务与采样变化,不能只凭这个数字判断哪个配置更快。
六、模型放 SATA SSD 会不会拖慢生成?
比较过 SATA SSD 和 NVMe SSD:
项目 SATA SSD NVMe SSD 加载时间 约 121 秒 约 47–70 秒 已测生成速度 约 32.2 tok/s 约 30.9–31.4 tok/s NVMe 的加载优势明显,但在这些测试中,没有观察到持续生成速度的一致优势。
这些结果受缓存和后台负载影响,也只适用于本次专家驻留内存的运行方式,不能推导为“SSD 速度永远不影响推理”。如果换成依赖磁盘读取专家的模式,需要重新测试。
目前因此保留 SATA SSD 存储模型。
七、同机 llama.cpp 的参考结果
这台机器也保留了 Qwen3.8 27B 的 llama.cpp 配置:
模型 上下文分配 KV MTP 短生成速度 UD-Q4_K_M 128K 主模型及草稿均为 GPU Q8 KV 2 个草稿 token 33.4–33.8 tok/s UD-Q5_K_M 64K 主模型及草稿均为 GPU Q8 KV 2 个草稿 token 30.9–31.5 tok/s 这里主模型权重、嵌入和活动 KV 都放在 GPU 上,显存余量较紧。
这部分只作为同机使用参考:27B 与 Flash-Next 是不同模型,测试负载也不同,不能据此判定哪个引擎普遍更快或哪个模型质量更好。
八、后续准备验证的方向
当前日常默认仍是 IQ2_XS。IQ3_XXS 能运行,但测试中系统可用内存最低只有约 3.3GiB,对其他应用的余量较小。尚未做完整质量评测,因此不在这里给两个量化版本下质量排名。
后续想继续验证:
- 更新引擎后重新测 Prefill、首字延迟和解码速度。
- 对 i5-13600KF 单独比较默认线程布局与 P/E 核亲和性。
- 比较更长的 MTP 窗口,在代码、中文聊天和工具调用中分别记录收益。
- 关闭游戏等后台负载,重复自动分配与手动层分配的对照。
- 在原生 Linux 上复测同一硬件
如果有同样使用 4070 + 3060、Intel P/E 核 CPU、64GB 内存 的朋友,欢迎分享层分配、线程亲和性和 MTP 实测。最好同时注明引擎版本、量化、实际输入长度与后台负载,这样更容易比较。
项目地址:Niko1221/Strata