跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签 硬件 项目 AI 广场
byronduck-jpgB

byronduck-jpg

@byronduck-jpg
取消关注 关注
关于
帖子
3
主题
1
分享
0
群组
0
粉丝
0
关注
0

帖子

最新 最佳 有争议的

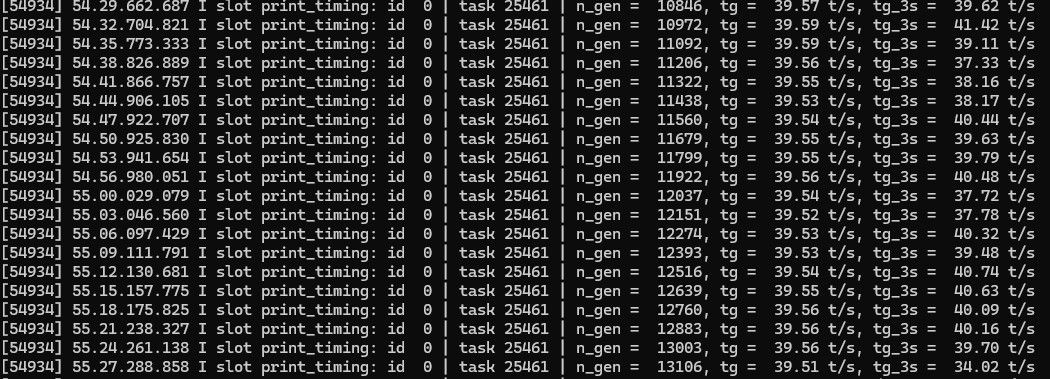
  • 新手贴:配置32G内存+5060TI 16G跑Huihui-Qwen3.8-27B-abliterated-GSQ-RCO-IQ3_S-mtp,在40上下tokens/s。
    byronduck-jpgB byronduck-jpg

    我是一个新手,还在摸索阶段,只知道复制别人的东西过来修修改改。

    huihui-ai/Huihui-Qwen3.8-27B-abliterated-GGUF
    这个huihui的模型里面,有一个来自于 ISTA-DASLab/Qwen3.8-27B-GSQ-RCO-GGUF模型的去审查版本,只有11G左右,但是质量非常高,由于是 ISTA-DASLab这个全球开源AI研究的顶尖实验室的作品,其Q3S的部分能力比起BF16近乎无损。

    目前从官方评测来看,它应该是量化的qwen3.8 27B模型里面又小又强的一个典范。

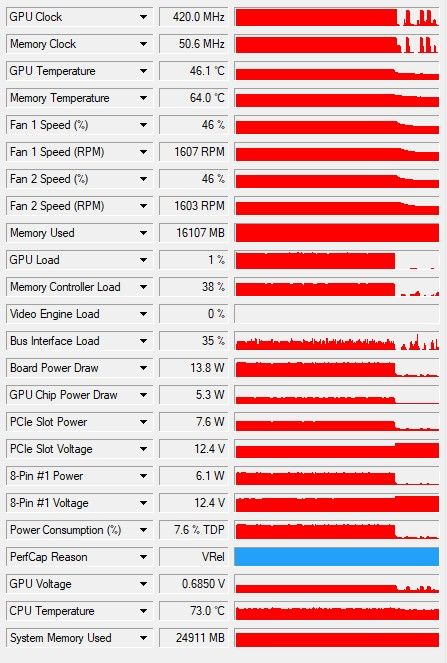
    我的配置是i5 14400 B760主板 32G内存 5060TI 16G(穷,从4060 8G升级过来的),这是载入后的内存和显存状况,基本快满了,但是跑起来速度还可以,30-40T是有的,上下文设置看启动参数,目前不知道怎么计算多少合适。
    3f93969e-acff-4849-97e8-01a71c58a545-image.jpeg

    4fc253e6-c6fc-41ec-b18c-149b84c9c764-image.jpeg

    下面是我的启动参数:

    llama-server.exe ^
    --models-dir D:\llamacpp\models ^
    --mmproj "%MODEL_DIR%%MODEL_MMP%" ^
    --models-max 1 ^
    --host 127.0.0.1 ^
    --port 8080 ^
    -c 65536 ^
    -np 1 ^
    -ngl 99 ^
    --fit off ^
    -fa on ^
    --jinja ^
    --reasoning auto ^
    --reasoning-format auto ^
    --ui-mcp-proxy ^
    --cache-type-k q8_0 ^
    --cache-type-v q8_0 ^
    --spec-type draft-mtp ^
    --spec-draft-n-max 2 ^
    -t 8

    看看下一步能不能跑hermes看看,目前还在学,不知道怎么弄。
    有没有大神指点一下这个还有什么优化改进空间。

    LLM讨论区 rtx5060 qwen-27b llama.cpp
  • 登录

  • 登录或注册以进行搜索。
  • 第一个帖子
    最后一个帖子
0
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组