
我跟你们讲,这个人物替换我之前研究了一段时间,好像有几个加速lora是会影响到人物替换的,特别是那个4step的加速,经常只替换服装,不替换人脸的,把加速lora屏蔽掉,替换成功率会高很多,应该是有bug的。
建议用10步以上做人物替换,lora不要用太多。
 B
byronduck-jpg
@byronduck-jpg
-
MiniMax-H3-角色替换-程小姐的一天 -
【硬核实测】M5 Ultra 本地 AI 视频生成与大模型推理评测:ComfyUI 翻车 · H3.C 救场 · MLX-Serve 留下楼主,我确认一下没看错吧:
DeepSeek-V4.1-Flash(iQ 3.0bpw 巨无霸 427GB)模型,在你这mac M5 ultra 256G内存的机器上,跑出了稳态解码 101 ~ 110 tok/s,16k 预填充飙至 2,038 tok/s
400多G的模型,在256G统一内存上还有100token每秒的速度,这已经很生产力了啊 -
在Mac Mini M4 Pro 64GB 上部署本地模型楼主你有机器就直接安装comfyui把各种主流图片、视频模型都跑一遍给我们没有的看看实际情况啊
-
近无损量化 Qwen3.8-27B-GSQ-RCO-IQ3_S-mtp.ggufhuihuiai已经出了去审查版本,还有个更小的Bonsai 系列版本只要7G不到
-
DDR4 服务器内存256G + RTX 3090 双卡 应该升级怎样的平台?感觉楼主除非要搞那种非法的或成人的内容,不然不如用线上的AI吧,电费都要贵死
-
小白 硬件 购买推荐买RTX pro 4500吧,虽然只有32G显存,但价格和4090 48G差不多,性价比不如R9700,但是有CUDA加持
-
马上 MAC 512g ultra studio就要出来了,大师们,怎么穷尽其玩耍?是否有Mac studio 128、256这种规格跑LLM模型的评测,以及跑comfyui里面wan2.2和minimax h3的测评?好像网上搜半天都是M1和M2的,没有M3和M4的
-
新手贴:配置32G内存+5060TI 16G跑Huihui-Qwen3.8-27B-abliterated-GSQ-RCO-IQ3_S-mtp,在40上下tokens/s。我认为5060ti 16G真是一个入门摸的神卡,便宜能学
-
新手贴:配置32G内存+5060TI 16G跑Huihui-Qwen3.8-27B-abliterated-GSQ-RCO-IQ3_S-mtp,在40上下tokens/s。我是一个新手,还在摸索阶段,只知道复制别人的东西过来修修改改。
huihui-ai/Huihui-Qwen3.8-27B-abliterated-GGUF
这个huihui的模型里面,有一个来自于 ISTA-DASLab/Qwen3.8-27B-GSQ-RCO-GGUF模型的去审查版本,只有11G左右,但是质量非常高,由于是 ISTA-DASLab这个全球开源AI研究的顶尖实验室的作品,其Q3S的部分能力比起BF16近乎无损。目前从官方评测来看,它应该是量化的qwen3.8 27B模型里面又小又强的一个典范。
我的配置是i5 14400 B760主板 32G内存 5060TI 16G(穷,从4060 8G升级过来的),这是载入后的内存和显存状况,基本快满了,但是跑起来速度还可以,30-40T是有的,上下文设置看启动参数,目前不知道怎么计算多少合适。
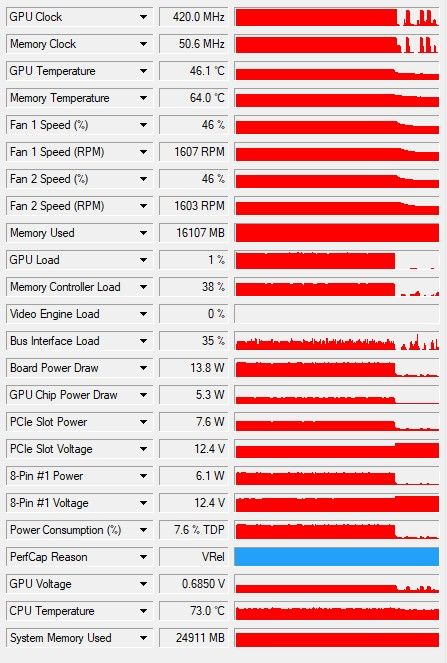
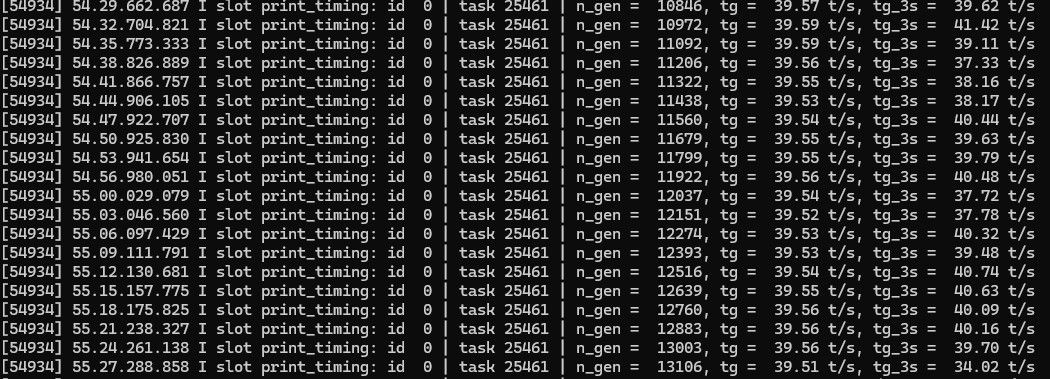
下面是我的启动参数:
llama-server.exe ^
--models-dir D:\llamacpp\models ^
--mmproj "%MODEL_DIR%%MODEL_MMP%" ^
--models-max 1 ^
--host 127.0.0.1 ^
--port 8080 ^
-c 65536 ^
-np 1 ^
-ngl 99 ^
--fit off ^
-fa on ^
--jinja ^
--reasoning auto ^
--reasoning-format auto ^
--ui-mcp-proxy ^
--cache-type-k q8_0 ^
--cache-type-v q8_0 ^
--spec-type draft-mtp ^
--spec-draft-n-max 2 ^
-t 8看看下一步能不能跑hermes看看,目前还在学,不知道怎么弄。
有没有大神指点一下这个还有什么优化改进空间。