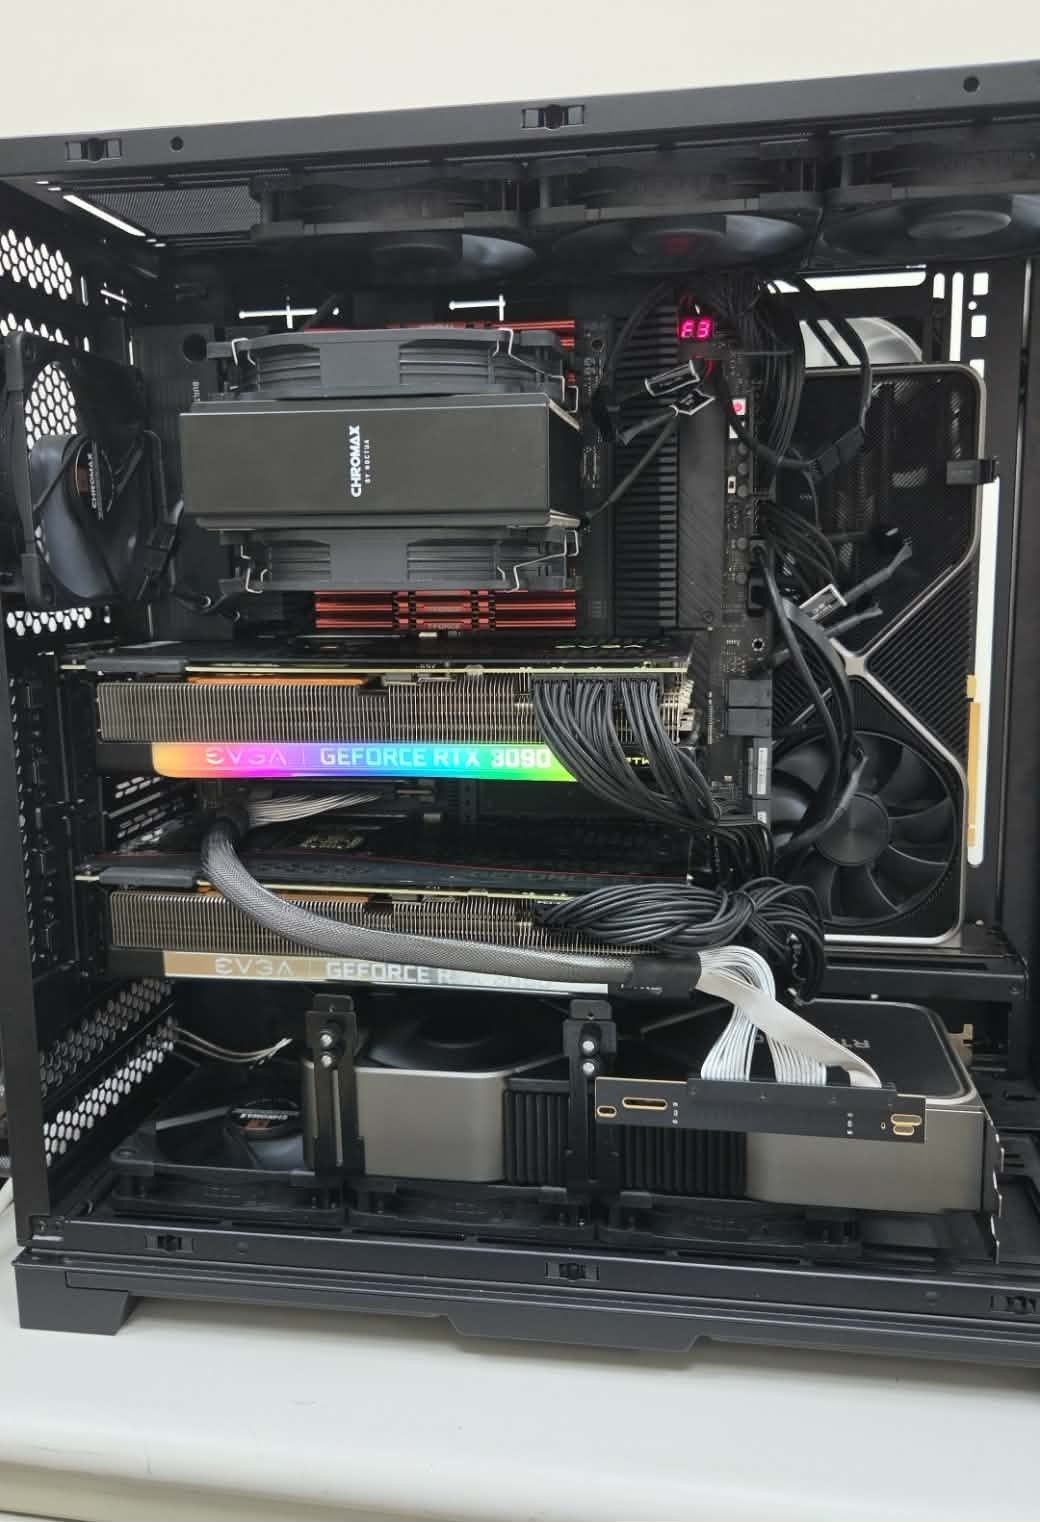
最近中秋前夕太忙哩,本來就想支持的,拖到現在
感謝 @starryskyknight 大神讓我少走很多彎路
架構:tp=2×2 雙實例 + sglang-router
對外入口 sglang-router → :8000 → round_robin 分流到 8001/8002
實例 A sglang-a → :8001 (GPU0/1, tp=2) healthy
實例 B sglang-b → :8002 (GPU2/3, tp=2) healthy
模型
target: /models/Qwen3.8-27B-AWQ-MTP (twolven abliterated)
draft: /models/Qwen3.8-27B-DFlash2
served-name: qwen3.8-27b,架構 Qwen3_5ForConditionalGeneration
兩實例共用啟動配方(一模一樣)
--tp-size 2 --context-length 262144
--mem-fraction-static 0.86
--kv-cache-dtype fp8_e5m2
--speculative-algorithm DFLASH --speculative-num-draft-tokens 8 (draft=DFlash2)
--mamba-ssm-dtype bfloat16 --max-mamba-cache-size 37 ← P3 修的 mamba cap
--max-running-requests 4
--chunked-prefill-size 2048 --max-prefill-tokens 8192
--enable-hierarchical-cache --hicache-ratio 6.0 --hicache-write-policy write_back ← 真復用
enable_thinking=false(全域關 think)
reasoning-parser qwen3 / tool-call-parser qwen3_coder
硬體 / 系統
4× RTX 3090,全卡 260W + persistence=Enabled,目前 idle(util 0%,溫 29-56°C)
顯存:四卡各佔滿 ~23GB/24GB(模型常駐)
RAM:247G,用 190G / 剩 56G(雙實例 hicache 各 ~43G)
DFLASH2 壓測 — 對齊 lcz.me/topic/1502 uni_bench 口徑
測試規格(帖子統一口徑,強度加倍版)
temp=0, streaming+include_usage, enable_thinking=false
rounds=6(帖子3), max_tokens=1024(帖子512), 並發4路(帖子2)
decode=(comp-1)/(total-ttft),只信 usage.completion_tokens
A. 單實例 :8001 (tp=2, GPU0/1) — 與帖子同構(2×3090 tp=2 單實例)
單路 decode
代碼生成 269.5 t/s (tok/chunk 6.01, TTFT 0.075s)
英文技術論述 169.8 t/s (3.81)
中文常規對話 119.4 t/s (2.68)
中文散文 70.0 t/s (1.57)
並發4路 aggregate
同 prompt (radix 命中) 714.0 t/s
不同 prompt 388.0 t/s
A.對照帖子(NVLink 王者版 / 無NVLink applejuice,都 rounds=3 max512 並發2)
場景 ws-ai(我) 樓主NVLink applejuice無NVLink
代碼單路 269.5 237/246.7 141/235.9
英文技術 169.8 166 140.8
中文對話 119.4 123 99.0
中文散文 70.0 92 61.4
並發同prompt 434.6(2路) 440 429.7
並發4路同 714.0 — —
判讀
- 單路全項贏或持平 applejuice(同為無 NVLink 同硬體),且贏樓主 NVLink 版的代碼/英文——無 NVLink 非瓶頸再次坐實。中文散文 70 稍低於樓主 92,是 accept len 低場景(tok/chunk 1.57),draft 命中差異,非環境問題。
- 並發同 prompt:2路434.6 對齊帖子 430/440;4路衝到 714,radix 命中下近線性放大(mrr=4 吃滿)。
B. 全系統 router :8000(雙實例 tp=2×2, 四卡全用)
單路 decode(經 router 分流,與單實例幾乎一致)
代碼生成 265.1 t/s
英文技術論述 172.2 t/s
中文常規對話 123.1 t/s
中文散文 71.6 t/s
並發8路 aggregate(雙實例 mrr=8 全壓)
同 prompt (radix 命中) 1387.1 t/s
不同 prompt 663.9 t/s
系統總產能全景(同代碼場景,同口徑)
配置 同prompt理想上界 不同prompt實戰
單實例 tp=2 2路 434.6 433.0
單實例 tp=2 4路 714.0 388.0
雙實例 8路(全系統) 1387.1 663.9
判讀
- 系統峰值 1387 t/s(8路同prompt),對比單實例4路714,雙實例近乎線性翻倍(1.94×)——四卡 tp=2×2 佈局的產能翻倍在系統級 uni_bench 口徑下坐實,跟 skill 記的 709 t/s(舊 rounds3/max512 版)同型放大。
- 不同 prompt 8路 663.9:這是最貼近來福真實負載的數字——8 張不同 issue 並發,無共享 radix,overlap 打折後系統仍能吐 664 t/s。對比單實例4路不同prompt 388,雙實例約1.71×。
- 單路 decode 經 router(265/172/123/72)vs 直打單實例(270/170/119/70)幾乎無損,round_robin 分流沒吃掉單路速度。