跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签 硬件 AI 广场
Eric SuE

Eric Su

@Eric Su
取消关注 关注
关于
帖子
13
主题
0
分享
0
群组
0
粉丝
0
关注
0

帖子

最新 最佳 有争议的

  • 【倡议】3090 单/双/多卡联合评测帖(2026年9-10月)—— benchmark与配置/模型对比
    Eric SuE Eric Su
    LLM讨论区 rtx3090 多卡部署

    @applejuice 離開辦公室哩,下禮拜繼續玩玩...剛主要在拷問有沒有DF的替代方案...

    演算法 pp>1 能用? 依據
    DFLASH(現役) ✗ 硬擋 arg 層 raise「only supports pp_size==1」(需獨立 draft 模型,不吃 PP_SPEC 路徑)
    DSpark ✗ 硬擋 同上 raise(596)
    UNO ✗ 硬擋 要求 TP=PP=1(506)
    EAGLE / NEXTN ✓ 可用 arg 層無 pp gate + 正是 PP_SPEC 路徑的目標
    NGRAM 待確認 arg 層無 pp gate,但 PP_SPEC 註解只提 MTP draft,NGRAM 走 trie 非 MTP,可能不吃這條路

    機制(scheduler.py L1033-1042 + L1172-1177):

    • 有一個環境變數 SGLANG_ENABLE_PP_SPEC(預設 False)。
    • 開啟後,pp 的非最後 stage 不跑 draft worker,只跑 verify-shaped target forward;draft(MTP layer)集中在最後 stage(因為 MTP head + lm_head 只在最後 stage)。
    • spec_info.py 有專門的 PP_SPEC_RELAY 中繼機制串接。

    為什麼 EAGLE 特別合適我們:
    現役模型 Qwen3.8-27B-AWQ-MTP 本身就內建 MTP head。EAGLE 直接吃這個內建 head 當 draft,不需獨立 draft 權重——skill 記載 DFLASH2 之前的正式配方就是 EAGLE(代碼 179 t/s、accept len 6.0),現役 image 就有,零額外下載。

    一個誠實的但書(未坐實,要實測)

    SGLANG_ENABLE_PP_SPEC 預設 False + 註解措辭(「非最後 stage 沒 draft worker」)透露這是實驗性/新路徑。三件事只有實測才知道:

    1. EAGLE + PP_SPEC + 我們這個 GDN mamba 混合架構會不會有雷(mamba 跨 pp + spec relay 同時作用,是雙重新路徑疊加)。
    2. 開了之後 EAGLE 的 accept len 在 pp 下會不會打折(draft 在 last stage 算、verify 跨 stage,可能有額外開銷)。
    3. 實測速度到底補回多少——理論上比「無 spec 的 71 t/s」高不少,但 pp bubble 還在。

    方案定位

    pp2×tp2 要跑更大模型時,EAGLE + SGLANG_ENABLE_PP_SPEC=1 是把 spec 加回來的正解路徑(取代被擋的 DFLASH),前提是那個大模型也有 MTP head 或 EAGLE draft。這正好把你前面擔心的「pp 丟了 spec 變慢」補上一大塊。


  • 【倡议】3090 单/双/多卡联合评测帖(2026年9-10月)—— benchmark与配置/模型对比
    Eric SuE Eric Su
    LLM讨论区 rtx3090 多卡部署

    @applejuice 正在測...但看來效能可能會很慘(GPU沒吃滿,另不支持DFlash)
    結果::
    pp2×tp2 POC 實測結果(27B)

    可行性 — 過了
    pp2×tp2 在 Qwen3.8-27B 混合架構(GDN mamba+MTP)上能穩定起、能推理。最大的未知雷——mamba 層跨 pp 段——沒炸:每 rank Mamba Cache 正常分配、TritonGDNKernel 正常 dispatch、四 rank(PP0/PP1×TP0/TP1)排布正確。這是 POC 要驗的核心,達成。

    速度 — 27B 上全面輸現役(如預期)

    口徑 pp2×tp2(無spec) 現役 tp2+DFLASH
    單路代碼 71 t/s 260 t/s(-73%)
    單路中文散文 70 73
    併發4路代碼 192 361(-47%)

    主因兩層:

    1. 丟了 DFLASH spec(pp≠1 硬互斥)——tok/chunk 從 ~6 掉到 1.00,單路少吐一堆 token,這是大頭。
    2. pp bubble + 每層仍走 PCIe。

    e9348f43-ee5d-4422-adca-ed78ac7e2678-image.jpeg


  • 【倡议】3090 单/双/多卡联合评测帖(2026年9-10月)—— benchmark与配置/模型对比
    Eric SuE Eric Su
    LLM讨论区 rtx3090 多卡部署

    也是,除非有 四路的 NVLINK...
    不過記錄喚起我的記憶,也是因為 SGLang 不支持會出CustomAllreduce 異常,當下就沒繼續鑽研了


  • 【倡议】3090 单/双/多卡联合评测帖(2026年9-10月)—— benchmark与配置/模型对比
    Eric SuE Eric Su
    LLM讨论区 rtx3090 多卡部署

    @applejuice 有,因 PCIE 頻寬頻頸(沒NVLink),效率低下(雖然96G顯存很吸引人)...
    剛剛又重新跟AI對話下,更新結論

    3090(無 NVLink,全程 PCIe)並行配置比較表
    數字全取自 skill 已固化實測(2026-09-15,社群 uni_bench 口徑,代碼場景)

    比較項 tp=2(單實例,用2卡) tp=4(四卡合一) tp=2×2(雙實例,各2卡)
    卡間鏈路 PCIe PCIe PCIe
    all-reduce kernel custom(較省) 退 NCCL 通用(較慢) custom(較省)
    通信範圍 2 卡對傳 4 卡集合,含跨 PHB 組慢跳 2 卡/實例,零跨組
    單路 decode 249.7 t/s 227.9 t/s(↓9%) 261.7 / 271.8 t/s(各實例)
    併發 4 路 agg 361.0 t/s 228.4 t/s(↓37%) 342.7 / 367.1 t/s(各實例)
    系統總吞吐 361.0 t/s(2卡用,2卡閒) 228.4 t/s 709.8 t/s(兩實例相加,↑97%)
    單模型可用顯存 48GB 96GB(單一池) 48GB × 2(獨立)
    卡使用 2 用 / 2 閒 4 全用 4 全用(2 實例)

    口徑警告(避免誤讀)

    • 709.8 是兩實例併發吞吐「相加」的系統總產能,不是單一請求變快。談速度看單路那列。
    • 單路對照(公平比速度):tp=4 227.9 比 tp=2 249.7 還慢 9% —— tp=4 純速度單路、併發兩頭都輸。
    • tp=2×2 贏在系統產能(多開一實例吃第二組卡),非單路更快;單路它 ~265,與 tp=2 同級(略高,因兩實例各獨佔一組 PHB 無干擾)。

    一句話結論

    • 現役 27B(~19GB,48GB 綽綽有餘):tp=2×2 系統產能最高(709),定案最優。
    • tp=4 唯一價值 = 96GB 單一顯存池,只有在「模型/context 塞不進 48GB」時才選,代價是單路 -9%、併發 -37%。速度維度全輸。

  • DDR4 服务器内存256G + RTX 3090 双卡 应该升级怎样的平台?
    Eric SuE Eric Su
    AI硬件 rtx3090 多卡部署 服务器

    這是上一代的線程撕裂者,很便宜的


  • 【倡议】3090 单/双/多卡联合评测帖(2026年9-10月)—— benchmark与配置/模型对比
    Eric SuE Eric Su
    LLM讨论区 rtx3090 多卡部署

    最近中秋前夕太忙哩,本來就想支持的,拖到現在
    感謝 @starryskyknight 大神讓我少走很多彎路

    架構:tp=2×2 雙實例 + sglang-router

    對外入口 sglang-router → :8000 → round_robin 分流到 8001/8002
    實例 A sglang-a → :8001 (GPU0/1, tp=2) healthy
    實例 B sglang-b → :8002 (GPU2/3, tp=2) healthy

    模型
    target: /models/Qwen3.8-27B-AWQ-MTP (twolven abliterated)
    draft: /models/Qwen3.8-27B-DFlash2
    served-name: qwen3.8-27b,架構 Qwen3_5ForConditionalGeneration

    兩實例共用啟動配方(一模一樣)
    --tp-size 2 --context-length 262144
    --mem-fraction-static 0.86
    --kv-cache-dtype fp8_e5m2
    --speculative-algorithm DFLASH --speculative-num-draft-tokens 8 (draft=DFlash2)
    --mamba-ssm-dtype bfloat16 --max-mamba-cache-size 37 ← P3 修的 mamba cap
    --max-running-requests 4
    --chunked-prefill-size 2048 --max-prefill-tokens 8192
    --enable-hierarchical-cache --hicache-ratio 6.0 --hicache-write-policy write_back ← 真復用
    enable_thinking=false(全域關 think)
    reasoning-parser qwen3 / tool-call-parser qwen3_coder

    硬體 / 系統
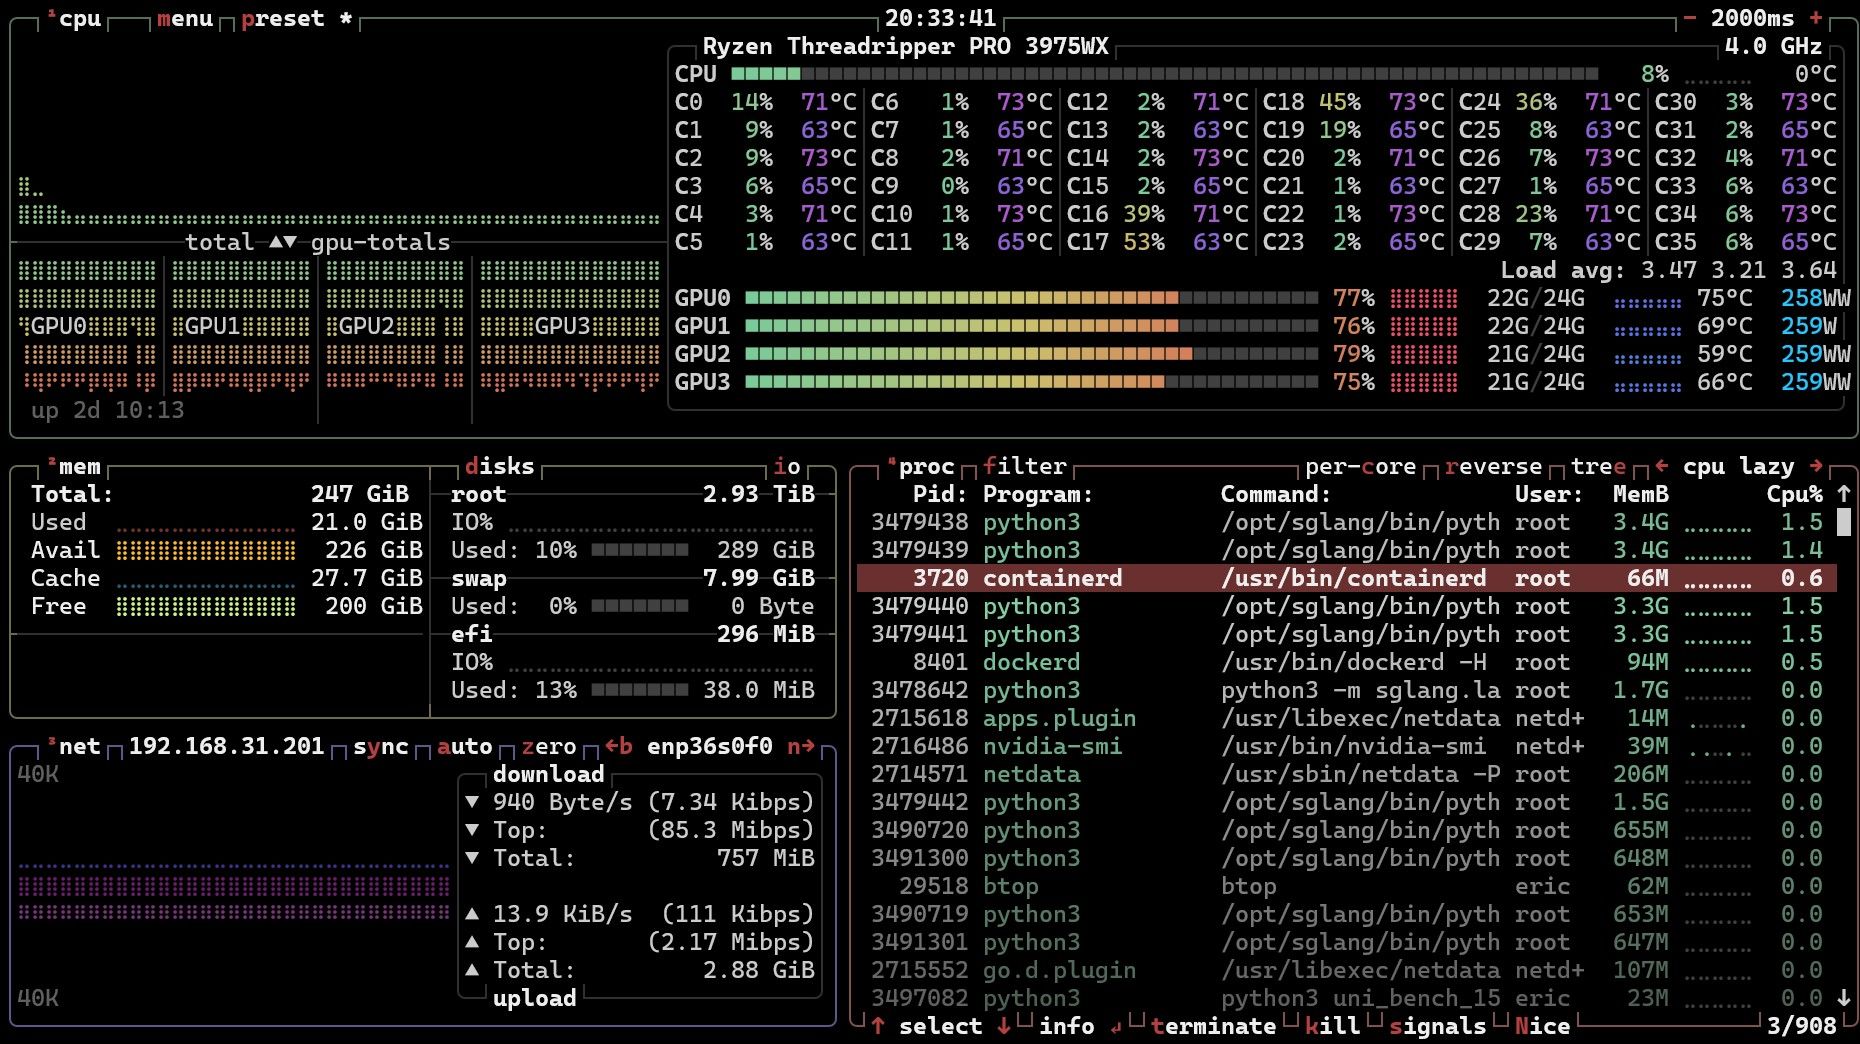
    4× RTX 3090,全卡 260W + persistence=Enabled,目前 idle(util 0%,溫 29-56°C)
    顯存:四卡各佔滿 ~23GB/24GB(模型常駐)
    RAM:247G,用 190G / 剩 56G(雙實例 hicache 各 ~43G)

    DFLASH2 壓測 — 對齊 lcz.me/topic/1502 uni_bench 口徑

    測試規格(帖子統一口徑,強度加倍版)
    temp=0, streaming+include_usage, enable_thinking=false
    rounds=6(帖子3), max_tokens=1024(帖子512), 並發4路(帖子2)
    decode=(comp-1)/(total-ttft),只信 usage.completion_tokens

    A. 單實例 :8001 (tp=2, GPU0/1) — 與帖子同構(2×3090 tp=2 單實例)

    單路 decode
    代碼生成 269.5 t/s (tok/chunk 6.01, TTFT 0.075s)
    英文技術論述 169.8 t/s (3.81)
    中文常規對話 119.4 t/s (2.68)
    中文散文 70.0 t/s (1.57)

    並發4路 aggregate
    同 prompt (radix 命中) 714.0 t/s
    不同 prompt 388.0 t/s

    A.對照帖子(NVLink 王者版 / 無NVLink applejuice,都 rounds=3 max512 並發2)

    場景 ws-ai(我) 樓主NVLink applejuice無NVLink
    代碼單路 269.5 237/246.7 141/235.9
    英文技術 169.8 166 140.8
    中文對話 119.4 123 99.0
    中文散文 70.0 92 61.4
    並發同prompt 434.6(2路) 440 429.7
    並發4路同 714.0 — —

    判讀

    • 單路全項贏或持平 applejuice(同為無 NVLink 同硬體),且贏樓主 NVLink 版的代碼/英文——無 NVLink 非瓶頸再次坐實。中文散文 70 稍低於樓主 92,是 accept len 低場景(tok/chunk 1.57),draft 命中差異,非環境問題。
    • 並發同 prompt:2路434.6 對齊帖子 430/440;4路衝到 714,radix 命中下近線性放大(mrr=4 吃滿)。

    B. 全系統 router :8000(雙實例 tp=2×2, 四卡全用)

    單路 decode(經 router 分流,與單實例幾乎一致)
    代碼生成 265.1 t/s
    英文技術論述 172.2 t/s
    中文常規對話 123.1 t/s
    中文散文 71.6 t/s

    並發8路 aggregate(雙實例 mrr=8 全壓)
    同 prompt (radix 命中) 1387.1 t/s
    不同 prompt 663.9 t/s

    系統總產能全景(同代碼場景,同口徑)

    配置 同prompt理想上界 不同prompt實戰
    單實例 tp=2 2路 434.6 433.0
    單實例 tp=2 4路 714.0 388.0
    雙實例 8路(全系統) 1387.1 663.9

    判讀

    • 系統峰值 1387 t/s(8路同prompt),對比單實例4路714,雙實例近乎線性翻倍(1.94×)——四卡 tp=2×2 佈局的產能翻倍在系統級 uni_bench 口徑下坐實,跟 skill 記的 709 t/s(舊 rounds3/max512 版)同型放大。
    • 不同 prompt 8路 663.9:這是最貼近來福真實負載的數字——8 張不同 issue 並發,無共享 radix,overlap 打折後系統仍能吐 664 t/s。對比單實例4路不同prompt 388,雙實例約1.71×。
    • 單路 decode 經 router(265/172/123/72)vs 直打單實例(270/170/119/70)幾乎無損,round_robin 分流沒吃掉單路速度。
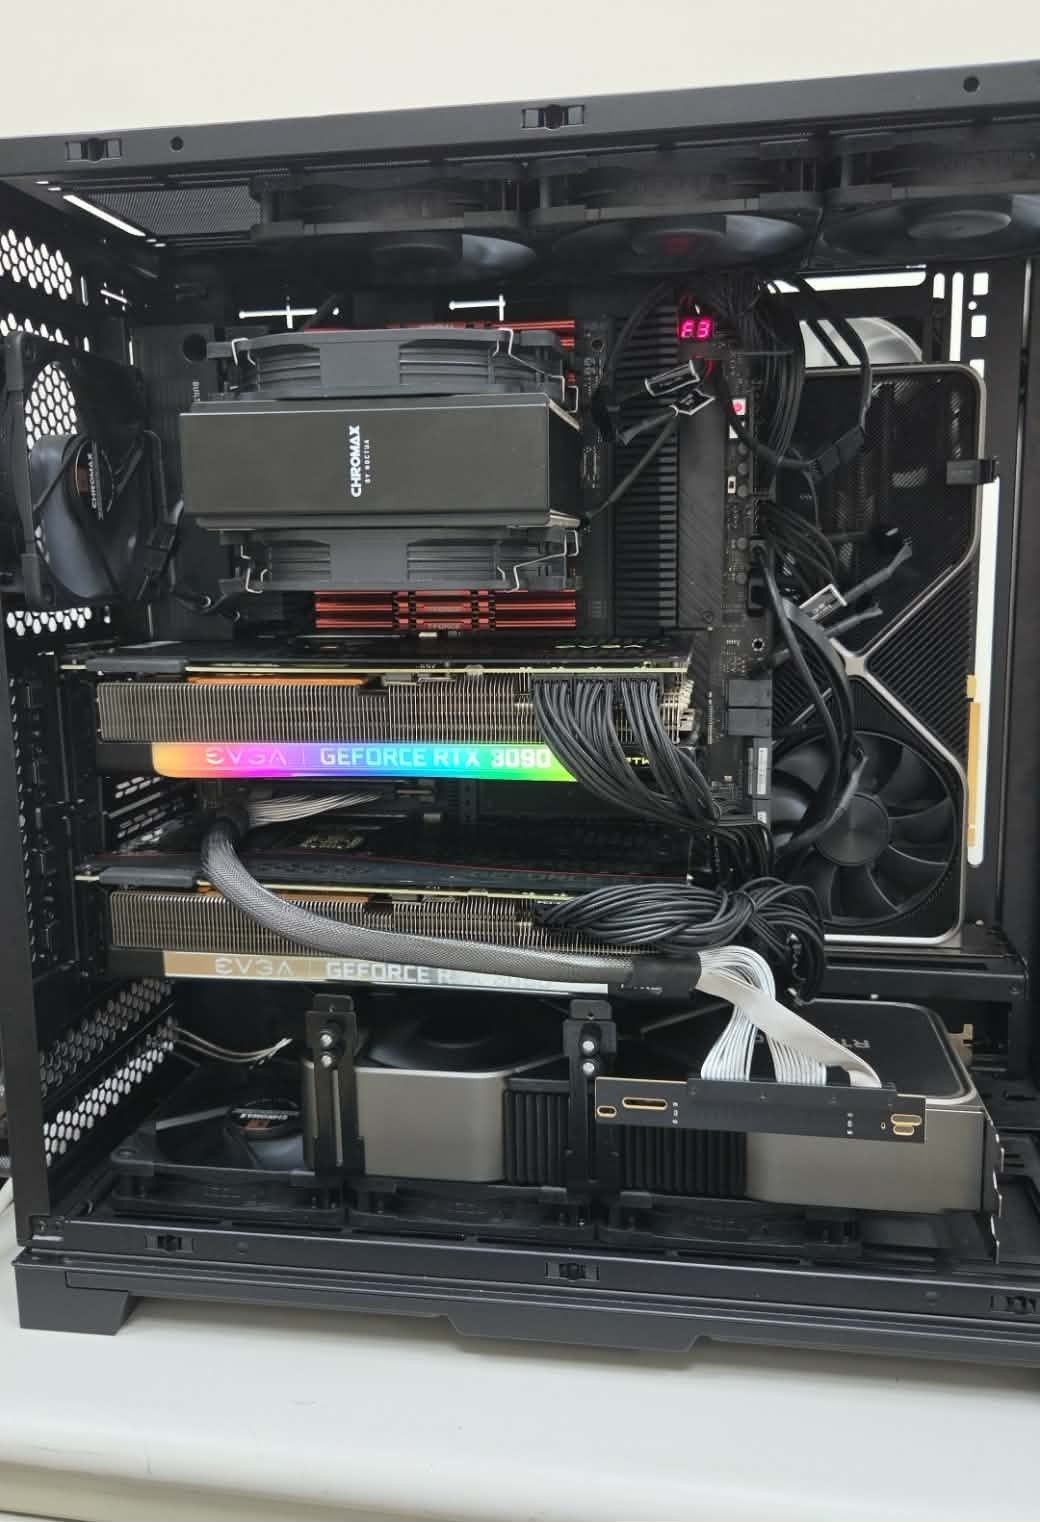
    image.jpeg


  • 【求助】不想碰3090矿卡,7900XTX双卡玩本地AI靠谱吗?后面能加到4卡6卡8卡吗?
    Eric SuE Eric Su
    AI硬件 7900xtx 多卡部署 rocm

    怎麼忽然大家都在問這問題....
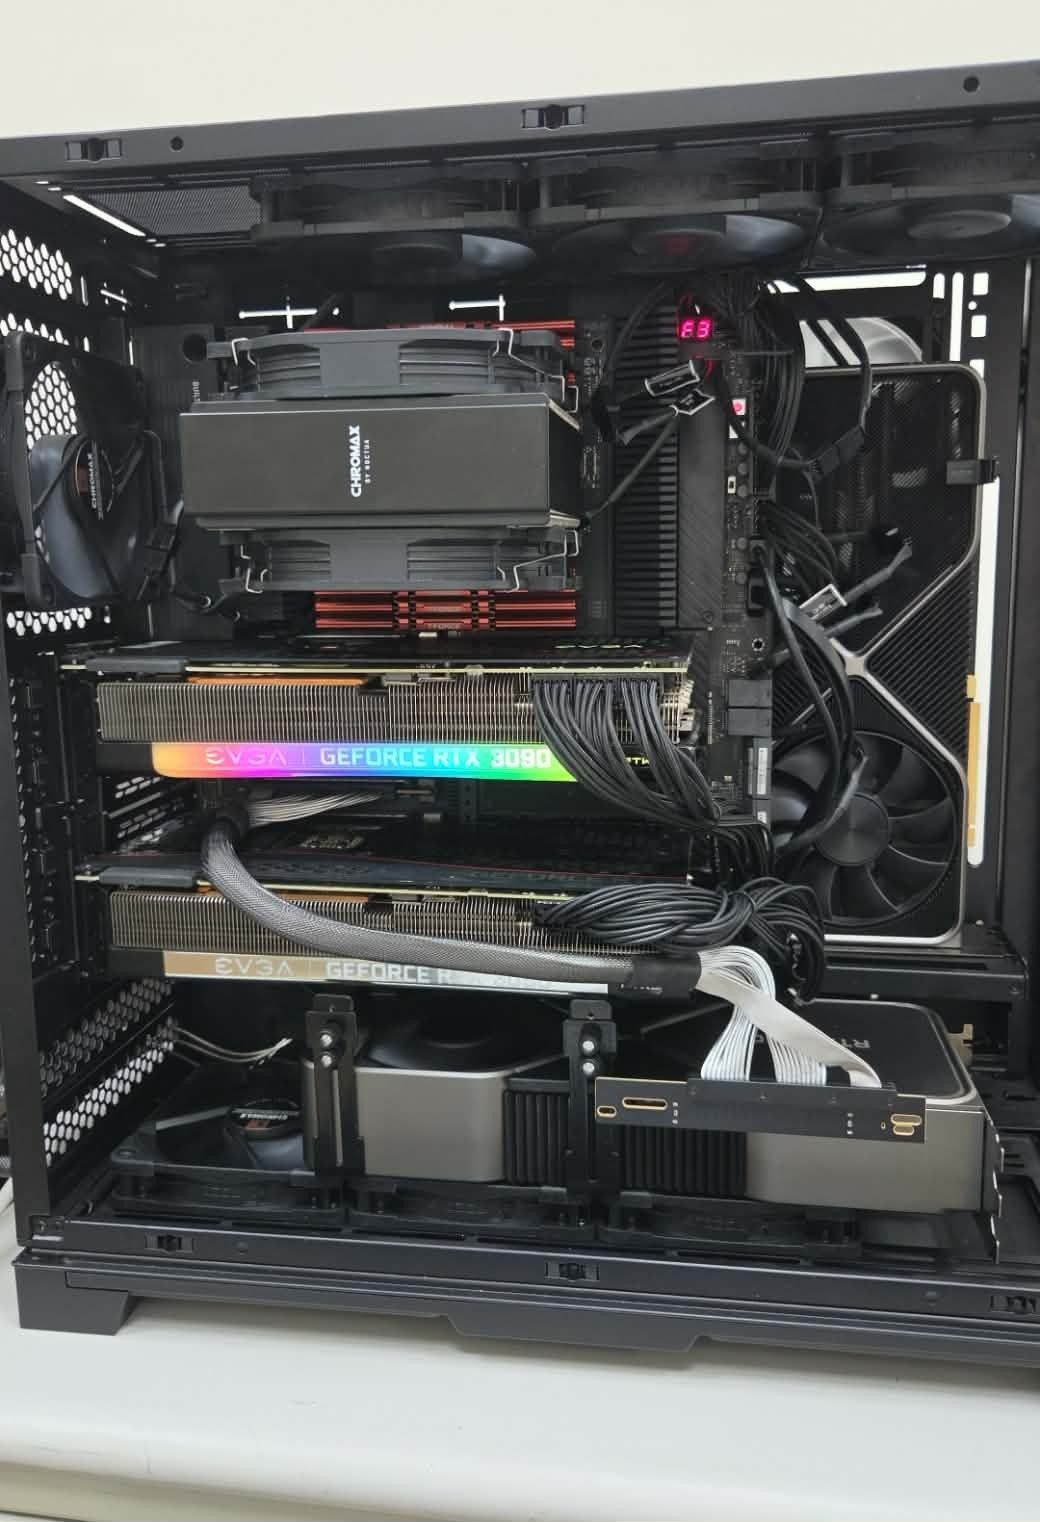
    AMD Ryzen Threadripper PRO 3945WX + ASUS WRX80E
    256G non ecc ddr4 + EVGA 3090 x2 + 3090FE x 2
    實裝沒問題
    image.jpeg


  • DDR4 服务器内存256G + RTX 3090 双卡 应该升级怎样的平台?
    Eric SuE Eric Su
    AI硬件 rtx3090 多卡部署 服务器

    為什麼沒考慮到 AMD Ryzen Threadripper PRO 3945WX + WRX80E
    滿血 PCIE 4 x 16 x 7,而且可以沿用非 ECC DDR4 加上八通道,拿來當 HiCache 用非常完美呀
    我的 3090 x 4 (SGLang TP=2x2) 用起來很完美


  • 求RTX 3090 (后续双卡)的整机配置
    Eric SuE Eric Su
    AI硬件 rtx3090 多卡部署

    其實,現階段主機配置認真推薦基於 WRX80E 去建構
    DDR4 8通道 + PCIE4 x 16


  • 2x3090 NVLink 王者配置再度进化——SGLang dev507 + DFLASH2 全面复测,并发 249 t/s 新高峰
    Eric SuE Eric Su
    LLM讨论区 rtx3090 sg-lang dflash

    @applejuice 沒,生產裝兩台(3945wx+WRX80E+128G DDR4)
    的確有考慮買礦機架來裝,把手上5090/5070Ti都裝上去看看會怎樣
    到時候再貼上來供大家娛樂
    PS. EVGA(大哥) 3090 預設功耗可以到450W


  • 请教购买NVLINK硬件及注意事项
    Eric SuE Eric Su
    AI硬件 多卡部署 nvidia

    @Xiaote 3090FE(初始版、公版)就是3slot的,我手上有兩張
    所以要買nvlink的話就要緊鄰插上然後買4slot的nvlink
    但這樣緊鄰溫度會炸
    FE版本的記憶體溫度在預設功耗下很容易破百

    這幾天也有在研究京東的nvlink(台灣價格真的很誇張)
    才發現原來以前20系的SLI是軟排
    現在pcie5 x 16 的延長軟線都很成熟了
    是不是可以期待更長的軟排版本nvlink...
    不知道有沒有大神給個希望


  • 2x3090 NVLink 王者配置再度进化——SGLang dev507 + DFLASH2 全面复测,并发 249 t/s 新高峰
    Eric SuE Eric Su
    LLM讨论区 rtx3090 sg-lang dflash

    其實都是一樣,市售版(3slot) 3090 x 4 的飄過,雖然當初是想裝兩台做互相備援...
    偉大的祖國怎麼沒人硬改 NVLINK 軟排長線...
    剛看板主的窮人越窮有感而發...


  • Strix Halo本地部署 DeepSeek V4 Flash — 環境、失效、可行與技術總結
    Eric SuE Eric Su
    LLM讨论区 deepseek

    好奇,如果用SGLang會不會有較好的PP表現?

  • 登录

  • 登录或注册以进行搜索。
  • 第一个帖子
    最后一个帖子
0
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组