
就这么卖完了。。。
 E
ericyancw
@ericyancw
-
【摆摊(已告罄 )】哈!终于混出头了,摆个小摊出点硬件! -
[H3剑心比赛] RTX Pro 6000 96G 单卡 · 一条片子 5 分半|MiniMax H3 3D / 2D -
参与者奖励20分,冠军60额外分,亚军30分,季军15分!AMD,Nvidia,Intel,Apple用户同提示词,同规格要求生成竞赛,正面较量!作品结算期限1周!参赛贴ID : https://lcz.me/topic/3069
H3剑心 2D https://youtu.be/r8NvaIm_0NU
H3剑心 3D https://youtu.be/DDn4dBp-0W4 -
【34.5 min → 3.3 min】用对注意力机制的2×7900XTX在H3流程中可以提速多少?—— 答案1050%↑啊,原来你之前也是没有做过ck attention这块的优化,那就属于直接捞了个最大的优化权重。ദ്ദി˶•̀֊•́)
是的,感谢大佬!
之前一直没发现这个问题,当时就是感觉能跑 但一步要跑几分钟,所以头大。 -
【34.5 min → 3.3 min】用对注意力机制的2×7900XTX在H3流程中可以提速多少?—— 答案1050%↑单卡 R9700 32G 跑 MiniMax-H3优化效果:每步从 353 秒到 114 秒
近期一直在搞R9700的Comfyui,搞得有点崩溃,我之前1344×768像素下,测出来的效果一直是每步 353 秒左右,做视频很痛苦。跟着大佬的帖子,让Agent梳理了下,目前提升到114秒
环境
项 对齐前 对齐后 GPU AMD Radeon AI PRO R9700 32 GB(gfx1201) 同左(未变) 系统 ROCm 7.2.53211 7.2.53211(未变) venv 里的 torch 2.10.0+rocm7.0 2.11.0+rocm7.2 torch.version.hip7.0.51831 7.2.26015 torchvision 0.25.0+rocm7.0 0.26.0+rocm7.2 torchaudio 2.10.0+rocm7.0 2.11.0+rocm7.2 ComfyUI 0.41.0 0.41.0(未变) comfy_kitchen 0.2.38 0.2.38(未变) 权重 主模型 ref2va_pruned-w4a812 GB + 编码器qwen3vl_32b-int413.5 GB + VAE 5 GB ≈ 31 GB同左(未变) 出图规格 1344×768(1.03 MP)/ 294 帧 @ 24 fps = 12.25 秒 / 参考图 6 张(ref2v) 同左(未变) 启动参数 无额外开关 --use-ck-attention --disable-smart-memory对齐前 torch 与系统 ROCm 分属 7.0 与 7.2(同大版本、次版本不同);对齐后两端均为 7.2。
之前的问题:
- comfy_kitchen 0.2.38 其实早就装好了。
int8_attention_is_available()在 R9700 上返回 True,HIP 后端也注册成功(backend hip: {'available': True, 'disabled': False})。 - 但 ComfyUI 一直没带
--use-ck-attention启动,所以跑的一直是兜底路径。日志原话:[INFO] Using pytorch attention。 - 每步 353 秒就是这个兜底路径下的数字。作为参照,社区在 832×480 / 362 帧 / 8 步上测到 sub_quad 259 秒/步、CK 50.1 秒/步(外部数据,仅作量级参考)——353 秒与 sub_quad 那一档处于同一量级,而不是 CK 档。
加上开关后日志变成:
[INFO] Found comfy_kitchen backend hip: {'available': True, 'disabled': False, ...}
[INFO] Using Comfy Kitchen attention
[INFO] comfy-kitchen version: 0.2.38
数据表
# 环境 torch / 系统 ROCm 启动参数 注意力后端(日志原文) 步数 每步 采样 端到端 1 之前 2.10.0+rocm7.0(HIP 7.0.51831)/ 7.2.53211 无额外开关 Using pytorch attention8 ≈353 秒 未跑完 — 2 现在 同上,未变 --use-ck-attention --disable-smart-memoryUsing Comfy Kitchen attention4 114.35 秒 7 分 37 秒 13 分 56 秒 3 现在 同上,未变 同上 同上 8 114.33 秒 15 分 14 秒 21 分 16 秒 4 对齐后 2.11.0+rocm7.2(HIP 7.2.26015)/ 7.2.53211 同上 同上 4 114.37 秒 7 分 37 秒 未留存 5 对齐后 同上 去掉 --use-ck-attention,仅--disable-smart-memoryUsing pytorch attention4 352.31 秒 23 分 29 秒 29 分 45 秒 五行同为 1344×768、294 帧、同一套 int4 权重,差别只在启动开关与 torch 版本。第 2、4 行用 4 步 LoRA,第 3 行用 8 步 LoRA;每步 114.35 / 114.33 / 114.37,说明单步成本与步数、LoRA 档位都无关,也与 torch 版本无关。
第 5 行是本轮补的关键对照:同一套 int4 权重、同一环境,只把
--use-ck-attention去掉,每步从 114.37 秒回到 352.31 秒(3.08×)。这说明 3 倍差距完全由这一个开关造成,与其他变量无关。三条同口径结论:
- 单步成本与步数、LoRA 档位无关:114.35 / 114.33 / 114.37。
- 单步成本与 torch 小版本无关:114.35(rocm7.0)对 114.37(rocm7.2)。
- 单步成本与权重精度档无关:353(fp8 组)对 352.31(int4 组),同一 SDPA 路径。
横向对照:同分辨率、同后端,单卡 vs 双卡
社区帖(RX 7900 XTX ×2,RDNA3,ROCm 7.2)与本机同分辨率实测并列。社区数据为其帖子表格原文,仅作量级对照;其序列为 362 帧,比本机 294 帧多 23%。
机器 显卡 卡数 分辨率 / 帧 注意力后端 每步 本机 R9700 32G(RDNA4) 1 1344×768 / 294 CK 114.37 秒 社区 7900 XTX 24G(RDNA3) 2(TP2) 1344×768 / 362 CK 112.3 秒 社区 7900 XTX 24G(RDNA3) 1 1344×768 / 362 CK 257.9 秒 本机 R9700 32G 1 1344×768 / 294 通用 SDPA 352.4 秒 社区 7900 XTX 24G 1 1344×768 / 362 sub_quad 兜底 OOM 两点可直接引用:
- 一张 R9700 ≈ 两张 7900 XTX 的 TP2(114.37 对 112.3)。对方是两张卡张量并行,本机是一张卡。
- 同分辨率单卡对比:114.37 对 257.9,快 2.25×。 扣掉帧数差(294 对 362,少 19%)折算后仍快约 1.8×。
低分辨率参照(社区,832×480 / 362 帧):sub_quad 兜底 259 秒、CK 单卡 53.7 秒、CK TP2 31.9 秒。该档像素仅 0.4 MP,约为本机 1.03 MP 的四成,不能与本机数字直接相比。
对齐 torch 与系统 ROCm 之后:大版本内的对齐,收益基本没有
先界定这次对齐的性质:venv 里
torch.version.hip从7.0.51831变成7.2.26015,系统是7.2.53211,两端始终在 ROCm 7.x 这同一个大版本内,只差次版本。属于「大版本内对齐」——ROCm 同大版本保持 ABI 兼容,内核本来就能正常加载,可修的东西几乎没有。对齐类型 典型例子 预期收益 实测 大版本内(本次) torch 7.0.51831 → 7.2.26015,系统 ROCm 7.2 接近 0,只消除隐患 114.35 → 114.37,+0.02% 跨大版本 torch +rocm10.1.0 链系统 ROCm 7.2(社区) 高,属修复静默降级 4.8×(259 → 53.7) - comfy_kitchen 0.2.38 其实早就装好了。
-
[H3剑心比赛] RTX PRO5000 MiniMax H3 2D / 3D[H3剑心比赛] RTX PRO5000 MiniMax H3 2D / 3D
先说结论
-
12 秒 / 294 帧 / 24fps,2D 与 3D 各一条,一次成型,走同一套多参考图工作流。
-
两条提示词逐字相同(只有第一行的风格词
2D traditional anime/3D CGI animation不同)、seed 相同(813788674966030)、步数相同(12),唯一变量就是风格——所以这是一组干净的对照。 -
实测耗时:2D 678 秒(11:18),3D 721 秒(12:00),均为整段一次跑完(含加载与解码)。
-
加速不靠偷步数,靠蒸馏 LoRA + SageAttention + INT8 注意力后端三层。
-
YouTube:
H3剑心 2D https://youtu.be/r8NvaIm_0NU
H3剑心 3D https://youtu.be/DDn4dBp-0W4
1. 硬件与软件
项 值 GPU NVIDIA RTX PRO 5000 Blackwell,48GB( nvidia-smi实测 48,935 MiB)驱动 621.14 显存占用 单条 12 秒任务常驻约 34GB 系统内存 64GB Python / Torch 3.13.12 / torch 2.12.1+cu130 ComfyUI 0.29(桌面版) 加速运行时 SageAttention 2.2.0+cu130、triton-windows 3.9.0 2. 工作流
- 文件:**MiniMaxH3多参武戏生成工作流_秒数版_直填分辨率V2.json
- 主链:
UNETLoader → LoraLoaderModelOnly(加速)→ LoraLoaderModelOnly(武戏)→ MiniMaxH3MemoryEfficientSageAttentionPatch → 引导器 → BasicScheduler(beta) → SamplerCustomAdvanced → VAEDecode → VHS_VideoCombine - 生成节点:
MiniMaxH3ReferenceToVideo(Ref2VA,多参考图 + 模型自生成音轨) - 帧数不用手算:
秒数(12.0) → ComfyMathExpression → 294 帧,公式max(5, round(秒×24)),再补到 17k+5 - 参考图:6张
3. 加速手段
手段 位置 作用 turbo 8 步蒸馏 LoRA minimax_h3_ref2v_turbo_8step_v1.0_768p@ 1.0链首 把官方 25 步压到 8–12 步,提速主力 SageAttention 补丁 MiniMaxH3MemoryEfficientSageAttentionPatch每个 H3 block int8 注意力内核,日志确认逐 block 生效 INT8 注意力后端 ModelAttentionBackend = comfy kitchen attention采样前 ComfyUI 自带量化注意力 低显存分块 LowVRAMAttention(head_chunks 2)+ChunkFeedForward(2, 4096)采样前 不加速,只为 48G 上稳跑不 OOM - 未用 SOL Attention(本机未装)与 FlashAttention 补丁(未启用)。
- 蒸馏 LoRA 配 8–12 步都在轨;本机对比过 8 / 10 / 12 步,细节随步数继续涨、耗时增量很小,故终版统一 12 步。
4. 完整运行日志
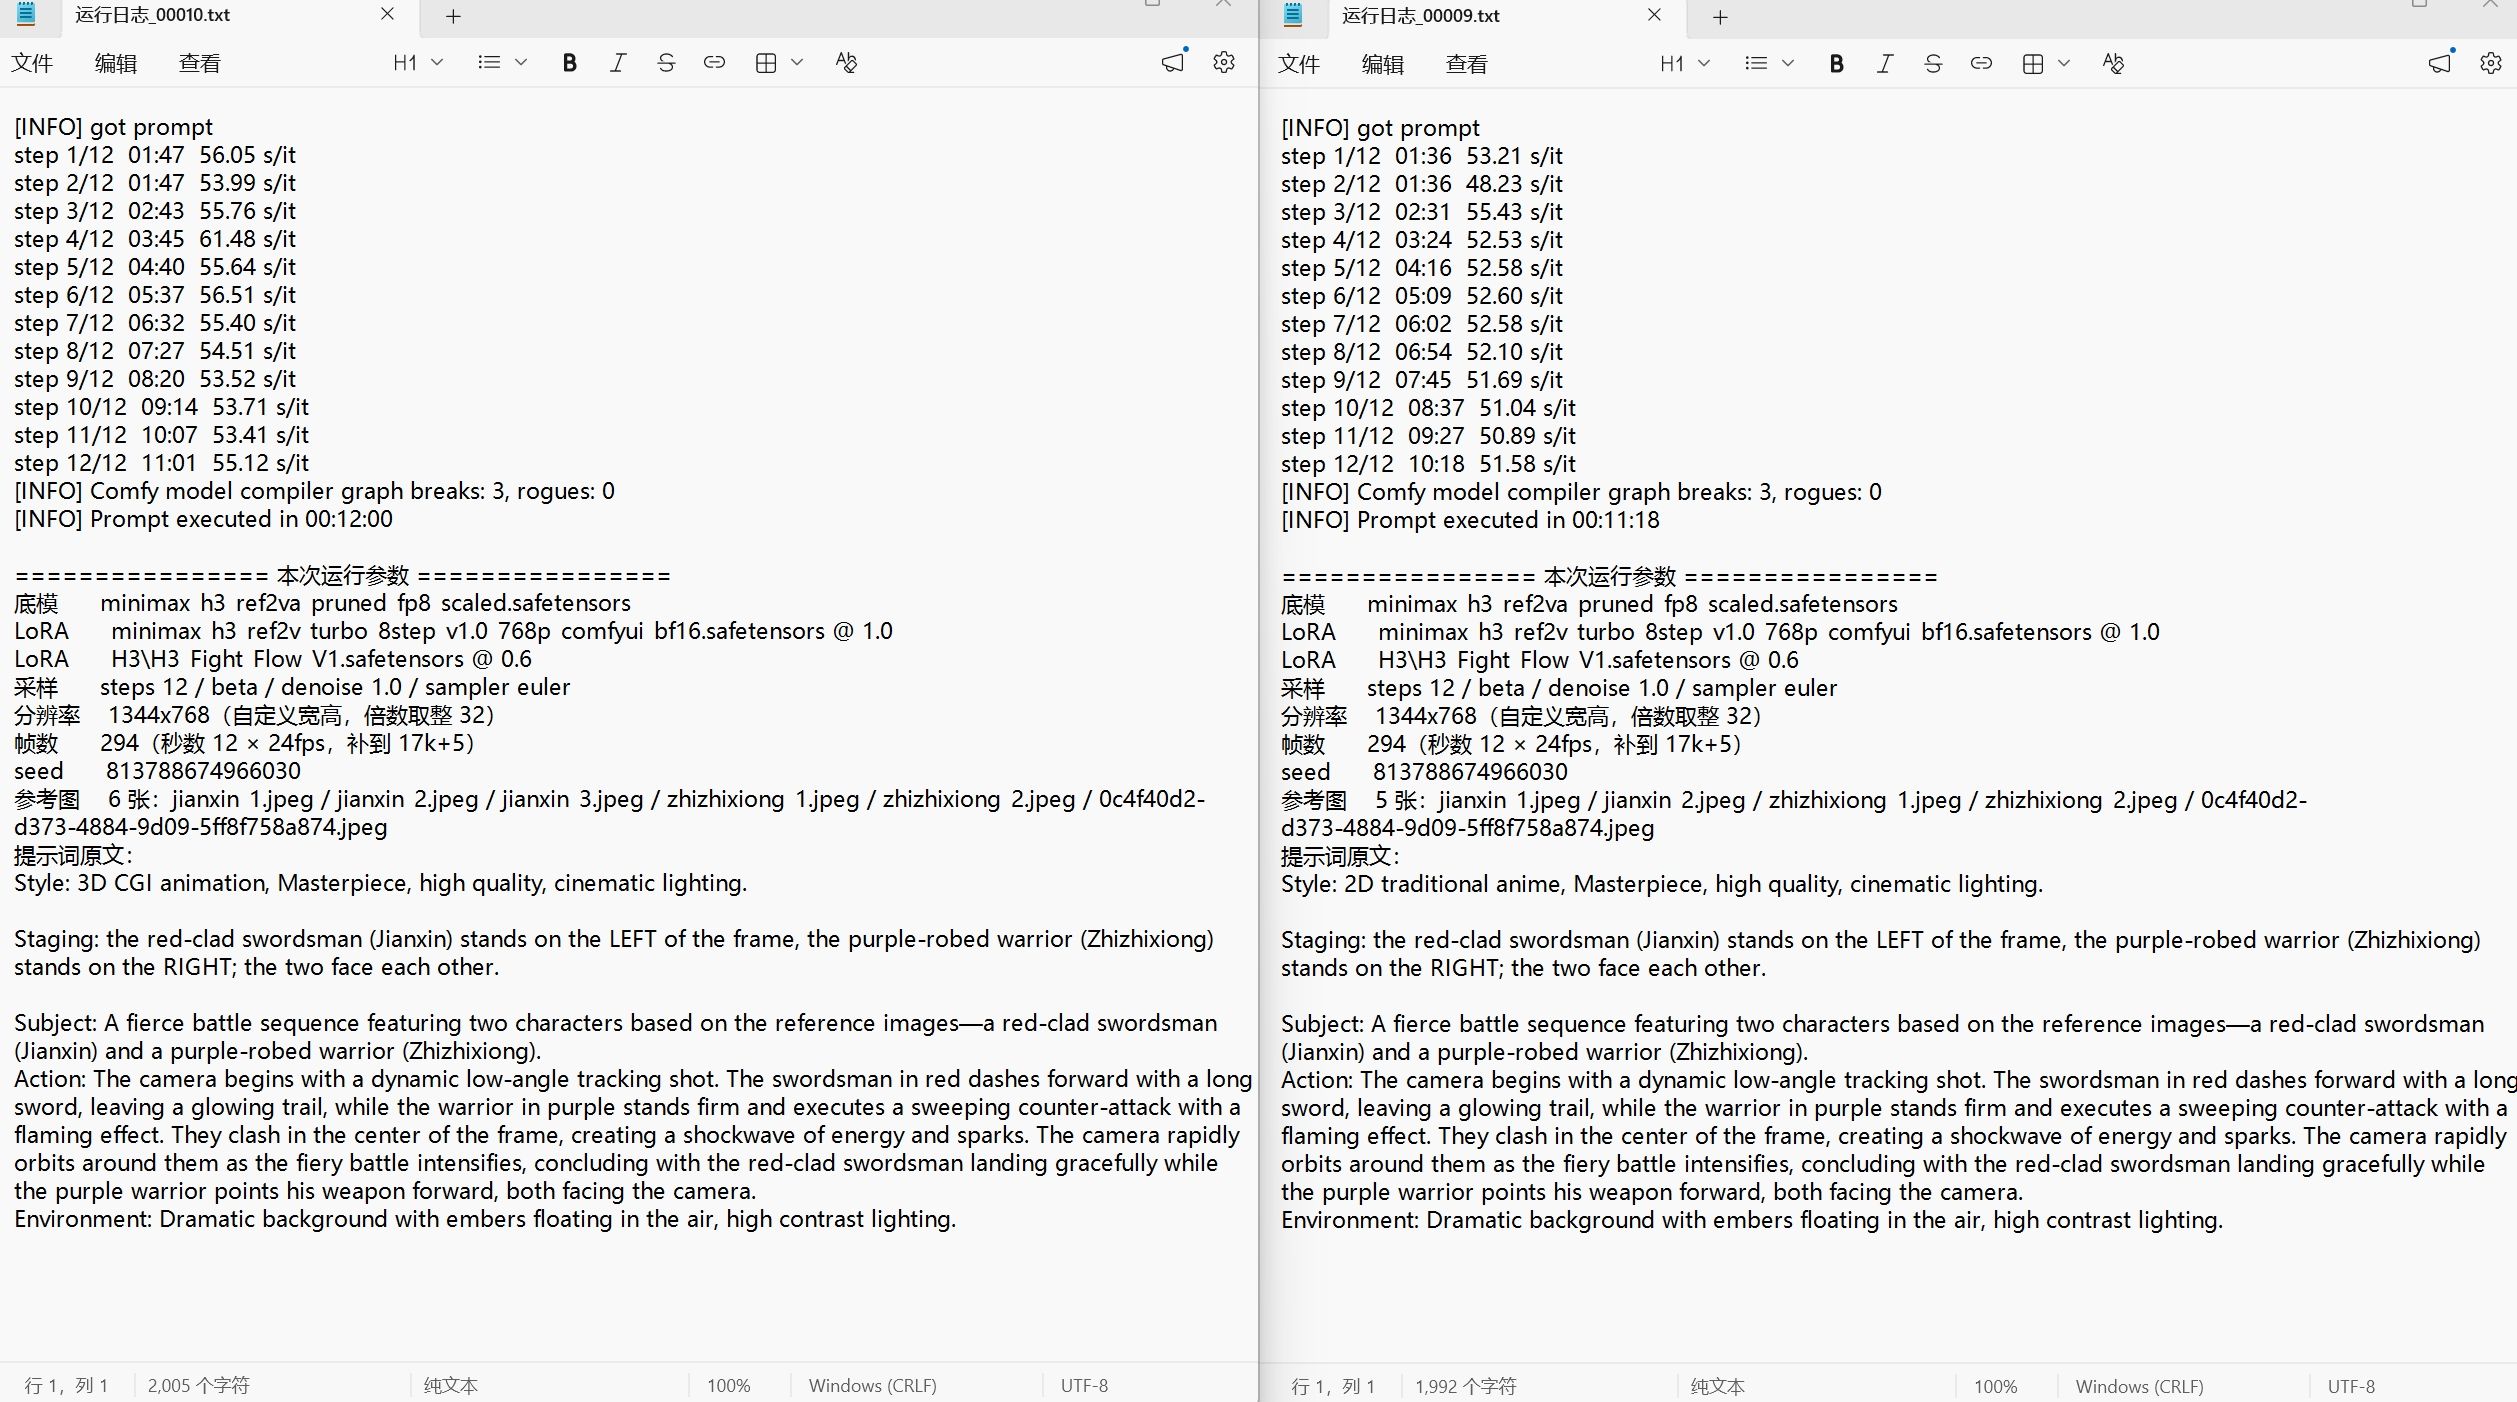
**
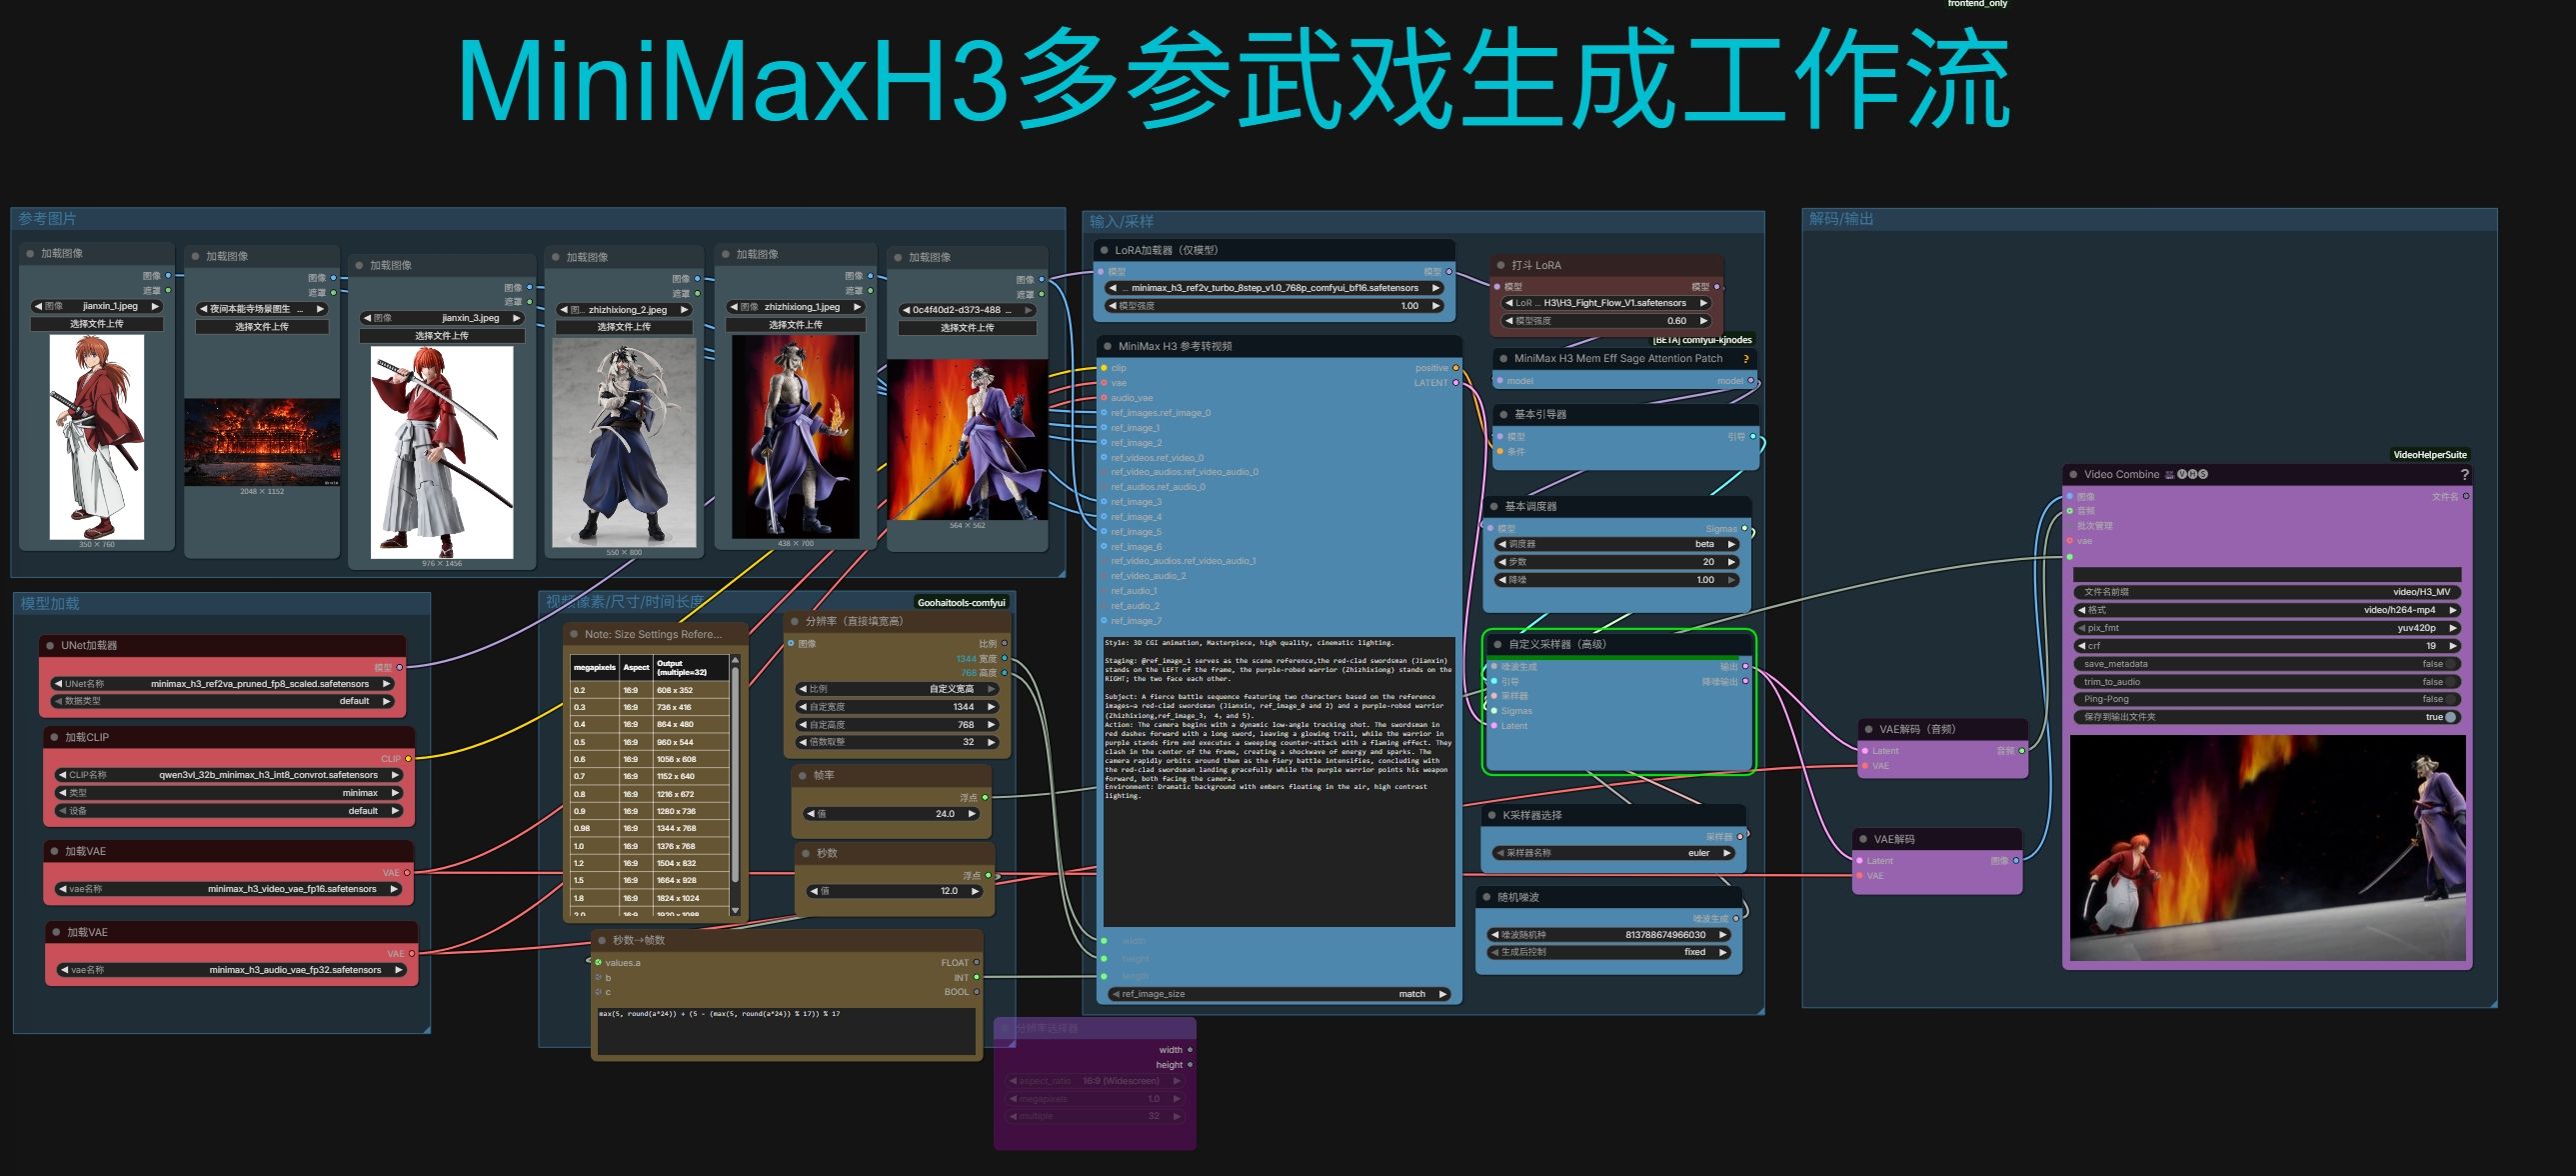
控制台截图**。5. 规格证明
项 2D 3D 工作流 秒数版(直填分辨率 V2) 秒数版(直填分辨率 V2) 步数 12 12 采样器 beta / euler / denoise 1.0 同左 LoRA turbo_8step @1.0 + H3_Fight_Flow_V1@0.6同左 分辨率 1344×768 1344×768 帧数 294 294 时长 12.250s @24fps 12.250s @24fps 音轨 aac 2ch 12.224s(模型自生成) 同左 seed 813788674966030 813788674966030 参考图 5 张 6 张 采样耗时 10:18(末步 51.58 s/it) 11:01(末步 55.12 s/it) 总耗时 678 秒(11:18) 721 秒(12:00) 文件体积 12.5 MB 10.2 MB ffprobe实测(两条输出一致):$ ffprobe -v error -select_streams v:0 -show_entries stream=width,height,nb_frames,r_frame_rate,duration \ -of default=nw=1 视频/H3武戏_2D_12步_00009.mp4 width=1344 height=768 r_frame_rate=24/1 duration=12.250000 nb_frames=294 $ ffprobe -v error -select_streams a:0 -show_entries stream=codec_name,channels,duration \ -of default=nw=1 视频/H3武戏_2D_12步_00009.mp4 codec_name=aac channels=2 duration=12.2240006. 复现清单
- 底模
minimax_h3_ref2va_pruned_fp8_scaled(FLOW_AV / bf16) - 加速 LoRA
minimax_h3_ref2v_turbo_8step_v1.0_768p_comfyui_bf16@1.0 - 武戏 LoRA
H3_Fight_Flow_V1@0.6 BasicScheduler= beta,steps 12,denoise 1.0,采样器 euler194 秒数填 12 → 294 帧;196 分辨率填 1344×768、倍数 32- 参考图按
ref_image_0~ref_image_5顺序喂入(3D 6 张 / 2D 5 张) - 注意力:Sage 补丁 + kitchen attention;显存不够再开 LowVRAMAttention / ChunkFeedForward
-