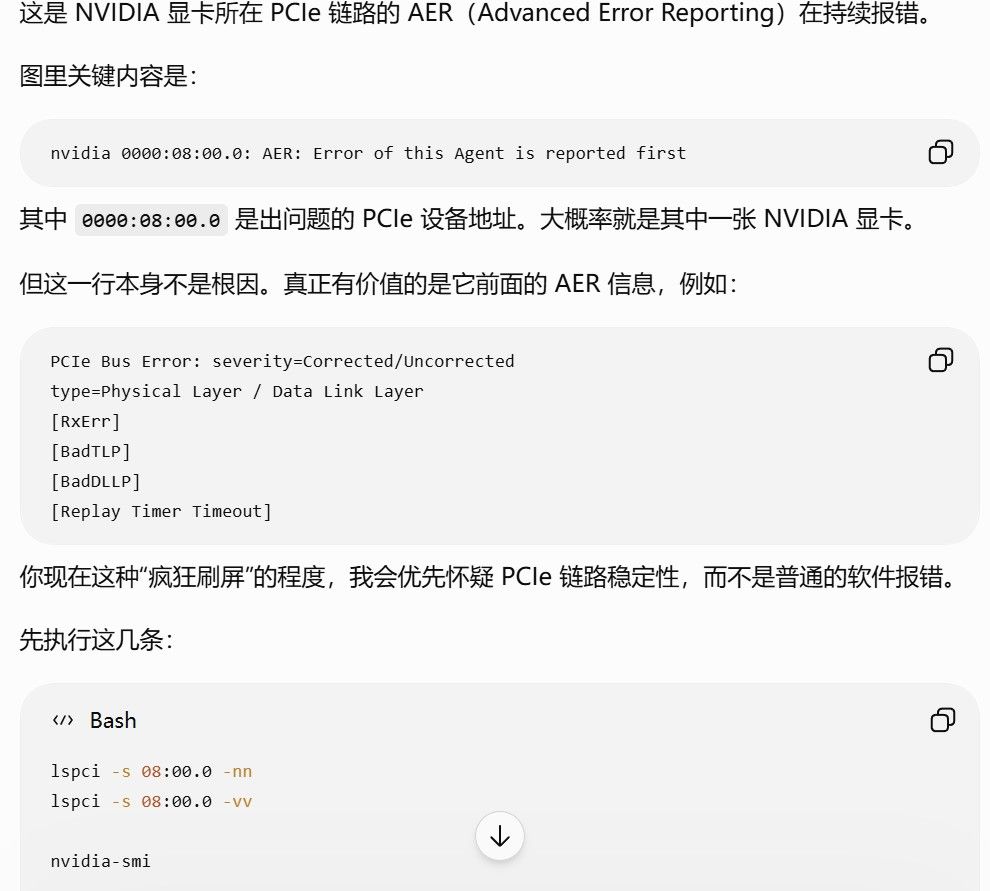
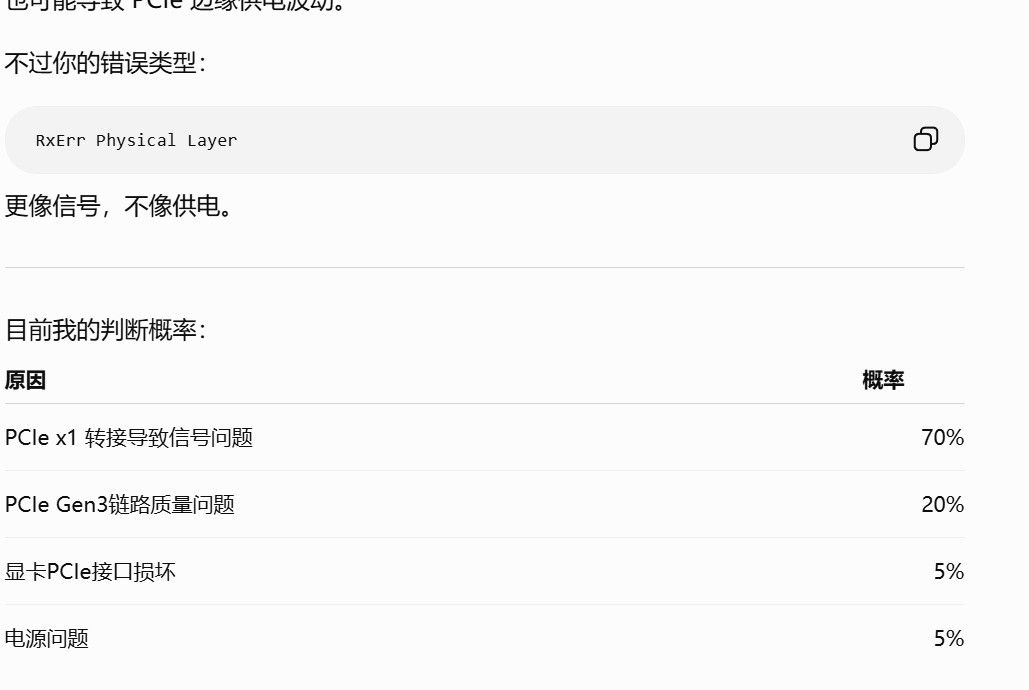
我记得似乎驱动是不一样的,你卸载现在的显卡驱动,去官网下3090的
-
纯小白!笔记本ComfyUI外接RTX3090没有CUDA -
3080 20G*2的有没有,来交流啊兄弟们 -
Qwen3.8-27B-FP8吃上了,接入Deepseek Harness使用 -
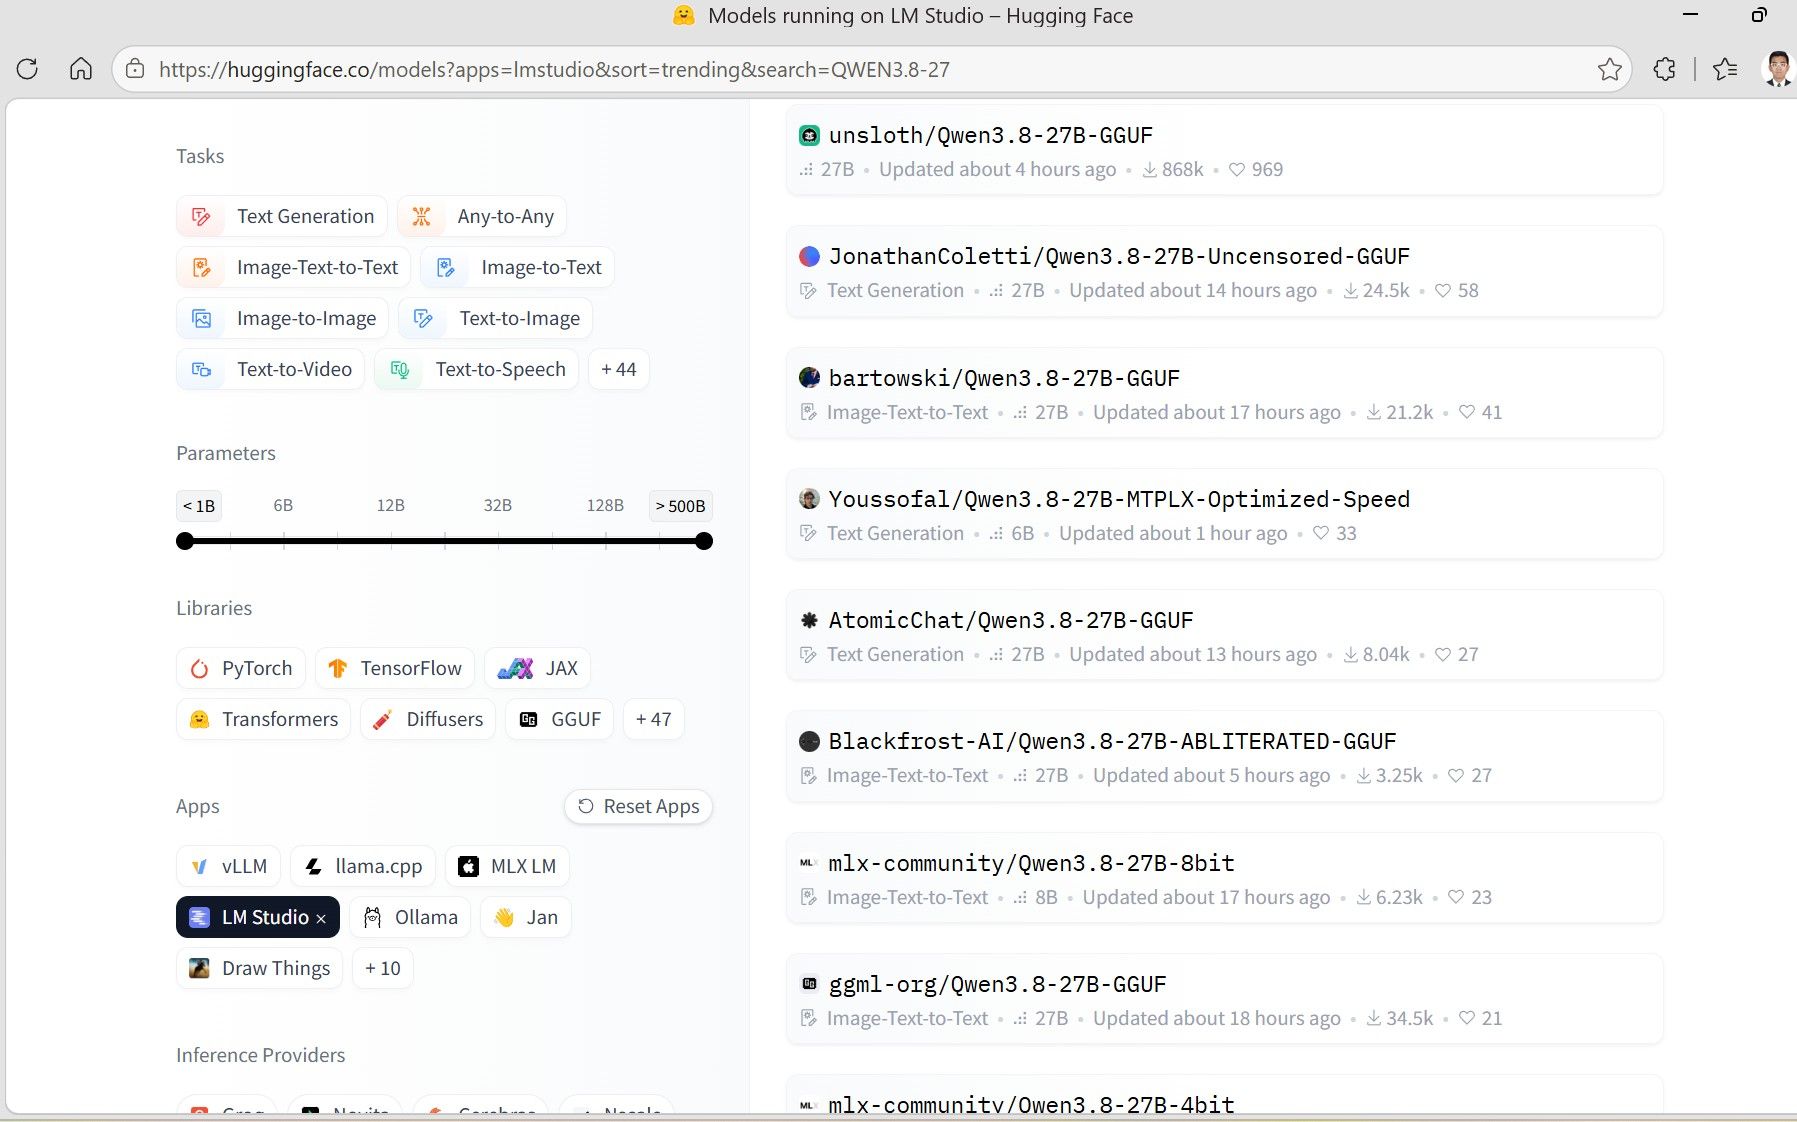
【求助/讨论】7900 XTX 24G + Ollama 用户蹲一个 Qwen3.8-27B,大家有消息吗?支持,只要huggingface上有了,他就能跑:
-
Qwen3.8-27B-FP8吃上了,接入Deepseek Harness使用 -
【求助/讨论】7900 XTX 24G + Ollama 用户蹲一个 Qwen3.8-27B,大家有消息吗?
我一般喜欢用opencode,开箱即用,没有hermes那么重。
优化可以直接使用里面免费的deepseek v4 flash模型,效果很不错,你看这就是本机优化的结果
-
【求助/讨论】7900 XTX 24G + Ollama 用户蹲一个 Qwen3.8-27B,大家有消息吗? -
【求助/讨论】7900 XTX 24G + Ollama 用户蹲一个 Qwen3.8-27B,大家有消息吗?换lm studio吧
-
3080 20G*2的有没有,来交流啊兄弟们 -
有人试过这种在线租赁的没感觉挺便宜,至少现在网吧开一个小时也没两块的了。
-
3080 20G*2的有没有,来交流啊兄弟们没接nvlink吗?我记得3080能接
-
7900XTX+Qwen 3.8 27B Q4 + DeepSeek Harness 实测rocm看来和cuda还是有差距
-
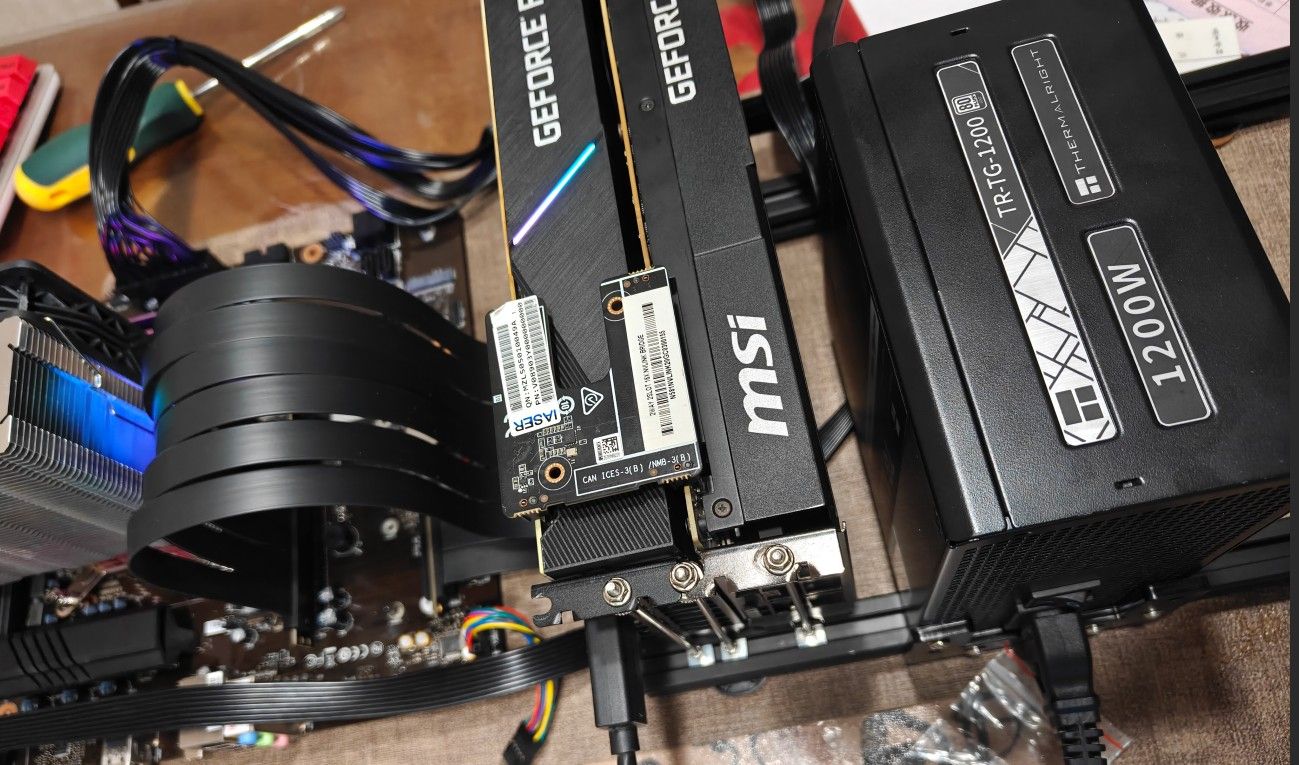
Qwen3.8-27B-FP8吃上了,接入Deepseek Harness使用我是延长线连接,可能是线路太劣质了,用一阵会are报错。
现在两张卡是运行在pcie3.0 x1 模式下;通过nvlink桥接
-
Qwen3.8-27B-FP8吃上了,接入Deepseek Harness使用服务器没梯子,huggingface连不上,用modelscope下的:
modelscope download Qwen/Qwen3.8-27B-FP8 --local-dir ./Qwen3.8-28B-FP8早上收到订阅邮件
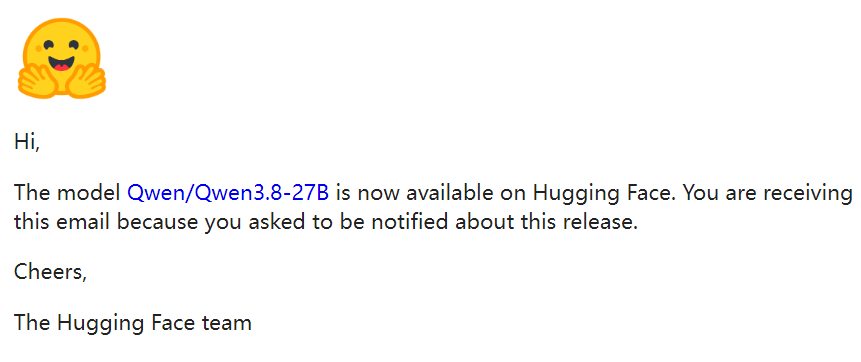
立马开测
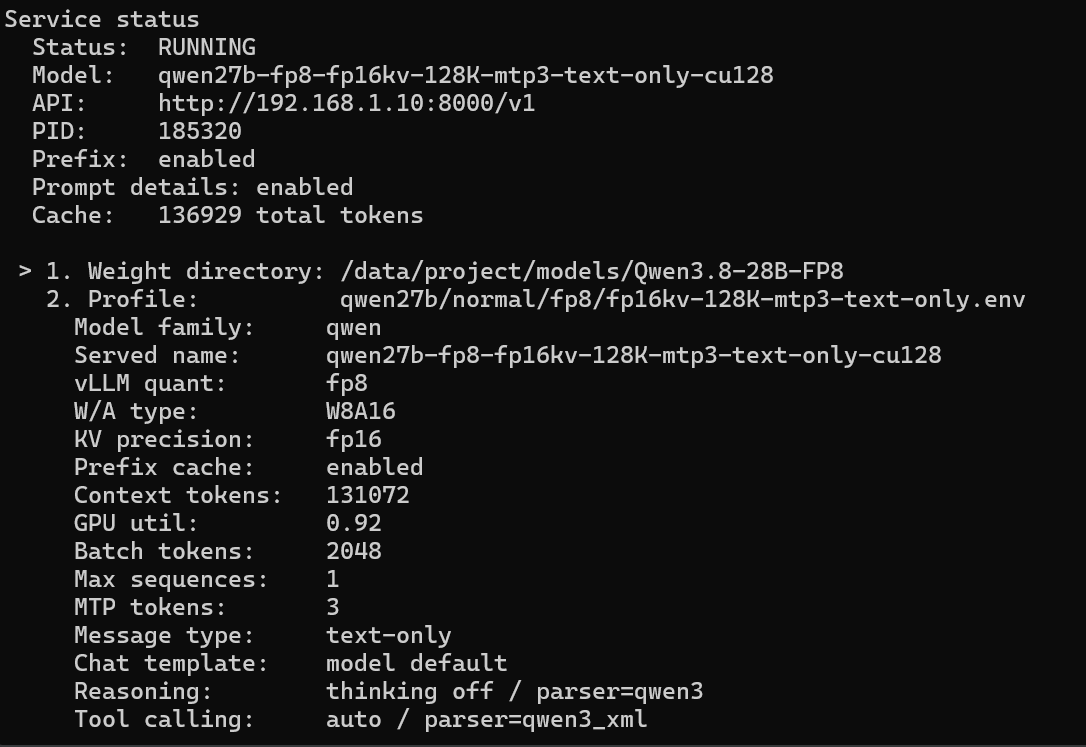
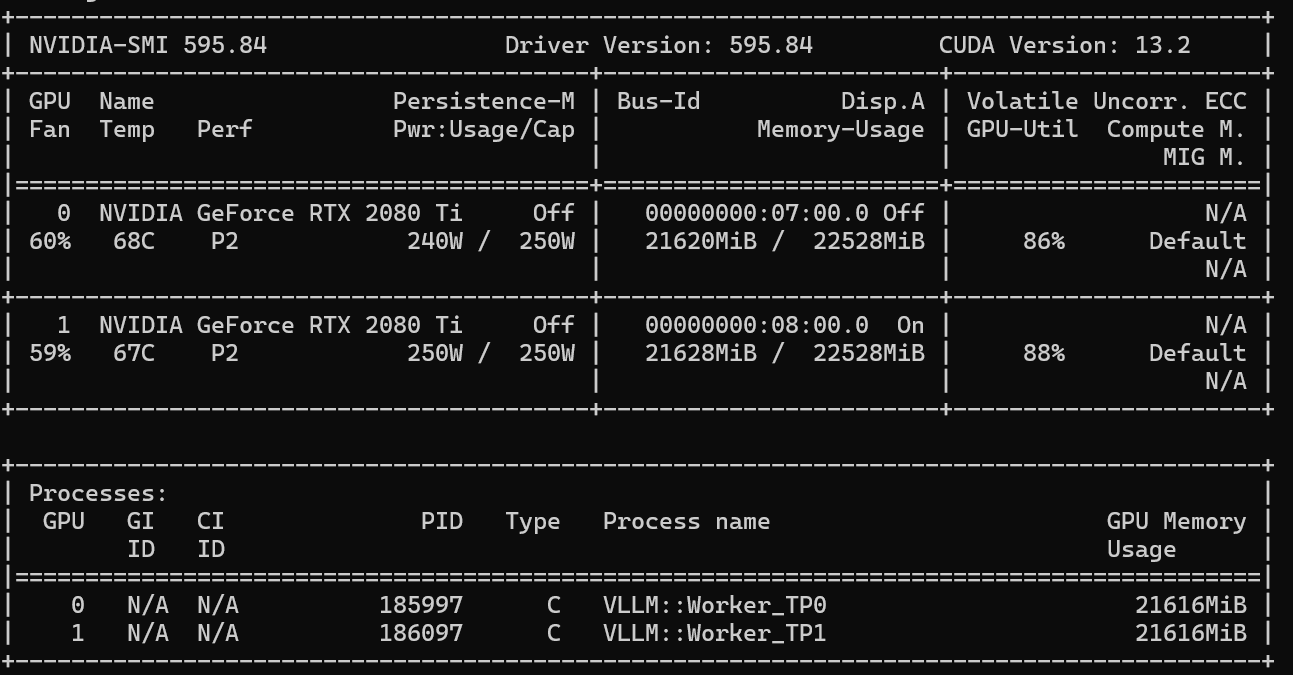
搭配Deepseek Harness
简单测试成果:
-
【国产替代】智铠100 32Gx2部署Qwen3.6-35B-W4A8含多并发测试结果@566656661 这卡待机功耗也太高了,两张100w,在旁边闷热闷热的
-
【国产替代】智铠100 32Gx2部署Qwen3.6-35B-W4A8含多并发测试结果@566656661 我这里是个台式机,推理卡也是改了涡轮散热,太神奇了

-
【国产替代】智铠100 32Gx2部署Qwen3.6-35B-W4A8含多并发测试结果 -
双 3090(NVLink)跑 Qwen3.6-27B,128K 上下文实测@applejuice 架子65,延长线贵延长线要¥69,30厘米的
nvlink是卖显卡那个二手店套餐送的
-
双 3090(NVLink)跑 Qwen3.6-27B,128K 上下文实测 -
2x2080ti nvlink到祸了。想问问大家有没有测试LLM脚本我看得github项目,vllm啥的都是一条龙配好的。但是bench跑不起来,我想测试一下输出速度