

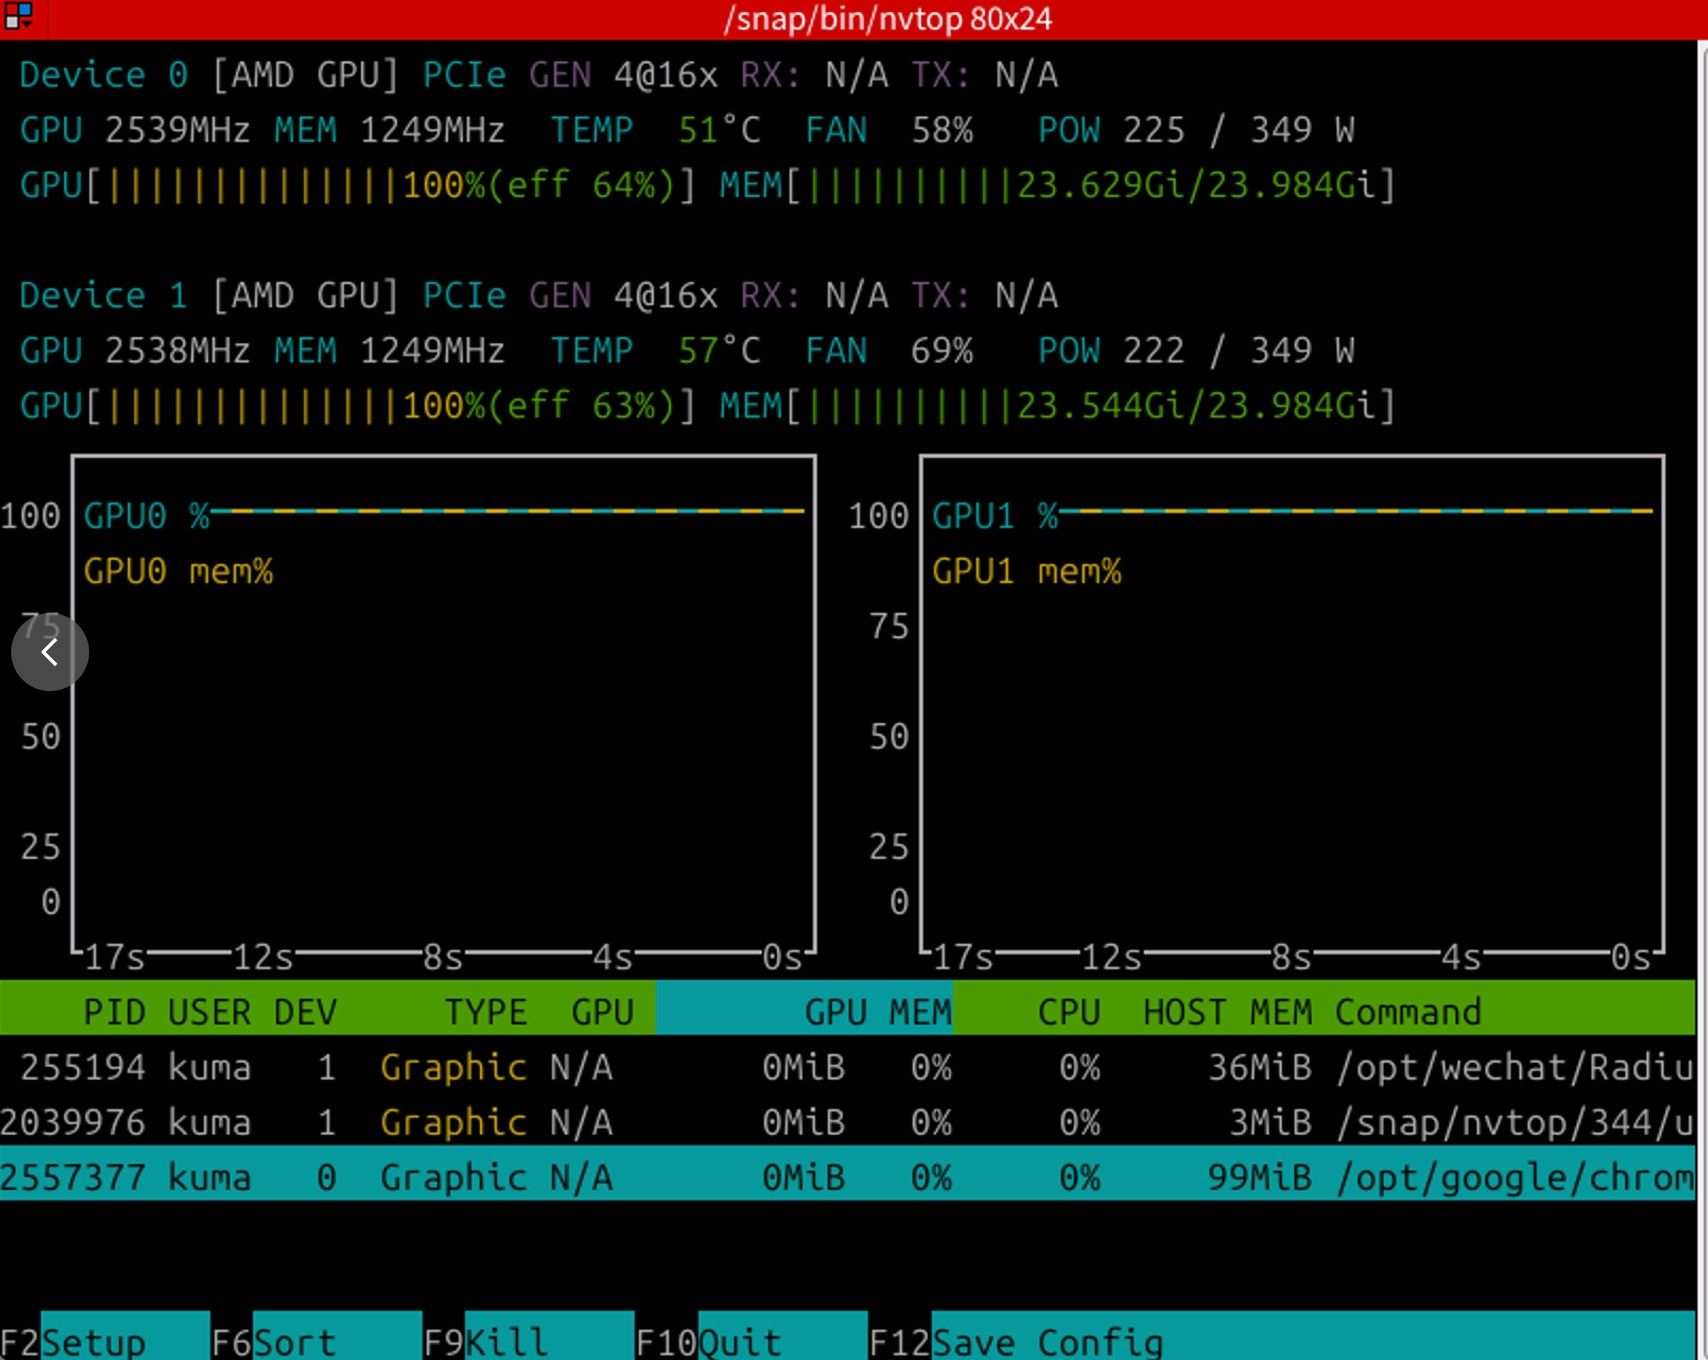
如图:
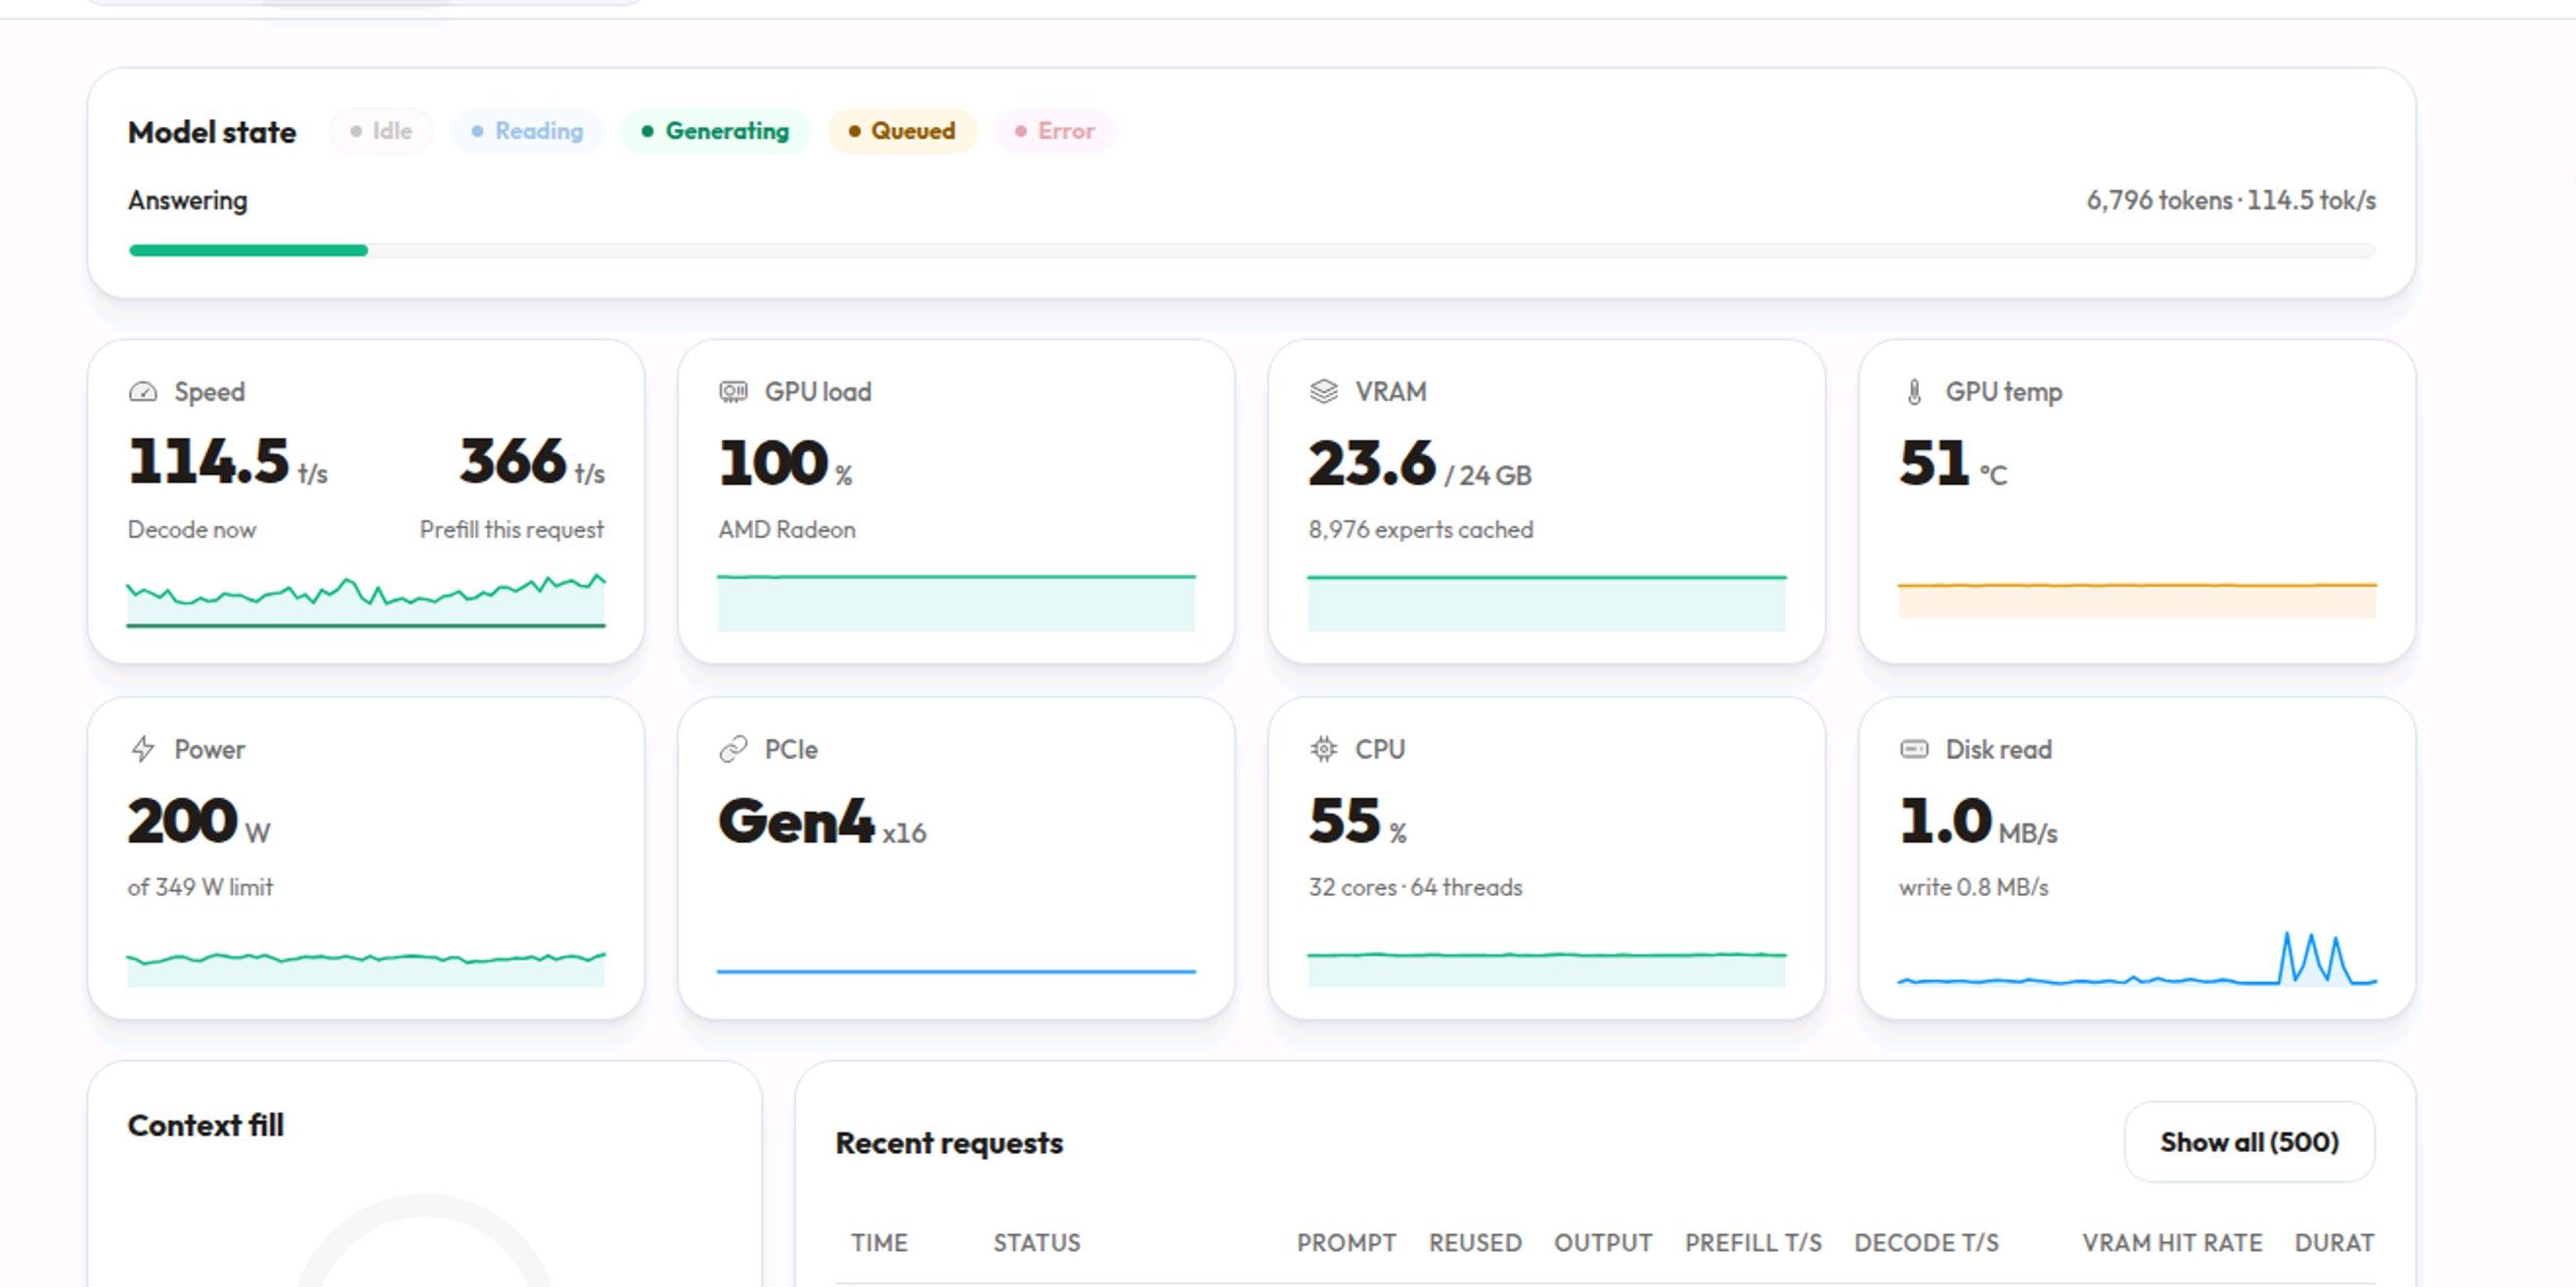
刚升级了最新的 rom 10.1 ,strata 版本 v0.1.44 , 一起升级的,这是什么奇妙的化学反应!!!
如图:
刚升级了最新的 rom 10.1 ,strata 版本 v0.1.44 , 一起升级的,这是什么奇妙的化学反应!!!
先上图:
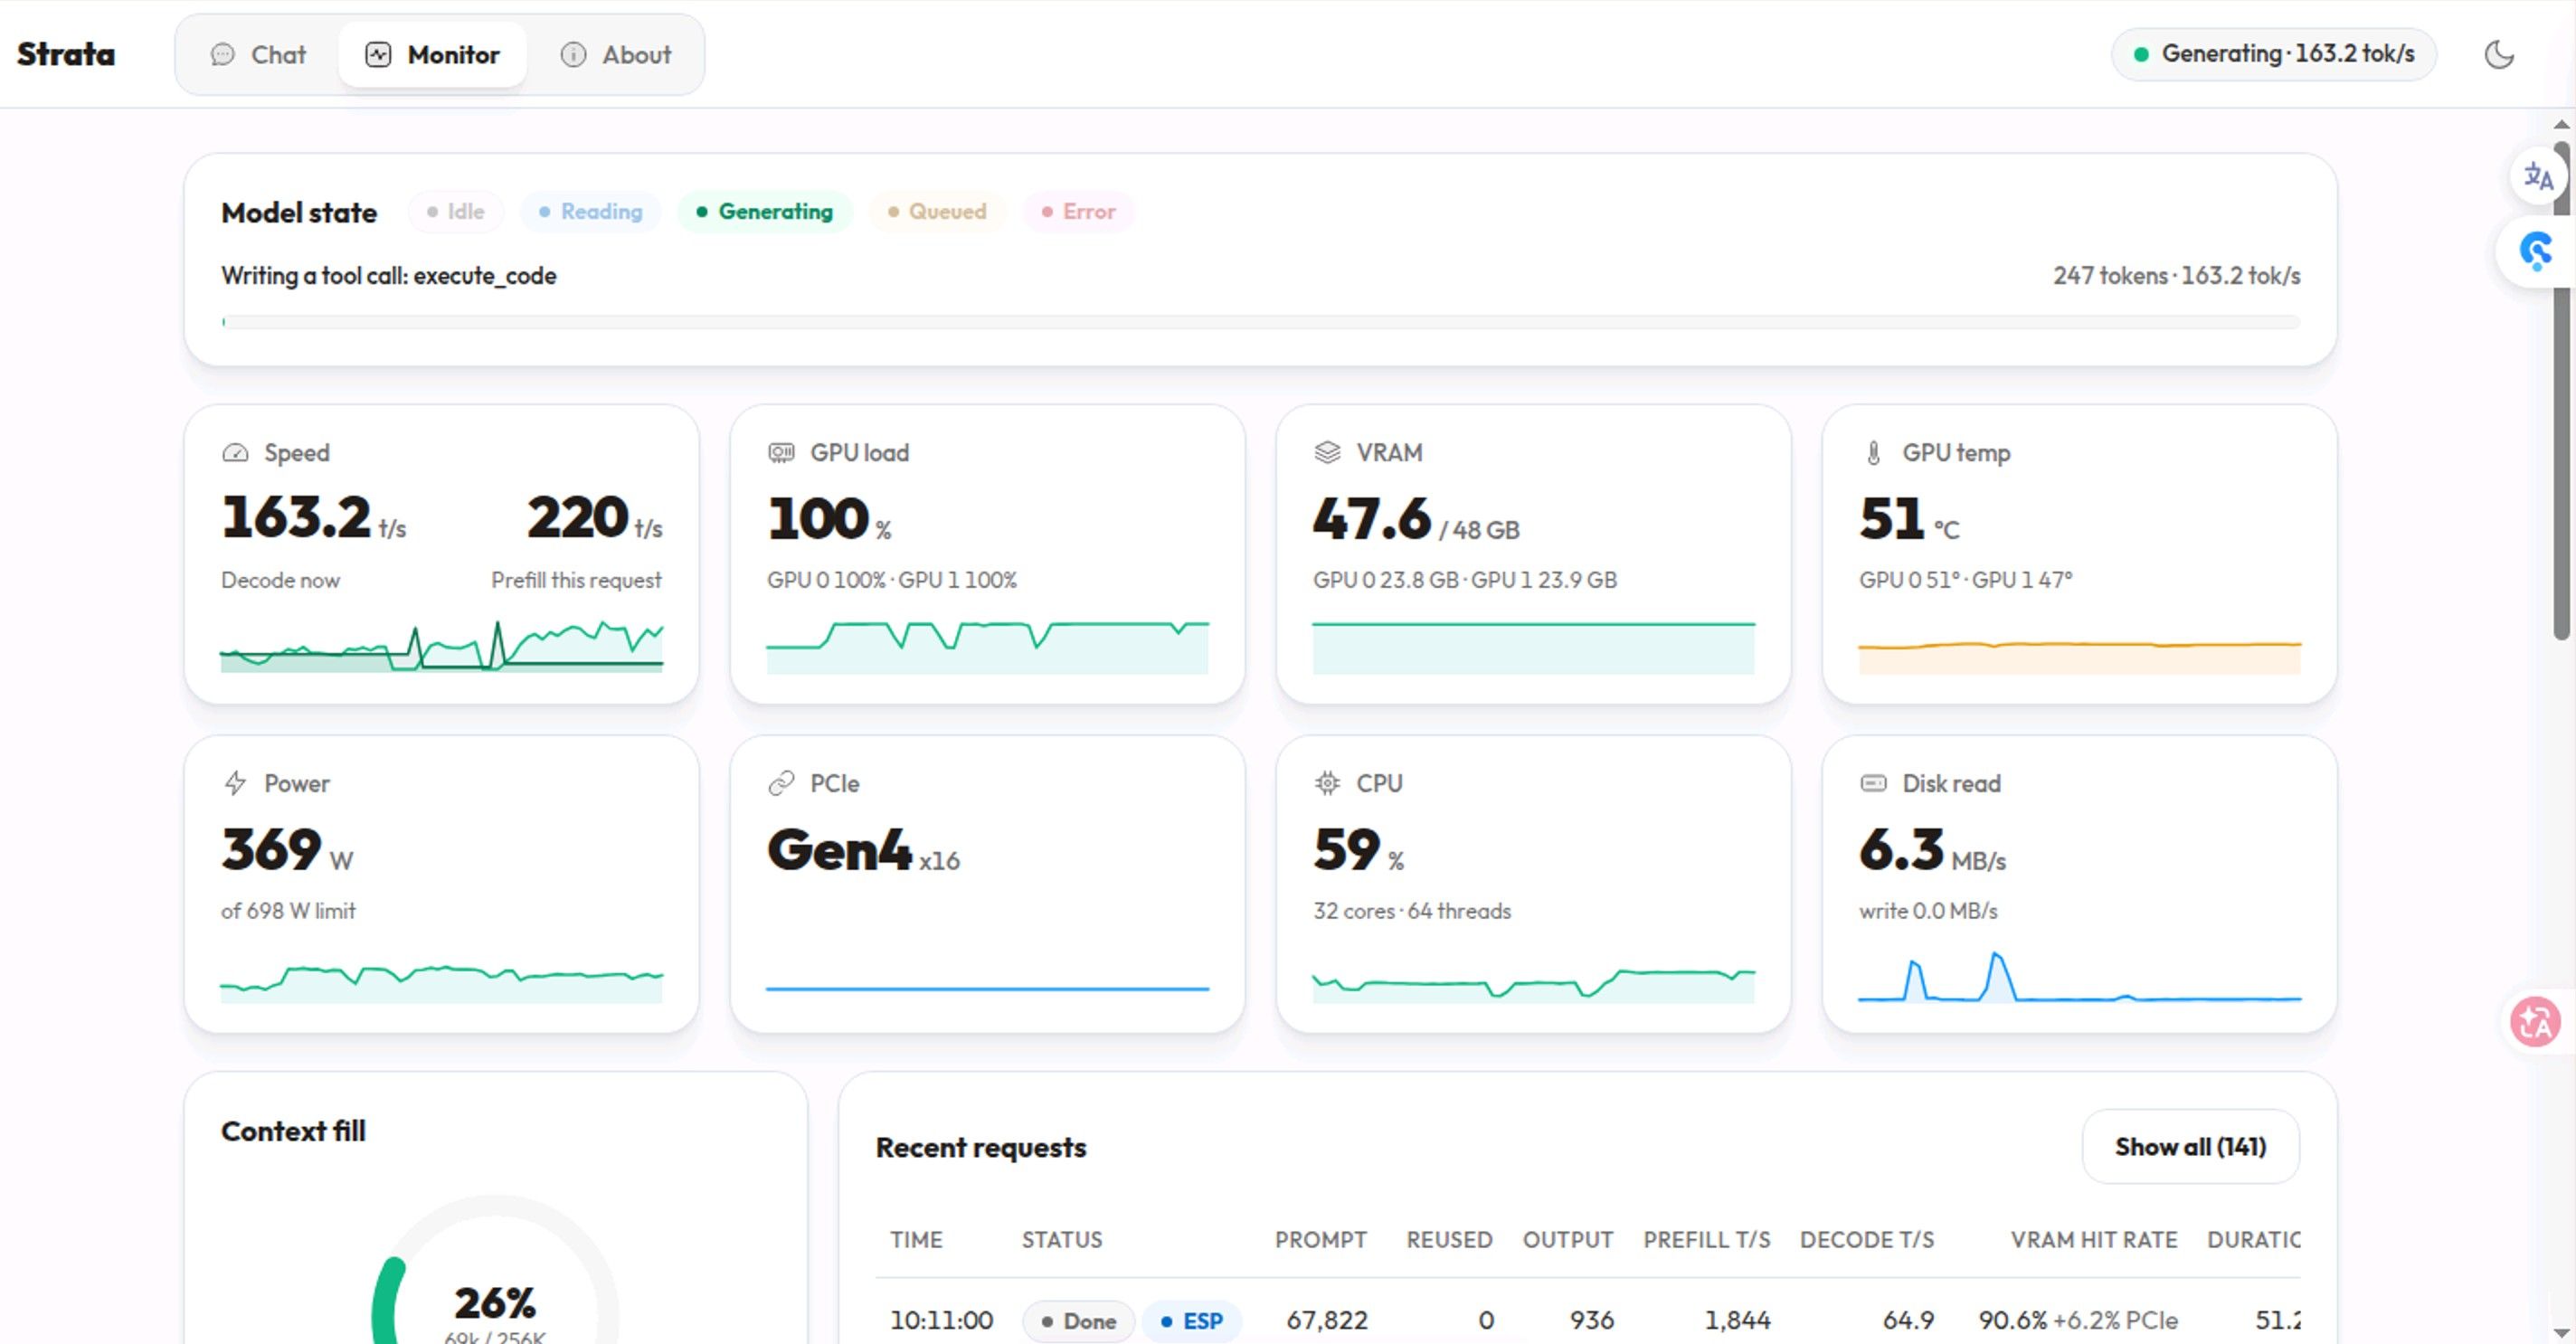
Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-proj
模型相关文件:
/work/packs/iq3_s

/models/IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00001-of-00002.gguf
/models/IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00002-of-00002.gguf

/work/mtp/rt
这次没有采用传统意义上的 TP2 或 layer split,而是使用 Strata 自带的 replicas 机制:
replica 0 → GPU0
replica 1 → GPU1
配置结构:
{
  "replicas": [
    {
      "gpus": [0]
    },
    {
      "gpus": [1]
    }
  ]
}
这个方案的特点:
--pack /work/packs/iq3_s

--native /models/IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00001-of-00002.gguf
--ple-gguf /models/IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00002-of-00002.gguf

--expert-profile /opt/strata/data/expert-profile.bin
--expert-cache auto

--max-context 262144
--kv int8
--kv-resident 32768

--shared-expert-arena /dev/shm/strata-shared-arena.bin
--conversation-cache-mib 8192
--prefill auto:32768

--spec 4
--spec-min-p 0.5
--mtp /work/mtp/rt
--mtp-window 32768
--ple-io direct
--vision
--vram-reserve-mib 700
--control-vector-scaled /models/Huihui-Qwen3.8-Flash-Next-refusal-direction-r.gguf:1.0
--control-vector-layer-range 4 44
--cvec-mode project
--cvec-dir per-layer
STRATA_HIPBLASLT_TUNING=/opt/strata/tools/hip/gfx1100-hipblaslt-100202.txt
STRATA_HIPBLASLT_VERBOSE=1
STRATA_HIP_WMMA=1
STRATA_STAGE_PIN=1
STRATA_WATCHDOG_S=180
配置文件:
/home/kuma/projects/strata-docker/deploy-gsq-iq3s/config/config-iq3s-11436-replicas-opt.json
两个副本通过下面的文件共享主机侧专家 arena:
/dev/shm/strata-shared-arena.bin
当前大约占用:
47.96GiB
该文件位于 /dev/shm,属于 RAM-backed tmpfs,不是 SSD。
共享 arena 可以避免两个副本把专家权重完整复制两份到主机内存。
但是,共享 arena 不会共享以下内容:
因此,replicas 可以减少部分 RAM 重复占用,但不会让两个副本只占一份完整运行内存。
当前使用:
--ple-io direct
含义是:
但是,PLE 的访问具有随机读取特征。长上下文 Prefill 时,如果 SSD 随机读取跟不上,会出现:
threads waiting on the disk
以及:
no progress for 180 s during a request
此时 GPU 可能处于低利用率甚至 0%,但请求不一定是真正死锁,而可能是卡在 PLE 的 SSD 随机读取阶段。
因此:
--ple-io direct
优先解决的是内存容量问题,不保证解决长上下文首 token 延迟问题。
Strata metrics 中常见字段:
queued
running
outside_slots
replicas[].alive
replicas[].running
replicas[].routed
replicas[].batch
含义:
queued:Strata 路由层队列;running:当前承载的请求状态;replicas[].running:某个副本当前承载的请求状态;alive:副本 engine 是否在线;routed:累计路由请求数量;batch=0:当前没有使用 batch。注意:
running 不等于 GPU 此刻正在计算
当请求处于:
reading the prompt
或者正在等待 PLE/SSD 时,GPU 利用率可能暂时为 0%。
一个请求一旦被分配到某个副本,不会因为另一张 GPU 空闲就自动迁移到另一个副本。replicas 是请求级路由,不是跨 GPU 的任务迁移机制。
以下测试使用:
temperature=0
medium thinking
这些结果只代表对应测试口径,不代表日常采样参数下的速度保证。
单请求:
83.6~85.5 tok/s
双请求共同窗口聚合:
159.5~170.1 tok/s
双请求聚合:
153.7 tok/s
实际每路输入约:
245755 tokens
双请求聚合:
159.6 tok/s
资源采样:
最低 MemAvailable:约 32.8GiB
Swap-out:0
Full memory PSI avg10:最高 0%
这些结果只能说明对应测试条件下双副本可以工作,不能直接外推:
另外测试过两副本、每个副本 batch=2 的配置。
四路请求聚合结果:
开启 batch-MTP:151.4 tok/s
关闭 batch-MTP:104.2 tok/s
在当时的测试条件下,batch-MTP 有明显收益。
但这个结果不能直接与双路 replicas 比较,因为两者的执行条件不同:
当前采用:
11436:双单卡 replicas + solo MTP
不默认启用 batch-MTP
这个是跑的是之前的昨天的分支,尝试修复FP8 KV 的问题,但是效果不太好,就不提交了,发数据发一下,看看大家是否有参考。(补充说明: 这个就是D4 , EPYC 7452 Z2, H12D-8D , 内存 4通道 ,128G )
针对双 AMD Radeon RX 7900 XTX (各 24GB VRAM,总 48GB,TP=2) 在运行 Qwen3.8-27B-W4A16-AutoRound 及块扩散投机解码 Qwen3.8-27B-DFlash2-W4A16 时的推理吞吐、算子瓶颈及长上下文退化现象进行了系统排查、源码修改与基准实测。
测试镜像已固化为 sglang-gfx1100:pr34058,启动脚本位于 ~/sglang-gfx1100/launch-dflash2.sh。
rdna_custom_all_reduce.cu 时硬编码了 CDNA 专用的 __builtin_amdgcn_global_store_b128,导致 gfx1100 报错并降级至慢速 NCCL PCIe。sgl_rdna_ar_v18_83f10ec8.so。rdna_unified_verify.py:将 3D Verify 下硬编码的 TILE_SIZE = 16 改为 32,匹配 7900 XTX Wave32 并发粒度,内层循环次数直接减半。triton_backend.py 与 rdna_verify_adapter.py:将原本针对 16K 上下文硬编码的 segments = 32 / 16 扩充为 segments = 64,将双卡 192 个计算单元 (WGP) 在 Verify 阶段全部吃满。--context-length 225280 正式修正为 196608 (192K),与实际物理显存池(197,144 Tokens)精准对齐,消除单流超界导致的静默 OOM 风险。测试环境:Qwen3.8-27B-W4A16 + DFlash2-W4A16,TP=2,BF16 KV Cache,Radix Cache 前缀命中。
| 上下文深度 | Cold Prefill 耗时 | Prefill 吞吐速率 | 显存缓存驻留率 | 稳态 Decode 耗时 (128 tok) | 稳态有效 Decode 速度 |
|---|---|---|---|---|---|
| 短文本 (~1K) | 0.05s | - | 0.1% | 1.220s | 104.94 tok/s  |
| 8K 深度 | 4.82s | 1,701 tok/s | 4.1% | 1.502s | 85.24 tok/s |
| 16K 深度 | 9.71s | 1,688 tok/s | 8.3% | 1.554s | 82.37 tok/s |
| 30K 深度 | 13.68s | 1,727 tok/s | 15.2% | 1.965s | 65.14 tok/s |
| 60K 深度 | 17.85s | 2,648 tok/s | 30.4% | 2.274s | 56.30 tok/s |
| 120K 深度 | 48.66s | 1,942 tok/s | 60.9% | 1.719s | 74.45 tok/s |
| 160K 极限 | 174.77s | 913 tok/s | 81.0% | 3.510s | 36.47 tok/s |
| 180K 极限 | 37.21s (增量) | 4,825 tok/s | 91.1% | 3.615s | 35.41 tok/s |
@terry 1. vLLM 0.4.2 就引入了 Automatic Prefix Caching(APC),跨请求/跨会话按块哈希共享 KV;V1 重写后这个开销压到 0% 命中率时 <1% 吞吐,所以默认常开。我现在第二次缓存命中就是3秒左右就开始了。 2. 针对7900xtx , sglang 我也在跑,sglang 只能用bf16 缓存,缓存词 开HICache 是 192k ,我用30g 内存,也才400-500k ,并发只能拉到 4 * 120k 左右, 但是现在这个 KV 是有1000k, 可以跑256*4 并发, 如果加上贡献前缀, 以及agent 的75% 压缩限制, 256k * 8 ,是可以直接跑的 ,如果不跑 256k , 跑120k 可以跑 16 并发! @ben-lee 这个可以跑 120k *16 并发呀。
把我这套双 7900 XTX 的 vLLM 部署交个作业。全部数字都是 2026-10-07 这台机器实测的,不是别人的理论值,不同硬件/版本跑出来会不一样,当参考不当保证。
| 部件 | 配置 |
|---|---|
| 主板 | 华南金牌 H12D8D(SP3 双路平台) |
| GPU | 2 × PULSE RX 7900 XTX(Navi 31 / gfx1100),各 24GB |
| CPU | AMD EPYC 7452,32 核 / 64 线程 |
| 内存 | 128GB(30GB 划给会话缓存,见下) |
| 系统 | Ubuntu 24.04.4,ROCm 7.2.4 |
| 模型 | Qwen3.8-27B W4A16(AutoRound 量化,19GB),256K 原生上下文 |
1. octave_k3v4 KV cache(本文主角,50 倍的主角)
KV cache 是模型对读过内容的记忆,fp16 存法每 token 每个 KV head 要 1024 字节,256K 直接爆显存。octave 是 JartX 在 vLLM 里做的压缩 KV 格式:K 用 3 bit、V 用 4 bit,压到 248 字节,只有 fp16 的 1/4,同样的显存装 4 倍上下文。而且它不是只省地方——JartX 的 WMMA 内核直接从压缩格式读数据做矩阵乘,省显存和提速是同一件事。作者在 4× 7900 XTX 上压 attention 内核的实测(原文在他仓库 OCTAVE_SPEED.md,注意:那是用 VLLM_ALLOW_LONG_MAX_MODEL_LEN=1 把 max-model-len 放宽到 380K 的内核级压力测试,不是"这模型能跑 380K 上下文"——27B 原生上限就是 256K,我生产也是 256K
| KV 格式 | 每 token 每 KV head | 380K 压力点 decode |
|---|---|---|
| fp16 | 1024 B | 2.7 tok/s(基本跑不动) |
| octave_k3v4 | 248 B | 151.4 tok/s,约 50 倍 |
| octave_k3v3 | 216 B | 129.6 tok/s |
换句话说,octave 内核在超出原生上限的超长序列下,比 fp16 快约 50×、比 TurboQuant 快 4.6-5.3×,且 MTP 验证路径比 TRITON_ATTN 快 78×——这才是 256K 真并发还守得住的底层原因。(同文件另测 380K 冷 prefill 比 fp16 快 20%、比 TurboQuant 快 2.1 倍。)
质量代价见下节实测,一句话:容量翻倍,没断崖。
2. MTP 投机解码(--spec-tokens 3)
模型自己"打草稿":每出一批字先猜 3 个再验证,猜对等于白嫖。27B 带原生 MTP 头,接受率够高,短上下文 96+ tok/s 基本是它撑起来的。关了这个,速度直接腰斩。
3. 30GB 内存 = 会话缓存,不是用来"跑"的
这块内存的定位说清楚:主角色是缓存,不是算力。多会话并发时,每个会话的 KV 状态常驻内存,切回来直接续上——热启动。前面 220K 那行"第二次问只要 5.3 秒"就是这么来的:前缀不用重算,直接命中。顺带的次要作用才是兜底:220K×6 这种超出 GPU KV 池的长会话,能被换到内存里不死掉。所以别把它理解成"借内存跑推理"——它是让 N 个长会话都能随时回来,不是让一台 48GB 显存的机器假装 78GB。
4. TP2 与 MoE 两个前瞻
词表先说透:27B 词表 248,320 token,TP2 下 embedding 和 lm_head 是每张卡各存一份全量(bf16,合计每卡约 4.7GB),不分片——别指望 TP2 切半词表,省的是 attention 和 MLP 的权重与激活。
更大的彩蛋:这个 fork 带 W4A16 冷专家 CPU offload,作者已在 2×24GB 上把 Qwen3.5-122B-A10B(256 专家 / top-8 / 48 层)端到端跑通——全量专家常驻内存,每层只换热专家进显存,一个环境变量 VLLM_MOE_EXPERT_CACHE_SIZE 控制。双 XTX 跑大 MoE 有明确路线,不用等 4 卡。
10-06 同一台机器、同一个模型,KV 格式切换前后各打一轮隐藏指令探针:
| KV 格式 | 每 token 每 KV head | 本机 GPU 层容量 | 质量 |
|---|---|---|---|
| int8 per-token-head | 520 B | ~55 万 token | 探针 6/6 全对(32K/120K × 检索/推理/代码) |
| octave_k3v4(现用) | 248 B | ~109 万 token | 32K 全对;120K 检索/推理对,代码格被 512 输出截断,答案本身没问题 |
容量接近翻倍,质量都在可用线内。第三方参照:上游 4×7900 XTX 的 GSM8K,k3v4 = 91.4,fp16 = 91.8,基本持平;反面教材是 TurboQuant——开 MTP 会输出垃圾(GSM8K 掉到 1% 附近),octave 把这块修好了,MTP=3 跑 256K 才有前提。
口径:每格 = 该上下文 + 该并发下单条请求的 decode tok/s 中位数(你体感的速度);括号 = 各流速率加总(高并发格各流首尾不齐,当量级看)。
| 上下文 \ 并发 | 1 | 2 | 4 | 6 | 8 |
|---|---|---|---|---|---|
| 2K | 96.4 (96) | 104.0 (208) | 90.0 (≈354) | 59.3 (≈345) | 61.6 (≈476) |
| 30K | 96.2 (96) | 76.7 (153) | 74.7 (≈293) | 46.6 (≈295) | 42.8 (≈375) |
| 60K | 66.4 (66) | 69.2 (138) | 55.7 (≈234) | 38.8 (≈236) | 38.5 (≈312) |
| 90K | 90.6 (91) | 77.2 (154) | 55.8 (≈225) | 37.7 (≈237) | 37.0 (≈303) |
| 120K | 76.5 (77) | 57.5 (115) | 53.2 (≈211) | 36.8 (≈237) | 34.1 (≈276) |
| 150K | 82.5 (83) | 68.4 (137) | 50.9 (≈203) | 41.9 (≈237) | — |
| 180K | 69.7 (70) | 64.7 (129) | 53.4 (≈213) | 34.0 (≈213) | — |
| 220K | 69.8 (70) | 48.6 (97) | 39.6 (≈157) | 27.6 (≈162) | — |
"-" = 没测。
怎么读:
| 上下文 | 第一次(冷) | 同一份文档第二次(缓存命中) |
|---|---|---|
| 2K | 1.1s | — |
| 30K | 15.9s | 0.84s |
| 60K | 20.2s | 1.47s |
| 120K | 26.7s | 2.54s |
| 220K | 48.6s | 5.31s |
多路共享同一份长前文时,前文只算一次,4 路 30K 并发 TTFT 1.5s 左右。这就是上一条会话缓存的价值:agent 场景基本无感。一次性的全新长文,220K 要等 50 秒,物理成本,没救,只能预热。
作者是 4 卡 + 高频桌面 CPU,我这台 EPYC 7452 单核睿频只有 3.35GHz。MTP 的验证调度走 CPU,单核慢一点,单流速度会比高频平台略低。EPYC 的好处在并发宽度:64 线程拉满多路时 CPU 不拖后腿。
仓库: github.com/JartX/vllm
基于 vLLM 上游的 AMD 优化分支,作者 4× 7900 XTX 自维护,持续在更新——octave KV、MTP、RDNA3 专用 attention 内核、MoE 专家 offload 都从这里长出来,上游还在 RFC/PR 阶段。带每日 watchdog,分支一动就提醒,关注仓库最新状态就行,别抱死某个旧 commit。
我跑的版本: 源码 commit 317415c5a1fd(2026-10-06 打包),生产基线分支 perf/rdna3_full_stack。复刻前先拉最新 commit 对比。
构建要点(ROCm,我用 docker 隔离编译):
# 核心环境变量,缺一不可
export PYTORCH_ROCM_ARCH=gfx1100
export VLLM_TARGET_DEVICE=rocm
# ROCm 版 torch + triton-rocm,别装成 NVIDIA 的
uv pip install torch-2.13.0+rocm7.2 triton_rocm-3.7.1
# 源码 tar 没有 git 元数据,版本手动钉
export SETUPTOOLS_SCM_PRETEND_VERSION=0.0.dev0+g317415c5a1fd
uv pip install -e . --no-build-isolation --no-deps
8 核 / 24GB 内存就够,不用 GPU 也能编(构建和部署分开)。编译完 import vllm 和 torch.ops._C.octave_cache_store 都在,就算成了。
启动命令(生产原样,一字未改):
vllm serve /path/to/Qwen3.8-27B-W4A16-AutoRound \
  --served-model-name qwen3.8-27b \
  --tensor-parallel-size 2 \
  --kv-cache-dtype octave_k3v4 \
  --attention-backend ROCM_OCTAVE \
  --max-model-len 262144 \
  --max-num-seqs 8 \
  --max-num-batched-tokens 8192 \
  --enable-prefix-caching --prefix-cache-retention-interval 3296 --prefix-match-unit 16 \
  --enable-chunked-prefill \
  --gpu-memory-utilization 0.95 \
  --spec-method qwen3_5_mtp --spec-tokens 3 \
  --enable-mamba-shared-prefix-checkpoint \
  --max-cudagraph-capture-size 16 \
  --kv-transfer-config '{"kv_connector":"SimpleCPUOffloadConnector","kv_role":"kv_both","kv_connector_extra_config":{"backend":"cpu","cpu_capacity_bytes":32212254720}}'
两个坑:
cpu_capacity_bytes 调小,或删掉这行(代价是 220K 这种超长会话兜不住);--spec-method)跟着换,不是所有模型都有原生 MTP 头,没有就删掉这两行,速度掉一截。AMD 卡还在升值:以前 7900 XTX 算玩具卡,现在 2 张 48G 显存 + 30G 会话缓存,27B 的 256K 上下文日常用——30K 上下文 8 路并发聚合 400tok/s,220K 长文还能 70 tok/s 不趴,多会话热启动秒回。单流速度没什么好吹的,大家都在 90~110 区间;真正的差距在长上下文和并发,这块以前是 AMD 的短板。想复刻的门槛也低:仓库现成,编译脚本半小时的事。
有问题评论区提,数字都能复现,欢迎拿自己的机器对比着测。
@kos-or 对的,昨天升级的最新的v0.1.43,但是这里的并发有点类似DP2 的方式,但是用的是同一个 端口, 可以共享一部分内存,我得单流跑内存暂用是60G 左右, 2个实例是90G 左右,共享内存在16G 左右.
@kos-or 我现在内存暂用90G 左右
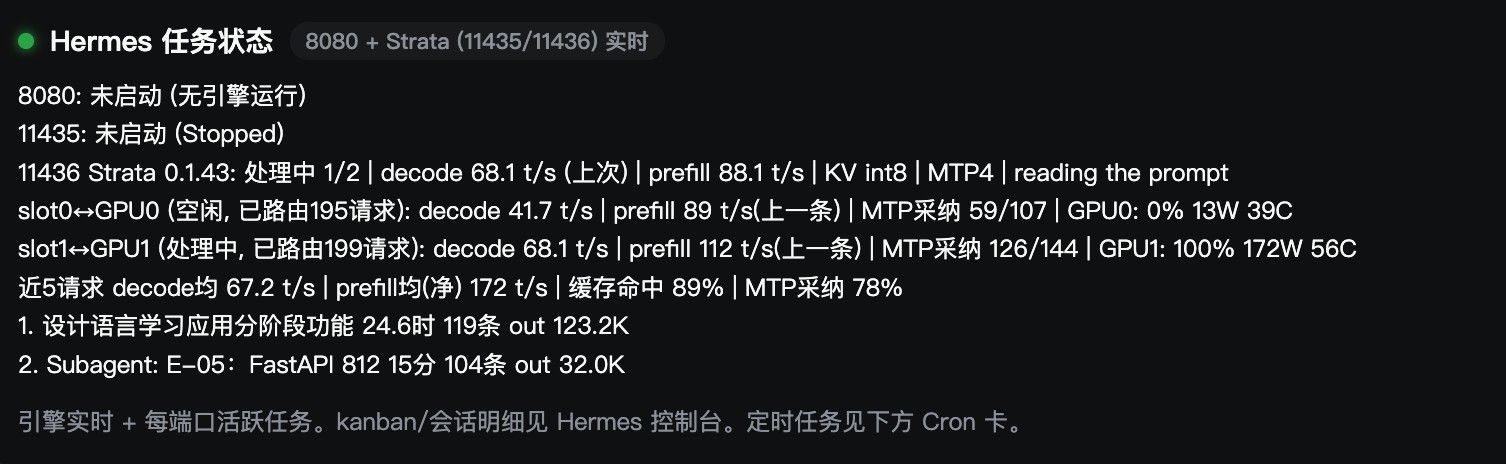
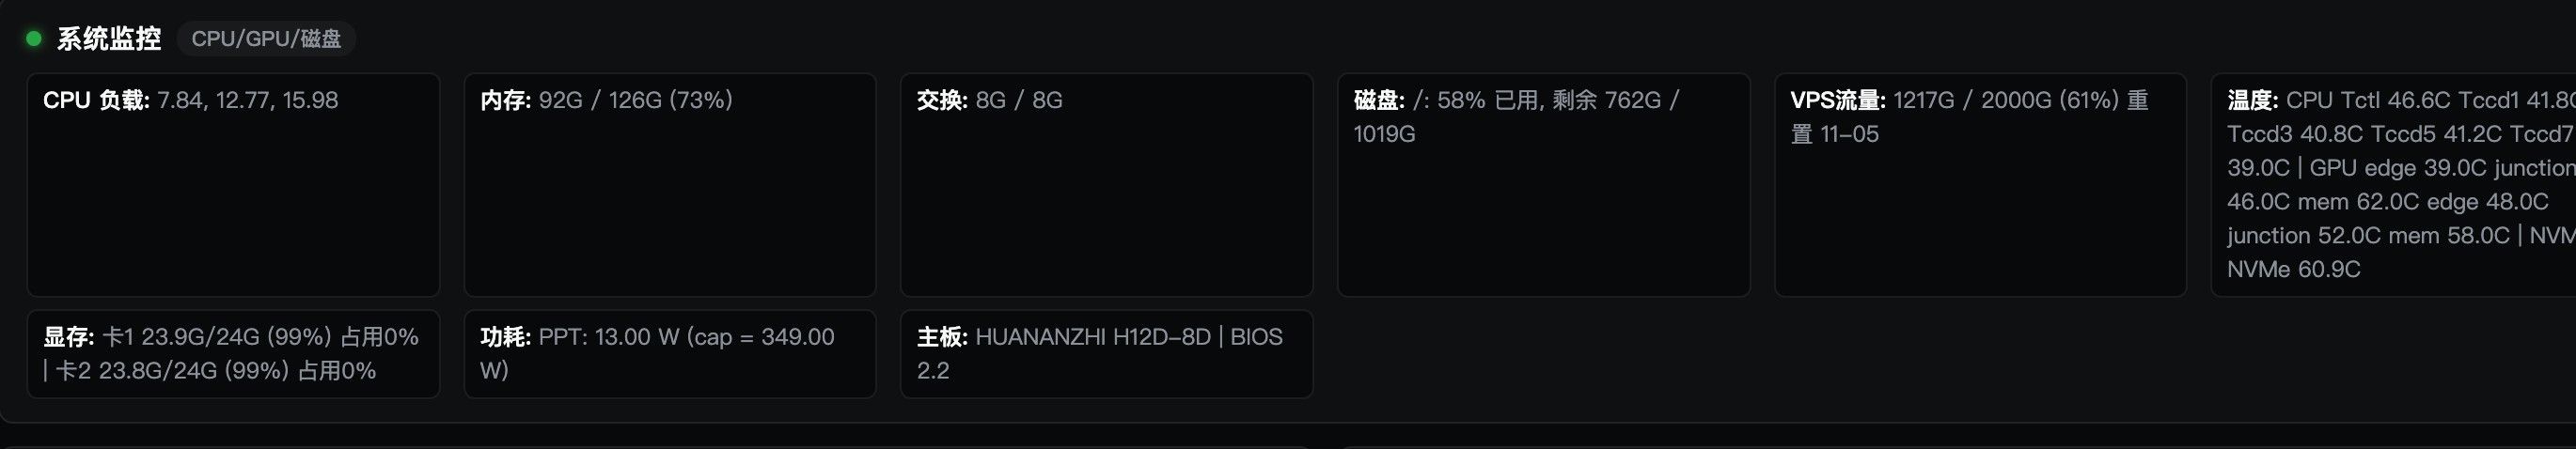
@张光璞 这个就是flyer666 改的 tensor 的上游分支,是参考的这个仓库改的,所一 TTFT 是很快的,prefill 和之前的一样,快的离谱,针对 7900txt 专门优化的 tensor ,数据上是比 3090 更快的 prefill,不是很慢,是快的离谱,但是还是会有 之前 一个大的prefill 会卡住的问题,这个问题,已经修复了很多,不会完全卡死,但是会慢一些。
@Ben-Lee 这个就是flyer666 改的 tensor 的上游分支,是参考的这个仓库改的,所一 TTFT 是很快的,prefill 和之前的一样,快的离谱,针对 7900txt 专门优化的 tensor ,数据上是比 3090 更快的 prefill。
@kos-or 对呀,很神奇,而且端口统一,不用管任务调度的问题,也是第一次见到这种做法。
图上的是真实生产跑的速度 能到100, 测试跑的矩阵 的速度是这样的:
已测的是 2K、16K、64K、128K、220K 输入,每档分别测单路和双路,输出上限 1024 token。下面是已完成格的实测速度;双路数字是“每路”,不是相加后的吞吐:
2K:单路 Decode 109.4 tok/s;双路各 109.7、114.1 tok/s;整批约 16 秒。
16K:单路 104.3;双路各 104.6、103.1 tok/s;整批约 26 秒。
64K:单路 97.9;双路各 96.2、96.8 tok/s;整批约 72 秒。
128K:单路 94.1;双路各 94.7、94.4 tok/s;整批约 138 秒。
220K:单路 90.3 tok/s,Prefill 约 226 秒,整次约 238 秒;
测试容器是 ROCm 10.1.0 + Strata 0.1.44.1、双单卡 replicas
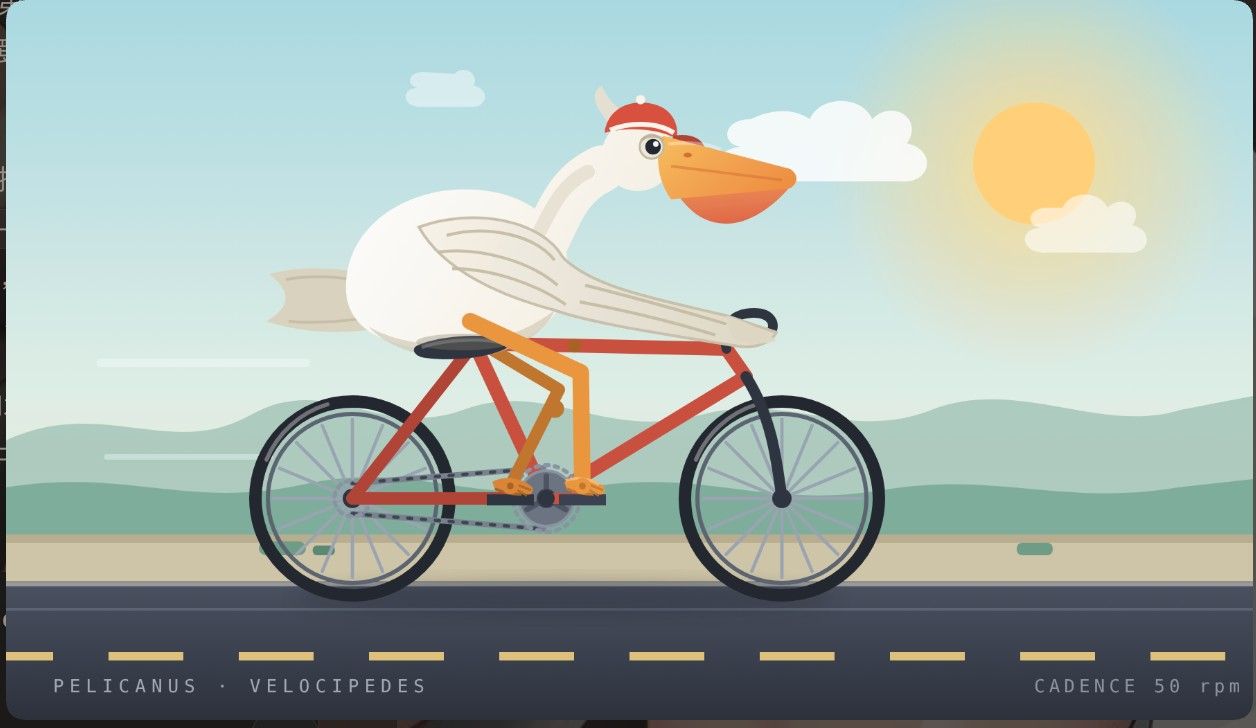
这个是Qwen3.8-Flash-Next-Uncensored-AD,类似IQ4_XS ,
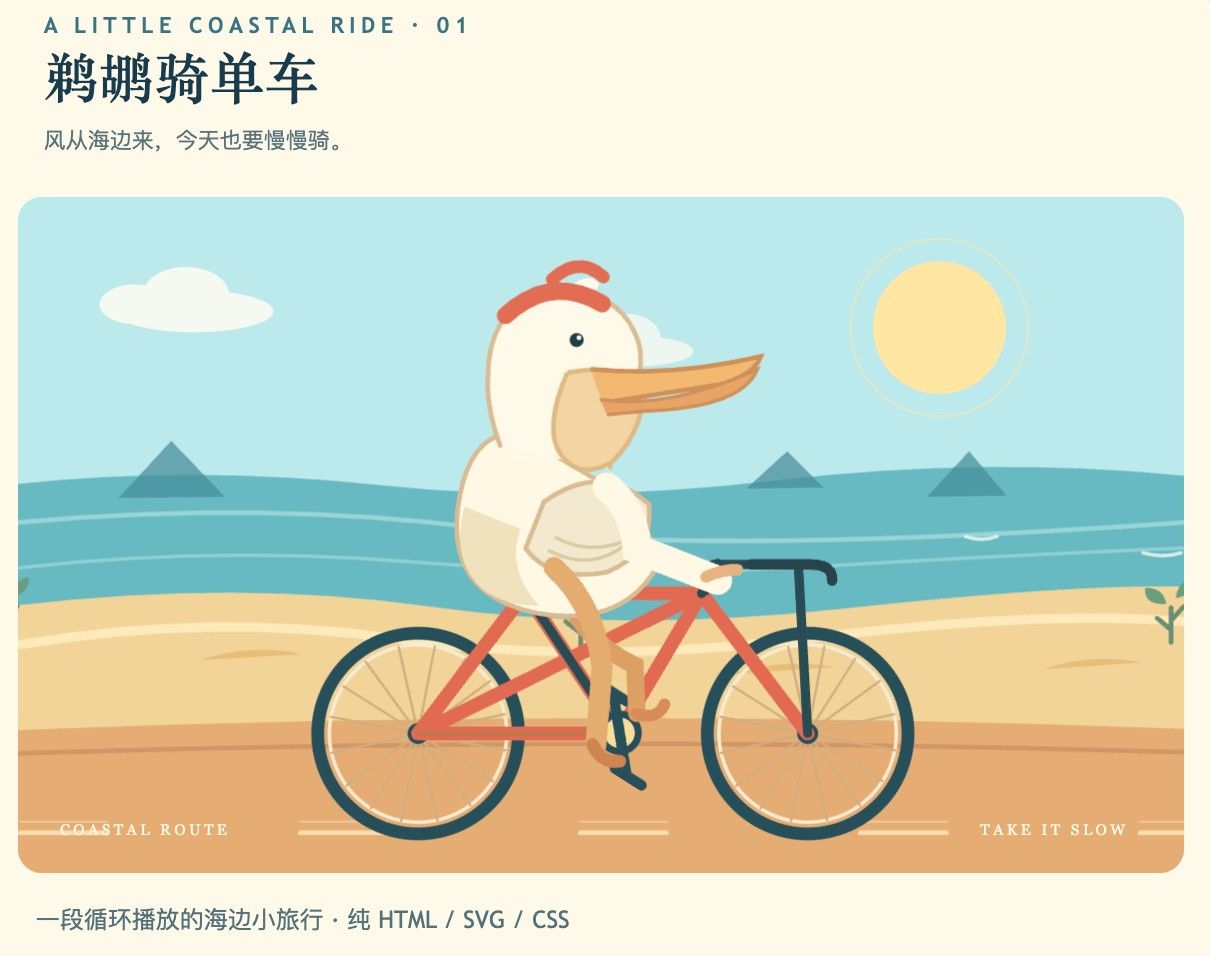
这个是 gpt 6.1 sol
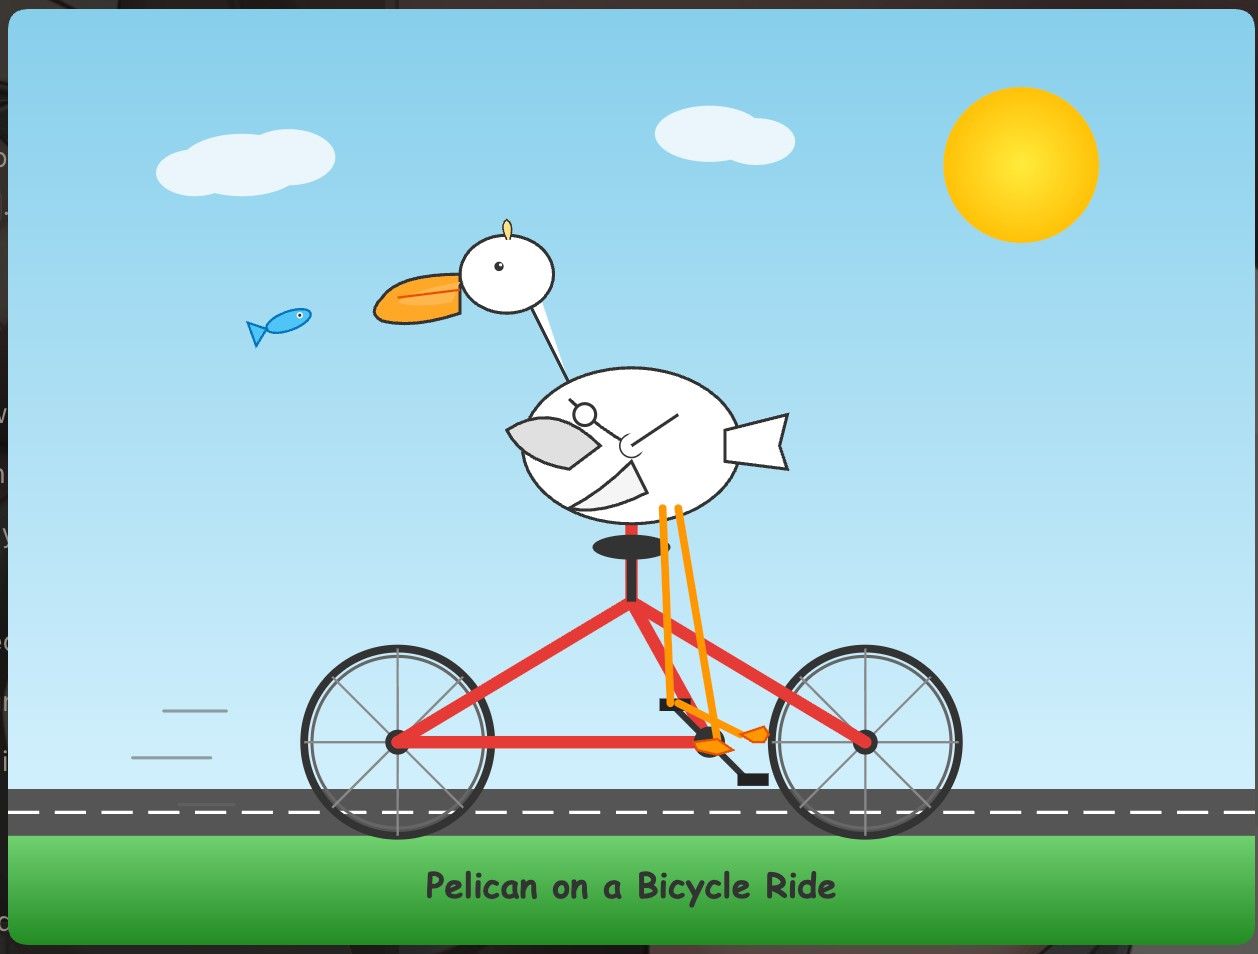
这个是minimax M3
这个是 gemini 3.6 flash high
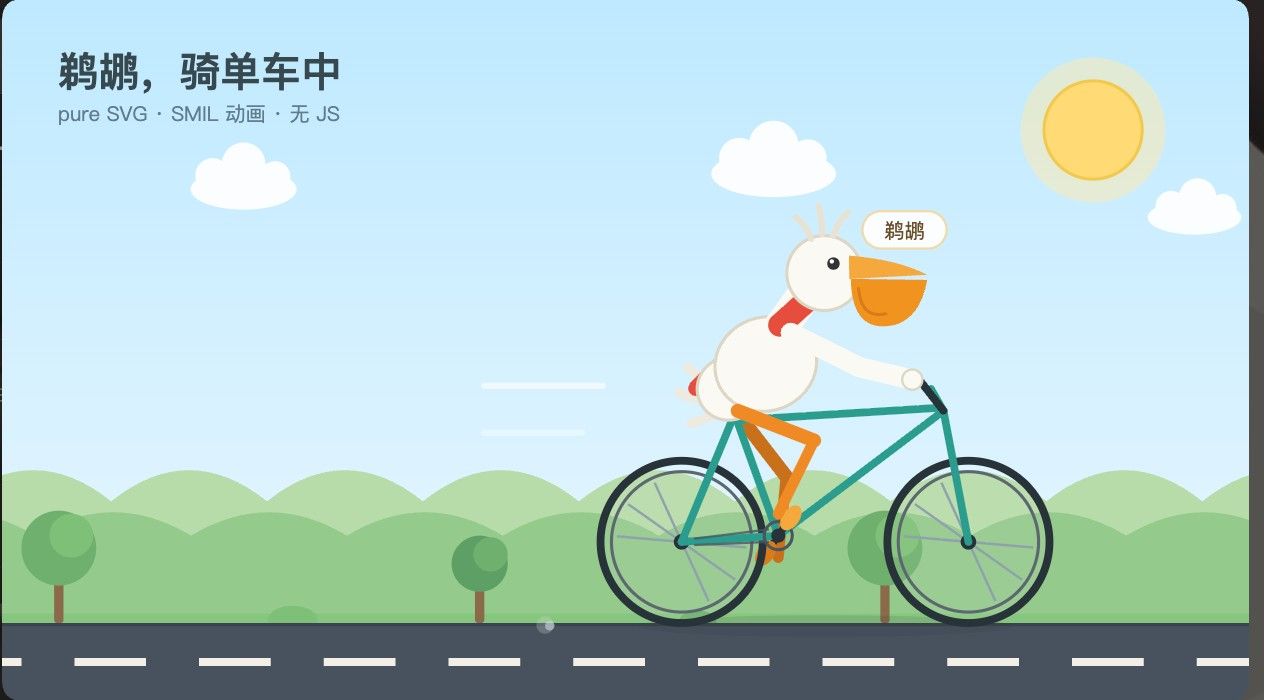
这个是 Qwen3.8-27B-W4A16-AutoRound
@Henry-Chiu-0 跑都能跑,64G 只是刚好够门槛,跑Strata IQ3_XXS , Strata IQ3_S可能也够,但是你说的其他的更多服务就不要想了。想要更好的体验 还是用96G ,而且后续可能还有4.0 flash next ,内存还是越大越好。
rag 检索已经有非常成熟的工具,没必要自己折腾了, 像是国内应用 腾讯的 ima (可以直接下载登录), cherryStudio, 或是dify ,这些直接就可以用, 把文件丢进去,然后自己就切分了,如果需要控制颗粒度,dify 的效果会好些,你可以试试
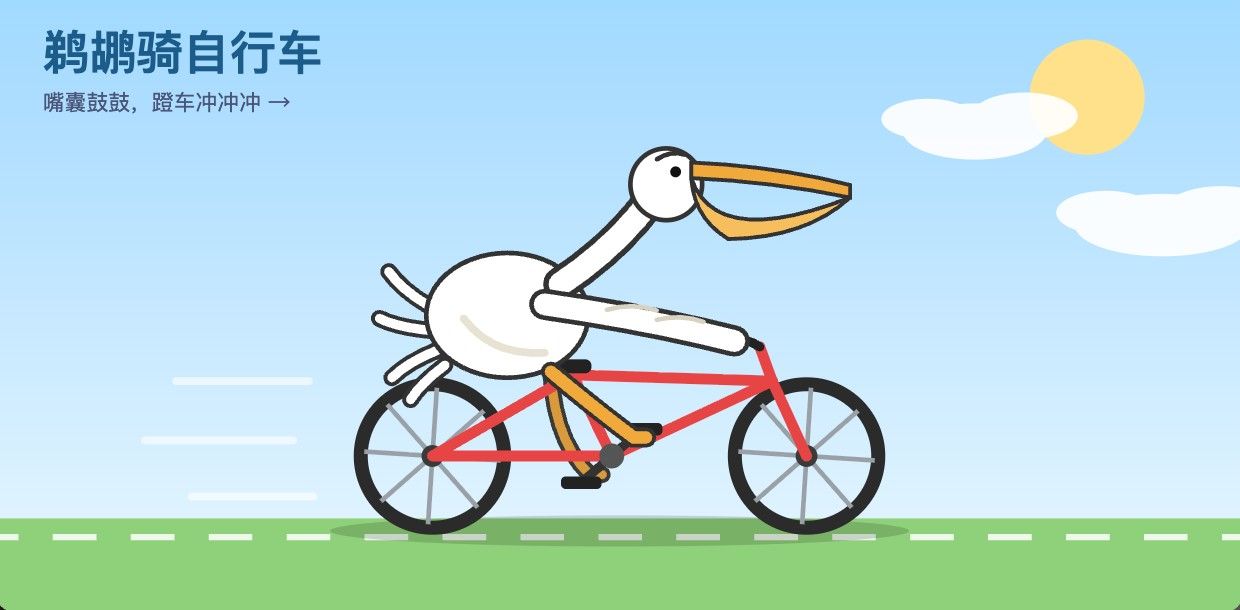
补一个跑鹈鹕的图:
@Ben-Lee 你这个方案是我sglang 本地的高速方案,我分享一下我本地的另一套vllm 的方案,不能用MTP ,Dflash2 加速,但是可以用 int8 KV, 真正的8并发,总吞吐 240
左右:
二、 部署配置与显存 / KV Cache 切片
生产甜点位启动命令
bash
docker run -d
--name vllm-prod
--ipc=host
--network=host
--shm-size=32g
--device=/dev/kfd
--device=/dev/dri
--group-add video
-e HSA_OVERRIDE_GFX_VERSION=11.0.0
-e ROCR_VISIBLE_DEVICES=0,1
-e PYTHONPATH="/opt/rocm-7.2.4/share/amd_smi"
-v /home/kuma/models:/models:ro
jartx-vllm:latest
vllm serve /models/Qwen3.8-27B-W4A16-AutoRound
--host 0.0.0.0
--port 8080
--tensor-parallel-size 2
--kv-cache-dtype int8_per_token_head
--max-model-len 131072
--max-num-seqs 8
--max-num-batched-tokens 8192
--attention-backend TRITON_ATTN
--enable-prefix-caching
--enable-chunked-prefill
--gpu-memory-utilization 0.95
--trust-remote-code
显存分配切片(2×24GB 运行时抓取)
三、 全梯队压测实测数据(纯并发模式,流式解耦)
测试场景 / 上下文深度: 短文本 (1K~4K)
并发路数: 1 路
首字延迟 (TTFT): 0.40 s
单路纯解码速率: 56.16 tok/s
稳态聚合吞吐 (实测): 56.16 tok/s
表现分析: 超过作者 49.2 t/s 基准 +15.5%
────────────────────────────────────────
测试场景 / 上下文深度: 短文本 (1K~4K)
并发路数: 2 路
首字延迟 (TTFT): 0.54 s
单路纯解码速率: 47.22 tok/s
稳态聚合吞吐 (实测): 94.44 tok/s
表现分析: 近似线性扩展
────────────────────────────────────────
测试场景 / 上下文深度: 短文本 (1K~4K)
并发路数: 4 路
首字延迟 (TTFT): 1.00 s
单路纯解码速率: 43.10 tok/s
稳态聚合吞吐 (实测): 172.39 tok/s
表现分析: 高吞吐甜点位
────────────────────────────────────────
测试场景 / 上下文深度: 短文本 (1K~4K)
并发路数: 8 路
首字延迟 (TTFT): 2.11 s
单路纯解码速率: 30.94 tok/s
稳态聚合吞吐 (实测): 247.53 tok/s
表现分析: 触及双卡 512GB/s 显存带宽物理极限
────────────────────────────────────────
测试场景 / 上下文深度: 中长文本 (30K)
并发路数: 1 路
首字延迟 (TTFT): 11.03 s
单路纯解码速率: 51.47 tok/s
稳态聚合吞吐 (实测): 51.47 tok/s
表现分析: 30K 深度下解码几乎不衰减
────────────────────────────────────────
测试场景 / 上下文深度: 中长文本 (60K)
并发路数: 4 路
首字延迟 (TTFT): 15.60 s
单路纯解码速率: 33.64 tok/s
稳态聚合吞吐 (实测): 134.55 tok/s
表现分析: 稳态多路并发
────────────────────────────────────────
测试场景 / 上下文深度: 超长文本 (120K)
并发路数: 1 路
首字延迟 (TTFT): 34.24 s
单路纯解码速率: 40.72 tok/s
稳态聚合吞吐 (实测): 40.72 tok/s
表现分析: 单流超长无 OOM,解码保持 40+ tok/s
────────────────────────────────────────
测试场景 / 上下文深度: 超长文本 (120K)
并发路数: 4 路
首字延迟 (TTFT): 1.54 s*
单路纯解码速率: 25.90 tok/s
稳态聚合吞吐 (实测): 103.60 tok/s
表现分析: 前缀共享缓存命中率 71.8%,吞吐破百
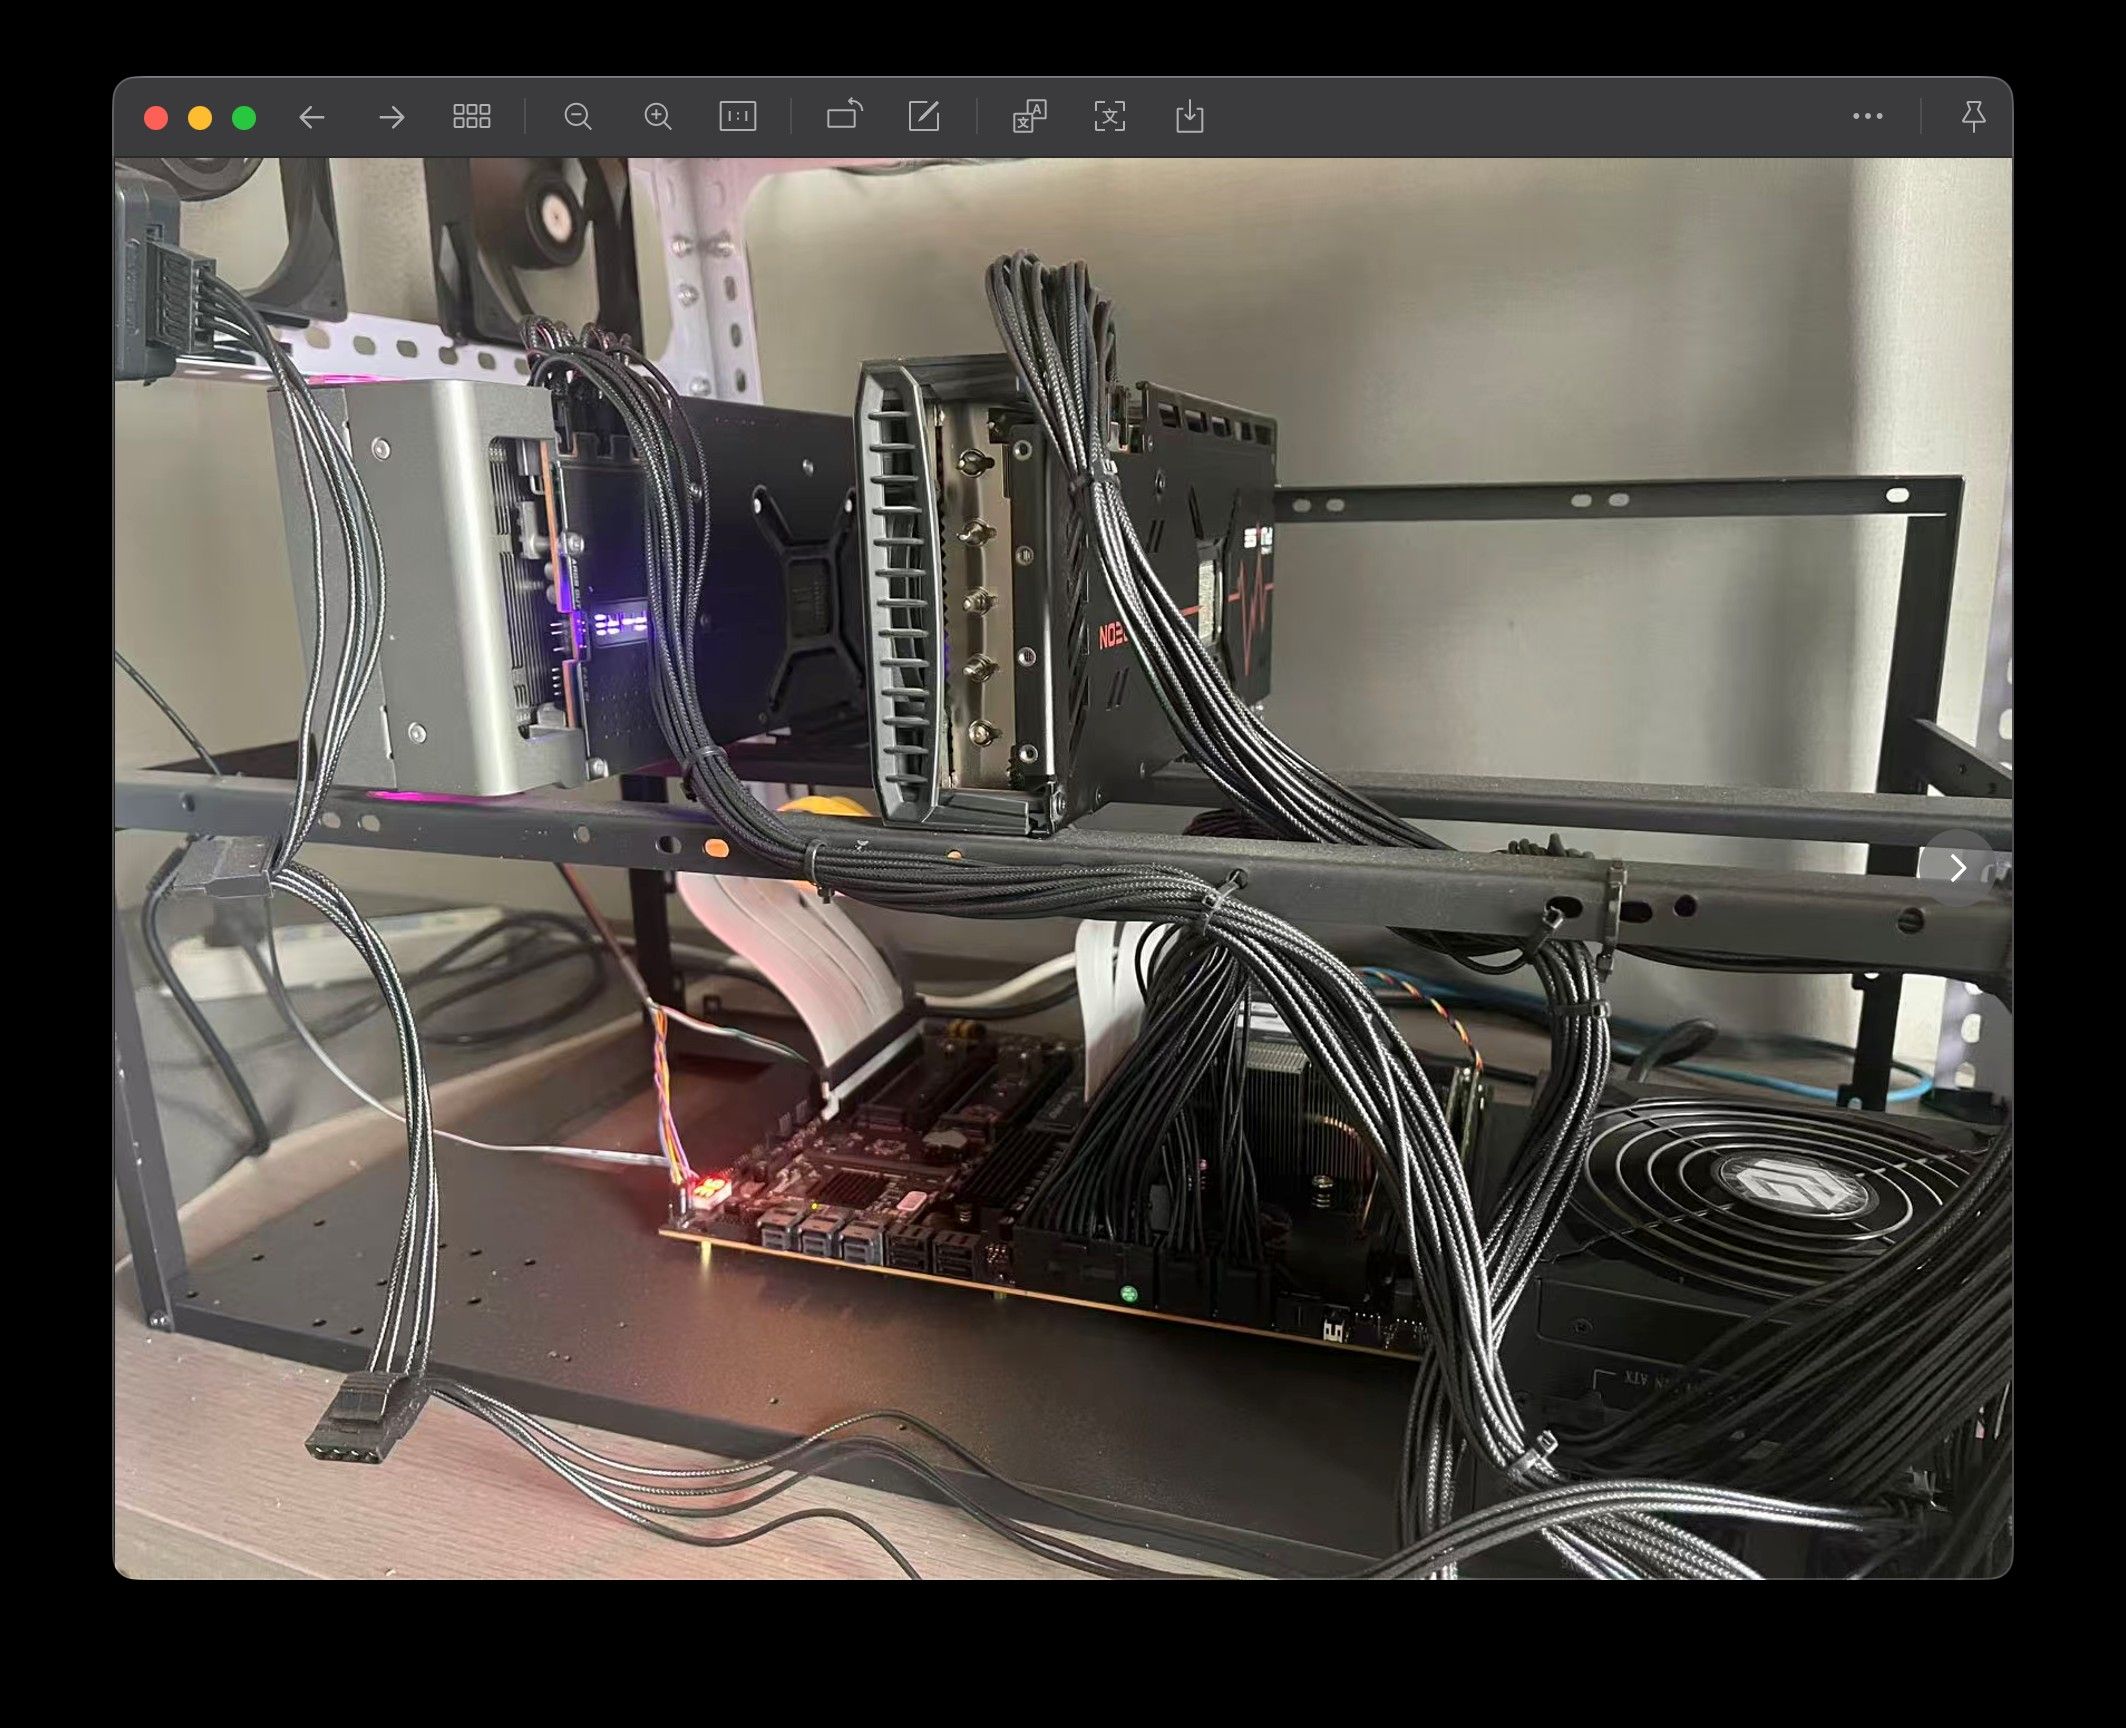
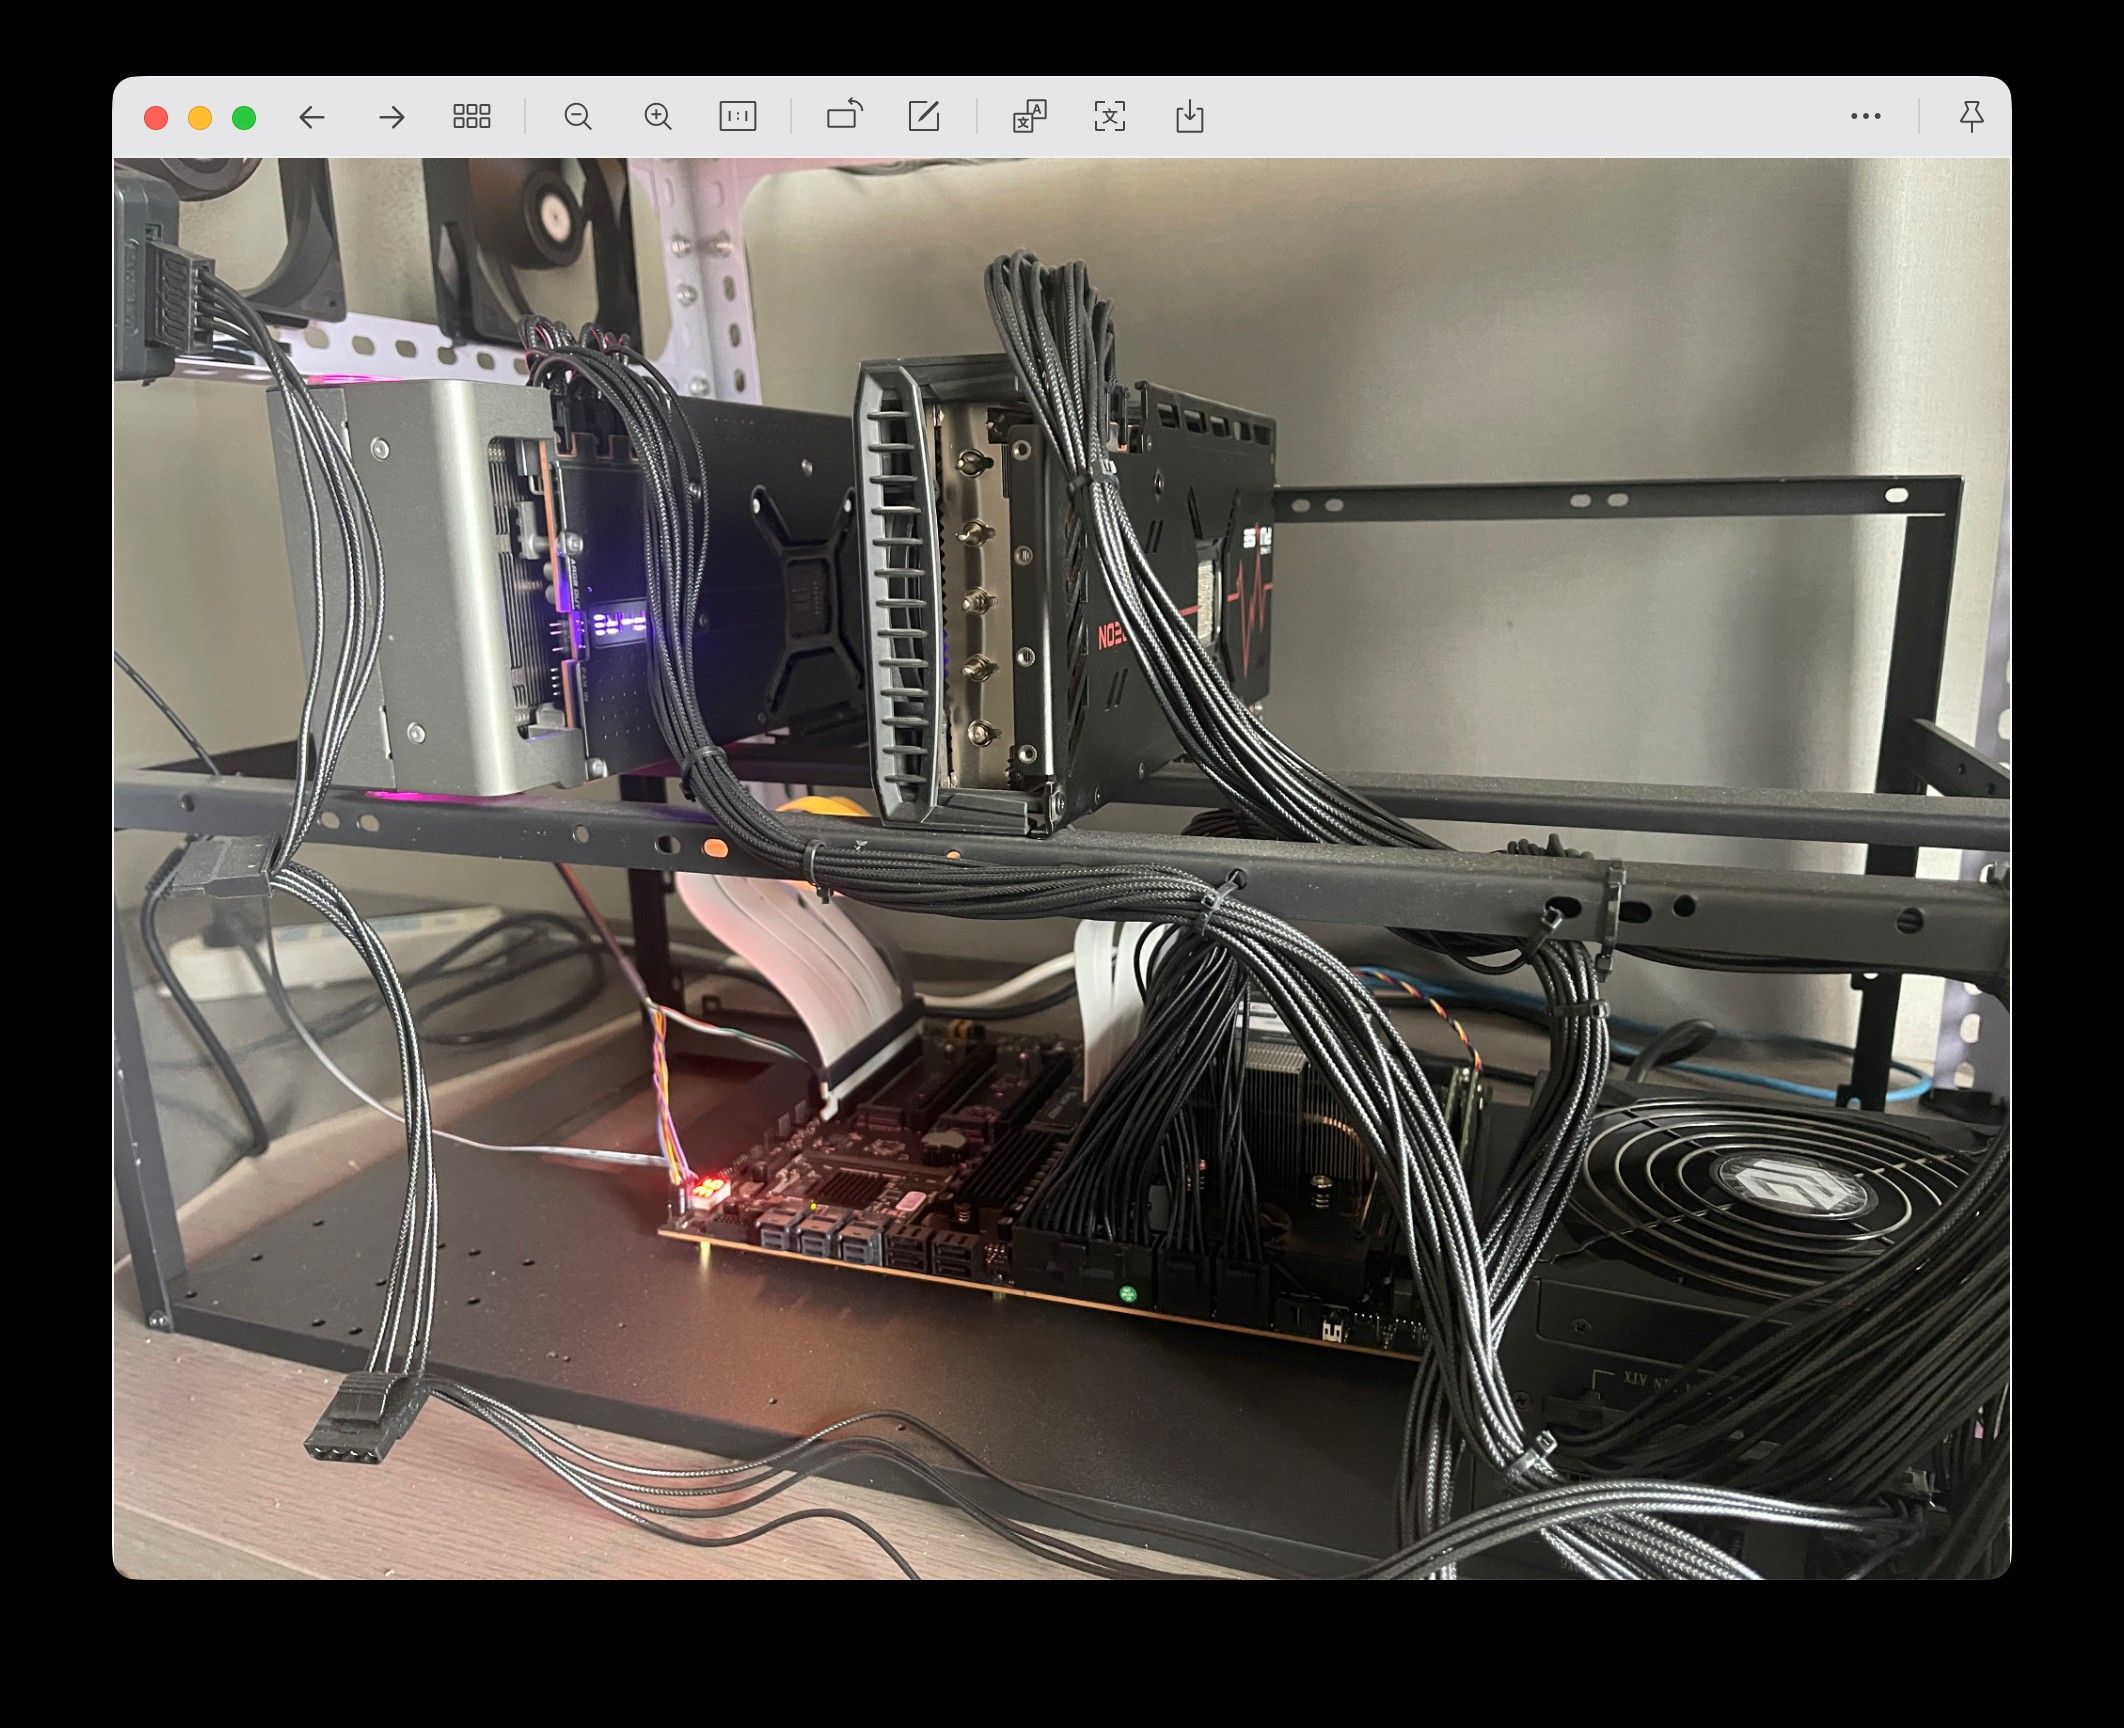
@terry 这个就是上次说有黑罩子的那个。这个是外面:
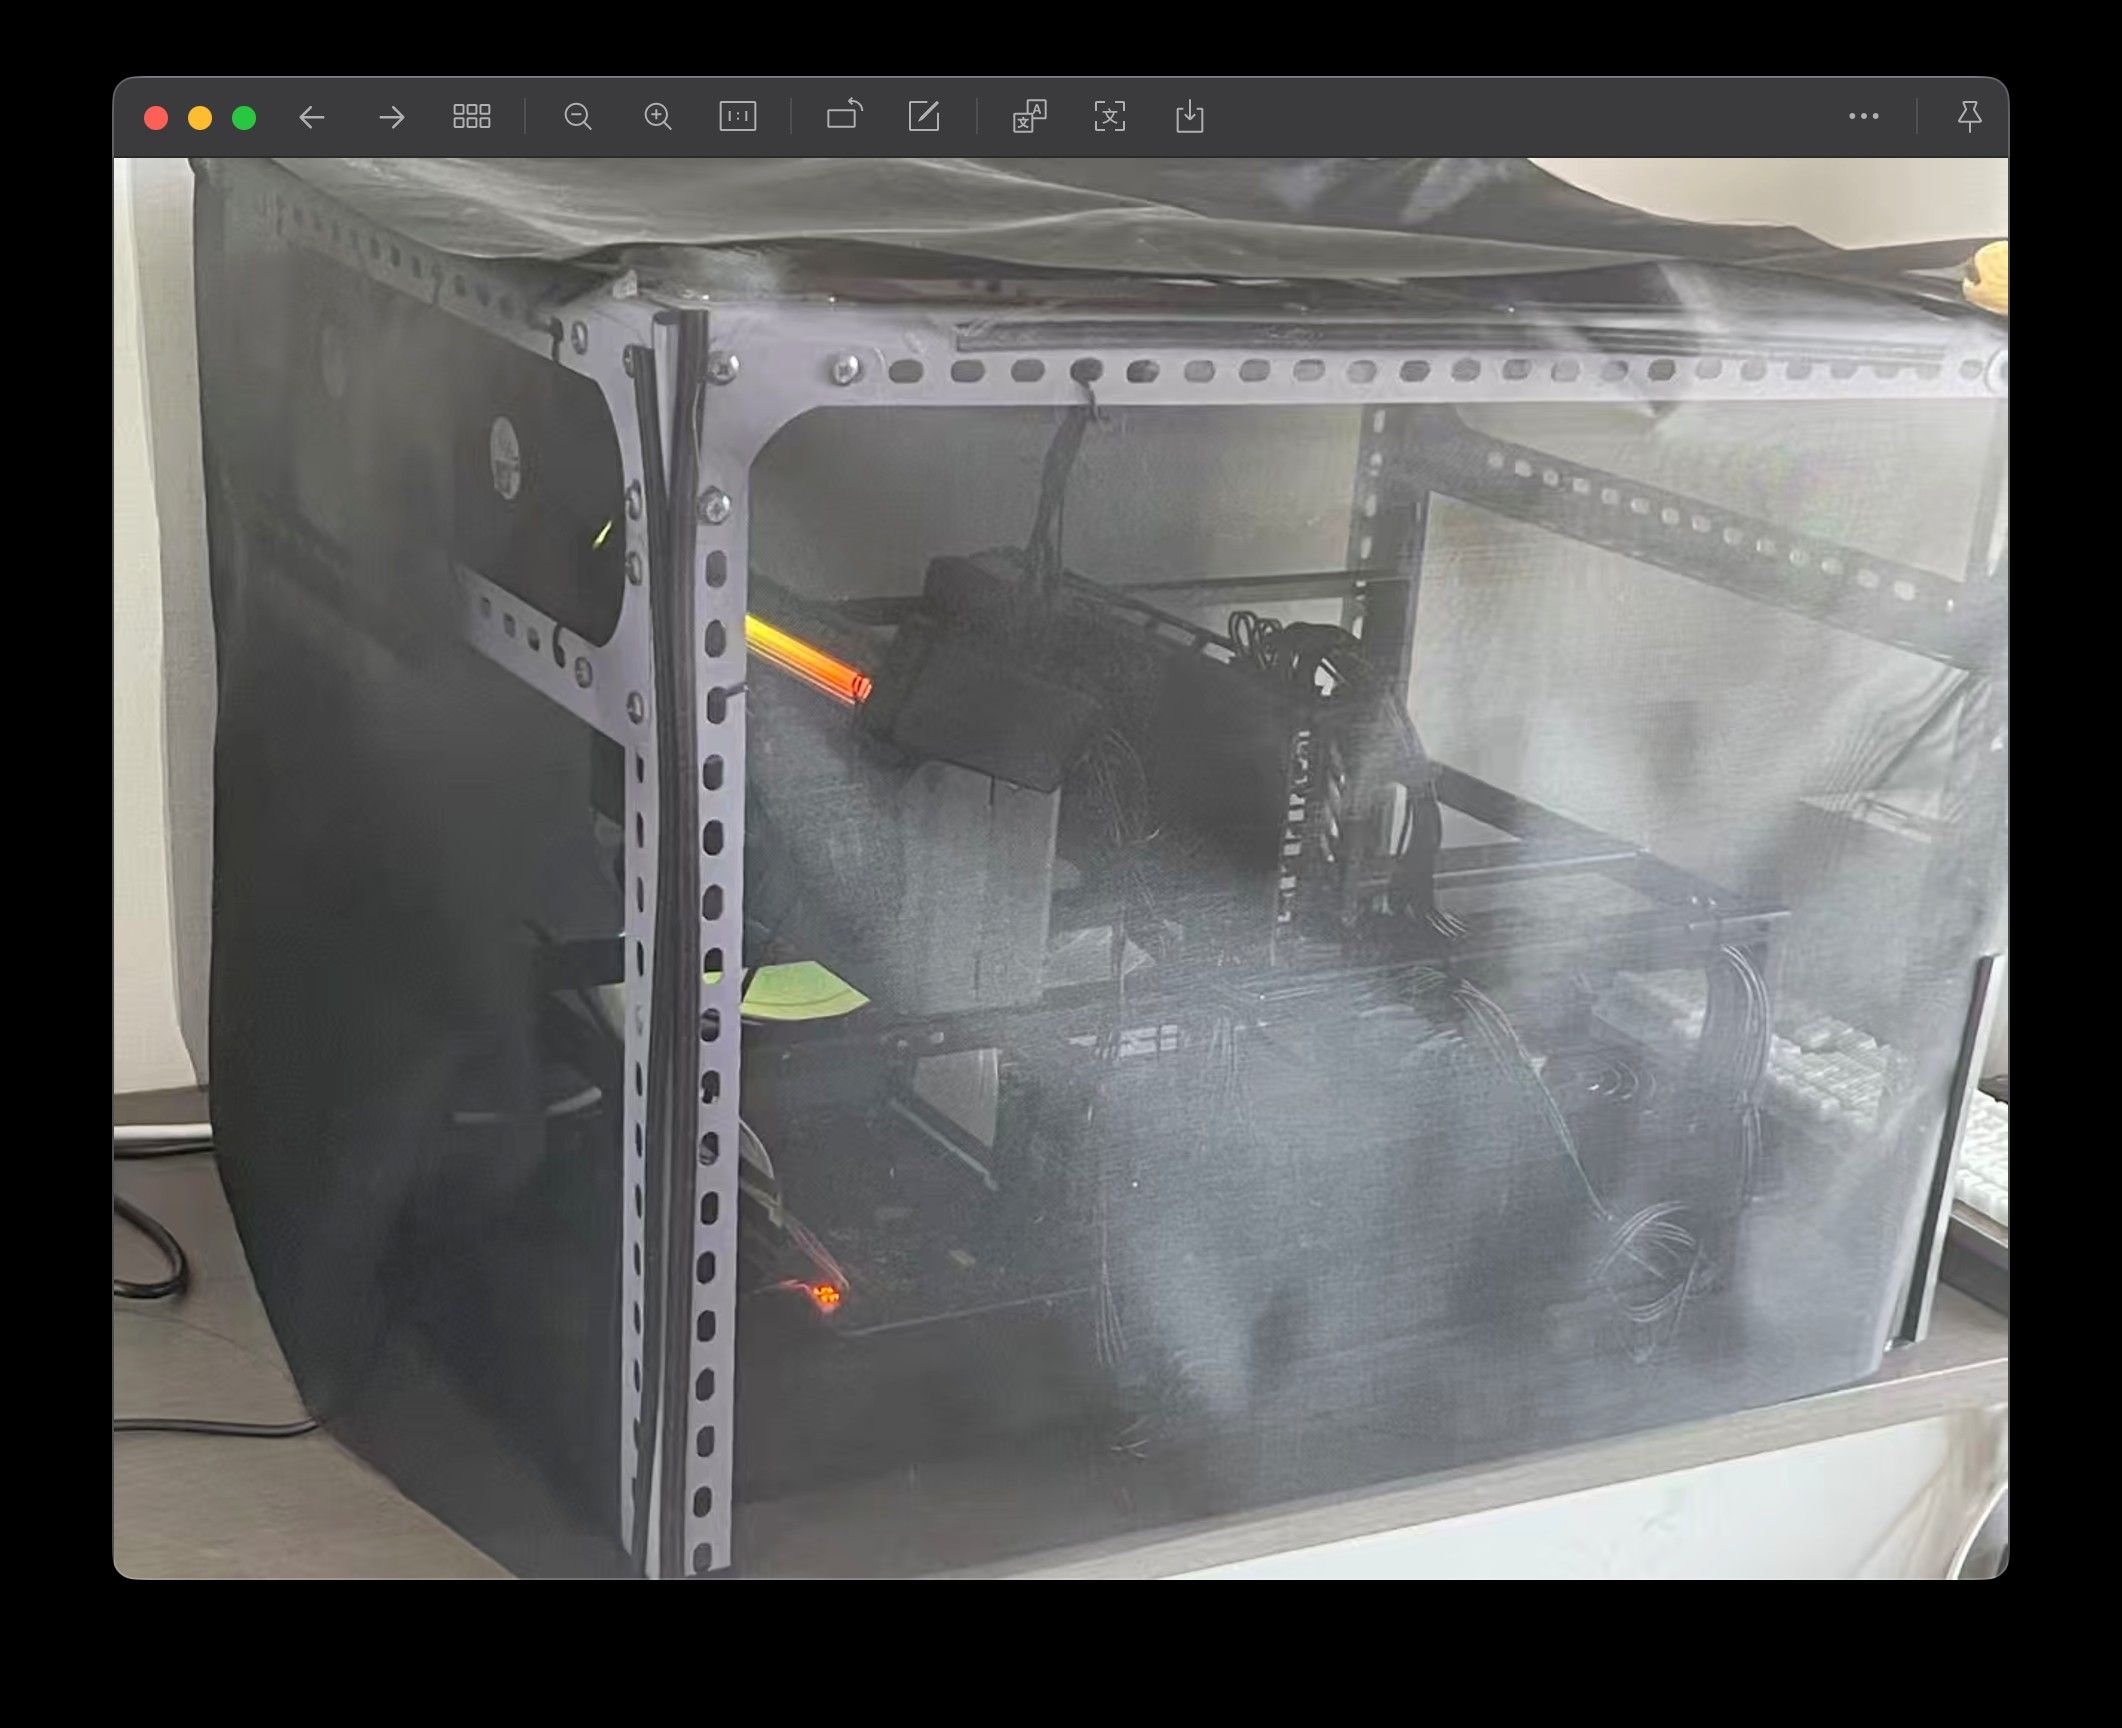
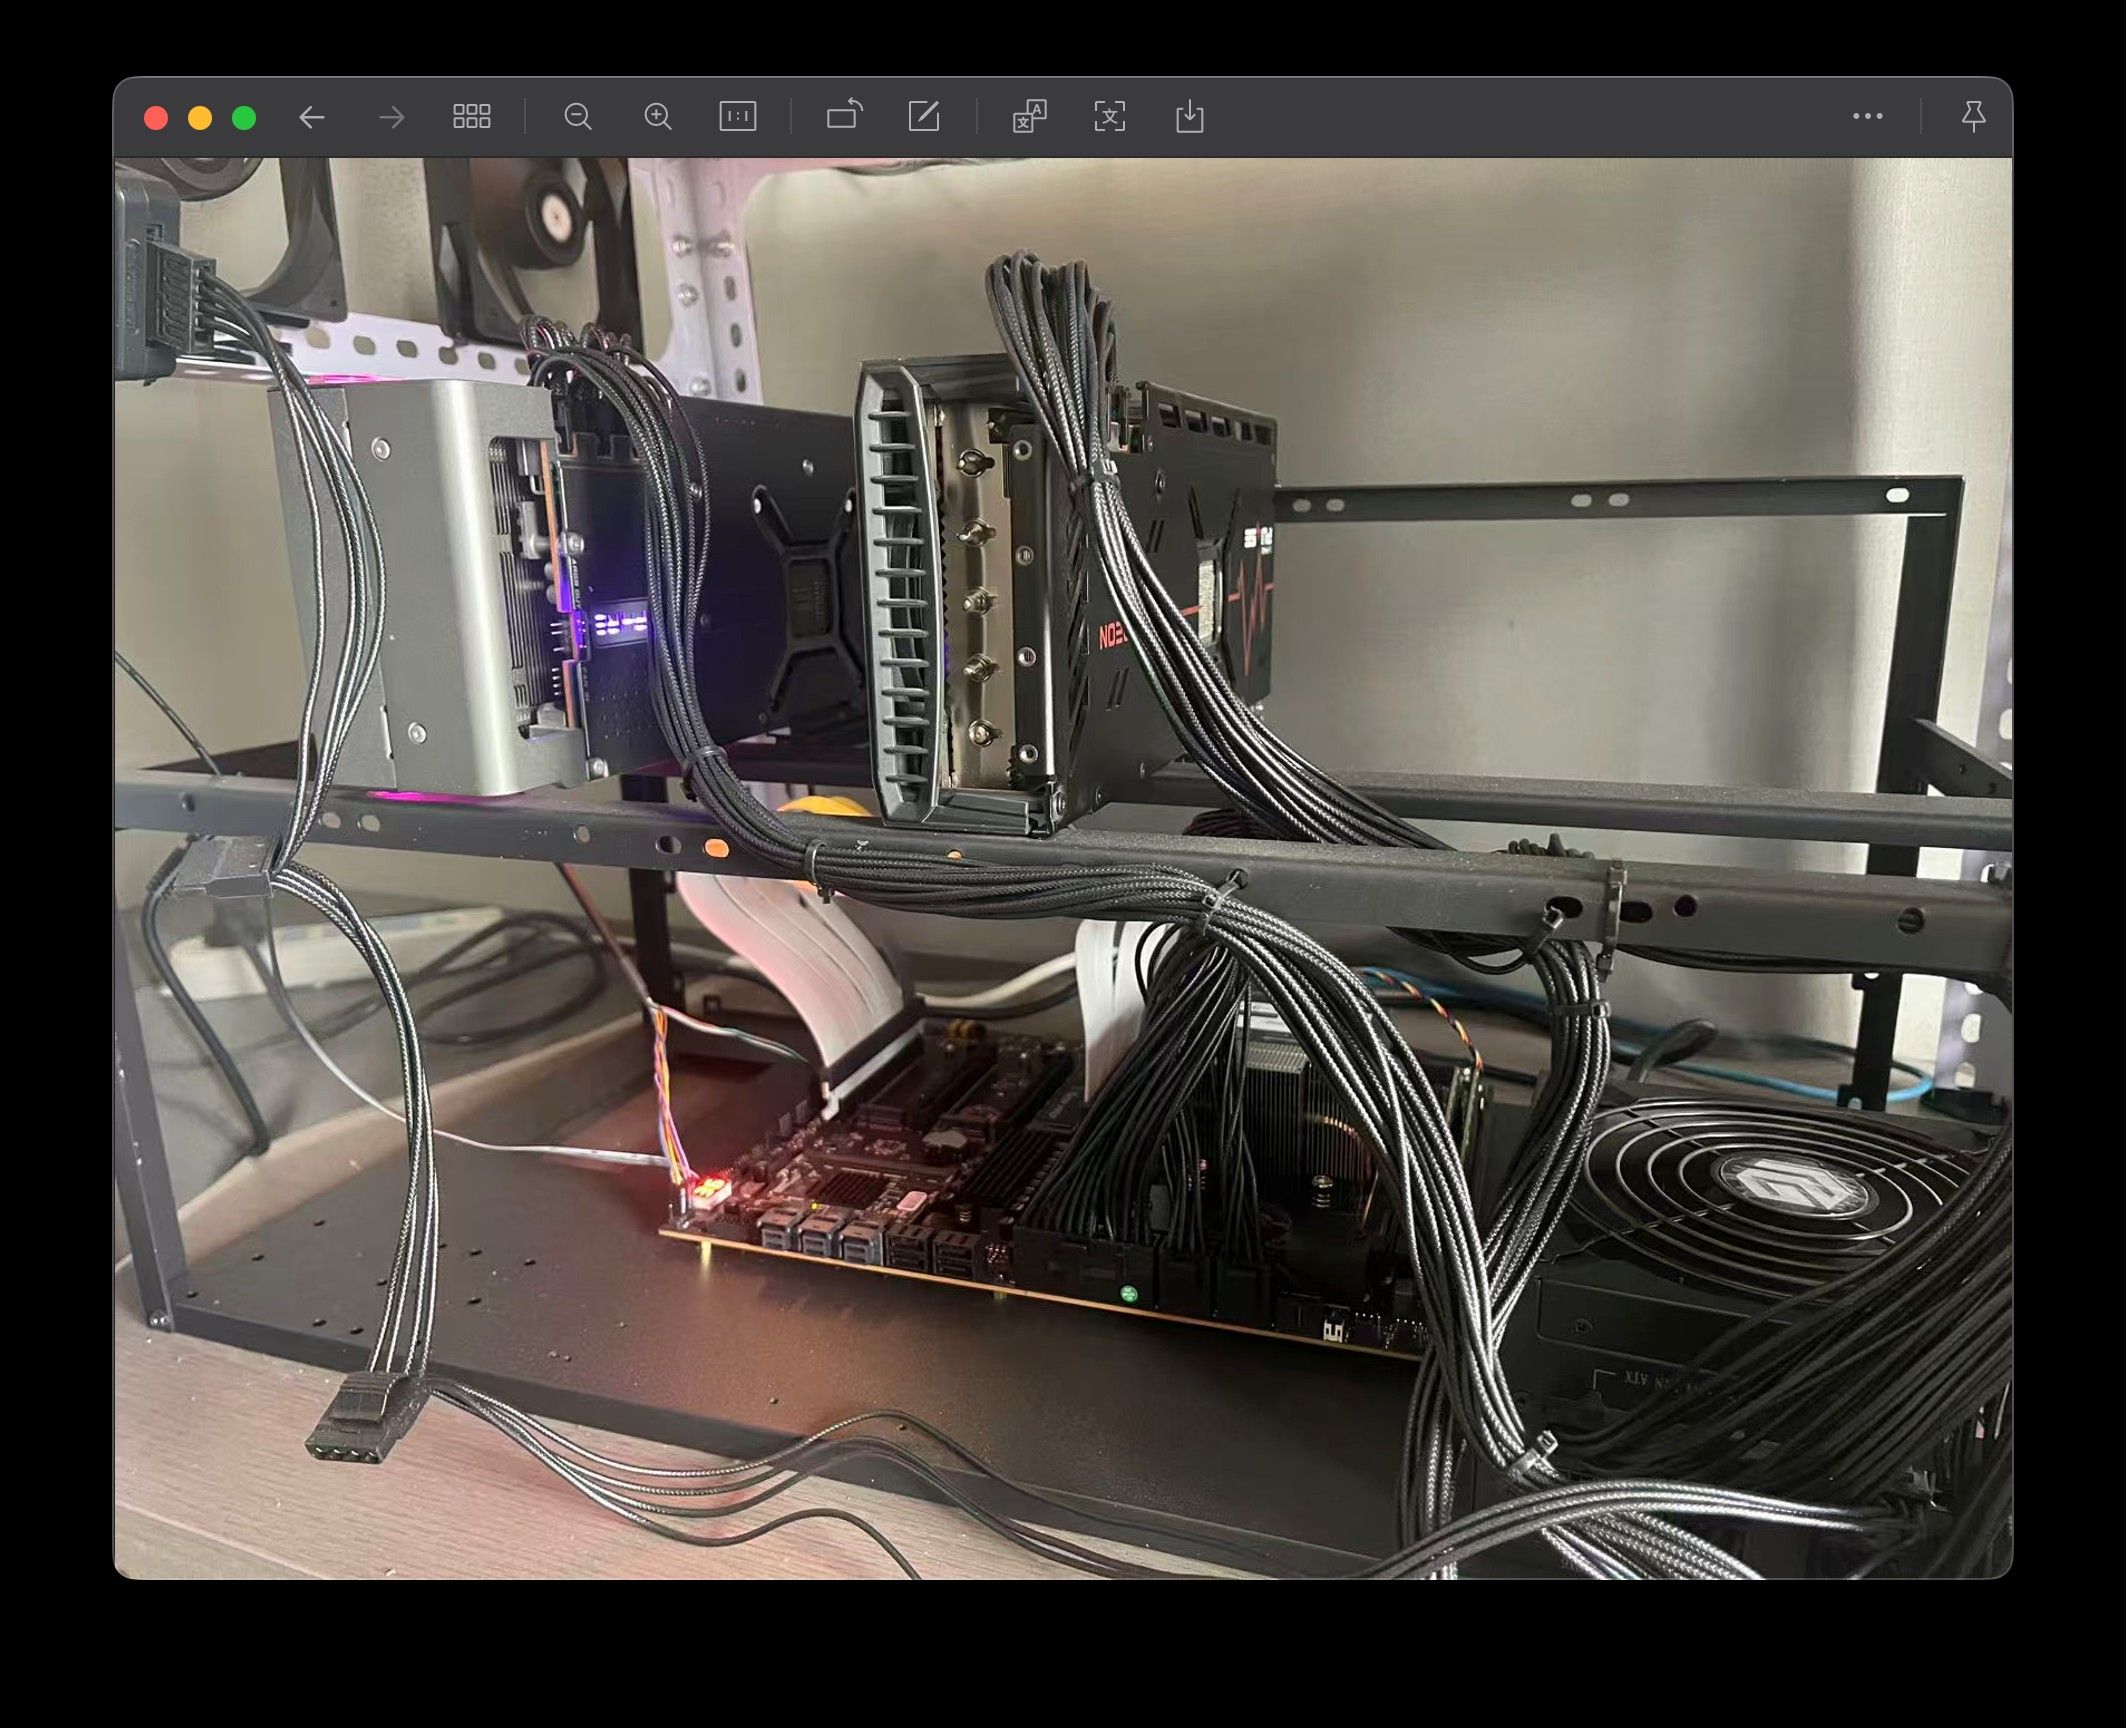
这个是里面: diding顶上和侧边加了几个风扇,温度最高是80,以前跑llama.cpp 负载高的时候会跑到80 , 现在换 vllm ,或是strata ,都是70左右:
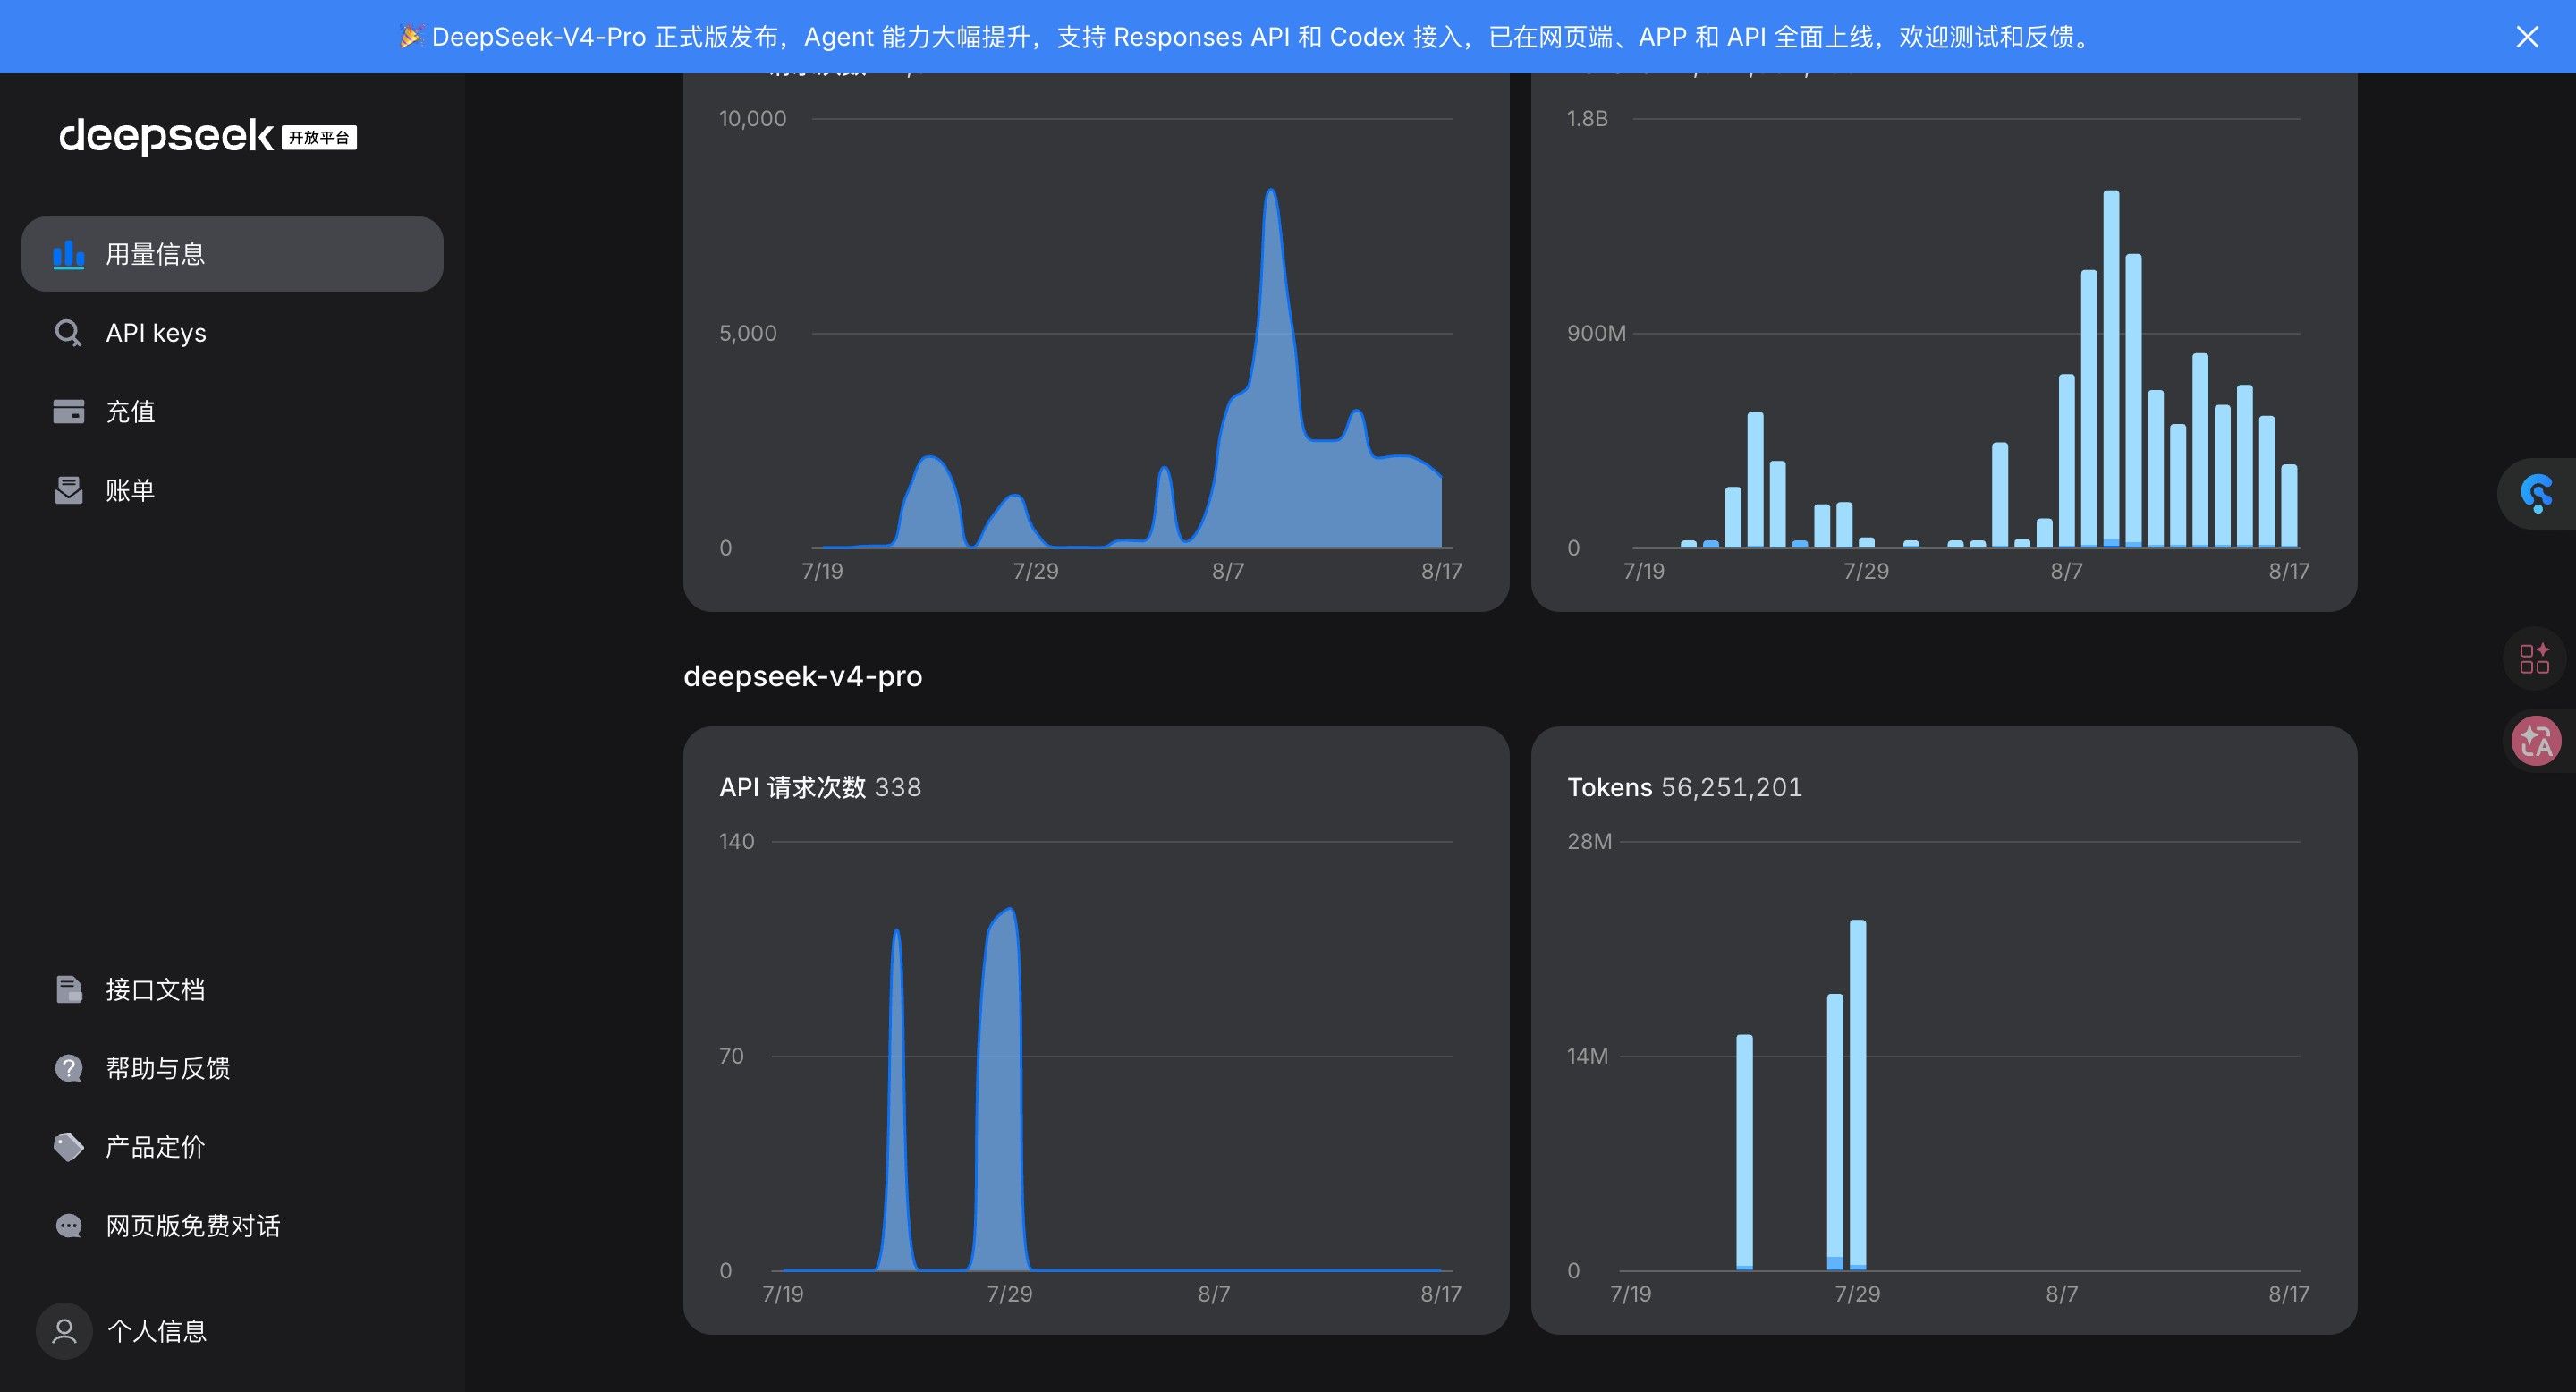
命中倒是没降,就是感觉傻了很多,经常改错问题,然后自己又改回来,还改不好,浪费好多token
@terry 哈哈哈,被老特翻牌子也是我得荣幸,哈哈哈
KV 才是大头,q4_0 或是q4_1 不够用,q5_1 勉强够, 最好上 q8 , 256k 上下文,显存就是10g+ 以上