
@xiaopbro IQ3_S 还不算最过度思考的,官方API更加雷霆。。。另外IQ3_XSS过度思考很多。
虽然思考有点长,但是输出质量我还是挺满意的。
这几天折腾了好一阵单卡strata,终于调优到了理想水平(pp1800, tg60-90)之后,略感空虚,整了点活,水一篇哈哈。
TDLR:单卡内存够的情况下,在视觉相关任务上(前端、客户端开发),strata生成质量明显高于27b,无脑选择IQ3_S。
量化更激进的模型跑的更快,但实际执行任务的时间更长,原因包括雷霆大思考流口水,不断返工等等,不值得为了点pp/tg的提升。此外,量化的确牺牲了不少模型对事物的认知和细节,具体可以从下文的报告里看到。
评测日期: 2026-10-04
测试方式: DeepSeek Harness (DSH) agent,同一句 prompt:Generate an SVG of a pelican riding a bicycle.
硬件: AMD Radeon RX 7900 XTX 24 GB (gfx1100/RDNA3),Ryzen 5 9600X (6C/12T),92 GiB RAM
本文回答两个问题:
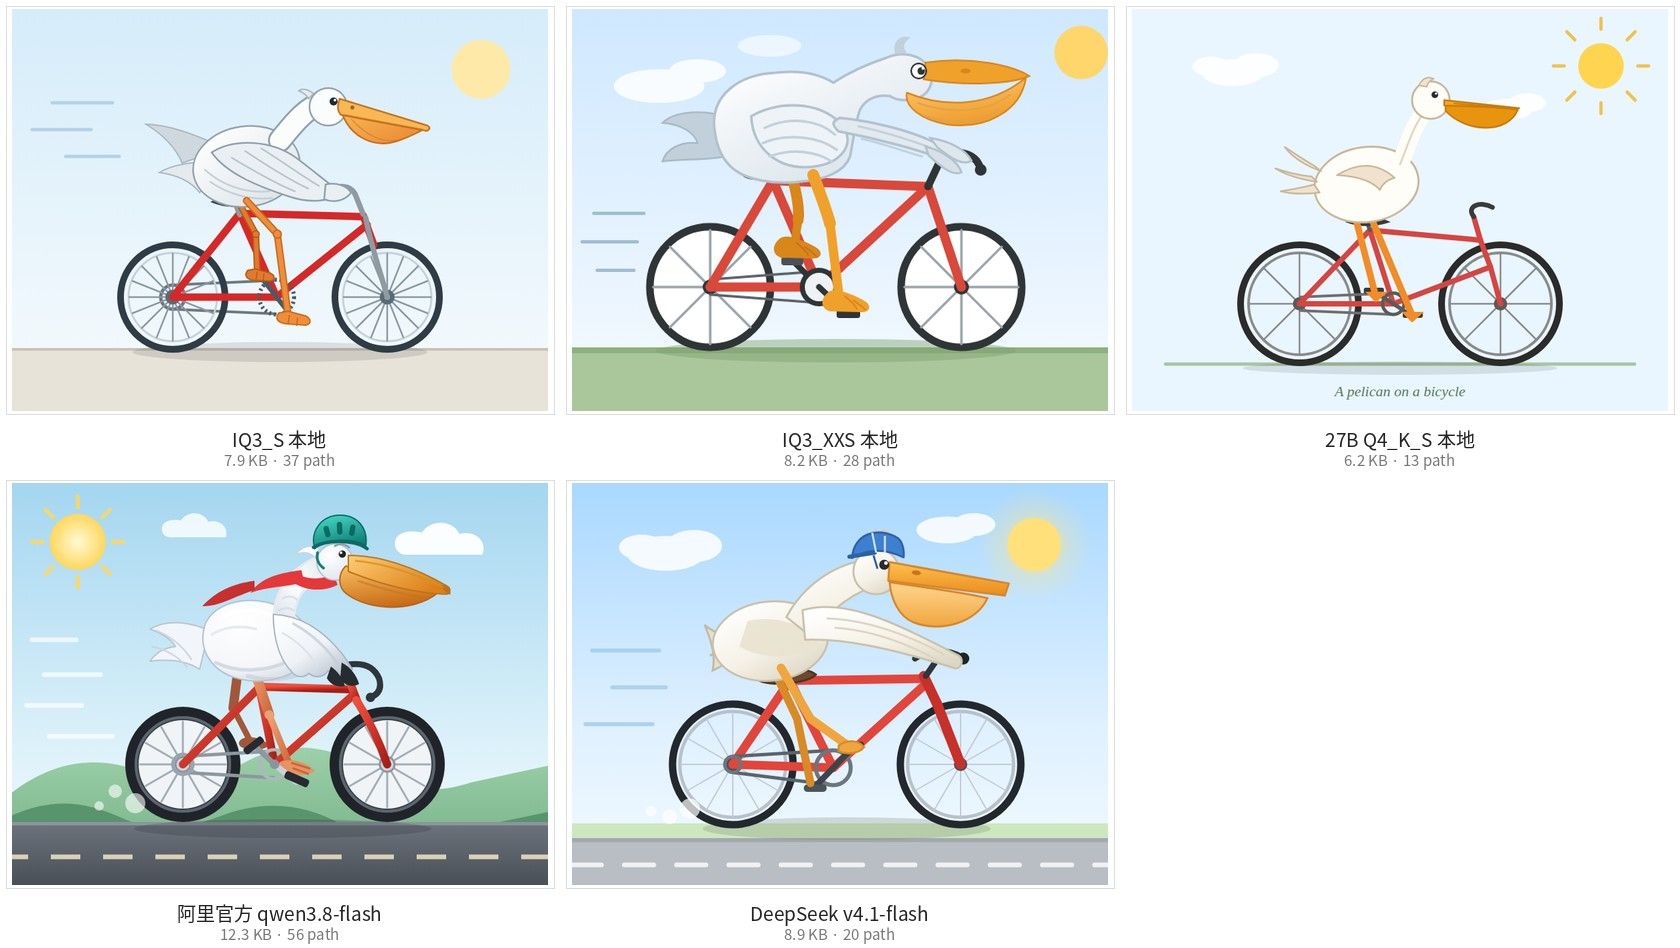
本地模型在质量上不落后。 IQ3_S(7.9 KB)产出的鹈鹕在解剖准确性上优于两个在线模型中的阿里官方,仅次于 DeepSeek v4.1-flash。三者在"能否画出正确的鹈鹕骑自行车"这一核心判据上处于同一档。
差距集中在延迟和吞吐,且分布不均:
| 维度 | 本地最优 | 在线最优 | 差距 |
|---|---|---|---|
| 冷启动 TTFT | 7,643 ms | 807 ms | 9.5× |
| 预热 TTFT | 411 ms | 750 ms | 本地反超 1.8× |
| decode 吞吐 | 88 tok/s | 279 tok/s | 3.2× |
| 短 prompt prefill | 1,195 tok/s | 不可比(缓存) | — |
关键发现:预热之后,本地模型的 TTFT 反而比在线更快(411 ms vs 750 ms),因为本地没有网络往返。真正输的只有 decode 吞吐(约 1/3.2)和冷启动的首次加载。
可用性判断:
IQ3_S → IQ3_XXS 是同一模型的两次量化,构成直接对照组。体积只小 10%,但行为差异显著:
| 指标 | IQ3_S | IQ3_XXS | 变化 |
|---|---|---|---|
| 权重体积 | ~79 GB | ~71 GB | −10% |
| decode 吞吐 | 71.8 tok/s | 88.0 tok/s | +23% |
| 短 prompt prefill | 1,044 tok/s | 1,195 tok/s | +14% |
| 冷启动 TTFT | 8,745 ms | 7,643 ms | −13% |
| 全程 output token | 23,814 | 65,175 | +174% |
| thinking 占比 | 51.6% | 64.3% | +12.7 pt |
| SVG 自纠正编辑 | 2 次 | 4 次 | +2 |
| SVG 渲染验证 | 6 次 | 11 次 | +5 |
量化省下 10% 的体积,换来 14–23% 的速度提升 —— 但代价是推理变得不节制: IQ3_XXS 输出了 2.7 倍的 token,其中 thinking 占比升到 64.3%。它单独产出的 41,921 个 thinking token 比 IQ3_S 的全部输出(23,814)还多 76%。
净效果是负的: IQ3_XXS 的 turn 1 端到端耗时 741.5 s,是 IQ3_S(307.5 s)的 2.4 倍。速度提升被过度推理完全吃掉。
产出质量没有损失 —— 两者同级,IQ3_XXS 的打磨次数甚至更多(自纠正 4 次 vs 2 次、渲染验证 11 次 vs 6 次),说明它更愿意反复迭代,但多花的成本没有转化为可见的质量收益。
这是单次运行的观察,n=1。 "IQ3_XXS 更啰嗦"可能是量化导致的系统性行为偏移,也可能是本次采样偶然。要确认需要多次重复实验。
| # | 模型 | 部署 | 量化 | HuggingFace 仓库 / 权重 | artifact |
|---|---|---|---|---|---|
| 1 | Qwen3.8-Flash-Next | 本地 Strata (HIP/gfx1100) | IQ3_S | ISTA-DASLab/…-GSQ-RCO-GGUF @ 2a55d759<br>…IQ3_S-00001/00002-of-00002.gguf |
/tmp/local_iq3/ |
| 2 | Qwen3.8-Flash-Next | 本地 Strata (HIP/gfx1100) | IQ3_XXS | 同上仓库 @ 2a55d759<br>…IQ3_XXS-00001/00002-of-00002.gguf |
/tmp/iq3_xxs/ |
| 3 | Unsloth Qwen3.8-27B | 本地 llama.cpp | UD-Q4_K_S(14.3 GiB) |
unsloth/Qwen3.8-27B-GGUF @ 14370d1b |
/tmp/27b/ |
| 4 | 阿里官方 qwen3.8-flash | 在线 API | — | 阿里云百炼 qwen3.8-flash |
/tmp/qwen-official/ |
| 5 | DeepSeek v4.1-flash | 在线 API | — | deepseek-official / deepseek-flash(1M ctx) |
/tmp/deepseekv41/ |
模型 1/2 是同一模型的不同量化,构成本文问题二的对照组。
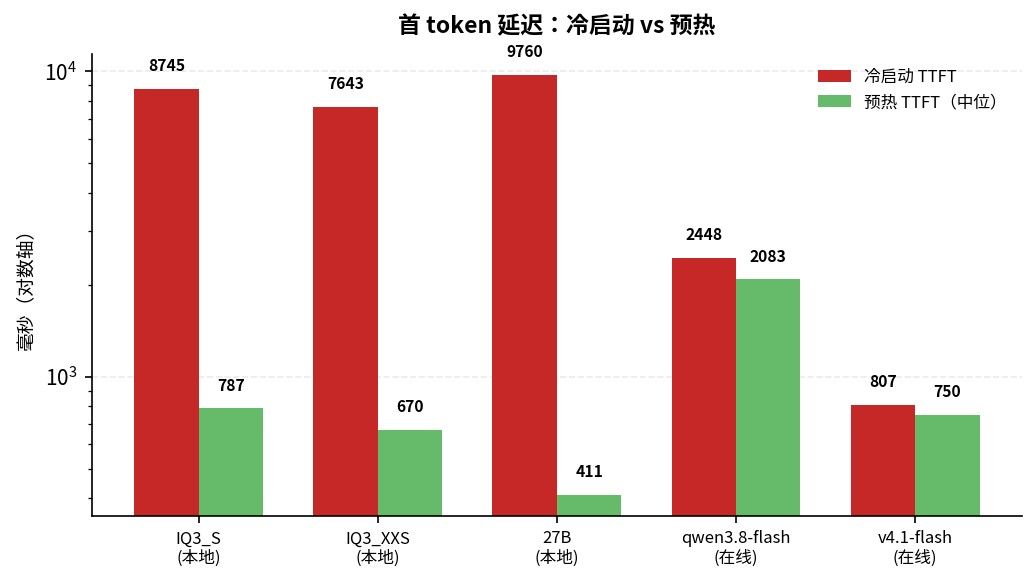
冷启动本地慢 3–4 倍,预热后本地反超。 本地三个模型的预热 TTFT(411–787 ms)全部优于阿里官方(2,083 ms),27B 甚至优于 DeepSeek(411 vs 750 ms)。原因是本地无网络往返,而在线模型每次请求都要跑完整 RTT。
本地模型的冷启动降幅达 11–24 倍,说明主要成本是首次加载(expert cache 预热、首个 verify window 建立),而非推理本身。在线模型冷/预热差异仅 1.1–1.2 倍,因其服务端始终处于热态。
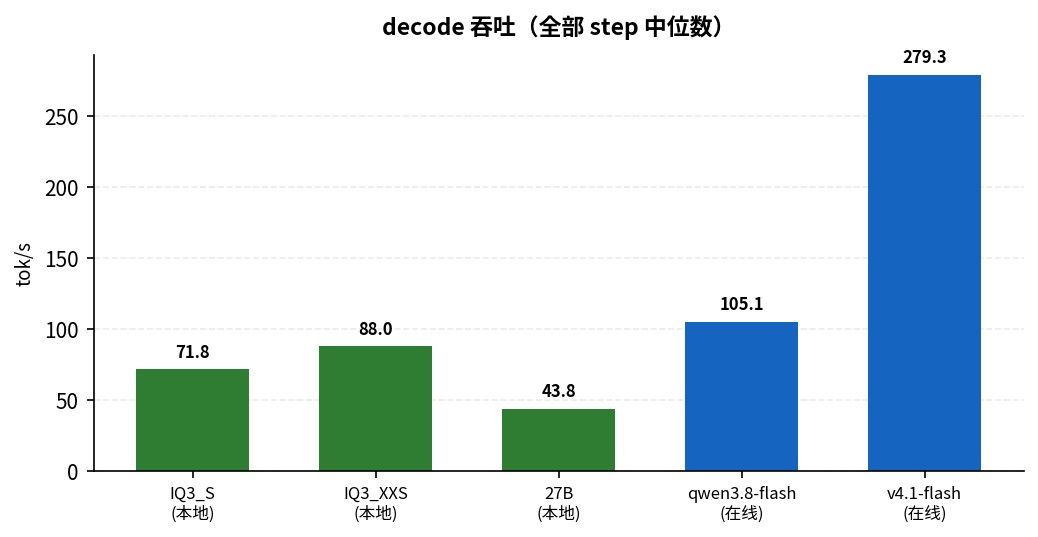
decode 是本地唯一稳定落后的维度:44–88 tok/s vs 在线 105–279 tok/s。差距比 prefill 小得多,且对交互体验的影响主要是长输出时的等待时长。但是考虑到一个27G的本地显卡可以达到阿里官方API 70%的速度,可以说并不差了。
prefill 无法公平比较: 两个在线模型的首步输入分别有 98% 和 86% 命中服务端缓存,其 TTFT 反映缓存读取而非计算。三个本地模型无缓存命中,是真实 prefill:
| 模型 | prefill | 说明 |
|---|---|---|
| IQ3_S | 1,044 tok/s | 真实(短 prompt) |
| IQ3_XXS | 1,195 tok/s | 真实(短 prompt) |
| 27B Q4_K_S | 991 tok/s | 真实(短 prompt) |
| 阿里官方 |  ️ 不可比 |
98% 缓存命中 |
| DeepSeek v4.1 | ️ 不可比 |
86% 缓存命中 |
长 prompt(33K 全新)下本地可达 1,856–1,980 tok/s,为短 prompt 值的 1.8–2.0 倍。
五个 artifact 并排对比(上排为本地模型,下排为在线模型;按各自原生画布尺寸渲染):
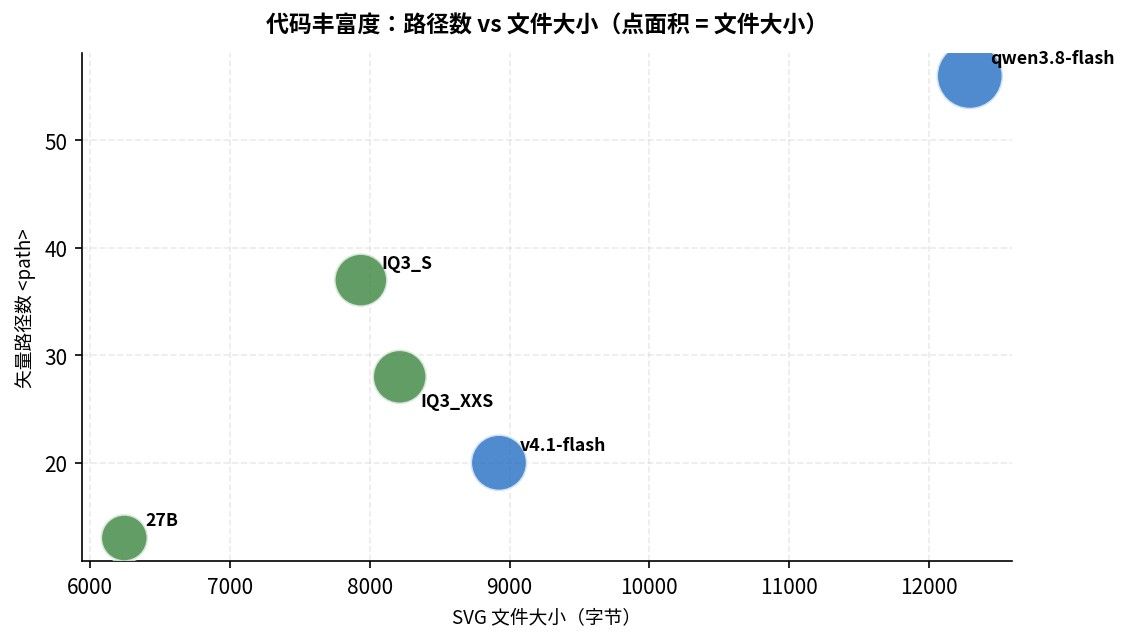
| 模型 | 字节 | 元素 | <path> |
transform |
可访问性 |
|---|---|---|---|---|---|
| IQ3_S 本地 | 7,936 | 89 | 37 | 3 |  |
| IQ3_XXS 本地 | 8,214 | 86 | 28 | 0 | |
| 27B Q4_K_S 本地 | 6,244 | 86 | 13 | 1 |  |
| 阿里官方 | 12,292 | 120 | 56 | 10 | |
| DeepSeek v4.1 | 8,924 | 90 | 20 | 9 | |
所有 artifact 按各自原生画布尺寸渲染(IQ3_XXS 640×480,其余 800×600),不作缩放比较。
目视评估:
<path> 仅 13 个,细节最少,脚与脚踏关系含糊。勉强能算“鸟骑自行车”吧。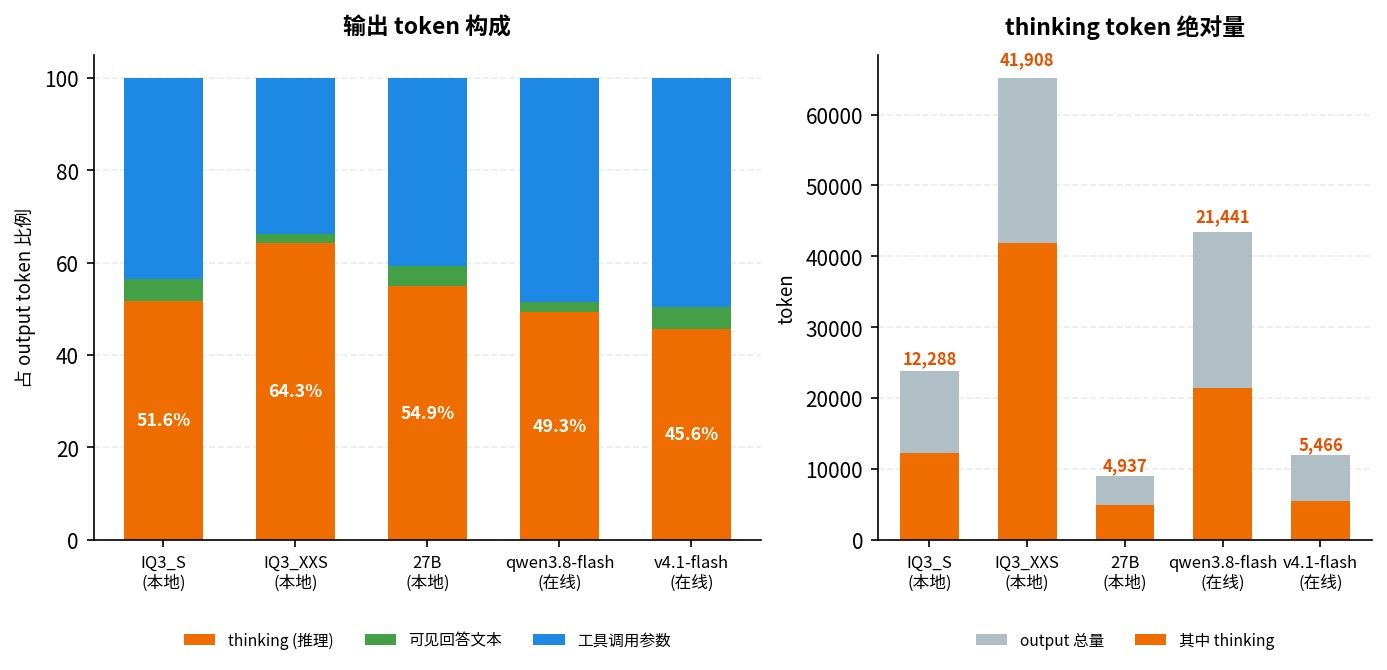
| 模型 | turn 1 耗时 | step 数 | 工具调用 | 全程 input | 全程 output |
|---|---|---|---|---|---|
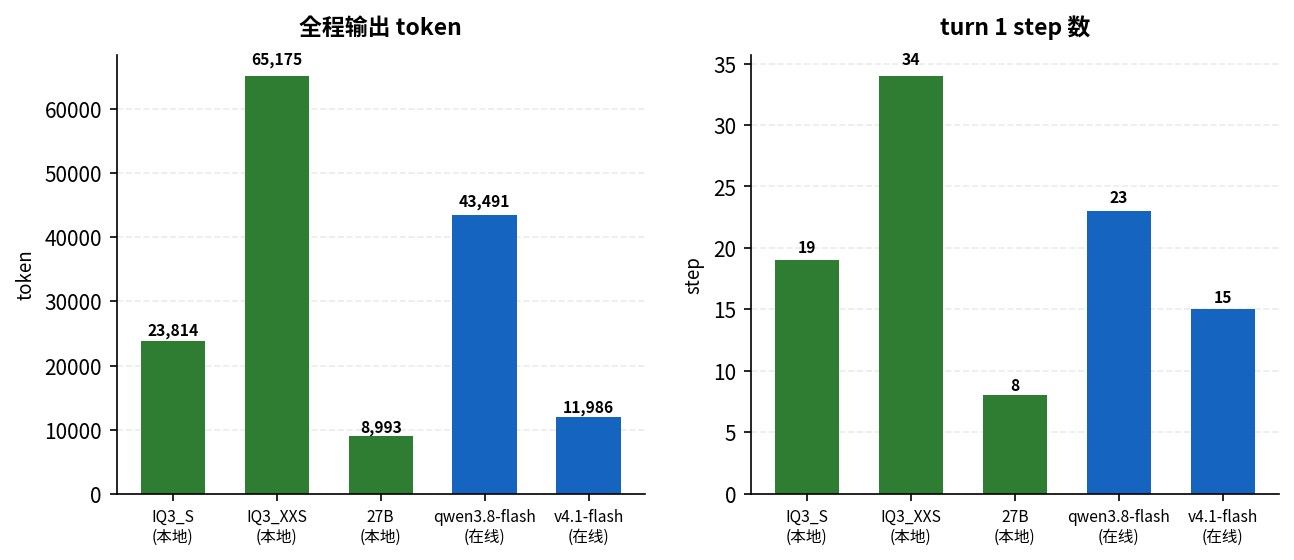
| IQ3_S 本地 | 307.5 s | 19 | 21 | 16,755 | 23,814 |
| IQ3_XXS 本地 | 741.5 s | 34 | 36 | 17,365 | 65,175 |
| 27B Q4_K_S 本地 | 202.2 s | 8 | 8 | 11,144 | 8,993 |
| 阿里官方 | 489.5 s | 23 | 27 | 81,170 | 43,491 |
| DeepSeek v4.1 | 56.4 s | 15 | 17 | 6,073 | 11,986 |
端到端耗时由输出长度主导,而非速度。 本地最慢的 IQ3_XXS 不是因为卡慢,而是因为它写了 2.7 倍的 token。
| 指标 | IQ3_S | IQ3_XXS | 解读 |
|---|---|---|---|
| 权重体积 | ~79 GB | ~71 GB | 省 10% |
| decode | 71.8 tok/s | 88.0 tok/s | 快 23% |
| prefill(短) | 1,044 tok/s | 1,195 tok/s | 快 14% |
| 冷启动 TTFT | 8,745 ms | 7,643 ms | 快 13% |
| 全程 output | 23,814 | 65,175 | 多 174% |
| thinking 占比 | 51.6% | 64.3% | 高 12.7 pt |
| 自纠正编辑 | 2 | 4 | 更多打磨 |
| 渲染验证 | 6 | 11 | 更多打磨 |
| turn 1 端到端 | 307.5 s | 741.5 s | 慢 2.4× |
第一层:推理节制性(最严重)。 IQ3_XXS 输出的 thinking token(41,921)超过 IQ3_S 的全部输出(23,814)达 76%。量化后的模型似乎更难"想够了就停"。这是本轮量化最明确的损失。
第二层:端到端效率(由第一层导致)。 速度提升 14–23%,但输出量增加 174%,净结果是端到端慢 2.5 倍。单看 tok/s 会得出完全错误的结论。
第三层:产出质量(无明显损失)。 两个 artifact 同级,IQ3_XXS 细节甚至略多。量化没有损害产出质量 —— 至少在这个任务上、这一次运行中。
另一个 aggressive 量化样本(27B 的 4-bit 版)不支持"量化必然导致啰嗦":
| 指标 | IQ3_XXS | 27B Q4_K_S |
|---|---|---|
| 量化等级 | IQ3_XXS(更激进) | UD-Q4_K_S |
| 全程 output | 65,175 | 8,993 |
| thinking 占比 | 64.3% | 54.9% |
| 自纠正编辑 | 4 | 0 |
| turn 1 耗时 | 741.5 s | 202.2 s |
27B Q4 输出最少、几乎不反复打磨(0 次编辑、4 次渲染),一次成型且质量合格。说明"量化导致过度推理"与具体模型/量化方案相关,不是普遍规律。
reasoning/text/tool-call 分类存储字符数,token 占比由各模型实测字符/token 比(中位 2.38–2.98)换算,非直接测量。有点意思,看来这个strata不太挑显卡,但是要发挥最高潜能,对机器整体素质要求不低。
我这边贡献个数据点:9600x 6核,96g ddr5 3600 (带宽比你的稍低),pcie4*16 (是你的两倍),跑更大的iq3_s时候pp1600-2000,decode 60-80。
看起来你这个setup 要是换个pcie4的板子还有提升空间
他这个双卡是layer parallelism,一般来说pp会上升,tg会略有下降
好不容易放假了,我又开始鼓捣我的本地硬件了,最近X上Strata比较火,昨天正好支持了AMD 7900xtx,简单跑了一下支持最高精度的IQ3_S,基本上tg跑到了55,但是prefill才700多,差点意思,于是指挥deepseek v4.1把vllm上的专用wmma kernel搬过来,效果立竿见影,pp能到1300+左右。
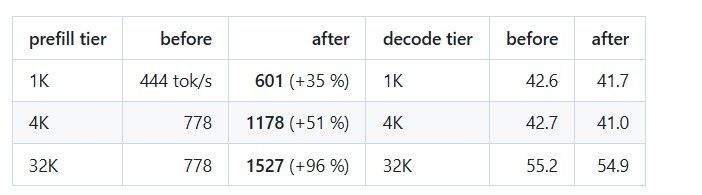
啥也不说,先放PR:https://github.com/Niko1221/Strata/pull/260 找个趁手的Agent帮你部署一下就好了。
简单谈几个可能会被忽视的小细节:
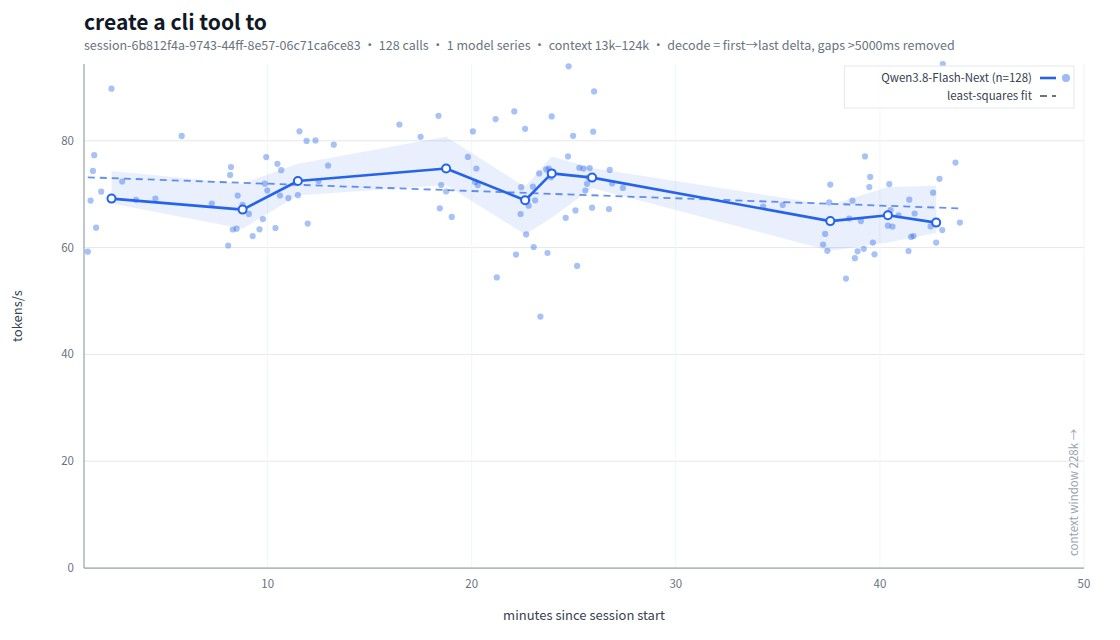
这个引擎的专家基本都在RAM缓存,支持CPU/GPU混合计算,所以会看到一个奇怪现象:段上下文的pp/tg比长上下文的pp低,这主要是VRAM caching构建中的摩擦成本,所以这模型越用越快也是有点意思。刚开始随机跟它对话的话tg大概40左右,用dsh加一个9k的prompt居然tg到了50,考虑到这是个80GB+模型,这个引擎也算是agent圣体了。
下面是一个dsh 120k session的 tg随context下降的图表:
pp阶段主要瓶颈是pcie带宽,我本来是双卡7900xtx pcie48 拆分,把另一张卡关机拔了重启后主显卡自动获得pcie416,pp自动涨了+30%,tg也涨了10%。另外可以看到12GB 的5070 tg和24g的7900xtx一样,主要是因为人家是pcie5*16,估计未来R9700支持之后速度会更快,当然要搭配更贵的PCIE5主板和内存。
最后API server的拉起命令:
cd path/to/Strata
HIP_VISIBLE_DEVICES=0 PYTHONUNBUFFERED=1 \
  ~/.config/strata/venv/bin/python -m serve.server \
    --engine strata --config /home/jianwei/.config/strata/serve.json --port 8080
serve.json
{
  "exe": "/path/to/Strata/build-hip/strata-hip",
  "cwd": "/path/to/Strata",
  "args": [
    "--pack",
    "/path/to/Strata-data/packs/iq3_s",
    "--native",
    "/path/to/Strata-data/models/IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00001-of-00002.gguf",
    "--ple-gguf",
    "/path/to/Strata-data/models/IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00002-of-00002.gguf",
    "--expert-profile",
    "/path/to/Strata/data/expert-profile.bin",
    "--expert-cache",
    "auto",
    "--prefill",
    "2048",
    "--spec",
    "2",
    "--spec-min-p",
    "0.5",
    "--adapt-every",
    "2",
    "--pcie-frac",
    "0.30",
    "--kv",
    "int8",
    "--max-context",
    "262144",
    "--mtp",
    "/path/to/Strata-data/models/IQ3_S/mtp/rt"
  ],
  "tokenizer": "/path/to/Strata-data/packs/iq3_s/tokenizer",
  "model_name": "Qwen3.8-Flash-Next",
  "host": "0.0.0.0",
  "port": 8080
}
最后一两张截图:
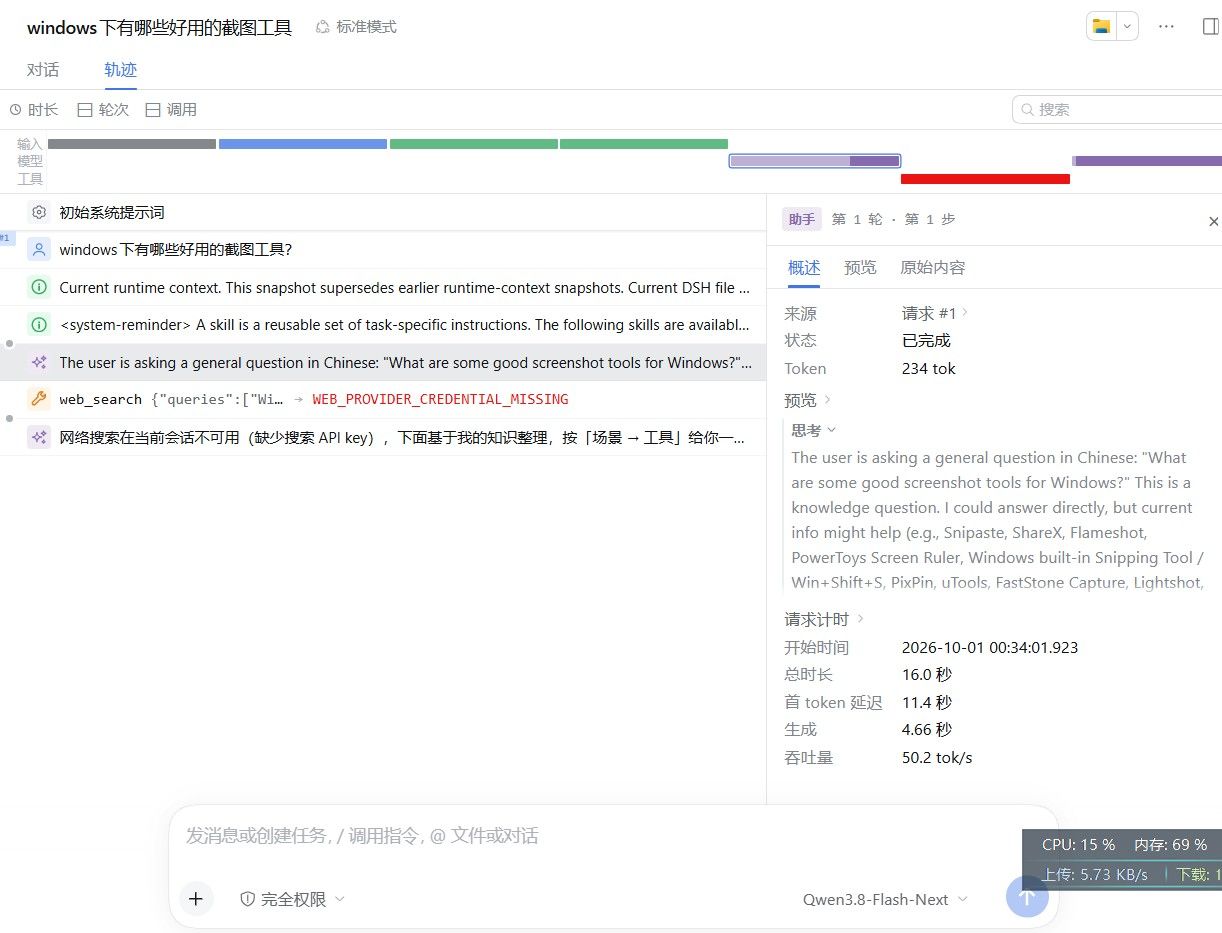
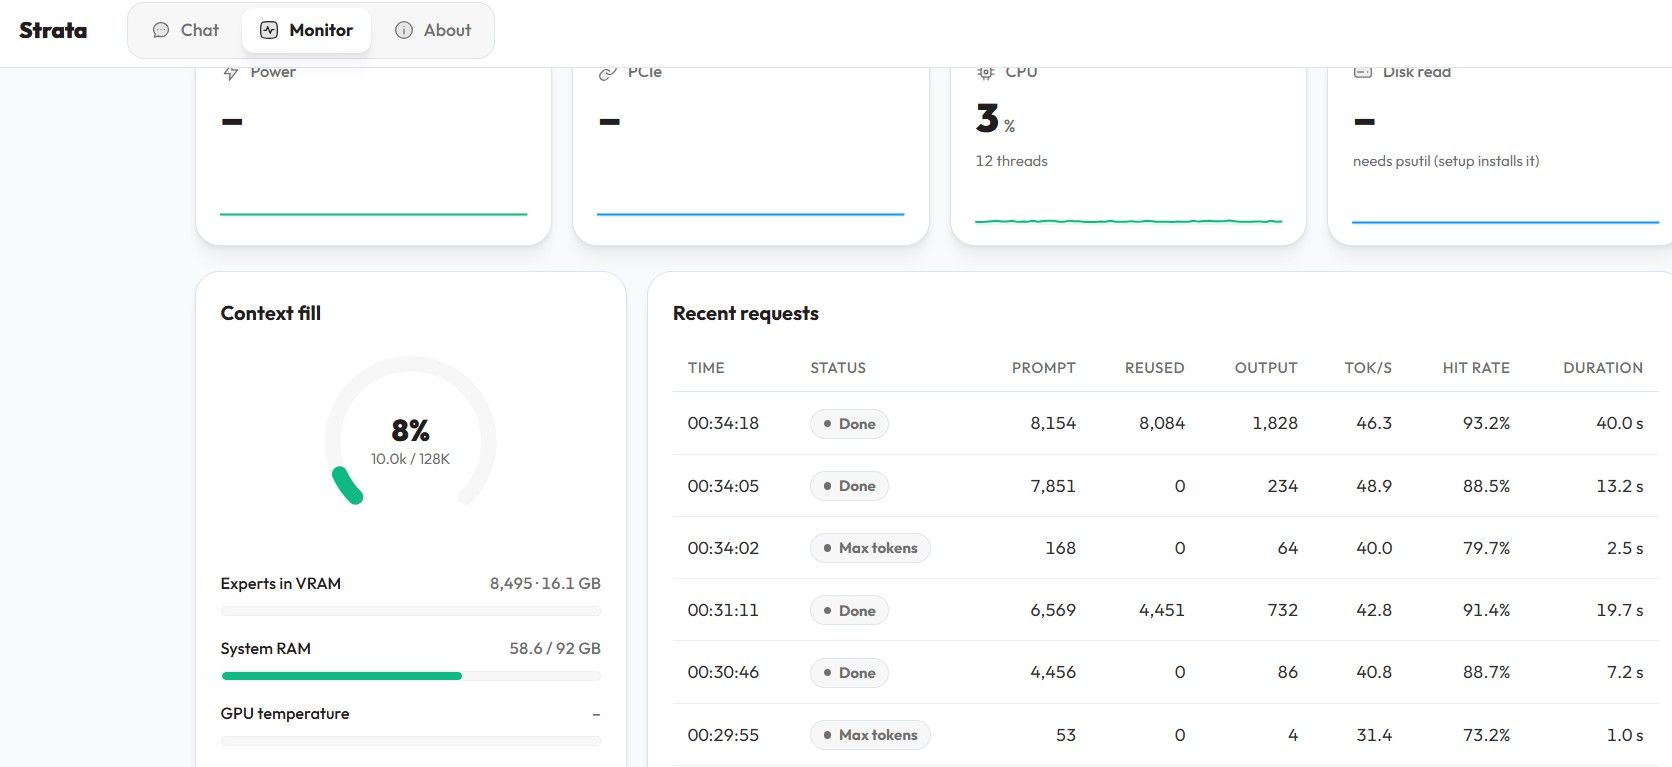
我的sglang 双卡7900xtx用的是1200w的海韵,其中每张卡还有一个6pin一转2和12pin一转二都没有问题。我觉得贴主的问题可能是pcie switch供电不太好。
@johnnybegood AM5 96G DDR5 因为是消费级平台降频到3600才跑得起来(反正瓶颈不在这 在pcie4*8的带宽
@johnnybegood 哈哈哈 我这两周在测试qwen3.8 flash next pp900-1000 tg40-50左右吧。大概是27b的llama.cpp基线水平,生成质量比27b好不少。这个模型主要瓶颈在VRAM大小 和 PCIE带宽,epyc平台或者双卡r9700应该还有50-80%的空间。
qwen3.8 27b 有w4a16的drafter (https://huggingface.co/syvai/Qwen3.8-27B-DFlash2-W4A16),节省2GB VRAM,你可以参考一下。我双卡tp可以飙到220tok/s以上。
周中被老特翻了牌子哈哈哈,所以周六早早爬起来水一篇续写前帖:
给梁圣冲了30块,狠狠地搞了一下dflash2的优化,现在基本差不多满意了,pp变化不大,但是tg比mtp提速了25%左右,还是很爽的。
运行方式和之前一样, pull一下之前的代码:https://github.com/StevenChenSE/sglang/blob/gfx1100-support/README.zh-CN.md
找你最爱的LLM agent harness 重新build一下SGLANG 引擎和kernel,下载对应的dflash2 drafter:
Disclailmer: 标题所说速度是仅仅在极短上下文,特定workload下有效,中等长度prompt (16k-32k)的decode速度大概在90-150tok/s之间。
先秀一下:
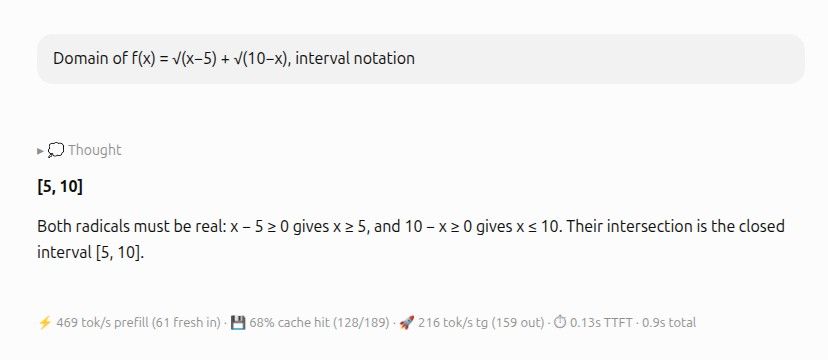
做数学题:(200-220)
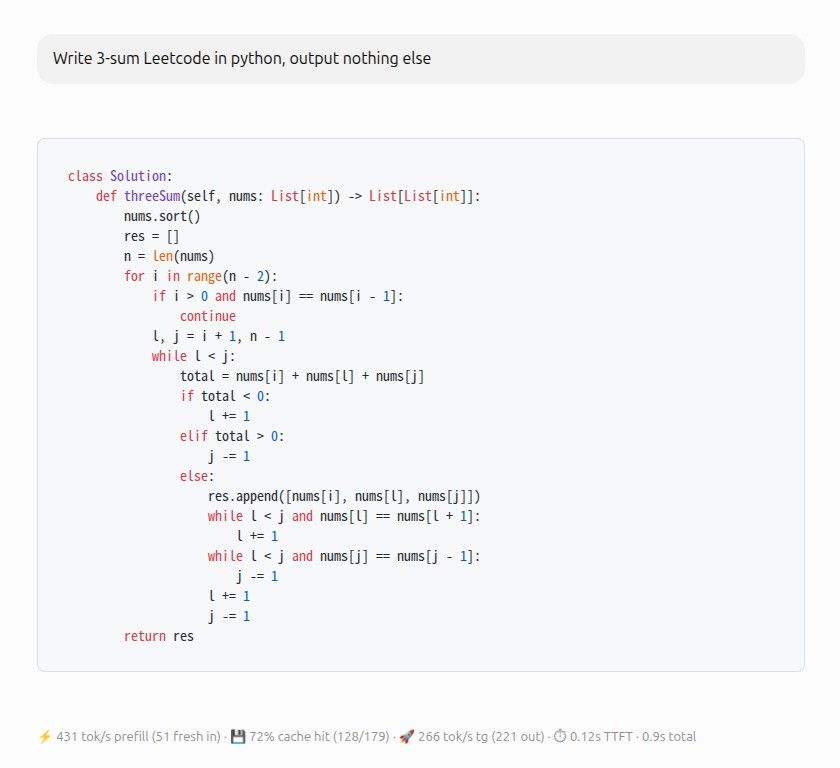
写代码:(180-250tok/s)
普通问答(英文):(90-120 token/s)
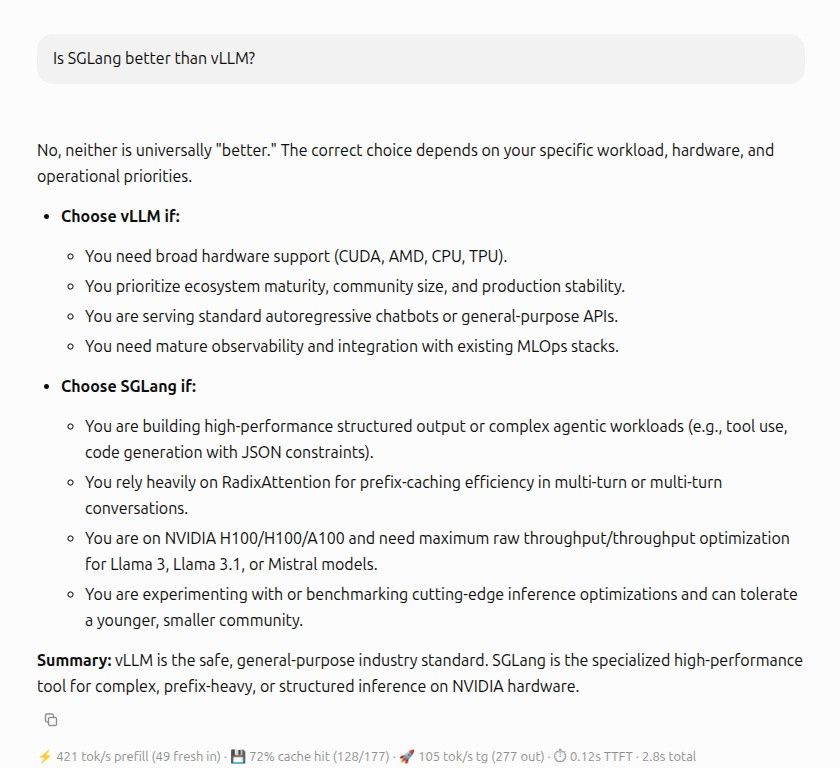
普通问答(中文):(70-90 token/s)
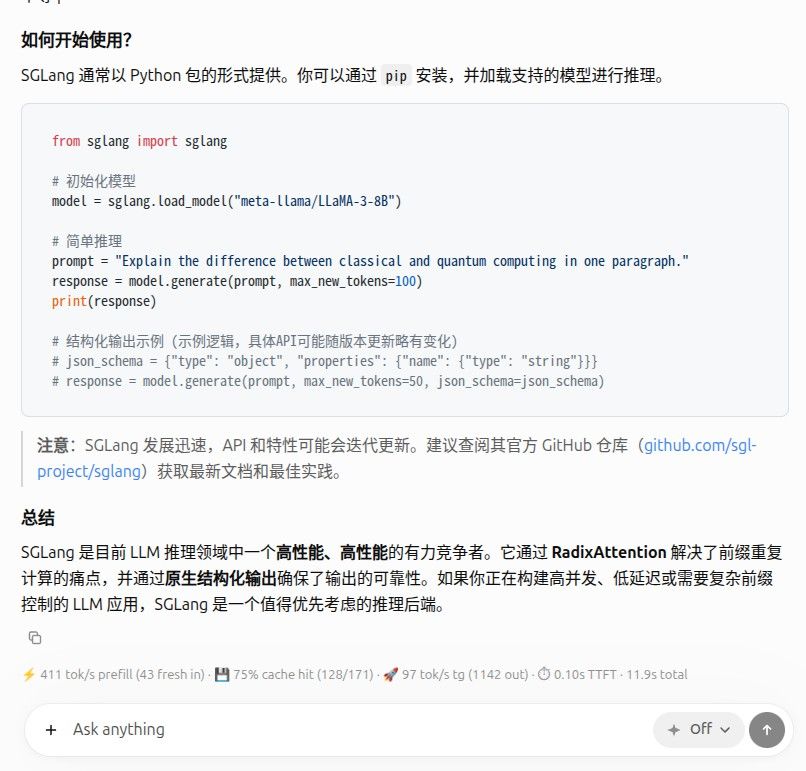
最后贴一下benchmark测试:
全部基准均在双卡 RX 7900 XTX (TP=2) 实机测试,运行 Qwen3.8-27B-W4A16 模型。
SGLang DFlash2 列于 2026-09-11 在当前构建上刷新(65b16b3df7,Prefill 第 1–5 轮
迭代 + 热 L2 Autotune 修复;llama-benchy 0.4.0,--no-cache 全新提示词,
每个深度取 3 次运行均值);数学与 120k 回放为单次运行。MTP-3 列与 c=4 取自
2026-09-09 套件(较早构建)。
vLLM 基线列为早期实测数据,如需精确对比请使用相同工具版本重新压测。
上方 DFlash2 列运行 W4A16 草稿模型(自 2026-09-08 起经 zz-w4a16-draft.conf
systemd drop-in 成为生产默认;KV 容量增至 214,284 tokens)。同日同构建的 bf16
草稿模型对照实测为:数学 181.0 tok/s / 120k 回放均值 119.3 tok/s / 深度均值
114.3 tok/s(池容量 189,172)——全面等于或低于 W4A16 列,故维持 W4A16。
第 5 节保留 2026-09-10 的 W4A16 原始验证记录及其取代的 bf16 列。
llama-benchy)标准 Prompt Prefill ($PP=2048$) 与 Token Generation ($TG=128$), 并发数 = 1
| 上下文深度 | SGLang MTP-3 (本分支) | SGLang DFlash2 (本分支) | vLLM MTP-3 基线 | vLLM DFlash2 基线 |
|---|---|---|---|---|
| Depth 0 | 93.6 tok/s | 128.3 tok/s | 88.6 tok/s | 71.1 tok/s |
| Depth 4,096 | 90.1 tok/s | 136.7 tok/s | 83.3 tok/s | 68.4 tok/s |
| Depth 8,192 | 85.9 tok/s | 112.8 tok/s | 93.3 tok/s | 71.8 tok/s |
| Depth 16,384 | 78.2 tok/s | 108.8 tok/s | 75.9 tok/s | 62.2 tok/s |
| 速度留存率 (16k / 0k) | 83.6% | 84.8% | 85.7% | 87.5% |
MTP-3 对比 vLLM MTP-3:+5.6 / +8.2 / −7.9 / +3.0%(2026-09-09 构建)。DFlash2 于 2026-09-11 刷新:深度 0 绝对速度较 09-09 读数 +19%(128.3 对 107.9),16k 深度 +3.5%(108.8 对 105.1);留存率比值读数偏低仅因深度 0 基线涨幅大于深上下文点位(本机单次采样波动约 ±15 tok/s,4k 点位恰逢波峰)。DFlash2 对比 vLLM DFlash2:+80.5 / +99.9 / +57.1 / +74.9%。
采样自真实 120k 长文本 Agent 对话(332 $\to$ 120,443 tokens),启用 Radix 前缀缓存
| 评估指标 | SGLang MTP-3 (本分支) | SGLang DFlash2 (本分支) | vLLM MTP-3 | vLLM DFlash2 |
|---|---|---|---|---|
| 平均生成速度 (Mean TG) | 89.46 tok/s | 118.7 tok/s | 63.50 tok/s | 67.96 tok/s |
| 中位数速度 (Median TG) | 88.38 tok/s | 112.8 tok/s | 61.52 tok/s | 67.16 tok/s |
| 抖动率 (CV Jitter %) | 11.74% | 23.6% | 45.34% | 36.56% |
| 最差轮次保底速度 | 72.88 tok/s | 56.9 tok/s | 16.94 tok/s | 32.94 tok/s |
MTP-3:较 vLLM MTP-3 平均提速 +40.9%、平稳度 3.9 倍、保底速度 4.3 倍(2026-09-09 构建)。DFlash2 于 2026-09-11 刷新:较 vLLM DFlash2 平均提速 +74.7%(118.7 对 67.96),平稳度 1.5 倍,保底速度较 09-09 读数 40.6 提升 40% 至 56.9。注意事项:最后一轮 120k 的前缀缓存命中降至 32%(09-09 启动约 93%),导致该轮 TTFT 膨胀至约 91 秒(TG 仍保持 56.9 tok/s)——当前显存池布局下 120k 前缀树驻留比例下降。
Greedy 贪婪采样,temperature = 0.0,max_tokens = 1024
| 数据集用例 | 生成 Token 数量 | 首字延迟 (TTFT) | Prefill 速度 | 生成速度 (TG) | 准确率 |
|---|---|---|---|---|---|
| GSM8K #1 | 48 | 0.128s | 701.6 tok/s | 97.3 tok/s | 100% 正确 |
| GSM8K #2 | 196 | 0.139s | 814.8 tok/s | 115.5 tok/s | 100% 正确 |
| MATH-500 #1 | 201 | 0.137s | 605.5 tok/s | 120.8 tok/s | 100% 正确 |
| MATH-500 #2 | 212 | 0.128s | 568.2 tok/s | 110.9 tok/s | 100% 正确 |
| 综合平均 | — | 0.133s | 672.5 tok/s | 113.9 tok/s | 100% 正确 |
SGLang DFlash2(同一测试套件,2026-09-11 刷新):
| 数据集用例 | 生成 Token 数量 | 首字延迟 (TTFT) | Prefill 速度 | 生成速度 (TG) | 准确率 |
|---|---|---|---|---|---|
| GSM8K #1 | 63 | 0.134s | 1510.5 tok/s | 144.2 tok/s | ✗(答 96,正确为 72) |
| GSM8K #2 | 200 | 0.144s | 1567.5 tok/s | 208.9 tok/s | ✓ |
| MATH-500 #1 | 195 | 0.133s | 1475.7 tok/s | 224.0 tok/s | ✓ |
| MATH-500 #2 | 182 | 0.131s | 1414.7 tok/s | 195.6 tok/s | ✓ |
| 综合平均 | — | 0.136s | 1492.1 tok/s | 193.2 tok/s | 75%(3/4) |
DFlash2 数学生成速度较 09-09 读数快约 70%(193.2 对 166.0 tok/s;两次套件运行复现
193.15 / 193.62),TTFT 在更长提示词下保持平稳,但 GSM8K #1 在贪婪采样下仍会失误
(答 96,正确 72)——这是其窗口式草稿路径在量化稠密 GEMM 上的已知权衡;MTP-3 四题全对。
使用 llama-benchy 进行多并发请求压测 ($PP=2048, TG=128$, Depth 0)
| 推理服务引擎 | 并发数 | Prefill 总吞吐 (PP) | 生成总吞吐 (TG) | 峰值生成吞吐 | 运行稳定性与说明 |
|---|---|---|---|---|---|
| SGLang MTP-3 (本分支) | c = 4 | 1,357.4 tok/s | 78.5 tok/s | 118.0 tok/s | 100% 稳定运行,Decode CUDA 图与 MTP-3 正常工作 |
| SGLang DFlash2 (本分支) | c = 4 | 1,275.5 tok/s | 92.1 tok/s | 146.0 tok/s | 100% 稳定运行,单次采样 |
| vLLM Baseline (无投机) | c = 4 | 1,891.1 tok/s | 83.1 tok/s | 180.0 tok/s | 原生稳定,但解码速度较低 |
| vLLM DFlash2 | c = 4 | 1,693.2 tok/s | 75.9 tok/s | 188.0 tok/s | 投机开销导致多并发总 TG 吞吐反而低于 Baseline |
| llama.cpp (MTP) | c = 4 | 636.3 tok/s | 50.1 tok/s | — | 受限于插槽并发队列瓶颈 (-np 2) |
多并发核心结论:SGLang 两套推测解码在 RDNA3 上 4 并发均保持 100% 稳定——无非法显存访问、无图捕获失败(vLLM 原生 MTP-3 在 batch > 1 时仍会崩溃)。DFlash2 以 92.1 tok/s 总生成吞吐领先(较 vLLM 无投机基线 +10.8%,较 vLLM DFlash2 +21.3%),峰值 146 tok/s;MTP-3 为 78.5 tok/s。vLLM 基线列为旧版
llama-benchy实测,引用精确跨引擎对比前请用 0.4.0 重新压测基线。
syvai/Qwen3.8-27B-DFlash2-W4A16,融合 KV)2026-09-10,同一硬件与 llama-benchy 0.4.0。深度曲线与 120k 回放在无外部流量的
隔离端口实测;数学、c=4、深上下文与多模态取自 2026-09-09 套件(顺序 KV 路径——
准确率与该路径无关,融合 KV 仅影响草稿上下文 KV 构建)。
深度曲线(PP=2048/TG=128,c=1;两次运行取平均,16k 为三次采样均值):
| 指标 | bf16 草稿模型(2026-09-09) | W4A16 草稿模型(融合 KV) |
|---|---|---|
| Depth 0 | 107.9 tok/s | 118.9 tok/s |
| Depth 4,096 | 96.8 tok/s | 98.9 tok/s |
| Depth 8,192 | 97.7 tok/s | 95.9 tok/s |
| Depth 16,384 | 105.1 tok/s | 98.0 tok/s |
| 速度留存率 (16k / 0k) | 97.4% | 82.4% |
本机单次采样 TG 波动约 ±15 tok/s(深度 0 的背靠背采样分别读得 101.7 与 136.1),解读单点数据时请保留该误差量级。在同一隔离端口关闭融合 KV 后,16k 均值降至 88.1 tok/s——融合 KV 在深度场景带来约 +11% 收益,并将与 bf16 草稿模型的 16k 留存率差距基本抹平。
120k Agentic 会话回放(两次运行,融合 KV):平均 88.6 tok/s、中位数
82.8 tok/s、CV 25.3%、最差轮次 52.5 tok/s——2026-09-09 的 bf16 草稿
模型为 83.8 / 79.8 / 23.0% / 40.6;2026-09-11 单次复测中 bf16 / W4A16 的均值
分别为 119.3 / 125.5 tok/s。平均速度持平或略优。
数学思维链(greedy,单次运行):3/4 正确——与 bf16 草稿模型出现 相同的
GSM8K #1 失误(答 96,正确 72),量化草稿模型未带来额外精度损失。平均 TG
148.9 tok/s(63 token 的 GSM8K #1 短答案拉低均值至 54.0 tok/s;其余三题
为 155–200 tok/s)。
深上下文扩展(单次运行,10k→160k TG):78.4 / 117.3 / 90.4 / 86.1 / 60.1 /
39.0 tok/s——约 80k 之后 TG 开始衰减,与该窗口式草稿家族的长上下文行为一致。
c=4 多并发: 总 TG 89.3 tok/s、峰值 121 tok/s、PP 1,266 tok/s、
100% 稳定(bf16 草稿模型:92.1 / 146.0 / 1,275.5)。
多模态矩阵: 单图 / 多图与多轮交错工作负载均无循环 / 格式缺陷。
