
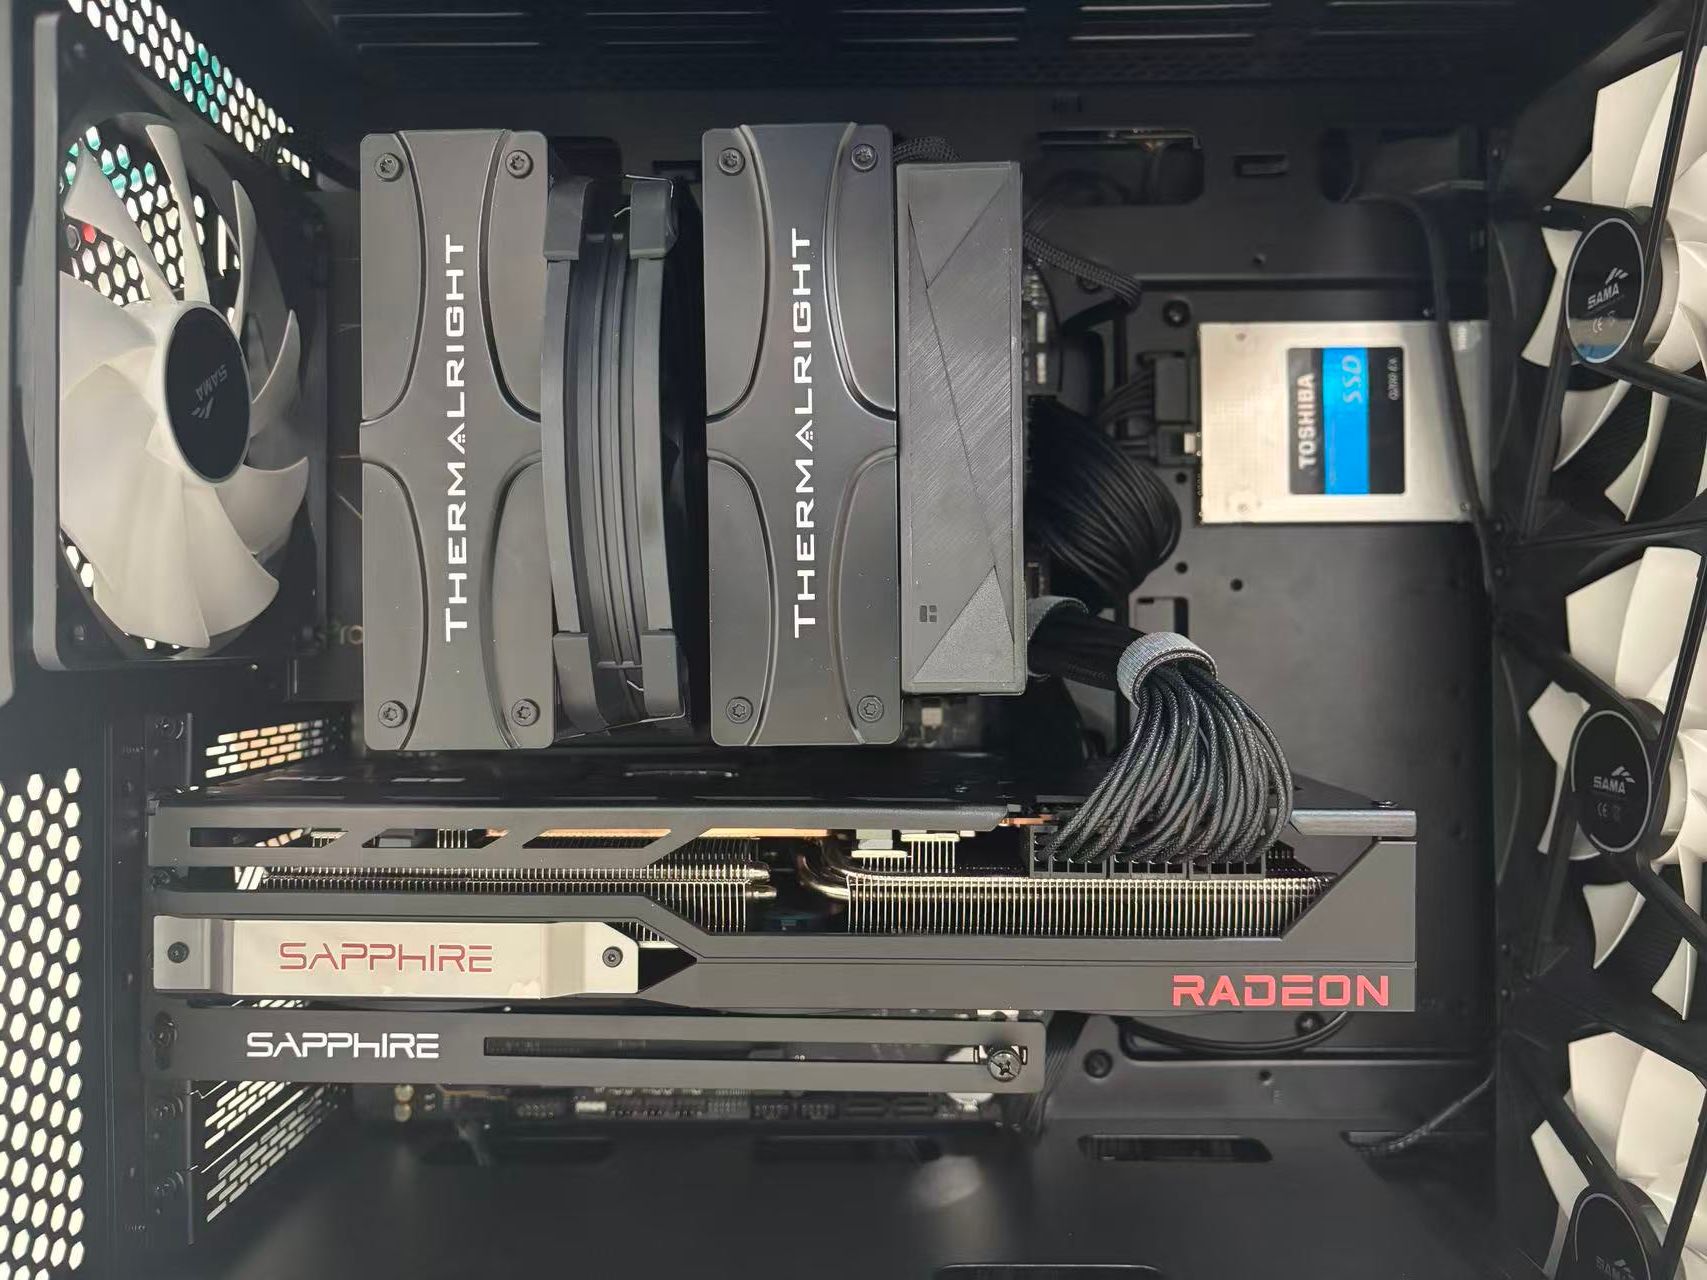
机箱内部照片.
G
Goitex
@Goitex
-
咨询装机:Pro WS X570-ACE+AMD Ryzen 9 5700X+ RX 7900XTX 白金 -
差生文具好,菜鸟欢乐多。 -
咨询装机:Pro WS X570-ACE+AMD Ryzen 9 5700X+ RX 7900XTX 白金最后还是上AM5平台,价格供参考
CPU AMD Ryzen 7 9700X 1370元
主板 ProArt B850-Creator WIFI NEO 2399元
散热 FC140 BLACK C12C-X28-V2 348元
内存 Lexar THOR 雷神二代DDR5 6000 32G x2 6000MT/s: CL40- 48- 48- 96 / 1.35V 4999元
硬盘 致态(ZhiTai)TiPlus9100 2TB NVMe M.2 1996元
电源 蓝宝石 1200W 金牌
显卡 AMD RADEON RX 7900XTX 白金 8699(显卡+电源组合)
机箱 先马(SAMA)黑洞X 376
共计 20187 -
R7900XTX+Vulkan + MTP,部署Qwen3.8 27B 测试速度是否正常,请大神赐教两个疑问,请大神赐教
1.从Qwen 3.6 27b部署,改为Qwen 3.8 27b,生成tokens速度下降23%
測試題目 3.6 decode / 接受率 3.8 decode / 接受率 变化
中文散文 72.3 t/s / 68.3% 55.8 t/s / 41.2% -23% / -27pp
C++ 程式碼 81.3 t/s / 83.5% 70.3 t/s / 66.2% -14% / -17pp
工具調用 72.3 t/s / 72.7% 78.8 t/s / 82.0% +9% / +9pp
純 JSON 82.8 t/s / 85.8% 79.9 t/s / 81.8% ≈ 持平
2.接入Hermes, 会话布置任务到响应需要几分钟 大概4分50秒,响应速度一言难尽,体验太差。
测试如下速度是否正常,请大神赐教。装机配置
CPU AMD Ryzen 7 9700X
主板 ProArt B850-Creator WIFI NEO
散热 FC140 BLACK C12C-X28-V2
内存 雷克沙Lexar雷神之刃二代 DDR5 6000 32G x2
硬盘 致态(ZhiTai)TiPlus7100 2TB NVMe M.2
显卡 AMD RADEON RX 7900XTX 白金
电源 蓝宝石 1200W 金牌
机箱 先马(SAMA)黑洞X
Qwen 3.8 27b Dense本地模型,后端Vulkan + MTPt600(10.0.0.62)硬件 + Qwen3.8-27B 配置 + 实测基准
一、硬件配置
部件 规格
CPU AMD Ryzen 7 9700X(8 核 16 线程,Zen5)
GPU AMD Radeon RX 7900 XTX 24G(Navi 31,PCIe 4.0 x16 满速)+ Granite Ridge 核显
内存 58G DDR5(当前用 28G / 可用 29G,swap 0 使用)
系统盘 NVMe 95.4G(用 11%)
数据盘 致钛 TiPlus9100 2TB NVMe(/data,用 2%)
系统 Ubuntu 26.04.1 LTS,内核 7.0.0-31-generic
GPU 驱动栈 ROCm 7.1.1(已装)+ Mesa 26.0.8 Vulkan(实际推理走 Vulkan 后端)
网络 1GbE(eno1 在线)+ 10GbE(enp7s0 在线)
存储 NAS 9 个 SMB 共享全部挂载(23T 可用)
二、Qwen3.8-27B 环境 + 启动参数
服务:llama-qwen.service(systemd,enabled,Restart=on-failure),9/15 12:10 启动,模型加载仅 6 秒,单 slot(-np 1,请求串行)。模型文件:/data/models/Qwen3.8-27B-UD-Q4_K_M.gguf(16G,Q4_K_M 量化)
完整启动命令(来自 systemctl cat llama-qwen):
llama-server -m /data/models/Qwen3.8-27B-UD-Q4_K_M.gguf
-ngl 999 # 全部 999 层 offload 到 GPU
--device Vulkan1 # Vulkan 后端
-c 131072 # 上下文 128K
--spec-type draft-mtp # MTP 推测解码
--spec-draft-n-max 2 # 每步最多 2 个草稿 token
-ctk q4_0 -ctv q4_0 # KV cache 量化 q4_0(省显存)
-fa auto # Flash Attention 自动
-b 512 -ub 512 # batch / ubatch = 512
-np 1 # 单并发 slot
--reasoning-budget 1024 # 思维链预算 1024 token
--host 0.0.0.0 --port 8080 --alias qwen3.8-27b
线程池:n_threads = 8(= 物理核数,正确)
槽位:n_slots=1, n_ctx_slot=131072, kv_unified=false
推理保留(reasoning-preserve)默认开启
 ️ 日志里有个提示:CORS=* 且无 API key,监听 0.0.0.0:8080——局域网内任何设备可直接调用,介意的话可加 --api-key
三、实测基准(2 轮,带 warmup,prefill 用 nonce 防 KV 前缀缓存污染)
指标 结果 说明
TTFT(短 prompt 60tok) 94 / 100 / 101 ms 首 token 延迟,非常低
TTFT(88tok,长生成场景) 200–418 ms 含 thinking 首 token
Prefill @ ~488 tok 574 / 569 t/s(850ms) 冷 prefill
Prefill @ ~1320 tok 705 / 688 t/s(1.9s) 越长越快(batched prefill 正常现象)
Prefill(缓存命中,参考) ~10,000 t/s 同前缀 KV 缓存命中,不代表冷启动
Decode(512tok 长生成) 63.0 / 54.7 t/s(8.6s / 9.6s) 含 reasoning token 的完整生成速度
Decode(短生成,参考) 60–74 t/s 32–128 token 段
生成吞吐(综合) ≈ 55–65 t/s MTP 推测解码开启状态下的稳定区间
GPU 状态 edge 50–52°C,idle 12–14W 基准期间负载轻,温度余量充足
解读:TTFT ~100ms(短 prompt):对 27B 模型来说极快,本地推理体验接近云端小模型
Prefill ~570–700 t/s:128K 上下文 + KV q4_0 量化下,几千 token 的文档几秒内读完
Decode ~60 t/s:比之前 4 题测试的 52–82 t/s 区间一致;-np 1 单 slot 意味着多用户并发会排队,单用户延迟最优
MTP(--spec-draft-n-max 2)是当前 60+ t/s 的关键贡献——之前 3.8 测试里 74 t/s 的 C++ 题就是吃到了推测解码红利
结论:这台机器跑 27B Q4 的推理配置已经调得很到位(全层 GPU、Flash Attention、KV 量化、MTP 推测解码、128K 上下文),实测参数健康,没有明显瓶颈。 -
0704 => 0908 二手內存上漲 37%DDR4 二手内存又被炒起来了.
在小黄鱼掏了掏一两天,尔虞我诈,几番折磨.
怒骂过后一狠心,上淘宝买新DDR5,肉疼. -
咨询装机:Pro WS X570-ACE+AMD Ryzen 9 5700X+ RX 7900XTX 白金 -
咨询装机:Pro WS X570-ACE+AMD Ryzen 9 5700X+ RX 7900XTX 白金学习千问3.8 2.7B 稠密部署和轻度ComfyUI,请帮手给出意见和建议.
CPU AMD Ryzen 7 5700X 875元
主板 Pro WS X570-ACE 1880元
散热 利民(thermalright)Assassin X 120 Refined SE 70
内存 DDR4 3200 16G x4 2080元
硬盘 致态(ZhiTai)TiPlus7100 1TB NVMe M.2 1278元
电源 蓝宝石 1200W 金牌+显卡 AMD RADEON RX 7900XTX 白金 8699元
机箱 先马(SAMA)黑洞X 376元
共计 15258元
后续,资金充裕后,再上AMD R9 5900X+双卡部署. -
我替大家趟趟路 T7910楼主加油,等待抄作业
-
已经买了个7900xtx,怎么去华南金牌选x99型号,抄个作业,论坛没搜索功能
