(0) 前言
最近本地AI的流行,让小弟我在这几个月也成为论坛潜水中的一员。看到大家使用各种大VRAM显卡跑得风生水起,很是羡慕
刚好最近Strata架构让小VRAM GPU也能重获新生, 我手边也有额外的游戏显卡能玩玩LLM
顺便浮出水面一下,让有类似硬件的坛友能参考这个配置下能跑出甚么速度
文章中的 Tuning 流程是我和 codex 讨论了很久后设计的,大部分操作也是由 codex gpt 6.1 sol 通过 SSH 连接 Linux 自动执行的
但这是我第一次调优LLM,我也不算懂行,所以如果想让 Agent 按照文中的 Tuning 流程设置,请先判断是否适合自己的机器
本文目标放在IQ_S量化版本,128K上下文,除了在优化这个配置外,也额外延伸了几个探讨议题
(1) 3080副卡有用吗?对prefill或decode速度加成多少?
(2) 可以把功耗限制设到多低,并得到跟原本差不多的速度?
(3) 不同量化版本,上下文,VRAM和RAM的使用量是多少?
每个人的情况可能不同,以我的情况来说,可以直接跳到第 (8) 节看看我的总结
另外特别感谢前人发过的30, 40系列跑Strata的文章,因为有你们我才有勇气来搞这个项目跟添置一些硬件零件
另外,我原先是使用繁体,考虑到论坛里的大陆坛友比较多,请AI帮忙把文章转成了简体,并调整为大陆常用的表达。如果还有不太自然的地方,还请见谅。
(1) 环境介绍
硬件配置大多是由我现有游戏机零件组成,补了32gb的DDR4, 以及从我老婆那儿“抢”来了她的4070当主推理引擎:
| 硬件 | 型号/规格 |
|---|---|
| CPU | Intel Core i7-13700K |
| 主板 | MSI MAG Z690 TOMAHAWK WIFI DDR4 |
| 内存 | DDR4 16GB*4=64GB 3200MHz |
| 显卡1 | ASUS TUF RTX 4070,12GB显存 |
| 显卡2 | EVGA RTX 3080 XC3,10GB显存 |
| 电源 | 1200W |
4070位于CPU直连的PCIe 5.0 x16插槽 (实际只有4.0),3080使用PCIe 3.0 x4连接。 后续调优以这个硬件固定为前提。
这台主机的CPU、内存、显存与存储资源都专用于LLM后端。计划通过局域网内的其他设备使用 Web Chat 或 agent,让64GB内存和两张显卡的资源尽量留给模型
本文的调优决策与命令发送也在另一台电脑使用codex ssh完成。
软件环境如下:
| 项目 | 版本/配置 |
|---|---|
| 操作系统 | Ubuntu 24.04 LTS,原生Linux |
| NVIDIA驱动 | 595.91.07 |
| Strata推理引擎 | 0.1.41 |
调优过程都沿用固定的Strata版本,测试期间不更新框架,以免版本变动影响比较。
Strata近几版有针对Multi GPU提速,有跑多卡的坛友们记得赶快去更新一下
(2) 目标模型和上下文窗口
实测前的主要目标如下:
| 目标模型 | 上下文窗口 | Vision |
|---|---|---|
| Qwen3.8-Flash-Next IQ3_S | 128K | ON |
先以这个组合作为起点,完成单卡、双卡与参数调优,确认速度和64GB内存是否足以支撑使用需求。
后续测试方向依速度与内存余量调整:
- 若IQ3_S速度太慢,或内存余量不足,就往IQ3_XXS测试,确认换量化后能否改善速度与内存占用。
- 若速度与内存仍有余量,就往256K上下文窗口测试,确认更长文本输入是否能稳定完成,以及Prefill、Decode和功耗的变化。
结果先剧透了,IQ3_S能顺利开启256K上下文 + Vision,而且速度还不错
AI线:以下文章内容的测试流程与结果整理由AI产生。不太习惯AI文风的坛友,可以先跳到 (8) 结论。
(3) Benchmark方法
速度测试都是统一使用 Strata repository 收录的 community benchmark harness(bench/results/2026-09-30-community-rtx-5090/benchmark.py),由另一台电脑通过 SSH 发送命令,在 Linux 主机上调用本机 Strata API。整个测试串行执行,一次一个请求。
输入使用 harness 的合成 Python 程序文本,固定模型、量化与输入内容,设置 temperature=0、reasoning_effort=none、流式输出,并固定生成 256 tokens。每轮记录 prefill、decode、TTFT 与总耗时,同时保存设置、原始 request/response、引擎 log,以及 GPU 和主机资源记录。
以下表格的Prefill、Decode单位均为tok/s,TTFT单位为秒。
研究流程分成几个阶段:
- 建立单卡、双卡基准:各测 4096、32768、128000 个输入 tokens,每个长度跑三次取中位数。先留下未校准起点,再比较加卡后的变化。
- 搜索设置与功耗区间:后续每个候选跑一次相同的 128000-token 测试,逐阶段比较分层、trim、prefill、校准与 power limit。官方 calibration 有自己的内部测试流程,完成后再用这份长文本输入验证。
- 验证最终配置:选定 K38 calibrated、双卡各150W后,再测32768、65536、128000个输入 tokens,各一次,确认不同长度下的速度与能耗。
- 测试其他配置:沿用同一套测法和特殊config,另列模型与上下文矩阵, 测试其他配置下的速度和功耗
每个测试配置先确认模型 ready,再预热;预热不列入成绩。正式请求核对实际输入与输出 token 数,并确认reused=0。功耗扫描与最终验证每个条件都使用新启动的 backend,避免前一轮的 prompt cache 影响比较。
(4) 单卡 v.s. 双卡,加入3080是否必要
先留下未校准的单 4070 起点,再加入 3080,重新让 setup 配置双卡。初始比较维持两卡各自 80% 的功耗上限:4070 为 160W,双卡时另加 3080 的 272W。
| 输入长度 | 单4070 Prefill | 双卡 Prefill | 单4070 Decode | 双卡 Decode |
|---|---|---|---|---|
| 4096 | 900 | 848 | 27.75 | 35.17 |
| 32768 | 1187 | 1511 | 28.10 | 35.98 |
| 128000 | 1205 | 1691 | 27.36 | 35.63 |
在 128K,加入 3080 后,读取约快四成,生成约快三成;TTFT从 106.3 秒降到 75.8 秒。但 4K 的读取反而略慢。
实测结论是:单 4070 可以跑;如果已经有 3080,又常读取长文档或希望答案生成快一点,值得一起用。
(5) Fine tune出最佳性能
这里的 Fine tune 是推理设置调优,没有重新训练模型权重。调优流程是先找分工,再调显存使用方式,最后校准;每一步都拿同一份长文本输入验证。
每次进入下一阶段,都先保存上一阶段的设置,让新候选有明确对照,也能退回已验证的起点。没有改善的实验仍留下记录,避免下次又重走一次。这次最有用的经验,是先把「这轮要回答什么」缩小:分层时比较分工,校准时验证整组参数,降功耗时固定模型设置。这样结果才能累积成一套日常可用的配置。
先分层,再把显存空间用好
K 是两卡的分层位置。模型有48层,K38代表4070跑前38层、3080跑后10层。不是把模型裁成38层,也不是K越大越快;分法会影响计算负担、缓存与读取缓冲空间。
接着开启 STRATA_STAGE_TRIM=1:每张卡只载入自己负责层的 dense weights,省下显存给 expert cache,完整模型仍由两张卡执行。trim on 下共测了九个K,当时K38读取较快、K36生成较快,先保留两个候选。
固定K36后,再测读取分块大小。prefill auto 实际选到8192,约1985 tok/s;改成1024、2048、4096,约剩371、697、1234 tok/s,生成却仍在45左右。因此保留auto。pipeline虽确实启用,这轮没有收益;split-own auto没有真正启用,也不把它当成有效加速结果。
校准之后,再回到长文本输入验证
对K36、K38各自跑官方 calibration,找CPU/GPU expert分流、MTP草稿门槛与缓存更新设置,再各跑一次128K。
| 候选 | 校准前 Prefill | 校准后 Prefill | 校准前 Decode | 校准后 Decode |
|---|---|---|---|---|
| K36+trim on | 1985 | 1985 | 45.11 | 57.63 |
| K38+trim on | 2280 | 2275 | 42.24 | 58.86 |
K38的生成约快39%,读取几乎不变。校准后K38读取比K36快约15%,生成只领先约2%;两组都只验证一次,最后选K38作为本轮基准,不宣称它一定稳定胜出。
这一步也改变了原先的候选排序。未校准时,K36比较适合重视生成速度的方向;校准后,K38在这次长文本输入验证两项都领先。因此,不把某一步的第一名当成永久答案:先留下候选,等后续设置完成,再用同样的工作负载回查。校准同时改了多个参数,这轮也没有把它们逐项拆开测,不能指定是哪一个参数带来全部提升。
| 本轮采用设置 | 值与用途 |
|---|---|
GPU顺序/layer_split |
4070 → 3080/38 |
STRATA_STAGE_TRIM/--expert-cache |
1/auto,保留空间给专家缓存 |
--prefill |
auto,本轮实际8192 |
| CPU workers | 预设15,校准后保留 |
--pcie-frac |
0.2,未缓存experts送GPU的分流比例 |
--spec/--spec-min-p |
4/0.7,MTP草稿深度与门槛 |
--adapt-every/--adapt-swaps/--adapt-decay |
1/160/0.97,自适应缓存更新设置 |
--kv/--max-context |
int8/131072 |
| Vision | 开启,放4070 |
从单卡约27到调好双卡约59 tok/s,是加卡、分层、trim与校准的合并成果。单4070起点没有校准,不能把整个倍增都算在3080身上。
(6) 一半的瓦数,99%的性能
先说清楚:这里「一半的瓦数」指功耗上限,不是实际耗电或电费减半;「性能」指这份工作负载的推理速度。
速度调好后,先恢复4070/3080上限为200/340W,再只降低3080,找速度开始掉落的位置。
| 3080上限(4070固定200W) | Prefill | Decode | 两GPU每次请求能耗 |
|---|---|---|---|
| 340W | 2335 | 58.94 | 5.399Wh |
| 170W | 2322 | 58.94 | 5.063Wh |
| 136W | 2305 | 58.60 | 4.901Wh |
| 100W | 1744 | 54.51 | 5.187Wh |
3080上限340→170W,读取保留99.44%、生成约99.99%。 这就是章名最直接的例子。不过3080实测平均功耗是159.7→137.7W,两GPU请求能耗只少约6.2%;原本就没有一直吃到340W。
降到100W时,读取明显拖慢,整笔请求跑更久,能耗反而比136W高。接着固定3080为150W,测4070的200→100W:100W仍保留约99.6%生成速度,但读取只剩约66.8%,请求能耗反而增加约6.2%。只看生成tok/s,会漏掉读取长文档的成本。
4070粗测的均衡候选落在160W附近,最后选两卡各150W,再验证不同输入长度:
| 输入tokens | Prefill | Decode | TTFT | 两GPU每次请求能耗 |
|---|---|---|---|---|
| 32768 | 1797 | 58.95 | 18.3秒 | 1.458Wh |
| 65536 | 2138 | 58.61 | 30.7秒 | 2.468Wh |
| 128000 | 2259 | 58.76 | 56.7秒 | 4.514Wh |
最终上限合计300W,是原本540W的约56%,接近一半。相对同一轮K38校准、双卡额定上限基准,128K 生成保留约99.7%、读取约96.7%,GPU请求能耗少约16.4%。这不是最低能耗记录,是本轮选定并验证的折中。
换成等待时间看,这份128K的TTFT约从54.9秒变成56.7秒,生成速度几乎维持。这份配置用少量额外读取时间,交换较低的GPU能耗。不过若工作每天都在重新读大文件,或回答特别长,取舍可能不同;应先比较整笔请求的耗时与能耗,再决定是否继续降瓦数。
功耗每200ms取样,但来源是约1秒平均的GPU板卡读值,再积分估算请求能耗;不含CPU、电源损耗、载入与待机。各条件只测一次,小差距可能含量测与热状态影响,读成「速度接近、能耗有下降」比较合适。
(7) 不同量化模型、上下文的比较
固定 K38、trim on、prefill auto、KV int8、Vision与MTP开启,双卡各150W,版本也保持不变。这次不重新搜索K或功耗,而是比较原版IQ3_S、IQ3_XXS在64K/128K/256K的表现,另外加入一组Abliterated IQ3_S/128K,共七组配置。
以下一次列出七组正式配置的21笔请求结果。
| 配置 | Prompt | Prefill tok/s | Decode tok/s | TTFT s | 总GPU平均 W | 总GPU峰值 |
|---|---|---|---|---|---|---|
| Org-IQ3_S-128k | 4096 | 716.77 | 56.33 | 5.74 | 201.17 | 236.30 |
| Org-IQ3_S-128k | 32768 | 1801.73 | 62.00 | 18.23 | 240.33 | 289.25 |
| Org-IQ3_S-128k | 128000 | 2247.54 | 60.49 | 57.04 | 267.66 | 291.93 |
| Org-IQ3_S-256k | 4096 | 684.19 | 55.13 | 6.01 | 194.67 | 230.58 |
| Org-IQ3_S-256k | 32768 | 1597.74 | 59.17 | 20.55 | 240.48 | 282.44 |
| Org-IQ3_S-256k | 256000 | 1939.30 | 56.43 | 132.13 | 271.46 | 289.93 |
| Org-IQ3_S-64k | 4096 | 733.80 | 58.48 | 5.61 | 201.99 | 243.13 |
| Org-IQ3_S-64k | 32768 | 1843.84 | 67.85 | 17.81 | 241.82 | 290.54 |
| Org-IQ3_S-64k | 64000 | 2117.42 | 70.34 | 30.28 | 257.54 | 290.72 |
| Org-IQ3_XXS-128k | 4096 | 836.29 | 65.25 | 4.92 | 205.41 | 246.62 |
| Org-IQ3_XXS-128k | 32768 | 1994.47 | 78.96 | 16.47 | 248.76 | 294.68 |
| Org-IQ3_XXS-128k | 128000 | 2337.60 | 75.21 | 54.83 | 269.86 | 297.26 |
| Org-IQ3_XXS-256k | 4096 | 796.61 | 62.88 | 5.17 | 203.53 | 236.79 |
| Org-IQ3_XXS-256k | 32768 | 1827.40 | 68.88 | 17.97 | 246.08 | 292.90 |
| Org-IQ3_XXS-256k | 256000 | 2222.27 | 57.58 | 115.35 | 276.36 | 296.49 |
| Org-IQ3_XXS-64k | 4096 | 854.72 | 74.01 | 4.81 | 207.90 | 262.84 |
| Org-IQ3_XXS-64k | 32768 | 2018.33 | 80.11 | 16.27 | 249.84 | 294.12 |
| Org-IQ3_XXS-64k | 64000 | 2259.45 | 79.14 | 28.39 | 262.34 | 296.18 |
| Abliterated-IQ3_S-128k | 4096 | 715.66 | 58.98 | 5.75 | 199.52 | 238.20 |
| Abliterated-IQ3_S-128k | 32768 | 1796.52 | 59.18 | 18.29 | 240.19 | 293.60 |
| Abliterated-IQ3_S-128k | 128000 | 2205.69 | 61.72 | 58.11 | 267.63 | 293.37 |
(Abliterated是我个人额外加测,因为之后可能有无审查模型的需求)
IQ3_S沿用Part 1最终设置;IQ3_XXS切换对应模型资产后,先测继承设置,再跑官方calibration与长文本输入验证,最后让三种上下文共用这份校准基准,不逐窗口重新调优。
IQ3_XXS正式比较采用验证后的设置:pcie-frac 0.2、spec 4、spec-min-p 0.7、adaptive 1/160/0.97;CPU workers由引擎自动配置。跨量化比较的是各自的已验证配置,不把结果归因于单一参数。
每组都测共同的4096、32768个输入tokens,再依窗口测64000、128000或256000。总context上限分别是 65536、131072、262144,保留模板与256-token输出的空间。每个长度一次,预热排除,正式请求均确认 reused=0;七组共21笔正式请求全部完成。
长文本输入:128K收益明显,256K主要改善读取
下面每个窗口使用不同的长文本输入,应比较相同窗口与输入长度的两种量化;不能把64K与256K的等待时间当成相同工作量的速度对照。
| 模型 | Context/实际输入 | Prefill | Decode | TTFT | 总GPU平均 W | 总GPU峰值 W |
|---|---|---|---|---|---|---|
| IQ3_S | 64K/64000 | 2117 | 70.34 | 30.3秒 | 257.5 | 290.7 |
| IQ3_XXS | 64K/64000 | 2259 | 79.14 | 28.4秒 | 262.3 | 296.2 |
| IQ3_S | 128K/128000 | 2248 | 60.49 | 57.0秒 | 267.7 | 291.9 |
| IQ3_XXS | 128K/128000 | 2338 | 75.21 | 54.8秒 | 269.9 | 297.3 |
| IQ3_S | 256K/256000 | 1939 | 56.43 | 132.1秒 | 271.5 | 289.9 |
| IQ3_XXS | 256K/256000 | 2222 | 57.58 | 115.3秒 | 276.4 | 296.5 |
| Abliterated IQ3_S | 128K/128000 | 2206 | 61.72 | 58.1秒 | 267.6 | 293.4 |
128K长文本输入下,IQ3_XXS生成约快24%,读取约快4%;到了256K,生成差距只剩约2%,较有感的是TTFT少约17秒。换量化的收益会随负载改变,不能把某一组的提升比例套用到所有情境。
资源记录也显示,128K配置的最低可用系统内存,IQ3_S约7.5GiB、IQ3_XXS约14.5GiB。对这台64GB主机,XXS留下较多内存余量。不过这轮没有做回答品质评测,速度与可用内存的优势,不等于已证明两种量化的回答品质相同。
Abliterated版本:速度接近原版
Abliterated组沿用相同IQ3_S权重与pack,只加入projection vector:strength 1.0、layer range 4–44、mode project、direction per-layer,每笔正式请求都核对projection已启用。
128K长文本输入下,原版/Abliterated的读取为2248/2206 tok/s,生成60.49/61.72 tok/s,TTFT57.0/58.1秒。共同32K输入的生成则为62.00/59.18 tok/s,没有一致的速度胜出方向;这轮可说速度接近,未测拒答行为或回答品质。
双卡功耗也没有因换成XXS而大幅下降:128K请求平均合计约268W/270W,256K约271W/276W(IQ3_S/XXS)。XXS的收益主要表现在完成速度;这些是GPU板卡功耗,并非整机用电。
本轮选择方向是:速度优先可考虑IQ3_XXS;窗口依实际需求选,32K输入测试以64K配置较快,需要更长内容再开128K或256K。 IQ3_S与Abliterated则按模型需求选择。所有配置各长度只有一次结果,小幅差异仍需重测确认;这次已建立可用的速度与资源对照,品质比较留待另行评测。
AI结束线:以下内容开始是人类写的了
(8) 我的小总结
(1) 这套4070+3080、64GB内存的配置,可以达成IQ3_S/128K的目标,速度Prefill: 2248 tok/s, Decode: 60.49 tok/s。
(2) IQ3_XXS 128K上下文的速度下,Prompt为128k,速度也还可以 Prefill: 2338 tok/s, Decode: 75.21 tok/s
(3) 虽说单4070能跑,但有副卡值得试试。初始128K Decode约从27提升到36 tok/s,但我没有测过单卡直接调优。
(4) 功耗限制可以调得很低也保留同样速度 (4070 200->150W, 3080 340W->150W),噪音低了不少
(5) 跟codex讨论,根据Log目前的bottleneck在哪里。主要还是在副卡的显存其实有点可惜,如果当初是买12GB版本的3080可能会提升不少。还有PCIE 3.0 x4的问题吧,
不过如果3080能加到20GB,反而PCIE 3.0 x4的影响就会变小了,因为主要运算就都会搬去显存。
可惜台湾这边比较少店家在帮忙改卡,大多有的也都是直接卖了,不然我也是很想改一下
希望能帮助到有类似配置的朋友,两张小显存卡能跑到256k上下文,128k能有75 decode速度,已经谢天谢地了
我也算是刚入门本地LLM的一员了,有什么使用技巧,还请大家多多指教。接下来还有好多工作要做呢,还得先接入Codex。
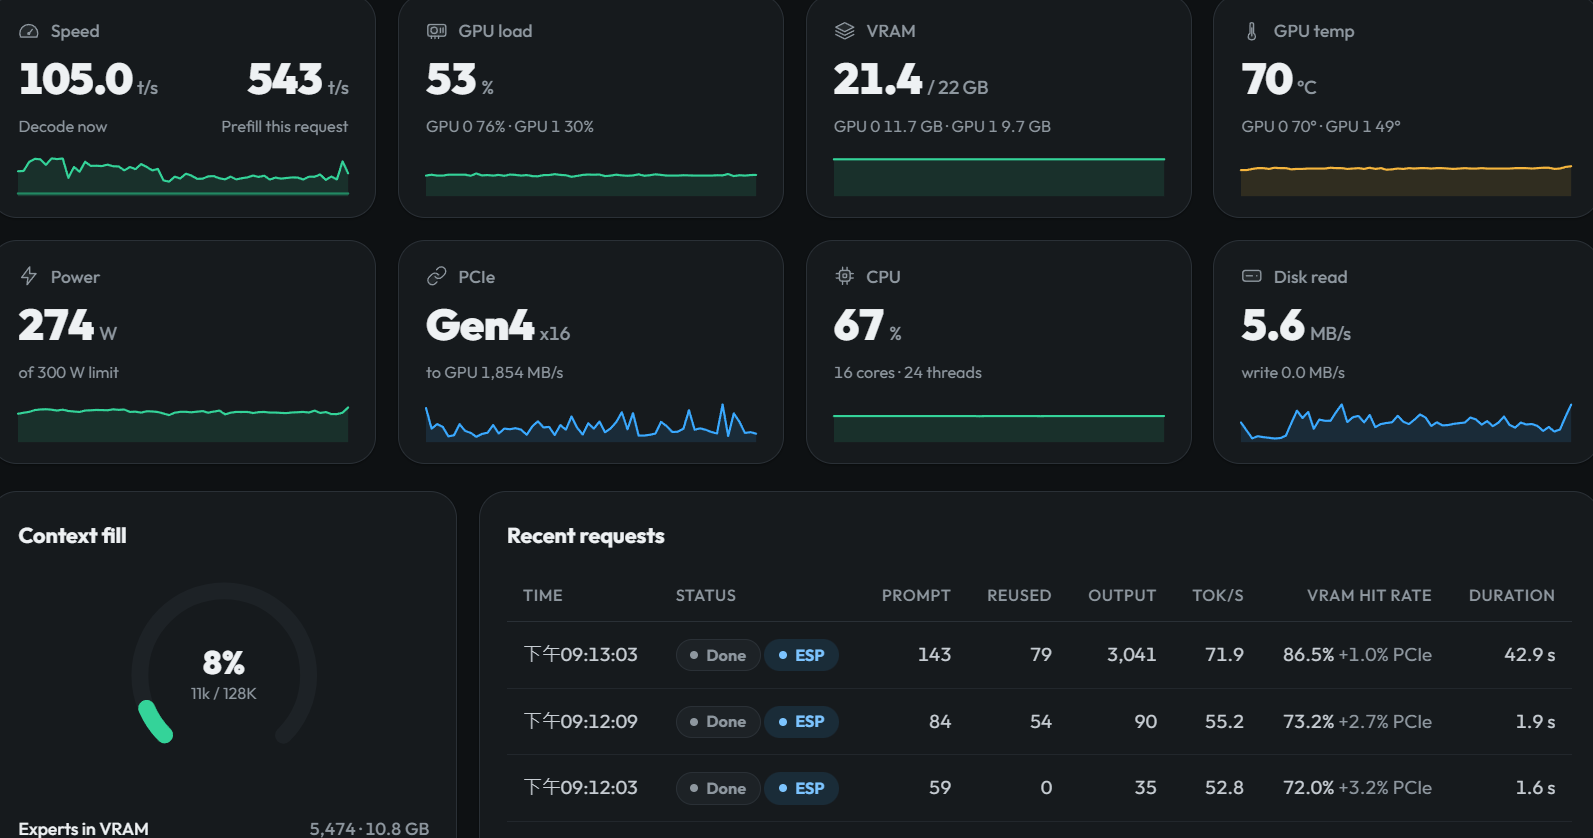
(随手用一些Dummy文本试了一下web chat)