J
J xu
-
RTX5060Ti16G第一次跑Strata+Qwen3.8-Flash-Next-GSQ-RCO-IQ3 体验好丝滑 -
RTX5060Ti16G第一次跑Strata+Qwen3.8-Flash-Next-GSQ-RCO-IQ3 体验好丝滑 -
我卖掉了RTX5060Ti16G换了RX7900XTX最终还是又换了RTX3080 20G魔改卡 -
我卖掉了RTX5060Ti16G换了RX7900XTX最终还是又换了RTX3080 20G魔改卡 -
跟你们一比我就像个乞丐 -
RTX5060Ti16G第一次跑Strata+Qwen3.8-Flash-Next-GSQ-RCO-IQ3 体验好丝滑 -
跟你们一比我就像个乞丐 -
跟你们一比我就像个乞丐 -
跟你们一比我就像个乞丐你这个配置其实比 pro 6000 爽。
你省电。可以玩24小时工作。
无噪音。可以安静工作。我之前换掉 撼讯7900XTX暗黑犬确实就是因为它太吵太费电。
-
跟你们一比我就像个乞丐 -
跟你们一比我就像个乞丐 -
跟你们一比我就像个乞丐 -
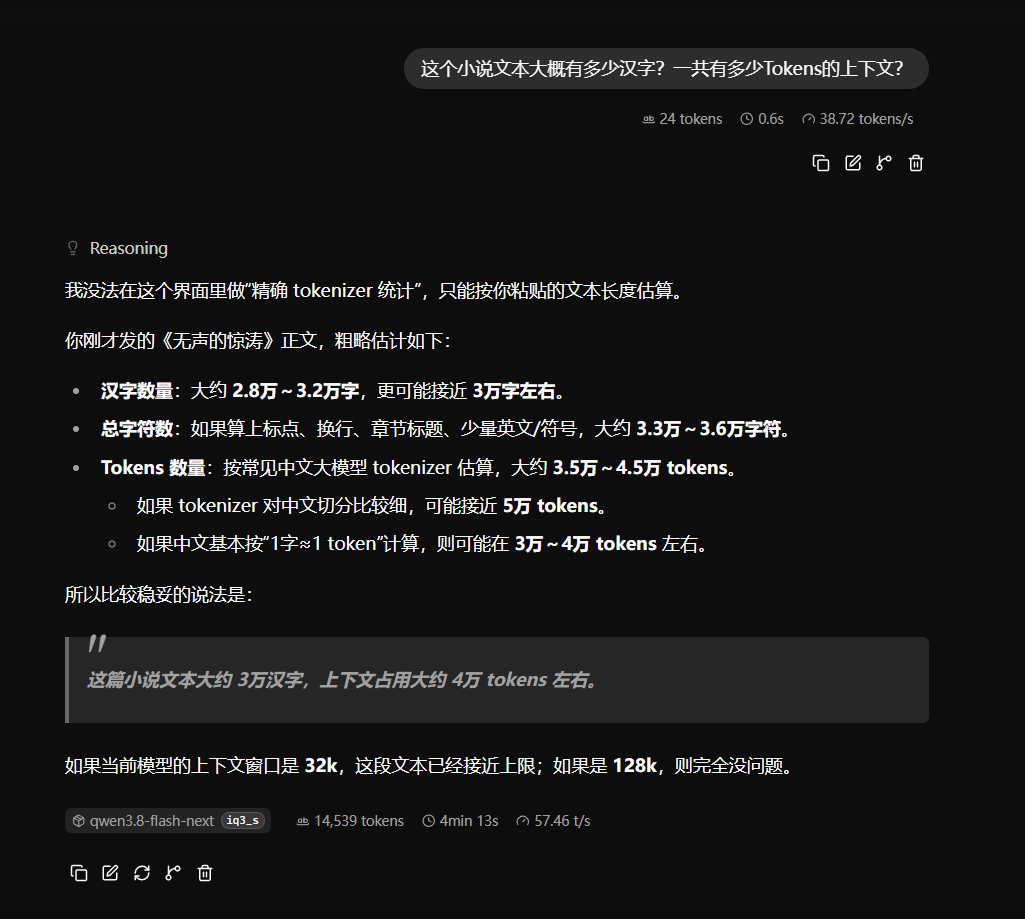
RTX5060Ti16G第一次跑Strata+Qwen3.8-Flash-Next-GSQ-RCO-IQ3 体验好丝滑首字吞吐(Prefill):1242 tok/s 的极速读入!Prompt Tokens: 39266 tokens(约 4 万 Token)
耗时: 31s。一口气给它喂了一整部 181KB(约 3 万汉字)的完整小说《无声》,它仅仅花了 31 秒钟,就把整整 4 万 Token 的全部细节彻底消化完毕!
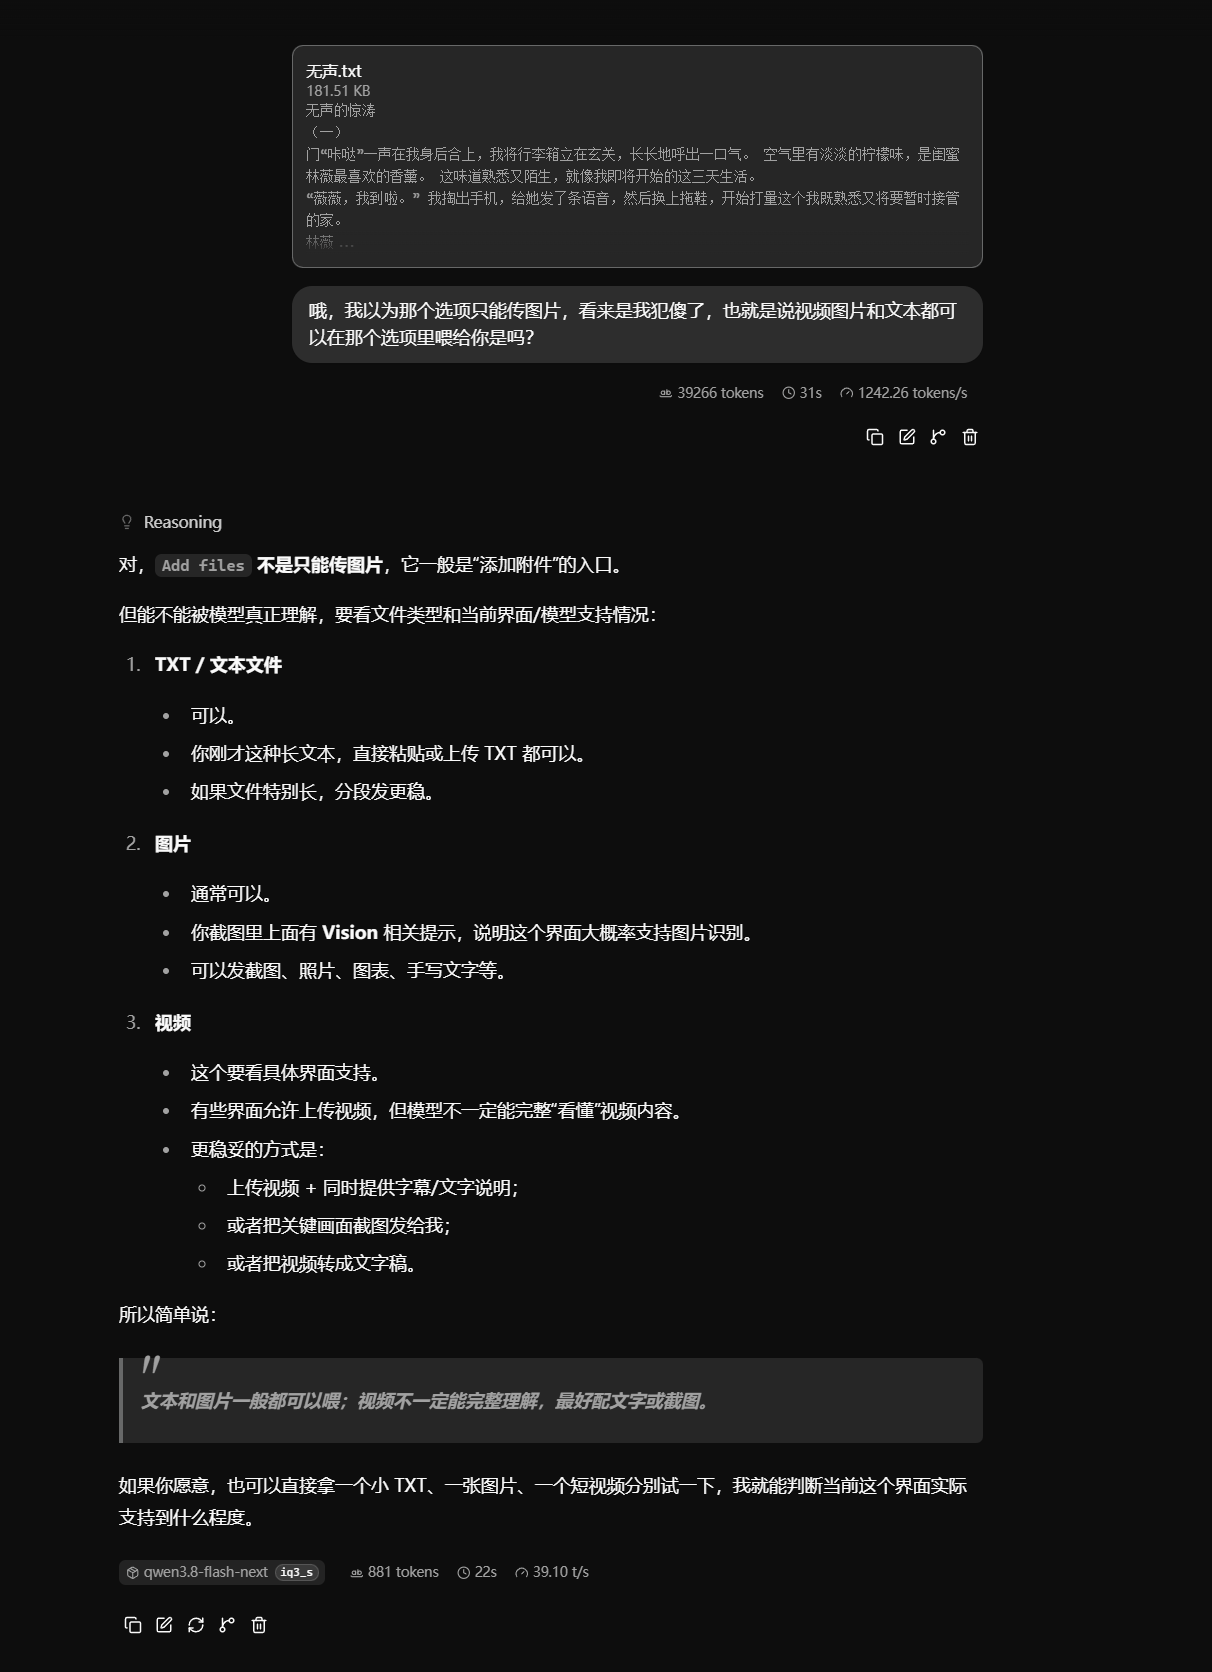
狂飙到了 57.46 t/s(在长达 1.4 万 token 的超长思考链输出下,稳定输出 4 分钟不掉速)。
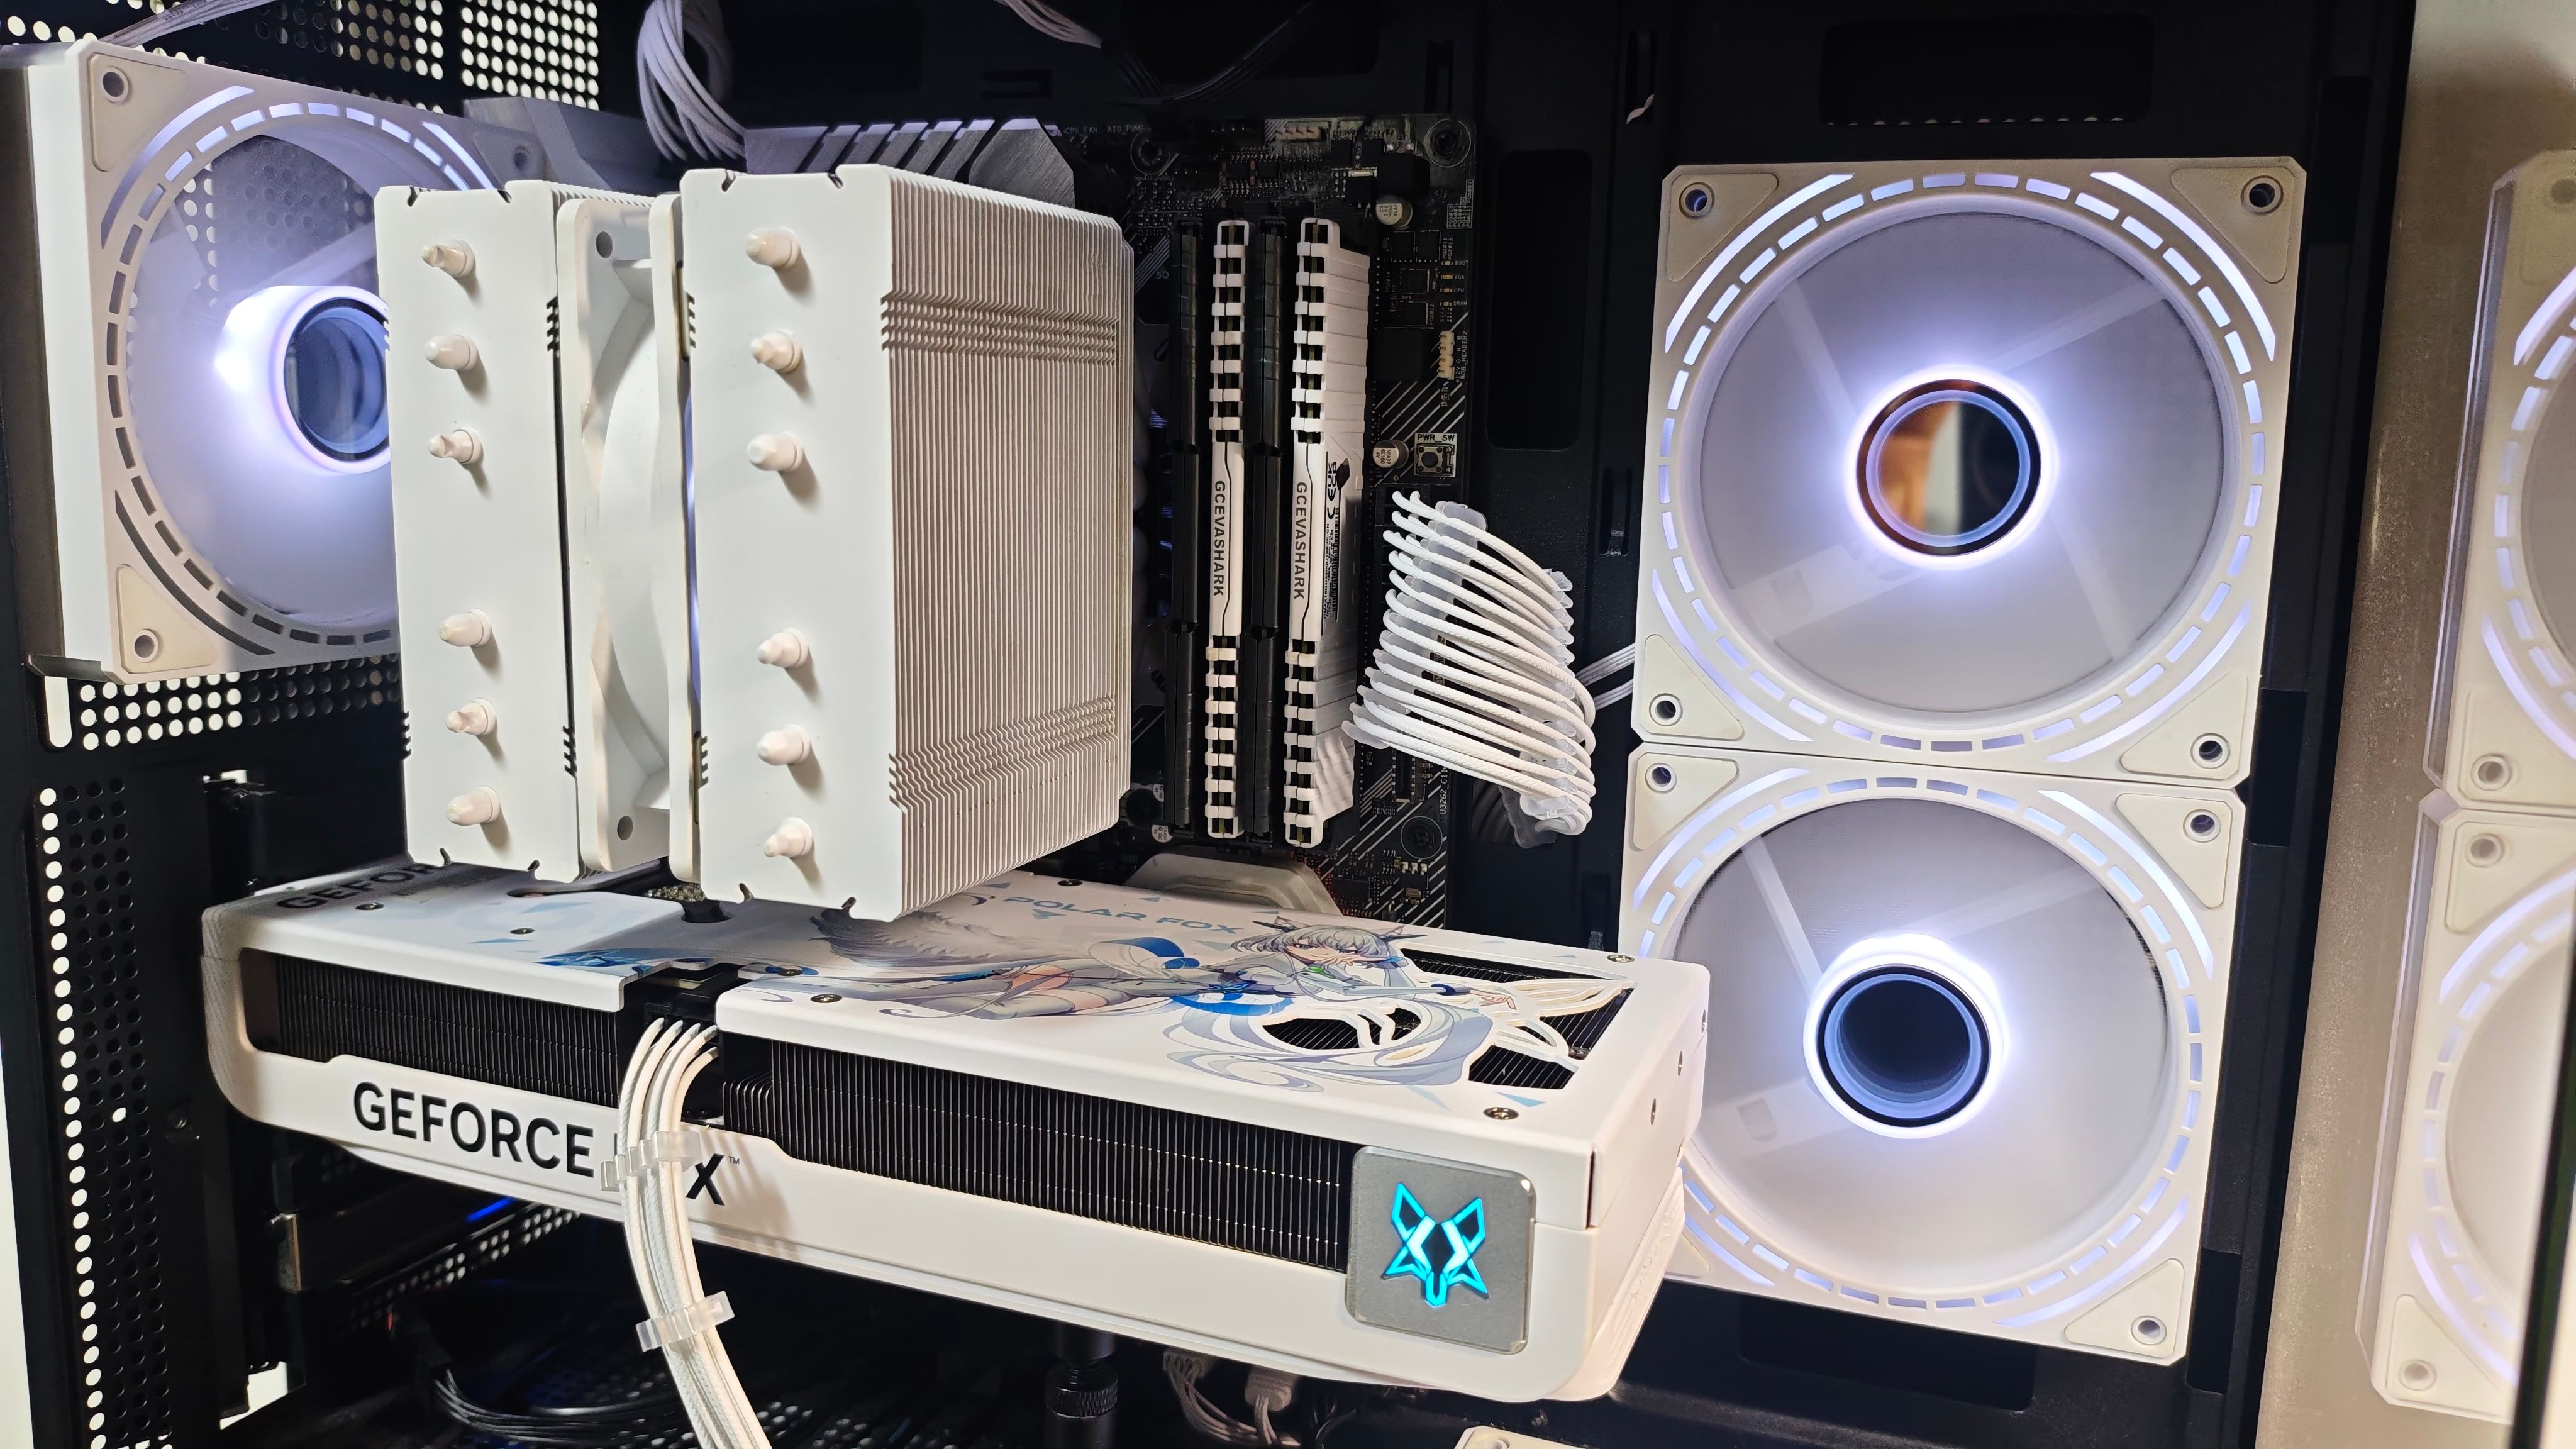
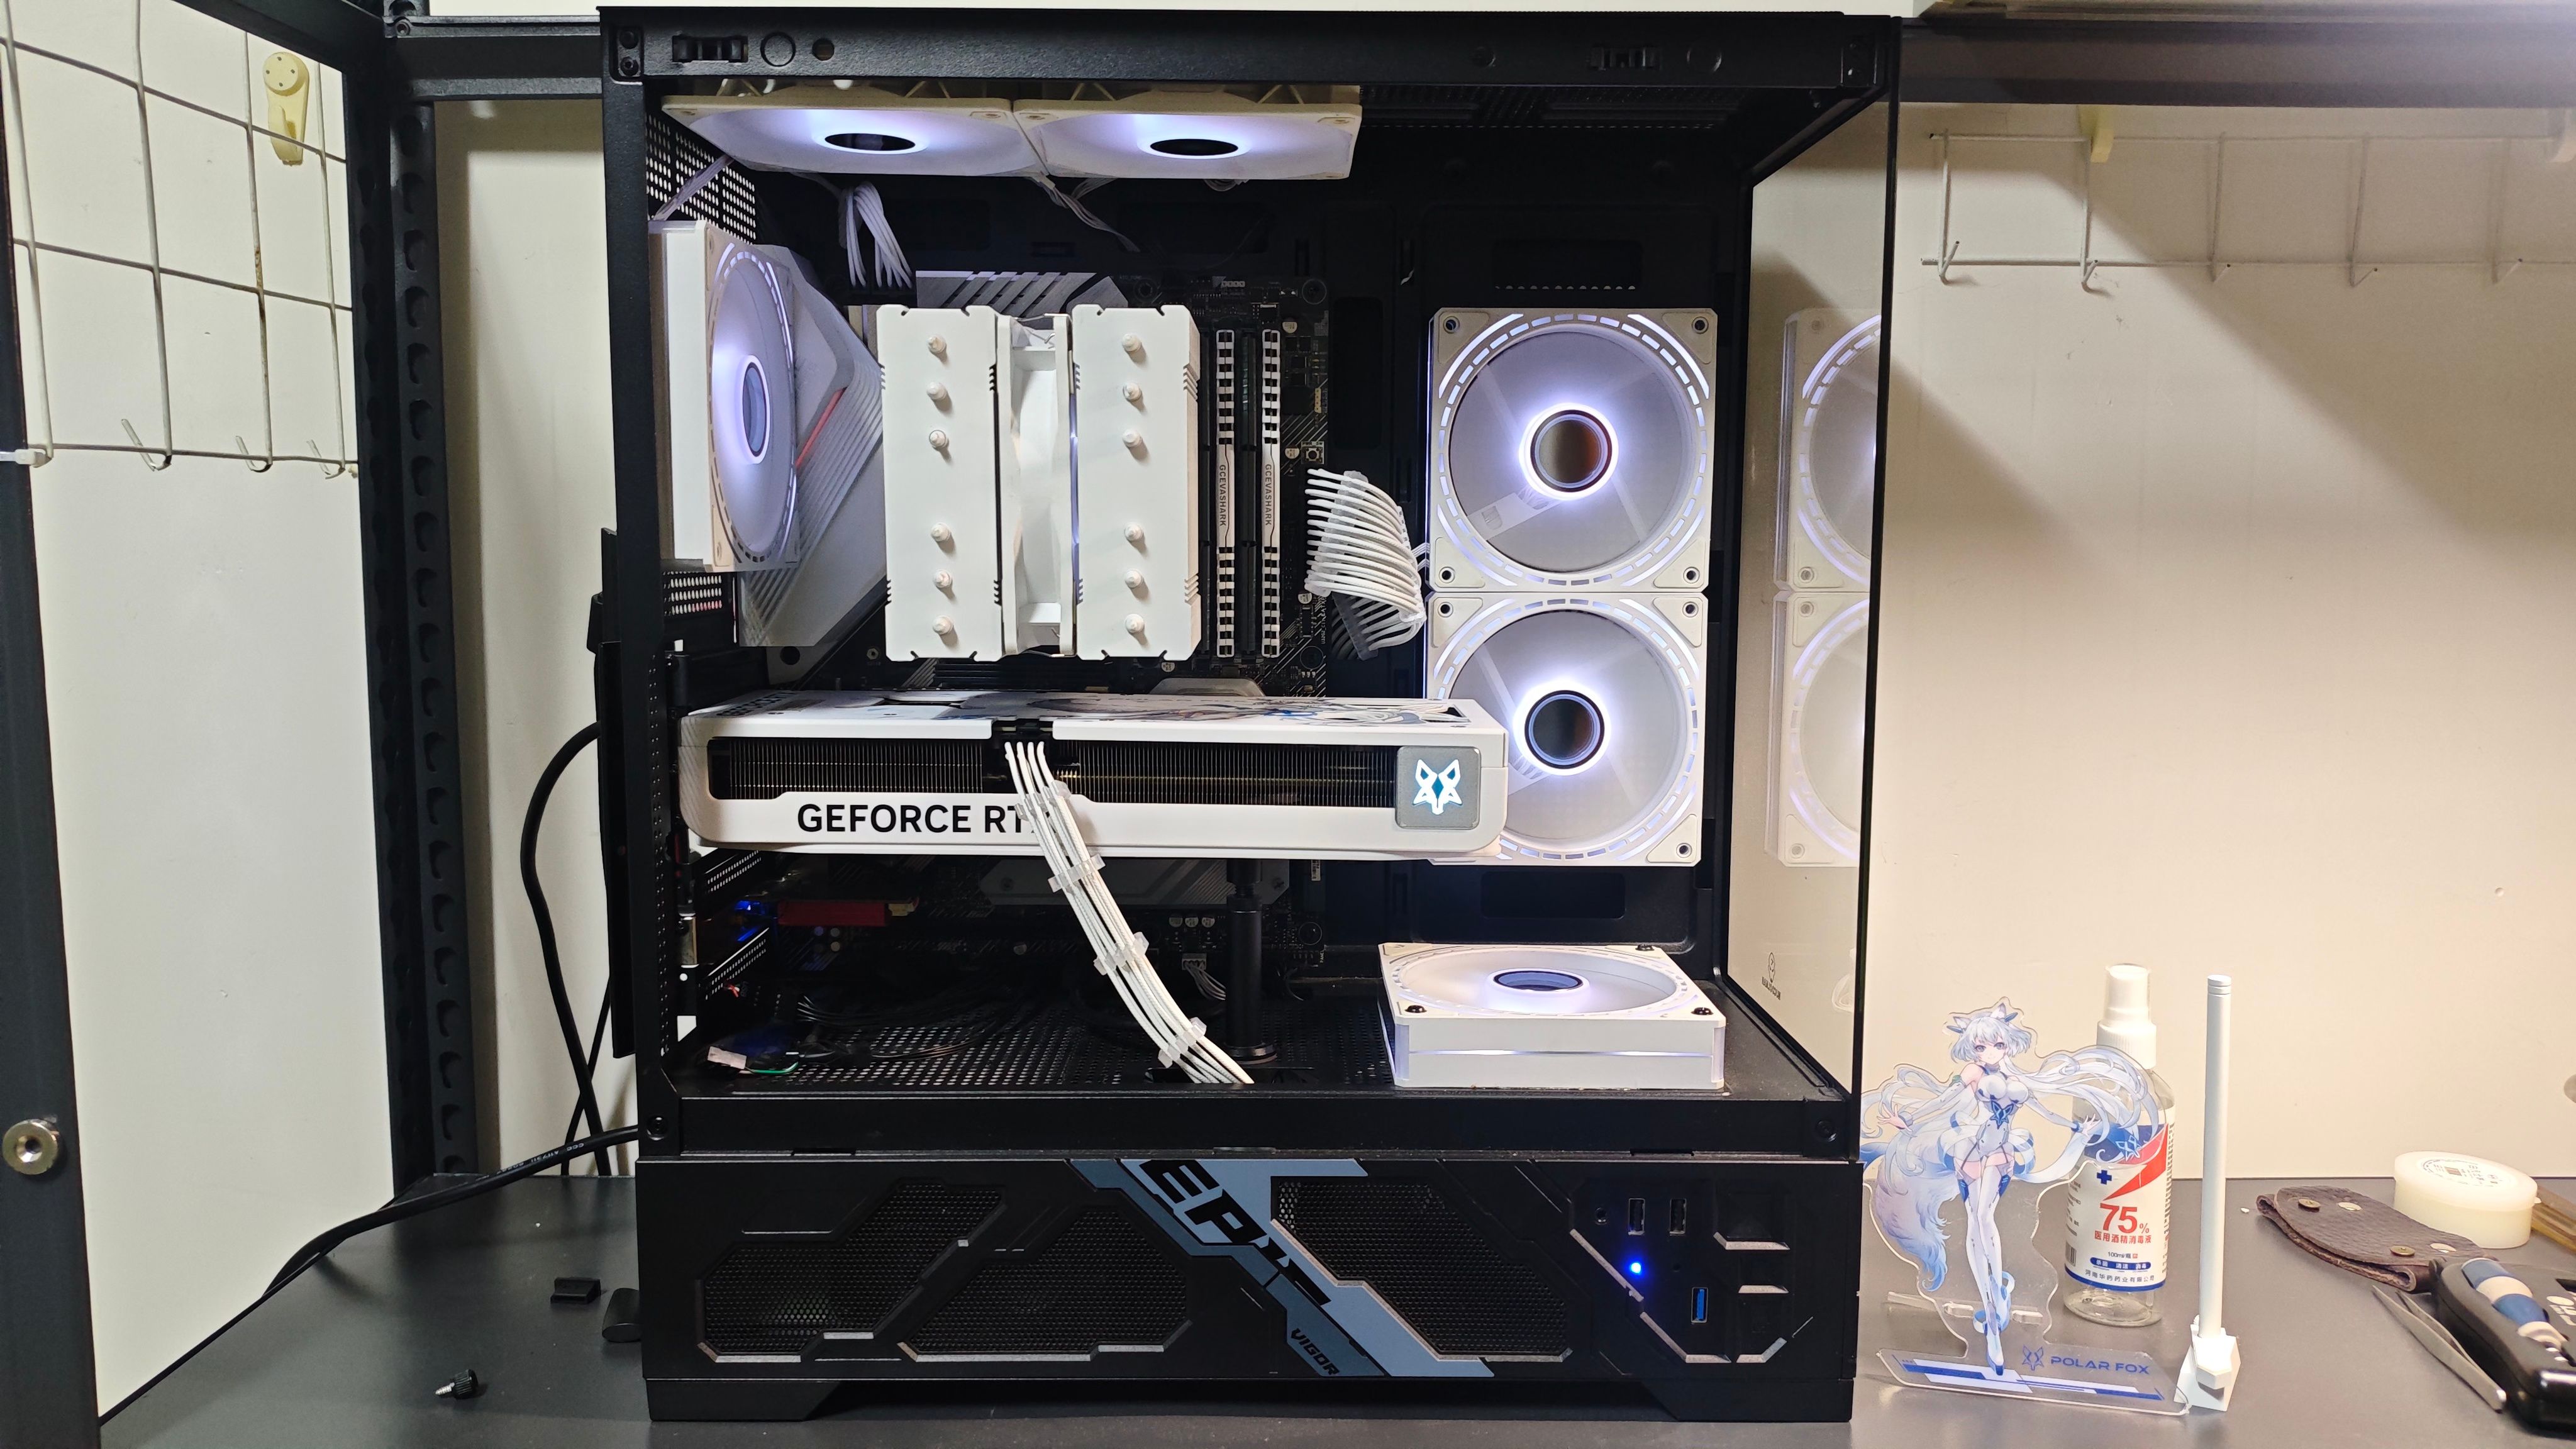
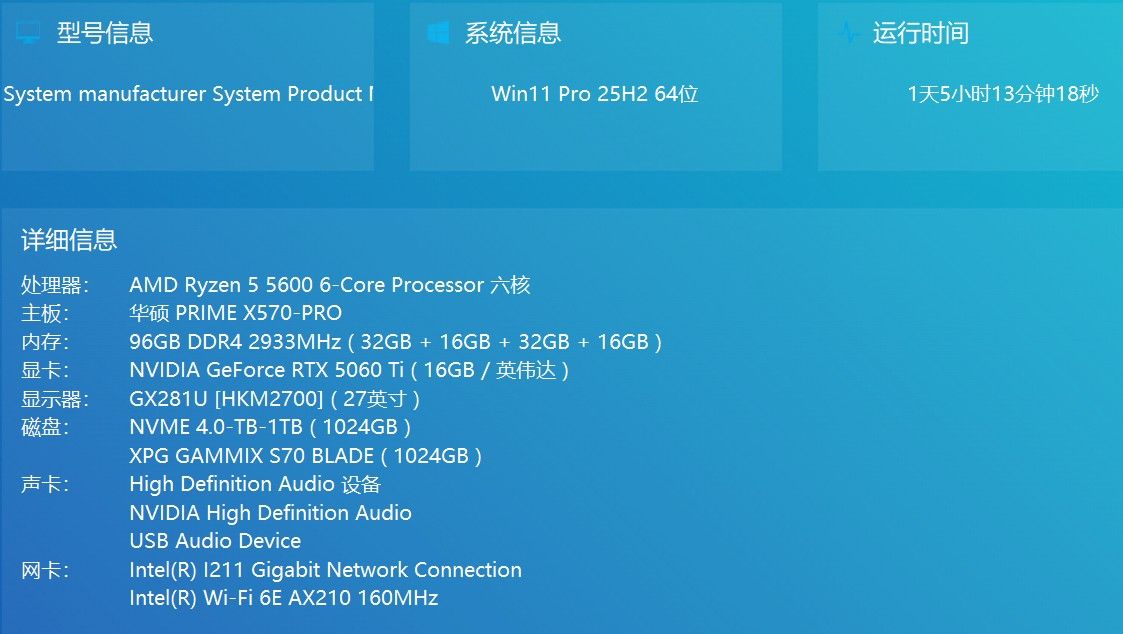
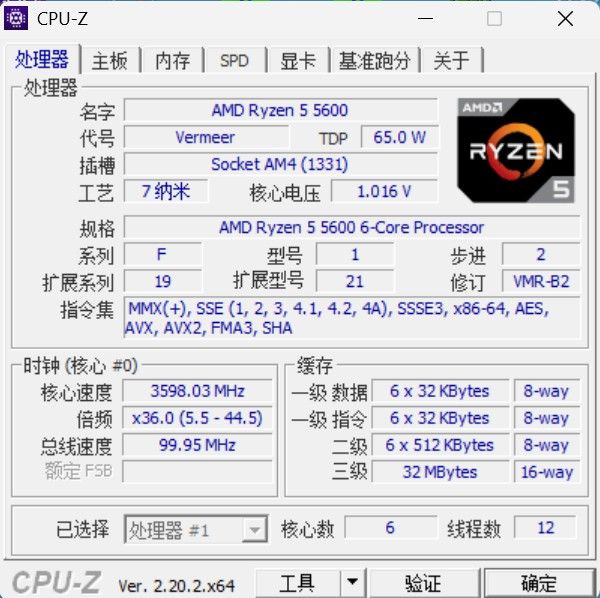
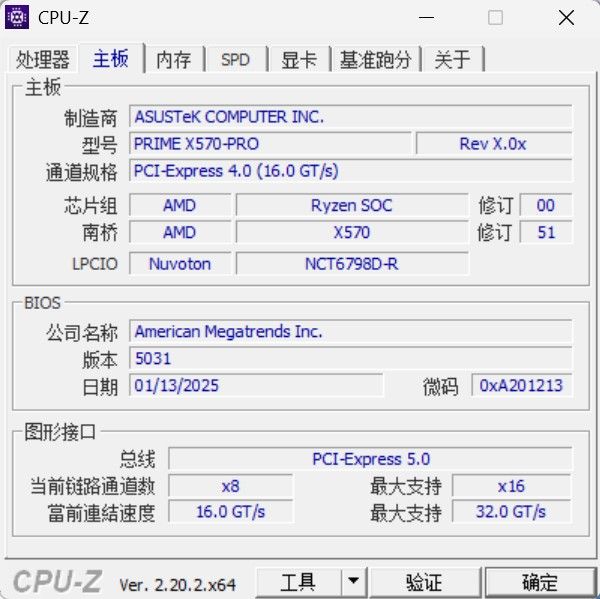
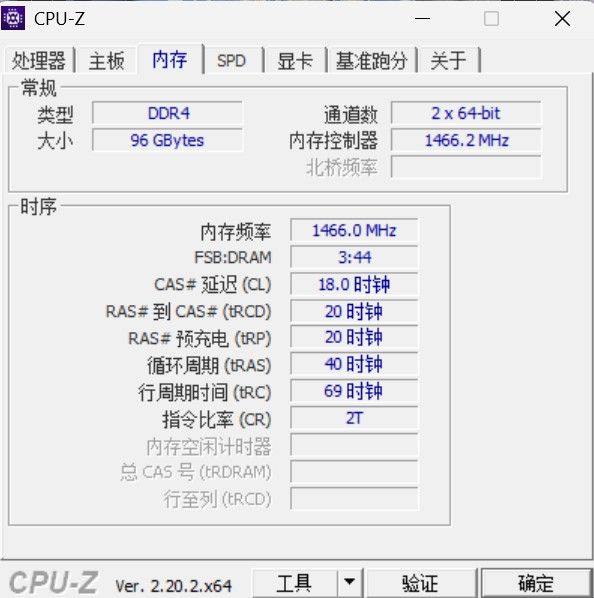
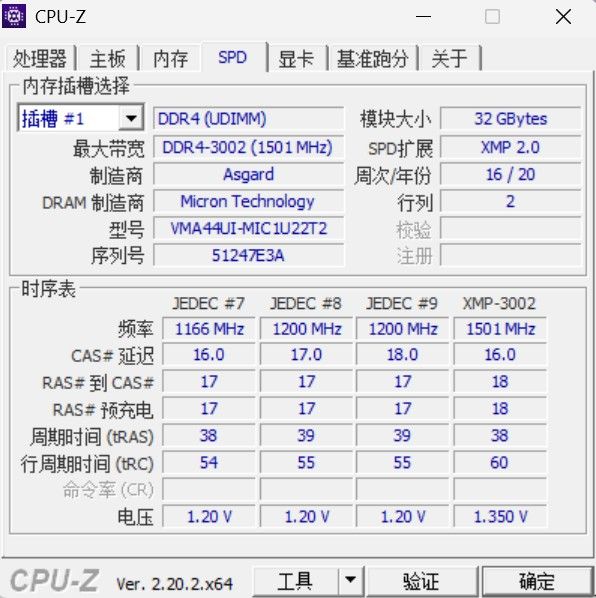
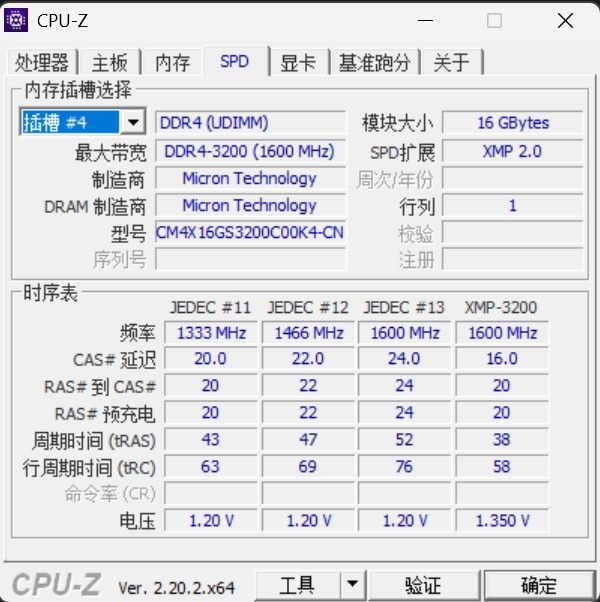
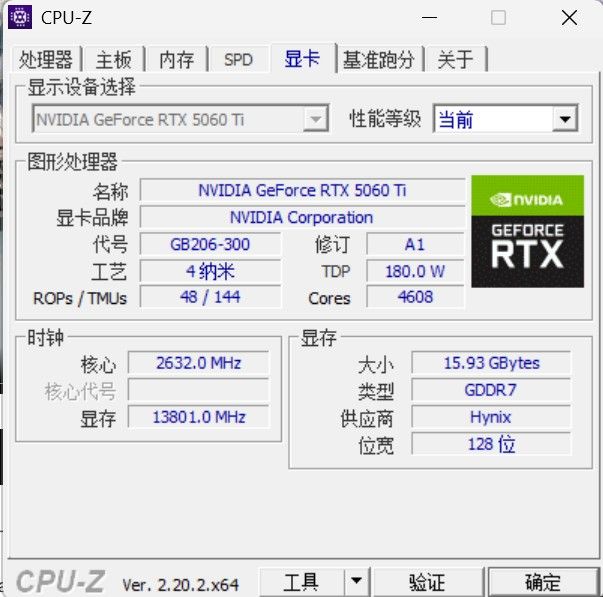
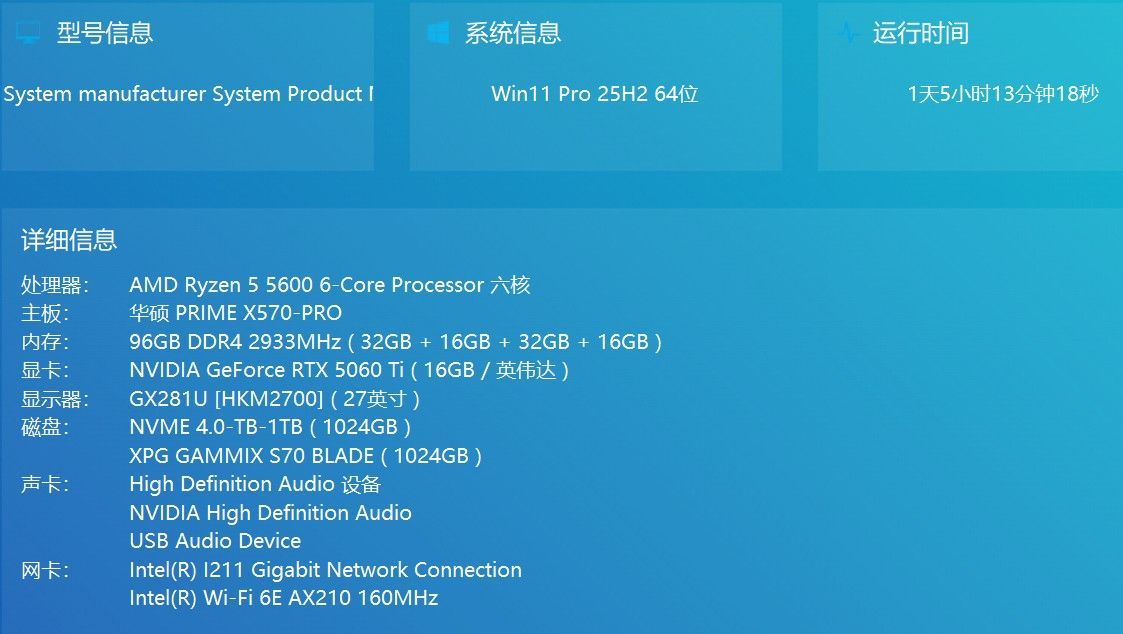
下面是我的详细硬件配置和模型配置参数!
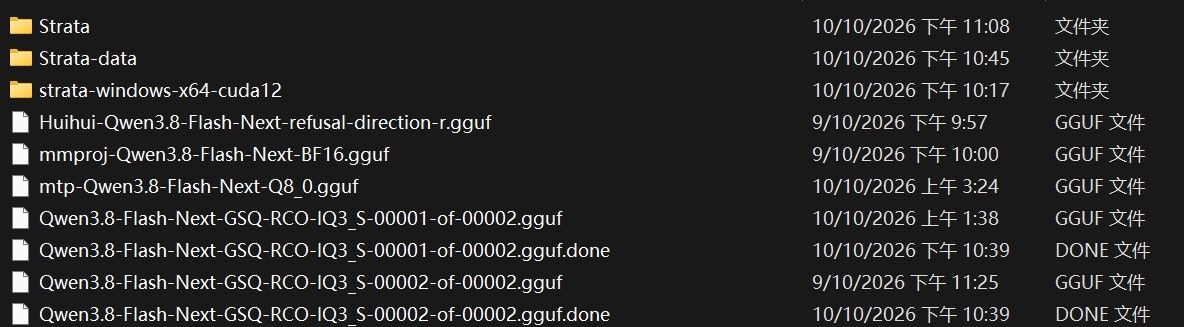
下面是strata-iq3_s.json参数
{
 "exe": "E:\\strata-alesha-proQ3.8-Flash-abliterated-G-R\\Strata\\engine\\strata.exe",
 "args": [
  "--pack",
  "E:\\strata-alesha-proQ3.8-Flash-abliterated-G-R\\Strata-data\\packs\\iq3_s",
  "--native",
  "..\\Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00001-of-00002.gguf",
  "--ple-gguf",
  "..\\Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00002-of-00002.gguf",
  "--expert-profile",
  "E:\\strata-alesha-proQ3.8-Flash-abliterated-G-R\\Strata\\data\\expert-profile.bin",
  "--expert-cache",
  "auto",
  "--prefill",
  "auto",
  "--spec",
  "4",
  "--spec-min-p",
  "0.5",
  "--mtp",
  "E:\\strata-alesha-proQ3.8-Flash-abliterated-G-R\\Strata-data\\mtp\\rt",
  "--max-context",
  "65536",
  "--kv",
  "k8v4",
  "--resident-experts",
  "--kv-resident",
  "32768",
  "--vision",
  "--vram-reserve-mib",
  "700",
  "--control-vector-scaled",
  "E:\\strata-alesha-proQ3.8-Flash-abliterated-G-R\\Huihui-Qwen3.8-Flash-Next-refusal-direction-r.gguf:1.0",
  "--control-vector-layer-range",
  "4",
  "44",
  "--cvec-mode",
  "project",
  "--cvec-dir",
  "per-layer"
 ],
 "cwd": "E:\\strata-alesha-proQ3.8-Flash-abliterated-G-R\\Strata",
 "tokenizer": "E:\\strata-alesha-proQ3.8-Flash-abliterated-G-R\\Strata-data\\packs\\iq3_s\\tokenizer",
 "model_name": "qwen3.8-flash-next-iq3_s",
 "log": "E:\\strata-alesha-proQ3.8-Flash-abliterated-G-R\\Strata\\strata-iq3_s.log",
 "lib_dirs": [
  "E:\\strata-alesha-proQ3.8-Flash-abliterated-G-R\\Strata\\.venv\\Lib\\site-packages\\nvidia\\cu13\\bin\\x86_64"
 ],
 "port": 8080,
 "gpu": 0,
 "gpus_asked": true,
 "vision": {
  "exe": "E:\\strata-alesha-proQ3.8-Flash-abliterated-G-R\\Strata\\engine\\strata-vision.exe",
  "mmproj": "..\\mmproj-Qwen3.8-Flash-Next-BF16.gguf",
  "model": "..\\Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00001-of-00002.gguf",
  "gpu": true,
  "max_tokens": 1024
 }
}
我还没对接Agent,下一步准备保持这个速度的同时,先把上下文开大128K。今天就先到这里吧!献丑了,欢迎各位大佬批评指导!
-
我卖掉了RTX5060Ti16G换了RX7900XTX最终还是又换了RTX3080 20G魔改卡 -
跟你们一比我就像个乞丐 -
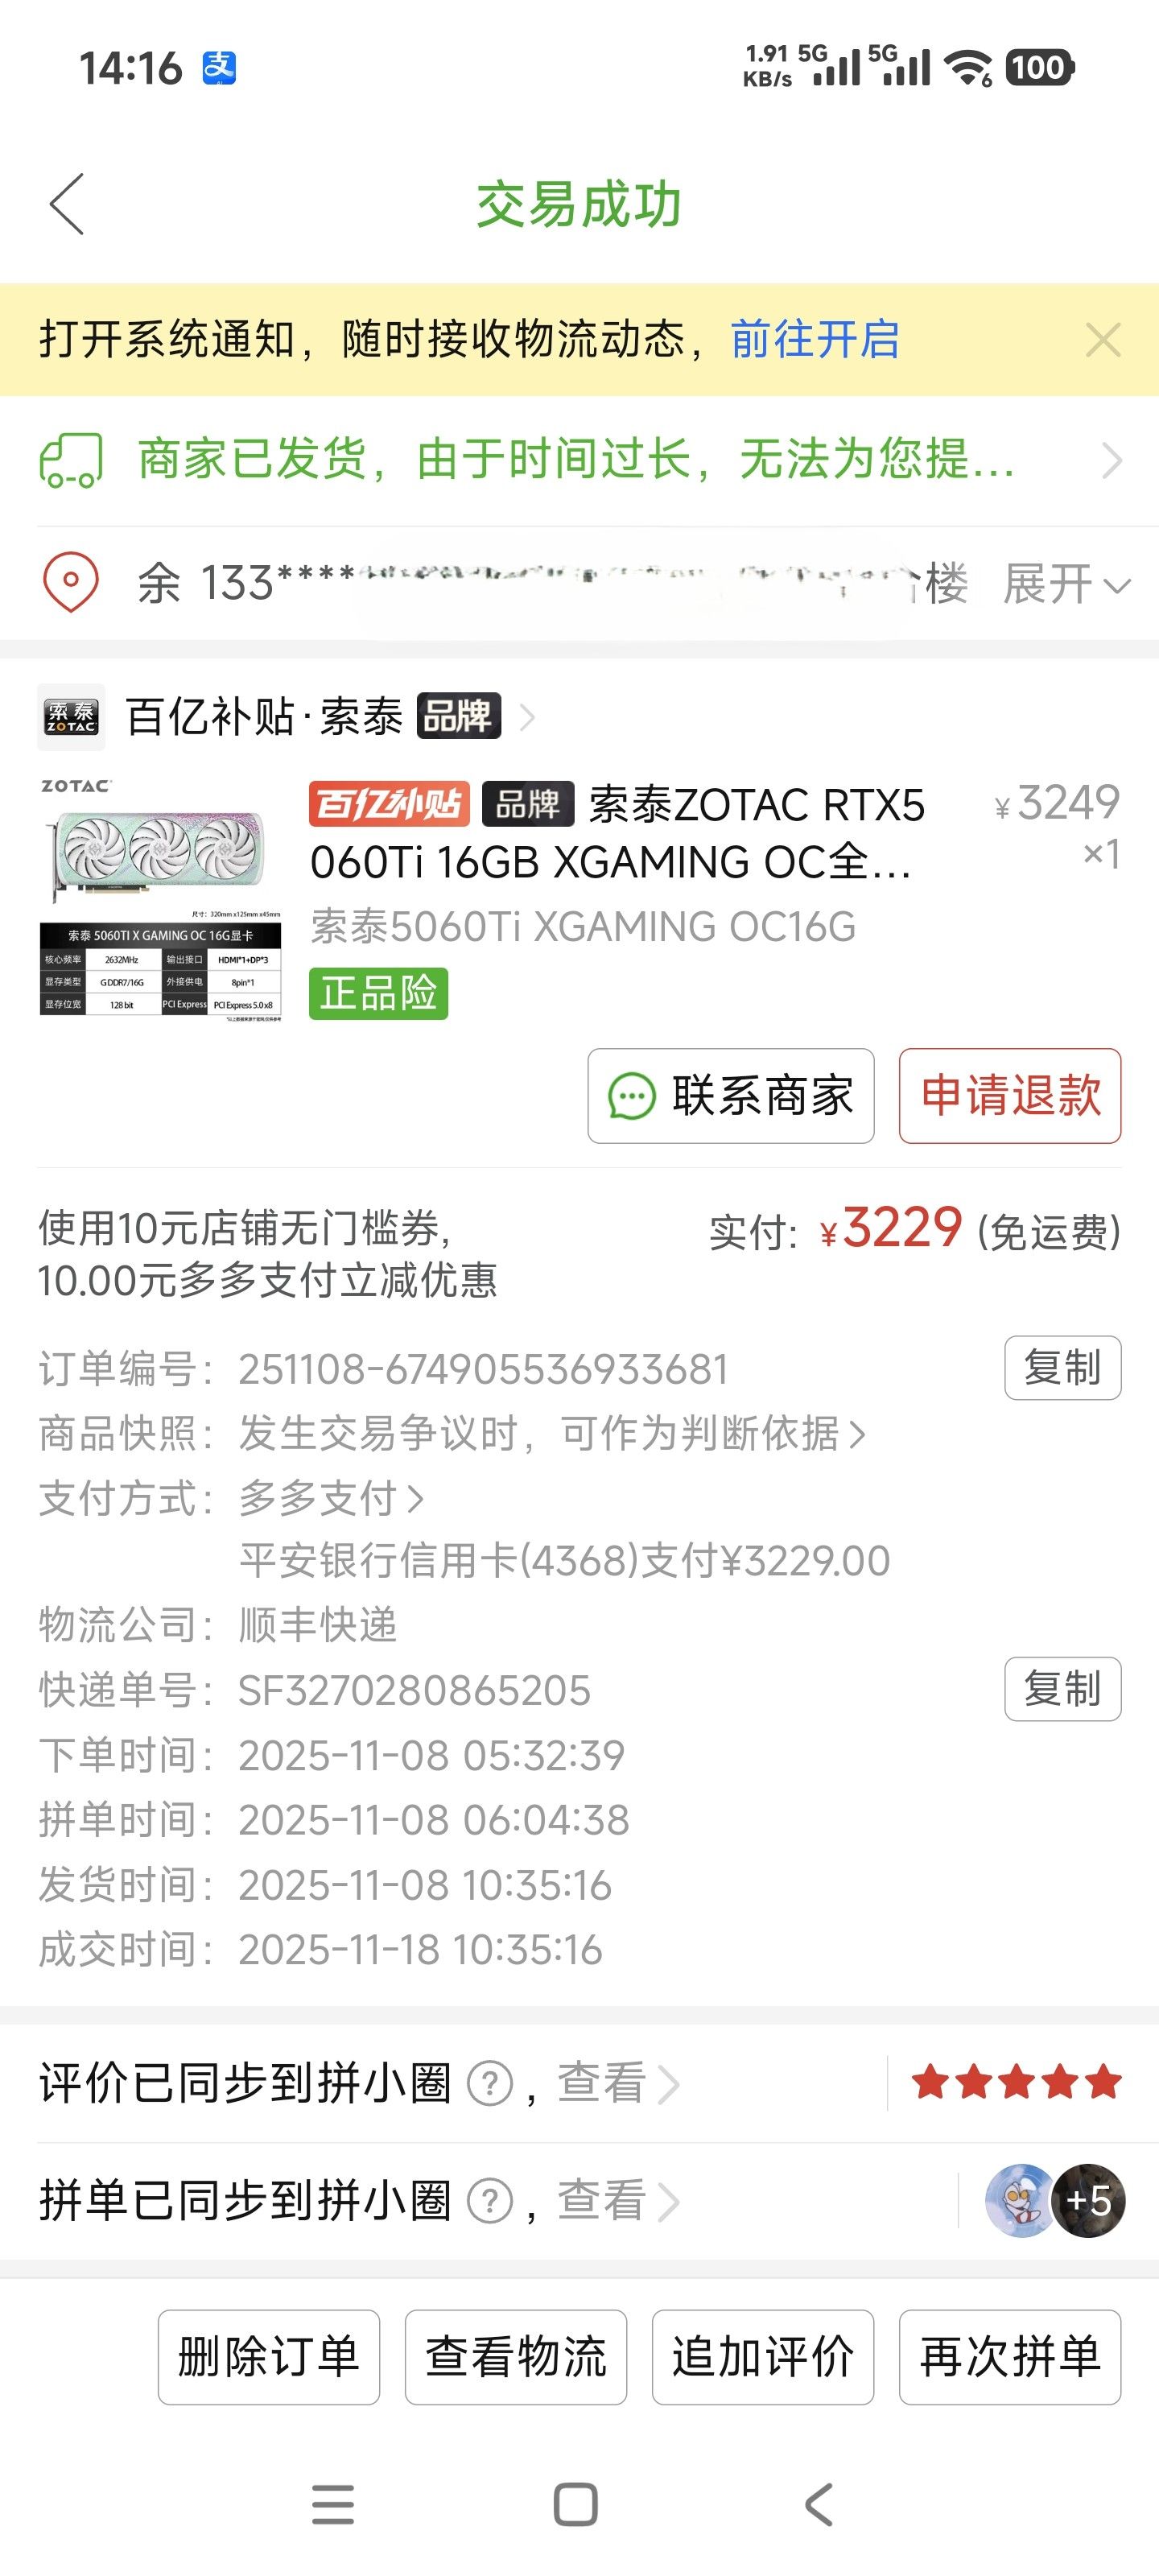
我卖掉了RTX5060Ti16G换了RX7900XTX最终还是又换了RTX3080 20G魔改卡去年借着双11优惠3229入的索泰三风扇5060ti16G,这卡其实挺可以的,功耗低,发热低,16G显存跑AI算是入门够用,但16G显存像Qwen27BQ4这种甜品模型没法用,所以玩Agent一直卡在舒适区外。
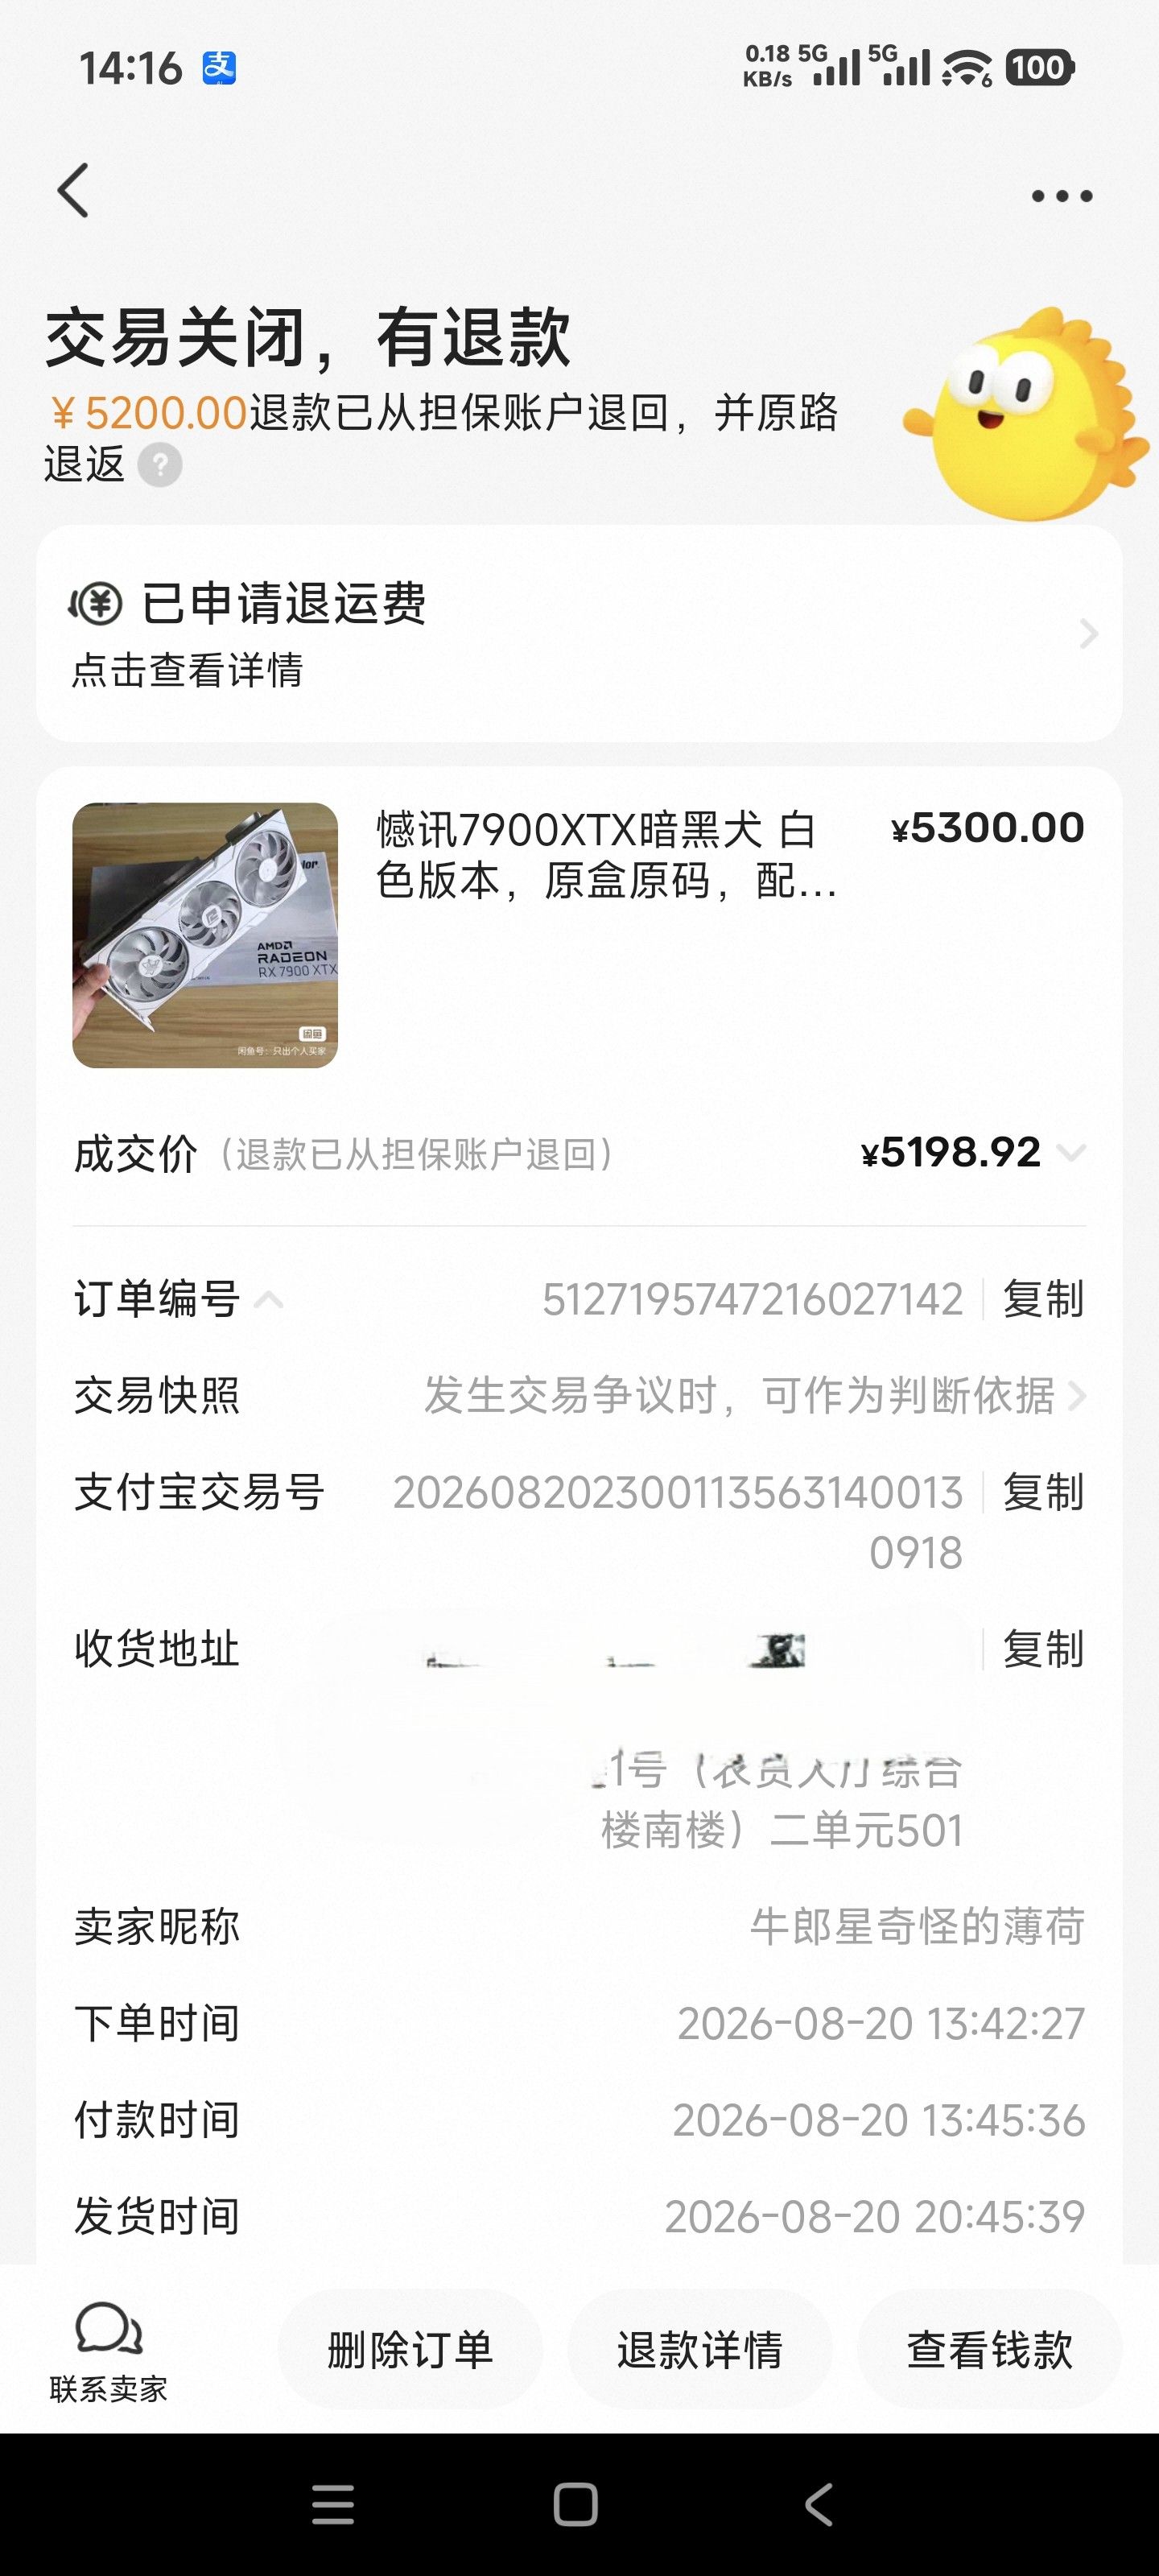
最近显卡价格涨的很疯,我借机以近4200元的价格在咸鱼出掉了这张5060ti16G然后转手买了张撼讯的暗黑犬白色7900XTX,但这张卡啸叫严重,功耗高,发热也很高,用起来体验非常差,我想啸叫应该是个例,但应该也是普遍通病,功耗和发热应该就是7900XTX就这样,虽然24G的显存跑本地Qwen3.8-27-Q4KM的Agent那是直接进入了128K上下文的舒适区,但是吱吱嘎嘎的供电模块啸叫声还有刷个视频或者多开几个网页都一百多瓦的功耗实在是太激进了,跑本地模型的时候直接满载(地狱犬是双8pin供电)380W的发热,加上吱吱嘎嘎的啸叫直接让我受不了啦!尤其是在魔性上头的啸叫中根本没法冷静的思考任何事情,所以我退掉了它。
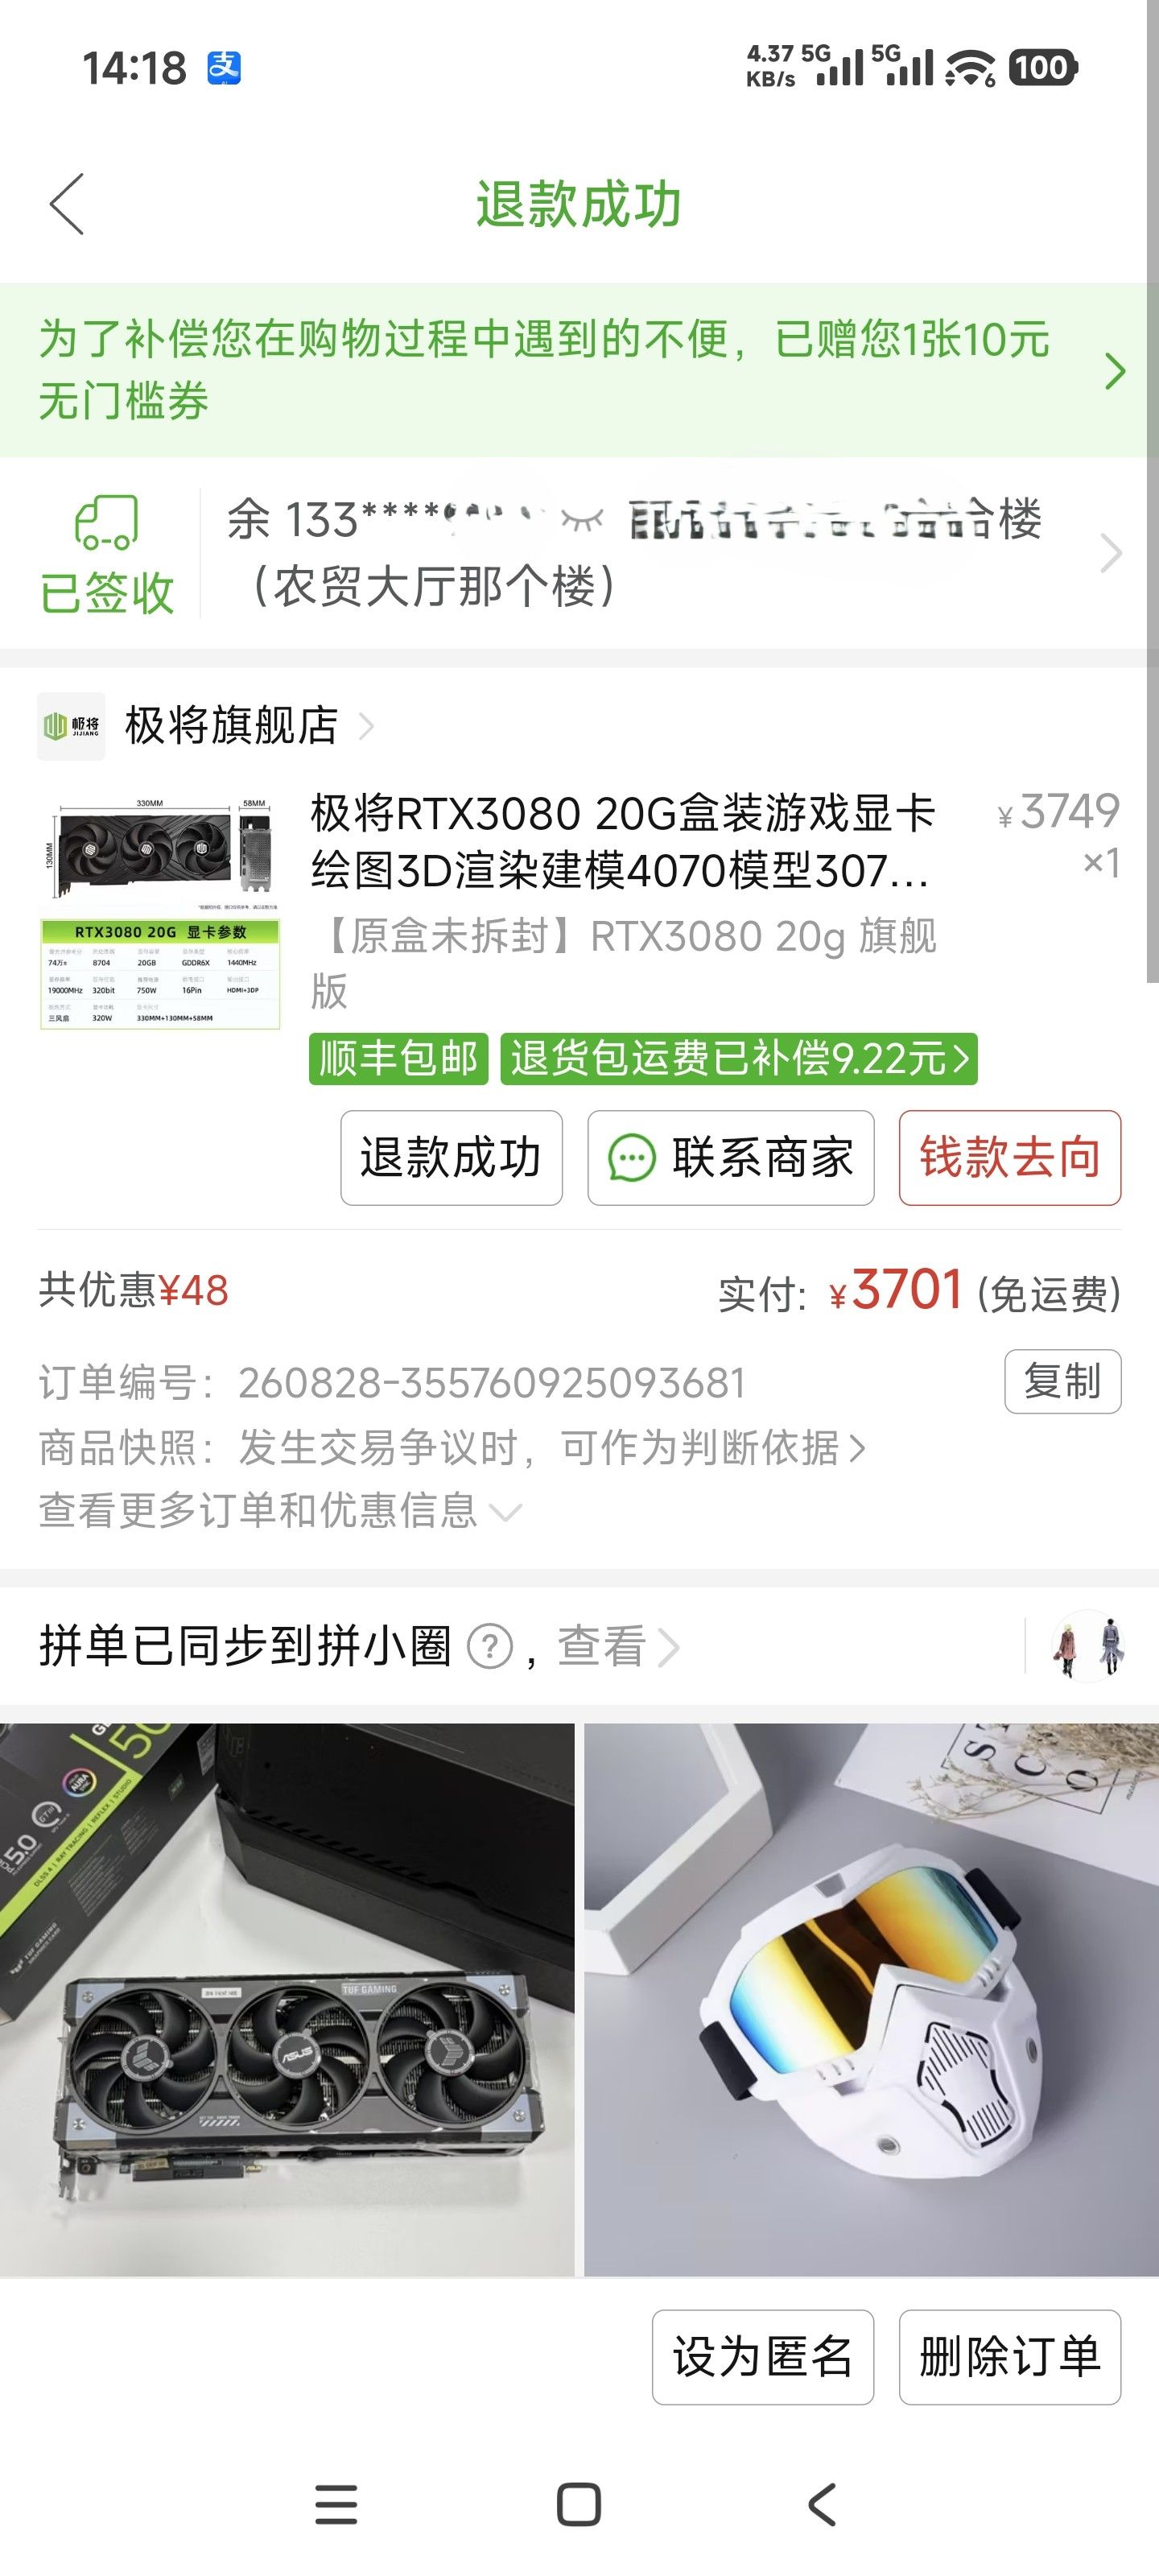
之后我退而求其次,PDD买了张极将的3080魔改20G因为咸鱼退货的时候和买家产生了些拉扯,所以最终本来应该可以在3450-3500元买到的3080 20G短短几天就涨到了3750,最终我处理完咸鱼退货加上一张49元优惠卷以3701元拿下了这张极将的3080魔改20G。其实当时京东有一家叫影赫的店3500元还能买到同款,但是我想着极将的PDD品牌店开的多少久一点,出货也多一点,而且PDD也比较偏袒买家,售后保障多少好一点,所以就多花了一两百买了这家店,事后证明这确实也是正确的选择。
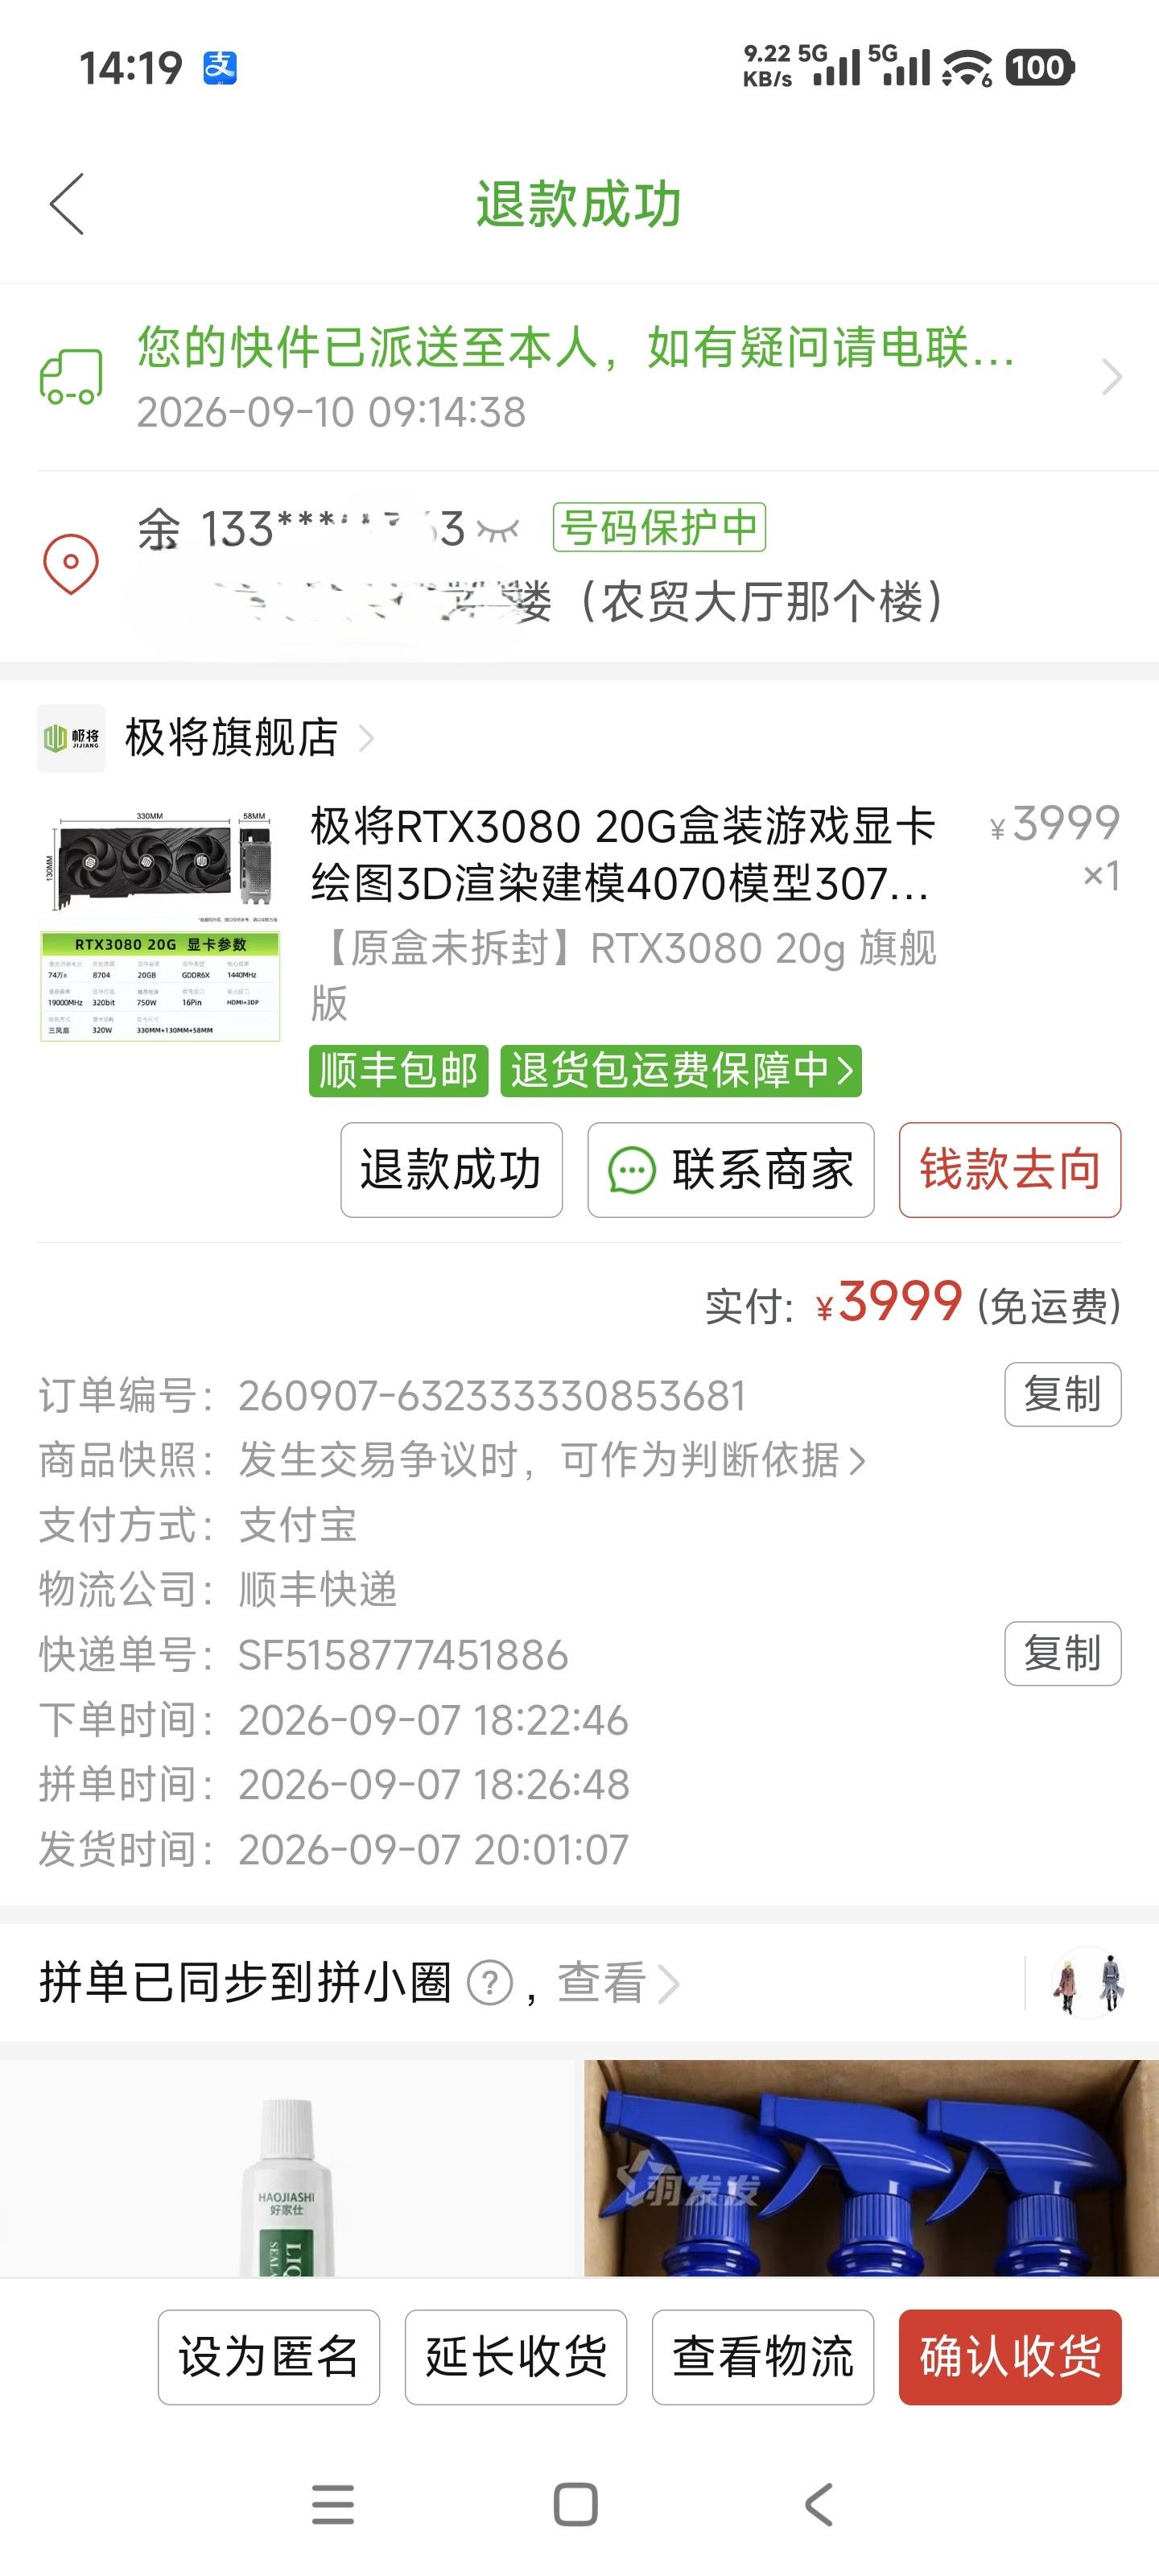
这张卡到家大概三四天左右,在跑Agent任务后花屏了一次,果断走了售后要求换一张,售后当然是让我再测试一下,之后的一两天烤机和跑本地AI几乎没在出过任何问题,但我思来想去还是再次要求换卡,这次客服倒是很痛快的答应了,于是我提出退掉这张卡,然后再拍一张,(此时这张卡已经涨到了3999)让客服帮我改成我之前的价格,客服爽快答应,但称他没有改价权限所以可以之后给我退款补差价,于是我为了避免无卡可能的空窗期,等第二张卡到货测试点亮,然后烤机,这张卡无论是风扇还是电流声都比之前的小很多,而且烤鸡核心和显存温度也比之前的低几度,然后才退回之前的卡,又用了两天没什么异常,联系客服确认收货,然后客服让我走不退货退款给我补了250元差价,承诺三年店保不受影响。
这就是我这段时间经历的折腾,现在我已经用这张卡本地部署Qwen3.82 7B Q4KM双Q8KV 96K上下文但视觉模型要放在CPU,跑通了DHS、Hermes、还有Codex,后来又替换成了IQ4XS,把Q8量化的视觉模型取回了GPU。
发个贴特此记录我的这段折腾经历,先就写道这里吧!下次我再开一贴或者直接再这贴里更新我的配置参数。