一、測試環境與使用版本
| 項目 | 環境 |
|---|---|
| CPU | Intel Xeon E5-2666 v3 |
| 主板 | 華南金牌 X99 BD3 |
| 記憶體 | 128GB DDR3 1833 拆機條 |
| 目標顯卡 | RTX 3080 20GB,GA102,PCI ID 10de:2206 |
| VBIOS | 94.02.27.00.14 |
| 系統 | Ubuntu 24.04.5 |
| 核心 | 6.8.0-147-generic |
| NVIDIA 驅動 | 595.99.02,open kernel module |
| 功耗上限 | 解鎖前後均為 320W |
| 矩陣測試 | CUDA 13.0 runtime/cuBLAS |
二、解鎖前後數據
| 運算 | 解鎖前 | 解鎖後 | 提升 |
|---|---|---|---|
| FP32,pedantic | 21.7603 | 21.7622 | +0.01% |
| FP16 輸入/FP32 累加 | 61.0683 | 110.4815 | +80.91% |
| BF16 輸入/FP32 累加 | 61.1053 | 113.9369 | +86.46% |
在這個測試條件下,半精度矩陣吞吐約提高到原本的 1.8 倍。
三、Ubuntu 6.8 實際有跑起來
這個作業系統在解鎖時有些問題,github上已經有人回報了,具體修正給agent看這就能解決。
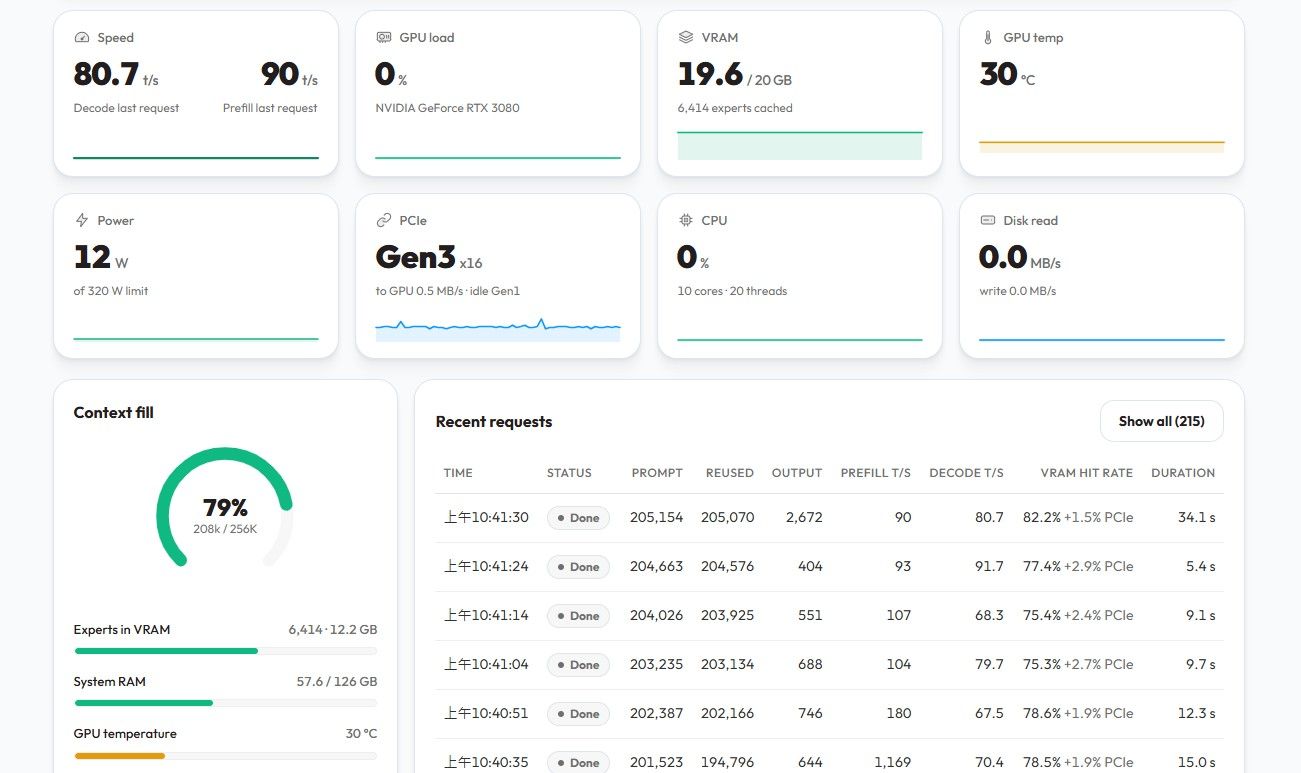
四、strata實際使用
應該比原本快個20%,原本單卡3080 decode平均大約6X,現在平均大約7X,以上給壇友們參考