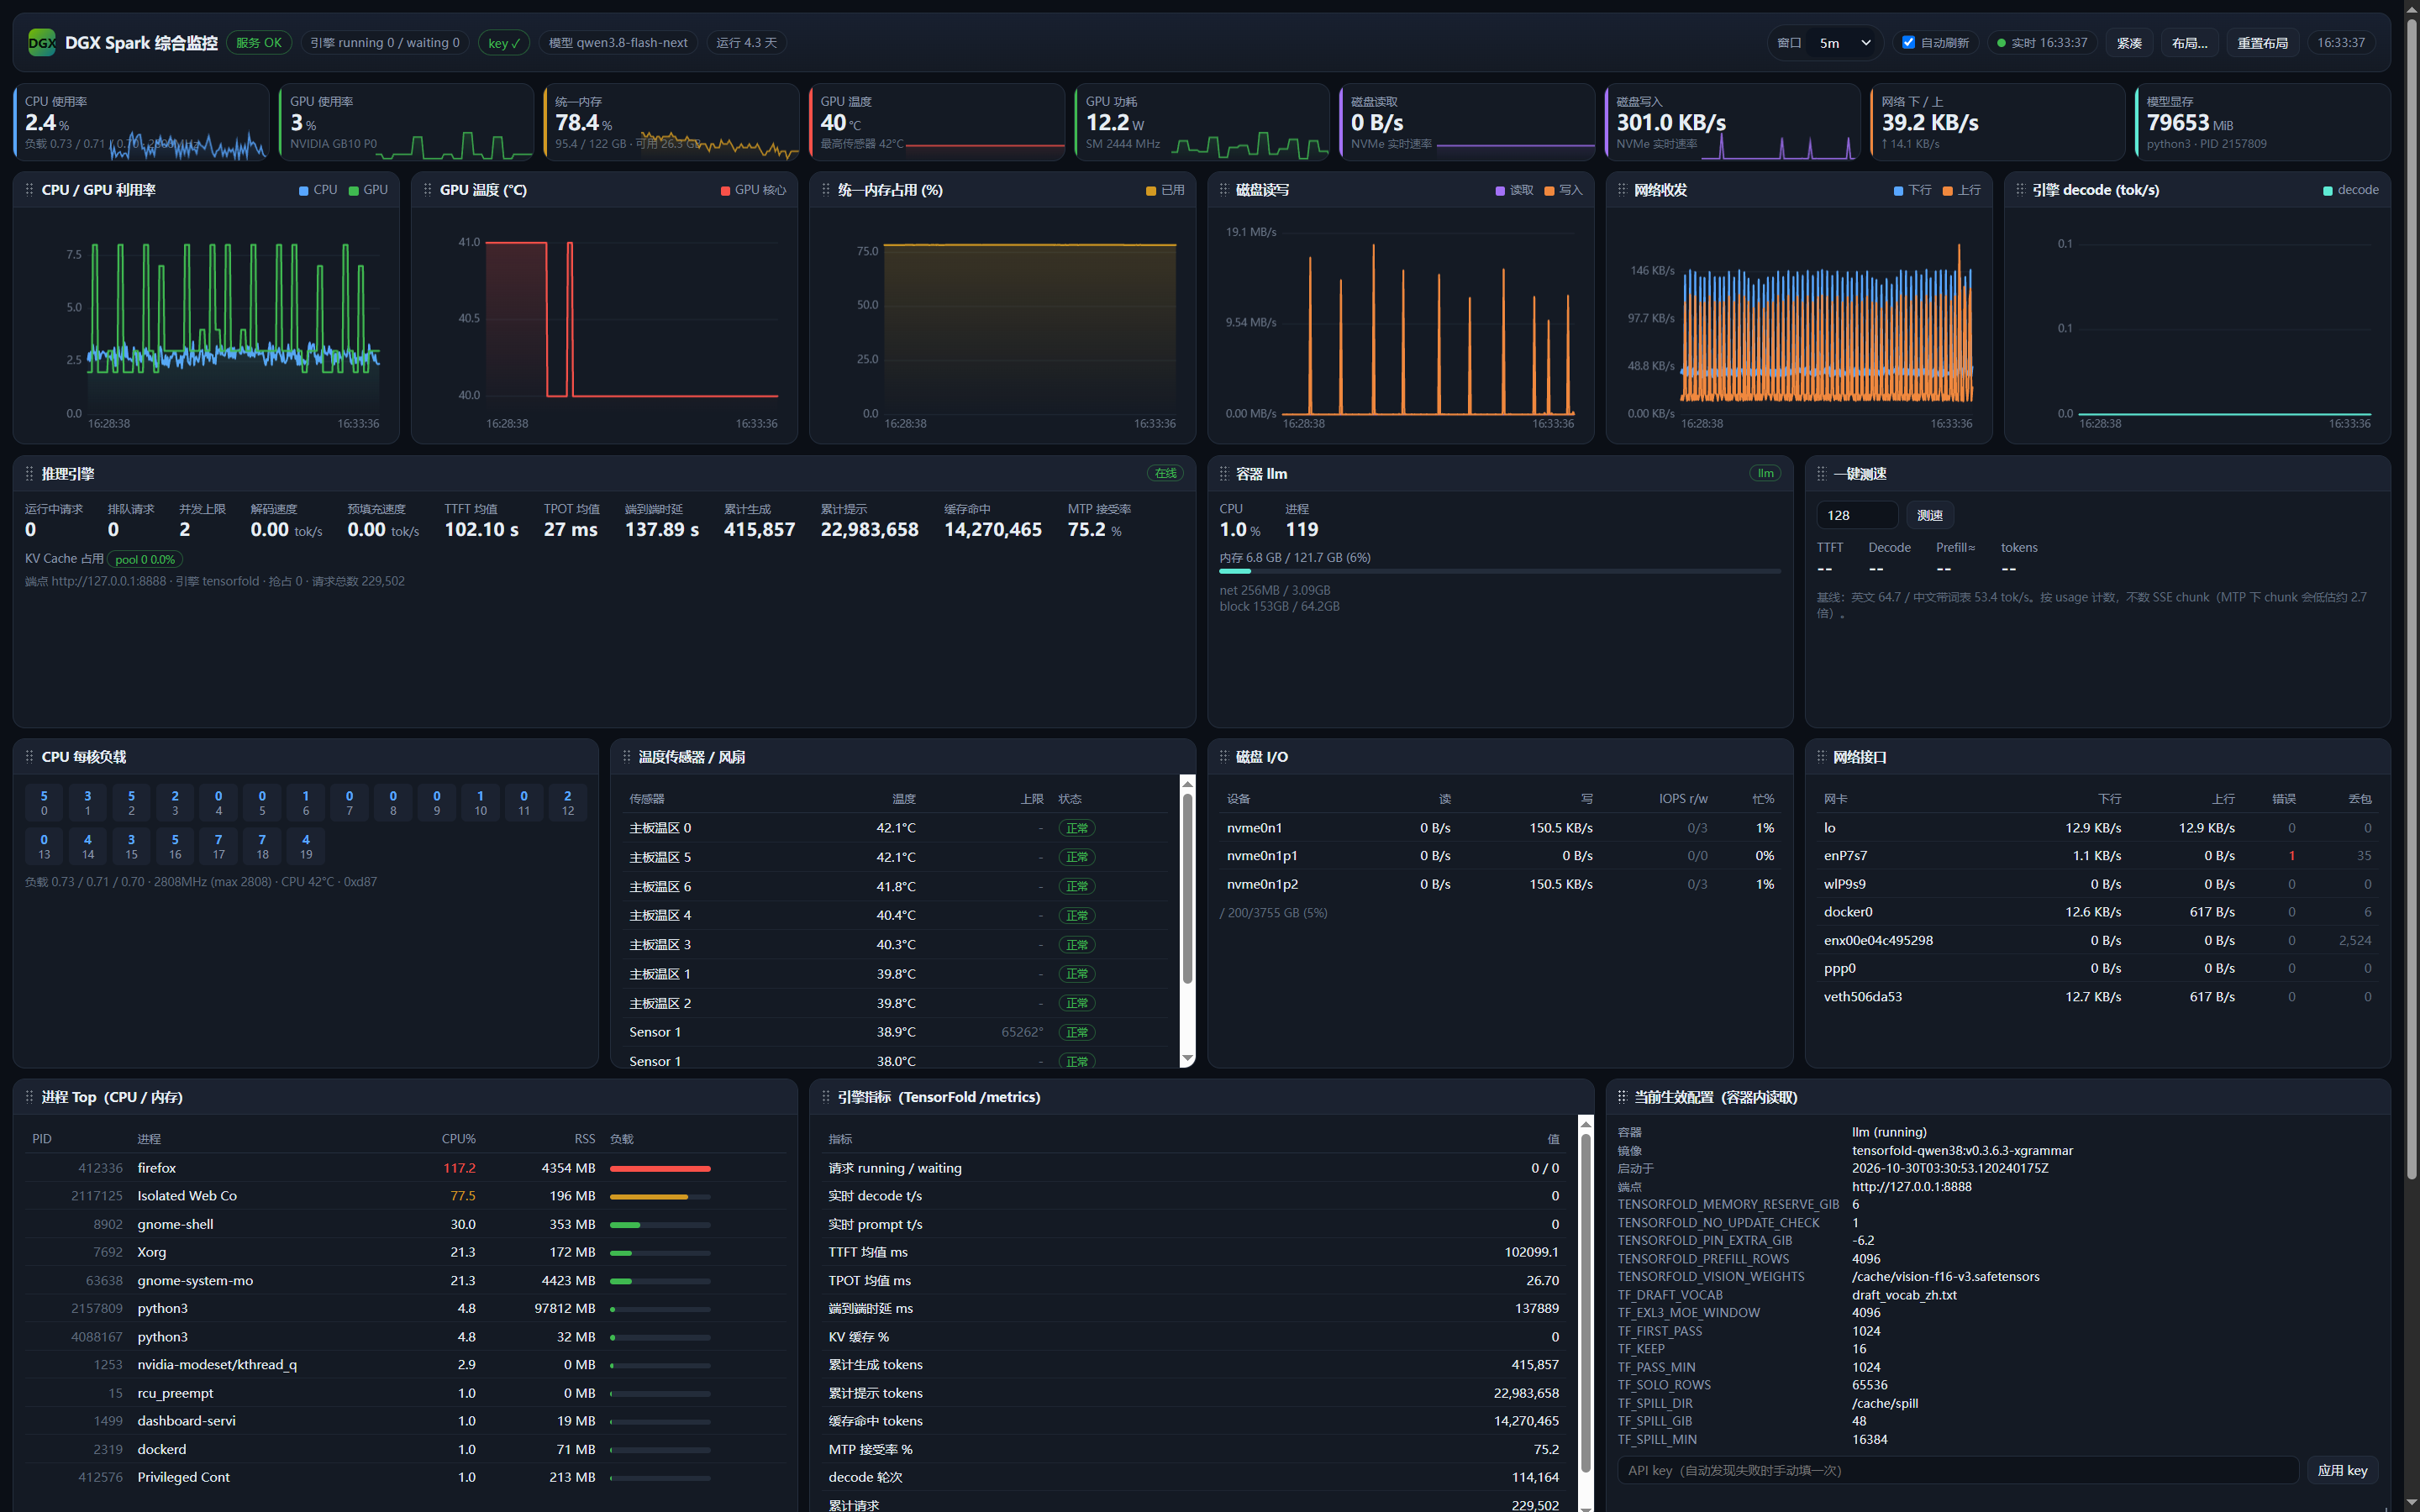
DGX Spark + TensorFold/SparkFold 跑 Qwen3.8-Flash-Next 完整实战:EXL3 4.05bpw 由 18 个补丁到中文 draft 词表,decode 64.7 tok/s(附全套 benchmark)
沿着 dgx-spark-llm-serving-main 仓库 lanes/exl3-sparkfold 这条路线,我在 DGX Spark 上从零跑了一遍完整 setup(2026-10-29 部署完成,服务在跑),顺便做了全套 benchmark 和中文 draft 词表的 A/B 实测。有几个发现(尤其中文词表那 part)想还回来给社群。
一、硬件
- DGX Spark:GB10(sm_121a)、128 GB 统一内存、aarch64,Docker 带 NVIDIA runtime
- 根分区 3.7 T,这条 lane 共占 173 G:
~/models/qwen3.8-flash-next-exl3-4.05bpw    101 G   权重
~/.cache/tensorfold-sparkfold               967 M   扩展缓存 + 视觉权重
~/tensorfold-src                             25 M   打补丁的源码树
~/src                                       ~70 M   上游配方 + TensorFold tarball
/var/lib/docker                             ~70 G   镜像
- 前置条件(
01-healthcheck.sh只读体检,不要跳过):可用统一内存 ≥ 121 GiB、磁盘可用 ≥ 200 GiB(权重 100 + 缓存 + spill 最多 48)、docker info能看到 NVIDIA runtime。
二、软件栈和安装
- 引擎:TensorFold 0.6.5 + SparkFold
806b345+ 仓库 18 个补丁。这条 lane 的全部价值来自那 18 个补丁——仓库记录过未打补丁时英文 decode 42.6 tok/s vs 打完 62.9,不要用未经补丁的 SparkFold 跑。 - 镜像:
tensorfold-qwen38:v0.3.6.3(MiaAI-Lab 封装)再叠一层xgrammar(response_format/ 结构化输出)→tensorfold-qwen38:v0.3.6.3-xgrammar(36.9 GB,tf.patches=c1f5d72f8d16)。 - 部署脚本全部做成幂等,失败重跑即可;都支持
DRY_RUN=1打印将执行的命令。
cd ~/dgx-spark-deploy && chmod +x *.sh

bash 01-healthcheck.sh        # 只读体检,先做
bash 02-build-tree.sh         # SparkFold 806b345 + 18 补丁 → ~/tensorfold-src
bash 03-build-image.sh        # 两层镜像(v0.3.6.3 → v0.3.6.3-xgrammar)
bash 04-download-pack.sh      # 权重 99.94 GiB:钉 commit sha + 逐文件 size + SHA-256 校验
bash 05-vision.sh             # 视觉权重转换(可选,VISION=0 就跳过)
bash 05b-draft-vocab-zh.sh    # 构造中文 draft 词表(中文场景建议做,见第七节)
bash 06-start.sh              # 启动(封装仓库的 start.sh,不重新实现启动逻辑)
bash 07-smoke.sh              # 冒烟 + 中英文基准(RUN_BENCH=1 附带仓库的 bench_en.py)
全新机器先跑
bash 00-bootstrap.sh:检查并补齐 Docker / NVIDIA Container Toolkit /hfCLI,已装的一律跳过,最后一步跑 GPU 容器冒烟,确认容器里真能看到 GB10。
02-build-tree.sh末尾应显示spill.py 在位(补丁 0005)。
MiaAI-Lab 的prepare.sh第 3、4 步会下载该封装自己的 MLX checkpoint,本 lane 用不到;照跑是为了与上游保持一致。
三、两个必改的关键配置(今次分享重点之一)
3.1 内存地板 6 GiB —— 不是随便定的
TensorFold 0.6.5 的 stream cache 规则:只有当宿主机 MemAvailable 高于 max(4 GiB, RAM/10)(本机 = 12.2 GiB)再加 2 GiB 时才允许增长,否则直接丢掉一条空闲对话的整个状态。而 Spark 服务这个模型时空载只有约 15 GiB 可用——于是一条长对话会把另一条挤掉,每一轮都变成冷 prefill。
仓库的对照实验(三条对话轮流,16 token 回复):
| 内存地板 | 后面几轮从零重新 prefill 的次数 |
|---|---|
| 12.2 GiB(引擎默认) | 8 轮里 7 轮(丢了 409 s 的 prefill) |
6 GiB(TENSORFOLD_MEMORY_RESERVE_GIB=6) |
9 轮里 0 轮 |
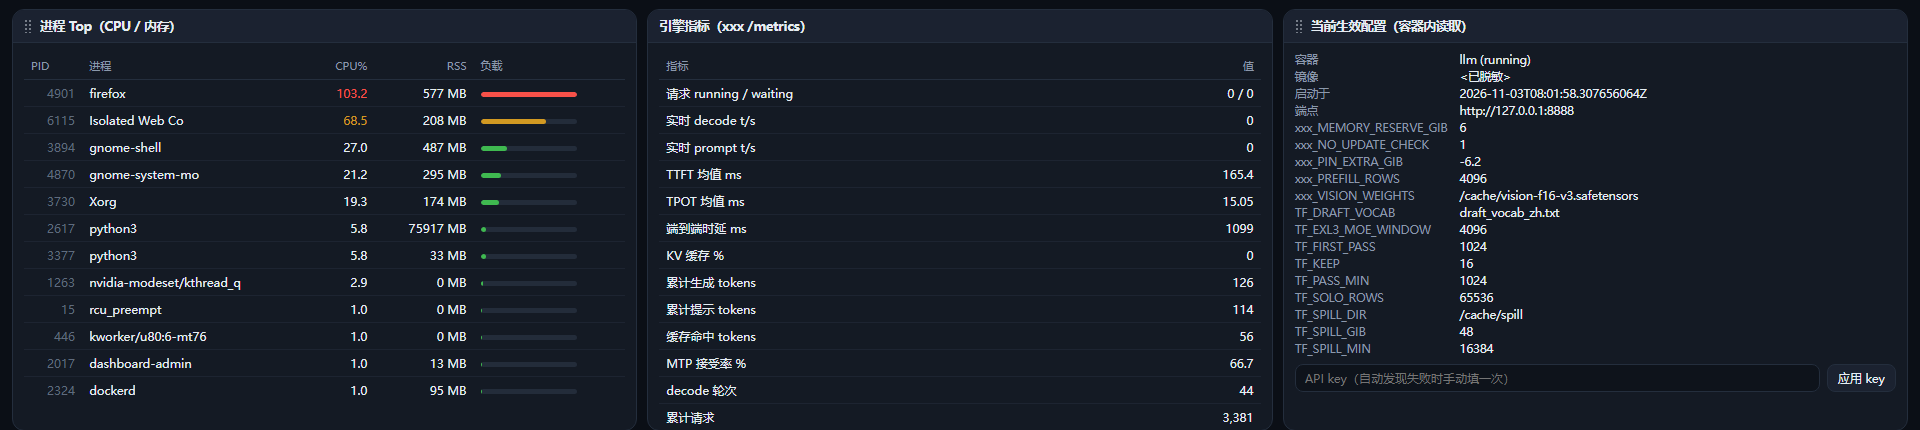
代价:到 earlyoom SIGTERM 线(RAM 的 3% = 3.6 GiB)的余量从约 11 GiB 降到约 5 GiB。所以不要把 n-gram 表全锁住——仓库记录过 TENSORFOLD_PIN_EXTRA_GIB=12(锁 36 GiB)会让 earlyoom 直接 SIGKILL 掉服务。当前配置 PIN_EXTRA_GIB=-6.2,让锁页量维持在 20-25 GiB。
3.2 NVMe spill —— 救 evicted 的对话,不是加速
TF_SPILL_DIR=/cache/spill,只写 ≥ 16384 token 的状态,目录上限 48 GiB,LRU 淘汰。仓库实测:100k token 的状态约 1.5-1.8 GiB,写 0.30-0.40 s,读 0.26-0.45 s。
它只在对话被挤掉时救命。内存够时它什么都不做,也不带来加速。仓库明确写:只在受控重放里验证过,没有在真实流量上验证过——当成便宜的保险,不要当成实测收益。
四、模型
turboderp/Qwen3.8-Flash-Next-exl3,分支 4.05bpw_h6_ng6,EXL3 4.05 bpw,125B 总参 / 6B 激活,99.94 GiB。
本机校验结果:26 个文件的 size + SHA-256 与 Hub 逐个一致,实下 100.08 GiB(trunk 62.9 GiB / n-gram 表 36.36 GiB / 视觉 0.52 GiB,与仓库记录逐项吻合)。
为什么必须逐文件校验:仓库的 vLLM lane 明确记录过——大小对但内容截断的 shard 能正常加载、报告出合理的 shape、产出量级正确的激活值,然后生成通顺但完全错误的输出。不崩溃,不报错,只是不对。有人为这个丢了一天。
另两个硬坑(与网络无关,但必须钉住版本):
- 上游封装仓库(MiaAI-Lab)的
main已换成 Zig 原生引擎,与本 lane 的 Python 引擎不兼容。必须用 commit38da375e5f4a0be0ed4c065d1014f61088e0a9e4(2026-09-29,最后一个 Python 引擎 + TensorFold v0.3.6.3 版本)。这个 commit 是对的,有硬证据:它的补丁集 hash 是c1f5d72f8d16,与仓库 README 记录的镜像标签tf.patches=c1f5d72f8d16一字不差。 04-download-pack.sh会先把分支名解析成 commit sha 再下载,钉住版本、可复现,并逐文件比对 size + SHA-256——照做就行。
五、生产启动配置(全套)
06-start.sh 透传给仓库 start.sh:
| 变量 | 默认 | 说明 |
|---|---|---|
PROFILE |
spark |
safe = 旧解码策略(A/B 对照用);bare = 引擎默认值 |
SPILL |
1 |
NVMe spill。SPILL=0 关掉 |
VISION |
1 |
多模态。VISION=0 关掉 |
PARALLEL |
5 |
并发流数 |
CONTEXT |
262144 |
上下文长度 |
KV_DTYPE |
int8 |
KV 精度 |
PORT |
8888 |
端口 |
BIND |
127.0.0.1 |
监听地址。BIND=(空)= 所有网卡 |
KNOBS |
— | 追加任意 TF_*,如 KNOBS="TF_KEEP=32" |
KNOBS="TF_DRAFT_VOCAB=draft_vocab_zh.txt" bash 06-start.sh   # 中文词表(推荐)
PROFILE=safe bash 06-start.sh            # 对照组
VISION=0 SPILL=0 bash 06-start.sh        # 纯文本、不落 NVMe
BIND= bash 06-start.sh                   # 对外提供服务(服务没有 API key,不要暴露到不可信网络)
启动日志里应该看到这四行:
lone-stream graph slot: 65536 rows
spill: N stored states adopted
... GiB of pages locked            <- 本机实测 "22.0 GiB of it locked"(仓库记录 20-25 GiB)
serving qwen3.8-flash-next ... loaded in ~90s
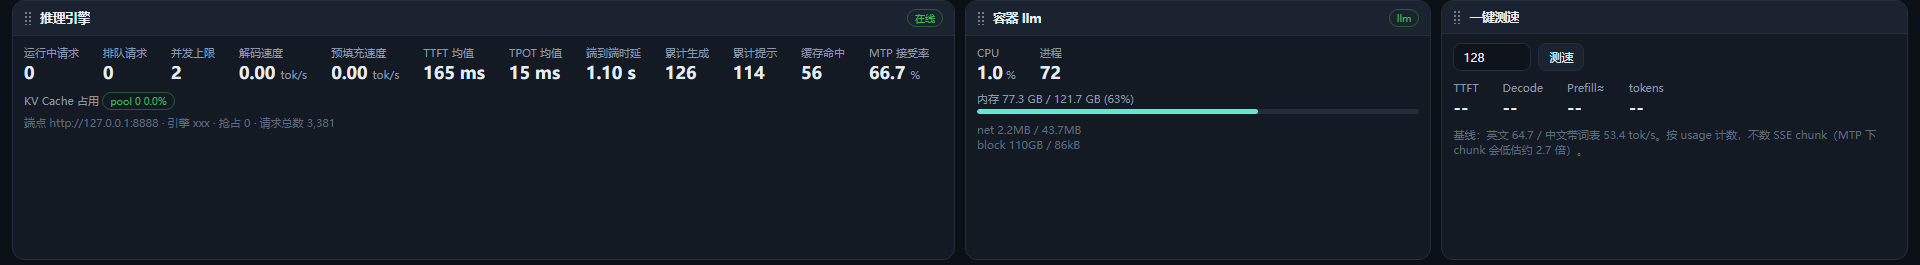
首次启动要编译 CUDA/Triton 扩展(本机 260 s),之后重启 73.8 s。脚本会等到 /health 有响应(最多 15 分钟)。服务在 127.0.0.1:8888。
常用操作:
bash 07-smoke.sh                              # 冒烟 + 中英文基准
docker logs -f llm                            # 看日志
docker exec llm env | grep TF_DRAFT_VOCAB     # 确认实际生效的词表
日志目录 ~/.cache/tensorfold-sparkfold/logs/。仓库的 start.sh 会 docker rm -f 旧容器、日志随之消失,所以 06-start.sh 现在重启前会先把旧日志备份进去。
六、Benchmark(本机 2026-10-29 vs 仓库基线 2026-10-21)
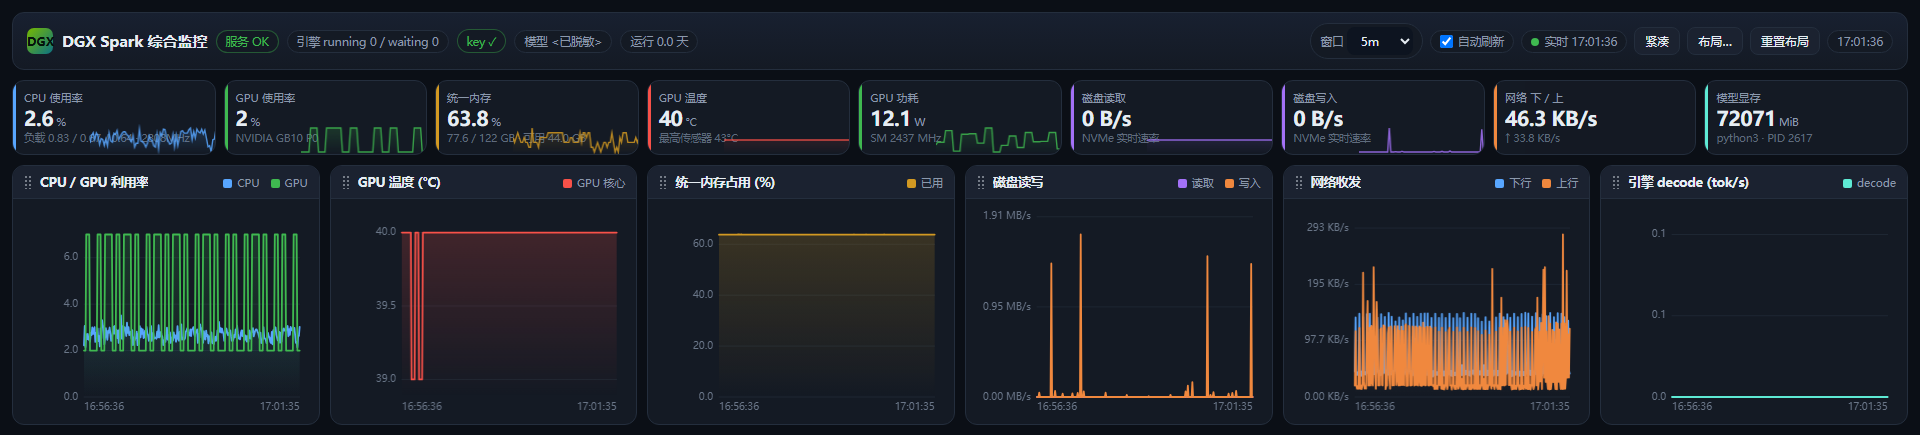
Decode 单流: 英文 64.7 tok/s(69.12 / 68.72 / 55.50 / 65.54 四条提示均值)vs 仓库 62.9——同一套构建,吻合。中文装词表 53.4、不装 38.9(见第七节);仓库韩文基线 54.1。
并发: 仓库 sgbench 端到端 1 / 2 / 4 流 = 66.9 / 92.1 / 131.1 tok/s;llama-benchy decode(深度 0)1 / 2 / 4 流 = 61.7 / 89.5 / 112.2 tok/s。本机只测了单流,多流并发没有测。
Prefill(冷启动): 1.9k-49k token 真实文本 1,830-2,067 tok/s(仓库)。
Spill 还原: 100k 对话被挤掉后,冷启 40-50 s vs 从 NVMe 还原 0.8-2.3 s(仓库)。
工具调用: tool-eval-bench 90/100(装 xgrammar 后,仓库)。
关键校验(本机):
- 权重:26 个文件 size + SHA-256 逐个一致,100.08 GiB
- 源码树:18 个补丁提交全在,
draft_vocab_ko.txt86,232 行(与仓库记录一字不差) - 镜像:
tf.patches=c1f5d72f8d16(与仓库 README 记录一致) - 引擎启动:22.0 GiB locked、84 个图、spill 目录 48 GiB、视觉塔 0.84 GiB
没测的(诚实清单): 中文质量没有基线(仓库对韩文质量和长工具上下文质量也明确没测过,速度追平 ≠ 质量追平,需要自己评估);多流并发;视觉输入(权重转换好了、引擎起来了,但没实际发过图片)。
七、中文 draft 词表 A/B 实测(新发现)
背景:MTP 投机解码的 drafter 只能从一张候选 token 列表里挑下一个 token。引擎自带的那张列表来自 CPython 标准库和 id < 65,536:
| 覆盖 | 比例 |
|---|---|
| 代码 / Markdown token | 99.3-99.5% |
| 英文散文 token | 93.9% |
| 韩文 token | 47.5% |
中文比韩文更糟。 这张表基本全是 ASCII,而 Qwen 分词器里绝大多数汉字 token 的 id 都 ≥ 65,536——它们根本不在候选表里。drafter 看不见中文 token,中文的投机接受率会很低,而 decode 速率基本就是"不投机"的速度。
上游其实已经做了中文版(MiaAI-Lab 的语言补丁带 draft_vocab_zh.txt,22,088 个纯汉字 token id),但那是替换语义——上游 README 明写 "English and code get a little slower with it"。本 lane 的 TF_DRAFT_VOCAB 是并集语义(仓库补丁 0009 的韩文表就是这么做的,补齐后英文贪心回复逐字节不变)。所以 05b-draft-vocab-zh.sh 取的是 并集:引擎默认表 ∪ 上游汉字 id = 101,679 个 id(默认 79,591 + 汉字 22,088)。中文拿到全部候选,英文和代码不受影响。
A/B(同一套构建、同一批中文提示、同一份 server 配置,只换 TF_DRAFT_VOCAB):
| 词表 | ZH-HIST | ZH-SCI | ZH-ADV | 均值 |
|---|---|---|---|---|
draft_vocab_ko.txt(仓库默认,不含汉字) |
34.38 | 42.80 | 39.52 | 38.90 |
draft_vocab_zh.txt(默认表 ∪ 汉字) |
50.40 | 55.96 | 53.68 | 53.35 |
+37.1%。 仓库测韩文时是 42 → 49(+17%),中文的增幅更大——因为默认表里汉字的覆盖率比谚文还低。旁证:每 chunk 的 token 数从 1.20-1.59 升到 1.88-2.11,也就是 MTP 接受率上去了,这正是 draft 词表该起的作用。对照仓库韩文基线 54.1:中文词表装上之后,中文追平韩文。
基准方法(tools/bench_zh.py,与仓库 bench_ko.py 同构):走 /v1/chat/completions,不覆盖采样参数(用服务端默认),thinking 打开,三条中文长句提示(历史散文 / 科学解释 / 现实建议),600 token 是测量窗口不是服务上限,流式测量、用首末 chunk 之间的时间把 decode 从 prefill 里分出来。
复现:
cd ~/dgx-spark-deploy
# A:仓库默认(不含汉字)
KNOBS="TF_DRAFT_VOCAB=draft_vocab_ko.txt" bash 06-start.sh
BENCH_MODEL=qwen3.8-flash-next BENCH_URL=http://127.0.0.1:8888/v1/chat/completions \
  python3 tools/bench_zh.py
# B:中文并集表
KNOBS="TF_DRAFT_VOCAB=draft_vocab_zh.txt" bash 06-start.sh
BENCH_MODEL=qwen3.8-flash-next BENCH_URL=http://127.0.0.1:8888/v1/chat/completions \
  python3 tools/bench_zh.py
要注意的取舍:
- 只影响速度,不影响质量。 draft 出来的 token 要经过验证才被采纳,换词表不会改变回复内容(仓库对韩文验证过"英文贪心回复逐字节相同")。
- 一次只认一个词表。
TF_DRAFT_VOCAB是一个文件名,韩文表和中文表不要同时用;中文表取的是并集,换过去不会丢掉英文/代码的覆盖。 06-start.sh会把仓库默认的韩文表和 KNOBS 一起传给 docker,同名变量以最后一个为准;用docker exec llm env | grep TF_DRAFT_VOCAB确认实际生效值。
八、陷阱清单
- 未打补丁的 SparkFold 千万别跑:英文 decode 42.6 vs 打完补丁 62.9,差一半。
- 权重必须逐文件 SHA-256 校验:截断的 shard 不崩溃、不报错,只是生成"通顺但完全错误"的输出。
- n-gram 表千万别全锁:
TENSORFOLD_PIN_EXTRA_GIB=12(锁 36 GiB)→ earlyoom 直接 SIGKILL 服务。 set -e+pipefail会让脚本静默死掉:grep没匹配 → 退出 1 → 管道非 0 → 脚本被杀,什么错误信息都没有。07-smoke.sh就这么死过一次(引擎的锁页日志是 "22.0 GiB of it locked",不是仓库旧版的 "pages locked")。凡是grep ... | ...形式的输出行,后面都要|| true。- 上游封装仓库的
main已换成 Zig 引擎:必须钉 commit38da375e…(补丁集 hashc1f5d72f8d16对得上镜像标签,是硬证据)。 - 仓库
start.sh会docker rm -f旧容器,日志随之消失——06-start.sh已改成先把日志备份到$CACHE/logs/再重启。 - 第一条回复特别慢是正常的:另一个 graph 槽位首次解码要多花 0.6-1.6 s,第二次就正常。
- 本 lane 不主打 prefix caching:重复前缀不保证命中,与 vLLM lane 不同。
- 服务没有 API key:
BIND=对外监听只可以在可信局域网里用。 - 对话每轮都重新 prefill 多半是内存地板问题:看日志里
memory gate evicted ...,确认TENSORFOLD_MEMORY_RESERVE_GIB=6。
致谢
dgx-spark-llm-serving 仓库(lanes/exl3-sparkfold)的前辈记录、turboderp 的 EXL3 权重、MiaAI-Lab 的封装与上游语言补丁、TensorFold / SparkFold。中文质量评估如果有人焗到更深,欢迎交流。
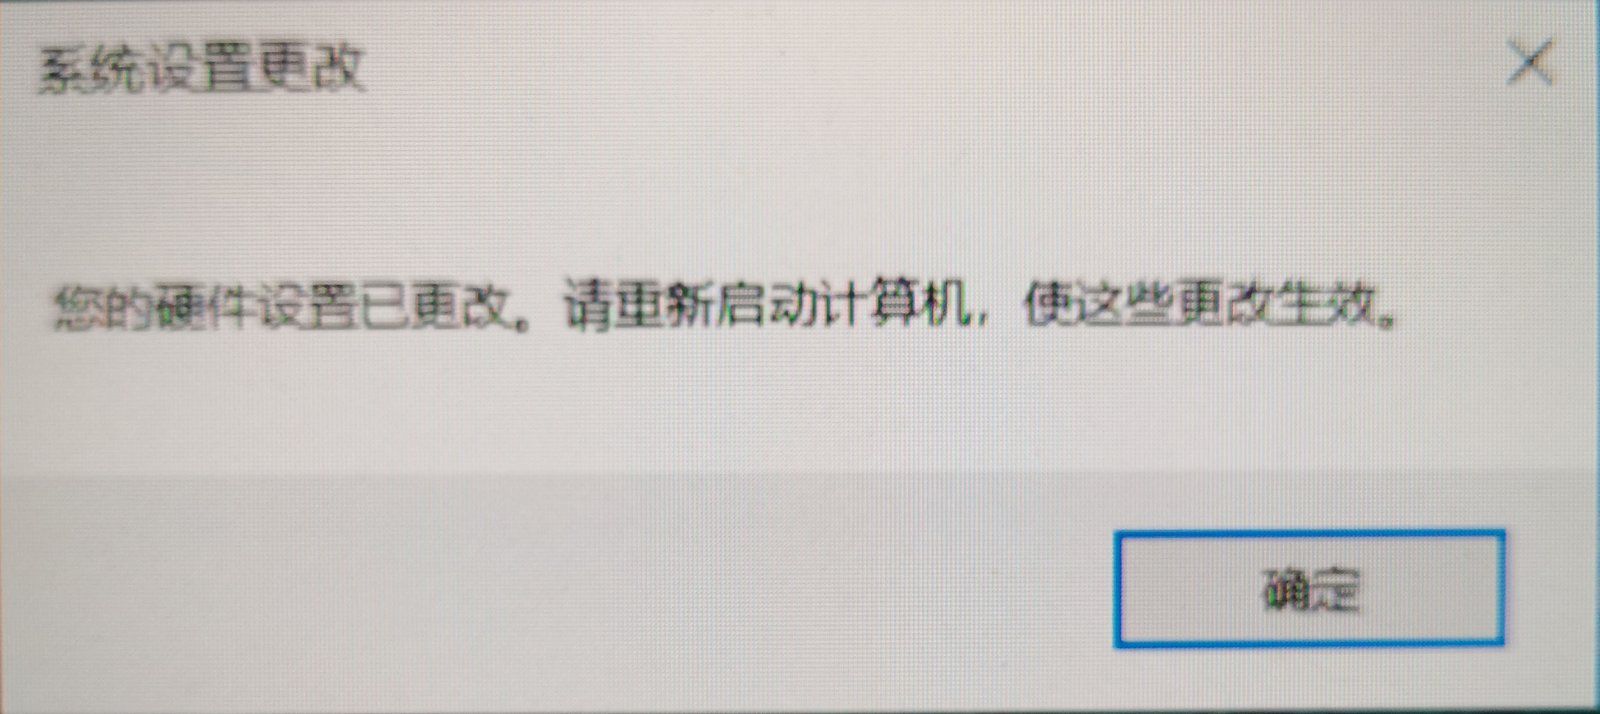
 「系统设置更改」照弹
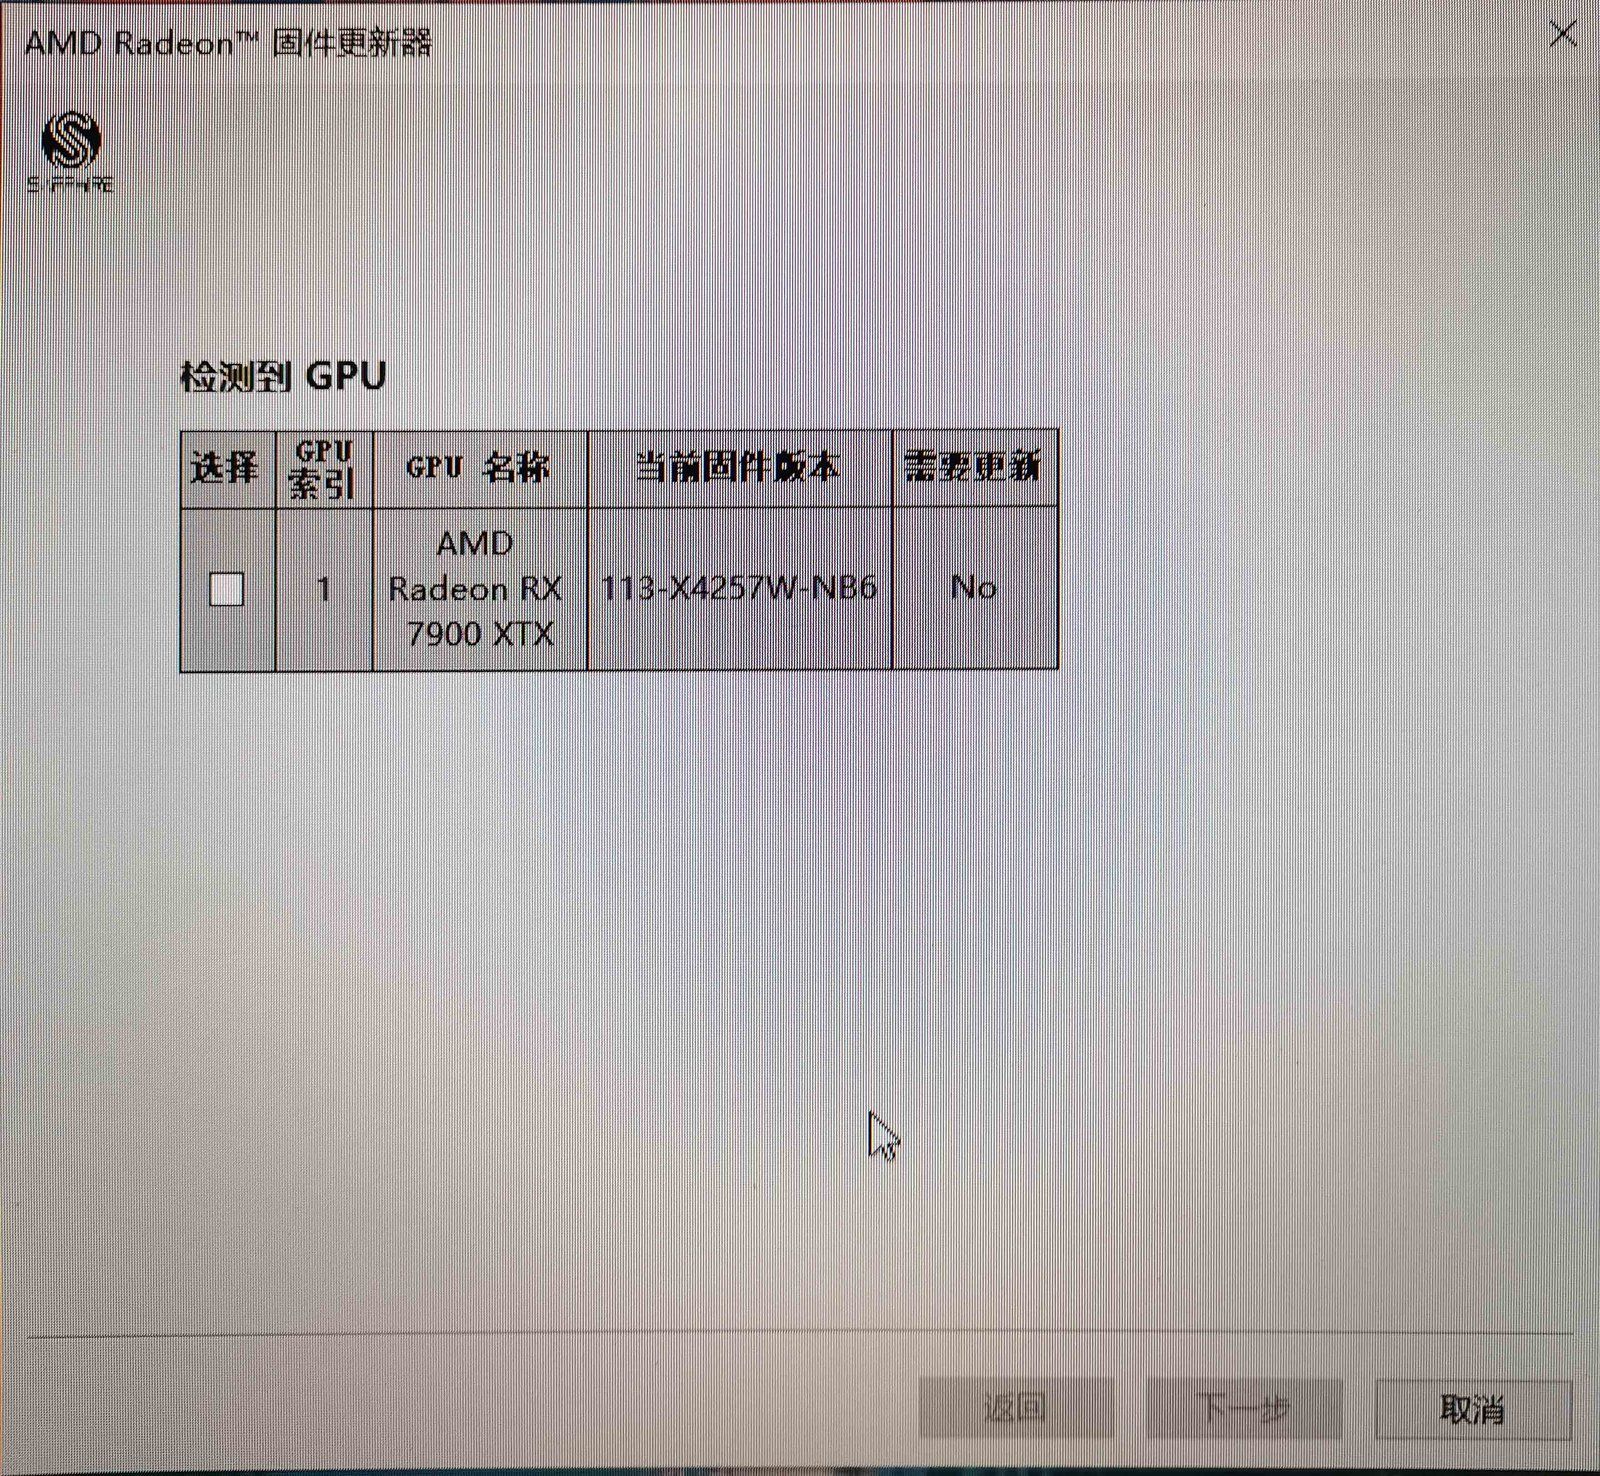
 ️ BIOS 乱码消失了,但「系统设置更改」依旧在
 答复两条路:要么返厂,要么自己备份旧固件重刷回去