论坛第一帖,初来乍到,希望能和各位大佬多多分享、交流学习!

新人发帖,难免有不足之处,还请大家多多包涵,轻喷轻喷!

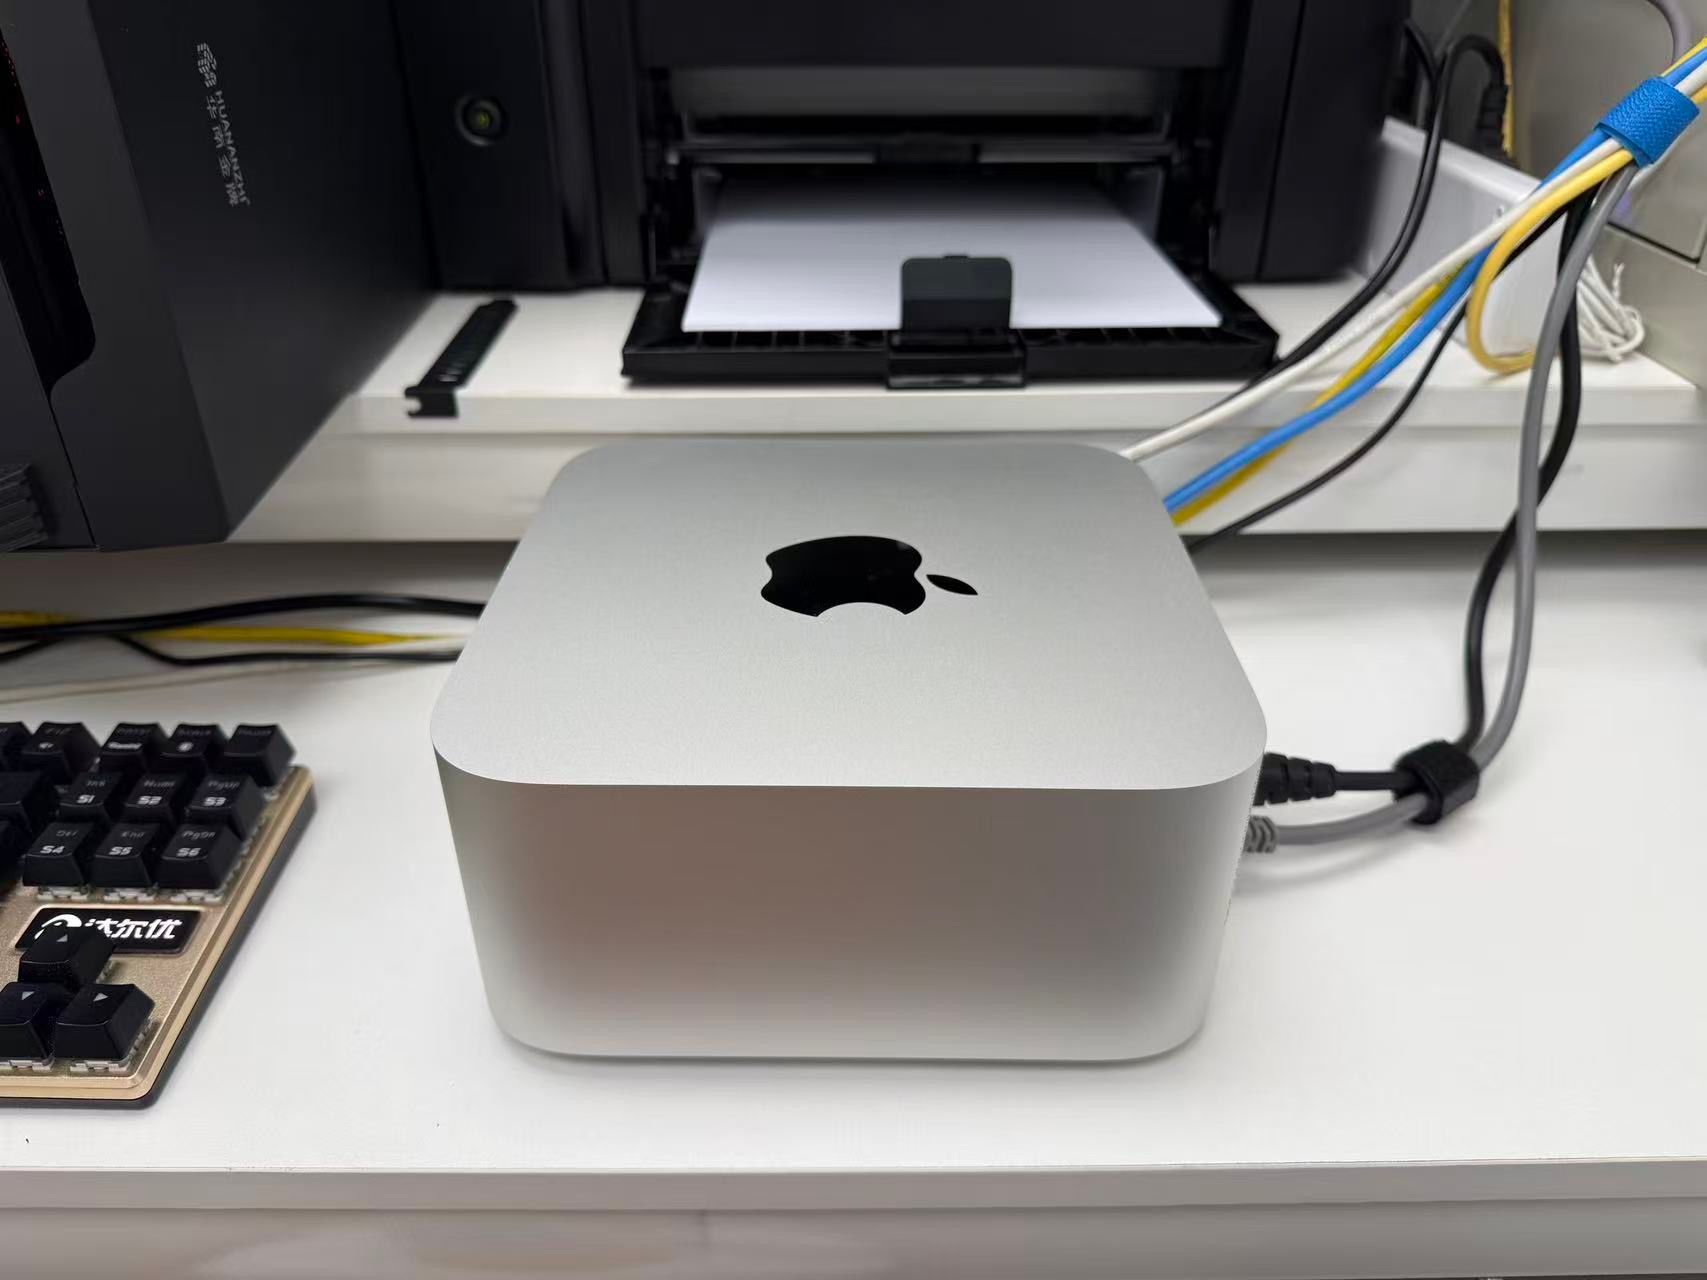
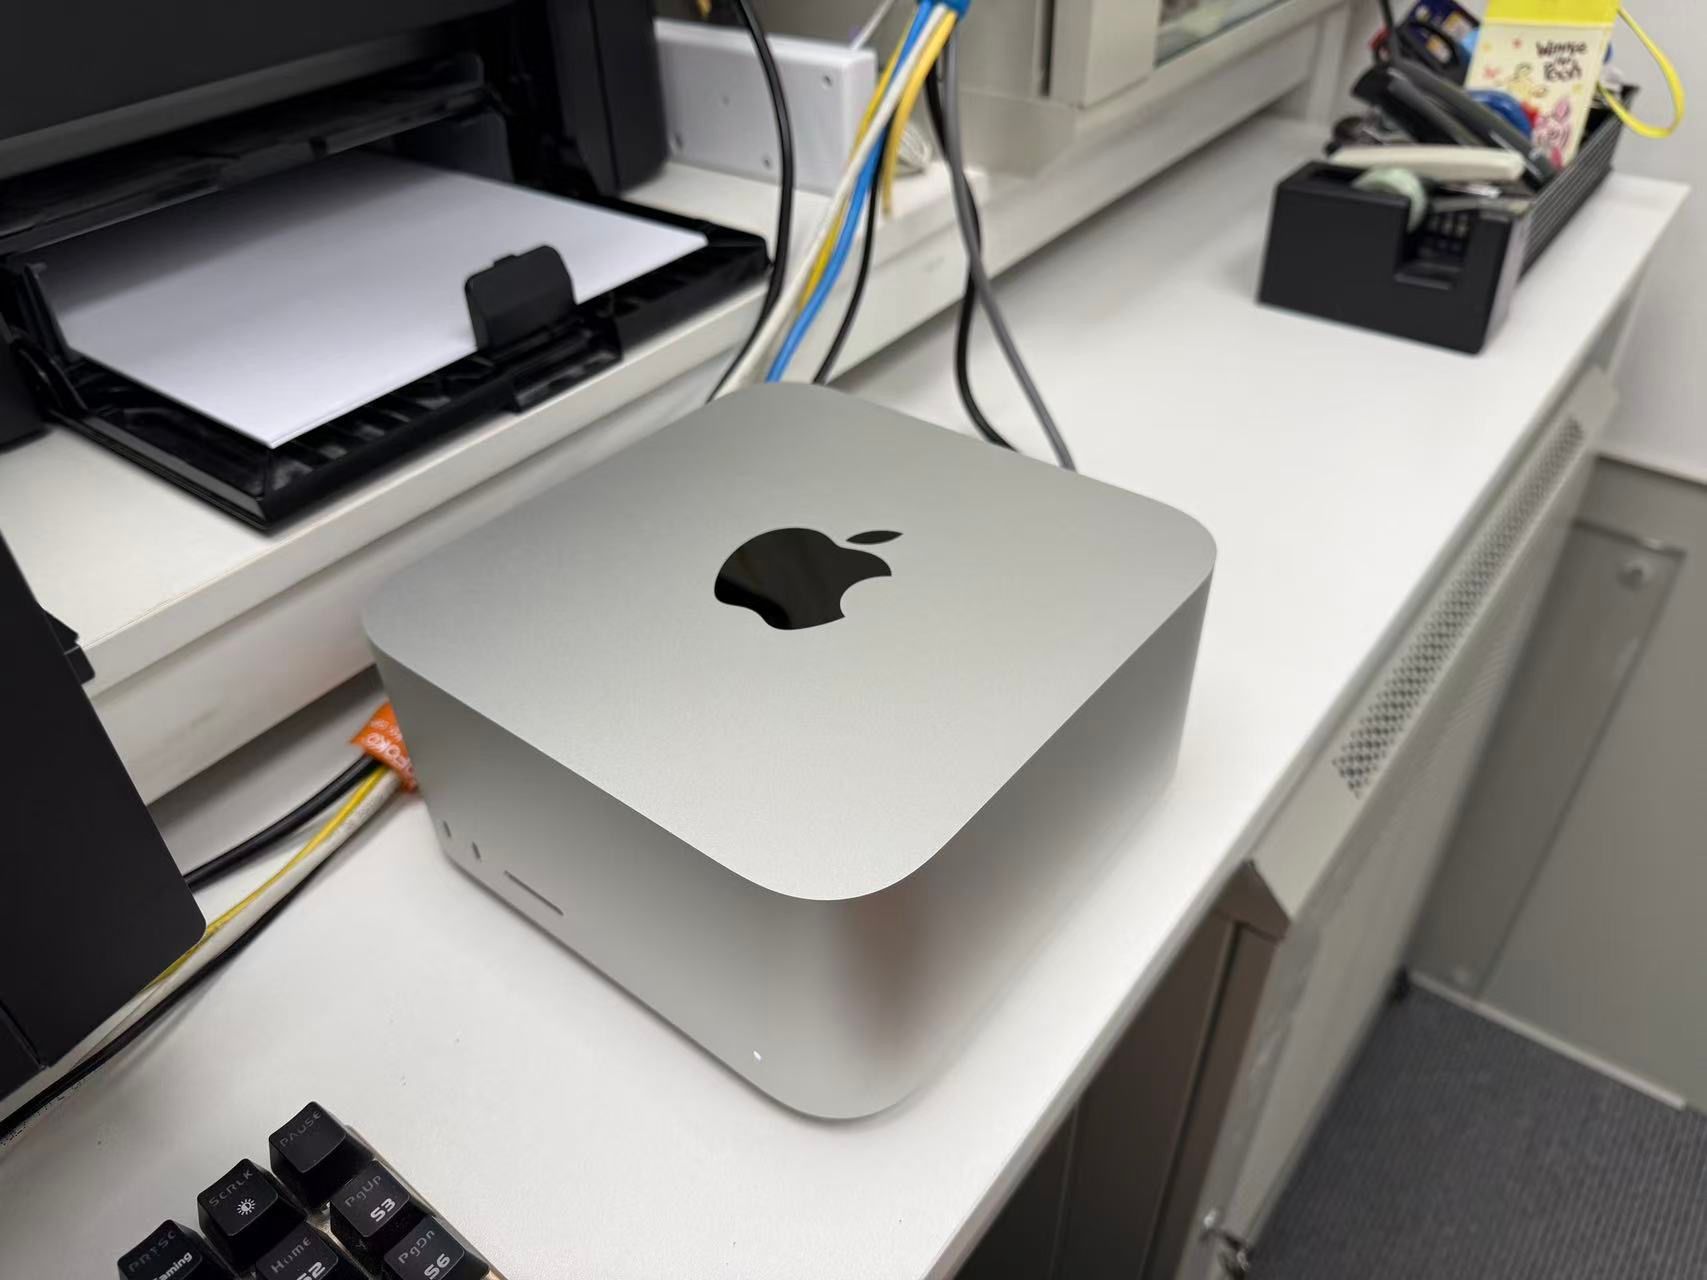
10天前拿到mac studio m5 ultra 256G 64GPU 几乎搜遍了现在全网所有m5的优化方案, 推理引擎选择omlx ,主要是因为底子好,缓存优化,算子开箱即用,基本上也是最优了. 起点高了后期优化更加游刃有余, 不用重复造轮子.
优化过程总结:
qwen3.8 flash next 优化方案很多, 权重全部驻留内存, 开箱成绩已经很好了, 稍微优化一下缓存, 成绩持平并且小幅领先网上公布的 m5 ultra 80GPU 的成绩.
deepseek v4.1 flash 的优化过程就多了一点点曲折, 主要优化工作都花在内存的管理. 得益于这代mac studio 挤破牙膏的SSD 升级, 磁盘读写性能达到13GB/s , v4.1 的engram 全部使用SSD卸载+异步预读, 对性能的影响可以忽略不计. 模型权重元数据无损压缩又减少7.9G, 这样内存常驻优化到了216G, 注意这是平均q3.5级别的权重! 552B总参数, 完整保留dspark和视觉, 跑这个模型我想不出比m5ultra更具性价比的方案了.
最后是测试总结. 稍后我还想开贴详细描述一下优化过程, 我也会把代码放上github.
以下按 2026-10-08 已完成的最终验收记录整理。
模型权重卡片
| 项目 |
DeepSeek V4.1 Flash LSQ |
Qwen3.8 Flash Next oQ6e MTP |
| 权重 |
本地 DeepSeek-V4.1-Flash-LSQ3-G128-MLX,从官方固定版本重建 |
mlx-community/oQ6e-mtp 权重卡 |
| 参数口径 |
552B 主干+196B Engram;预填充激活约 8B,解码约 16B |
125B 主干+51B n-gram+4B MTP,完整包约 180B;激活约 6B。官方卡 |
| 量化 |
主专家 LSQ 3-bit/G128,其他模块混合精度;完整保留 DSpark 和视觉 |
oQe imatrix,默认 6-bit/G64;部分模块采用 8-bit 或其他分组,保留 MTP |
| 本地权重体积 |
412.61 GiB,含 Engram;优化后非 Engram 常驻权重 215.58 GiB |
140.11 GiB,28 个 safetensors 分片 |
DeepSeek 的体积和转换口径见权重证据。
推理框架与关键配置
共同测试机器为 Apple M5 Ultra,30 核 CPU、64 核 GPU、256 GiB 统一内存,macOS 27.0.1。
| 配置 |
DeepSeek |
Qwen |
| 框架 |
oMLX 0.7.0.dev4+tacos8me 补丁;MLX 0.32.3 dev;核心提交 78a5a474 |
oMLX 0.7.0+社区补丁;MLX 0.32.2;核心提交 d542b0da |
| MTP |
DSpark 开启,每轮草稿 4 tokens,异步执行 |
fixed depth 3+P2 prompt lookup |
| 权重驻留 |
主模型、DSpark、视觉驻留;Engram 大表在 SSD |
专家、PLE/ngram 全部驻留 |
| 预填充分块 |
8192 tokens |
8192 tokens,缓存边界可能进一步切分 |
| 服务上下文上限 |
1,048,576 tokens |
262,144 tokens |
| 最新服务 |
并发上限 8;3 GiB 精确前缀缓存,支持重启恢复 |
并发上限 8;8K 快照+尾部/公共前缀缓存,SSD 缓存预算 50GB |
| 内存保护 |
进程与 wired 上限 240 GiB |
进程保护 232 GiB,wired 上限 240 GiB |
正式性能计时使用 temperature=0;Qwen 关闭 thinking,当前日常服务默认 temperature=1。
定制优化的简单概况
- **DeepSeek:**无损压缩量化元数据,并在 Metal 内核中直接恢复计算;配合 CED、异步 DSpark 和精确前缀缓存。常驻权重减少 7.90 GiB,最后一轮预填充优化提升约 4.21%。
- **Qwen:**采用 QSA/NAX、固定深度 MTP 和提示词匹配,再保存真实 GDN 尾部及公共前缀状态,减少重复预填充。最终选择 PLE 全驻留方案。
最终性能数据
下面是预热后、无前缀命中、单请求、每次生成 512 tokens的结果。DeepSeek 使用几何平均,Qwen 使用中位数;提示词不同,不构成严格的模型间对照。
| 模型及测试口径 |
输入长度 |
Prefill tokens/s |
Decode tokens/s |
首 token 延迟 |
| DeepSeek,三场景综合 |
8K |
2196.22 |
76.07 |
3.774 s |
| DeepSeek,代码场景 |
16K |
2203.40 |
94.40 |
7.495 s |
| DeepSeek,代码场景 |
32K |
2194.11 |
97.23 |
15.022 s |
| Qwen,完整串行矩阵 |
2K |
2812.28 |
143.45 |
0.736 s |
| Qwen,完整串行矩阵 |
8K |
3884.35 |
134.54 |
2.128 s |
| Qwen,完整串行矩阵 |
32K |
3910.28 |
124.63 |
8.443 s |
| Qwen,最终前缀版本复核 |
32K |
3807.32 |
129.06 |
8.671 s |
DeepSeek 的 8K 三场景分别为代码 91.22、营销文本 71.59、视频/computer-use 计划文本 67.40 tokens/s。最终 A/B 共 32 次正式请求,另有 10 次热身。
Qwen 完整矩阵每组 5 次,采用 MTP+lookup 配置,测于前缀优化前;最终前缀版本的 32K 冷请求复核为 3 次。
缓存命中后的最终表现:
| 场景 |
冷请求 |
缓存命中后 |
实际复用 |
| DeepSeek,65,520-token 请求总耗时 |
43.682 s |
5.751 s;重启恢复后 4.588 s |
57,344 tokens |
| Qwen,7792-token 重复提示词 TTFT |
2.132 s |
0.160 s |
7785 tokens |
| Qwen,32K 重复提示词 TTFT |
8.671 s |
0.281 s |
32,761 tokens |
Qwen 最终缓存命中时,约 8K/32K 的解码速度分别为 146.18/138.11 tokens/s。
其他完成的测试:
- **内存:**DeepSeek 最终单请求 A/B 采样峰值最高 225.73 GiB;Qwen 前缀优化前完整运行峰值 158.83 GiB,最终前缀版本未重新采集峰值。
- **真实代码 Agent:**DeepSeek 的 Hermes/DSH 单项功能任务耗时分别为 158.37/302.99 秒,各自独立隐藏测试均 5/5 通过。
- **并发:**两组最新服务均通过 8 路请求及缓存回归;这些属于短请求正确性验收,尚无最终版本的持续 8 路吞吐基准。
更新 2026-10-10
Deepseek v4.1 flash 的量化权重上传至 huggingface
https://huggingface.co/gnahzhang/DeepSeek-V4.1-Flash-LSQ3-G128-MLX
本仓库发布已有的混合 LSQ3-G128 MLX 权重,并附加 120 个路由专家投影的精确元数据字典。原始量化有损;本次压缩对既有权重的 BF16 scale/bias 位模式逐位无损,整数权重编码不变。常驻模型张量从 223.481 降至 215.581 GiB,节省 7.900 GiB。发布包保留原始分片、SSD Engram 表及回退原件,因此下载总量为 420.53 GiB,不等于常驻内存大小。
Deepseek v4.1 flash 与 Qwen3.8 flash next oQ6 的复现代码也上传到了 github
https://github.com/gnahz/omlx-flash-optimizations