跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
S

simo9052

@simo9052
取消关注 关注
关于
帖子
5
主题
2
分享
0
群组
0
粉丝
0
关注
0

帖子

最新 最佳 有争议的

  • RTX 3080 20G 单卡跑 Qwen3.8-Flash-Next IQ2_XS:Strata 上机实测(128K 上下文 / int8 KV / MTP)
    S simo9052
    LLM讨论区 rtx3080 strata qwen-flash

    RTX 3080 20G 单卡跑 Qwen3.8-Flash-Next IQ2_XS:Strata 上机实测(128K 上下文 / int8 KV / MTP)

    發現一個有趣項目
    https://github.com/Niko1221/Strata

    我这边是一单张 3080 20G,用 Strata 把 IQ2_XS 量化版跑起来,对外提供 OpenAI 相容 API。这篇只写这台机器的配置、踩过的坑、以及目前验证到哪一步。

    一、机器与部署

    项目 配置
    主机 HP Z440,Xeon E5-2690 v4,Ubuntu 26.04.1,约 45 GiB RAM
    显卡 RTX 3080 20 GB,驱动 595.91.07
    引擎 Strata(main.zip 本机 CMake 编译,未记录 commit)
    权重 原版 Qwen3.8-Flash-Next IQ2_XS(纯文字),约 72 GB
    模型 ID qwen3.8-flash-next-iq2_xs
    API http://192.168.1.200:1234/v1(LAN 监听,API key 保存在权限 600 的配置里,不贴明文)
    上下文 131072 tokens;KV int8;MTP --spec 4(模型数据自带 MTP runtime)

    二、编译踩坑:CUDA 13.1 的 rsqrt 冲突

    GitHub 预编译 binary 当时下载 404,只能本机 CMake 编译。Ubuntu 26.04 的自动 CUDA 安装流程不适用,改用发行版仓库的 CUDA 13.1 编译器/运行库。

    第一次编译卡在一个很具体的坑:cuda-crt-13-1 13.1.115-0ubuntu1 的 rsqrt/rsqrtf 与 glibc 2.43 的 exception specification 冲突。对策是对 /usr/local/cuda-13.1/targets/x86_64-linux/include/crt/math_functions.h 的相关声明加 noexcept(true)(patch -b 留了 .orig 备份)。

    这是系统 CUDA header 的兼容性 workaround,套件更新会覆盖,别不确认就照搬到其他版本。相关 bug 报告:Ubuntu bug、NVIDIA forum。

    三、启动方式

    sudo systemd-run --unit=strata-trial \
      --property=User=simon \
      --property=WorkingDirectory=/home/simon/Strata-main \
      /home/simon/Strata-main/run-iq2_xs.sh
    

    注意这是 transient unit,systemctl is-enabled 返回 transient——不会随开机自启,重启后要另行启动(或日后做正式持久化 unit)。

    四、验证(2026-09-28)

    • 服务端 ss -ltn 显示 192.168.100.200:1234 监听;UFW inactive。
    • Windows 客户端 Test-NetConnection 192.168.100.200 -Port 1234 → TcpTestSucceeded: True。
    • 无 key 调 /v1/models 得 401;带 key 得模型 ID qwen3.8-flash-next-iq2_xs。
    • LAN 调 /v1/chat/completions(reasoning_effort=low、max_tokens=64)→ HTTP 200,finish_reason=stop;SSH 断开后仍可响应。
    • 短测资源占用:内存约 38/45 GiB,显存约 19761/20480 MiB,swap 约 1.2 MiB。
    • localhost 短测约 57.8 tokens/s。

    可重复的安全检查(key 自己填,别贴真实 key):

    systemctl status strata-trial.service
    ss -ltnp | grep ':1234'
    curl -sS -H 'Authorization: Bearer <STRATA_API_KEY>' http://192.168.100.200:1234/v1/models
    

    五、还没做的事(先把丑话说前面)

    1. 57.8 t/s 是短请求数字,不是长 context 的保证。 程序报 context 131072,但我还没送入接近 128K 的完整输入,也没测多并发。按论坛惯例,prefill/decode 分开测、冷缓存自证,才算数。
    2. IQ2_XS 权重 72 GB,显存 20G 装不下全部——这必然涉及 offload,长 ctx 下 decode 会被 PCIe + 内存带宽压住(小特在 KVMem 帖里说得很清楚:能跑通 ≠ 跑得快)。下一步补 nvidia-smi dmon 的 SM%/mem% 曲线。
    3. reasoning_effort=low 仍可能吃思考 tokens:早前 max_tokens=16 的测试只见到思考没有最终文字,那不是 API 故障,是思考预算把输出窗口吃光了。

    六、一句话总结

    单张 3080 20G 上,IQ2_XS + int8 KV + MTP4 + 128K 配置已经能稳定对外提供 API,短请求 ~58 t/s 日常够用;但「配了 128K」不等于「128K 全程稳定」,长输入实测和持久化 systemd unit 是接下来两件事。有 3080/3090 单卡想抄这套的,编译那个 rsqrt 坑和 transient unit 这两点先看完再动手。


  • RTX 3080 20GB 上以 256k / ~45 tk/s 运行 Qwen3.6-35B-A3B-Q4-K-M(ubuntu)
    S simo9052
    LLM讨论区 rtx3080 ubuntu

    我基本上是按照这个视频中的方法操作的:
    https://www.youtube.com/watch?v=8F_5pdcD3HY
    我没有 1:1 完全复制,而是以此为主要参考并根据我自己的机器进行了调整。

    我目前的配置:

    GPU: RTX 3080 20GB

    RAM: 15 GB

    CPU: i3-10100F

    llama.cpp: turboquant 编译版本
    https://github.com/TheTom/llama-cpp-turboquant

    模型 (Model): Qwen3.6-35B-A3B-UD-Q4_K_M.gguf

    多模态组件 (mmproj): mmproj-F16.gguf

    上下文 (Context): 256k

    n-cpu-moe: 15

    cache-type-k: turbo4

    cache-type-v: turbo3

    flash-attn: 开启

    目前的结果:

    在 256k 上下文下运行稳定

    速度大约为 45 tok/s

    模型加载时间约为 5 分钟

    运行添加 mmproj 后,视觉功能也能正常工作
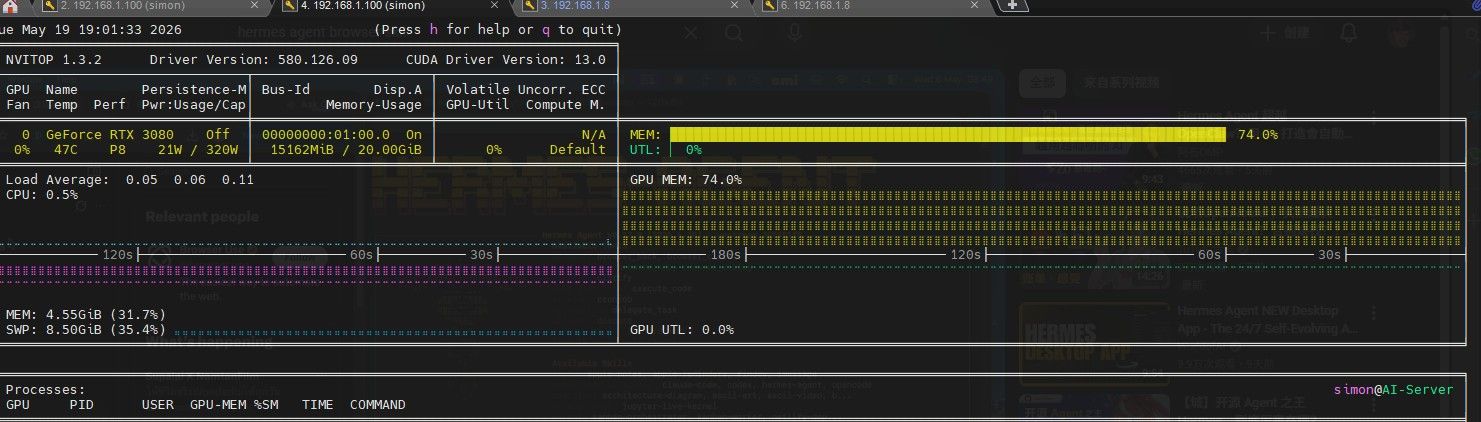
    beca22fc-40cd-4620-8b5d-87dca6e8d079-image.jpeg

    运行脚本:
    #!/usr/bin/env bash
    set -euo pipefail

    MODEL="/mnt/hdd_storage/models/llama.cpp/Qwen3.6-35B-A3B-UD-Q4_K_M.gguf"
    SERVER="/mnt/hdd_storage/llama.cpp-turboquant/repo/build/bin/llama-server"
    HOST="0.0.0.0"
    PORT="9999"
    CTX="262144"
    THREADS="6"
    THREADS_BATCH="6"
    BATCH="256"
    UBATCH="128"
    GPU_LAYERS="99"
    CPU_MOE="20"
    PARALLEL="2"
    CACHE_K="turbo4"
    CACHE_V="turbo3"
    MMPROJ="/mnt/hdd_storage/models/llama.cpp/mmproj-F16.gguf"
    REASONING_MODE="${REASONING_MODE:-off}"

    exec "$SERVER"
    --model "$MODEL"
    --host "$HOST"
    --port "$PORT"
    -ngl "$GPU_LAYERS"
    --n-cpu-moe "$CPU_MOE"
    -c "$CTX"
    -t "$THREADS"
    -tb "$THREADS_BATCH"
    -b "$BATCH"
    -ub "$UBATCH"
    -np "$PARALLEL"
    --cache-type-k "$CACHE_K"
    --cache-type-v "$CACHE_V"
    --mmproj "$MMPROJ"
    --flash-attn on
    --no-warmup
    --jinja
    --reasoning "$REASONING_MODE"

    我尝试了运行不同27B模型量化参数但是都不能稳定跑长上下文任务,经常OOM,想说各位老大有没有什么办法。

  • 登录

  • 登录或注册以进行搜索。
  • 第一个帖子
    最后一个帖子
0
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组