 S
Sin Yang Wu
@Sin Yang Wu
-
工作室規劃:4 台 DGX Spark 本地 AI 叢集架構,並預留擴充至 8 台 -
工作室規劃:4 台 DGX Spark 本地 AI 叢集架構,並預留擴充至 8 台感謝分享,這點很重要。能力上限跟長期穩定性確實要分開看。我這次主要記錄四台 DGX Spark 從建置、部署到串接驗證的過程,目前還不能用短期測試代表長期使用表現。
方便分享你遇到 loop 的主要情境嗎?是寫程式、工具呼叫,還是一般對話?另外是在什麼工具或框架、使用哪些參數?這樣比較容易對照,後續評估也應該把任務完成率、循環頻率與需要人工介入的次數一起算進去,而不只看生成速度。 -
工作室規劃:4 台 DGX Spark 本地 AI 叢集架構,並預留擴充至 8 台從四台 DGX Spark 到自己的 AI 服務:一套 DeepSeek 叢集的建置實錄
把四台電腦接起來,下載模型,再按下啟動——原本以為,架設自己的 AI 服務大概就是這樣。
真正動手之後才發現,模型只是其中一部分。網路、驅動、容器、通訊函式庫、遠端管理、API,以及日後如何更新和還原,每一個環節都會影響整套系統能不能穩定運作。
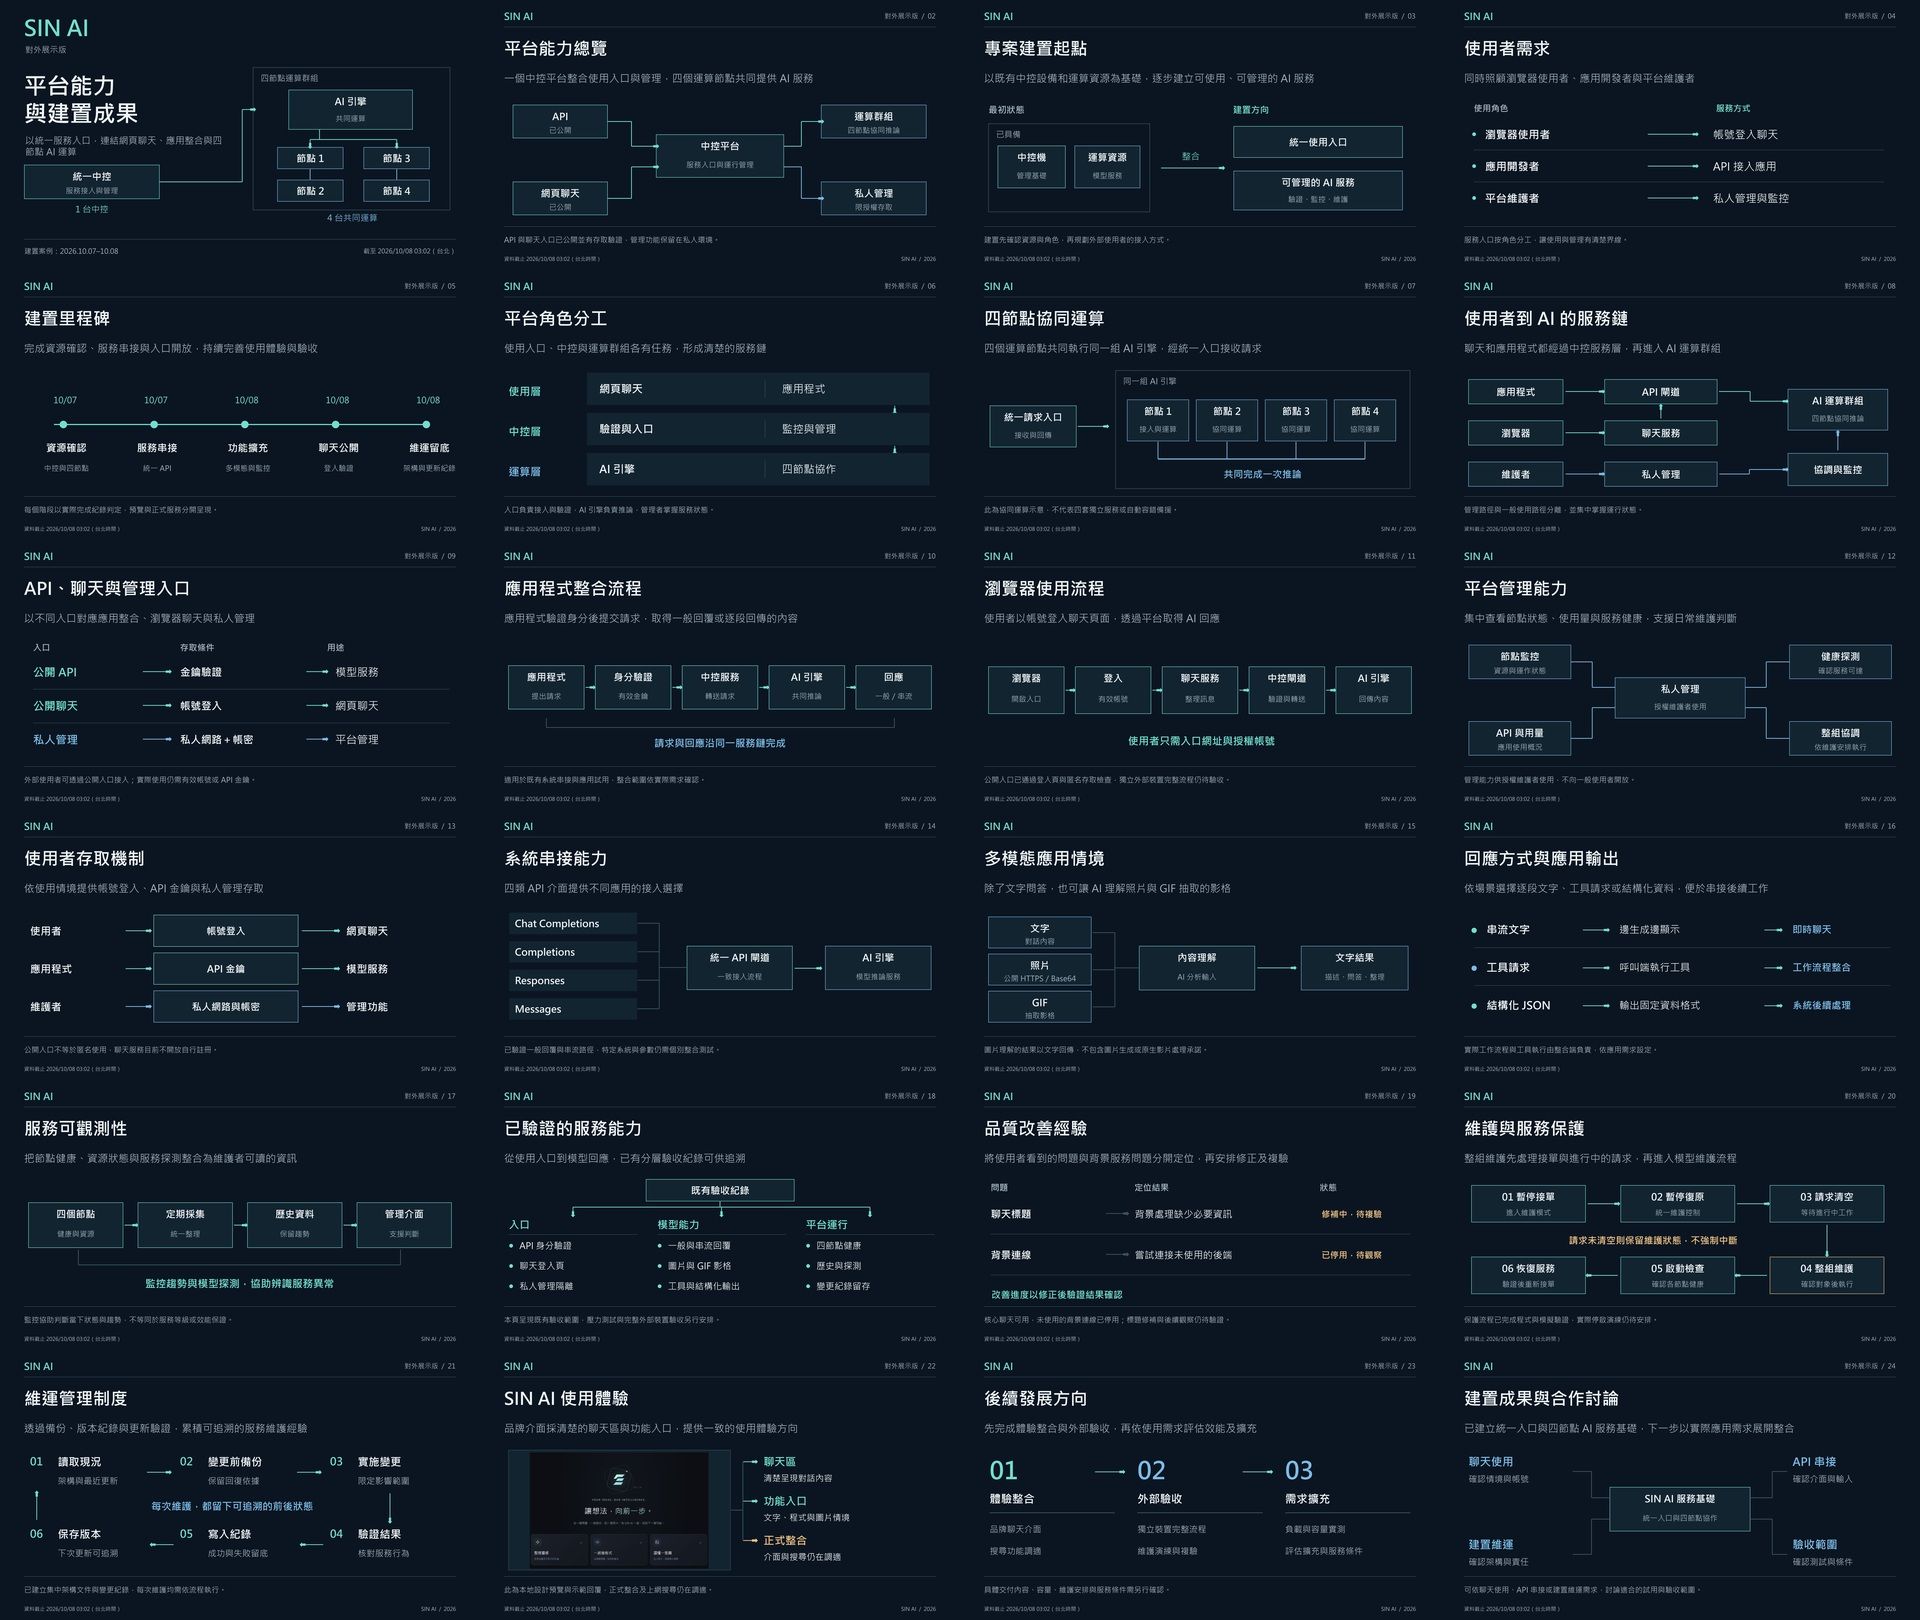
這次專案的目標,是讓四台 NVIDIA DGX Spark 共同執行 DeepSeek-V4.1-Flash,提供統一的 API,接入 OpenCode,並留下可以交接、維護與重建的文件。
一路從設備連線做到模型回應,過程跨越夜間,也累積了不少值得記錄的經驗。
一、先把目標定清楚:四台共同服務一個模型
這套系統不是四台各自執行一個完整、獨立的 AI 服務。
實際採用的是 SGLang、TP4 與 EP1 配置。TP4 讓模型運算分散到四台機器的 GPU,由 Spark01 作為統一的 API 入口,其餘節點共同參與推論。
雖然一開始也討論過 vLLM,最後是依照參考專案採用 SGLang 的部署方式。
另一項重要決定,是讓每台機器都保有完整的本機模型檔案:- 每台約 476 GiB。
- 包含 48 個模型權重分片。
- 四台都完成檔案雜湊驗證。
本機完整副本可以減少載入模型時對共享儲存的依賴,也讓各節點的檔案版本更容易核對。不過,推論是否有效率,仍然取決於 GPU、記憶體、通訊與軟體配置,不能只靠「模型都有放好」來判斷。
二、三種網路,各自負責不同工作
這次建置最需要釐清的事情之一,就是管理網路和模型通訊網路的差別。
系統主要分成三個用途。
管理 LAN 負責 SSH、Docker 控制,以及部分叢集啟動協調。目前管理介面協商為 1 Gb/s。
Tailscale 提供跨地點的遠端管理通道。之後換一台管理電腦,只要具備適當的網路與憑證權限,就能接手維護。
DAC 高速網路 則負責節點之間的模型通訊。四台以 DAC 線直連成環:
Spark01 → Spark02 → Spark03 → Spark04 → Spark01。
這個高速環沒有使用高速交換器,四條連線各自配置獨立網段,採固定 IP 與 MTU 9000,不在高速介面上設定預設閘道。
因此,遠端管理走 Tailscale,不代表模型資料也要繞進 VPN。把用途分清楚,後續排錯才不會混在一起。
三、200 Gb/s 是連線速率,不是實測成績
四條已使用的高速連線都協商為 200 Gb/s,但這不等於實際程式可以直接跑滿 200 Gb/s。
本次逐條連線測試的結果是:
測試項目 本次實測範圍
TCP 吞吐量 約 98.1~111 Gb/s
RoCE RDMA Write 約 99.39~111.62 Gb/s
RDMA 測試使用固定的訊息大小、佇列數與測試時間,確認四條直接連線都能正常傳輸。
這些數據證明高速路徑可以工作,但它們不是 NCCL 集合通訊成績,也不是模型生成速度。完整判斷效能,還需要往上測到實際推論。
這次也再次體會到:看見介面顯示「200G」,只是驗收的開始。
四、真正耗時間的,是各層之間的相容性
建置過程並不是一次成功。
曾遇到套件管理程序卡住,導致安裝一直等待鎖定;也碰到第三方套件來源的簽章問題。Tailscale 從暫時啟動切換到系統服務時,也需要確認服務設定與登入狀態是否銜接正確。
模型叢集啟動後,還遇到 RDMA 記憶體註冊錯誤。
這類問題不能只看「網路線有沒有亮」。必須逐層核對:- 系統與核心狀態。
- GPU 驅動及網卡韌體。
- 網路介面、IP、MTU 與 RoCE GID。
- NCCL 函式庫與修補版本。
- 容器環境及推論參數。
- 四個節點是否真正完成協同啟動。
經過修正與必要的重啟驗證後,四台推論容器都進入健康狀態,API 也能正常回應。
重要的經驗是:遇到安裝或服務卡住,要先確認正在執行的程序及其狀態,不能靠刪除鎖檔、重複執行安裝,或隨意終止程序來碰運氣。
五、先留下基準,再談優化
服務能啟動之後,下一步才是效能調整。
本次保留原始 EP2 配置作為基準,再與調整後的 EP1 配置比較。在相同測試條件下,得到以下結果:
項目 原始配置 優化配置 提升
單路文字生成 54.21 tokens/s 71.20 tokens/s 約 31.3%
單路程式碼生成 89.69 tokens/s 110.82 tokens/s 約 23.6%
64K 合成輸入 prefill 3,804.85 tokens/s 5,013.90 tokens/s 約 31.8%
這些數字有明確的適用範圍:它們來自本次固定題目與參數的測試,不是所有使用情境的保證。
也不是每個指標都變好。例如,單路文字測試的首個 token 延遲中位數,從約 188.74 毫秒增加到 225.81 毫秒。生成吞吐量提升,同時存在延遲上的取捨。
此外,這批效能數據是在後續加入語言政策之前取得;目前版本仍需要在相同條件下重新測量,才能建立完整的新基準。
六、讓模型接入實際工作流程
完成叢集只是第一步,接下來要讓它真正能用。
這套服務提供 OpenAI 相容 API,讓 OpenCode 透過統一的模型端點連線。API 金鑰與 SSH 金鑰分開管理,不寫進公開文件,也不直接放在可攜式明文資料夾。
本次功能驗收包含:- 一般對話、多輪歷史與串流輸出。
- 工具呼叫及結構化 JSON 輸出。
- 圖片辨識與 OCR。
- OpenCode 的檔案讀寫、編輯與受限指令測試。
- 長上下文檢索。
預先定義的 API 驗收項目通過 17 項。不過,通過功能測試只代表這些測試路徑可用,不代表模型永遠回答正確。
在另一組 29 題品質檢查中,結果是 27 題通過。把未通過項目留下來,才能作為後續調整與回歸測試的依據。
PDF 能讀,但要說清楚怎麼讀
目前驗證成功的 PDF 流程,是先在本機將頁面轉成圖片,並擷取可用的文字,再交給模型處理。
這與「API 原生接受 PDF 檔案」是兩件事。
實測已確認模型可以讀取轉換後的 PDF 頁面,包括表格、文字,以及沒有文字層的圖像內容;但不能因此把服務標示成支援所有原生 PDF 輸入。
語言規則放在生成前
為了讓不同 API 客戶端有一致的預設語言,本次也在伺服器的 Chat Completions 對話編碼流程加入政策:
預設使用台灣繁體中文,明確要求英文時則使用英文;程式碼、路徑及必要的原文內容保持正確。
這是生成前的提示政策,不是修改模型權重,也不是輸出完成後再翻譯,因此仍需要持續驗證,不能視為百分之百的語言保證。
七、花了多久?有紀錄的才寫成數字
這個專案從設備連線、帳號設定,一路進行到模型部署、效能調整與文件整理。
但早期操作沒有留下完整起訖時間,因此目前無法精確計算總建置工時。
能明確確認的測試時間包括: - EP2 基準測試:約 4 分 14 秒。
- EP1 基準測試:約 3 分 20 秒。
- 約 104 萬輸入 tokens 的單次檢索測試:約 5 分 25 秒;其中包含快取重用。
這些都是特定測試的耗時,不能拿來代表模型下載、安裝、除錯或整個專案花費的時間。
為了讓後續紀錄更完整,管理入口已加入執行收據。透過入口執行的動作,會保存開始時間、結束時間、耗時與結果;入口以外的人工操作則需要另外補記。
八、把成果留下來,才能持續維護
最後交付的不只是一個正在回應的 API。
專案已整理成一份可攜式管理包,包含: - 36 頁建置與維運手冊。
- 整體服務、高速接線與建置流程三張架構圖。
- 管理網路及高速網路設定說明。
- 安裝、更新、調適、回復與移機 SOP。
- 效能與功能驗收證據。
- 12 階段建置進度,以及後續待辦順序。
大型模型權重與 Docker 映像沒有直接塞進一般文件壓縮包,因此這不是完整的離線安裝映像,也還不是經過空白機演練的一鍵重建工具。
接下來仍有明確工作:完善開機後推論服務恢復、更新加密備份、確認管理權限與位址配置,並補上 NCCL 及長時間負載測試。
這次建置帶來的最大改變,是把四台設備整理成一套有入口、有實測、有文件,也有待辦清單的 AI 系統。
模型能回答,是一個重要里程碑;讓下一位維護者知道它怎麼運作、出了問題怎麼查、更新失敗怎麼回復,才讓這套系統真正具備長期使用的基礎。
-
工作室規劃:4 台 DGX Spark 本地 AI 叢集架構,並預留擴充至 8 台目前工作室的本地 AI 運算環境,第一階段規劃會先以 4 台 NVIDIA DGX Spark 建置,之後再逐步擴充到 8 台。
目前大致硬體規劃如下:
- NVIDIA DGX Spark ×4
- HPE DL360 Gen10 ×1
- ESXi 8.0
- 作為管理主機、API、Agent、監控與服務入口
- MikroTik CRS804-4DDQ-hRM ×1
- 4×400GbE QSFP56-DD
- 作為 Spark 節點間高速交換機
- QSFP-200G CU 0.5M DGX Spark 專用 DAC ×4
- 一般管理網路另外使用 RJ45 Ethernet
- UPS 預計 2~3 台,較偏向最後採 3 台分組
第一階段 4 台 Spark 的高速網路會先這樣接:
CRS804 Port 1 → 200G → Spark 1
CRS804 Port 2 → 200G → Spark 2
CRS804 Port 3 → 200G → Spark 3
CRS804 Port 4 → 200G → Spark 4也就是每台 DGX Spark 各使用一條 200G QSFP DAC 接到 CRS804。
管理網路與 AI Fabric 會分開:
一般 Ethernet:
筆電 / OpenCode / DL360 / Spark 管理介面200GbE Fabric:
DGX Spark 1~4 CRS804
DL360 主要負責:
- API Gateway
- Agent / Task Management
- Monitoring
- VM
- 自動化
- 模型服務管理
Spark 則專心負責模型推論與 distributed inference。
UPS 目前比較傾向使用 3 台分組:
UPS-A:
- Spark 1
- Spark 2
UPS-B:
- Spark 3
- Spark 4
UPS-C:
- DL360
- CRS804
- Router / Management Switch
這樣停電或單組 UPS 異常時,不會一次把整個控制面和所有 Compute Node 一起帶走,也比較方便之後做自動安全關機。
後面如果擴到 8 台 DGX Spark,目前不打算換 CRS804。
CRS804 每個 400G QSFP56-DD Port 可以拆成 2×200G,所以未來會把現在 4 條單路 200G DAC 改成:
400G QSFP56-DD → 2×200G QSFP56 breakout DAC/AOC
拓撲會變成:
Port 1
├─ 200G → Spark 1
└─ 200G → Spark 2Port 2
├─ 200G → Spark 3
└─ 200G → Spark 4Port 3
├─ 200G → Spark 5
└─ 200G → Spark 6Port 4
├─ 200G → Spark 7
└─ 200G → Spark 8也就是:
4 個 400G Port
→ 拆成 8 路 200G
→ 對應 8 台 DGX Spark所以 4 台升級成 8 台時,主要變動會是:
- 新增 Spark 5~8
- 更換成 4 條 400G → 2×200G breakout 線
- CRS804 不需要更換
- 重新調整 RouterOS Port Breakout
- 重新跑 NCCL / AllReduce / AllGather
- 重新驗證 distributed inference 效能
- UPS 與電源迴路再依實際功耗重新規劃
目前模型方向會以 DeepSeek V4.1 Flash 這類大型模型為主,之後會實測 TP、PP、EP 等不同並行方式,不會單純假設 TP=4 或 TP=8 就一定最快。
目前策略還是:
先把 1 台跑通 → 4 台成叢集 → 實測穩定後,再慢慢補 UPS、儲存、監控、電力與其他設備。設備不打算一次全部買滿,會先把核心 AI Fabric 與模型服務搭起來,再依實際需求逐步補強。
如果有人實際使用過 CRS804-4DDQ-hRM 搭 NVIDIA ConnectX-7 / DGX Spark,尤其是 200G、400G breakout、RoCE、NCCL 或 8-node 環境,也歡迎分享實測經驗。
-
工作室規劃:4 台 DGX Spark 本地 AI 叢集架構,並預留擴充至 8 台目前想在工作室規劃一套本地 AI 運算環境,第一階段以 4 台 DGX Spark 組成叢集,並預留未來擴充到 8 台。這篇先分享整體架構,想請教有實際建置經驗的朋友。
【第一階段:4 台 DGX Spark】
使用者筆電/OpenCode
│ 一般乙太網路
▼
路由器/一般網路交換機
├── HPE DL360 Gen10(ESXi 8.0;規劃管理與 API 服務 VM)
└── DGX Spark 管理網路DGX Spark 1 ─┐
DGX Spark 2 ─┼── QSFP 高速交換機(節點間叢集通訊)
DGX Spark 3 ─┤
DGX Spark 4 ─┘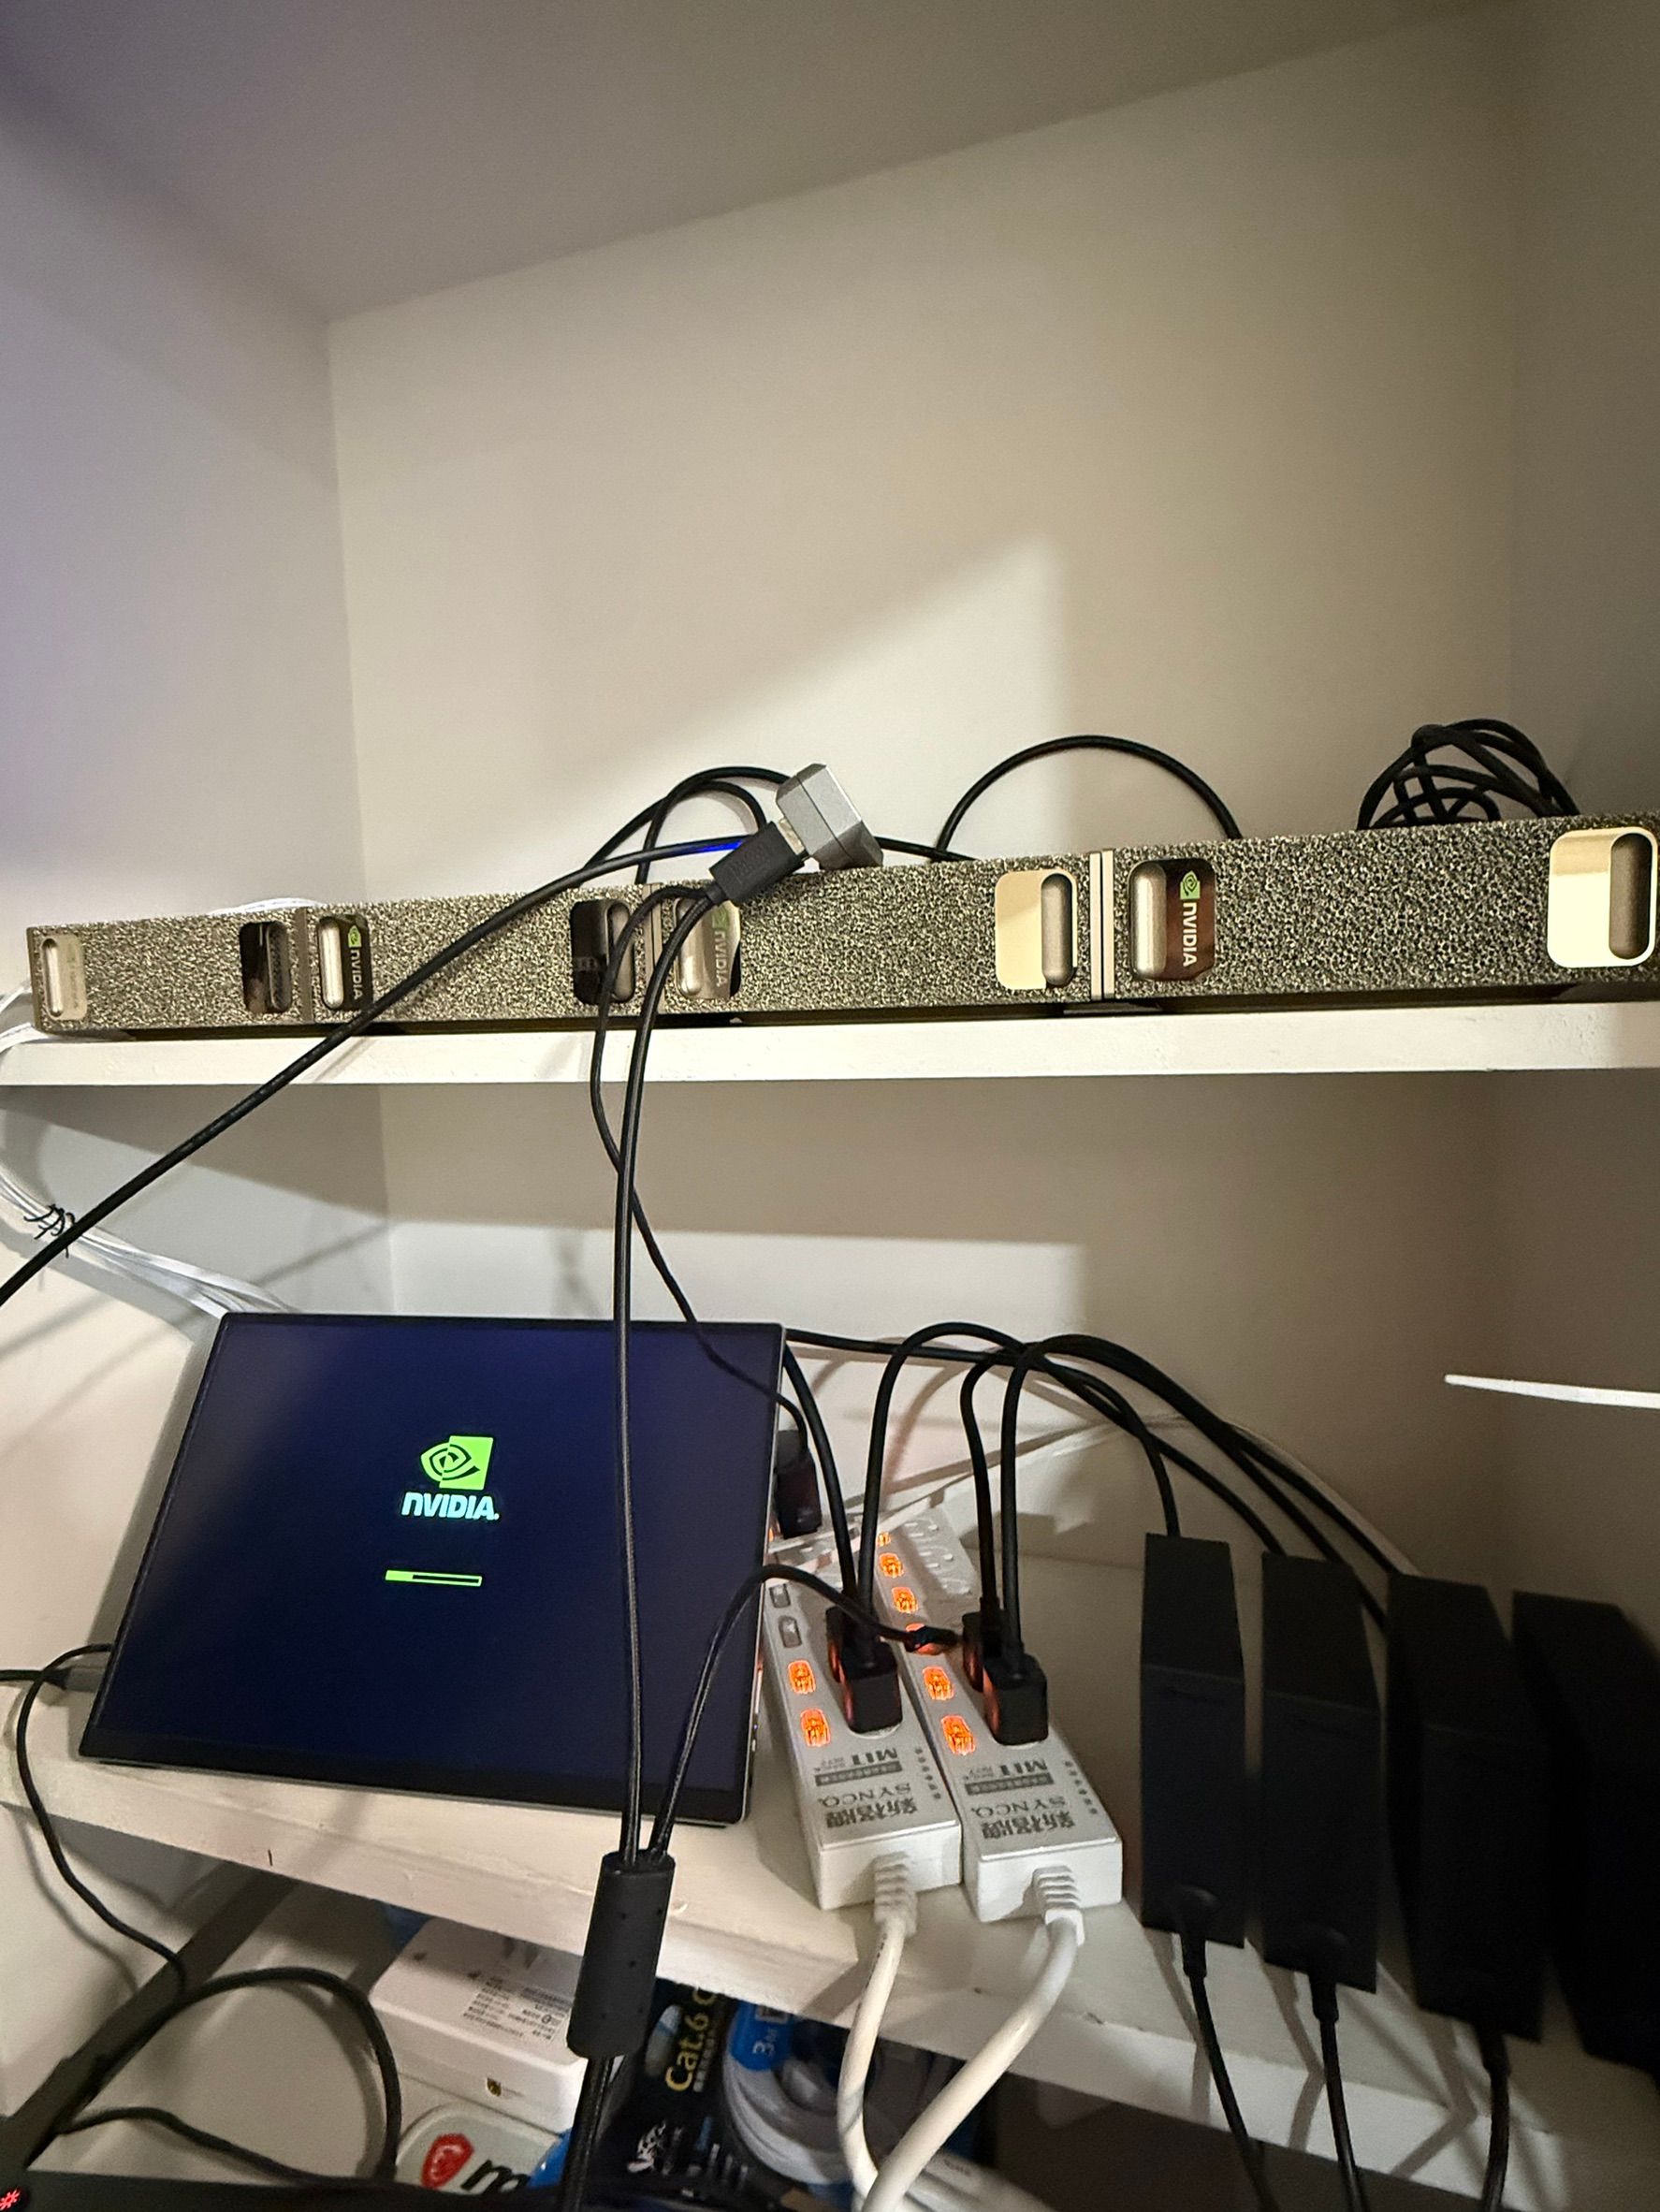
規劃上由 DL360 承擔服務入口、使用者/任務管理與 API 管理;DGX Spark 負責模型推論與叢集運算。一般乙太網路用於管理及服務連線,Spark 節點之間的高速互連則走 QSFP 交換機。以每台設備各使用一個對應網路埠的初步想法,4 台階段會是每台 Spark 一條一般網路線,以及一條 QSFP 線接高速交換機;實際介面與線材規格仍需依設備型號確認。
【UPS 與智慧插座規劃】
供電備援會先以實際量測整套設備的耗電量,再決定 UPS 容量、供電分組與可支撐時間,不預設一台 UPS 就能同時承載所有設備。初步想法是優先讓路由器、一般網路交換機與 DL360 管理主機在短暫停電時維持運作,讓監控與關機流程有機會完成;DGX Spark 與 QSFP 交換機是否納入 UPS,則依負載、UPS 輸出能力和預計續航時間評估。也希望建立 UPS 電量不足時通知管理主機/服務,依序執行模型服務停止與主機安全關機,並實測網路中斷時的處置。
智慧插座預計作為單台設備的遠端電源控制/故障恢復備援,需確認額定負載、斷電後自動恢復行為,以及斷網時是否仍可在區域網路操作。它不取代 UPS,也不作為正常關機方式;只有在系統已安全關機、或確認當機且無法透過管理介面處理時,才考慮遠端斷電再上電。
【未來擴充:8 台 DGX Spark】
DGX Spark 1–8 各自以 QSFP 連接至具足夠相容埠數的高速交換機,形成星狀拓撲;管理網路則仍由一般乙太網路交換機承載。擴充前需要重新確認交換機埠數、速率/線材相容性、交換容量,以及叢集軟體對 8 台的支援方式,不預設 4 台配置可以直接無痛擴充。UPS 與電源迴路也需依 8 台的實際負載重新規劃。
想請教大家:
- 4 台 Spark 使用 QSFP 高速交換機互連,有哪些拓撲或設定細節容易忽略?
- 管理網路和節點高速網路分開規劃,是否有建議的做法?
- DL360 Gen10 作為 ESXi 管理主機與 API 服務入口,應如何安排網路與 VM 角色?
- UPS 如何按實測負載安排供電分組、續航與安全關機流程?
- 智慧插座若用於單台設備故障後遠端重啟,有哪些額定規格或安全注意事項?
- 若之後擴到 8 台,交換機、線材、供電與叢集軟體方面有哪些限制要先留意?
目前仍是架構規劃,會依實際設備、電力與軟體支援狀況驗證。歡迎分享建議或實測經驗。