跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
soop ladiosS

soop ladios

@soop ladios
贵族大夫 硕果累累
取消关注 关注
关于
帖子
81
主题
11
分享
0
群组
2
粉丝
2
关注
0

帖子

最新 最佳 有争议的

  • 2 x Tesla V100 32G, llama.cpp-v100, Qwen3.8-27B-Q8_0.gguf , decode 破百, prefill 16xx~19xx tok/s, 部署,調優與TP修補與解決循環問題
    soop ladiosS soop ladios
    LLM讨论区 v100 qwen-27b 多卡部署

    手上空著兩張V100, 其他模型都有機器跑了, 就想回頭搞搞Qwen 3.8 27B, 順便為Qwen 4.0暖暖身. 基於工作需求, Q8是必須的, 之前跑過大概decode 3,40 tok/s , prefill 7,800 tok/s, 就差強人意. 這次網上找找看有沒有什麼更強的部署, 還真的找到.
    用著用著無限循環的老問題再度發生, 就讓GPT 6.1 sol去修復一下, 修好之後就沒有再發生了. 少了循環問題後, 3.8 27B還是挺能打的, 跑了幾個長鏈任務, 不比其他模型差, 就256K上下文少了點, 時不時就compact. 以下為安裝紀錄:

    Qwen3.8-27B 部署摘要

    目前模型與服務

    項目 正式設定
    API 模型名稱 qwen-3.8-27b
    Target models/Qwen3.8-27B-Q8_0.gguf,Q8_0 GGUF,約 29.05 GB
    Draft models/Qwen3.8-27B-DFlash2-F16.gguf,約 3.86 GB;來源 BF16 已轉 F16,未直接使用 BF16 運算
    推論引擎 1115714829/llama.cpp-v100 v100-2.0.1.1,基準 commit f17d925,另有本機 TP 修補;執行檔 build-tp/bin/llama-server
    硬體 2 × Tesla V100-SXM2-32GB,NVLink;每卡功耗上限 225 W
    GPU 切分 Tensor parallel,--split-mode tensor --tensor-split 1,1,全層 GPU offload
    max seq num / 最大併發 2,--parallel 2;兩路同時處理與生成均已實測
    每路實際可用 context 262144 tokens(256K,輸入+輸出)
    --ctx-size 524800 tokens(總配置);獨立 KV,--no-kv-unified
    每路 KV token 容量 262400 tokens,為 256 對齊配置;524800 ÷ 2
    Slot 上限 262152,含 8 個內部保留位置;SLOT_CTX=262152、--kv-unified-per-slot 262152
    主模型 KV cache K/V 均為 q8_0;payload 合計 17425 MiB ≈ 17.02 GiB,每卡對齊配置 8712.77 MiB
    Draft KV / recurrent state Draft KV 約 80 MiB/卡;target recurrent state 約 1197 MiB/卡,與主模型 KV 分開計算
    Batch / ubatch logical batch 2048、physical ubatch 2048
    投機解碼 draft-dflash,最多 7 個 draft tokens/輪
    其他快取 --cache-ram 2048:主機 RAM 前綴快取上限 2048 MiB;--ctx-checkpoints 4,不是 GPU KV 容量
    採樣預設 temperature 1.0、frequency_penalty 0.3、top_p 0.95、top_k 20、min_p 0
    Thinking 預設 開啟、xhigh;請求可用 reasoning_effort 覆寫;none 關閉,high 映射至 xhigh
    記憶體保護 systemd MemoryMax=54G、MemorySwapMax=0

    實際容量以兩路各 261632 輸入+512 輸出=262144 tokens 驗證,並非把總 256K 除以兩路。額外 slot 位置用於投機解碼內部空間;runtime metadata 覆寫為 262152,未修改 GGUF、未啟用 YaRN/RoPE 縮放,也不宣稱原生 256K 以上的品質。

    最近採樣參數變更

    依使用者指示,將服務預設 temperature 從 0.4 改為 1.0、frequency_penalty 從 0 改為 0.3,

    改動原因:Coding agent使用本模型時,出現大段推理文字循環,以及成功取得工具結果後仍反覆發出相同工具呼叫。使用者停止該次執行,之後指定這兩項採樣調整,以減少重複循環。temperature 改回 1.0 的用意是增加採樣多樣性,frequency_penalty 0.3 則對重複出現的 token 加入頻率懲罰;後者不是對相同工具名稱或參數的直接去重機制。temperature 0.4 是否為原問題根因尚未經對照測試確認。

    後續測試結果:新參數 temperature 1.0/frequency_penalty 0.3 經多輪測試,原先的重複推理/工具呼叫循環問題未再復現。此處記錄使用者回報的測試結果,

    驗證與測試數據

    單位為 tokens/s;屬指定測試內容的觀測值。Native 冷測 temperature=0;warm/並行 chat 為 temperature=1,chat 測試明確關閉 thinking。目前 temperature=1.0、frequency_penalty=0.3 已重啟並驗證短 API,且使用者回報後續多輪測試未再復現原循環問題;下列歷史效能測試的 frequency_penalty=0,尚未按新採樣設定重跑整套效能基準。

    測項 輸入/輸出與結果 Prefill Decode
    正式服務單路 16K 冷測 16384+128,cache_n=0,通過 1949.28 180.53
    兩路各 32K 冷測 各 32768+128,全通過;整組 38.17 秒 — —
    兩路各 128K 冷測 各 131072+128,全通過;整組 211.30 秒 — —
    兩路完整 256K 冷測 各 261632+512,cache_n=0,全部無截短;整組 603.08 秒(10.05 分鐘) 第一路 879.71 每路 106.08–107.32
    滿長前綴兩路同時生成 各 261632+512,無截短;各重用 261628 個 prompt tokens、重算 4 個;整組 8.41 秒 不作冷 prefill 比較 每路 63.92–75.52
    連續重用滿長前綴 再次兩路各輸出 512、無截短;整組 8.23 秒,再次觀察同時生成 2 路 — 每路 65.30–76.17
    重啟後兩路 OpenAI chat 各完整輸出 512,HTTP 200,同時生成 2 路 — 每路約 157.45–157.48

    冷長輸入有排程等待:上述 256K 冷測同時 processing=2、generating=1;另以 warm 測試確認滿長下 generating=2。第二路冷測 prompt timing 含等待,不當作獨立 prefill 基準;warm 數字也不等於冷輸入速度。

    其他驗證:

    • 正確性抽查:6 組 greedy 答案與原 layer 模式參考逐字一致;不是完整品質基準。
    • TP 修補:修正 mirrored 非連續 tensor 的 async 傳輸限制;CPU/雙 GPU Meta 與 scheduler CTest 共 3/3 通過,兩張卡 CONT 算子各 78/78 通過;本機 patch 尚未上游合併。
    • 邊界修正:原本只留 2 個位置,7 步投機的 warm 測試曾只輸出 511;改留 8 個位置後,完整冷測與連續兩輪 warm 皆輸出 512,失敗結果保留。
    • 服務驗證:health、模型名稱、兩個 slot、metrics、實際 TP 函式庫、重啟與開機啟動皆通過。temperature/frequency_penalty 新預設、thinking 預設及各 reasoning level 均已有實際 API 驗證。

    資源與未採用方案

    • 最終滿長冷/熱/連續 warm 測試:每卡 VRAM 峰值 28500 MiB,實際 memory.free 最低 3995 MiB;驅動另保留約 274 MiB,不能直接把 total−used 全算成可用。
    • 同三輪測試:host 最低 available 51.04 GiB、服務 RSS 最高約 3.75 GiB,服務 swap 始終 0。其他測項已有 RAM 快取時 RSS 可較高;主機原有 swap 約 0.84 GiB,不代表主機 swap 為 0。
    • 三路共用約 600K+F16+ubatch 2048 未採用:曾在 draft 載入時 OOM。額外 KV 本身只多約 1.22 GiB/卡,但共享路徑使用 dense mask,主模型計算緩衝曾升至約 7.30 GiB/卡;不是單純多 88K KV 放不下。使用者已決定維持兩路 256K,未降低 KV 精度。

    Llama bency 實測數據
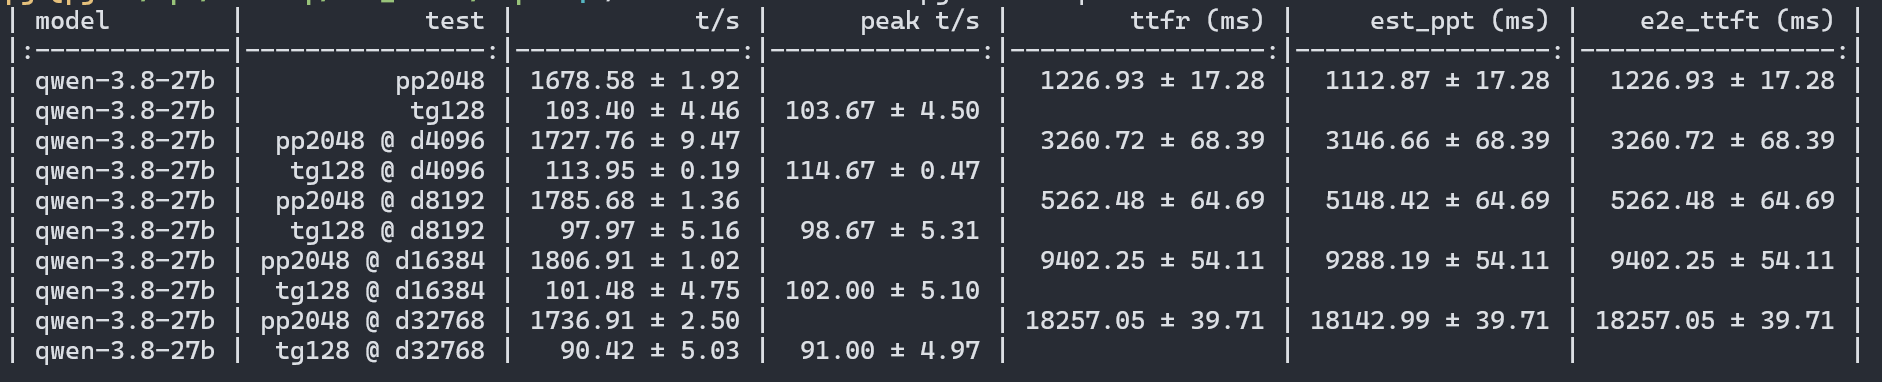
    螢幕擷取畫面 2026-11-02 175153.png


  • 4 x Tesla V100 32G, Maya-DS4, DeepSeek-V4.1-Flash-1017 EXL3 2.9bpw, decode 37 tok/s, prefill 640 tok/s, 部署,調優與避坑紀錄
    soop ladiosS soop ladios
    LLM讨论区 v100 deepseek 多卡部署

    @Lei-Gao 我的四張卡排列比較特殊, GPU0/GPU1是外接顯卡鄔, 接pcie switch佔一條pcie插槽, 有nvlink.
    GPU2/GPU3是分開插在兩條PCIE, 所以走的是TP2, PP2. 我請Gemini小弟解釋一下:

    DeepSeek-V4.1-Flash-1017 NVLink 拓撲與實質效益分析報告

    主機環境: AMD EPYC 7K62 48C/96T, 128GB RAM, 4 × NVIDIA Tesla V100-SXM2 32GB
    模型版本: DeepSeek-V4.1-Flash-1017 EXL3 2.9bpw + Engram 1017
    推論引擎: project-maya / maya-ds4 (--tp 2 --layer-split auto)


    結論

    NVLink 在本機推論此模型時有局部的實質加速作用,但不是決定整體端到端效能的核心瓶頸(對端到端速度的實質貢獻估計約在 5% ~ 10% 左右)。


    一、 實體硬體拓撲現況(關鍵前置事實)

    經由 nvidia-smi topo -m 與 nvidia-smi nvlink -s 檢測,本機 4 張 V100 的互聯是不對稱的:

    GPU 配對 實體連線方式 頻寬 狀態
    GPU 0 ↔ GPU 1 NVLink 2.0 (5 條 bonded, NV5) ~128.9 GB/s Active (運作中)
    GPU 2 ↔ GPU 3 PCIe / Host Bridge (NODE) ~12–15 GB/s (PCIe Gen3) No NVLink (全數 Inactive)
    GPU 0/1 ↔ GPU 2/3 PCIe Host Bridge (NODE) ~12–15 GB/s (PCIe Gen3) 跨節點走 PCIe

    二、 模型並行架構下的通訊分佈

    目前的服務配置為 --tp 2 --layer-split auto(即 TP=2 + PP=2):

    • Stage 0(前 20 層,Layers 0..19):切在 GPU 0 與 GPU 1(TP=2)。
    • Stage 1(後 20 層,Layers 20..39 + LM Head):切在 GPU 2 與 GPU 3(TP=2)。
    • PP 流水線交接:Stage 0 算完後的 Hidden States 跨卡傳給 Stage 1。

    三、 NVLink 在哪裡有「實質作用」?

    1. 加速 Stage 0(Layers 0..19)的 TP All-Reduce:
      • 每一層的 MLA (Multi-head Latent Attention) 投影與 MoE 共享專家(Shared Expert)輸出,都需要在 TP 兩卡間做 All-Reduce 聚合。
      • GPU 0 ↔ GPU 1 走 NVLink 5 條通道,延遲極低(< 10 µs),通訊耗時基本能被計算完全重疊(Overlap)。
    2. 避免 Stage 0 的 PCIe 總線爭搶(Bus Contention):
      • 由於 GPU 0 與 GPU 1 的 TP 溝通走的是專用 NVLink 實體鏈路,不會佔用主機板的 PCIe 通道,使得這兩張卡的 PCIe 頻寬能 100% 留給 CPU 串流專家資料。

    四、 為什麼 NVLink「無法成為全局決定性因素」?

    1. 核心瓶頸在 CPU ↔ GPU 冷專家動態串流(走 PCIe Gen3):
      • 模型總共有約 92.4 GB ~ 100 GB 的冷專家權重 駐留在 CPU Host RAM,推論時需要根據動態路由經由 PCIe 串流到 GPU(即日誌中的 CPU lane ~22%~28% experts)。
      • NVLink 只能加速 GPU ↔ GPU 互聯,無法加速 CPU RAM ↔ GPU 的 H2D 傳輸。這部分的頻寬上限受死在 PCIe Gen3 x16(約 12–13 GB/s),是整個系統最大的延遲來源。
    2. 木桶效應:Stage 1(GPU 2 ↔ GPU 3)沒有 NVLink:
      • 後半段 20 層的 TP=2 在 GPU 2 與 GPU 3 上執行,由於這兩張卡之間沒有啟用 NVLink,它們的 All-Reduce 只能走 PCIe (NODE)。
      • 流水線(Pipeline)的速度由最慢的一環決定,Stage 1 在 PCIe 上的通訊延遲,會抵消掉 Stage 0 NVLink 帶來的部分增益。
    3. PP 傳輸的資料量極小:
      • Stage 0 傳給 Stage 1 只需要傳遞單個 Token 的活化向量(Hidden States,大小僅約數 KB),在 PCIe 上傳輸耗時僅需幾微秒,NVLink 在此處毫無顯著差別。

    五、 總結評估

    • 實質效益:有,它確保了前半部模型(GPU 0/1)通訊不打架、低延遲,估計貢獻了約 5% ~ 10% 的端到端效能。
    • 全局瓶頸:目前推論速度(Decode ~35–45 tok/s)的主導瓶頸是 CPU 記憶體頻寬與 PCIe Gen3 串流速度,而非 GPU-to-GPU 的通訊頻寬。

  • 4 x Tesla V100 32G, Maya-DS4, DeepSeek-V4.1-Flash-1017 EXL3 2.9bpw, decode 37 tok/s, prefill 640 tok/s, 部署,調優與避坑紀錄
    soop ladiosS soop ladios
    LLM讨论区 v100 deepseek 多卡部署

    @terry 確實,不過考慮到這價錢不到一台DGX spark GB10, 而這個量化要兩台GB10才跑的起來,就覺得還可以了.
    37 tok/s不至於慢到不能接受,640 tok/s prefill就.. 靠kv緩存命中彌補了


  • 4 x Tesla V100 32G, Maya-DS4, DeepSeek-V4.1-Flash-1017 EXL3 2.9bpw, decode 37 tok/s, prefill 640 tok/s, 部署,調優與避坑紀錄
    soop ladiosS soop ladios
    LLM讨论区 v100 deepseek 多卡部署

    DeepSeek-V4.1-Flash-1017 在4台GB10上表現不錯, 又看到DGX論壇上EXL3 2.9bpw量化品質似乎不差, 所以想在我的v100 32G x 4上面試試, 跑了一陣子感覺還可以, 就是prefill有點慢, 尚待優化. 以下為部署,調優與避坑紀錄.

    主機環境:AMD EPYC 7K62 48-Core / 96-Thread,128GB RAM,4 × NVIDIA Tesla V100-SXM2 32GB


    1. 模型與運行設定

    項目 正式線上生產配置 (Production) 備註說明
    模型全名 DeepSeek-V4.1-Flash-1017 EXL3 2.9bpw 含 Engram 1017 專家分片
    模型權重路徑 ~/deepseek-v4.1-flash-1017/packs/maya-ds4 EXL3 量化權重
    引擎軟體 maya-ds4 (專案路徑: project-maya) 版本: 1.1.41 (Git commit bcf379f)
    上下文上限 (Context) 500,000 tokens (--max-context 500000) 實測至 497,714 tokens 100% 針檢索通過
    預設取樣設定 temperature=0.4, reasoning_effort="high" 支援 Thinking 思考鏈輸出
    DSpark 配置 DSpark OFF (--dspark none) 釋放 GPU 1 被夾困的 7.5GB VRAM
    GPU 分割與專家配置 GPU 0–3 各承載 28.6~28.7 GB 專家(共 15,467 專家在 VRAM) GPU VRAM 餘裕 ~400 MiB
    主機 RAM 專家 (Direct RAM) 98.4 GB 常駐 Anonymous Heap (--mmap-experts off) DS4_REQUIRE_ALL_RAM=1, DS4_COPY_GB=90
    Prefill Chunk 大小 4096 tokens (--prefill-chunk 4096) 對齊 kVlRows=4096 流水線最優塊
    Attention 核心 DS4_ATTN_V7=0 SM70 架構最優穩定 Tensor Core Attention
    資源守護底線 MemAvailable >= 15.0 GiB, Engine VmSwap = 0 500K Prefill 期間允許暫降至 10.0 GiB

    2. Repo 更新與核心優化

    A. 上游 v1.1.41 程式碼同步

    • 上游基礎版本:同步自官方 origin/main(commit 9030b73,tag v1.1.41)。
    • 合併分支:integration/sync-upstream-v1141 -> Fast-Forward 合併至 production/upstream-20261027。
    • 主要增強:
      1. 啟用 Volta Tensor Core WMMA GEMM 矩陣運算核心(EXL3_WMMA_V70)。
      2. 升級 Prefill DMA 排程與批次流式傳輸機制。
      3. 保留本地多 GPU 區塊取消界限守護(ds4_chunk_cancel::Boundary),與上游 yield_to / run_yields 協同運作。
      4. 保留本地自研之零命中跳過邏輯,與上游 DS4_SKIP_UNPICKED 實現雙軌相容。

    B. Zero-hit Expert Transfer Skipping (DS4_SKIP_ZERO_EXPERTS=1)

    • 核心機制:在 Prefill 階段,各層於 GPU 完成 Top-K Routing 後,檢查 cur_bounds[v+1] == cur_bounds[v]。若命中 Token 數為 0,則跳過該冷專家的 PCIe DMA 傳輸。
    • 傳輸節省:
      • 32K Prefill:節省 66.9% ~ 73.2% 的 H2D 傳輸量。
      • 128K Prefill:節省 65.6% ~ 70.3% 的 H2D 傳輸量。
      • 500K Prefill:節省 82.9% 的 H2D 傳輸量(GPU 0/1 傳輸量從 3.03TB 驟降至 503GB)。
    • 品質保證:不修改 EXL3 權重、不修改 Top-K 結果、不漏算任何有效 Token,貪婪輸出與原始版本維持 Bit-Exact 完全一致。

    C. Direct RAM 啟動 Compaction 防護

    針對 Direct RAM(98.4GB)啟動時容易因 Linux 核心記憶體碎片引發 migrate_longterm_unpinnable_folios 導致長達 10 分鐘卡頓的問題,實施兩項核心修復:

    1. Buddyinfo 自適應 THP 檢測 (ds4_os.hpp):
      動態檢查 /proc/buddyinfo。僅在系統擁有足夠的連續 2MB 頁框時才啟用 MADV_HUGEPAGE;若碎片化嚴重則自動回退為標準 4KB 頁框,徹底杜絕核心逐頁遷移與 Compaction 重試停頓。
    2. 8 執行緒並行 cudaHostRegister (ds4_model.cu):
      將 61 個層的 Host Memory Pinned 註冊改為 8 條執行緒並行執行,加速完成 DMA 映射。

    3. 最新實測效能與驗證資訊

    A. Cold Prefill & Decode 效能矩陣

    評測維度 原始基準 (Skip OFF) 前期版本 (Skip ON) 最新 v1.1.41 (Skip ON) 較前期提升 較原始基準提升
    32K Cold Prefill (Tok/s) 429.0 tok/s 486.5 tok/s 605.9 tok/s +24.5% 🚀 +41.2% 🚀
    32K TTFT 首字延遲 73.30 s 64.66 s 52.21 s -12.45 s -21.09 s
    32K Decode (Tok/s) 34.60 tok/s 34.71 tok/s 37.39 tok/s +7.7% +8.1%
    32K Needle 正確性 100% 100% 100% (Pass) 一致 一致
    128K Cold Prefill (Tok/s) 462.0 tok/s 500.0 tok/s 640.3 tok/s +28.1% 🚀 +38.6% 🚀
    128K TTFT 首字延遲 281.95 s 260.59 s 203.90 s -56.69 s -78.05 s
    128K Decode (Tok/s) 29.80 tok/s 30.22 tok/s 37.13 tok/s +22.9% 🚀 +24.6% 🚀
    128K Needle 正確性 100% 100% 100% (Pass) 一致 一致

    B. 功能與穩定性測試

    1. 單元測試套件:
      • python3 -m unittest tools.test_ds4_pack serve.test_server:145/145 測試全部通過(耗時 35.3s)。
    2. Thinking 思考鏈推理:
      • 驗證 Prompt:How many letters in the word "apple"? Output reasoning and answer.
      • 3.77s 內順利回傳 reasoning_content 與標準解答,思考鏈標籤未發生截斷或錯位。
    3. Tool Calling 結構化調用:
      • 驗證 Prompt:What is the stock price of NVDA? + lookup_stock tools schema。
      • 成功命中並回傳標準 OpenAI tool_calls JSON 結構:{'name': 'lookup_stock', 'arguments': '{"ticker":"NVDA"}'}。
    4. 長上下文能力:
      • 通過 500,000 邊界保護測試(<= 500000 正常運作,> 500000 正常回傳 400 錯誤)。


    4. 異常調查:長 Prefill 原因與修復 (Prefill Cache Stall / Long Prefill Fix)

    A. 問題現象

    在生產環境運行多輪 Agent / OpenCode 對話時,發現每次對話都會出現長達 60~90 秒的長 Prefill(如 54K、57K、64K、69K Tokens),日誌顯示:

    ds4: took back a 22090-token shared start (0.01 s)
    maya ds4 serve: prompt 69438 tokens = 22090 reused + 47348 read in 89230 ms (530.6 tok/s)
    

    Prefix Cache 始終只能重用前 22,090 tokens(System Prompt),後續對話增量(20,000 ~ 47,000 tokens)每一輪都在重新進行 Cold Prefill。

    B. 根因分析 (Root Cause)

    1. 觸發旗標殘留 (/tmp/maya_always_cold_prefill):
      • 20:03 執行的 scripts/run_upstream_v1141_verification.py 測試腳本在跑純冷啟動壓測時寫入了 /tmp/maya_always_cold_prefill,但結束時未清理。
      • scripts/restart_production.sh 先前重啟步驟中亦未清理 /tmp/maya_* 旗標。
    2. C++ 引擎行為:
      • 於 src/ds4/ds4_main.cpp 第 1400 行:
        if (access("/tmp/maya_always_cold_prefill", F_OK) == 0 ||
            (std::getenv("DS4_ALWAYS_COLD_PREFILL") != nullptr && std::atoi(std::getenv("DS4_ALWAYS_COLD_PREFILL")) != 0)) {
            m.reset();
        }
        
      • 生產環境每當接收到任何請求時,該檔案強制觸發 m.reset(),將當前對話的動態 KV Cache 完全清空。
      • 引擎只剩下開機時常駐於 RAM 的 22,090-token System Prompt(prefixes RAM Tier),因此日誌只能「took back a 22090-token shared start」,導致後續數萬 tokens 每次均被迫重算。

    C. 修復措施與驗證

    1. 立即移除殘留旗標:
      • 刪除 /tmp/maya_always_cold_prefill。
    2. 自動化重啟防禦加固:
      • 更新 [scripts/restart_production.sh],在重啟生產服務前強制執行 rm -f /tmp/maya_always_cold_prefill /tmp/maya_skip_zero_experts。
      • 更新 [scripts/run_upstream_v1141_verification.py],加入 finally 區塊與啟動/結束清理,確保測試旗標絕不遺留。
    3. 線上驗證實測:
      • 旗標移除後,第 1 個請求(70,965 tokens):
        prompt 70965 tokens = 69438 reused + 1527 read in 7739 ms (197.3 tok/s)
        重用率瞬間升至 97.8%,Prefill 時間由 89.2 秒銳減至 7.7 秒!
      • 第 2 個請求(72,493 tokens):
        prompt read: 1180 tokens in 4.9 s,重用逾 71,313 tokens,耗時僅 4.9 秒。
      • 驗證 Prefix Cache 機制 100% 正常,長 Prefill 現象徹底解除。

  • Mac studio M5 ultra 256G - glm 5.3 flash 初嘗試
    soop ladiosS soop ladios
    LLM讨论区 apple-m5 glm 本地模型

    機器到手後嘗試安裝了一下GLM 5.3 flash, 本次使用 oMLX main 原始碼與原生 Metal 核心配方,模型 ID GLM-5.3-Flash-oQ4e-mtp,context 262144,常態併發 4 路。8 路額外測試已完成,現已恢復 4 路。主要是模型權重較大, 需要多併發就需要限制上下文, 不過記憶體看來還有餘裕, 以後需要可以再調整.

    環境與版本

    項目 實際結果
    硬體/系統 Mac Studio Mac17,15、M5 Ultra、256 GB Unified Memory、macOS 27.0.1
    磁碟 安裝前約 1.8 TiB 可用;完成後 1.5 TiB 可用
    oMLX 原始碼/commit ~/omlx-glm-src;base a4048eef24b41d885d593742e32a290f3bdb2300,recipe patch d6c33e309876454e43a3e6a5ce497934d00a4496,upstream #4086 patch/實際 HEAD 85ef9488063c28e3b770b95153f7fee7384e7035
    oMLX/MLX/mlx-lm 0.7.0rc1/0.32.2/0.31.4.dev132+g94cdcae13;五項原生核心 bonsai、decode_fast、glm_moe_dsa、minimax_m3、qwen35_prefill 均可載入
    建置工具 Python 3.12.15、Xcode 27.1 (27A9275)、CLT 27.0、Metal Toolchain 27A266a、Apple metal 32023.921、CMake 4.4.4
    oQ4e backbone ~/models/src/dfp-GLM-5.3-Flash-oQ4e-mtp,revision 728cc0d92aef48d64bd2a7ebfaefec6aeff5921b;34 個 shard,181,607,491,134 bytes,與索引一致
    MTP donor ~/models/src/vontra-mtp,revision 76add2a341a1cd90ad0e86bb69839ea9c35827c6;layer 45 共 2,641 個 tensors
    官方模板 ~/models/src/zai-template,revision eb9eb208eb0d988989d07a6a12d0fdeb5f52574a;與輸出模板逐位元組一致
    最終模型 ~/models/mlx/GLM-5.3-Flash-oQ4e-mtp;~/models/mlx 指向 ~/models.noindex/mlx;graft shard 4,183,682,557 bytes,索引共 5,639 鍵

    runtime/model_settings.json 設定 MTP enabled、fixed depth 2、max context 262144;scripts/serve-local.sh 啟用 Prompt Lookup、HC GEMV、232 GB memory guard。設定隔離於本專案 runtime/。API /v1/models 回報 max_model_len=262144;最終重啟後 Chat Completions 回覆 OK,模型載入 32.09 秒。Prompt Lookup 專項複製測試 32/32 行正確;伺服器記錄 drafted 280、accepted 278(99.3%)。MTP 日誌顯示 nextn layer 已綁定。

    Metal wired-memory 設定

    本機 Unified Memory 為 256 GB。iogpu.wired_limit_mb 參數存在,原值 0;已執行 sudo sysctl -w iogpu.wired_limit_mb=245760,調整後回讀及最終再讀均為 245760 MB(240 GiB)。模型成功分配 Metal 記憶體並完成全部測試。**還原命令:sudo sysctl -w iogpu.wired_limit_mb=0。**未設定開機自動套用,未修改 SIP、Swap 或其他系統參數。oMLX 提示其內部 static ceiling 254 GB 高於系統 Metal cap 240 GB;實測配置最高 192.343 GiB,服務另有 232 GB memory guard。

    Benchmark

    2026-10-22 實測。TTFT、Prefill、Decode 取自 OpenAI streaming usage;TTFT 單位秒,速率 tokens/s。長 Context 在開頭埋隨機碼、末尾提問,三項回憶皆正確。短輸出只有 6–8 tokens,Decode 值僅供參考。原始逐請求結果:runtime/benchmarks/results-4.jsonl、results-8.jsonl;約每 2 秒監控:memory-4.csv、memory-8.csv。

    Context 目標 實際 prompt tokens Prefix cache tokens TTFT Prefill Decode 回憶
    32K 31,618 0 18.73 1,688.32 40.22 通過
    128K 129,926 0 68.24 1,903.85 29.81 通過
    256K 260,998 163,840 146.26 664.27 40.59 通過

    256K 命中前次 prefix cache;664.27 tokens/s 是 oMLX 對未快取部分的回報,不能直接與前兩列的未快取 Prefill 比較。三項實際 prompt 均低於 262144 上限。

    同時請求數 TTFT 範圍(秒) Prefill 範圍(tokens/s) Decode 範圍(tokens/s) 各串流 Decode 速率合計(tokens/s) 結果
    1 0.23 134.86 86.71 86.71 1/1 正常結束
    2 0.08–0.33 24.27–93.46 34.98–35.93 70.91 2/2 正常結束
    4 0.21–1.04 1.92–145.26 18.92–27.61 100.40 4/4 正常結束
    8(暖機後) 0.10–0.79 2.55–19.78 13.82–16.41 123.42 8/8 正常結束

    短 prompt 每路僅 31 tokens,多數命中 prefix cache,因此併發 Prefill 值主要供記錄。8 路首次冷載入測試也 8/8 正常,模型載入約 31.1 秒,合計 Decode 118.45 tokens/s;表中採暖機後數據。合計是各串流回報速率相加,並非同一時間窗的端到端吞吐。

    Tool Calling:指定 lookup_city 函式與 Taipei 參數,回傳 finish_reason=tool_calls,JSON 參數 {"city":"Taipei"} 正確;通過,端到端約 2.281 秒。

    監控範圍 最低 Memory Pressure free Swap 最大使用 Metal in-use 峰值 Metal allocated 峰值 oMLX footprint 峰值 oMLX 壓力
    常態 4 路及 32K/128K/256K 23% 7.19 MB 187.869 GiB 189.769 GiB 187.647 GiB ok
    額外 8 路含冷載入 22% 62.50 MB 190.424 GiB 192.343 GiB 189.974 GiB ok

    8 路期間 Swap 由 7.19 MB 增至 62.50 MB,未達停止線 512 MB。監控腳本在 free ≤12%、Swap ≥512 MB、Metal in-use/allocated ≥232 GiB 或 oMLX 壓力達 hard/critical 時終止本服務。上表為各測試時段峰值;CSV 保存完整時間序列。


  • 双 V100 16G + 128G D3 + X99 跑Strata Qwen 3.8 Flash Next UD-Q4_K_XL 喂到 1500+ tok/s Prefill 和 60 tokens/s Decode 配合 256K 上下文全记录(含翻车与负结果)
    soop ladiosS soop ladios
    LLM讨论区 v100 x99 qwen

    @gao-Gao 我也是一開above 4G就打不開了, 我的板子是X99-T8 . 現在裝3060 12G x 2


  • 【内存】给近期玩模型,换DDR3 32G模型的朋友一些建议,关于32G 14900L 马甲内存避个小坑
    soop ladiosS soop ladios
    AI硬件 x99 bios

    @jason-an 好的,感謝. 我的也是三星14900L 32G x 8, 目前看起來沒有問題, 要是有問題在參考看看


  • 【内存】给近期玩模型,换DDR3 32G模型的朋友一些建议,关于32G 14900L 马甲内存避个小坑
    soop ladiosS soop ladios
    AI硬件 x99 bios

    @jason-an 非常有用的資訊! 請問最後電壓跟緩衝的設定是什麼?設的值是多少?


  • 双 RTX PRO 6000 + 48GB RAM:Strata 跑 DeepSeek 1017,Decode 80.8 tok/s,524K Prefill 1,385 tok/s
    soop ladiosS soop ladios
    LLM讨论区 rtxpro6000 deepseek 多卡部署

    @lunarmoon26
    交換機我只有買過MIKROTIK CRS 804, 預設風扇蠻吵, 應該可以調. 不知道好不好買, 4台的話不用switch也是行的.


  • 双 RTX PRO 6000 + 48GB RAM:Strata 跑 DeepSeek 1017,Decode 80.8 tok/s,524K Prefill 1,385 tok/s
    soop ladiosS soop ladios
    LLM讨论区 rtxpro6000 deepseek 多卡部署

    @lunarmoon26
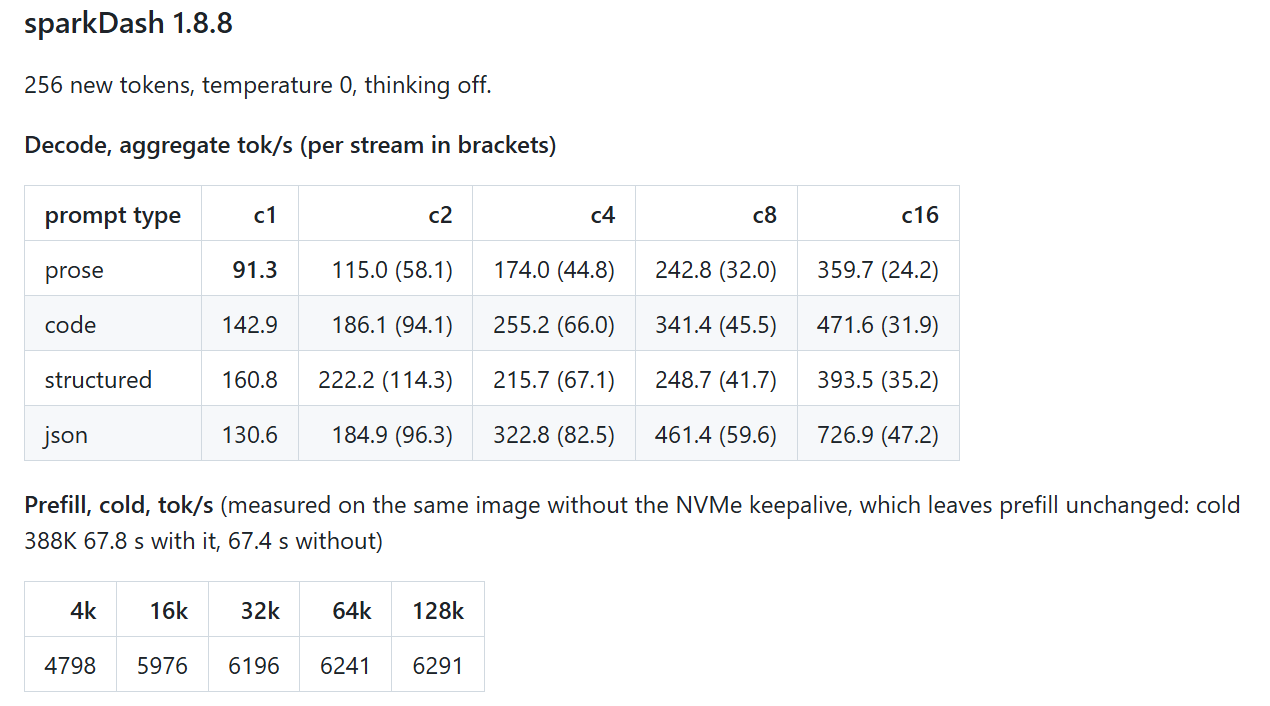
    這是我實測的數字, 配方來源 https://github.com/knapcio/DeepSeek-V4.1-Flash-4x-DGX-Spark-TP4
    這是原版模型,不是3 bit量化的. 10併發實測能有2x我覺得很好了.
    原repo的數據:
    螢幕擷取畫面 2026-10-26 060538.png

    我的實測c1 90~100多是實際跑任務觀察的, c10 是叫Agent打的, 平常沒那麼多在跑.
    社區上有更猛的repo, 不過要改到kernel, 我就懶得弄了


  • 双 RTX PRO 6000 + 48GB RAM:Strata 跑 DeepSeek 1017,Decode 80.8 tok/s,524K Prefill 1,385 tok/s
    soop ladiosS soop ladios
    LLM讨论区 rtxpro6000 deepseek 多卡部署

    @kos-or 10併發約230-260 tok/s.


  • 双 RTX PRO 6000 + 48GB RAM:Strata 跑 DeepSeek 1017,Decode 80.8 tok/s,524K Prefill 1,385 tok/s
    soop ladiosS soop ladios
    LLM讨论区 rtxpro6000 deepseek 多卡部署

    光就跑deepseek來說, DGX spark GB10還是比較香一點, 一張RTX pro 6000差不多就四台GB10的錢. 4台GB10可以跑滿血deepseek v4.1 flash 1017, decode 90~100 tok/s, prefill 3500-4000 tok/s, 500K ctx 10併發.


  • V100以NVFP4量化運行Strata實測 Qwen 3.8 Flash Next
    soop ladiosS soop ladios
    LLM讨论区 v100 strata qwen-flash

    @dardeaw-feng 原來是這樣,我是雙卡v100 32G, 是跑UD_K-Q4-XL


  • V100以NVFP4量化運行Strata實測 Qwen 3.8 Flash Next
    soop ladiosS soop ladios
    LLM讨论区 v100 strata qwen-flash
    UD-Q4_K_XL(Unsloth) 111 GB 72 GiB ~88 GB 93.1% 4-bit 中品質最好
    NVFP4(Strata GPTQ 版) 128 GB ~80 GB ~80 GB 92.09% V100 無 FP4 tensor core,走 8-bit 精度路徑

    請問照這個表, 不是UD-Q4_K_XL品質比較好嗎?為什麼選NVFP4?


  • 请教一个公司用的配置,希望有高低两种建议
    soop ladiosS soop ladios
    AI硬件 服务器 本地模型

    @丁浩

    @张光璞
    我裝了四台DGX SPARK GB10跑deepseek-v4.1-flash-1017 , KV緩存有3,371,520 logical tokens, 看你要分成幾併發, 我是設定500K, 10併發.
    部署來源; https://github.com/knapcio/DeepSeek-V4.1-Flash-4x-DGX-Spark-TP4
    一些測試數據:

    指標 標準 v2.4 目前配置
    實際 KV tokens 2,984,960 3,371,520
    增量 — +386,560,約 13%
    實際 prompt tokens TTFT(秒) 有效 prefill(tok/s)
    32,832 12.238 2,682.73
    131,144 37.584 3,489.33
    262,222 74.952 3,498.51
    500,075 200.850 2,489.79
    1,048,006 401.592 2,609.63
    併發 單 stream decode(tok/s,中位數) Aggregate decode(tok/s)
    C1 88.95 88.95
    C2 55.47 109.86
    C4 39.00 149.95
    C8 28.47 217.92
    C10 24.29 235.56

  • Tesla V100 32G雙卡跑Qwen 3.8 flash next IQ3_S, 393K上下文,雙併發, 80~90 tok/s, peak 120 tok/s, 雙併發KV緩存修復, 同場加映UD-Q4_K_XL對比
    soop ladiosS soop ladios
    LLM讨论区 v100 qwen-flash 多卡部署

    @kos-or
    Swift15 應該思考回合會少很多才是. xhigh可能是他寫的python跑到停不下來, 我就遇到這個問題, 不把它停掉可能一個python就跑好幾天..


  • Tesla V100 32G雙卡跑Qwen 3.8 flash next IQ3_S, 393K上下文,雙併發, 80~90 tok/s, peak 120 tok/s, 雙併發KV緩存修復, 同場加映UD-Q4_K_XL對比
    soop ladiosS soop ladios
    LLM讨论区 v100 qwen-flash 多卡部署

    @kos-or 這些都是正在上線跑的,順便測一下


  • Tesla V100 32G雙卡跑Qwen 3.8 flash next IQ3_S, 393K上下文,雙併發, 80~90 tok/s, peak 120 tok/s, 雙併發KV緩存修復, 同場加映UD-Q4_K_XL對比
    soop ladiosS soop ladios
    LLM讨论区 v100 qwen-flash 多卡部署

    @kos-or 我把手上有空的模型都測了一下:

    七輪直接隔離 Pi 解題測試:比較報告(2026-10-21)

    摘要

    七個正式輪次都已正常交付、凍結並完成獨立報告。提交 residue 均為 385583993536,與參考答案一致。 這是本題的數值比對結果,不等於七份原文都已通過完整嚴格證明驗收,更不能推成模型一般正確率 100%。使用工具為pi agent, 主持人為GPT 6.1 sol

    • 目前無人工解題介入輪次中,觀測端到端最短:Maya-L,1h58m39.466s。
    • Qwen UD-Q4_K_XL 為 2h28m38.344s;其已完成的裁判重跑包含大 N 與真正小 N 枚舉,但仍非窮盡形式化審證。
    • 新增 GLM-5.3-Flash-Q4_K_XL/4×V100 32GB:3h09m14.937s,與先前 Maya-L 分開記錄,沒有人工中斷/提示。約 65 分鐘消耗於模型自行設置的逾時,最後自行修正多項式容器未截短問題,大 N 主計算降至 4.9 秒。
    • Qwen NVFP4 是人工介入後完成:5h16m27.925s;其中單一額外驗證約四小時,另包含受控交接與使用者執行範圍指令。不可當成完全無干預結果直接併排名。

    1. 正式輪次、部署及時間

    模型名稱與硬體依使用者提供,未驗證服務端權重、量化檔或硬體身份。表列端到端為首次正式作答開始至最後交付,含推理、工具、錯誤、續答等,不是純 GPU 推理測速。

    模型資訊 模型名稱 使用者提供硬體 端到端 Invocation 外部解題介入
    Strata IQ3_S Qwen 3.8 flash next 2×Tesla V100 32GB, 64G ram 5h38m35.130s 2 無
    Strata UD-Q4_K_XL Qwen 3.8 flash next 2×Tesla V100 32GB, 64G ram 2h28m38.344s 1 無
    Qwen3.8-Flash-Next-NVFP4 Qwen 3.8 flash next DGX GB10 x 2 5h16m27.925s 5 有,另列,不作原始排名
    GLM-5.3-Int4-Int8Mix GLM 5.3 DGX GB10 x 8 3h39m18.201s 4 無
    GLM-5.3-Flash-NVFP4 GLM 5.3 flash DGX GB10 x 4 3h03m55.934s 16 無
    Maya-L GLM 5.3 flash 4×Tesla V100 32GB, 128G ram 1h58m39.466s 5 無
    GLM-5.3-Flash-Q4_K_XL GLM 5.3 flash 4×Tesla V100 32GB, 128G ram 3h09m14.937s 3 無

    Qwen3.8-Flash-Next-NVFP4寫出一個要跑幾十億次的迴圈, 跑完可能超過一天, 被發現後人工把它停止

    2. 正確性與驗收深度

    共同必要小 N 值為 N=2…8:1、3、6、15、63、195、717,各輪提交記錄均符合。下面明確分開數值、原文證明與裁判重跑範圍:

    模型 residue 比對 原稿審核重點/限制 裁判程式重跑範圍
    Strata IQ3_S 一致 R/S 組合律及共軛簡化有錯 快速大 N 路徑;小 N 對 small_ref,非重新暴力枚舉
    Qwen UD-Q4_K_XL 一致 初審未見同類明顯主幹代數錯誤,但非窮盡審證 大 N +實際 N=2…8 枚舉/Burnside,約 3.022 秒
    Qwen Flash NVFP4 一致 群關係漏二次取逆、分層集合域錯誤;部分額外驗證未完成 只審既有提交/日誌,且有人工介入
    GLM Int4-Int8Mix 一致 奇長 S₁ 固定字的乘積式有錯 未重跑完整套件;模型既有日誌包含多種交叉核對
    GLM Flash NVFP4 一致 共軛符號、反射尾端下標有局部錯誤 quick 大 N +實際 N=2…8 枚舉,26.211 秒;非 all/thorough 全套
    Maya-L 一致 O1 的求和式重複乘 3;程式採用正確閉式 依使用者要求,只審既有提交/日誌,不追加重跑
    GLM Flash Q4_K_XL 一致 一般反射相鄰邊索引漏 k';一般 exact 介面有範圍限制 只審既有提交/日誌,不追加重跑

    這不是把局部文字缺陷直接等同於最終計數錯誤;也不是因為 residue 正確,就忽略證明與重現性問題。詳細位置、修正方向、證據限制均列於各模型報告。沒有對任何模型宣告已完成全面形式化證明驗證。

    模型自行記錄的 N=9/10、exact/modular、成分級驗證或矩陣交叉核對,不冒稱為裁判新執行。重複讀取同一 log,也不計成多次獨立成功測試。

    3. 用量

    以下為保存的完成 assistant 訊息 usage 累加。reasoning 是 output 子集,不可再加一次。 input 與 cacheRead 的口徑不同,跨端點不可只比 input 欄位;這也不是實際服務端帳單。

    模型 API 請求 input cacheRead output reasoning
    Strata IQ3_S 75 442,834 9,756,614 178,325 116,613
    Qwen UD-Q4_K_XL 137 279,691 21,401,727 222,274 157,414
    Qwen Flash NVFP4 † 101 11,685,167 0 155,407 93,754
    GLM Int4-Int8Mix 79 12,352,483 0 186,328 125,397
    GLM Flash NVFP4 122 22,234,362 0 378,932 286,864
    Maya-L 32 221,558 4,733,035 212,131 177,550
    GLM Flash Q4_K_XL 25 155,552 2,764,653 147,284 116,563

    † 人工介入輪。其 101 個保存請求均有 response_end,完成訊息 usage 已列入,但仍不擴張解讀成完整服務端計費。GLM NVFP4 另有 compaction/無工具請求,因此訊息 usage 亦不保證涵蓋全部服務端用量。

    4. 公平性與可下的結論

    • 這一次題目上,七輪提交的 residue 全部正確,必要交付完整。
    • 在此次無外部解題介入的完整流程中,Maya-L 觀測耗時最短,Qwen UD-Q4_K_XL 次之。
    • 工具策略、驗證範圍、實作缺陷與自主除錯,足以主導端到端時間;Qwen 長迴圈與新 GLM 多項式尾巴就是明確例子。
    • 新 GLM 沒被裁判提示 bug,最後自行修正並完成;Qwen NVFP4 需單列使用者介入。

  • Tesla V100 32G雙卡跑Qwen 3.8 flash next IQ3_S, 393K上下文,雙併發, 80~90 tok/s, peak 120 tok/s, 雙併發KV緩存修復, 同場加映UD-Q4_K_XL對比
    soop ladiosS soop ladios
    LLM讨论区 v100 qwen-flash 多卡部署

    單卡@seabass 測過囉, 我貼一下:

    Tesla V100 32GB PCIe 跑 Qwen3.8-Flash-Next IQ3_S

    Strata | 200K 上下文 | 视觉:开 | Speculative Decoding:开 | 1 slot

    模拟真实多轮对话测试:每轮新增约 10K tokens + 提问,AI 回复保留在历史里,前缀缓存全程命中,一直聊到 183K。

    测试数据

    已用上下文 解码速度 首字延迟(新增 10K) 预填充速度
    10–40K 70–89 t/s 8.5–9.2 秒 1100–1180 t/s
    50K 74.5 t/s 9.4 秒 1081 t/s
    60–100K 49–57 t/s 10.5–13.7 秒 780–975 t/s
    110–150K 49–60 t/s 14–15.6 秒 695–765 t/s
    160–183K 48–61 t/s 16.5–17.2 秒 634–662 t/s

    结论

    1. 50K 以内:70–89 t/s,跟 IQ2_XS 差不多快
    2. 60K 以后:降到约 50–60 t/s,然后一直稳定到 183K,没有继续明显掉速
    3. 前缀缓存效果:即使 180K 上下文,每轮新增 10K 也只要约 17 秒首字

    還有@dardeaw-feng 兄說買了雙卡v100 16G, 應該馬上就有文發表了吧
    https://lcz.me/post/24315


  • Tesla V100 32G雙卡跑Qwen 3.8 flash next IQ3_S, 393K上下文,雙併發, 80~90 tok/s, peak 120 tok/s, 雙併發KV緩存修復, 同場加映UD-Q4_K_XL對比
    soop ladiosS soop ladios
    LLM讨论区 v100 qwen-flash 多卡部署

    @Chanver-Lao 這部分我沒紀錄,記得每條大概就單流的一半多一點吧, 之後有機會再詳細看看, 先排幾天的品質驗證跟看看上游有沒有更新

  • 登录

  • 登录或注册以进行搜索。
  • 第一个帖子
    最后一个帖子
0
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组