跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
soop ladiosS

soop ladios

@soop ladios
贵族大夫 硕果累累
取消关注 关注
关于
帖子
81
主题
11
分享
0
群组
2
粉丝
2
关注
0

帖子

最新 最佳 有争议的

  • Nvidia DGX spark一些心得
    soop ladiosS soop ladios
    LLM讨论区 dgxspark nvidia

    NVIDIA DGX spark 不是這邊的主力部署, 不過這裡有一些數據分享給想知道或是有類似需求的朋友.
    我的LLM的用途主要是工作上(驅動/韌體 開發/debug), 基本上需要模型跑在全精度或至少Q8量化以上. 我試過FP8相較BF16已經略差, Q4實際使用上是無法達到我的需求.
    在這個前提下, 我需要的是更多的vram, 能夠跑Q8以上的模型, 並且至少需要256K context, 才能比較舒適的使用. DGX spark雖然不快, 但是如果我想跑minimax, deepseek, mimo之類的模型, 選擇似乎也不多. 如果有超大模型, 超長上下文, 多併發的需求, 同時又不能使用雲端模型的情況下, DGX spark是可以考慮的選擇之一.
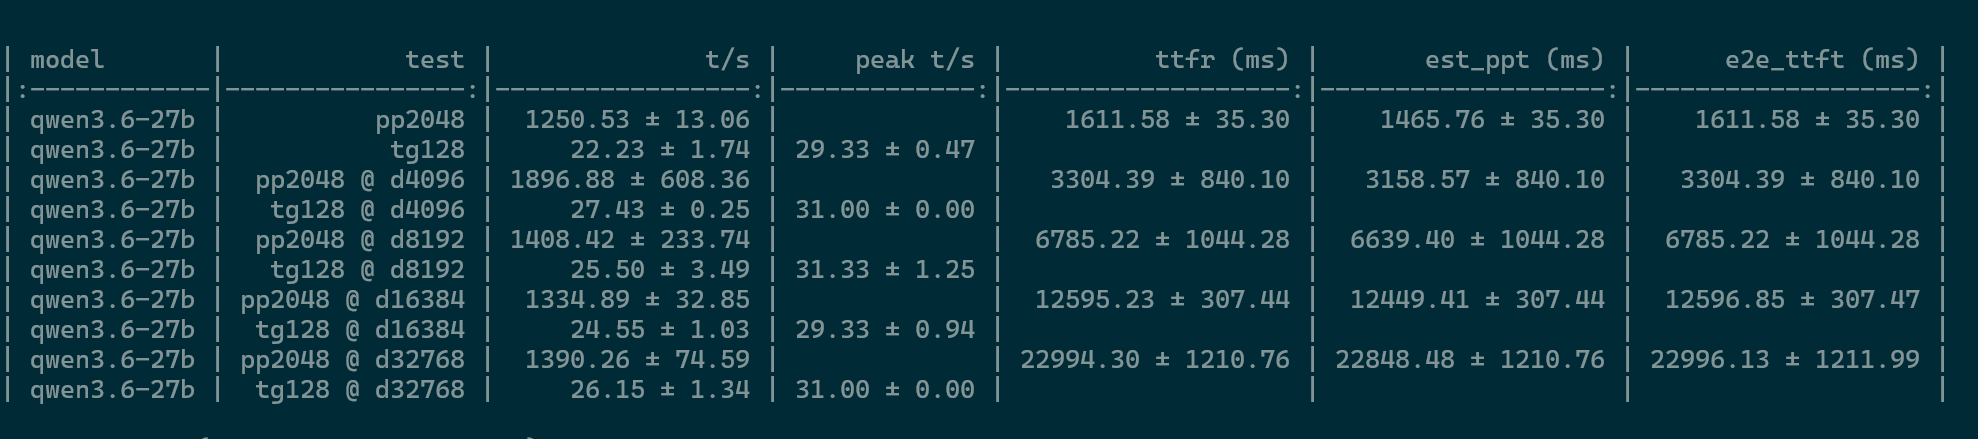
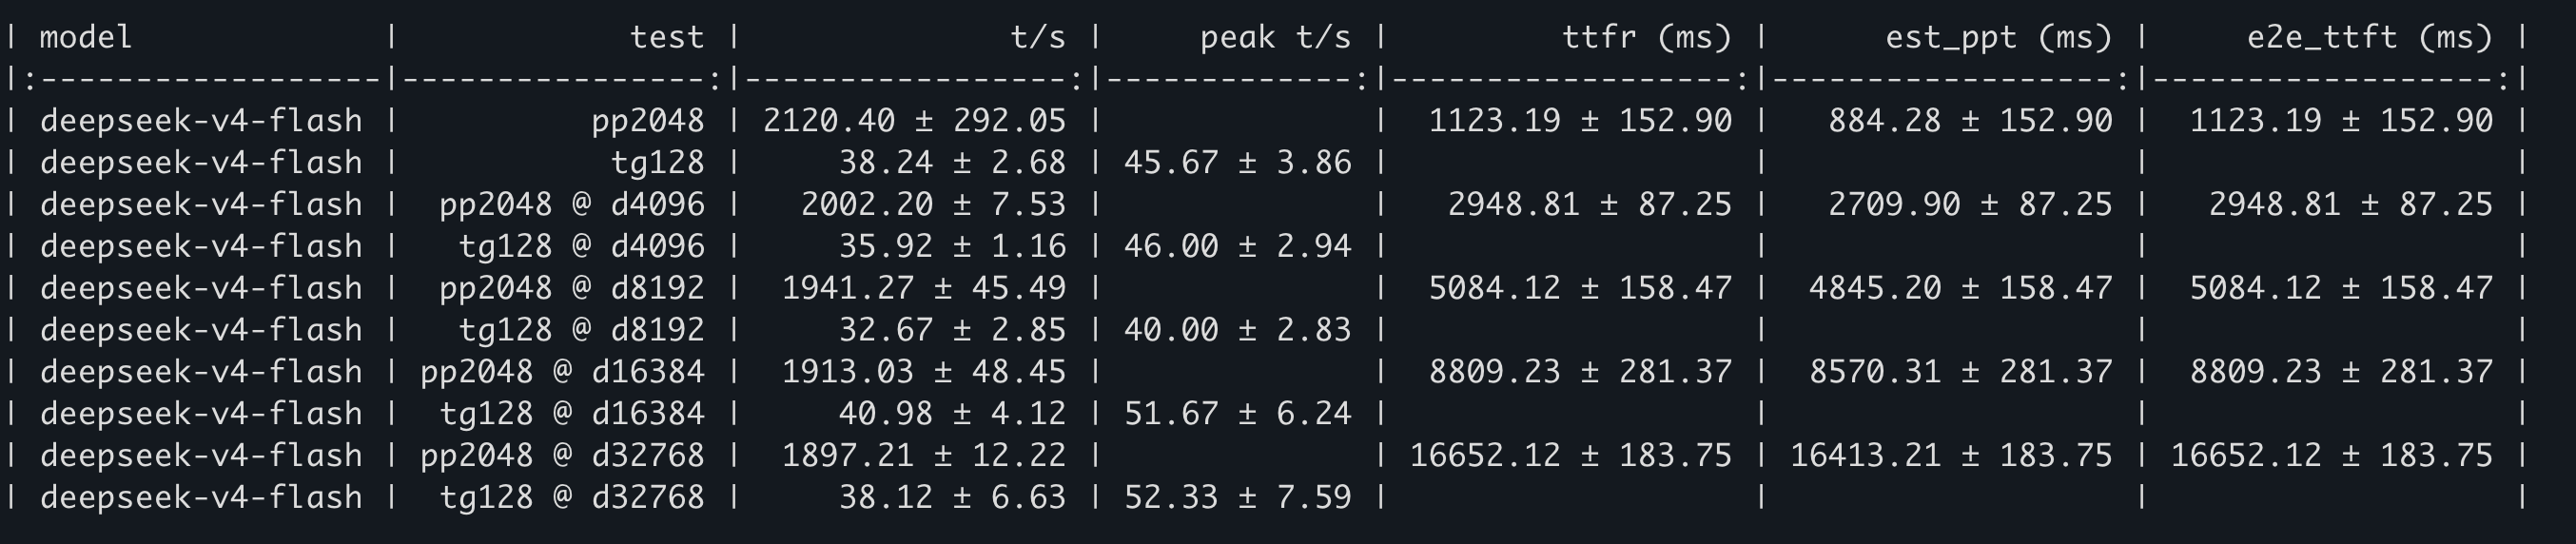
    現在我手上有4台DGX spark, 因為QSFP switch還沒到手, 所以只能先倆倆對接, 四台還沒辦法接在一起. DGX spark自帶兩個connectX-7 QSFP介面, 把多台接在一起的時候,透過RDMA 和張量並行,集群可實現部分加速, 越多台速度越快,這應該比mac的exo快, 我沒有多台mac, 所以不知道實際狀況如何. 目前我是跑Qwen/Qwen3.6-27B-FP8(模型權重30.9G)跟deepseek-ai/DeepSeek-V4-Flash全精度模型(模型權重160G), 下面速度供大家參考:

    Qwen/Qwen3.6-27B-FP8單spark:
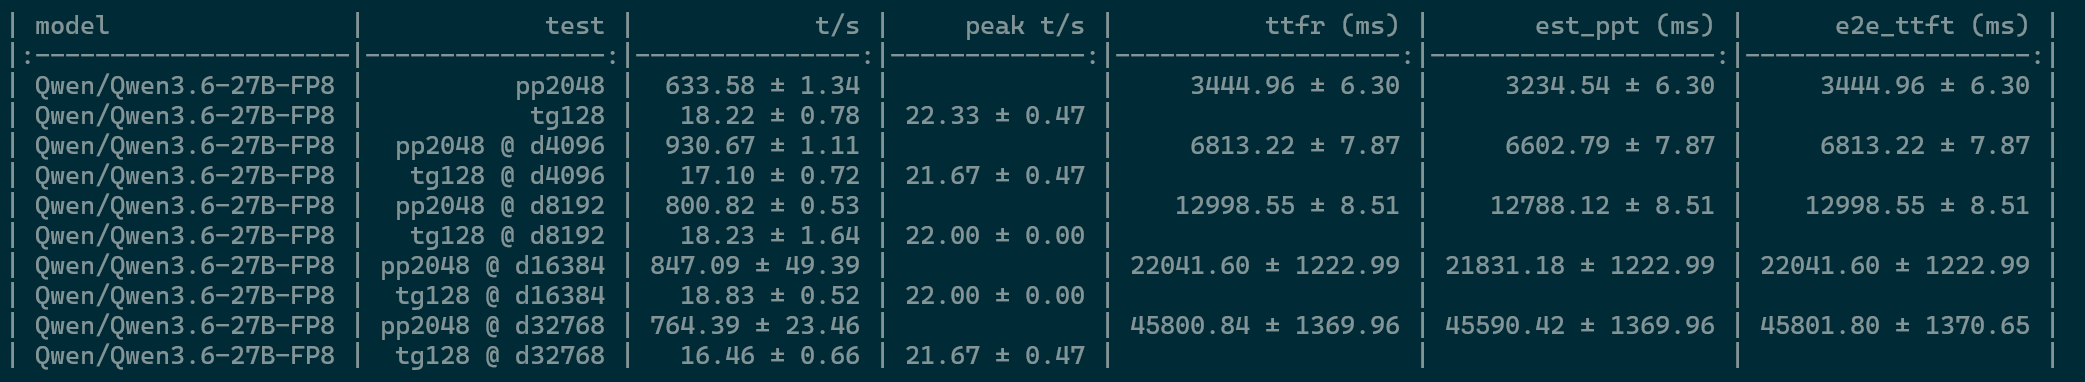
    qwen3_single_spark.png
    Qwen/Qwen3.6-27B-FP8雙spark:
    qwen3-dual_spark.png
    deepseek-ai/DeepSeek-V4-Flash, 雙spark:
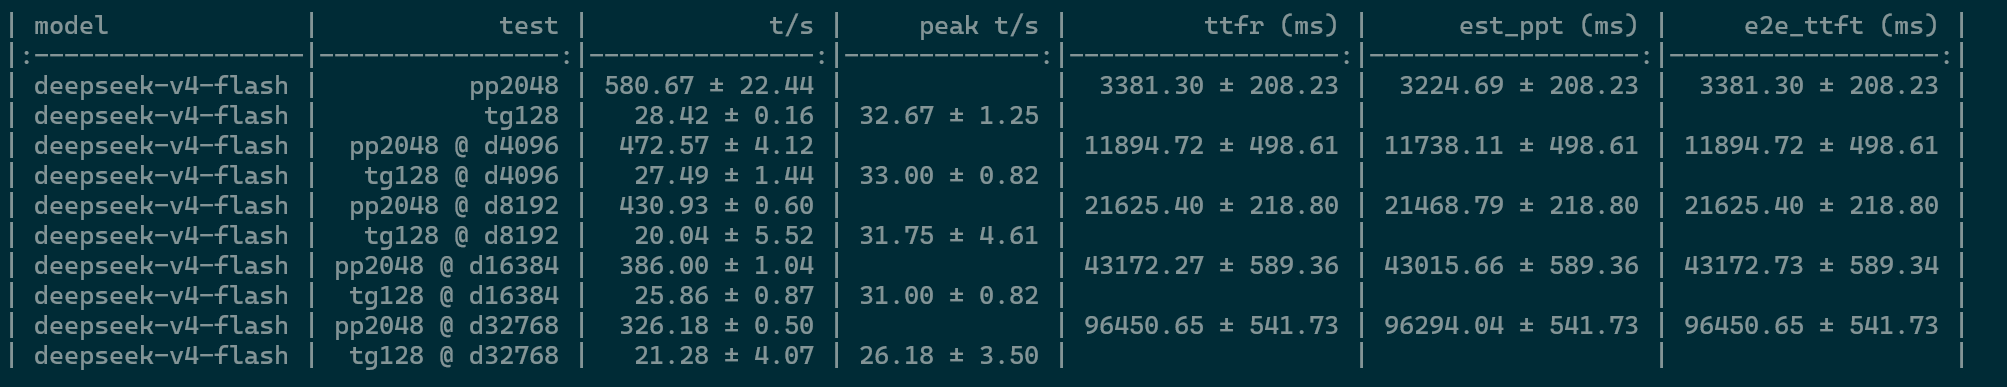
    deepseek.png

    速度不是非常快, 不過因為平常我也不跟它們聊天, 都是用opencode或pi把工作丟給它們就去做別的事了, 所以也還好. 基本上有個20我就覺得可以用了, 畢竟這是8 bit的模型, 也不能強求什麼了.
    這兩個模型依我的使用比較起來, 感覺智力上相當接近, qwen 3.6 27B在tool call上出錯比較少, 是真的能打. 雖然跟claude opus 4.7或GPT 5.5相較之下還是有差異, 不過也堪用了.

    至於ComfyUI嘛.. 它就是一個沒有什麼跑不動, 卻也沒有什麼跑的快的狀態.

    6/2更新, deepseek v4 flash spark論壇上有新的優化, 請gemini cli照做後性能有所提升.
    論壇網頁:
    https://forums.developer.nvidia.com/t/deepseek-v4-flash-official-fp8-running-across-2x-dgx-spark-tp-2-mtp-200k-ctx-recipe-numbers/370309/135

    測試:
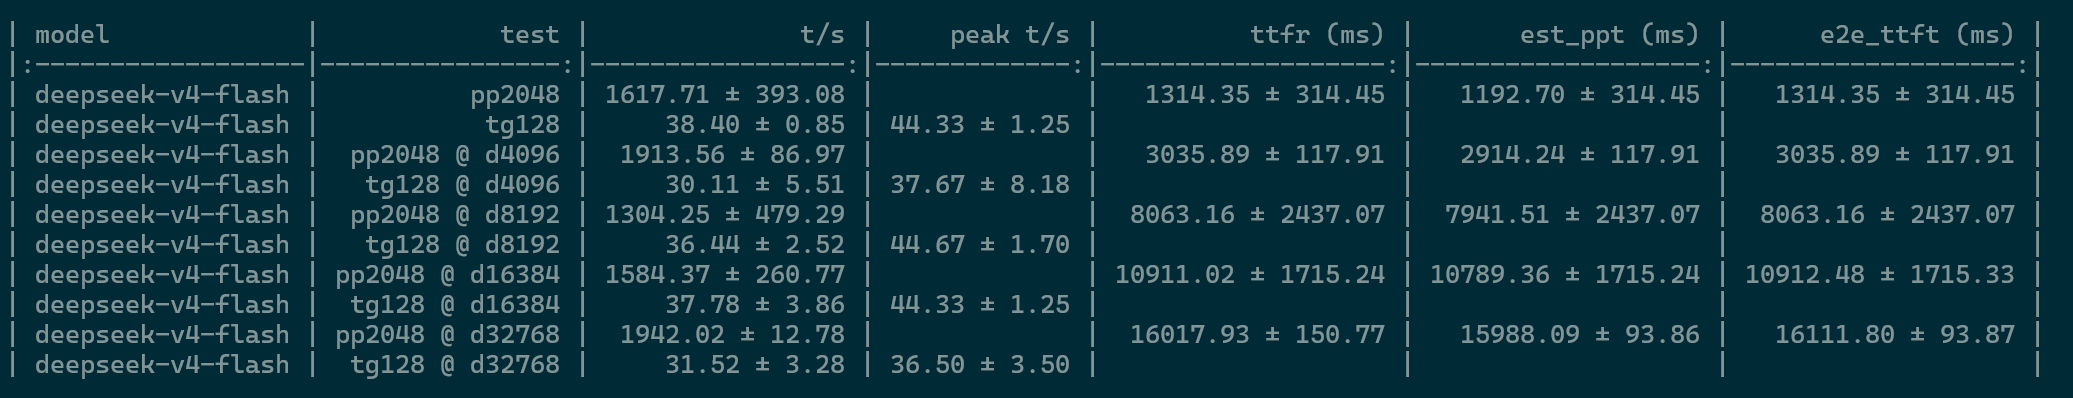
    螢幕擷取畫面 2026-06-02 233155.png


  • 想买两台华硕 DGX 跑 V4,论坛大神给个建议吧
    soop ladiosS soop ladios
    AI硬件 dgxspark deepseek

    我已經用了好一陣子了, coding中速度30~70不定, pp約2000.
    我來回答你的問題:
    1. 两台 DGX Spark 跑 V4,实际生成速度大概能到多少 token/s?
    測速約40~50, 實際coding使用視狀況約落在30~70不等.
    2. 两台之间用 200G 网络互联,实际通信效率怎么样?
    這有點複雜, 他每一個port有兩個rail, 各100G, 你可以用100G或200G, 看怎麼設. 我是用100G, 看他實際也沒用到100G, 就沒去搞200G了. 實測iperf約97G
    3. 跑 V4 的时候,两台机器是比较接近“线性叠加”,还是通信开销会吃掉很多性能?
    因為一台跑不了正常V4 flash, 所以沒辦法比較. 不過照之前別的模型的經驗,兩台速度約為一台的1.5倍左右. 我之前也跑過4台,速度又比兩台快上不少
    4. 如果主要用途是编程、Agent、长上下文和日常本地 AI,两台 DGX Spark 是否值得?
    我只用來編程, 主要是驅動韌體的開發跟debug, 跑claude code或codex cli , 兩台實際上約可以並行6個ctx 500K的session. 使用上是夠順了, 就看智力跟能力符不符合你的需求, 我是覺得不到優秀,但是堪用.
    5. 有没有已经实际部署过 V4 的朋友,能分享一下真实测试数据?
    截圖 2026-08-15 上午8.14.24.png

    6. 如果现在买,华硕、技嘉、微星等不同品牌的 DGX Spark,散热、SSD、稳定性方面有没有明显区别?
    1TB 版本是不是就够了?后面自己升级 SSD 是否更划算?
    我有華碩跟技嘉的, 感覺差不多. 兩台的話還好,反正也跑不了多大模型, 選擇也不多. 1T應該可以,有需要日後再換就好. 如果只用來跑模型的話, 速度瓶頸在頻寬, 長時間不間斷運轉可以考慮GPU降頻跑不會影響pp跟t/s太多, 溫度跟功耗會下降不少

    最後應該考慮的是, 是否真的有這個需求? 這需要從用量跟隱私方面評估了. 兩台GB10不便宜, 漲價後更是誇張. 若是用量沒那麼多, 兩台GB10可能可以抵過10年的線上費用, 隱私又沒問題的話, 可以考慮線上使用就好. 本地用起來是舒適, 線上的是飛快, 爽度還是有差.


  • Deepseek v4.1 flash , 4台DGX spark GB10, TP=4
    soop ladiosS soop ladios
    LLM讨论区 deepseek dgxspark gb10

    V4.1 flash釋出沒多久, DGX論壇上已經有幾個看起來不錯的配方了, 今天選了一個裝起來, 速度很讓人驚豔, 實際品質未知, 等跑了幾天實際任務再update. 實際工作單條工作流約40-60 tok/s, 三條約50-100 tok/s. prefill速度在2500 ~ 3000 tok/s左右, 快取命中約99%.

    使用方案: https://github.com/MiaAI-Lab/DeepSeek-v4.1-Flash-DGX-Sparks , 模型為官方原始模型. 用Antigravity cli + gemini flash 3.8 安裝, 過程遇到幾個坑它自行解決, 安裝資訊與測試數據如下:

    DeepSeek-V4.1-Flash TP4 部署與測試總結報告 (Summary)


    一、 模型與服務基本資訊

    • 模型名稱 (Model Name):deepseek-ai/DeepSeek-V4.1-Flash
    • 權重版本 (Pinned Revision):fb2764a5cf321eaa5070ca8f9e892818f477c16d
    • 上游原生路線:MiaAI-Lab TP4 原生路由 (https://github.com/MiaAI-Lab/DeepSeek-v4.1-Flash-DGX-Sparks)
    • 硬體環境:4× NVIDIA DGX Spark (GB10, aarch64, 單節點 121.7 GiB 統一記憶體)
    • 高速網路互連:200G RoCEv2 (rocep1s0f0 / enp1s0f0np0), MTU 9000 (Jumbo Frames), GID Index 3

    權重存儲與掛載:完整模型權重(476 GB,48 個 safetensors 分片)存放於 HEAD 本地 NVMe,透過 RoCE 容器化 NFSv4 (dsv41-weights) 共享給 WORKERS 唯讀掛載,各節點無重複複製。


    二、 核心規格與配置參數 (Core Specs & Configurations)

    核心參數 數值 / 設定 說明
    Context Length (ctx size) 1,048,576 (1M tokens) 模型原生完整支援長度;生產實測認證邊界依上游 Proxy 設定為 500K tokens
    Max Running Requests (max seq num) 8 支援最大並行請求數,CUDA Graph 完整捕獲 Batch Size 1 ~ 8
    KV Cache Pool Size (kv cache size) 4,000,000 (4M tokens) 每 Rank 分配 1,000,000 tokens,100% 完整採納(零 downscaling 降級),FP8
    精度
    靜態記憶體比例 (Mem Fraction Static) 0.78 (Head: 0.78) 預留 ~94.9 GB 靜態預算,保證 4M KV pool 成功分配,並為各節點留出 18~20 GiB 實體
    記憶體空間
    分塊預填充尺寸 (Chunked Prefill Size) 2048 tokens 抑制 FP4 indexer attention logits 峰值張量至 2.0 GB,徹底消除超長上下文 OOM
    快取釋放頻率 2048 tokens DSV41_PREFILL_EMPTY_CACHE_TOKENS=2048,每分塊預填充後立即主動釋放記憶體片段
    推測解碼 (Speculative Decoding) DSpark (Block Size = 5) 草稿模型 DeepseekV4ForCausalLMDSpark 圖融合加速,動態接受率 ~0.44
    Engram Offload 本地 NVMe 卸載 Layer 1 與 Layer 14 各 ~24 GiB,96 I/O threads 直讀,完全不佔用主機 RAM 與網路頻寬
    多模態視覺 (Vision) 原生支援 (Triton Backend) 支援 3024×588 高解析度影像,標準消耗 1024 視覺 tokens
    健康檢查機制 SGLANG_ENABLE_HEALTH_ENDPOINT_GENERATION=0 /health 即時回應 HTTP 200,杜絕長文本 Prefill 期間 dummy generation 造成的假死誤判

    三、 驗證與測試數據 (Verification & Benchmark Data)

    1. 基礎功能與能力驗證 (Correctness & Advanced Capabilities)

    測試項目 輸入條件 輸出結果 / 指標 狀態
    算術邏輯 (Arithmetic) 19 + 23 輸出 42,延遲 0.32s 通過 (PASSED)
    代碼生成 (Code Generation) 快速逆平方根 (Fast Inverse Square Root) 輸出完整包含 0x5f3759df 與牛頓迭代之代碼,解碼速率 39.2 tok/s 通過 (PASSED)
    結構化輸出 (JSON Schema) 巴黎景點資料 Strict JSON Schema 100% 吻合 Schema 定義,延遲 1.19s 通過 (PASSED)
    思考切換 (Thinking OFF) 質數判定直接回答 直接回覆 Yes,無思考內容,延遲 0.29s 通過 (PASSED)
    深度思考 (Thinking ON) 質數判定逐步推演 產出 1,536 字元之完整數學證明思維鏈,延遲 12.05s 通過 (PASSED)
    工具呼叫 (Tool Calling) get_stock_price(NVDA) 正確發起 Tool Call 參數並於次輪整合回傳股價,總延遲 2.21s 通過 (PASSED)
    原生視覺 (Multimodal Vision) 3024×588 幾何彩色圖形 精準識別紅圓與藍方之相對位置,消耗 1024 vision tokens,延遲 2.07s 通過 (PASSED)

    2. 長上下文階梯壓測 (Long-Context Benchmark)

    依據生產反向代理(Proxy)預設上限 500K,測試數據如下:

    測試長度 (Tokens) 首字延遲 (TTFT) Prefill 吞吐速率 輸出 Tokens 解碼延遲 解碼速率 總耗時 (Wall Time) 輸出品質 狀態
    32K (32,768) 10.02s 3,271.0 tok/s 64 0.95s 67.5 tok/s 14.44s 技術摘要精準連貫 PASSED
    128K (131,072) 48.46s 2,704.8 tok/s 64 0.95s 67.5 tok/s 48.94s 技術摘要精準連貫 PASSED
    256K (262,144) 87.46s 2,997.3 tok/s 64 1.08s 59.4 tok/s 88.00s 技術摘要精準連貫 PASSED
    500K (500,000) 268.94s 1,859.1 tok/s 64 1.10s 58.2 tok/s 269.49s 技術摘要精準連貫 PASSED

    記憶體監控結果:在 500K 超長上下文推演期間,各節點 GB10 實體可用記憶體均保持在 18 ~ 20 GiB,Swap 使用量全程維持 0 bytes,無任何 OOM 或快取逐出情況。


    3. 高並發壓測 (Concurrency Benchmark C1 → C8)

    測試梯級涵蓋 C1 至滿載 C8 並行請求,每請求生成 128 output tokens:

    並發等級 成功率 總耗時 (Wall Time) 總生成 Tokens 聚合吞吐速率 平均請求延遲 P50 延遲 P95 延遲 狀態
    C1 (1 並行) 1/1 (100%) 3.47s 128 36.9 tok/s 3.47s 3.47s 3.47s PASSED
    C2 (2 並行) 2/2 (100%) 5.13s 256 49.9 tok/s 5.05s 5.05s 5.12s PASSED
    C4 (4 並行) 4/4 (100%) 6.72s 512 76.2 tok/s 6.45s 6.47s 6.72s PASSED
    C6 (6 並行) 6/6 (100%) 8.27s 768 92.8 tok/s 7.59s 7.86s 8.27s PASSED
    C8 (8 並行) 8/8 (100%) 10.67s 1024 96.0 tok/s 8.51s 8.50s 10.66s PASSED
    • 全數成功:21/21 個請求全部成功回傳(成功率 100%)。
    • 極速解碼:滿載 8 並發下,聚合輸出速率達到 96.0 tok/s,P50 延遲僅 8.50s。
    • 動態排程:SGLang 與 CUDA Graph 完美覆蓋動態批次,無重新分配與記憶體震盪。


  • Mac studio M5 ultra 256G - glm 5.3 flash 初嘗試
    soop ladiosS soop ladios
    LLM讨论区 apple-m5 glm 本地模型

    機器到手後嘗試安裝了一下GLM 5.3 flash, 本次使用 oMLX main 原始碼與原生 Metal 核心配方,模型 ID GLM-5.3-Flash-oQ4e-mtp,context 262144,常態併發 4 路。8 路額外測試已完成,現已恢復 4 路。主要是模型權重較大, 需要多併發就需要限制上下文, 不過記憶體看來還有餘裕, 以後需要可以再調整.

    環境與版本

    項目 實際結果
    硬體/系統 Mac Studio Mac17,15、M5 Ultra、256 GB Unified Memory、macOS 27.0.1
    磁碟 安裝前約 1.8 TiB 可用;完成後 1.5 TiB 可用
    oMLX 原始碼/commit ~/omlx-glm-src;base a4048eef24b41d885d593742e32a290f3bdb2300,recipe patch d6c33e309876454e43a3e6a5ce497934d00a4496,upstream #4086 patch/實際 HEAD 85ef9488063c28e3b770b95153f7fee7384e7035
    oMLX/MLX/mlx-lm 0.7.0rc1/0.32.2/0.31.4.dev132+g94cdcae13;五項原生核心 bonsai、decode_fast、glm_moe_dsa、minimax_m3、qwen35_prefill 均可載入
    建置工具 Python 3.12.15、Xcode 27.1 (27A9275)、CLT 27.0、Metal Toolchain 27A266a、Apple metal 32023.921、CMake 4.4.4
    oQ4e backbone ~/models/src/dfp-GLM-5.3-Flash-oQ4e-mtp,revision 728cc0d92aef48d64bd2a7ebfaefec6aeff5921b;34 個 shard,181,607,491,134 bytes,與索引一致
    MTP donor ~/models/src/vontra-mtp,revision 76add2a341a1cd90ad0e86bb69839ea9c35827c6;layer 45 共 2,641 個 tensors
    官方模板 ~/models/src/zai-template,revision eb9eb208eb0d988989d07a6a12d0fdeb5f52574a;與輸出模板逐位元組一致
    最終模型 ~/models/mlx/GLM-5.3-Flash-oQ4e-mtp;~/models/mlx 指向 ~/models.noindex/mlx;graft shard 4,183,682,557 bytes,索引共 5,639 鍵

    runtime/model_settings.json 設定 MTP enabled、fixed depth 2、max context 262144;scripts/serve-local.sh 啟用 Prompt Lookup、HC GEMV、232 GB memory guard。設定隔離於本專案 runtime/。API /v1/models 回報 max_model_len=262144;最終重啟後 Chat Completions 回覆 OK,模型載入 32.09 秒。Prompt Lookup 專項複製測試 32/32 行正確;伺服器記錄 drafted 280、accepted 278(99.3%)。MTP 日誌顯示 nextn layer 已綁定。

    Metal wired-memory 設定

    本機 Unified Memory 為 256 GB。iogpu.wired_limit_mb 參數存在,原值 0;已執行 sudo sysctl -w iogpu.wired_limit_mb=245760,調整後回讀及最終再讀均為 245760 MB(240 GiB)。模型成功分配 Metal 記憶體並完成全部測試。**還原命令:sudo sysctl -w iogpu.wired_limit_mb=0。**未設定開機自動套用,未修改 SIP、Swap 或其他系統參數。oMLX 提示其內部 static ceiling 254 GB 高於系統 Metal cap 240 GB;實測配置最高 192.343 GiB,服務另有 232 GB memory guard。

    Benchmark

    2026-10-22 實測。TTFT、Prefill、Decode 取自 OpenAI streaming usage;TTFT 單位秒,速率 tokens/s。長 Context 在開頭埋隨機碼、末尾提問,三項回憶皆正確。短輸出只有 6–8 tokens,Decode 值僅供參考。原始逐請求結果:runtime/benchmarks/results-4.jsonl、results-8.jsonl;約每 2 秒監控:memory-4.csv、memory-8.csv。

    Context 目標 實際 prompt tokens Prefix cache tokens TTFT Prefill Decode 回憶
    32K 31,618 0 18.73 1,688.32 40.22 通過
    128K 129,926 0 68.24 1,903.85 29.81 通過
    256K 260,998 163,840 146.26 664.27 40.59 通過

    256K 命中前次 prefix cache;664.27 tokens/s 是 oMLX 對未快取部分的回報,不能直接與前兩列的未快取 Prefill 比較。三項實際 prompt 均低於 262144 上限。

    同時請求數 TTFT 範圍(秒) Prefill 範圍(tokens/s) Decode 範圍(tokens/s) 各串流 Decode 速率合計(tokens/s) 結果
    1 0.23 134.86 86.71 86.71 1/1 正常結束
    2 0.08–0.33 24.27–93.46 34.98–35.93 70.91 2/2 正常結束
    4 0.21–1.04 1.92–145.26 18.92–27.61 100.40 4/4 正常結束
    8(暖機後) 0.10–0.79 2.55–19.78 13.82–16.41 123.42 8/8 正常結束

    短 prompt 每路僅 31 tokens,多數命中 prefix cache,因此併發 Prefill 值主要供記錄。8 路首次冷載入測試也 8/8 正常,模型載入約 31.1 秒,合計 Decode 118.45 tokens/s;表中採暖機後數據。合計是各串流回報速率相加,並非同一時間窗的端到端吞吐。

    Tool Calling:指定 lookup_city 函式與 Taipei 參數,回傳 finish_reason=tool_calls,JSON 參數 {"city":"Taipei"} 正確;通過,端到端約 2.281 秒。

    監控範圍 最低 Memory Pressure free Swap 最大使用 Metal in-use 峰值 Metal allocated 峰值 oMLX footprint 峰值 oMLX 壓力
    常態 4 路及 32K/128K/256K 23% 7.19 MB 187.869 GiB 189.769 GiB 187.647 GiB ok
    額外 8 路含冷載入 22% 62.50 MB 190.424 GiB 192.343 GiB 189.974 GiB ok

    8 路期間 Swap 由 7.19 MB 增至 62.50 MB,未達停止線 512 MB。監控腳本在 free ≤12%、Swap ≥512 MB、Metal in-use/allocated ≥232 GiB 或 oMLX 壓力達 hard/critical 時終止本服務。上表為各測試時段峰值;CSV 保存完整時間序列。


  • 有大神在本地部署 GLM 5.2 吗?
    soop ladiosS soop ladios
    LLM讨论区 本地模型 glm

    最近我的DGX SPARK GB10增加到了10台, 其中八台拿來跑GLM5.2, ctx 320K x 10. 正在測試中, 感覺是比deepseek v4 flash強, 強多少要多跑幾天才知道
    不過很慢, prefill 大概600-800, tok/s大概2x
    ps. 四台就可以跑了, 參考 https://forums.developer.nvidia.com/t/glm-5-2-on-a-4x-gb10-cluster-22-tok-s-decode-256k-ctx-recipe/374125


  • 有大神在本地部署 GLM 5.2 吗?
    soop ladiosS soop ladios
    LLM讨论区 本地模型 glm

    @566656661
    CRS804是4 port 400G QSFP56-DD, 每個port由八條獨立的資料通道組成, 所以可以分出2x200G, 4x100G等等. 買對線就可以接8台或16台DGX spark. 我看TP 8的時候網路流量好像也沒有到100G, 所以接16台應該對速度也沒有影響. 我是買這條線, 接了8台
    螢幕擷取畫面 2026-07-11 232515.png


  • Asus Ascent GX10到货,双gb10的DSV4-Flash集群全程hermes远程部署
    soop ladiosS soop ladios
    AI硬件 gb10 deepseek hermes

    @kop-wang
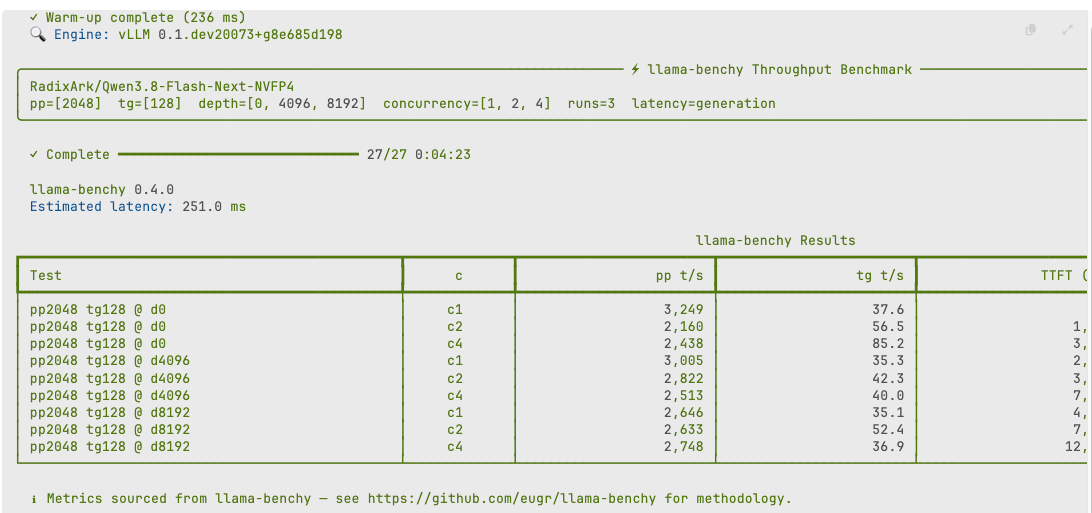
    我是沒用兩台跑過qwen 3.8 flash next, 機器都拿去跑別的模型了. 照以往的經驗, 兩台大概可以提昇1.3~1.5倍左右的速度.
    這邊有一台用SGLang跑出43 tok/s平均速度的可以參考 https://github.com/azampatti/GB10-3.8-Flash-Next

    也有人兩台跑vllm的nvfp4可以參考:
    截圖 2026-09-02 下午3.30.20.png


  • 这可能是目前本地部署GLM5.2 的最佳方案了
    soop ladiosS soop ladios
    LLM讨论区 本地模型 glm mac

    我跑的是這個 https://github.com/ciprianveg/gb10-glm-5.2
    不過是用八台, 為了榨出更多的併發數, 我用了DCP4 , prefill跟tok/s都慢不少, 不過得到300K x 10 的ctx
    截圖 2026-07-31 下午1.54.06.png

    如果是DCP1的話會快上不少, 這是作者的數據:
    截圖 2026-07-31 下午2.05.08.png


  • 單卡3060 12G跑Strata Qwen 3.8 flash next -- IQ2_XS 與 IQ3_XXS 比較
    soop ladiosS soop ladios
    LLM讨论区 rtx3060 strata qwen-flash

    本來這台電腦只是隨便插上一張沒在用的顯卡, 想不到也有起飛的一天, 紀錄一下IQ2_XS跟IQ3_XXS的規格差異點.
    心得放在前面:
    IQ3_XXS整體表現雖然比我的4卡V100 32G的Qwen3.8-Flash-Next-NVFP4略差, 但不會差太遠. 只是併發與上下文長度還是完全無法相比, 但單流使用已經是能用了. 相較之下IQ2_XS就差距比較明顯, 工作表現跌跌撞撞的. 可以的話還是裝IQ3_XXS, 多耗損的資源不多, 但整體水平相差巨大.

    硬件資源比較如下:
    本報告針對在同一台硬體設備上運行的 Qwen3.8-Flash-Next 兩種量化版本——IQ2_XS 與 IQ3_XXS,提供主機硬體環境、架構配置、資源佔用、實測效能與回答品質的客觀對比分析。


    1. 測試平台與電腦整體硬體配置 (Hardware Environment)

    硬體組件 規格型號 詳細參數與運行狀態
    中央處理器 (CPU) AMD Ryzen 9 9950X 16-Core Processor 16 核心 / 32 執行緒,完整支援 AVX-512、AVX2 指令集
    獨立顯示卡 (GPU) NVIDIA GeForce RTX 3060 12GB 12,288 MiB GDDR6,Compute Capability 8.6 (Ampere 架構)
    匯流排介面 (PCIe) PCIe 4.0 x16 實測 Host-to-Device DMA 傳輸頻寬高達 26.8 GB/s
    系統主記憶體 (RAM) 64 GB (系統實體識別 62 GiB) 交換空間 (Swap) 配置為 8.0 GiB
    資料儲存空間 (Storage) 11 TB LVM 磁區 (/opt) 掛載於 /dev/mapper/vg_storage-lv_data,可用餘量約 9.0 TB
    作業系統 (OS) Linux 6.17.0-35-generic x86_64 標準 Linux 64-bit 運行環境
    顯示卡驅動 / CUDA NVIDIA Driver: 590.48.01 CUDA Version: 13.1
    推論引擎 (Engine) Strata v0.1.39 (commit 6f32ec07) 官方預建 (Ready-Made) CUDA 13 / RTX 30 系列二進制引擎

    2. 核心規格與配置對比

    比較維度 IQ2_XS (2-bit i-quant) IQ3_XXS (3-bit i-quant) 差異說明
    模型 Shard 1 大小 ~37 GB ~44 GB IQ3_XXS 增加約 7 GB 專家量化權重
    模型 Shard 2 大小 ~27 GB ~27 GB 共用完全相同的 PLE n-gram 查表檔案
    總下載檔案大小 ~68 GB ~76 GB IQ3_XXS 總體積稍大約 11.7%
    目標 Context 長度 262,144 tokens (256K) 262,144 tokens (256K) 完全相同,皆為完整原生 256K
    KV Cache 精準度 INT8 (KV Streaming) INT8 (KV Streaming) 完全相同
    KV Resident 顯存駐留 32,768 cells / QSA layer 32,768 cells / QSA layer 完全相同
    KV Cache RAM 容量 3.09 GiB (Pinned RAM) 3.09 GiB (Pinned RAM) 完全相同
    預設 Temperature 0.4 0.4 完全相同
    投機解碼 (MTP) 4 tokens (--spec 4) 4 tokens (--spec 4) 兩者皆掛載 835 MiB Draft Head

    3. 記憶體與硬體資源佔用對比

    資源項目 IQ2_XS IQ3_XXS 說明與影響
    Expert Arena (Pinned RAM) ~35.5 GB ~40.9 GB IQ3 需多鎖定約 5.4 GB 實體記憶體
    Strata Process 總 RSS 約 38 ~ 40 GB 約 46 ~ 47.4 GB 包含權重、KV Cache、運算 Buffer
    模型 Idle 時系統總 RAM 使用 ~42 GiB / 62 GiB ~50 GiB / 62 GiB IQ3 系統佔用率由 67% 升至 80%
    系統剩餘可用 RAM (MemAvailable) 約 19 ~ 20 GiB 約 12 GiB IQ2_XS 能為背景程式留下更多記憶體餘裕
    GPU VRAM 總佔用 ~11.50 GiB / 12 GiB ~11.58 GiB / 12 GiB 兩者皆高度利用 RTX 3060 顯存
    VRAM 專家快取容量 4,119 個 slots (~5.53 GiB) 3,030 個 slots (~5.07 GiB) IQ3 投影矩陣權重略大,GPU 快取專家數少約 26%
    VRAM 安全緩衝餘裕 474 MiB 459 MiB 均保持安全裕度避免 CUDA OOM

    4. 推論速度與實測基準對比 (Benchmarks)

    以下數據皆基於同一平台實際 API 呼叫實測所得:

    效能指標 IQ2_XS IQ3_XXS 效能差異評估
    短文本解碼生成速度 (Decode) 54.3 tokens/s 46.3 tokens/s IQ2_XS 速度快約 17%
    長文本解碼生成速度 (35K+ Context) 49.5 tokens/s 44.9 tokens/s IQ2_XS 速度快約 10%
    長文本 Prefill 處理速度 (35K Context) 1,062.1 tokens/s 1,073.3 tokens/s 兩者 Prefill 速度相當(~1,070 tok/s)
    長文本 35K Tokens Prefill 總耗時 33.0 秒 32.6 秒 處理 3.5 萬 token 均在約半分鐘完成
    投機解碼 (MTP Draft) 接受率 ~75% - 85% ~80% - 100% IQ3 因品質提升,草稿預測接受率略高
    Prompt Cache 命中率 95.7% (實測) 相同機制 (即時命中) 多輪對話皆可跳過重複 Prompt 運算

    5. 模型品質與推理能力分析

    • IQ2_XS(~2.3-bit i-quant):
      • 特點:在低位元量化中屬於高性價比方案,大幅降低 RAM 佔用並提高生成吞吐量。
      • 品質表現:處理一般摘要、對話、簡單邏輯或常規文字產出表現良好;但在極複雜的長鏈條邏輯推理、多重條件邊界處理、精準格式輸出(如高難度 JSON/語法樹解析)時,細節偶有語義衰減或幻覺。
    • IQ3_XXS(~3.0-bit i-quant):
      • 特點:官方評為 "Great Quality",每個權重多出約 30% 的位元精確度。
      • 品質表現:邏輯嚴密性、長程推理能力與指令遵循能力有顯著提升,數理推理與複雜程式碼生成更貼近未量化的原始基準模型,大幅減少因過度量化導致的邏輯跳躍。

    6. 優缺點摘要與選用建議

    方案 A:選擇 IQ2_XS

    • 優勢:
      • 推論速度最快(生成可達 55~70 tok/s)。
      • 記憶體佔用較少,系統留有約 20 GiB 可用 RAM,系統餘裕最充沛。
      • GPU 快取的專家數較多(4,119 個),PCIe 傳輸負擔較小。
    • 適用情境:
      • 追求極致即時回應速度、高併發吞吐量。
      • 電腦同時有其他高記憶體消耗程式在背景長時間運作。

    方案 B:選擇 IQ3_XXS(目前上線版本)

    • 優勢:
      • 智商與邏輯能力明顯提高,長文本推理與複雜任務品質更佳。
      • 依然維持 45~50 tok/s 的流暢生成速度。
      • 完整保留 256K context 與 INT8 KV 快取。
    • 代價:
      • 系統 RAM 佔用增加至 ~50 GiB,可用 RAM 降至約 12 GiB。
      • 生成速度相較 IQ2 略降約 15% 左右。
    • 適用情境:
      • 對回答精確度、深度推理、程式碼嚴謹度有較高要求的場景。


  • 有大神在本地部署 GLM 5.2 吗?
    soop ladiosS soop ladios
    LLM讨论区 本地模型 glm

    @566656661
    2部鏈接在一起的話應該只能接到3台, 兩兩對接. 我是用MikroTik CRS804 switch 接到八台GB10的200G的port.


  • 一直没找到在DGX上能完全满意的一套模型配置
    soop ladiosS soop ladios
    LLM讨论区 本地模型 服务器

    @linkdesu 我已經用兩台跑很久了,0731出來也已經換上了,真心不錯,速度快,kv緩存也夠500K x 6.
    不過coding上使用起來感覺還是差glm 5.2一點,純個人感覺,沒有甚麼根據.
    單純論性價比,dsv4f用兩台,glm 5.2至少要四台,dsv4f還是比較高的


  • 單DGX spark GB10 安裝 Qwen 3.8 flash next
    soop ladiosS soop ladios
    LLM讨论区 dgxspark gb10 qwen-flash

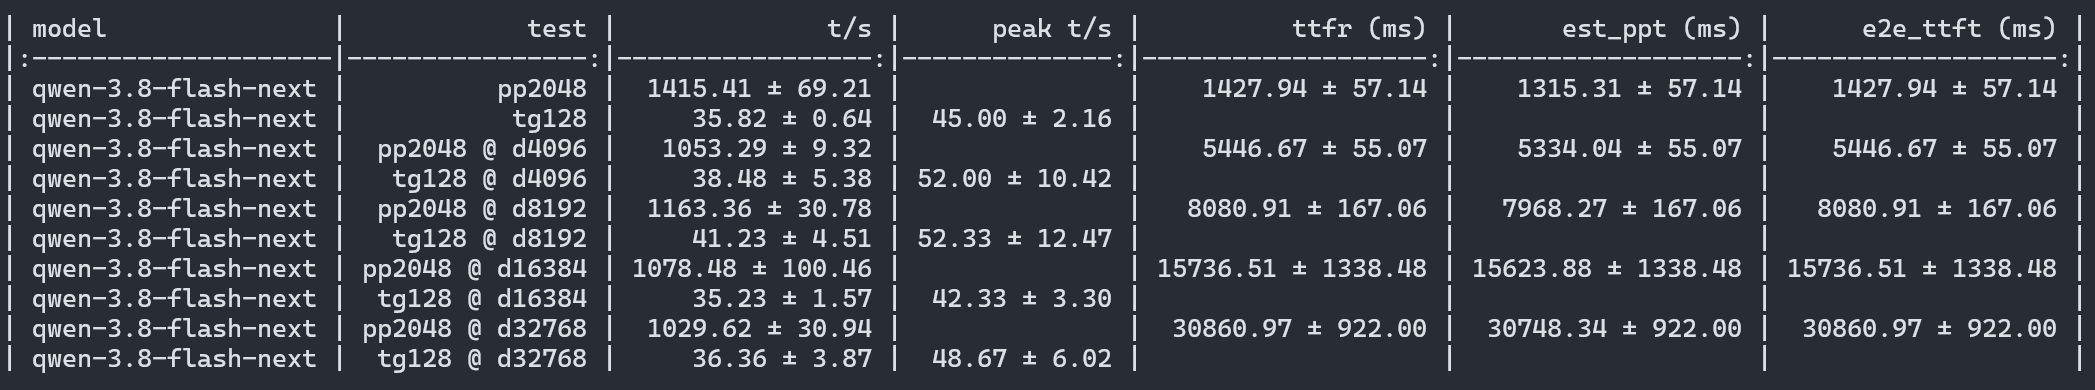
    論壇大神發布了一個單spark的配方,速度很快, 跟大家分享一下.
    出處: Up to 70tok/s Qwen3.8-Flash-Next-Int4-AutoRound

    我在一台GB10上跑了一陣, 的確比我原本的雙GB10跑Qwen 3.8 flash next 快, 跑長鏈任務品質跟雙GB10沒有明顯區別. 不過prefill還是雙GB10快上一大截, KV poll兩台GB10也是多了超過一倍. 就看怎麼取捨了.

    上述單台GB10配方測試數據如下, 實際跑會比這個快一些:
    螢幕擷取畫面 2026-09-10 224935.png

    相關資訊如下:

    Model

    項目 值
    HF repo azampatti/Qwen3.8-Flash-Next-125B-A5B-INT4-AutoRound
    Base Intel/Qwen3.8-Flash-Next-W4A16-AutoRound(原始 Qwen3.8-Flash-Next,作者把 routed experts 由 10 砍到 5 並 healing)
    量化 INT4(AutoRound, W4A16)
    參數 125B 總 / 4.8B active / token(原版 6B);vocab 248,320、hidden 2,560、48 layers、512 experts、top-k 5
    架構(vLLM) Qwen4ExpForConditionalGeneration;layer pattern 每 4 層一個 full-attention、其餘 linear-attention(Δ-net)+ sparse-attention indexer + PLE n-gram table
    license qwen(原始 Qwen 授權)
    硬體目標 1× DGX Spark(GB10, 128 GB unified)
    設定 值 來源
    max_model_len (CTX) 262,144(256K) --max-model-len
    KV cache pool --kv-cache-memory-bytes 20g → vLLM reserved 18.63 GiB / 644,732 tokens;滿 ctx 單 request 可並行 2.46×(實測報告) --kv-cache-memory-bytes
    max-num-seqs 8(同時最多 8 條 request) --max-num-seqs
    gpu-memory-utilization 0.01(配合 kv-cache-memory-bytes 手動控 KV,不走 util 估算)
    KV dtype auto(預設;若改 KV_DTYPE=fp8_e4m3 可擴到約 1.9× tokens,但慢約 10%) --kv-cache-dtype
    投機解碼 MTP depth 3 + draft k=10(讀 ~/.models/...-draft-k10 那包 symlink;Same weights,只有 config 改 top-k) --speculative-config
    prefix caching / chunked prefill on
    chunked prefill size 8192 --max-num-batched-tokens
    CUDA graph PIECEWISE;explicit splitting_ops 排除 Δ-net / indexer / PLE mmap 這些需要 host→device copy 的 op
    flashinfer autotune off
    Tool calling parser qwen3_coder(--enable-auto-tool-choice)
    Reasoning parser qwen3(thinking 會被放到 reasoning 欄位,content 只放最終回答)

    Vision

    模型 包含 vision:model_type=qwen4_exp,language_model_only=false,image_token_id=248056;隨附 preprocessor_config.json (Qwen2VL image processor,longest_edge 16,777,216) 與 processor_config.json (Qwen3VLProcessor + video processor,longest_edge 25,165,824)。


  • Tesla V100 32G雙卡跑Qwen 3.8 flash next IQ3_S, 393K上下文,雙併發, 80~90 tok/s, peak 120 tok/s, 雙併發KV緩存修復, 同場加映UD-Q4_K_XL對比
    soop ladiosS soop ladios
    LLM讨论区 v100 qwen-flash 多卡部署

    @kos-or 我把手上有空的模型都測了一下:

    七輪直接隔離 Pi 解題測試:比較報告(2026-10-21)

    摘要

    七個正式輪次都已正常交付、凍結並完成獨立報告。提交 residue 均為 385583993536,與參考答案一致。 這是本題的數值比對結果,不等於七份原文都已通過完整嚴格證明驗收,更不能推成模型一般正確率 100%。使用工具為pi agent, 主持人為GPT 6.1 sol

    • 目前無人工解題介入輪次中,觀測端到端最短:Maya-L,1h58m39.466s。
    • Qwen UD-Q4_K_XL 為 2h28m38.344s;其已完成的裁判重跑包含大 N 與真正小 N 枚舉,但仍非窮盡形式化審證。
    • 新增 GLM-5.3-Flash-Q4_K_XL/4×V100 32GB:3h09m14.937s,與先前 Maya-L 分開記錄,沒有人工中斷/提示。約 65 分鐘消耗於模型自行設置的逾時,最後自行修正多項式容器未截短問題,大 N 主計算降至 4.9 秒。
    • Qwen NVFP4 是人工介入後完成:5h16m27.925s;其中單一額外驗證約四小時,另包含受控交接與使用者執行範圍指令。不可當成完全無干預結果直接併排名。

    1. 正式輪次、部署及時間

    模型名稱與硬體依使用者提供,未驗證服務端權重、量化檔或硬體身份。表列端到端為首次正式作答開始至最後交付,含推理、工具、錯誤、續答等,不是純 GPU 推理測速。

    模型資訊 模型名稱 使用者提供硬體 端到端 Invocation 外部解題介入
    Strata IQ3_S Qwen 3.8 flash next 2×Tesla V100 32GB, 64G ram 5h38m35.130s 2 無
    Strata UD-Q4_K_XL Qwen 3.8 flash next 2×Tesla V100 32GB, 64G ram 2h28m38.344s 1 無
    Qwen3.8-Flash-Next-NVFP4 Qwen 3.8 flash next DGX GB10 x 2 5h16m27.925s 5 有,另列,不作原始排名
    GLM-5.3-Int4-Int8Mix GLM 5.3 DGX GB10 x 8 3h39m18.201s 4 無
    GLM-5.3-Flash-NVFP4 GLM 5.3 flash DGX GB10 x 4 3h03m55.934s 16 無
    Maya-L GLM 5.3 flash 4×Tesla V100 32GB, 128G ram 1h58m39.466s 5 無
    GLM-5.3-Flash-Q4_K_XL GLM 5.3 flash 4×Tesla V100 32GB, 128G ram 3h09m14.937s 3 無

    Qwen3.8-Flash-Next-NVFP4寫出一個要跑幾十億次的迴圈, 跑完可能超過一天, 被發現後人工把它停止

    2. 正確性與驗收深度

    共同必要小 N 值為 N=2…8:1、3、6、15、63、195、717,各輪提交記錄均符合。下面明確分開數值、原文證明與裁判重跑範圍:

    模型 residue 比對 原稿審核重點/限制 裁判程式重跑範圍
    Strata IQ3_S 一致 R/S 組合律及共軛簡化有錯 快速大 N 路徑;小 N 對 small_ref,非重新暴力枚舉
    Qwen UD-Q4_K_XL 一致 初審未見同類明顯主幹代數錯誤,但非窮盡審證 大 N +實際 N=2…8 枚舉/Burnside,約 3.022 秒
    Qwen Flash NVFP4 一致 群關係漏二次取逆、分層集合域錯誤;部分額外驗證未完成 只審既有提交/日誌,且有人工介入
    GLM Int4-Int8Mix 一致 奇長 S₁ 固定字的乘積式有錯 未重跑完整套件;模型既有日誌包含多種交叉核對
    GLM Flash NVFP4 一致 共軛符號、反射尾端下標有局部錯誤 quick 大 N +實際 N=2…8 枚舉,26.211 秒;非 all/thorough 全套
    Maya-L 一致 O1 的求和式重複乘 3;程式採用正確閉式 依使用者要求,只審既有提交/日誌,不追加重跑
    GLM Flash Q4_K_XL 一致 一般反射相鄰邊索引漏 k';一般 exact 介面有範圍限制 只審既有提交/日誌,不追加重跑

    這不是把局部文字缺陷直接等同於最終計數錯誤;也不是因為 residue 正確,就忽略證明與重現性問題。詳細位置、修正方向、證據限制均列於各模型報告。沒有對任何模型宣告已完成全面形式化證明驗證。

    模型自行記錄的 N=9/10、exact/modular、成分級驗證或矩陣交叉核對,不冒稱為裁判新執行。重複讀取同一 log,也不計成多次獨立成功測試。

    3. 用量

    以下為保存的完成 assistant 訊息 usage 累加。reasoning 是 output 子集,不可再加一次。 input 與 cacheRead 的口徑不同,跨端點不可只比 input 欄位;這也不是實際服務端帳單。

    模型 API 請求 input cacheRead output reasoning
    Strata IQ3_S 75 442,834 9,756,614 178,325 116,613
    Qwen UD-Q4_K_XL 137 279,691 21,401,727 222,274 157,414
    Qwen Flash NVFP4 † 101 11,685,167 0 155,407 93,754
    GLM Int4-Int8Mix 79 12,352,483 0 186,328 125,397
    GLM Flash NVFP4 122 22,234,362 0 378,932 286,864
    Maya-L 32 221,558 4,733,035 212,131 177,550
    GLM Flash Q4_K_XL 25 155,552 2,764,653 147,284 116,563

    † 人工介入輪。其 101 個保存請求均有 response_end,完成訊息 usage 已列入,但仍不擴張解讀成完整服務端計費。GLM NVFP4 另有 compaction/無工具請求,因此訊息 usage 亦不保證涵蓋全部服務端用量。

    4. 公平性與可下的結論

    • 這一次題目上,七輪提交的 residue 全部正確,必要交付完整。
    • 在此次無外部解題介入的完整流程中,Maya-L 觀測耗時最短,Qwen UD-Q4_K_XL 次之。
    • 工具策略、驗證範圍、實作缺陷與自主除錯,足以主導端到端時間;Qwen 長迴圈與新 GLM 多項式尾巴就是明確例子。
    • 新 GLM 沒被裁判提示 bug,最後自行修正並完成;Qwen NVFP4 需單列使用者介入。

  • Tesla V100 32G雙卡跑Qwen 3.8 flash next IQ3_S, 393K上下文,雙併發, 80~90 tok/s, peak 120 tok/s, 雙併發KV緩存修復, 同場加映UD-Q4_K_XL對比
    soop ladiosS soop ladios
    LLM讨论区 v100 qwen-flash 多卡部署

    單卡@seabass 測過囉, 我貼一下:

    Tesla V100 32GB PCIe 跑 Qwen3.8-Flash-Next IQ3_S

    Strata | 200K 上下文 | 视觉:开 | Speculative Decoding:开 | 1 slot

    模拟真实多轮对话测试:每轮新增约 10K tokens + 提问,AI 回复保留在历史里,前缀缓存全程命中,一直聊到 183K。

    测试数据

    已用上下文 解码速度 首字延迟(新增 10K) 预填充速度
    10–40K 70–89 t/s 8.5–9.2 秒 1100–1180 t/s
    50K 74.5 t/s 9.4 秒 1081 t/s
    60–100K 49–57 t/s 10.5–13.7 秒 780–975 t/s
    110–150K 49–60 t/s 14–15.6 秒 695–765 t/s
    160–183K 48–61 t/s 16.5–17.2 秒 634–662 t/s

    结论

    1. 50K 以内:70–89 t/s,跟 IQ2_XS 差不多快
    2. 60K 以后:降到约 50–60 t/s,然后一直稳定到 183K,没有继续明显掉速
    3. 前缀缓存效果:即使 180K 上下文,每轮新增 10K 也只要约 17 秒首字

    還有@dardeaw-feng 兄說買了雙卡v100 16G, 應該馬上就有文發表了吧
    https://lcz.me/post/24315


  • 4 x Tesla V100 32G, Maya-DS4, DeepSeek-V4.1-Flash-1017 EXL3 2.9bpw, decode 37 tok/s, prefill 640 tok/s, 部署,調優與避坑紀錄
    soop ladiosS soop ladios
    LLM讨论区 v100 deepseek 多卡部署

    DeepSeek-V4.1-Flash-1017 在4台GB10上表現不錯, 又看到DGX論壇上EXL3 2.9bpw量化品質似乎不差, 所以想在我的v100 32G x 4上面試試, 跑了一陣子感覺還可以, 就是prefill有點慢, 尚待優化. 以下為部署,調優與避坑紀錄.

    主機環境:AMD EPYC 7K62 48-Core / 96-Thread,128GB RAM,4 × NVIDIA Tesla V100-SXM2 32GB


    1. 模型與運行設定

    項目 正式線上生產配置 (Production) 備註說明
    模型全名 DeepSeek-V4.1-Flash-1017 EXL3 2.9bpw 含 Engram 1017 專家分片
    模型權重路徑 ~/deepseek-v4.1-flash-1017/packs/maya-ds4 EXL3 量化權重
    引擎軟體 maya-ds4 (專案路徑: project-maya) 版本: 1.1.41 (Git commit bcf379f)
    上下文上限 (Context) 500,000 tokens (--max-context 500000) 實測至 497,714 tokens 100% 針檢索通過
    預設取樣設定 temperature=0.4, reasoning_effort="high" 支援 Thinking 思考鏈輸出
    DSpark 配置 DSpark OFF (--dspark none) 釋放 GPU 1 被夾困的 7.5GB VRAM
    GPU 分割與專家配置 GPU 0–3 各承載 28.6~28.7 GB 專家(共 15,467 專家在 VRAM) GPU VRAM 餘裕 ~400 MiB
    主機 RAM 專家 (Direct RAM) 98.4 GB 常駐 Anonymous Heap (--mmap-experts off) DS4_REQUIRE_ALL_RAM=1, DS4_COPY_GB=90
    Prefill Chunk 大小 4096 tokens (--prefill-chunk 4096) 對齊 kVlRows=4096 流水線最優塊
    Attention 核心 DS4_ATTN_V7=0 SM70 架構最優穩定 Tensor Core Attention
    資源守護底線 MemAvailable >= 15.0 GiB, Engine VmSwap = 0 500K Prefill 期間允許暫降至 10.0 GiB

    2. Repo 更新與核心優化

    A. 上游 v1.1.41 程式碼同步

    • 上游基礎版本:同步自官方 origin/main(commit 9030b73,tag v1.1.41)。
    • 合併分支:integration/sync-upstream-v1141 -> Fast-Forward 合併至 production/upstream-20261027。
    • 主要增強:
      1. 啟用 Volta Tensor Core WMMA GEMM 矩陣運算核心(EXL3_WMMA_V70)。
      2. 升級 Prefill DMA 排程與批次流式傳輸機制。
      3. 保留本地多 GPU 區塊取消界限守護(ds4_chunk_cancel::Boundary),與上游 yield_to / run_yields 協同運作。
      4. 保留本地自研之零命中跳過邏輯,與上游 DS4_SKIP_UNPICKED 實現雙軌相容。

    B. Zero-hit Expert Transfer Skipping (DS4_SKIP_ZERO_EXPERTS=1)

    • 核心機制:在 Prefill 階段,各層於 GPU 完成 Top-K Routing 後,檢查 cur_bounds[v+1] == cur_bounds[v]。若命中 Token 數為 0,則跳過該冷專家的 PCIe DMA 傳輸。
    • 傳輸節省:
      • 32K Prefill:節省 66.9% ~ 73.2% 的 H2D 傳輸量。
      • 128K Prefill:節省 65.6% ~ 70.3% 的 H2D 傳輸量。
      • 500K Prefill:節省 82.9% 的 H2D 傳輸量(GPU 0/1 傳輸量從 3.03TB 驟降至 503GB)。
    • 品質保證:不修改 EXL3 權重、不修改 Top-K 結果、不漏算任何有效 Token,貪婪輸出與原始版本維持 Bit-Exact 完全一致。

    C. Direct RAM 啟動 Compaction 防護

    針對 Direct RAM(98.4GB)啟動時容易因 Linux 核心記憶體碎片引發 migrate_longterm_unpinnable_folios 導致長達 10 分鐘卡頓的問題,實施兩項核心修復:

    1. Buddyinfo 自適應 THP 檢測 (ds4_os.hpp):
      動態檢查 /proc/buddyinfo。僅在系統擁有足夠的連續 2MB 頁框時才啟用 MADV_HUGEPAGE;若碎片化嚴重則自動回退為標準 4KB 頁框,徹底杜絕核心逐頁遷移與 Compaction 重試停頓。
    2. 8 執行緒並行 cudaHostRegister (ds4_model.cu):
      將 61 個層的 Host Memory Pinned 註冊改為 8 條執行緒並行執行,加速完成 DMA 映射。

    3. 最新實測效能與驗證資訊

    A. Cold Prefill & Decode 效能矩陣

    評測維度 原始基準 (Skip OFF) 前期版本 (Skip ON) 最新 v1.1.41 (Skip ON) 較前期提升 較原始基準提升
    32K Cold Prefill (Tok/s) 429.0 tok/s 486.5 tok/s 605.9 tok/s +24.5% 🚀 +41.2% 🚀
    32K TTFT 首字延遲 73.30 s 64.66 s 52.21 s -12.45 s -21.09 s
    32K Decode (Tok/s) 34.60 tok/s 34.71 tok/s 37.39 tok/s +7.7% +8.1%
    32K Needle 正確性 100% 100% 100% (Pass) 一致 一致
    128K Cold Prefill (Tok/s) 462.0 tok/s 500.0 tok/s 640.3 tok/s +28.1% 🚀 +38.6% 🚀
    128K TTFT 首字延遲 281.95 s 260.59 s 203.90 s -56.69 s -78.05 s
    128K Decode (Tok/s) 29.80 tok/s 30.22 tok/s 37.13 tok/s +22.9% 🚀 +24.6% 🚀
    128K Needle 正確性 100% 100% 100% (Pass) 一致 一致

    B. 功能與穩定性測試

    1. 單元測試套件:
      • python3 -m unittest tools.test_ds4_pack serve.test_server:145/145 測試全部通過(耗時 35.3s)。
    2. Thinking 思考鏈推理:
      • 驗證 Prompt:How many letters in the word "apple"? Output reasoning and answer.
      • 3.77s 內順利回傳 reasoning_content 與標準解答,思考鏈標籤未發生截斷或錯位。
    3. Tool Calling 結構化調用:
      • 驗證 Prompt:What is the stock price of NVDA? + lookup_stock tools schema。
      • 成功命中並回傳標準 OpenAI tool_calls JSON 結構:{'name': 'lookup_stock', 'arguments': '{"ticker":"NVDA"}'}。
    4. 長上下文能力:
      • 通過 500,000 邊界保護測試(<= 500000 正常運作,> 500000 正常回傳 400 錯誤)。


    4. 異常調查:長 Prefill 原因與修復 (Prefill Cache Stall / Long Prefill Fix)

    A. 問題現象

    在生產環境運行多輪 Agent / OpenCode 對話時,發現每次對話都會出現長達 60~90 秒的長 Prefill(如 54K、57K、64K、69K Tokens),日誌顯示:

    ds4: took back a 22090-token shared start (0.01 s)
    maya ds4 serve: prompt 69438 tokens = 22090 reused + 47348 read in 89230 ms (530.6 tok/s)
    

    Prefix Cache 始終只能重用前 22,090 tokens(System Prompt),後續對話增量(20,000 ~ 47,000 tokens)每一輪都在重新進行 Cold Prefill。

    B. 根因分析 (Root Cause)

    1. 觸發旗標殘留 (/tmp/maya_always_cold_prefill):
      • 20:03 執行的 scripts/run_upstream_v1141_verification.py 測試腳本在跑純冷啟動壓測時寫入了 /tmp/maya_always_cold_prefill,但結束時未清理。
      • scripts/restart_production.sh 先前重啟步驟中亦未清理 /tmp/maya_* 旗標。
    2. C++ 引擎行為:
      • 於 src/ds4/ds4_main.cpp 第 1400 行:
        if (access("/tmp/maya_always_cold_prefill", F_OK) == 0 ||
            (std::getenv("DS4_ALWAYS_COLD_PREFILL") != nullptr && std::atoi(std::getenv("DS4_ALWAYS_COLD_PREFILL")) != 0)) {
            m.reset();
        }
        
      • 生產環境每當接收到任何請求時,該檔案強制觸發 m.reset(),將當前對話的動態 KV Cache 完全清空。
      • 引擎只剩下開機時常駐於 RAM 的 22,090-token System Prompt(prefixes RAM Tier),因此日誌只能「took back a 22090-token shared start」,導致後續數萬 tokens 每次均被迫重算。

    C. 修復措施與驗證

    1. 立即移除殘留旗標:
      • 刪除 /tmp/maya_always_cold_prefill。
    2. 自動化重啟防禦加固:
      • 更新 [scripts/restart_production.sh],在重啟生產服務前強制執行 rm -f /tmp/maya_always_cold_prefill /tmp/maya_skip_zero_experts。
      • 更新 [scripts/run_upstream_v1141_verification.py],加入 finally 區塊與啟動/結束清理,確保測試旗標絕不遺留。
    3. 線上驗證實測:
      • 旗標移除後,第 1 個請求(70,965 tokens):
        prompt 70965 tokens = 69438 reused + 1527 read in 7739 ms (197.3 tok/s)
        重用率瞬間升至 97.8%,Prefill 時間由 89.2 秒銳減至 7.7 秒!
      • 第 2 個請求(72,493 tokens):
        prompt read: 1180 tokens in 4.9 s,重用逾 71,313 tokens,耗時僅 4.9 秒。
      • 驗證 Prefix Cache 機制 100% 正常,長 Prefill 現象徹底解除。

  • 關於能本地運行DeepSeek V4 Flash大模型的配置
    soop ladiosS soop ladios
    AI硬件 deepseek

    @terry 目前我兩台GB10跑deepseek V4 flash, 八台跑glm 5.2. 這是我自己兩台GB10跑出來的結果. prefill 速度上面也有, 接近2000 t/s. 每次會話的首字延遲視上下文而定, 約幾秒到分鐘不等. 首字過後緩存命中約9x%, 一般就沒甚麼prefill的花費, 這時候就是看吐字速度了.


  • 双 RTX PRO 6000 + 48GB RAM:Strata 跑 DeepSeek 1017,Decode 80.8 tok/s,524K Prefill 1,385 tok/s
    soop ladiosS soop ladios
    LLM讨论区 rtxpro6000 deepseek 多卡部署

    @kos-or 10併發約230-260 tok/s.


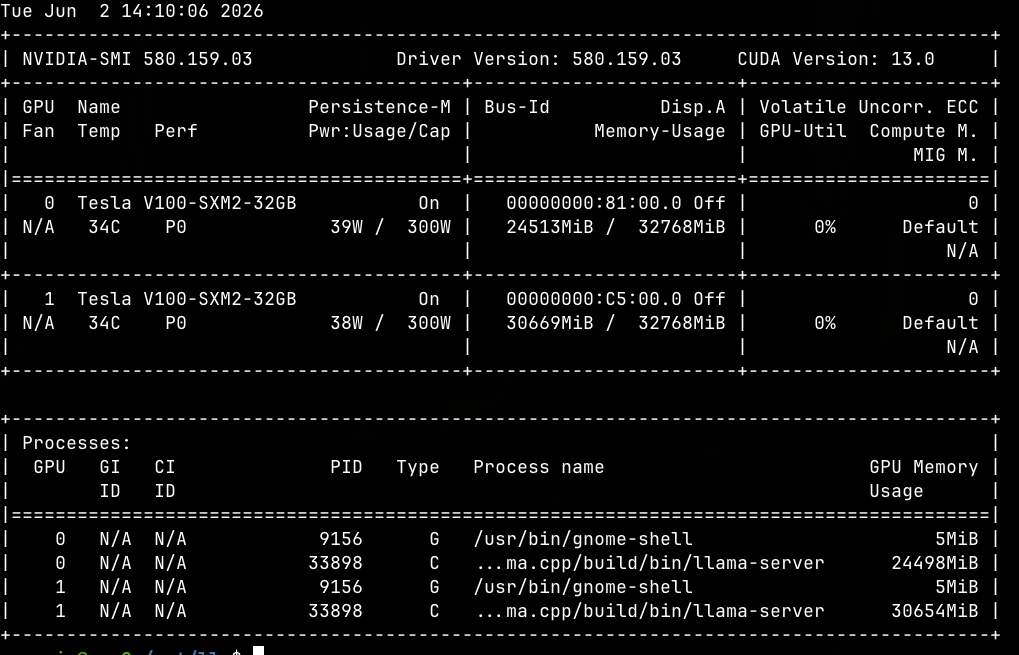
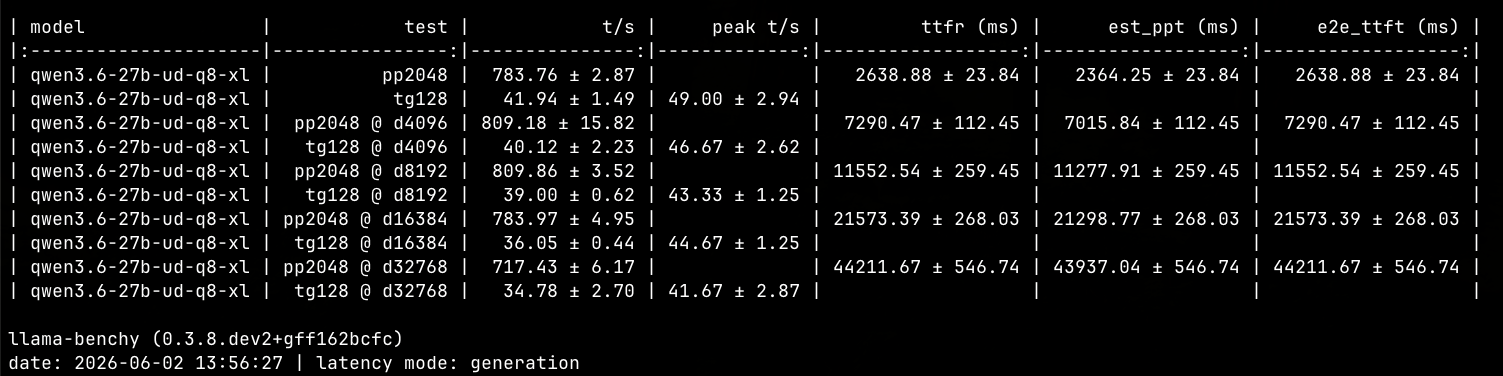
  • 廉頗老矣,尚能飯否? 測試tesla V100 32Gx2 部署Qwen 3.6 27B Q8模型
    soop ladiosS soop ladios
    LLM讨论区 本地模型 v100 qwen-27b 量化

    前幾天看著平常編程在用的洋垃圾, 突然想搞個顯卡來跑跑qwen 3.6 27B. 看了半天, 台灣這邊魔改卡不好買, 也都是天價. 7900XTX基本沒人在賣, R9700兩張又太貴, 就入了兩張Nvidia TESLA v100 32G來試試.
    電腦本來只有BMC顯示, 所以驅動啥的都沒裝, 只有裝ubuntu 26.04.
    各論壇看了看, 鎖定llama.cpp + Qwen3.6-27B-UD-Q8_K_XL.gguf , 然後把相關資料交給gemini cli去安裝, 大概一個小時它就把NVIDIA 驅動,CUDA其他相依軟件及設定搞好, llama.cpp編譯完成, 該避的坑避掉, 模型下載完然後就跑起來了, 全程無干預.
    再來就是跟它花了大概兩個小時測試調整, 主要是一開始的prefill慘不忍睹, 花很多時間在長文本測試優化. 調到一個滿意的設定, 就差不多了, 整個過程還挺順利的.
    底下是我電腦的基本資訊:

    系統與硬體狀態

    • 作業系統: Ubuntu 26.04 LTS
    • CPU: AMD EPYC 7K62
    • RAM: 128GB DDR4
    • GPU 硬體: 2x NVIDIA Tesla V100-SXM2-32GB
    • PCIe 連線: Gen3 x16 (狀態良好)
    • 平均溫度: Idle 35°C / 滿載 ~45°C
    • 功耗限制: 300W

    目前的狀態大概是這樣:

    服務運行狀態

    • 服務名稱: qwen36-llama.service
    • 執行引擎: llama.cpp (CUDA 70架構優化編譯版)
    • 載入模型: Qwen3.6-27B-UD-Q8_K_XL.gguf

    當前模型參數配置 (終極優化版)

    • 總 Context 空間: 524,288 tokens
    • 併發能力 (Parallel): 2 路 (每路 262,144 tokens)
    • KV Cache 精度: q8_0
    • MTP 加速: 啟用 (draft-mtp, 最大預測數: 2)
    • Batching 設定: Batch 1024, UBatch 256

    效能與資源佔用指標

    VRAM 記憶體佔用

    系統已確保 100% 的權重與 KV Cache 駐留於 VRAM 中,完全不依賴系統 RAM 進行 offload,徹底解除 PCIe 頻寬瓶頸。

    • GPU 0 佔用: ~24.3 GB
    • GPU 1 佔用: ~30.3 GB
    • 總計佔用: 54.6 GB
    • 安全餘裕: 剩餘約 9.4 GB,足以應付 Batch 1024 運算時產生的動態 Scratch Buffer 需求。

    推理速度 (實測)

    • Prompt Processing (Prefill): 最高可達 ~611 tokens/second (長文測試)。
    • Generation (Decode): 穩定於 ~40 tokens/second。
    • MTP 接受率: 約 79% ~ 100% (極高效率)。

    以上是Gemini寫的報告, 中間有多次參數設定調整, 比較如下:

    效能測試結果總表

    測試組合 3路 256K (無MTP) 2路 256K (MTP 2) 1路 256K (B256, mtp2) 1路 256K (B512,mtp2) 1路 256K (B1024,mtp2) 2路 256K (B1024,mtp2)
    1. 成功啟動 是 是 是 是 是 是
    2. VRAM Used (GPU0/1) 27.8/31.2 GB 23.7/29.1 GB 19.3/23.8 GB 19.6/24.5 GB 19.9/25.1 GB 24.3/30.3 GB
    3. Prefill (t/s) 90.31 42.02 (短文) 263.93 395.94 611.04 23.01 (短文)
    4. Generation (t/s) 20.87 37.24 46.64 43.09 40.65 40.06
    5. MTP 接受率 N/A 79% 100% 100% 100% 87.5%
    6. 是否 OOM 否 否 否 否 否 否
    7. 數據位置 部分 RAM 部分 RAM 純 VRAM 純 VRAM 純 VRAM 純 VRAM
    8. GPU Power (0/1) 51W/49W 51W/49W ~50W/50W 52W/52W 53W/53W 51W/49W
    9. GPU Temp (0/1) 35°C/35°C 34°C/33°C 35°C/35°C 39°C/40°C 39°C/41°C 34°C/34°C

    定案之後看了一下vram占用狀態跟跑一下benchmark:
    v100_smi_2c_batch1024_ubatch_256_m2.png

    v100_bench_2c_batch1024_ubatch_256_m2.png

    心得:

    1. 一樣是qwen3.6 27B Q8模型, 實際使用速度約比雙spark高出5~10 token/s, prefill速度也還行. 不過雙spark可以容納約15路並行, 這台電腦礙於vram容量, 只能兩路.
    2. 渦輪風扇實在太吵, 必須關到小房間... 早知道不要嫌麻煩買個水冷...

  • 工作室規劃:4 台 DGX Spark 本地 AI 叢集架構,並預留擴充至 8 台
    soop ladiosS soop ladios
    AI硬件 dgxspark 多卡部署

    集結眾人之力, 我現在手上有16台 GB10 , 兩台CRS804. 配置如下:
    glm 5.3 => 8台, ctx 500K, DCP8, 實際使用單流30-40 toks, 八條同時打 60-120 tok/s. 8台用400G=>2x200G接在CRS804 4個port
    glm 5.3 flash => 4台, ctx 500K, 實際使用單流60-80 toks, 八條同時打有兩百多吧,有點忘了. 這四台是用400G=>4x100G接在CS804的一個port.
    deepseek v4 flash-vision-exp => 2台對接, ctx 500K, 單流50-70 toks , 多流忘了
    qwen 3.8 flash next => 2台對接, ctx 391K, 單流60-80 tok/s , 多流忘了
    以上都是TP, decode速度是平常使用的印象, 應該差不多是這樣. pp速度就1000 tok/s 到 3000 tok/s不等,平常緩存命中都在98%以上, 其中較慢的glm 5.3還有做nvme KV cache, 所以pp不是很在意.
    網路拓樸簡單粗暴, 10G口都接到lab網路, 另外一台小電腦跑litellm管理跟分流這些模型, 方便維護以及修理一些小問題.
    關於你的問題:
    4 台 Spark 使用 QSFP 高速交換機互連,有哪些拓撲或設定細節容易忽略?

    1. 機器插上QSFP線之後要斷電在開, 我遇過熱差拔後throughput只剩3G
    2. 每個port有兩個interface, 每個interface 100G, 如果一個port要跑足200G, 必須使用2 rail用到兩個interface. 不過那也沒有必要,我實測模型在跑的時候,實測頻寬沒有超過100G, 所以我第二台CRS804就用100G去接,這樣就可以擴充到16台

    管理網路和節點高速網路分開規劃,是否有建議的做法?
    看需求吧, 我是簡單可用就好.

    DL360 Gen10 作為 ESXi 管理主機與 API 服務入口,應如何安排網路與 VM 角色?
    沒在用, 我是用litellm提供所有api接口

    UPS 如何按實測負載安排供電分組、續航與安全關機流程?
    沒裝UPS, 只有remote power control. 主機到貨後須確定他插電是否立即開機, 沒有就到BIOS去設定

    智慧插座若用於單台設備故障後遠端重啟,有哪些額定規格或安全注意事項?
    沒有. 可以設定模型開機自啟動.

    若之後擴到 8 台,交換機、線材、供電與叢集軟體方面有哪些限制要先留意

    1. 如果最終目標是八台,直接買四條400G=>2x200G就好,不用買單條200G的線, 效果是一樣的
    2. 線材接頭很多種, switch端跟GB10端是不一樣的, 我買的是https://www.naddod.com/products/32709.html

  • 4 x Tesla V100 32G, Maya-DS4, DeepSeek-V4.1-Flash-1017 EXL3 2.9bpw, decode 37 tok/s, prefill 640 tok/s, 部署,調優與避坑紀錄
    soop ladiosS soop ladios
    LLM讨论区 v100 deepseek 多卡部署

    @Lei-Gao 我的四張卡排列比較特殊, GPU0/GPU1是外接顯卡鄔, 接pcie switch佔一條pcie插槽, 有nvlink.
    GPU2/GPU3是分開插在兩條PCIE, 所以走的是TP2, PP2. 我請Gemini小弟解釋一下:

    DeepSeek-V4.1-Flash-1017 NVLink 拓撲與實質效益分析報告

    主機環境: AMD EPYC 7K62 48C/96T, 128GB RAM, 4 × NVIDIA Tesla V100-SXM2 32GB
    模型版本: DeepSeek-V4.1-Flash-1017 EXL3 2.9bpw + Engram 1017
    推論引擎: project-maya / maya-ds4 (--tp 2 --layer-split auto)


    結論

    NVLink 在本機推論此模型時有局部的實質加速作用,但不是決定整體端到端效能的核心瓶頸(對端到端速度的實質貢獻估計約在 5% ~ 10% 左右)。


    一、 實體硬體拓撲現況(關鍵前置事實)

    經由 nvidia-smi topo -m 與 nvidia-smi nvlink -s 檢測,本機 4 張 V100 的互聯是不對稱的:

    GPU 配對 實體連線方式 頻寬 狀態
    GPU 0 ↔ GPU 1 NVLink 2.0 (5 條 bonded, NV5) ~128.9 GB/s Active (運作中)
    GPU 2 ↔ GPU 3 PCIe / Host Bridge (NODE) ~12–15 GB/s (PCIe Gen3) No NVLink (全數 Inactive)
    GPU 0/1 ↔ GPU 2/3 PCIe Host Bridge (NODE) ~12–15 GB/s (PCIe Gen3) 跨節點走 PCIe

    二、 模型並行架構下的通訊分佈

    目前的服務配置為 --tp 2 --layer-split auto(即 TP=2 + PP=2):

    • Stage 0(前 20 層,Layers 0..19):切在 GPU 0 與 GPU 1(TP=2)。
    • Stage 1(後 20 層,Layers 20..39 + LM Head):切在 GPU 2 與 GPU 3(TP=2)。
    • PP 流水線交接:Stage 0 算完後的 Hidden States 跨卡傳給 Stage 1。

    三、 NVLink 在哪裡有「實質作用」?

    1. 加速 Stage 0(Layers 0..19)的 TP All-Reduce:
      • 每一層的 MLA (Multi-head Latent Attention) 投影與 MoE 共享專家(Shared Expert)輸出,都需要在 TP 兩卡間做 All-Reduce 聚合。
      • GPU 0 ↔ GPU 1 走 NVLink 5 條通道,延遲極低(< 10 µs),通訊耗時基本能被計算完全重疊(Overlap)。
    2. 避免 Stage 0 的 PCIe 總線爭搶(Bus Contention):
      • 由於 GPU 0 與 GPU 1 的 TP 溝通走的是專用 NVLink 實體鏈路,不會佔用主機板的 PCIe 通道,使得這兩張卡的 PCIe 頻寬能 100% 留給 CPU 串流專家資料。

    四、 為什麼 NVLink「無法成為全局決定性因素」?

    1. 核心瓶頸在 CPU ↔ GPU 冷專家動態串流(走 PCIe Gen3):
      • 模型總共有約 92.4 GB ~ 100 GB 的冷專家權重 駐留在 CPU Host RAM,推論時需要根據動態路由經由 PCIe 串流到 GPU(即日誌中的 CPU lane ~22%~28% experts)。
      • NVLink 只能加速 GPU ↔ GPU 互聯,無法加速 CPU RAM ↔ GPU 的 H2D 傳輸。這部分的頻寬上限受死在 PCIe Gen3 x16(約 12–13 GB/s),是整個系統最大的延遲來源。
    2. 木桶效應:Stage 1(GPU 2 ↔ GPU 3)沒有 NVLink:
      • 後半段 20 層的 TP=2 在 GPU 2 與 GPU 3 上執行,由於這兩張卡之間沒有啟用 NVLink,它們的 All-Reduce 只能走 PCIe (NODE)。
      • 流水線(Pipeline)的速度由最慢的一環決定,Stage 1 在 PCIe 上的通訊延遲,會抵消掉 Stage 0 NVLink 帶來的部分增益。
    3. PP 傳輸的資料量極小:
      • Stage 0 傳給 Stage 1 只需要傳遞單個 Token 的活化向量(Hidden States,大小僅約數 KB),在 PCIe 上傳輸耗時僅需幾微秒,NVLink 在此處毫無顯著差別。

    五、 總結評估

    • 實質效益:有,它確保了前半部模型(GPU 0/1)通訊不打架、低延遲,估計貢獻了約 5% ~ 10% 的端到端效能。
    • 全局瓶頸:目前推論速度(Decode ~35–45 tok/s)的主導瓶頸是 CPU 記憶體頻寬與 PCIe Gen3 串流速度,而非 GPU-to-GPU 的通訊頻寬。
  • 登录

  • 登录或注册以进行搜索。
  • 第一个帖子
    最后一个帖子
0
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组