跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
stakiraS

stakira

@stakira
体面乡绅
取消关注 关注
关于
帖子
41
主题
4
分享
0
群组
1
粉丝
2
关注
0

帖子

最新 最佳 有争议的

  • X99 不能P2P让我很难受 。 买Pcie switch(260926死缓改判无罪,交换机完美实现P2P 9月27:TP2 Qwen3.8 Q8 60t/s)
    stakiraS stakira
    AI硬件 x99 ai-pro-r9700 多卡部署

    我也为自己的 x99 主板研究过。有些是可以通过自行修改 BIOS 解决的,而且确实有人玩这个,比如:https://winraid.level1techs.com/t/request-ga-x99-ud4p-bios-with-above-4g-decoding/104550


  • Qwen3.8 27B实测:编程能力暴涨,但Agent长链推理频繁崩溃,替代DeepSeek不现实,社区优化后潜力很大,可稍晚入手!
    stakiraS stakira
    LLM讨论区 qwen-27b deepseek hermes

    @terry 我也没有过说它比 Deepseek 怎样。我的意思是,出于量化原因,实际应该要更强一些。另外:

    • dsv4 flash 固然尺寸更大,一般直觉上会更强,但它一次只激活 13B,和全尺寸 284B 比只占可怜的一点儿, 智力和稠密 27B 比有来有回并不奇怪。
    • 模型技术本就不是只有一个维度,Deepseek 很多技术都是成本方向,是否全方位更强并不一定。好几家早一点出的模型都比后出的 dsv4 pro 强了,这也没什么奇怪的。
    • 虽然默认长度给的是 256k,但官方 huggingface 明确表示将提供 1M 的 API,没有一定信心不会这样做。

  • Qwen3.8 27B实测:编程能力暴涨,但Agent长链推理频繁崩溃,替代DeepSeek不现实,社区优化后潜力很大,可稍晚入手!
    stakiraS stakira
    LLM讨论区 qwen-27b deepseek hermes

    @terry 所以我的意思是,所谓长线不行,可能只是因为量化


  • Qwen3.8 27B实测:编程能力暴涨,但Agent长链推理频繁崩溃,替代DeepSeek不现实,社区优化后潜力很大,可稍晚入手!
    stakiraS stakira
    LLM讨论区 qwen-27b deepseek hermes

    容易崩不一定是模型本身的问题。我这几天几次默认 xhigh 跑到 220k+ 都没什么问题。我就直接用官方 llama.cpp 跑的 unsloth Q4_K_XL,但不开 kv 量化,占用 40GB。其中权重 18GB,那么 kv 占 22GB。你跑的 FP8,但没说 kv 量化没有。官方 FP8 大小 31GB,kv 给你剩下 17GB,说可以开 256K,那应该是量化了吧?kv 比权重对量化敏感得多,越长越容易崩显然是正常的。如果是 chat template 的问题,社区迭代的可能比官方还好,就直接用unsloth就好了。话说回来,要跑个满血版兑现全部潜力,还是很困难的,48G 显存也还是不够啊,也就差不多能用的样子。


  • Qwen3.8 27B AA综合评分与 DeepSeek V4 Flash 持平
    stakiraS stakira
    LLM讨论区 qwen-27b deepseek

    @像素盒子 "错误 您没有权限执行此操作。" 一张 23KB 的 png,转成更小的 jpg 也不行。


  • Qwen3.8 27B AA综合评分与 DeepSeek V4 Flash 持平
    stakiraS stakira
    LLM讨论区 qwen-27b deepseek

    刚出炉的新鲜评分,Qwen3.8 27B 52 分,与 DSV4 Flash 0731 持平

    不给上传图片了?大家自己看吧。

    Artificial Analysis Intelligence Index

    当然,评分对应的应该是参数无量化、kv cache 无量化的官方版本。

    个人体感:3.8 更具主动性,做长任务的能力强了很多。分数或许略有水分,但比 DSV4 Flash Preview 好用是肯定的。和API 相比其实也就是速度慢了点,完全可以替代很多 API 模型了。

    从 3.6 到 3.8 也才半年,官方已经敢拿它和 Opus 4.6 对比,而不久前 Opus 4.6 还是最好的编程模型。未来应该会超乎很多人想象。


  • (双卡指南) 最丐 Qwen3.6-27b - 3000 元双 RTX 3060 - 50t/s
    stakiraS stakira
    AI硬件 nvidia rtx3060 多卡部署

    @ezios nvlink 多贵啊,有点浪费了吧。如果用nvlink,数据交换基本走nvlink,有可能第二张不需要pcie速度。一般来讲,x1 是矿卡标配,用pcie跑tp还是不要太慢,每张卡地位是对等的,没有第二张怎样的说法。说是不要太慢,有 gen3 x8 = gen4 x4 也就够了,很多主板还是有的。


  • 你们说说这是在干啥,把人家华南金牌都干缺货了
    stakiraS stakira
    AI硬件 x99

    人不在国内,直接搞了块二手技嘉 ga-x99-ud4p 加 E5 2690v4,四条间隔2槽的pcie,原生支持4路SLI。DDR4 32GB(感觉其实16GB问题不大)。不需要延长线直插四张 3060,虽然不比双卡快但一共48GB,加起来折合不到8000人民币,还是非常非常香的6dabf69f-cd90-464d-95a8-853ad44083ed-image.jpeg


  • 来自RTX PRO 5000的碎碎念
    stakiraS stakira
    AI硬件 rtxpro5000

    想说现在很多机箱每个槽中间没有那一条,整体就是一个洞


  • (双卡指南) 最丐 Qwen3.6-27b - 3000 元双 RTX 3060 - 50t/s
    stakiraS stakira
    AI硬件 nvidia rtx3060 多卡部署

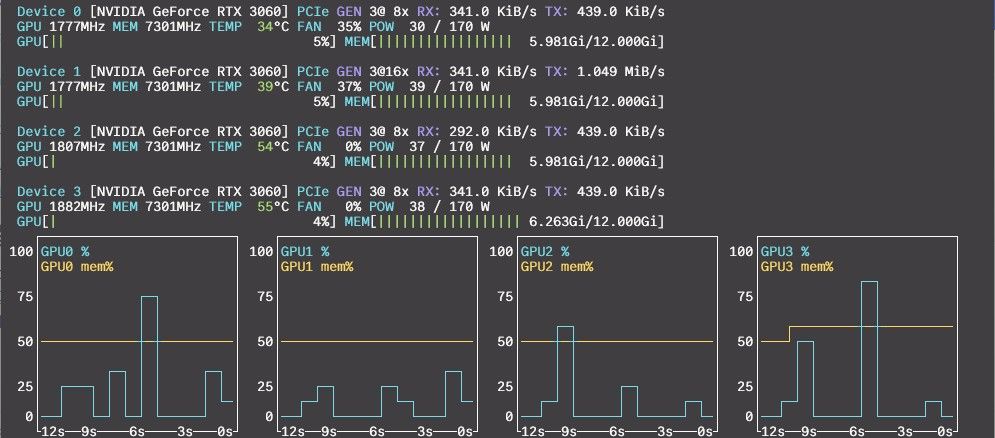
    @joker_chang 搞了张 x99,应该直接插上就可以了。然后在 nvtop 里面检查一下至少有 PCIe Gen 3@ 8x 就行了
    62b7e67b-843a-4bfa-a280-ccfdb6b25635-image.jpeg


  • (双卡指南) 最丐 Qwen3.6-27b - 3000 元双 RTX 3060 - 50t/s
    stakiraS stakira
    AI硬件 nvidia rtx3060 多卡部署

    @joker_chang 这个真不懂,没有玩过 x99


  • (双卡指南) 最丐 Qwen3.6-27b - 3000 元双 RTX 3060 - 50t/s
    stakiraS stakira
    AI硬件 nvidia rtx3060 多卡部署

    @vosrock 不错,显存差点,搞两张


  • (双卡指南) 最丐 Qwen3.6-27b - 3000 元双 RTX 3060 - 50t/s
    stakiraS stakira
    AI硬件 nvidia rtx3060 多卡部署

    @vosrock 上哪找 3000 人民币的 4080?


  • (双卡指南) 最丐 Qwen3.6-27b - 3000 元双 RTX 3060 - 50t/s
    stakiraS stakira
    AI硬件 nvidia rtx3060 多卡部署

    @asd2667 赞!倒腾一下 #23225 可以双 q8 或双 q4,但目前性能略有损失。


  • (双卡指南) 最丐 Qwen3.6-27b - 3000 元双 RTX 3060 - 50t/s
    stakiraS stakira
    AI硬件 nvidia rtx3060 多卡部署

    @kop-wang 尝试下来确实有用。按评论所说,回退到 #22616 之前,打上 #23225 补丁,开 MTP 可以开到 128k 上下文了


  • (双卡指南) 最丐 Qwen3.6-27b - 3000 元双 RTX 3060 - 50t/s
    stakiraS stakira
    AI硬件 nvidia rtx3060 多卡部署

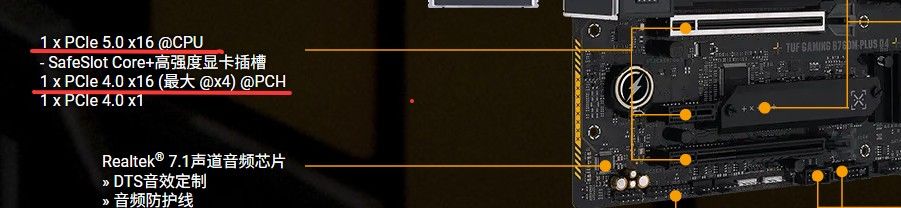
    @tommam 理论上 Gen4 x4 就相当于 Gen3 x8 了,很多新一点的主板是有的。比如 1 x PCIe 4.0 x16 + 1 x PCIe 3.0 x16,或者 1 x PCIe 5.0 x16 + 1 x PCIe 4.0 x4。不是非得 x8+x8。

    随便挑一个 华硕TUF GAMING B760M-PLUS D4重炮手,就是 Gen5 x16 + Gen4 x4。
    18fbaf68-02f2-47fc-9755-ed9aba4ff381-image.jpeg

    这种配置近期似乎比较流行。但 Gen4 x4 那一路走的是芯片组不是 CPU,可能会有一点影响。

    主板支持 PCIe 通道拆分的话可以买线拆分成 Gen5 x8+x8。


  • 双 3090(NVLink)跑 Qwen3.6-27B,128K 上下文实测
    stakiraS stakira
    AI硬件 nvidia rtx3090 多卡部署

    应该可以快很多,可以看一下我的双 3060 帖子


  • (双卡指南) 最丐 Qwen3.6-27b - 3000 元双 RTX 3060 - 50t/s
    stakiraS stakira
    AI硬件 nvidia rtx3060 多卡部署

    @kop-wang 感谢提供信息


  • (双卡指南) 最丐 Qwen3.6-27b - 3000 元双 RTX 3060 - 50t/s
    stakiraS stakira
    AI硬件 nvidia rtx3060 多卡部署

    @kop-wang 帖子里已经说明了,SPLIT_MODE_TENSOR 目前开不了 kv 量化。


  • 从纯游戏机改成游戏+AI双用机,Qwen 3.6 27B MTP 速度只有 37 t/s,求大神指点怎么升级
    stakiraS stakira
    AI硬件 nvidia rtx5080

    可以去看看我刚发的双 3060 帖子,主板合适的话 5080 16GB + 5060Ti 16GB 肯定能跑到 65。

  • 登录

  • 登录或注册以进行搜索。
  • 第一个帖子
    最后一个帖子
0
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组