跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
Sun LyuS

Sun Lyu

@Sun Lyu
体面乡绅
取消关注 关注
关于
帖子
5
主题
1
分享
0
群组
1
粉丝
0
关注
0

帖子

最新 最佳 有争议的

  • 【纯闲着】2700 块的洋垃圾跑 QFN:MI50 16G×2 + 128G DDR3,从装系统到 54 tok/s,这可能是目前价格最低的洋垃圾方案。
    Sun LyuS Sun Lyu
    LLM讨论区 amd rocm 多卡部署

    第二次调优结果放在#16

    先说结论,再讲过程。

    这台机器现在稳定跑 54.0 tok/s(decode)、571 tok/s(prefill),支持 128K 上下文,使用 IQ3_S 量化,OpenAI + Anthropic 兼容接口常驻 8080。

    显卡、内存、主板三件合计 2700 元:MI50 16G 每块 750 元,32G DDR3 REG ECC 4 条共 900 元,华南金牌 X99-TF 二手 300 元。

    折算下来:32GB HBM2 显存折合 46.9 元/GB,128GB DDR3 内存折合 7.0 元/GB。同样运行这个模型,一张 4080 SUPER 16G 大约能给到 58 tok/s,但仅那张卡的价格就足够配三台这样的机器。


    一、硬件与成本

    项目 型号 / 规格 价格
    显卡 AMD Instinct MI50 16GB ×2(已改主动散热) 750 × 2 = 1500
    内存 DDR3 1333 RDIMM 32GB ×4(共 128GB) 900
    主板 华南金牌 X99-TF(二手) 300
    CPU Intel Xeon E5-2696 v3(18 核 36 线程) 未计入
    硬盘 1TB NVMe(系统 + 模型) 未计入
    电源 长城 1250W 金牌 未计入
    已计合计 显存 32GB + 内存 128GB 2700

    有几点值得单独说明:

    • MI50 是 HBM2,单卡 1024 GB/s。这不仅是“便宜的显存”,它的显存速度还超过很多家用卡。双卡合计 2TB/s 的名义带宽,是整个方案里最不合常理的性价比来源。
    • DDR3 1333 四通道实测约 30 GB/s。这是这台机器真正的短板,后面所有调优都围绕它展开。
    • 双卡各需 2×8pin,共 4 根;1250W 金牌电源完全过剩(没有做整机功耗实测,这里不编造数字)。
    • BIOS 必须开启 Above 4G Decoding,否则卡无法启动。
    • MI50 是涡轮或被动散热的服务器卡,必须改散热(我这套已改主动散热)。

    硬件验收的原始数据(lspci / sysfs 实测):

    • 两卡均为 Vega 20 [1002:66a1],mem_info_vram_total 各 16.0 GiB(确认是 16G 版,不是 32G 版);
    • LnkCap/LnkSta 两卡都是 Speed 16GT/s, Width x16,Gen3 x16 满血,无需争抢槽位;
    • /dev/kfd、/dev/dri/card1、card2、renderD128、renderD129 齐全。

    二、这套卡为什么需要“自己编译”

    gfx906 在 Strata 里是社区验证路径,官方的“支持的硬件”表里根本没有 MI50。这里有三条硬性约束:

    1. 官方 Setup 不会自动构建 gfx906,必须从源码自行构建,编译参数中带上 -DSTRATA_HIP_GFX906=ON(注意不是 STRATA_ENABLE_HIP,两者互斥,同时给出会直接触发 FATAL_ERROR)。
    2. ROCm 官方版已经不再包含 gfx906 的库,必须使用社区镜像 mixa3607/rocm-gfx906:7.14-complete,并走内核自带的 amdgpu 驱动,不使用 hipBLASLt。
    3. 宿主机不需要安装 ROCm,只需要内核 amdgpu、/dev/kfd 和 Docker,所有工具链都在容器里。

    编译命令(在容器内执行,源码位于 /src/Strata):

    cmake -S . -B build-906 -G Ninja \
      -DSTRATA_HIP_GFX906=ON \
      -DCMAKE_HIP_ARCHITECTURES=gfx906 \
      -DSTRATA_GGML_DIR=/src/llama.cpp \
      -DCMAKE_C_COMPILER=/opt/rocm/llvm/bin/clang \
      -DCMAKE_CXX_COMPILER=/opt/rocm/llvm/bin/clang++ \
      -DCMAKE_BUILD_TYPE=Release
    ninja -C build-906 strata
    

    165/165 全部通过,36 线程约 3 分钟。 产出的二进制文件为 40MB;若在宿主机上直接运行,会报 libhipblas.so.3: cannot open shared object file,所以所有命令都必须在容器内通过 docker exec 执行,以免踩到这个坑。

    编译期唯一的坑是:include/strata/platform/hip_compat/strata_hip.h 缺少两个映射宏。原因是 gfx906 构建不定义 STRATA_USE_HIP,dflash2.cpp 会走 CUDA 兼容分支,从而报 use of undeclared identifier。补上两行即可(上游有 PR #3986,但当时还没合入 0.2.11):

    #define cudaStreamCreateWithPriority hipStreamCreateWithPriority
    #define cudaDeviceGetStreamPriorityRange hipDeviceGetStreamPriorityRange
    

    三、模型:从 IQ3_XXS 换到 IQ3_S,体现了反直觉的正确决定

    模型是 ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF。它的体积口径很容易被误读:47.0GB 只是权重,实际下载量为 47.04 + 28.80 = 75.84GB——第二个分片是 28.8GB 的 per-token 表。

    下载走 hf-mirror.com,峰值 48.8 MB/s,75.84GB 用时 19 分 08 秒,下载完成后按精确字节数校验(这类数字必须一个字节不差)。

    构建 pack(使用 tools/iq_pack.py,注意必须加 --experts-bin,否则 mmap 模式无法启动):

    量化 experts.bin dense.bin top-1 一致率 专家槽位 decode
    IQ3_XXS 42.9 GB 1.43 GiB 84.46% 15,123 37.5
    IQ3_S 50.3 GB 1.54 GiB 87.69% 12,741 37.7

    我原本的判断是“专家块大 16.6%,显存槽位少 16%,decode 肯定会掉 8%”——实测没有下降,几乎持平。原因大概是命中率对槽位数并不敏感。因此在这台机器上换成更高精度档相当于免费获得质量提升,我把生产线直接换成了 IQ3_S。

    另外,IQ3_S 和 IQ3_XXS 的第二个分片(那 28.8GB 的表)逐字节相同,用软链接复用即可,省下 29GB 下载量。


    四、调优全过程:六个台阶,从 28.3 到 54.0

    每个数字都是先重启服务、空转 90 秒、用 6 条短请求预热之后才测得的(这点非常重要,见第五节)。全程使用同一台机器、同一份模型文件。

    阶段 改动 decode
    首跑 IQ3_XXS,出厂参数 28.3
    ① --spec 2 + --pool-workers 32 31.0
    ② 解除 --adapt-every 0 37.6
    ③ 换 IQ3_S 37.7
    ④ 升级 0.2.11 + DFlash2 草稿模型 49.3
    ⑤ MTP 草稿 + --pipeline-windows 2 + --trim-stage-weights 54.0

    最后一轮使用官方口径(1.6K prompt / 128 token / temp 0)复核过的五组对照:

    组合 decode prefill
    官方原参数(无草稿层) 34.8 —
    + --pipeline-windows 2(该组合下开关被静默关闭,见第五节) 35.9 —
    + MTP 草稿 47.1 —
    + MTP + 流水线 + trim(IQ3_XXS) 51.8 —
    + MTP + 流水线 + trim(IQ3_S) 54.0 571
    同机 IQ3_S + DFlash2 48.3 571
    官方参考机(2×MI50 16G,0.1.43.1,IQ3_XXS) 49.2 353

    比官方参考机快 10%,prefill 高 62%,而且量化档更高。

    关键参数(生产配置):

    {
      "exe": "/src/Strata/build-906/strata",
      "args": [
        "--pack", "/src/models/packs/iq3s",
        "--native", ".../IQ3_S-00001-of-00002.gguf",
        "--ple-gguf", ".../IQ3_S-00002-of-00002.gguf",
        "--expert-profile", "/src/models/learned-iq3s.bin",
        "--expert-profile-save", "/src/models/learned-iq3s-mtp.bin",
        "--expert-profile-save-every", "3",
        "--expert-cache", "auto",
        "--prefill", "auto",
        "--spec", "3",
        "--max-context", "131072",
        "--kv", "int8", "--kv-resident", "32768",
        "--layer-split", "27", "--trim-stage-weights",
        "--mtp", "/src/models/mtp/rt",
        "--pipeline-windows", "2",
        "--pool-workers", "32",
        "--pcie-frac", "0", "--vram-reserve-mib", "1024"
      ],
      "env": { "STRATA_RESIDENT_HEADROOM_GIB": "6" }
    }
    

    五、三个“静默失效”的坑,比参数本身更重要

    这三个坑的共同点是:服务仍然让 /health 返回 ok,也仍然正常输出文字,但你调的东西根本没有生效。

    1. --adapt-every 0 会静默关闭自适应专家缓存层

    官方冒烟命令里带着 --adapt-every 0,我早期配置直接继承了它。后果是:

    • 专家缓存退化成出厂 profile 的静态 15,123 个槽位,永远不会学习——同一批请求连续测三遍,命中率分别为 0.709 / 0.711 / 0.711,一个数都没变;
    • --expert-profile-save 根本不会落盘。

    引擎原话:

    strata serve: --expert-profile-save needs the adaptive tier
      (--adapt-every and --adapt-swaps above 0) and --expert-profile: nothing will be saved
    

    去掉这个参数后,命中率直接从 0.71 跳到 0.98,decode 提升 27%(从 29.7 到 37.6)。这是整台机器上成本最低的一次提速,代价只是删掉四个字符。

    2. --pipeline-windows 2 必须配合 MTP,否则会被静默禁用

    我第一次测试流水线时,前后两轮都“没有收益”,于是得出了“流水线无用”的结论。后来补加 --mtp 才发现日志里一直写着:

    strata generate: --pipeline-windows 2 is off: it needs the MTP drafter (--mtp, --spec)
    

    这个开关只作用于 MTP 草稿路径。 它生效时的自检行是下面这三条:

    strata mtp: draft layer loaded, 837 MiB of VRAM (experts 675, dense 111)
    --pipeline-windows 2: 290 MiB of CUDA0 kept out of the expert cache
    --pipeline-windows 2: two verifiers per stage, 2 stages overlap across windows (decode too)
    

    3. DFlash2 和流水线不能共存,这是源码里写死的

    DFlash2 从“已经跑完的那个窗口的 hidden taps”里起草,而流水线的本质是让两个窗口在时间上重叠,两者的数据依赖直接冲突。源码 generate.cpp:7103 的拒绝理由如下:

    it does not run beside --pipeline-windows (the MTP's speculative next
    window has no DFlash2 counterpart); --pipeline-windows 0
    

    所以只能二选一:DFlash2(48.3)或 MTP + 流水线(54.0)。顺带说,--draft auto(两个草稿按请求二选一)也不适用于双卡 layer split,源码写明它是给“单卡、单请求”使用的。


    六、测速方法学:否则测出来的结果并不可靠

    这点我和公开的 fieldnotes 结论完全一致,值得单独说明:

    1. 重启后必须空转 ≥90 秒,再发 6 条预热请求,然后才能开始计分。 冷启动后首次测量的数字会偏低 30–40%,而且不同配置的冷启动偏差不同——如果拿第 1 个样本做 A/B 对比,结论会非常自信却完全错误。
    2. 重启必须同时杀掉 serve.server 和引擎子进程,并且要在容器内执行 pkill。 如果只杀引擎,serve.server 会立刻把它重新拉起来并继续占用 8080,新实例会静默失败,/health 会立刻返回旧服务的响应——我第一轮就是这样把上一版的数字当成了这一版的。
    3. 启动后核对 /v1/models 的模型名是否等于本配置的 model_name,如果不一致,直接中止测量。
    4. 权威数字取 /metrics 中服务端自报的行,不要用客户端 wall time 估算。
    5. 修改配置时删除参数,要连它的值一起删除,否则残留值会变成位置参数,报 unknown argument: 2,而 serve 只会说“引擎启动前退出”。

    七、128K 上下文和内存的实际分配方式

    位置 内容 实测
    显存(两卡) 专家缓存 + dense 权重 + 草稿层 + KV 窗口 每卡约 15.9 / 16.0 GiB,余量 1.1 GiB
    系统内存 PLE 表 26.8 GiB(锁页) --ple-io ram 自动选中
    系统内存 专家常驻 arena / 文件页缓存 50.3 GB 的 experts.bin
    系统内存 KV 后备 --kv-resident 32768:每 QSA 层 32768/131072 个 cell 在显存,其余 K/V 落在锁页内存(早期设 20480 时实测锁页 K/V 为 0.77 GiB)

    要点是:128K 上下文不等于把 128K KV 全部塞进显存。 这个模型 48 层里只有 12 层 QSA 需要 KV,其余 36 层是 GDN 线性注意力,KV 成本天然就小;再配合 --kv int8 和 --kv-resident 32768 的流式方案,就能实现。

    实测长 prompt 表现:

    • 61,859 token 冷预填耗时 92.8 秒 ≈ 666 tok/s;
    • 15.6K token 预填约 29 秒;
    • 64–69K token 的长会话因为复用了 conversation cache,decode 达到 33.5–54.8 tok/s、命中率 0.78–0.93。

    冷启动到 /health ok:84 秒(首次锁页的那几分钟会很安静,别以为程序挂了)。


    八、横向对比

    平台 卡 decode 备注
    本机 2×MI50 16G 54.0 IQ3_S + MTP + 流水线
    官方参考机 2×MI50 16G 49.2 IQ3_XXS,Ryzen 7 5700X + DDR4-3600
    社区同卡 2×Radeon Pro VII 16G 47.8 IQ3_S,Ryzen 5 2600 + DDR4-2133
    单卡 4080 SUPER 1×16G 58.8 IQ3_XXS,i7-12700 + DDR4-3200
    同机 llama.cpp 2×MI50 16G 26.3–26.6 Qwen3.8-27B UD-Q4_K_M,pp 228.5

    两点说明:一是同一张卡搭配不同 CPU,差距非常明显,我测得 54.0,而公开数据是 47.8,差异主要来自 MTP + 流水线这套组合,并不完全由硬件决定;二是 27B dense 在这套卡上只有 26 tok/s 量级,而 125B 总参 / 6B 激活的 MoE 反而更快——这台机器注定应该跑 MoE。


    九、性价比换算

    口径 数字
    显卡/内存/主板合计 2700 元
    显存成本 46.9 元 / GB(HBM2)
    内存成本 7.0 元 / GB
    每 1000 元买到的 decode 20 tok/s
    对比:4080 SUPER 16G 单卡价格约 3–4 倍,decode 只高 9%

    再补充两点:MI50 单卡标称 300W TDP,但轻载推理时的实际功耗并不高,1250W 电源纯属过剩;这台机器同时还能当 128GB 内存的普通服务器使用(我平时在上面跑 Docker 做杂活)。

    一句话概括:用显存买速度,用内存买容量,用老 CPU 硬扛剩下的部分——这条路能走通,前提是你愿意花一晚上编译。


    十、未验证 / 待办事项

    这里如实标注,避免误导:

    1. 质量还没有做正式评测。 目前只跑了冒烟测试和讲义风格的中文长文样本(情境、公式、易错点齐全,没有套话)。3bit 在中文长文上的典型失效是重复、断段、术语漂移,这需要真材料 A/B 对比才算数。
    2. 没有测试满 128K 的检索质量,最长实测输入为 61.9K。
    3. 没有测试并发。官方和社区都说这条路径并发不行,我也没有尝试。
    4. 没有做整机功耗和温度实测,散热是改过的,长期稳定性只观察了一天。
    5. 0.1.57 的 --draft mtp 能否也配合流水线,还没有验证——我现在使用 0.1.55 是为了稳妥;DFlash2 那条线保留在 /src/Strata-0211,随时可以切换。
    6. 层切分只试了 27/21(按官方给出的值),没有穷举,不要当成全局最优。

    十一、一句话总结

    750 元一块的 16G HBM2 卡两张、900 元的 128G DDR3、300 元的二手主板,总计 2700 元,达到 54 tok/s,支持 128K 上下文,兼容 OpenAI/Anthropic 双接口。

    真正花时间的不是攒机,而是搞清楚哪些开关是真正生效的:--adapt-every 0 会让性能损失 27%,--pipeline-windows 2 在没有 MTP 时不会生效,DFlash2 和流水线在源码级就是互斥的。这三个坑的信息量,比任何一个调参数字都大。
  • 【纯闲着】2700 块的洋垃圾跑 QFN:MI50 16G×2 + 128G DDR3,从装系统到 54 tok/s,这可能是目前价格最低的洋垃圾方案。
    Sun LyuS Sun Lyu
    LLM讨论区 amd rocm 多卡部署

    @terry 说:

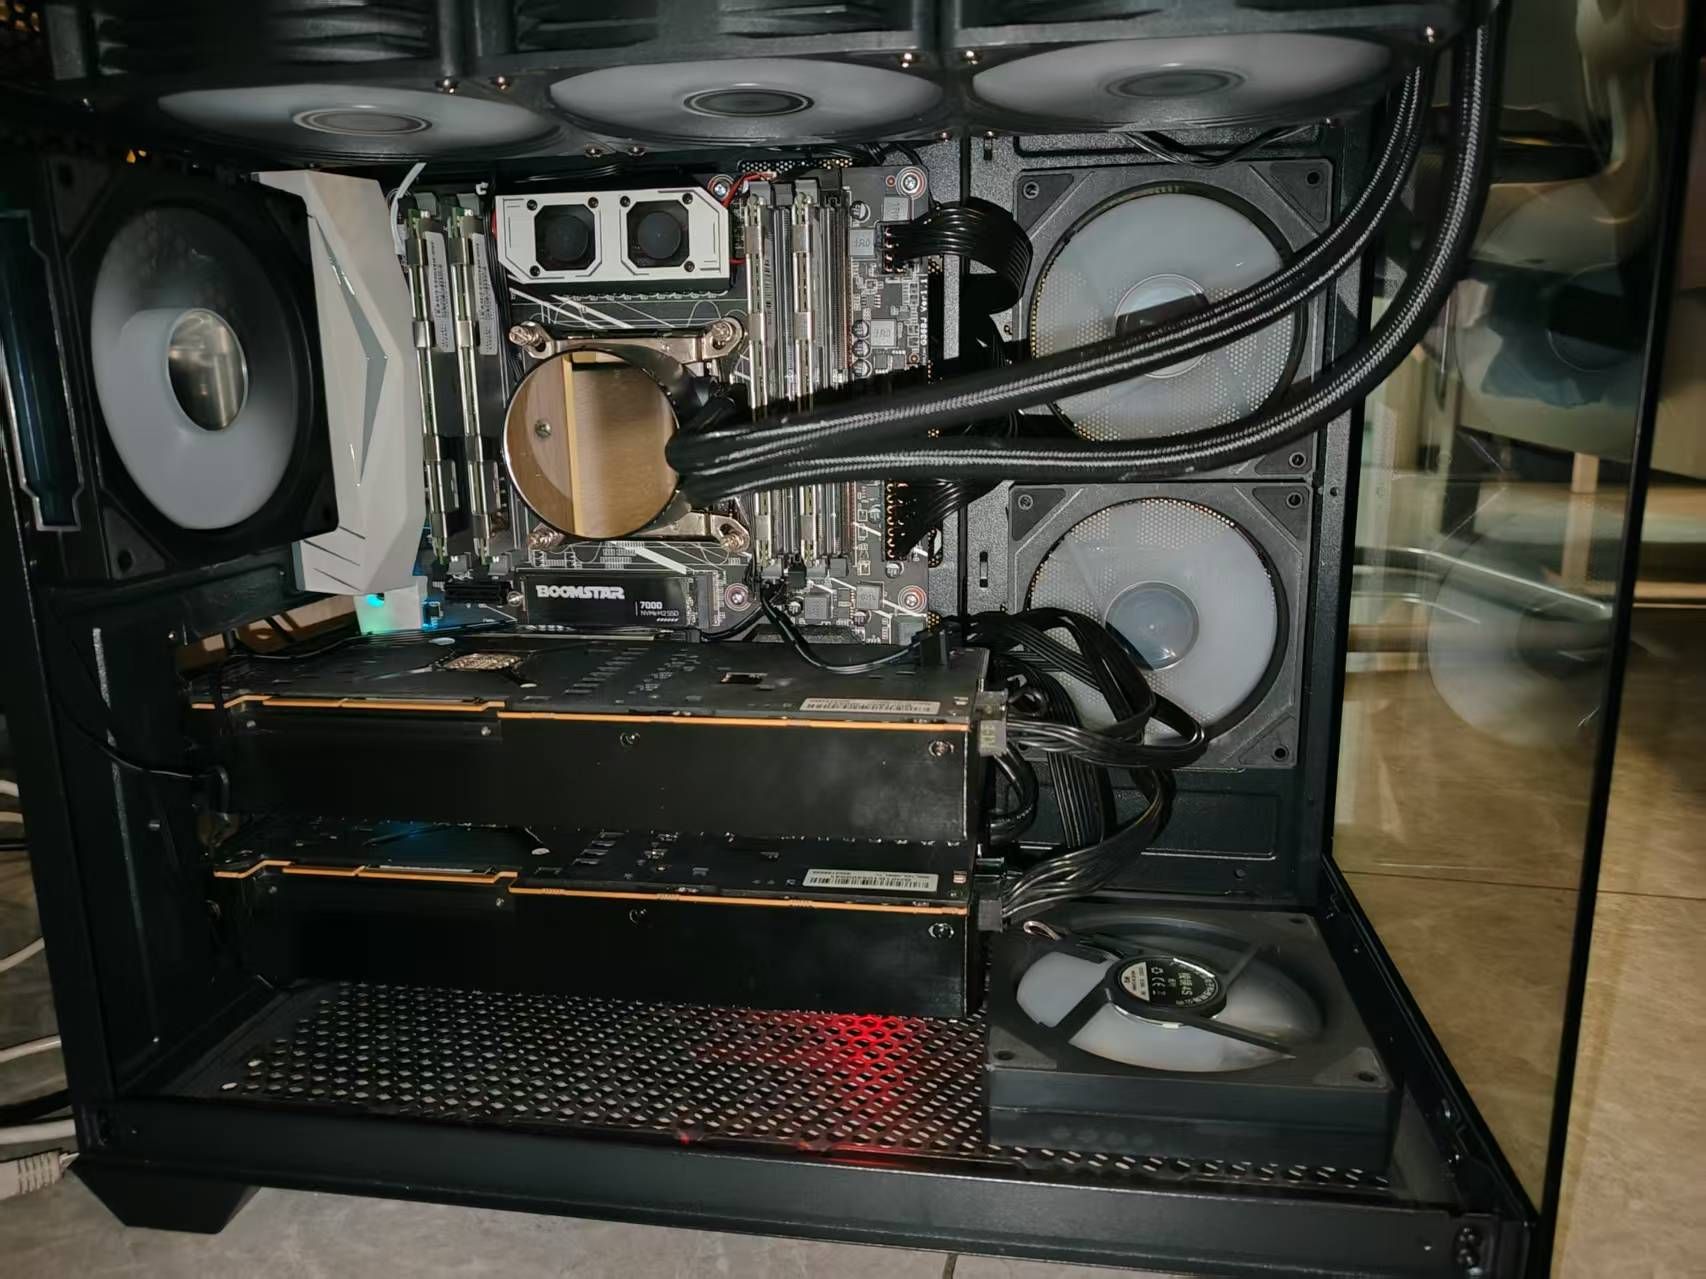
    不充点实拍图呢,我弟,我先水一集视频。

    好,晚上回去搞


  • 【纯闲着】2700 块的洋垃圾跑 QFN:MI50 16G×2 + 128G DDR3,从装系统到 54 tok/s,这可能是目前价格最低的洋垃圾方案。
    Sun LyuS Sun Lyu
    LLM讨论区 amd rocm 多卡部署

    调优再进一步

    上一篇写到 54.0 tok/s 就收尾了。

    吃晚饭的时候,我又去挖了挖潜力。

    先把结论放在前面:

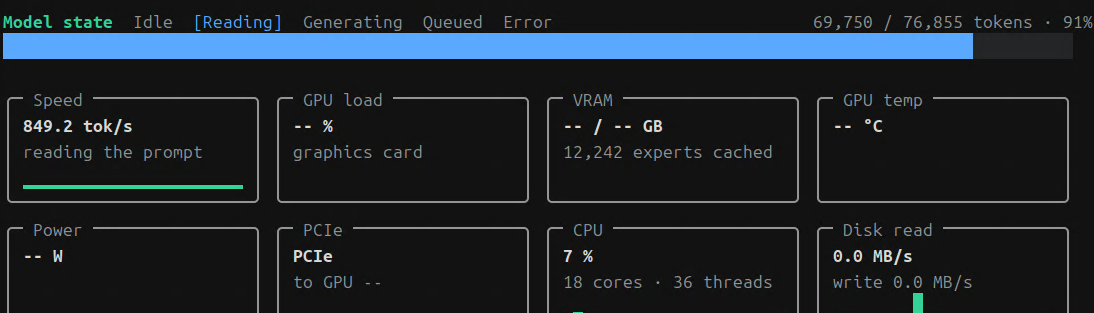
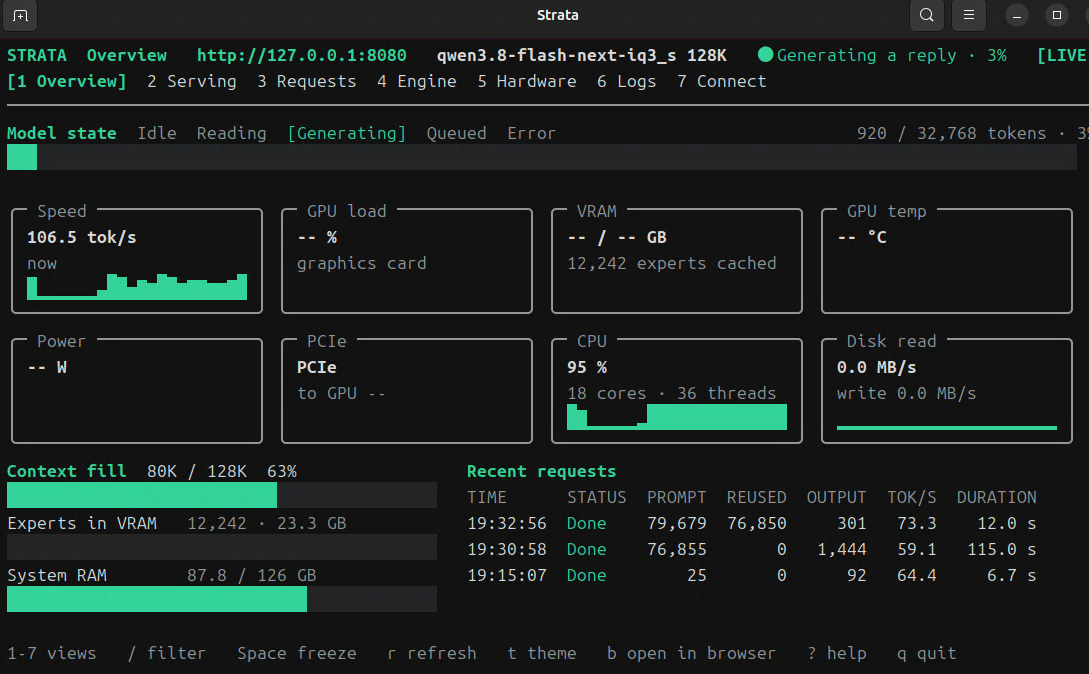
    同一台机器、同一份模型文件、同样的量化档(IQ3_S),decode 从 54.0 提到 65.1 tok/s,峰值可以突破100tok/s,prefill 从 571 提到 752 tok/s,峰值850 tok/s。

    均值65.1 是官方 2×MI50 参考机(49.2)的 1.32 倍,是我自己首跑(28.3)的 2.3 倍。

    代价只有一个:引擎版本从 0.1.55 退到 0.1.52+PR。

    微信图片_20261107193643_64_2.jpg

    微信图片_20261107193228_61_2.png

    微信图片_20261107193336_63_2.png


    一、线索:一个没人评审的 PR

    上一篇之后我看到:

    @rori 说:

    這卡有潛力, 已經有大神做strata優化:
    https://github.com/Niko1221/Strata/pull/5361

    作者是 4×MI50 32GB 的机器,报出来的数字是 decode 125 tok/s、prefill 8K 1250 / 32K 1766——差不多是我 54 的两倍多。我第一反应是"32G 版显存大,全驻,不奇怪",但里面有些数字对不上:我判负过的 --prefill-pipe,在他那儿是 +73% @8K、+109% @32K。

    这个 PR 的状态很说明问题:22 个 commit、30 个文件、+5046/−147,整个 PR 只有两条评论,都是 bot 在提醒"标题要加 [Engine] 前缀",没有一行人工评审。作者自己在描述里写着"基于 0.2.7,main 已经前进约 4k commits"。

    也就是说:这东西质量未必差,但没人验过,也不会自动合进来。想用只能自己来。


    二、第一次找错了地方

    我让模型去读这个 PR 的提交列表,它挑了 e4f4027 说:"这条值得参考,IQ3 的 gate/up 走 repacked GEMM,bitwise 等价,GEMM 从 0.85ms 降到 0.63ms。"

    听起来很对口——我用的正是 IQ3_S。于是我把这个分支完整编译了一遍(0.1.52,165/165 目标通过),然后做了个隔离实验:STRATA_PF_RP_IQ3=0 把这个改动关掉,看差多少。

    结果:

    臂 配置 decode prefill
    分支默认 repack 开着 50.1 690
    同一分支 STRATA_PF_RP_IQ3=0 关掉它 53.4 721

    关掉反而更快。 也就是说这条提交在我这台机器上测不出收益,方向甚至是反的(都在噪声里)。

    但它不是白读的——它把我引到了 PR 自带的 docs/AMD_MI50.md,那里面有一句被我(和模型)一路略过去的话:

    Each new switch is off by default.
    When a switch is off, that kernel runs exactly as before.
    

    三、转折:收益在"默认关着"的那一整块里

    docs/AMD_MI50.md 的推荐配置里,env 有 21 个开关。默认全关,全关时"kernel 和以前完全一样"。

    这意味着:我前面用分支默认态跑出来的 50.1,等于只免费蹭到了 prefill 栈(默认开),decode 一个开关都没吃到。

    把 21 个全打开之后:

    臂(同一协议,空转 90s) 引擎 decode 中位 prefill 冷启动
    上一篇的生产版 0.1.55(0.2.9) 47.0 521 75s
    分支默认态 0.1.52+PR 50.1 690 84s
    分支 + 关掉那条提交 0.1.52+PR 53.4 721 54s
    分支 + 21 个开关全开 0.1.52+PR 61.3 701 57s

    decode +30%、prefill +34%。

    顺带说清楚一件事:为什么同一台机器上一篇测 54.0,这一轮基线只有 47.0。因为口径变了——上一篇收尾时用的是官方口径(1.6K prompt / 128 token / temp 0),这一轮统一成 3×512 token + 14K token 长 prefill,两者不可直接比。下面所有数字都在这一个口径里。


    四、不等作者,自己把分支拉下来编

    作者只在 PR 分支上,fork 也不会被合并。但这件事根本不需要作者配合:

    curl -L --proxy http://192.168.2.2:7890 \
      -o int6.tar.gz \
      https://codeload.github.com/rpcribari/Strata/tar.gz/refs/heads/int6
    

    31,216,899 字节,解压到 /src/Strata-int6。三个意外的好消息:

    1. ggml 的 pin 没变(还是 3cf03257f2),所以我上一轮为 0.2.9 下的 /src/llama.cpp 直接复用,不用重下 37MB。
    2. 这个分支自带了我上一篇手补的那两个宏,而且在 dflash2.cpp:198 把 guard 改成了 #if defined(STRATA_USE_HIP) || defined(STRATA_HIP_GFX906)——比我"补两个 #define"的土办法干净,说明作者踩过同一个坑。
    3. project(strata VERSION 0.1.52),编译 165/165 全过,约 3 分钟。

    编译命令和上一篇完全一样,只把源码目录换掉:

    cmake -S . -B build-906 -G Ninja \
      -DSTRATA_HIP_GFX906=ON -DCMAKE_HIP_ARCHITECTURES=gfx906 \
      -DSTRATA_GGML_DIR=/src/llama.cpp \
      -DCMAKE_C_COMPILER=/opt/rocm/llvm/bin/clang \
      -DCMAKE_CXX_COMPILER=/opt/rocm/llvm/bin/clang++ \
      -DCMAKE_BUILD_TYPE=Release
    ninja -C build-906 strata
    

    注意:这里有一个反直觉的取舍——我为了 +30% 把引擎从 0.1.55 退回了 0.1.52。 新版本里 DFlash2 的改进、--draft mtp 那套新键,全都用不上了。但我是走 MTP + 流水线路线的,DFlash2 本来就用不了(上一篇第五节),所以这个代价对我是零。


    五、空转时间本身就是个变量

    社区那份 gfx906 调优台账里有一句我当时没在意的话:

    重启后与每次换负载后都有约 5 个请求的冷启动爬坡,且是 10 分钟量级、值得 3.7 tok/s 的进程级效应。

    于是我把同一套配置的等待时间从 90 秒拉到 540 秒,重测:

    空转 decode 中位 三次样本 prefill
    90 s 61.3 58.4 / 64.9 / 61.3 701
    540 s 65.1 57.6 / 66.9 / 65.1 751.9

    +6%,一分钱没花。

    这条值得单独记住:冷启动不是"等一会儿就好",而是一条 10 分钟的爬坡曲线。 空转 90 秒去比两个配置,等于在两条不同形状的爬坡曲线上各取一个点做比较——数字看着挺整齐,结论可能是错的。我前面几轮"某开关无收益"的判断里,至少有一部分要打这个折扣。


    六、最后一个选项,判负

    那条提交还留了个选项:STRATA_PF_RP_IQ3=2,让 IQ2_S 也走 repacked GEMM(作者报该算子 +12–21%,非 bitwise 但相对误差 1.7e-7)。

    我们的 pack 是混合量化(层 0/16 是 IQ3_XXS/IQ4_NL、层 8 是 IQ2_S/Q2_0、层 24/32 是 IQ2_S/IQ4_NL、层 40 是 IQ3_S/IQ4_NL),IQ2_S 占比不小,值得一试。同样 540 秒空转:

    臂 decode 中位 prefill
    21 个开关 65.1 751.9
    22 个(多 RP_IQ3=2) 60.8 754.4

    decode −4.3、prefill 持平。 判负。作者那个 +12–21% 是在他那种"同类专家集中"的 pack 上测的,我这种层间混排的 pack 把 IQ2_S 从 MMQ 挪走反而更亏。


    七、现在的生产配置

    {
      "exe": "/src/Strata-int6/build-906/strata",
      "args": [
        "--pack", "/src/models/packs/iq3s",
        "--native", ".../IQ3_S-00001-of-00002.gguf",
        "--ple-gguf", ".../IQ3_S-00002-of-00002.gguf",
        "--expert-profile", "/src/models/learned-iq3s.bin",
        "--expert-profile-save", "/src/models/learned-iq3s-mtp.bin",
        "--expert-profile-save-every", "3",
        "--expert-cache", "auto",
        "--prefill", "auto:16384",
        "--prefill-pipe", "350",
        "--spec", "3",
        "--max-context", "131072",
        "--kv", "int8", "--kv-resident", "32768",
        "--layer-split", "27", "--trim-stage-weights",
        "--mtp", "/src/models/mtp/rt",
        "--pipeline-windows", "2",
        "--pool-workers", "32",
        "--pcie-frac", "0", "--vram-reserve-mib", "1024"
      ],
      "env": {
        "STRATA_RESIDENT_HEADROOM_GIB": "6",
        "STRATA_MTP_STAGE0": "0",
        "STRATA_RESIDENT_PIN": "0",
        "STRATA_GR_NORM_FAST": "1",
        "STRATA_IQ_STAGE_GRID_MMVQ": "1",
        "STRATA_IQ_MMVQ_XLDS": "1",
        "STRATA_IQ_MMVQ_RB": "16",
        "STRATA_IQ_MMVQ_R2": "1",
        "STRATA_MMVQ_XLDS": "1",
        "STRATA_MMVQ_WPB": "8",
        "STRATA_MMVQ_Q6X4": "1",
        "STRATA_MMVQ_Q4X4": "1",
        "STRATA_EXP_X4": "1",
        "STRATA_EXP_GU_H2": "1",
        "STRATA_EXP_LDS_Q50": "1",
        "STRATA_GR_DOWN_TG": "a",
        "STRATA_GR_DOWN_PF": "1",
        "STRATA_MMVF_ROWS": "1",
        "STRATA_GFX906_ATTN_QUERY_SWIZZLE": "1",
        "STRATA_GFX906_ATTN_REDUCE12": "1",
        "STRATA_HIP_SWIGLU_FUSED": "1"
      }
    }
    

    实测:decode 65.1 tok/s / prefill 752 tok/s / 128K 上下文 / 命中率 0.96–0.98 / 冷启动约 60 秒。冒烟抽查("机械效率 + 斜面")输出结构完整、带摩擦力的因果解释。

    顺便说一句:STRATA_GFX906_ATTN_QUERY_SWIZZLE 和 STRATA_GFX906_ATTN_REDUCE12 这两个开关,我上一轮单独测它们是判负的(48.1/47.8,都低于基线 49.3)。现在它们进了全开组合,整体反而更快——这大概是"单开没用、和别的 kernel 一起才有用"的典型,也说明单开关 A/B 在 kernel 层是会骗人的。


    八、三条可复用的教训

    1. 收益常藏在"默认关闭 + 文档里一句话"里

    我两次踩同一个坑:

    • --adapt-every 0:官方冒烟命令就带着,我继承了,偷走 27%;
    • 21 个 STRATA_*:默认全关,文档写得很清楚"off by default",但我先只编了分支就跑,白跑了 20%。

    判据很简单:一个功能如果"默认关",它的作者就是在等你读文档。 拿到新分支,先 grep -n "env" docs/*MI50*.md,别急着 ninja。

    2. 任何"某开关无效"的结论,先去日志里确认它真的生效

    我在上一篇写过这条,这次又验证了一遍:--pipeline-windows 2 没有 MTP 会被静默关掉,日志里那句 is off: it needs the MTP drafter 躺在几万行里。判据就看三类行:is off / kept as asked / 启动 banner。

    3. 测速的空转时间必须够长

    90 秒和 540 秒能差 6%。这条对谁都成立,不是我这台老机器的特例——社区在同一份台账里写了"10 分钟量级"。


    九、代价与回滚

    诚实列出:

    1. 引擎版本倒退:0.1.52+PR < 0.1.55 < 0.1.57。如果哪天官方把 PR 的 kernel 合进 main,我立刻回去。
    2. 回滚成本几乎为零:/src/models/strata-iq3smtp.json(0.1.55 + MTP + 流水线,54.0)和 /src/Strata/build-906/strata 都留着,改个 exe 路径重启就能退回。
    3. 分支是 untested 的:一个人维护、没人评审、基于 0.2.7。我只能用"编译通过 + 冒烟正常 + 输出结构正确"来担保,长跑稳定性还没验证(这点和上一篇的待办一样)。

    十、第 9 个台阶后的横向对比

    平台 卡 decode 备注
    本机(本轮) 2×MI50 16G 65.1 int6 分支 + 21 开关 + IQ3_S + MTP + 流水线
    本机(上一篇) 2×MI50 16G 54.0 0.1.55 + MTP + 流水线
    官方参考机 2×MI50 16G 49.2 IQ3_XXS,Ryzen 5700X + DDR4-3600
    社区同卡 2×Radeon Pro VII 16G 47.8 IQ3_S,Ryzen 5 2600 + DDR4-2133
    单卡 4080 SUPER 1×16G 58.8 IQ3_XXS,i7-12700 + DDR4-3200
    同机 llama.cpp 2×MI50 16G 26.3–26.6 Qwen3.8-27B UD-Q4_K_M

    我这台 2700 块的洋垃圾,现在的 decode 已经超过了单卡 4080 SUPER 的公开数据(58.8),而那张卡的价格够配三台这机器。

    而且这是在 DDR3-1333 约 30 GB/s 的前提下跑出来的。这也侧面说明:MoE 的 decode 瓶颈主要不在显存带宽,而在专家回落到内存时的那条路有没有被榨干——这条路一旦通了,便宜的 DDR3 也能顶住。


    十一、待办(更新)

    1. 质量仍然只有冒烟和风格样本,没有正式评测。 3bit 在中文长文上的失效模式是重复、断段、术语漂移,必须真材料 A/B 才算数——这是我现在唯一的硬闸门。
    2. 长跑稳定性:分支版连续跑满 24 小时没有掉速/OOM 才算数。
    3. 没测并发(官方与社区都说这条路径并发不行)。
    4. --prefill-pipe 在"专家全驻"场景(换 Coder IQ1_M 那种塞得进 32GB 显存的档)还没复测——PR 里它 +73% @8K 的前提就是全驻。
    5. 层切分仍只用了官方给的 27/21,没穷举。

    十二、一句话总结

    上一篇的 54 是"把开关打开",这一篇的 65 是"发现开关根本没打开"。

    真正值钱的不是那 11 tok/s,而是这两次都指向同一件事:这套引擎的默认值是给"能跑起来"准备的,不是给"跑得快"准备的。--adapt-every 0 是一处,21 个 env 是另一处,下一处大概率还写在某个没人读的 docs/*MI50*.md 里。

    项目地址:Niko1221/Strata
    分支:rpcribari: int6


  • 登录

  • 登录或注册以进行搜索。
  • 第一个帖子
    最后一个帖子
0
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组