暂时最后一弹:Q3.8 FN参数到顶之后,我换了3.6 35B A3B对比了一下
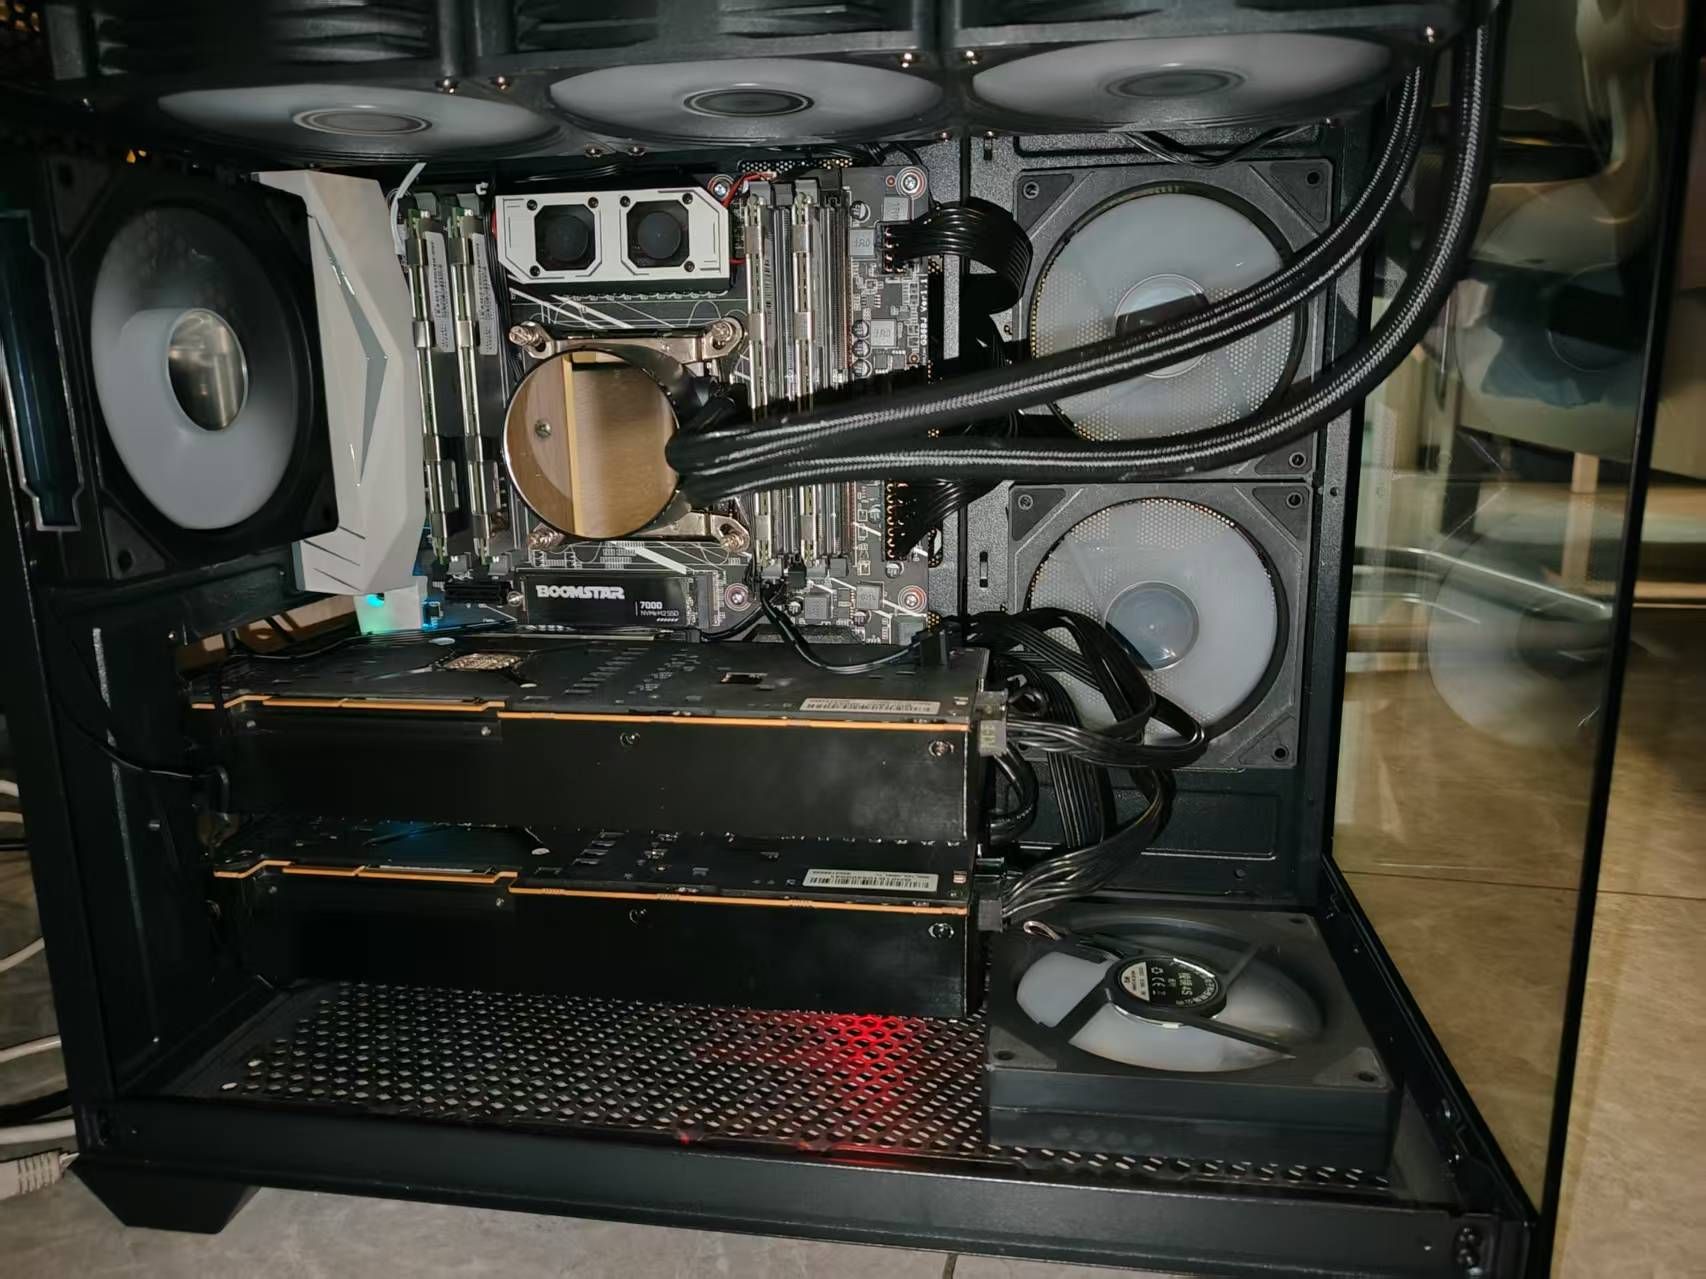
(2×MI50 16GB + DDR3-1333 的第三轮)
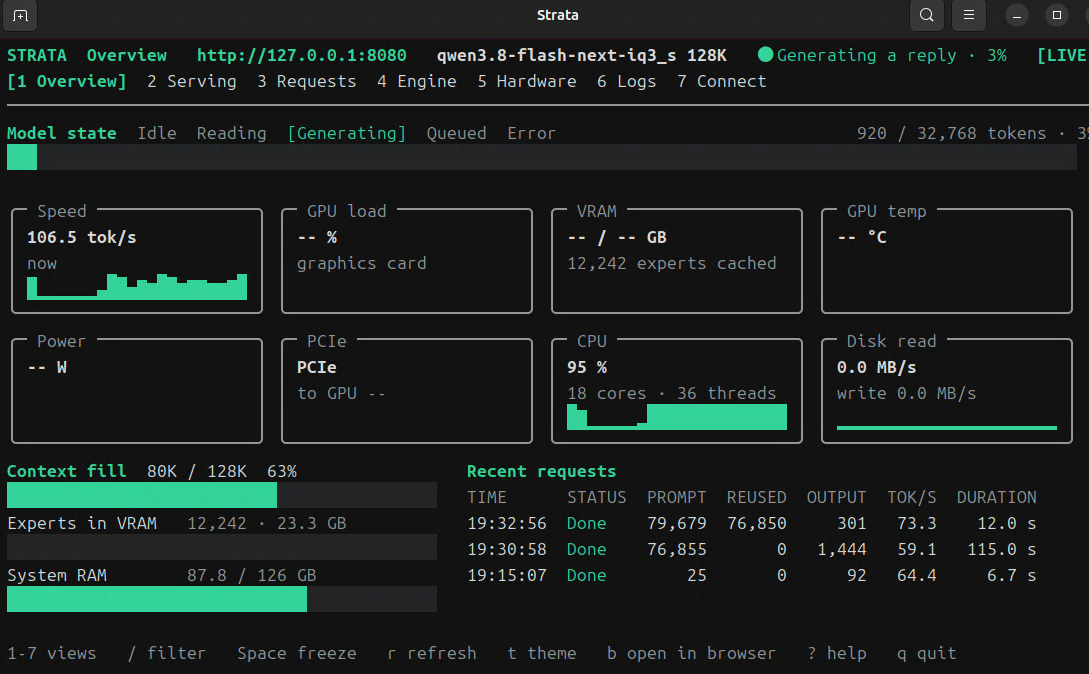
QFN参数扫完,这台机器停在 decode 67.83 tok/s、窗口 160K、专家命中 97–99%。
结论:
- 现役定版跑出 decode 67.83(三个样本 64.94 / 67.83 / 70.27)、长 prefill 716–727 tok/s、18K 冷预填 736.6 tok/s,窗口 160K
- q36 最好成绩是短上下文 98.8 tok/s、18K 冷预填 962 tok/s、18K 复用后 38.2 tok/s,窗口 32K
- 继续用 Flash-Next。q36 赢的那一格现役已经够用,其余都在输
数字是怎么量的
decode 走流式请求,取 usage 自报的计数,同一配置连发三次取中位。长预填用同一份 11,018 token 的 prompt。短 prompt 一组 185 token、一组 515 token,只看首字节。18K 一组是 87 KB 中文材料,先冷跑一轮,再在同一会话里追问一轮,两轮分开记。空转 180 秒,前面带六条预热。
改完配置要核对自检行。/health 在加载期就返回 ok,看不出开关有没有生效。MTP 要看到 draft layer loaded,流水线要看到 two verifiers per stage,env 类只能读进程环境:
docker exec strata-build bash -c 'tr "\0" "\n" < /proc/<引擎pid>/environ | grep CPU_SHARE'
生产上还能动的地方
第 22 个 env 买的是首字节
STRATA_PREFILL_CPU_SHARE=auto 把预填阶段的一部分专家行分给 CPU 线程池,跟 GPU 并行推进。短 prompt 本来就在等 CPU 算专家,收益应该落在这里。
| 指标 | 21 个 env | 22 个 env(现役) | 变化 |
|---|---|---|---|
| decode 中位(3×512) | 70.49 | 67.83 | −3.8% |
| 长预填 11,018 token | 710.3 / 746.6 | 726.8 / 716.3 | 持平 |
| 18K 冷预填 | 774.2 tok/s | 736.6 tok/s | −4.9% |
| 短 prompt 185 token | 1.527 s | 1.326 s | −13.2% |
| 短 prompt 515 token | 2.226 s | 1.861 s | −16.4% |
decode 和长预填的差都在噪声带里,同一个臂连发三次就能从 62.32 摆到 71.38。稳的只有首字节,三个样本 1.516 / 1.326 / 1.314,摘掉这个 env 是 1.687 / 1.517 / 1.527。
所以它留在生产里,理由是交互的时候人等的是第一个字。它不提吞吐,这一条不该写成提速。
env 从 21 项变 22 项,备份在 strata-iq3s-prod-pre-cpushare.json,restart-prod.sh 一条命令上去,WARM_DONE 17.8s,冒烟正常。
窗口定在 160K
模型原生 262K。192K 也能跑,同批对比摆在下面。
| 配置 | max-context / kv-resident | 启动 | 短上下文 decode | 长预填 |
|---|---|---|---|---|
| 192K | 196608 / 65536 | 66.1 s | 59.3 | 803.2 @19K、901.4 @53K |
| 160K(定版) | 163840 / 54624 | 60.3 s | 60.6 | 744.1 @11K |
这一组是同一批测的,只读相对差,绝对值看开头那行。
192K 那版还跑过一组长上下文。
| prompt | decode | prefill |
|---|---|---|
| 29 token | 59.3 | — |
| 19,026 token | 42.0 | 803.2 |
| 53,125 token | 52.7 | 901.4 |
上下文从 29 token 涨到 5.3 万,decode 掉 11%。这笔开销跟 KV 放不放得下无关,是 attention 本身随长度线性涨价。160K 比 192K 短上下文快 1.3 tok/s,启动快 6 秒,多出来的 32K 用不上,生产里最长的一次真实会话 145,985 token,占 160K 的 89%。
那条会话的日志比合成测试更有说服力。
prompt 145,985 tokens = 144,739 reused + 1,246 read in 4.7 s
1,982 generated in 36.8 s (53.9 tok/s)
decode expert cache hit rate: 97.4%
接近满窗还有 54 tok/s。
会话缓存,低的是前缀复用率
「命中率只有七成」这个印象一直挂在专家缓存上,挂错了。专家缓存常年在 0.96–0.98,低的是 --conversation-cache-* 管的前缀复用。
根因很朴素。默认四个停放槽,--conversation-cache-min-tokens 默认 0,任何请求都能占一个。几条二十来 token 的请求就把槽占满,长会话挤不进去。
--conversation-cache-mib 16384
--conversation-cache-slots 8
--conversation-cache-min-tokens 8192
--conversation-cache-park-gain 512
生效后日志里能看到短请求被挡在门外。
strata serve: conversation cache: skip parking (43 tokens, below the 8192 minimum; parked=0)
长会话的复用率跟着上到 99.2%。
代价在冷启动。缓存槽刚改完、引擎还在爬坡的时候,8,592 token 的冷预填跑过 373 秒;稳定之后 18K 冷预填 23.6 秒。重启后必须有预热,否则第一个真实请求可能卡几分钟。warm.py 已经内置进 restart-prod.sh,一次 WARM_DONE 17.7s,首请求 TTFT 从 11.9 秒降到 0.59 秒。
十六个开关臂全落在噪声里
后面又扫了十六个开关,分三批,同一口径。扫描结果折算成相对基线的差。
| 批次 | 臂 | 相对基线(tok/s) |
|---|---|---|
| 草稿与管道 | --spec 4 |
−4.1 |
--spec 5 |
−13.8 | |
--spec-min-p 0.5 |
−0.8 | |
--prefill-pipe 300 |
−2.0 | |
--prefill-pipe 450 |
−2.3 | |
| GDN 五臂 | GDN_PIPELINE / GDN_SPLIT / GDN_CHUNKED / GDN_COMMIT_SPLIT / GDN_PP=2 |
−1.3 / −0.8 / −3.4 / −1.5 / +0.3 |
| KV 与 MTP 五臂 | KV_PREFETCH / KV_GROW / MTP_TOP2 / MTP_FULL_HEAD / LOOKAHEAD |
−2.1 / −3.4 / −3.4 / −2.3 / −1.7 |
掉出噪声带的只有 --spec 4 和 --spec 5。--spec 3 是唯一最优点,而且非单调,4 慢,5 更慢,6 也不快,不是越大越好。
结论很干脆:靠调参数榨不出东西了。想再快只剩两条路,改内核或者换模型。
外部路线都试过一轮
replicas 单流掉两成
同平台(E5 + X99 + 128G DDR3 + 双卡)用 replicas 拓扑的报告里,单流明显更高,就想验证一卡一副本能不能绕开跨卡握手。
| 拓扑 | 单流 decode | 双流聚合 | 专家命中 | 启动 |
|---|---|---|---|---|
| 层切分(现役) | 基准 | 57.4–61.7 | 0.952 | 87 s |
| replicas(一卡一副本) | −22% | 66.1 | 0.682 | 120 s |
replicas 输在显存。每个副本只看得见自己那张 16GB 卡,专家槽位从约 12,200 掉到 5,500 上下,命中率 0.952 → 0.682,缺口全落到 DDR3 上。同平台那台能赢,推测是同样的机制反过来,副本看得见的显存够放槽位,命中率不掉。
判定是保持层切分。我们的负载是单 agent 长会话顺序推进,单流速度决定一切;replicas 只在多人同用、每人能接受 40 tok/s 的时候有意义。
rocBLAS 解表派发不通
xxDoman/strata-gfx906 那条线里唯一带速度的是 rocBLAS solution table。库版本对不上(我们是 5.5.0,它的表是 5.2.0),只能现场调一份。
- 42 个 shape,32 个有更优解,最大
T=8192 N=1 K=2560增益 6.36 倍; - 表落在
/src/models/gfx906-rocblas.txt。
reader 一编进引擎,生产直接不可用。
reading the prompt: 13 of 20 tokens, 143 s
no progress for 60 s ... stopping the engine
带与不带 STRATA_ROCBLAS_TUNING 结果一样,表的问题是次要的。走不通的是 rocBLAS 在这个 shape 上的派发,缺 Tensile 内核或者首次 JIT 极慢,没证实。已回滚,重编后二进制字节数与补丁前完全一致。
单测证明「这档算得快」和「引擎能用这档」是两件事。
Avalon 能加载算不对
fraiadoc/Avalon 是 llama.cpp 的 fork。移植时改了逻辑 warp32、MMQ GCN 的 nthreads/2、host warp_size,编得过;官方 89.72 GiB 的包也能加载,25 个专家 pool 全部 register=1。
坏在 MMQ 批量路径在 gfx906 上 unspecified launch failure:ub≥16 必崩,ub≤4 才正常,加 GGML_CUDA_NO_MMQ 短路也换不来可用吞吐。90 GB 模型已删。
这条留下的教训比速度重要。随机 token 的 bench 只证明跑得动,证明不了算得对。
其余几条判负
--kv k8v4:−7%--ple-io direct和mmap:与ram无差别,PLE 26.8 GiB 已经整表锁内存,每 token 只取 90 字节每行- 中文 MTP 草稿词表:默认 106,299 token 的集合里只有 27 个汉字(共 55,328 个),但中文 decode 61.0 tok/s、英文 63.9 tok/s,只差 4%,prompt-lookup 草稿仍能命中;
--add cjk是 +3–5% 的小杠杆 - vLLM 的 gfx906 两个实现(MobyDick #53 / #34):收益场景是 page-cache 随机 gather,我们的 PLE 已经整表锁内存,没空间
- Basalt:只支持 NVIDIA Blackwell,源码里没有 HIP 后端
转去 Qwen3.6-35B-A3B
参数到顶、窗口定死、内核路径能试的都试过之后,剩下的变量只有模型本身。Qwen3.6-35B-A3B 是官方仓库里的一等模型,22.9 GB 的 UD-Q4_K_XL 塞得进显存,总参 35B、激活 3B,理论上比 125B 总参 / 6B 激活的 Flash-Next 轻。
它按单卡写死
只读调研的证据链很硬:src/qwen35/ 里 ggml_ 零引用,没有 cudaSetDevice 和 cudaGetDeviceCount,所有权重裸 cudaMalloc,--gpu 只由父进程的 HIP_VISIBLE_DEVICES 生效。而且整个目录被 CMakeLists.txt:860 的 if(NOT STRATA_HIP_GFX906) 排除,理由写在同处注释里:它调用 wave64 兼容层没映射的 cuBLAS 入口,kernel 也假设 32-lane warp。
所以这条路得做移植,改配置没有用。按五个阶段推进:能编、单卡跑通、层切分、和 serve 共存、接 MTP。
让它能编译
最小改动两处。
include/strata/platform/hip_compat/cublas_v2.h补cublasSgemm和cublasGemmStridedBatchedEx两个映射(指向 hipblas);CMakeLists.txt加option(STRATA_BUILD_QWEN35_GFX906 ... OFF),条件改成if(NOT STRATA_HIP_GFX906 OR STRATA_BUILD_QWEN35_GFX906)。
默认 OFF 是关键。实验用独立的 build-906-q36,生产构建完全不受影响。结果 167/167 编译通过,--families 从 qwen4exp 变成 qwen4exp qwen35moe。
单卡上撞三道门
| 门 | 报错 | 结局 |
|---|---|---|
| 专家类型白名单 | blk.0.experts are IQ2_S/IQ3_S, which the native expert kernels do not take |
UD-IQ3_XXS 是逐层混合量化,补表补不完,换档 |
| 32-lane warp 假设 | MUL_MAT failed 加 unspecified launch failure |
逻辑 warp32 改造,四处 |
| MMQ 批量路径 | ub=16/64/256 必崩,ub≤8 正常 |
GCN 配置表按 64 lane 波设计,改 nthreads/2 |
换成 UD-Q4_K_XL(22,853,663,008 B)后加载成功,25 个专家 pool 全部注册,-ub 1 下中文跑通。
层切分暴露四个跨设备 bug
单卡跑通只是及格线。两卡实现选了两个 Engine 对象各自 init(),没有去手抄七十多个指针的 scratch 快照。这一层暴露的四个 bug,单卡上永远看不到。
iq_embed_rows: invalid resource handle,所有入口前置use_dev()(cudaSetDevice);k_moe_out在 GPU0 上 Memory Fault,边界层的wn指向了 dev1 的next->attn_norm,改成 load 末尾复制到 dev0;- 残差流没跨设备,
k_moe_out同时写h和残差x,原实现只搬了h,从边界层起全错; xq_ready跨 forward 泄漏,边界层让mkq保持为真,标志留在 A 上,下一个 token 复用了上一个 token 的 q8 镜像。
修完速度:pp 约 345 → 935(2.7 倍),tg 约 64 → 77(+20%)。
这一层比速度更值钱的收获,是那个不变量闸门。
同一条 prompt、--n 1,只改 --layer-split
  split 20 → gen: 2972   ← 三个切点给出三个答案
  split 22 → gen: 271
  split 23 → gen: 248044 (EOS)
  单卡     → gen: 1
修好后四者全是 token 1;--n 16 四份逐 token 相同;--dump-full-logits 显示 split 20、22 与 split 23 的 max|Δlogit| = 0。
切分类改造必须配这个测试。没有它,速度数字再漂亮也是错的。
和 serve 共存,卡住四个 token
删掉 q36_engine.cu:3980 那个 if (layer_split > 0 && serve_mode) return 2;,补上 select_all、copy_session_all、reserve_bnd,8082 上中文正确,API 与 CLI 逐 token 相同(25/25)。
会话前缀复用恒为 0。根因在模板。生成提示末尾会追加一个空思考块 <think>\n\n</think>\n\n,四个 token,而历史轮渲染默认不回放 think 块,第二轮的 prompt 与第一轮的前缀差这四个 token。match_len() 要求整段 live 是新 prompt 的前缀,引擎又没有 KV 回退,于是恒 0。
把 chat_template.jinja 里那个 preserve_thinking 条件改成 {%- if true %},历史 assistant 轮永远回放 think 块,立刻变成 REUSE 42 of 62。
顺带一个运维坑:tokenizer 目录是容器 root 建的,宿主机改不动,只能 scp 脚本进 /src/bench/ 再用 docker exec 跑。
接 MTP 改了七处
矛盾在权重的位置上。MTP 权重在 head 引擎(dev1),验证窗口必须从拥有 layer 0 的引擎(dev0)进入。
commit()循环加if (!owns_layer(l)) continue;,每卡只推进自己那半层的 GDN 状态;spec_step()的验证窗口改由peer ? *peer : *this跑,之后双侧 commit 加双侧 pos 同步,只让一边 commit 会让两卡状态分叉;- 新增
spec()委托到head_e,覆盖 warmup、serve、CLI 三个调用点; - 新增
mtp_prompt(),prompt 的 MTP K/V 预填写到 head 引擎,拷贝全用它的 stream; main()删掉 split 下的mtp_d = 0;spec_step入口补use_dev();Model::embd1给 dev1 一份嵌入副本,否则 MTP 种子行在 dev1 读 dev0 的嵌入会越界(rc=141),代价 0.50 GiB。
验证跑了 split 20 / 22 / 23 乘 mtp 0 / 3 四种配置,两套 prompt 各 16 token 全部 IDENTICAL。
两个模型的成绩
同一份材料、同一条会话、同一台机器。材料被两个 tokenizer 数成 17,408 和 18,376 个 token,不是两份材料。
| 指标 | q36(split 22 + mtp 3) | 现役 Flash-Next | 谁赢 |
|---|---|---|---|
| 冷预填 18K | 19.1 s(962 tok/s) | 23.6 s(736.6 tok/s) | q36,1.31 倍 |
| 复用读入 | 0.125 s | 0.381 s | q36 |
| 18K 冷 decode(28 token) | 50.0(drafts 19/24) | 53.9 | 现役 |
| 18K 复用后 decode(128 token) | 38.2(drafts 80/144) | 58.3 | 现役,1.53 倍 |
| 上下文窗口 | 32,768 | 163,840 | 现役 |
那 28 个 token 的样本太小,又是在冷启动的爬坡段里取的,波动比差距还大,这一格别太当真。
MTP 在 q36 身上是双刃剑。
| 场景 | 无 MTP | --mtp 3 |
变化 |
|---|---|---|---|
| 1,242 token 短上下文 | 77.9 | 98.8 | +26.8% |
| 18,376 token 冷预填 | 960.9 | 919.9 | −4.3% |
| 18K 冷 decode | 44.2 | 50.0 | +13% |
| 18K 复用后 decode | 43.7 | 38.2 | −12.6% |
--mtp 5 掉到 37.0,--mtp 6 掉到 33.9,草稿越激进越糟。
机制说得清。q36 的 decode attention 按 query 行展开,窗口越大越亏;投机解码每轮要验证多个 token,等于在长上下文里把这份成本乘若干倍。现役 Flash-Next 的 QSA 层本来就是为长窗口设计的,48 层里只有 12 层需要 KV,MTP 验证才吃得下。
两个模型最好成绩并排
| 维度 | Qwen3.8-Flash-Next(现役) | Qwen3.6-35B-A3B(q36) |
|---|---|---|
| 量化与体积 | IQ3_S,两分片 54.8 + 28.8 GB,PLE 嵌入表走内存 mmap | UD-Q4_K_XL,22.85 GB |
| 架构 | 125B 总参 / 6B 激活 MoE | 35B 总参 / 3B 激活 MoE |
| 短上下文 decode | 70.27 峰值、67.83 中位 | 98.8(1.2K 上下文,mtp 3) |
| 中长上下文 decode | 58.3(18K,复用后) | 38.2(18K,复用后) |
| 冷预填 | 736.6 tok/s(18K) | 962 tok/s(18K) |
| 长 prefill(11K) | 716–727 tok/s | 962 tok/s(18K 口径) |
| 上下文窗口 | 163,840 | 32,768 |
| 显存余量 | 两卡各约 1 GiB | dev0 1.16、dev1 1.51 GiB |
| 代码状态 | 上游分支加一份配置,没改业务代码 | 改 5 个文件,其中 q36_engine.cu 803 行 patch,移植两天 |
| 生产运行 | 连跑 30 天 | 从未上生产 |
q36 领先的只有短上下文那一格,冷预填领先 31%;长上下文和反复追问都归现役,窗口大五倍。
没换的原因
我们的负载形状长在 Flash-Next 的优势区。
- 主流程是同一份材料反复追问,是讲一讲、改一改、再问细节,同一份一万到两万 token 的材料在同一条会话里来回推进。这条路吃的是复用后 decode,58.3 对 38.2,现役快 53%。q36 赢的那条是冷预填快 4.5 秒,每份材料只发生一次。
- 窗口是硬约束。32K 装不下一讲完整材料加多轮对话,我们真实会话已经到 14.6 万 token。q36 的可行带在 40 层里是
split 17..23,往上要么放不下要么爆显存。 - 稳定性差着数量级。现役是上游分支加一份配置,连跑 3天;q36 是改 5 个文件移植出来的,上游一次更新就可能要重来。
- 它的收益场景现役能覆盖。超长材料只问一轮,现役多付 4.5 秒预填就能做,窗口还是五倍。为这 4.5 秒去背一个自己维护的移植分支,不划算。
- 想让它真赢,得改 kernel。唯一能把 q36 的 18K decode 推到现役之上的路,是改
k_attn_part和k_attn_prep,让窗口内 T 行共享一次 KV 读取。那是一两天的 kernel 工作,且不保证成功。
教训
切分类改造要配切点不变性测试
同一条 prompt、--n 1、只改切分点,比 argmax。q36 靠它抓出四个 bug。Avalon 那次是反例,ub 调小跑得动、一放大就崩,随机 token 的 bench 把「算不对」伪装成了「调参问题」。
基线必须同批
同一台机器、同一个二进制、同一份 args,隔一天测出来的数能差 16%。所以 A/B 要在同一批里跑,跨天、跨口径的数字不能直接减,否则会得出「越调越慢」这种结论。
默认值是给能跑起来准备的
--adapt-every 0 关掉自适应缓存层,21 个 env 默认全关,--conversation-cache-min-tokens 默认 0 让短请求占满长会话的槽。这几处默认值只管能跑起来,不管跑得好。
别人的增益不能照搬
rocBLAS 那张表在我们机器上确实成立,32/42 个 shape 有更优解,最大 6.36 倍,但派发走不通就是走不通。先核对是不是同一条代码路径、同一个瓶颈,再决定复刻。
还没做的
- 质量评测没做,速度已经够了。
- 长跑稳定性。int6 分支版连跑满 24 小时不掉速才算数,目前断续跑了几天,没见异常。
- 并发没测,官方和社区都说这条路径并发不行。
- 识图没启用。模型本身是多模态,repo 另发 907 MB 的 mmproj,引擎 0.1.52 也有
--vision,但官方把 gfx906 的图片功能列为未做,/health仍是images: false。没启用的能力不写进成绩。 - 层切分只有 27 和 21 两个值,没穷举。
收尾
第一轮把机器装起来,54 tok/s。第二轮发现开关默认是关的,65。第三轮把剩下的试完,参数到顶、窗口定死、三条外部路线全部判负,于是换了个模型,跑通、跑对、跑快,然后决定不换。
最后那个决定不靠速度。q36 的 98.8 是我这台机器上出现过的最快数字,它只在 32K 窗口里成立。这台机器真正的瓶颈在窗口乘复用,不在算力。
项目地址:Niko1221/Strata
分支:rpcribari: int6
q36 实验归档:strata-research/q36-experiment/(803 行移植 patch 加全部日志)