@xiaote 你怎么不回复了?
T
Tony Yun
@Tony Yun
-
我越来越觉得AI大模型就是一个X-large版的Stackoverflow -
我越来越觉得AI大模型就是一个X-large版的Stackoverflow -
我越来越觉得AI大模型就是一个X-large版的Stackoverflow表面看上去 什么都能干,什么问题都能接住;
可实际体验下来,回答的质量几乎没有统一的质量保证。
还是要靠人力核对,验证,调修。最后就变成了一个更好使用体验的stackoverlow。
给愿意学习的人赋能了一下,缩短了学习的时间。但是并非任何想法都能在上面找到答案;
最终还是靠人的水平/能力 确保产品的质量。大部分人来地球就是吃吃喝喝的,没有那么多精力学习;
愿意学习的精力也有限;愿意玩的又很picky 普通AI的产品没人愿意浪费时间。这一波AI发展要是放缓了,这X-large版的Stackoverlow的感觉就更明显了,感觉能把AI股票一波带崩了..
毕竟谁家没事自己deploy一个本地的stackoverlow 问问题学习啊。这市场还是太小了。
-
agent操作浏览器 还得是codex啊 -
agent操作浏览器 还得是codex啊试了好几种方案:
- dsh + browser use MCP: 各种崩溃 版本冲突 不得不放弃
- hermes + browser MCP: 稳定 但是无法看到agent在浏览器的操作
- hermes desktop: 可以同步看到agent打开的页面 但是drive_preview各种bug 一堆
- codex: 丝滑的浏览器操控体验 就是不能换模型
问一下你们是否也是一样的体验?
-
Qwen3.8-27b 跑了几个小时做的游戏 不忍直视 -
Qwen3.8-27b 跑了几个小时做的游戏 不忍直视 -
Qwen3.8-27b 跑了几个小时做的游戏 不忍直视 -
Qwen3.8-27b 跑了几个小时做的游戏 不忍直视kos-or 我的感觉是跟AI越聊越蠢 往往不如最开始的Oneshot的一致感 当然可能是我给AI拖后腿了
-
Qwen3.8-27b 跑了几个小时做的游戏 不忍直视我们的目标是做一个2d RPG游戏 要有地图和建筑贴图 参考口袋妖怪 每次把任务拆分一下 开发前 派一个subgent作为游戏策划讨论;开发完 派一个游戏试玩进行全方位测试反馈
-
Qwen3.8-27b 跑了几个小时做的游戏 不忍直视ninfer框架 decode 70~170 tok/s DSH里跑了几个小时 又是QA 又是策划 看着对话挺像回事 最后一玩 一整个浪费时间:
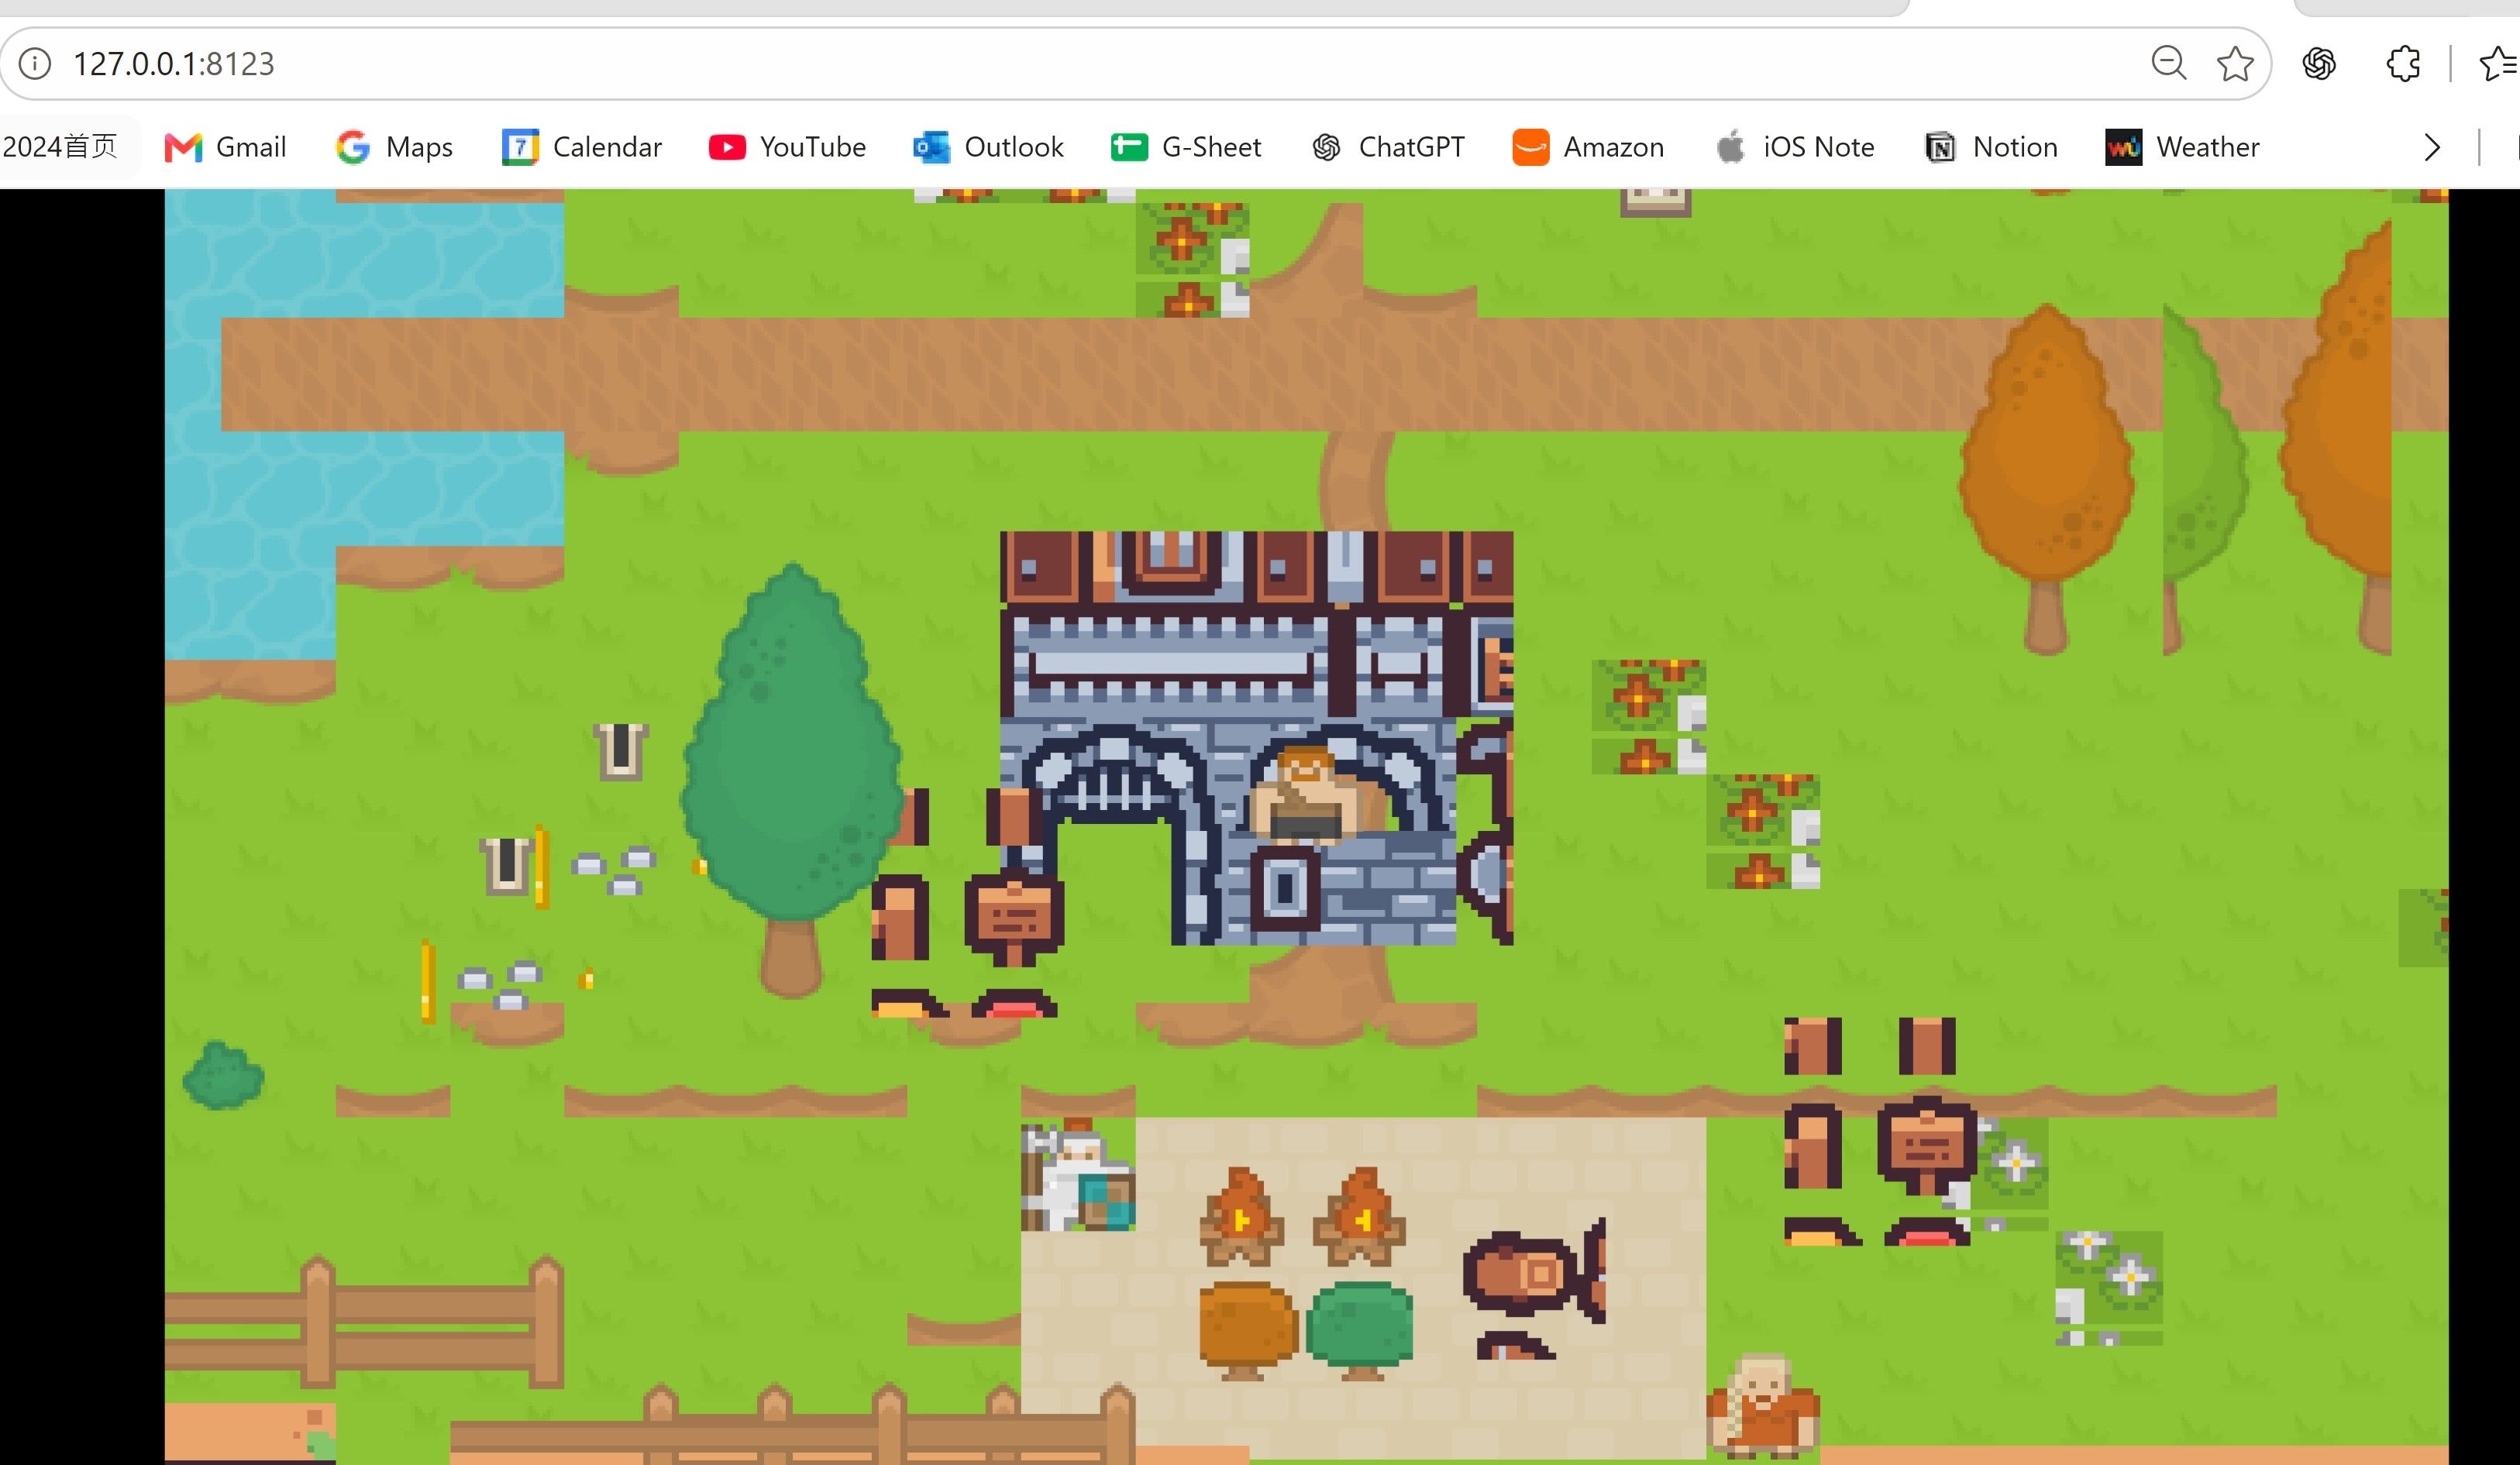
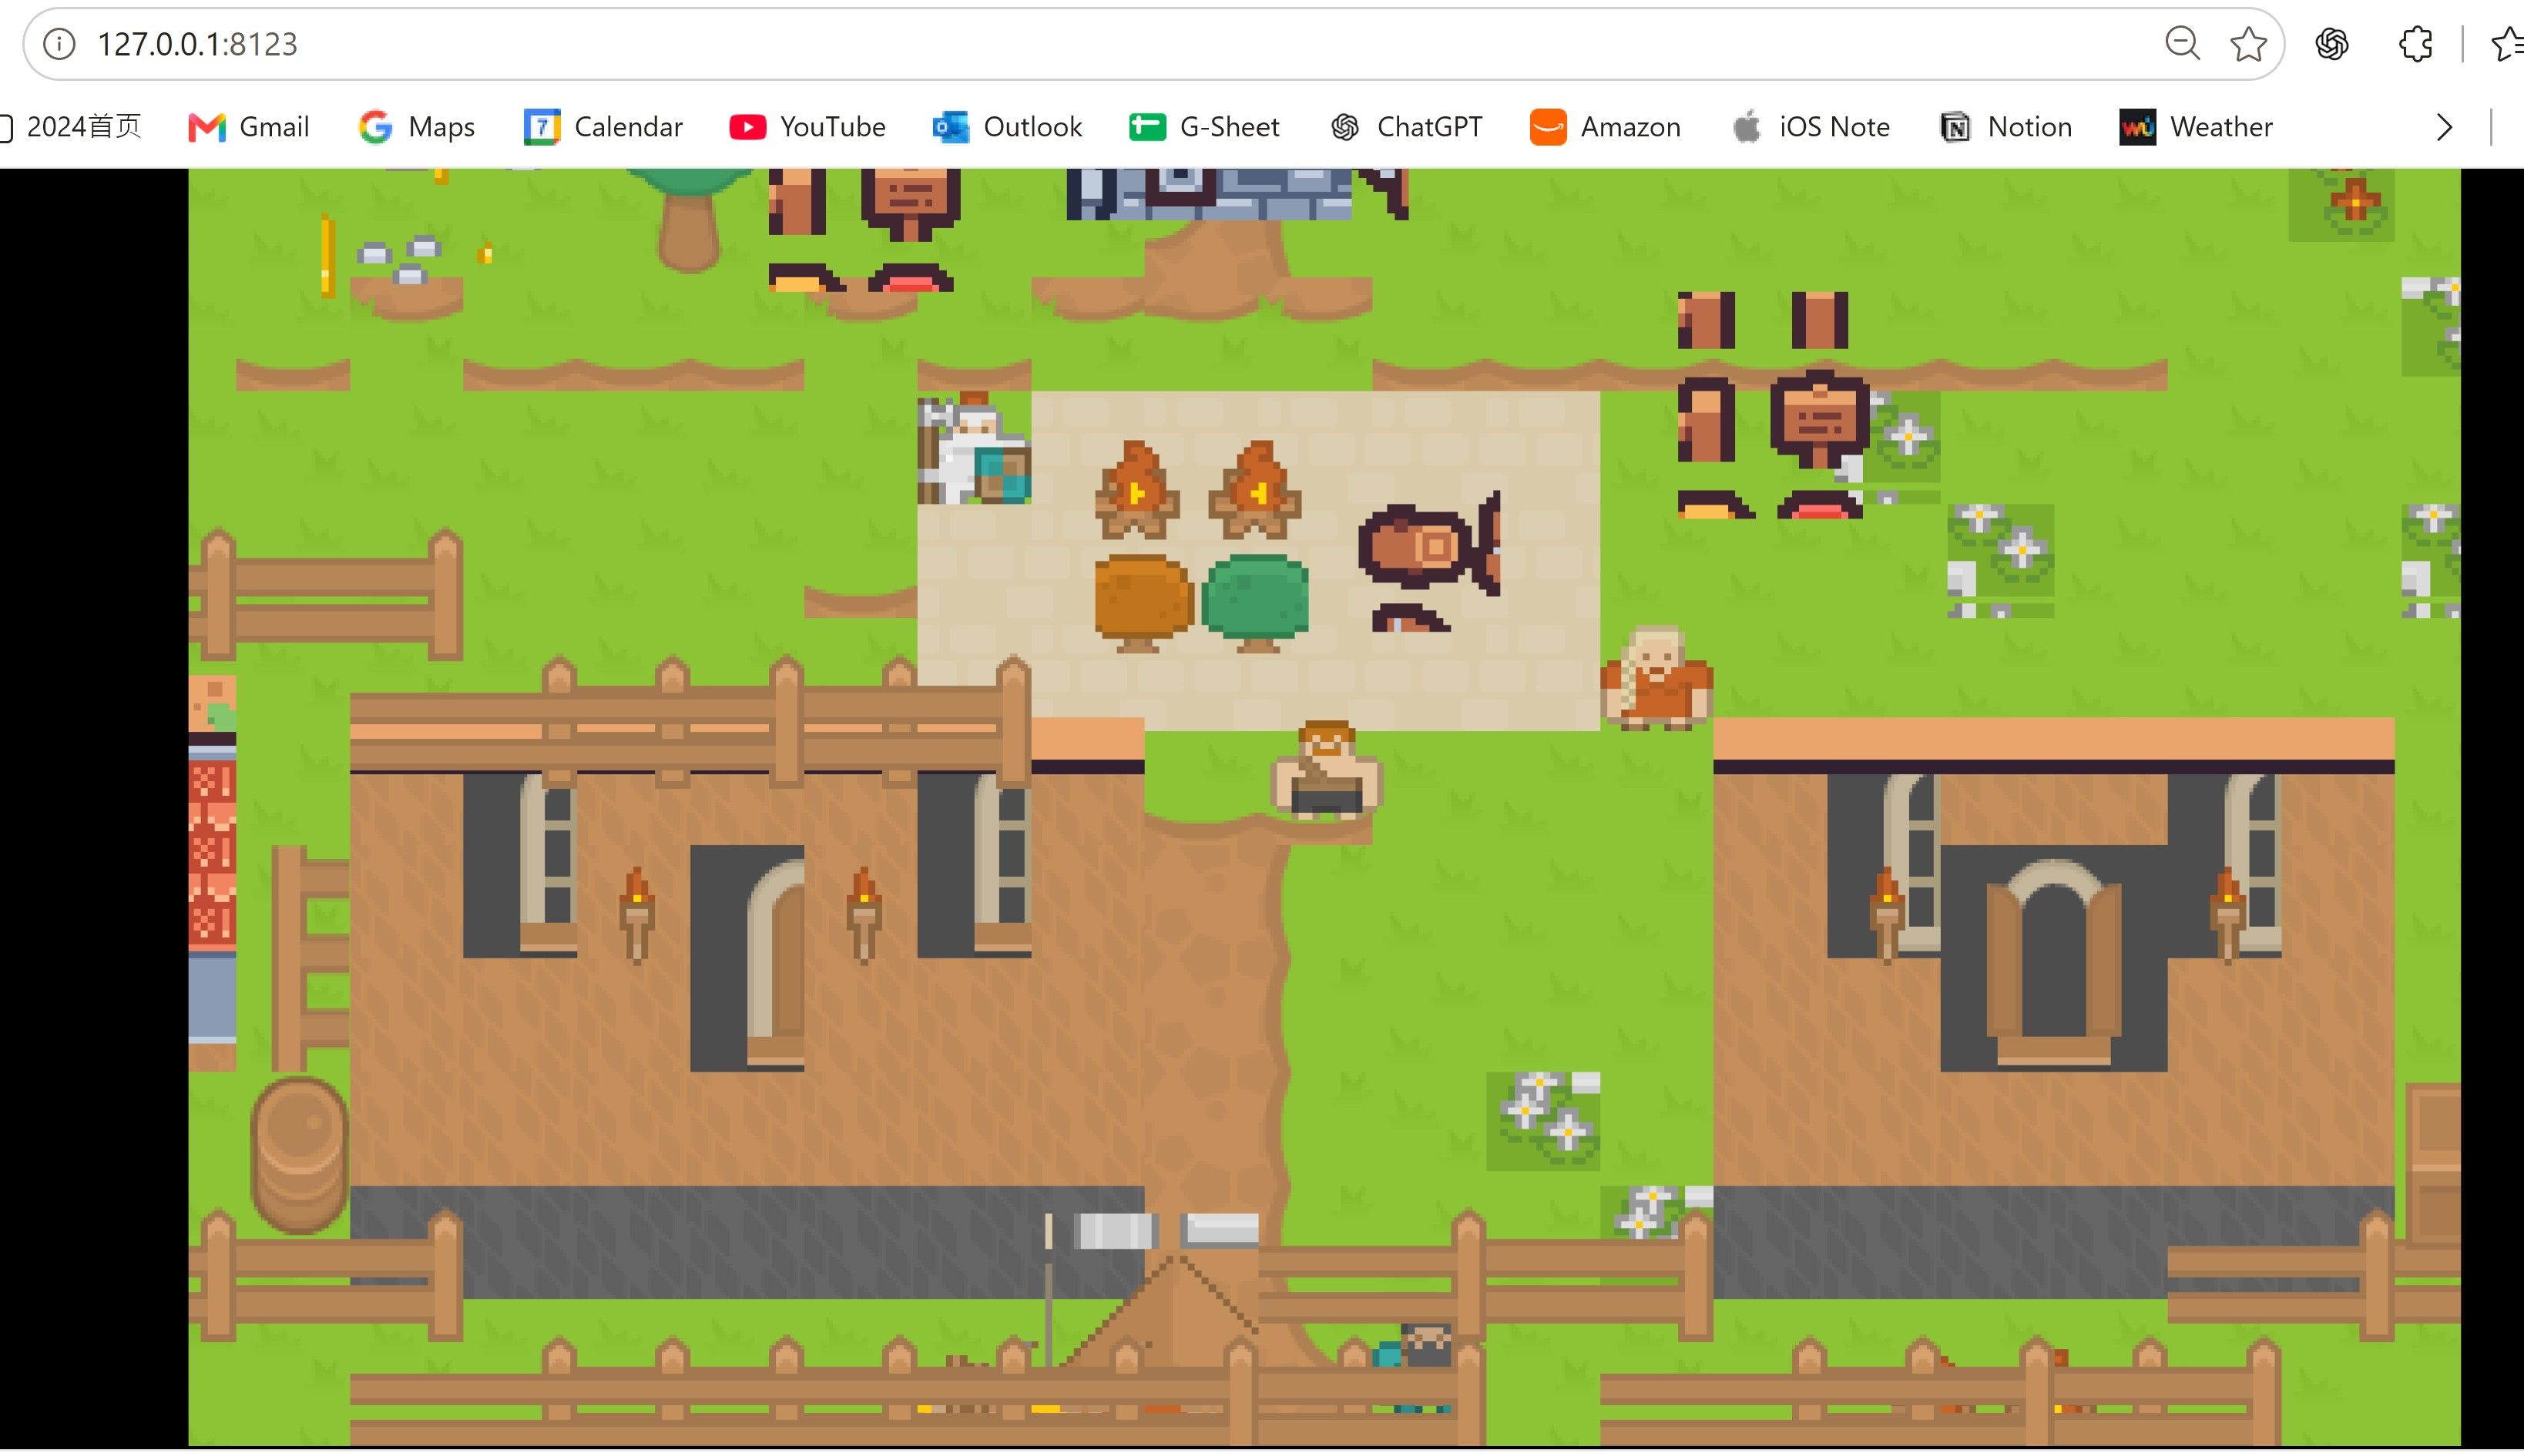
它还整了一个音乐 老大声 没法放上来听。
这就是本地27b的极限了吗?还是我harness和工具不到位

-
M5 Ultra的1.2T/s高带宽有多大用处?M芯片prefill速度慢如蜗牛 估计就N卡的1/10速度;我在想选配96GB到底能有多大生产力
-
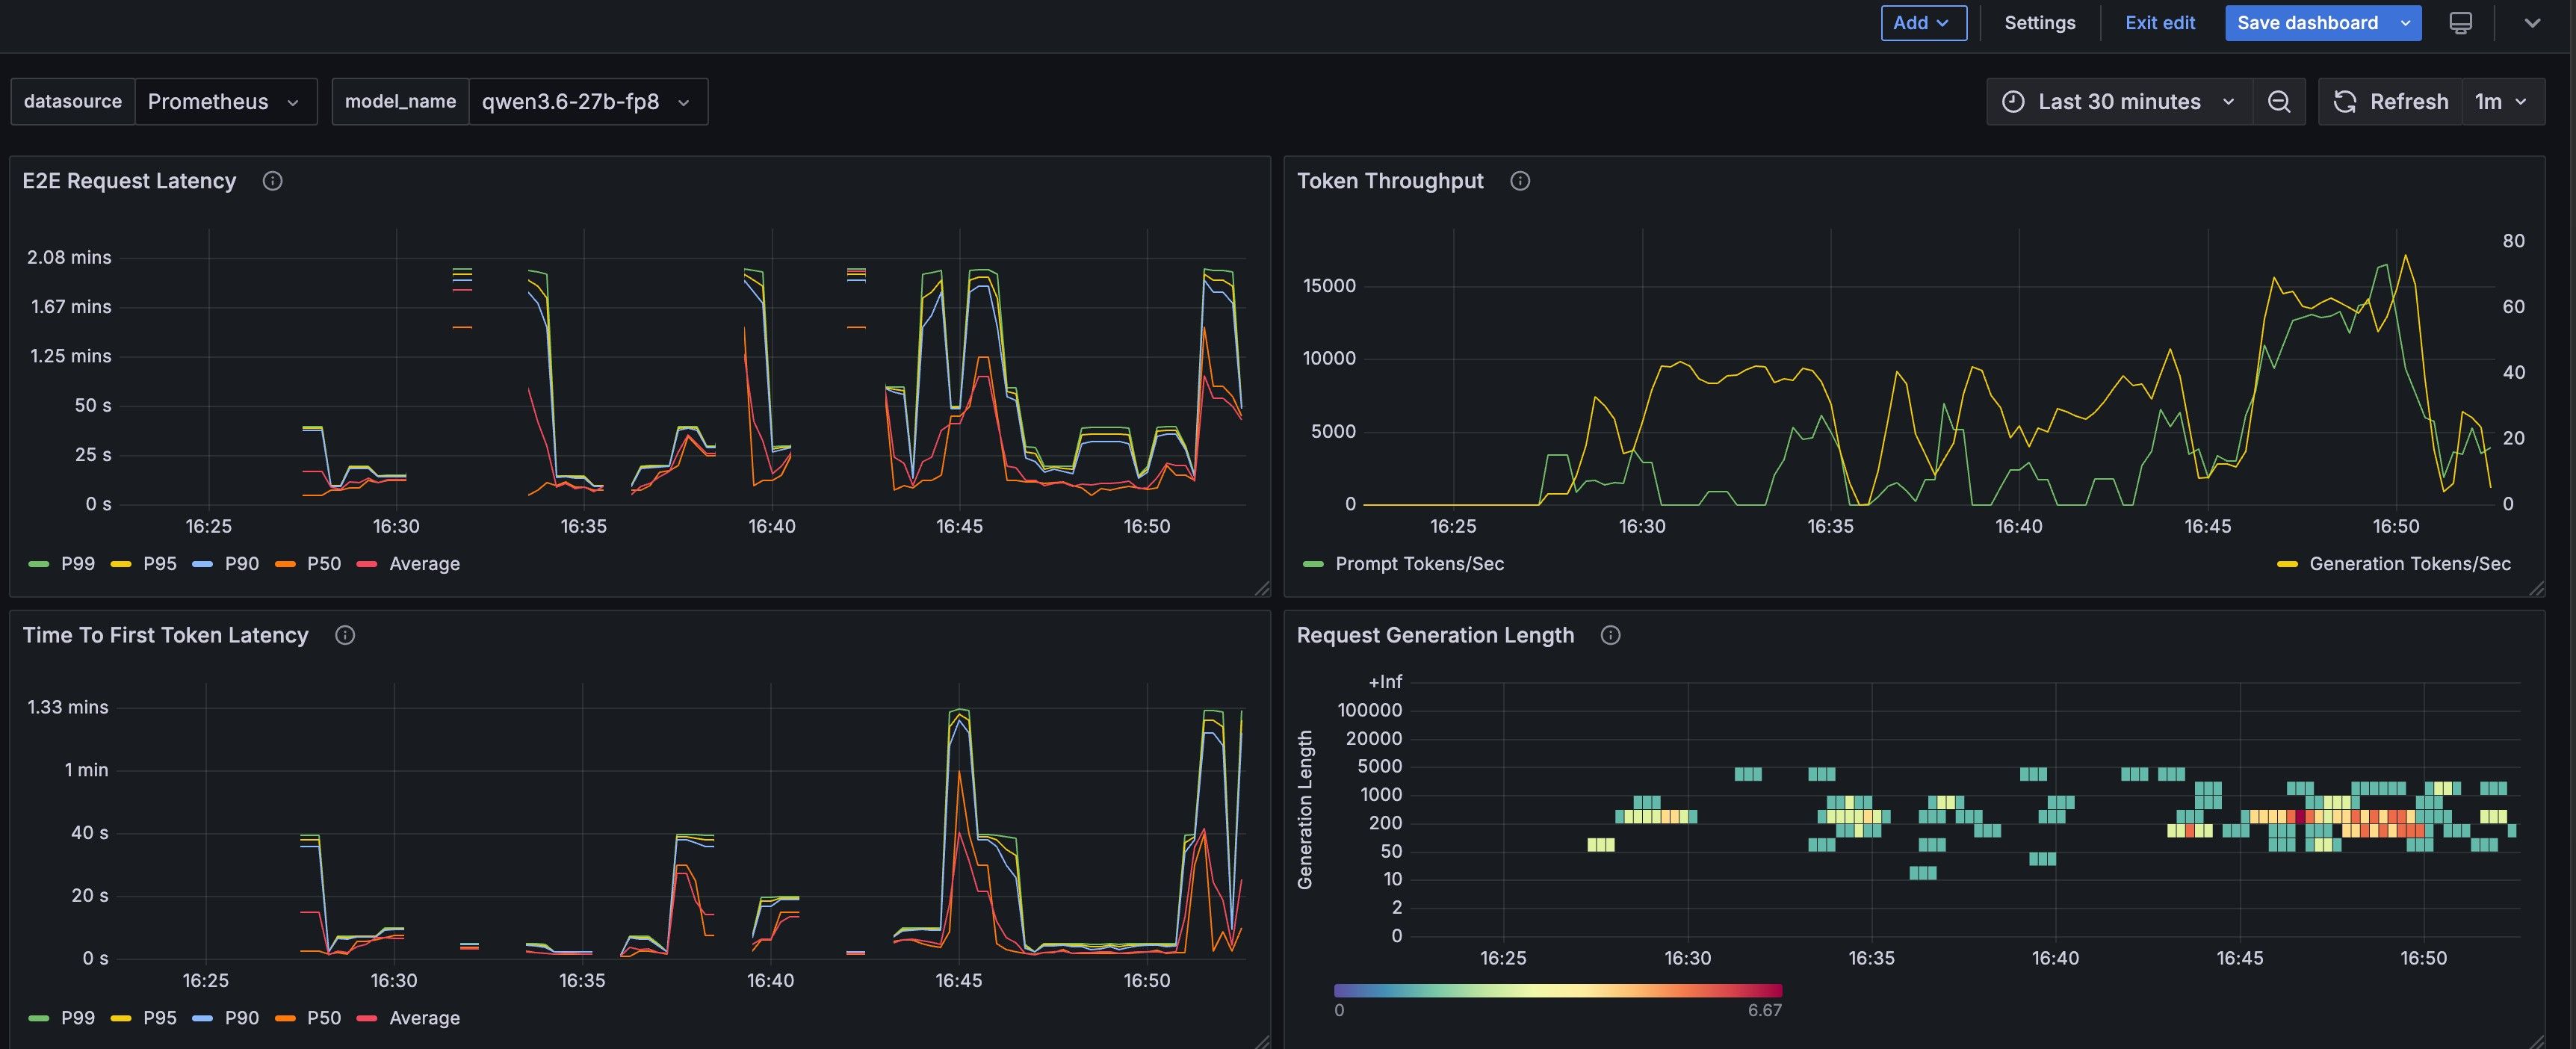
GPT建议我降低--max-token-len 这合理吗?@Tony-Wang 可以跑的,还行。我max model len也是放满262k的 还行:
-
GPT建议我降低--max-token-len 这合理吗? -
GPT建议我降低--max-token-len 这合理吗? -
GPT建议我降低--max-token-len 这合理吗?@566656661 L40S 48GB
-
GPT建议我降低--max-token-len 这合理吗?我现在的vllm启动命令:
--served-model-name qwen3.6-27b-fp8
--kv-cache-dtype fp8
--dtype auto
--max-model-len 262144
--gpu-memory-utilization 0.98
--max-num-seqs 32
--max-num-batched-tokens 4096
--trust-remote-code
--enable-auto-tool-choice
--tool-call-parser qwen3_coder
--reasoning-parser qwen3
--enable-prefix-caching
--compilation-config '{"cudagraph_capture_sizes": [1, 2, 4, 8]}'
--speculative-config '{"method": "mtp", "num_speculative_tokens": 3}'
--port 8000 --host 0.0.0.0但是经常超高cache,导致请求latency长达十几分钟。可是我不想限制max-model-len 这样最大上下文就没有260K了(gpt建议减半)。可130k上下文能干什么啊。
-
大家有什么让LLM 24小时不停工作的方案啊 -
大家有什么让LLM 24小时不停工作的方案啊@566656661 那感觉还是deepseek v4 pro完全够用了 也用不了几块钱
-
Qwen3.6 27b FP8 260K CTX - 准备放弃了这正常thinking就老长了 叠加20tok/s 的吞吐慢如蜗牛。关了thinking直接降智,回答洗车店问题就整不对了。
用的L40S GPU,号称有FP8 tensor core,可没有任何感觉,跟用Q8感觉没有区别。
就这速度让agent干活我得等冒烟了。又没有特别好的工程方法让他们自己干活。 让它干一天估计不如deepV4Pro干一小时。