
你的是乌班图,我的也是。
我就把这个帖子直接扔给后面死,他就帮我改好了
然后他测了个测试报告。
具体什么原理我不知道
但是如果没有论坛这样的帖子。我们怎么能享受到这种操作业的福利呢
楼主碰到的问题是和我一模一样的。我呢,就让 Hermes 去修理它。Hermes 读了源码以后呢,就改掉了这个 64K 预留。强行的改的代码。 然后它也提醒我,每一次升级也要重新再补一次补丁。
总之,现在的 DSH 在上下文的剪枝方面。还有压缩方面是做的不是很好。本来就干脆把系统的压缩全给关了,用那个 10 亿上下文插件来替代.这样子基本上就解决了所有问题。
你的情况和我几乎一模一样,而且我也是自建本地 VLLM。
我原来有好多个 profile。有维护的 有股票的 有写作的 还有一个是专门做音频视频流的。
光是维护这么多 Profile,我就已经受不了了。 这些构构架之间,它不是由一个统软件总体调度,而是由你这些提示词和一些人格设置和一些记忆库来维护的。 总体来说,等同于手搓了一个管理体系。
经过了一两个月的使用,我现在是放弃了。
我的 Hermes 基本上用法和老特是一样的。仅仅是部署在服务器上的 hermes ,用于服务器本身的维护,因为它稳定。
然后我现在主力工具全部 已经搬到 DSH 里面了。
一开始 DSH 各种不顺。 直到我装了一个腾讯的MemoryeDB. 的 dsh 简化版本. 这个插件呢,需要向量数据库.我本地是 3090 24G, 安装了 vllm 跑千文 3.8 27b 还有 ollma 跑一个几百兆的最小号的 104 维的向量数据库
从此以后, dsh 里任何的聊天记录,都能瞬间找到. 还算勉强能用.
总结:我也是 5 马走过来的,现在就 不纠结聊天了
就开几个聊天.1 个管 系统维护, 1个文档, 1 个管写日记随笔,, 再开了一个 dsh im 手机入口.
最重要的股票 方面.我呢就有好多个项目. 但是,项目里面 需要系统配合的,也随时可以 口述 要求改系统, 都没有问题
hermes 需要多profile 的, 被我用 d'sh +向量历史库,解决了,有全能助理的感觉了!
腾讯的产品 能用,谈不上好用. 但人家为了用户数,给的多. 合理!
字节的好用,但妥妥的先养熟,再收费,人家敢收就是有自信!!!
但是我一个都不选.我自建算力,自己升级 hermes,
用 dsh 培养出一个贾维斯,
谢谢.dsh 升级很容易升一堆 的坑.
特别是用本地 vllm 的.
主要是插件各种矛盾
3090单卡
我之前呢是觉得 3090 单卡是不可能有生产力的,所以一直是有卡,从来没有用过。本地部署
直到 DSH 出来以后,我更加坚信本地 VLLM 没有任何意义。
直到我把https://github.com/syv-ai/qwen38-27b-rtx3090
这个链接丢给 DSH,然后所有的事情我都没做。他帮我弄出来一个。|
150k 60t/s 已经稳定地跑了几天了,好像 DSH 也能用。中间所有的坑,全都碰到了。
比如说打循环,比如说 call tool 卡了.但是直接都是在 DSH区里面切换成 Deepseek 在线模型以后让它自己处理都搞定
好像中间有那么一两次没搞定,我就DSH让他来看这个论坛具体他怎么搞定的不知道,但是大概花了十来块钱吧,他就 OK 了。
纠结电费的。可以不用:华南 x99 +e 2685 +3090
我的方案是,淘宝,拼多多,买一个 pci 的开机卡,然后把文档发给 herems。做一个开机就好了。
我的 hermes 默认用 deepseek。模型可以随时切换到本地,用完切换回 deepseek 就好了,顺便让 herems 把服务器关闭。
一切都可以在 hermes 的管理下,不需要人去动。
这么用还解决一个服务器噪音问题。
同配置。我只不过是单卡。主板带的 vga 没有集成显卡的。自然也不会点亮主板输出。这个坑我没踩。
除非是惠普的服务器主板带远程管理的可以不需要核显。
总之,单 3090 一点都不好用。看到了 github 双 3090 那才是生产力。
不建议去买任何没有保险的卡,未来 4 年的保障,怎么也值 1000 元。当然,如果是学习就可以买,入门后这个卡一定是跑小任务玩。我就是京东 6399 买的 4 年保的。说实在也是赌,毕竟不是官方旗舰店。
而且 24g就是拿来练手的,理论上 5500 可以收到 1 手带购买凭证,纯粹玩游戏,没有挖过矿的 卡,而且是风扇卡才能值得入手,这样,直接解决了家用噪音问题。
其实,新手 24g 反而不是个好开始,真正值得练手卡是 32g 4080s。
尽量争取上好的啊。我这个半个月 3090 24g 真的好累。
没有任何必要。本来就不懂,让 hermes 不停烧 token 调试服务器才勉强跑起来。
我同时在 Docker 里布置了两个模型,一个是通过 llama 跑的 3.5。一个是vllm跑老板哥们兄弟强烈推荐的3.6 27b 4b量化稠密。都具有生产力。
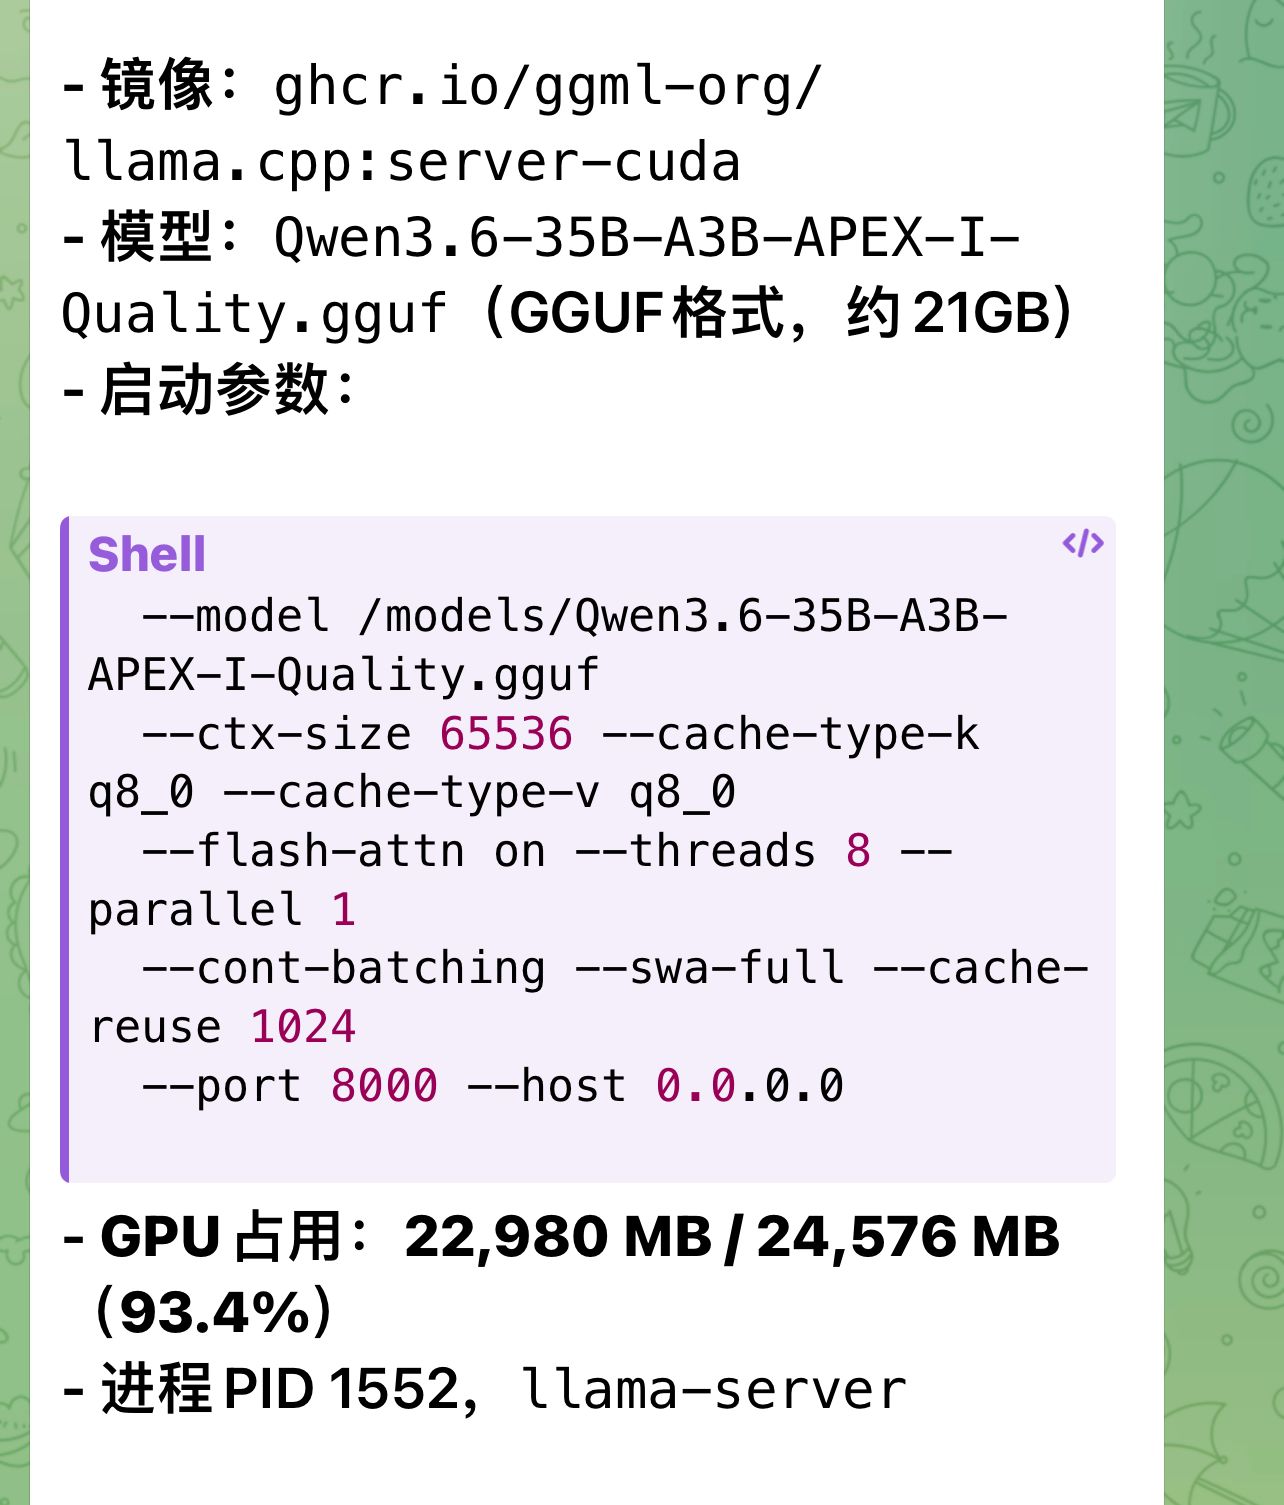
完全是 Hermes 自己去下载了一个 Docker,启动了一个千问 3.5 模型。这是启动参数。
是的,刚才查到的就是 8010 (llama) 的日志。
根据最新的数据,它的运行速度非常稳,且符合你的直观感受:
为什么“刚才跑了好久”?
日志里显示,上一次处理了一次 8192 Token(大约 6000 多字)的长输出,耗时 79 秒。
这就是你觉得“跑了好久”的原因——它正在认真生成长篇内容。
虽然时间长,但速度一直稳定在 100 TPS 以上,并没有卡顿。
结论:
8010 目前处于最佳状态,既聪明(35B 模型)又够用(100 TPS),完全不需要切到 8020 去。就让它这么跑着吧。
真的和老板说的几乎接近,我从 Deepseek 切换回 本地千问模型除了感觉,盯着看是慢一点。但是用来跑 Hemes 是没有太多感知的,因为它后台就完成任务。慢点,快点。并不重要,完成的效果一样就可以了
如果想买相同配置。所有的问题我都可以回答。
折腾机器的时候,有几个感触。
DDR4 价格还是太贵了,建议还是买 DDR3 的主板。我这里刚好有人有这个 DDR4 的主板,本地收的。
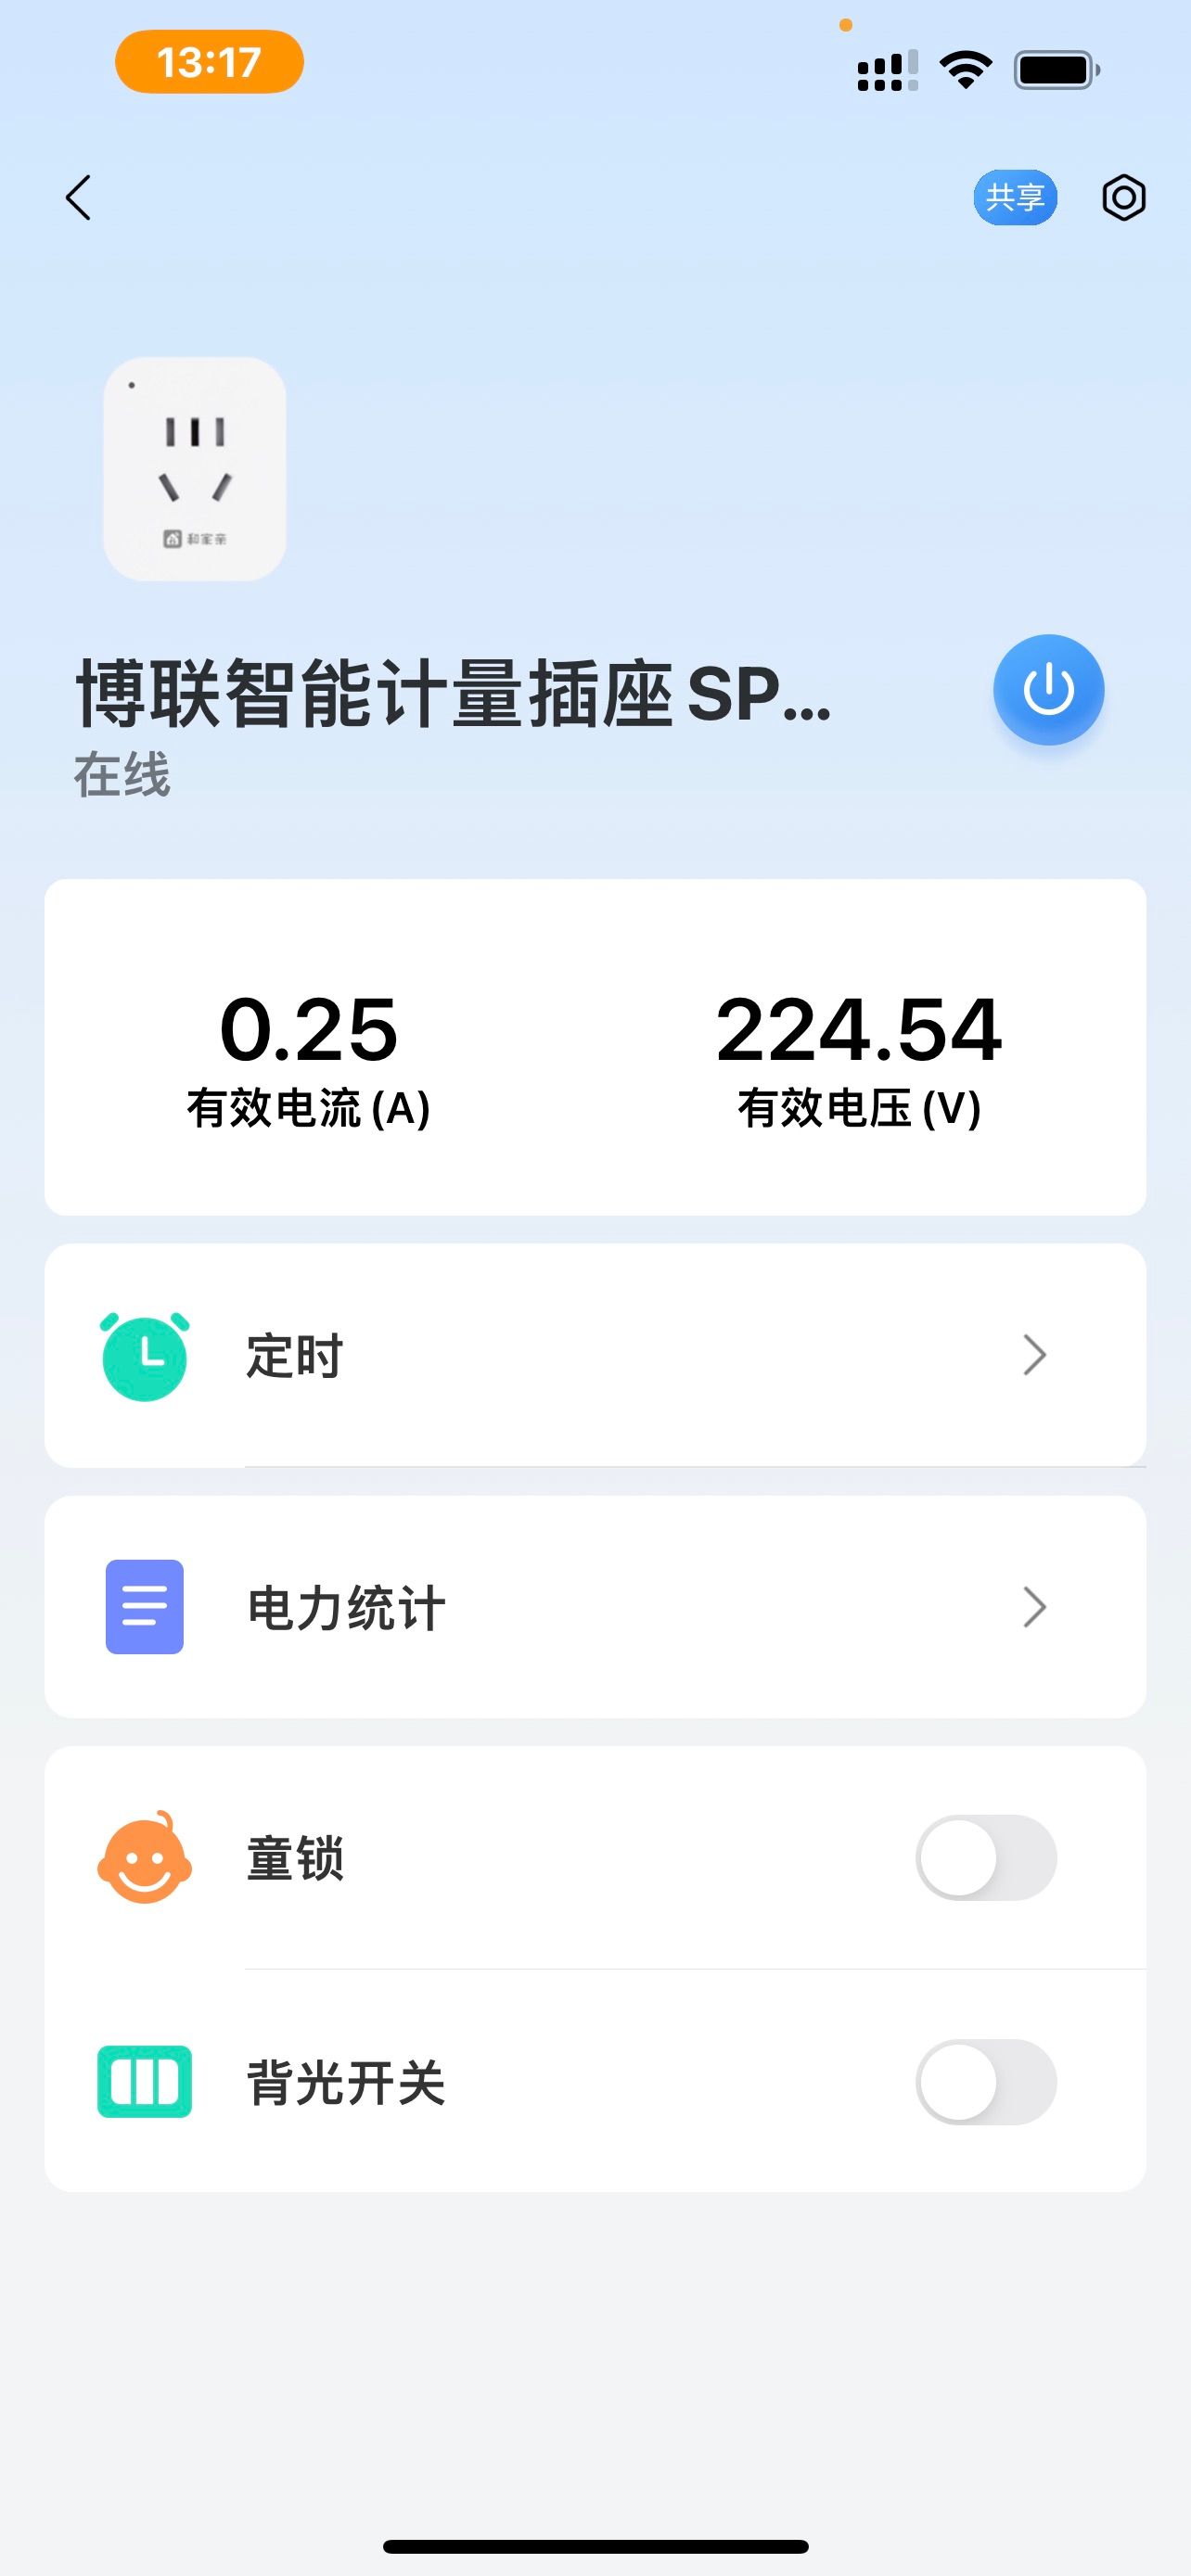
能耗,家用智能插座显示,待机的时候电流是0.25 ,满载1.94 。大概就是 60~70 瓦的待机,满载功率就是 440 瓦,很恒定。
涡轮风扇的噪音那是有的啊,我用 iPhone 手机的去测试,最靠近风扇的时候有 90 分贝,离远点也有 60 分贝,离开两米远。才能够勉强地接受它,坐在旁边是受不了的,一定要把它放在一个密封的柜子里面,或者是放在远一点的地方。
我把论锤者所有的视频都仔仔细细看了个遍,然后严格按照配置推荐,买的配置如下。
x99华南 2680 cpu 套装188 小主板
32gb ddr4内存 587
3090 京东买的6399
其他配件都是利旧
振华850电源 原价320全日系,注意课代表点题,老板说,电源一定要买好的,一定要用 10 年以上。
机箱先马静音,实测对涡轮无静音效果。所以老板说,一定要买个大机箱,未来会更好。
ssd 爱国者2tb ssd pt7000,放在这个机器被降速为4500m了。
本来不想装一台新机器的,哪想看中了一句话,就是不就是花钱?买了一个显卡坞吗?
立马决定买了一个新机。
系统是 Ubuntu 22,就开始了我的折腾,全部都是用 Hermes。全程没有自己打过一句指令,所以我现在折腾的效果。我自己都不知道。
总共从认识这个论坛到现在折腾,我的成就感爆棚,因为我什么都不知道。
我求助的是论坛里高手,真正来指引一下我们这样的小白怎么去真正的去了学习,入门。而不是完全靠着 Hermes。
你这是开了我的脑洞。音乐我玩的溜啊。至少可以拿来做个自动伴奏不错的。另外随便混成一个音乐人,也行啊。
5090 好机器。我们都是diy。严格按照lcz老师的。x99 洋垃圾 2666 32g ddr3内存,1000w电源,23090配置。
现在只买了1个3090,看后来到底是2还是 另配一个4080s
只能玩这么多了。
运行
python -m sglang.launch_server
--model-path ./Qwen3.6-35B-A3B-APEX-I-Quality.gguf
--model-format gguf
--context-length 6144
--kv-cache-dtype int8
--mem-fraction-static 0.92
--chunked-prefill-enabled
--enable-radix-cache
--chat-template qwen3
--extra-body '{"enable_thinking": false}'
--port 8000
每个参数的作用和为什么这么设
表格
参数 作用 为什么设这个值
--model-path ./xxx.gguf 模型文件路径 替换成你下载的 22.08GB 文件的实际路径
--model-format gguf 指定模型格式 告诉 SGLang 这是 GGUF 格式的模型
--context-length 6144 最大上下文长度 24G 显卡的黄金平衡点,再大就需要 offload 权重了
--kv-cache-dtype int8 KV 缓存精度 3090 最优选择,显存减半,速度不变
--mem-fraction-static 0.92 显存分配比例 给模型和 KV 缓存分配 92% 的显存(约 22.08GB),刚好放下你的模型 + 6K INT8 KV 缓存
--chunked-prefill-enabled 分块预填充 避免长 prompt 一次性吃光显存,提升稳定性
--enable-radix-cache 启用 Radix 缓存 多轮对话中自动复用历史 KV 缓存,速度提升 30% 以上
--chat-template qwen3 聊天模板 正
谢谢!!!
我以为论坛都是大佬。原来云。云。云。
下次看清楚了。
必须是实测,分享之类的
这 4 个参数 SGLang 0.5.11 实际安装版识别不到:
| 指南写的参数 | SGLang 实际是否支持 |
|:---|:---|
| --model-format gguf | ❌ 没有这个参数(应改用 --load-format gguf) |
| --chunked-prefill-enabled | ❌ 没有(应改用 --chunked-prefill-size 512) |
| --enable-radix-cache | ❌ 没有(默认已开,可调 --radix-eviction-policy) |
| --extra-body | ❌ 不是启动参数(这是 API 请求体参数) |

那篇表格分析是理论推断,但实际 SGLang 0.5.11 装上去跑就是报这些错。要不要把所有参数改成 SGLang 实际支持的,再试一次看能不能过最后那一关?
╰────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
抄作业都发现sglang根本没有你说的参数。请问sglang是那个版本??