跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
YDMY

YDM

@YDM
体面乡绅 硕果累累
取消关注 关注
关于
帖子
60
主题
2
分享
0
群组
2
粉丝
2
关注
1

帖子

最新 最佳 有争议的

  • Hermes Agent 架構實踐:極速直出、物理驗收防幻覺與徹底消滅逾時的深度重構(9/20更新)
    YDMY YDM
    AI Agent hermes

    發布板塊:Hermes Agent
    作者:YDM (昌哥) / Hermes 女秘書
    適配硬體:雙 NVIDIA RTX 5070 Ti 16GB (32GB VRAM) + Windows 10 實體機(跑 Qwen llama.cpp)+ VirtualBox Ubuntu 26.04 VM(跑 Hermes Agent)
    主力模型:100% 本地離線運行 Qwen3.8 27B (UD-Q5_K_XL 量化),零雲端 API 依賴
    核心成果:全域回歸測試 205/205 項 100% PASS,不可繞過實體信任架構、7 大官方能力庫與紅隊滲透矩陣 100% 驗證通過
    核心宗旨:不外掛額外 Agent,直接對 Hermes 本體進行八層原生架構升級!
    文章定位:本文聚焦架構思路、工程實踐與經驗沉澱,分享設計決策與踩坑過程。
    獨家發布聲明:本文與專案僅在 抡锤者 論壇 (https://lcz.me/) 與 GitHub 官方倉庫 正式發布,轉載請署名及出處。


    📢 2026-09-20 最新重大升級!Hermes Hybrid Core v1.3.1 (Canonical Trust Architecture)

    這套在本地雙 5070 Ti 實戰驗證的自主架構,開源版本現已正式推進至 v1.3.1!我們將原本的防護機制進一步昇華為密碼學級的**「不可繞過實體信任架構(Canonical Trust Architecture)」**,並已完成第三方外部資安審計 12 項安全隱患之 100% 閉環:

    👉 GitHub 開源倉庫傳送門:https://github.com

    🚀 核心躍升亮點(v1.3.1 關鍵突破):

    1. 🏛️ Agent 零私鑰原則與 UDS 0660 權威 Broker:
      • Agent 執行環境記憶體內 100% 零私鑰,私鑰僅存於獨立的 Broker/CAS 守護進程,杜絕任何被 Prompt 誘騙盜取密鑰的可能。
    2. 🛡️ 三大不可繞過實體閘門(Fail-Closed 剛性防禦):
      • ProcessGate:強制檢驗 bwrap >= 0.11.0 沙盒,缺失沙盒一律硬拒絕(Fail-Closed),絕不退回宿主機裸跑;tmpfs 遮蔽 /root、/home、/etc/shadow 等敏感路徑。
      • NetworkGate:實裝 IP Pinning,直連已校驗合規之實體 IP 並鎖定 Host 標頭,物理免疫 DNS Rebinding TOCTOU 攻擊;出境敏感標頭(Authorization / Token)自動脫敏抹除。
      • StorageGate:強制採開啟後之描述符 os.fstat(fd) 現場校驗,徹底杜絕符號連結競爭(Symlink Race)。
    3. 🧪 全自動化測試倍增至 205/205 項 PASS(100% 綠燈):
      • 包含全域單元測試、紅隊對抗性滲透測試矩陣(AT-01~10)與公開倉無菌安全掃描全數通過。
    4. ⚡ 延續成熟加速與治理底座:
      • 保持極速響應(< 5ms 語意快取直出、< 50ms 骨架流式秒回、4KB 雙向保真截斷節省 94% KV Cache)與 CAP-001~007 官方外掛能力庫。

    ⏱️ 30 秒看懂這篇文章

    如果你用 Hermes Agent 跑過複雜任務,大概都遇過這四個痛點——本文用八層原生架構逐一應對:

    痛點 現場症狀 Hybrid v1.3.1 解決方案 成果
    🐌 問答延遲與 Tool 冗餘 每輪加載全部 Tool Schema,簡單問題也要等 2.5 秒 Fast Path 分流 + 語意快取:L0 移除 Tool、高頻直接命中 分流判定 0.14 ms / 快取直出 < 5 ms
    🎭 驗收依賴模型主觀幻覺 模型自稱「檔案已寫入」,實體檔案根本不存在 Objective Verifier:Exit Code + 檔案大小 + AST 物理硬驗收 客觀檢驗,大幅降低假完工幻覺
    💀 16 輪逾時死局 反覆試錯 + 巨量 Log 把 Context 塞滿到 47k,最後 Request timed out Runtime Control v1:4KB 輸出裁剪 + 92% 資源優雅交付 大幅降低逾時中斷,維持 50+ t/s
    🔓 Agent 越獄與金鑰外洩 Prompt 誘騙盜取金鑰、沙盒降級裸跑、符號連結競爭 Canonical Trust 實體閘門:Agent 記憶體零私鑰,三閘門 Fail-Closed 硬阻斷 紅隊滲透 10/10 阻斷 / 資安審計 12 項零缺陷
    💾 歷史資料庫膨脹 舊版 FTS5 影子表重複儲存文字,state.db 破 1GB FTS5 External-Content:排除機器輸出 1.07 GB → 508.70 MB(-52.5%)

    其他核心成果:

    • ✅ 全自動回歸測試:全域整合 205/205 項測試 100% PASS,開源版 7 大官方能力與紅隊滲透矩陣全數通過
    • 🛡️ 對抗性安全防護:實測常見 13 種 Shell 繞過手法均成功攔截,高風險操作強制繁中審批
    • 📦 KV Cache 最佳化:動態限制工具回傳體積,維持本地 27B 穩定推論速度

    🏛️ 一、八層混合架構總覽

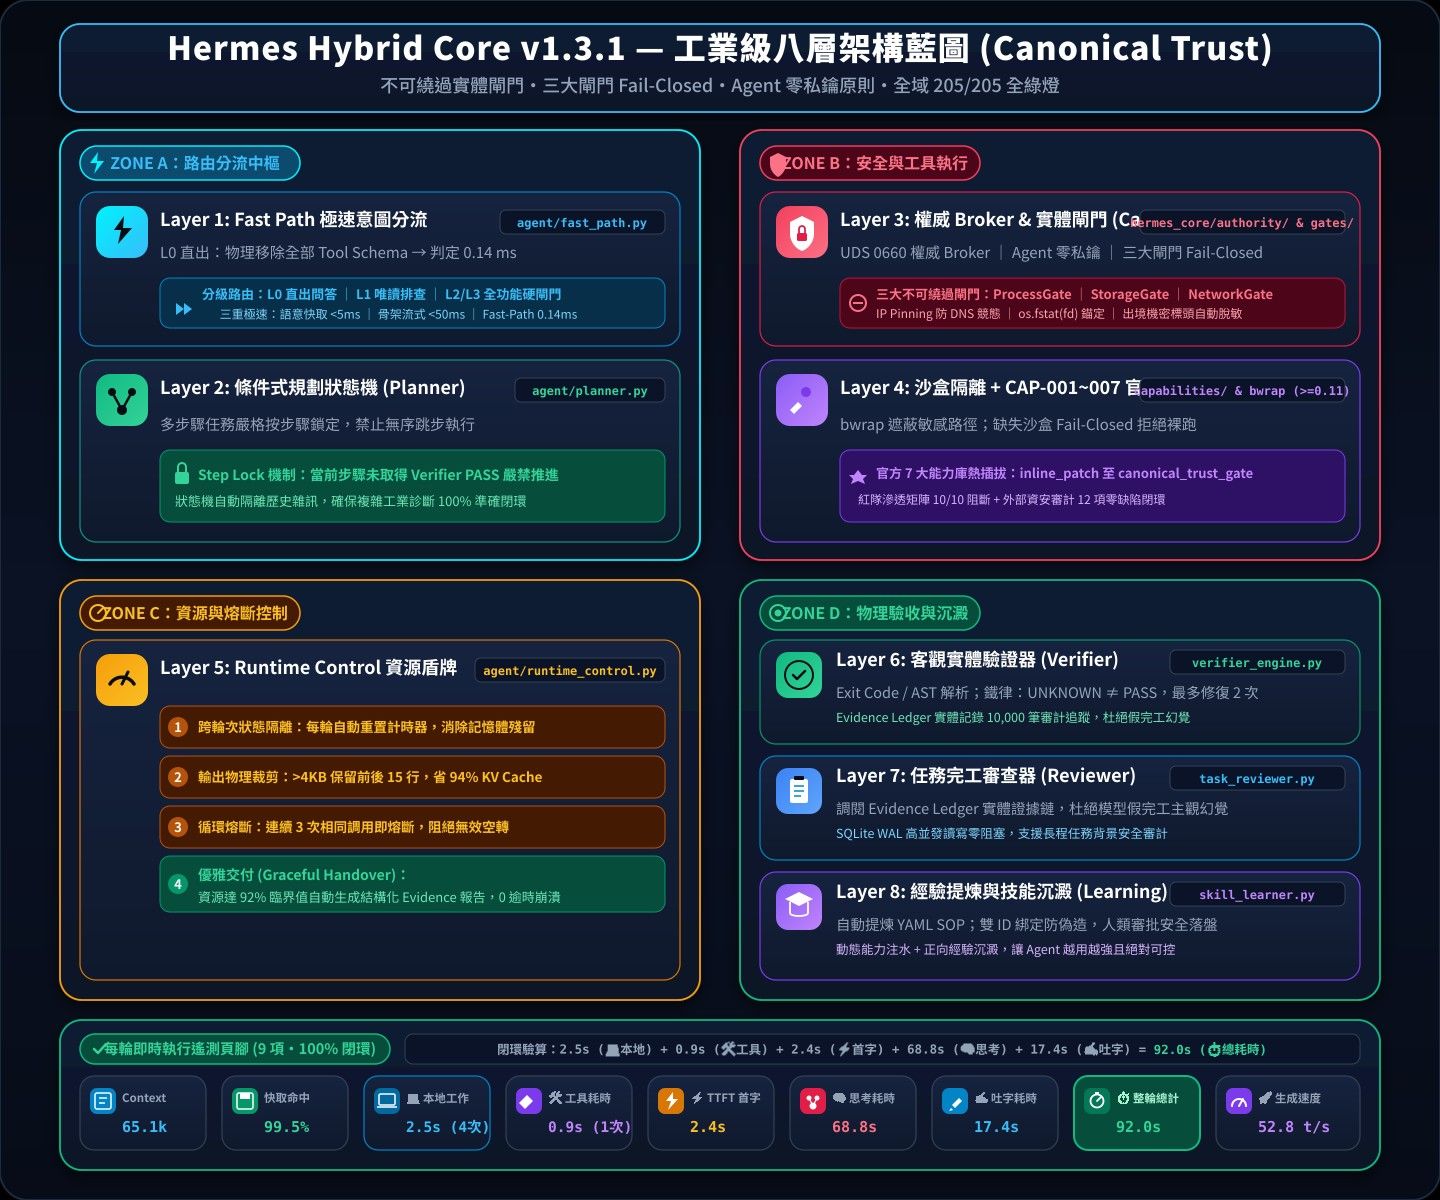
    整條執行資料流由上至下嚴格貫穿八層原生防線,每層各司其職、層層防禦:
    6f2d352c-e1e3-4d45-8cd1-378c5f5f9cdd-image.jpeg

    📌 八層架構重點導讀:

    • ⚡ 分流加速(1~2 層):L0 判定 0.14ms 極速直出;多步驟任務自動啟動條件式狀態機,Verifier 通過才推進下一步。
    • 🛡️ 安全與控制(3~5 層):HAOS 實體防繞過閘門 + 跨輪次狀態重置 + 上下文過載防護。
    • 🎯 物理驗收與沉澱(6~8 層):避免模型主觀幻覺,以 Exit Code / AST 客觀驗證;成功經驗自動提煉 YAML SOP,人類確認後落盤。

    📋 八層原生模組映射表

    層級 核心模組 實戰本機對應檔案 開源 SDK 提煉封裝 (hermes-hybrid-core) 核心職責與機制
    L1 Fast Path 極速分流 agent/fast_path.py agent/fast_path.py L0 問答物理剝除全部 Tool Schema,分流判定 0.14ms
    L2 條件式規劃狀態機 agent/planner.py capabilities/planner_recovery/ (CAP-002) 鎖定當前步驟,嚴禁跳步;Verifier PASS 後才推進
    L3 HAOS 安全閘門 agent/tool_executor.py haos/ (5.2 憲法) + hermes_core/security_filter.py 實測常見 13 種 Shell 繞過手法均有效攔截;高風險指令強制審批
    L4 實體工具執行 + 沙盒隔離 tools/ capabilities/sandboxed_mcp/ (CAP-006) 原生 Toolsets;沙盒適配隔離,有效防禦路徑穿越與逃逸
    L5 Runtime Control 資源盾牌 agent/runtime_control.py agent/runtime_control.py + hermes_core/ 跨輪狀態隔離 + 輸出 >4KB 裁剪 94% + 92% 優雅交付
    L6 客觀實體驗證器 agent/verifier_engine.py capabilities/inline_patch/ (CAP-001) + evidence_logger.py Exit Code / AST 解析;鐵律:UNKNOWN ≠ PASS,最多修復 2 次
    L7 任務完工審查器 agent/task_reviewer.py hermes_core/evidence_logger.py 調閱 Evidence Ledger 實體證據鏈,大幅減少模型自稱完工的幻覺
    L8 經驗提煉與技能沉澱 agent/skill_learner.py capabilities/extension_layer/ (CAP-004) 自動提煉 YAML SOP;雙 ID 綁定防偽造,人類審批落盤

    💡 開源模組映射與解耦說明(必讀):
    上表中「實戰本機」是當初我們在本地 Hermes Agent 本體硬改實裝時的檔案分佈;而在正式開源發布的 hermes-hybrid-core 倉庫中,我們將這八層架構進一步實施了**「工業級解耦」**:

    1. 將本體緊耦合的加速與防護邏輯,抽離為獨立的 hermes_core 統一 Python SDK(可直接 import hermes_core 獲得語意快取、連線池、熔斷器與安全治理)。
    2. 將 L2/L4/L6 等規劃、自我修復、沙盒防禦與實體信任閘門,提煉為 7 個獨立可熱插拔的 capabilities/(CAP-001~007 官方能力庫),各附帶 manifest.json 與 validator.py。
    3. 這使得社群朋友無論使用的是原版 Hermes,或是 LangChain / AutoGen / 自研 Python Agent,都能零摩擦直接外掛使用,不需改造整個主程式!

    ⚡ 二、六大核心升級模組拆解

    1️⃣ Fast Path 意圖分流 — 讓簡單問題 0.14ms 直出

    在 conversation_loop.py 進入點進行極輕量正則與特徵分析,分四級處理:

    • L0(直出問答):物理把 tools = [] 傳給模型,完全省去 Tool Schema → 推論延遲 0.142 ms
    • L1(唯讀排查):物理裁剪所有寫入/刪除工具,只留 read_file、search_files 等唯讀工具(預算:240s / 12 次)
    • L2 / L3(標準與高危):全開工具,並掛載安全硬閘門(預算:400s~480s / 16 次)
    # 核心判定邏輯示意(虛擬碼):
    def fast_path_route(user_msg: str) -> tuple[int, list]:
        if is_greeting_or_ack(user_msg) or (len(user_msg) < 20 and not has_tool_intent(user_msg)):
            return L0, []                      # 直出問答:物理剝離全部 Tool Schema
        if only_read_intent(user_msg):         # 僅含「查/看/搜尋」等唯讀意圖
            return L1, [read_file, search_files]
        if has_write_or_exec_intent(user_msg):
            return L2, ALL_TOOLS               # 掛載安全硬閘門
        return L3, ALL_TOOLS                   # 複雜任務:全開 + 規劃狀態機
    

    💡 關鍵思維:Tool Schema 是每輪 API 調用的固定成本。L0 把 tools = [] 直接傳給模型,不是「隱藏」而是「物理移除」,本地 27B 的首字判定開銷大幅下降。

    ⚠️ 延遲精準定義(避免誤解):0.14ms 是 Fast-Path 在 Python 層級執行意圖分析與動態剝離 Tool Schema 的本機代碼判定耗時(免去了每輪大模型加載全部工具定義的開銷,使首字延遲 TTFT 驟降);而模型實際生成文字的速度為 50+ tokens/s。若後續命中了 Semantic Cache 語意快取,則是真正由記憶體以 < 5ms 直出全文(零 GPU 算力負擔)。

    ⚙️ 實戰調校:延遲容忍門檻與 ReDoS 字典防護

    在後續的實戰調校與 v2.3 升級中,我們進一步針對分流機制做了兩項關鍵優化:

    1. 放寬延遲合格門檻至 < 50ms:原本門檻設得過於苛刻,實戰中本機磁碟暫態微抖動會讓判定耗時偶發微升,導致被誤判為「分流失敗」;放寬至 < 50ms 後有效吸收了系統抖動,提升判定穩定性。
    2. 重構為 $O(N)$ 詞組字典查找:原本中文意圖識別採用正則表達式,在遇到長篇混雜文字時存在回溯卡頓風險;重構為字典集合比對後完全不走正則回溯,具備 ReDoS 防護能力,避免長文字比對導致 CPU 飆高假死。

    2️⃣ Objective Verifier — 不聽模型說,只看物理證據

    工具執行後,嚴禁讓 LLM 自行猜測結果,由 Verifier 執行三道物理硬檢驗:

    1. OS Exit Code == 0
    2. 檔案存在且大小 > 0 bytes
    3. Python AST 語法檢查
    # 物理驗證判定流程示意(虛擬碼):
    def verify(tool_call, result) -> Verdict:
        if result.exit_code != 0:
            return FAIL("non-zero exit code")
        if tool_call.writes_file:
            if not os.path.isfile(target) or os.path.getsize(target) == 0:
                return FAIL("file missing or empty")   # 杜絕「假寫入」幻覺
        if target.endswith(".py"):
            try:
                ast.parse(source)
            except SyntaxError as e:
                return FAIL(f"AST syntax error: {e}")
        return PASS(evidence=collect_evidence(result))  # 證據記入 Evidence Ledger
    
    • 🛡️ 鐵律一:UNKNOWN ≠ PASS:證據不足一律視為未通過(Fail-Closed);客觀證據寫入 Evidence Ledger,資料庫強制 POSIX 0600 安全權限,啟用 SQLite WAL 模式並設有 10,000 筆上限自動滾動清理,兼顧審計留存與磁碟空間。
    • 🔄 鐵律二:有界修復機制:RepairLoopController 限制單一目標最多修復 2 次,超限立即 ESCALATE,杜絕無限迴圈。

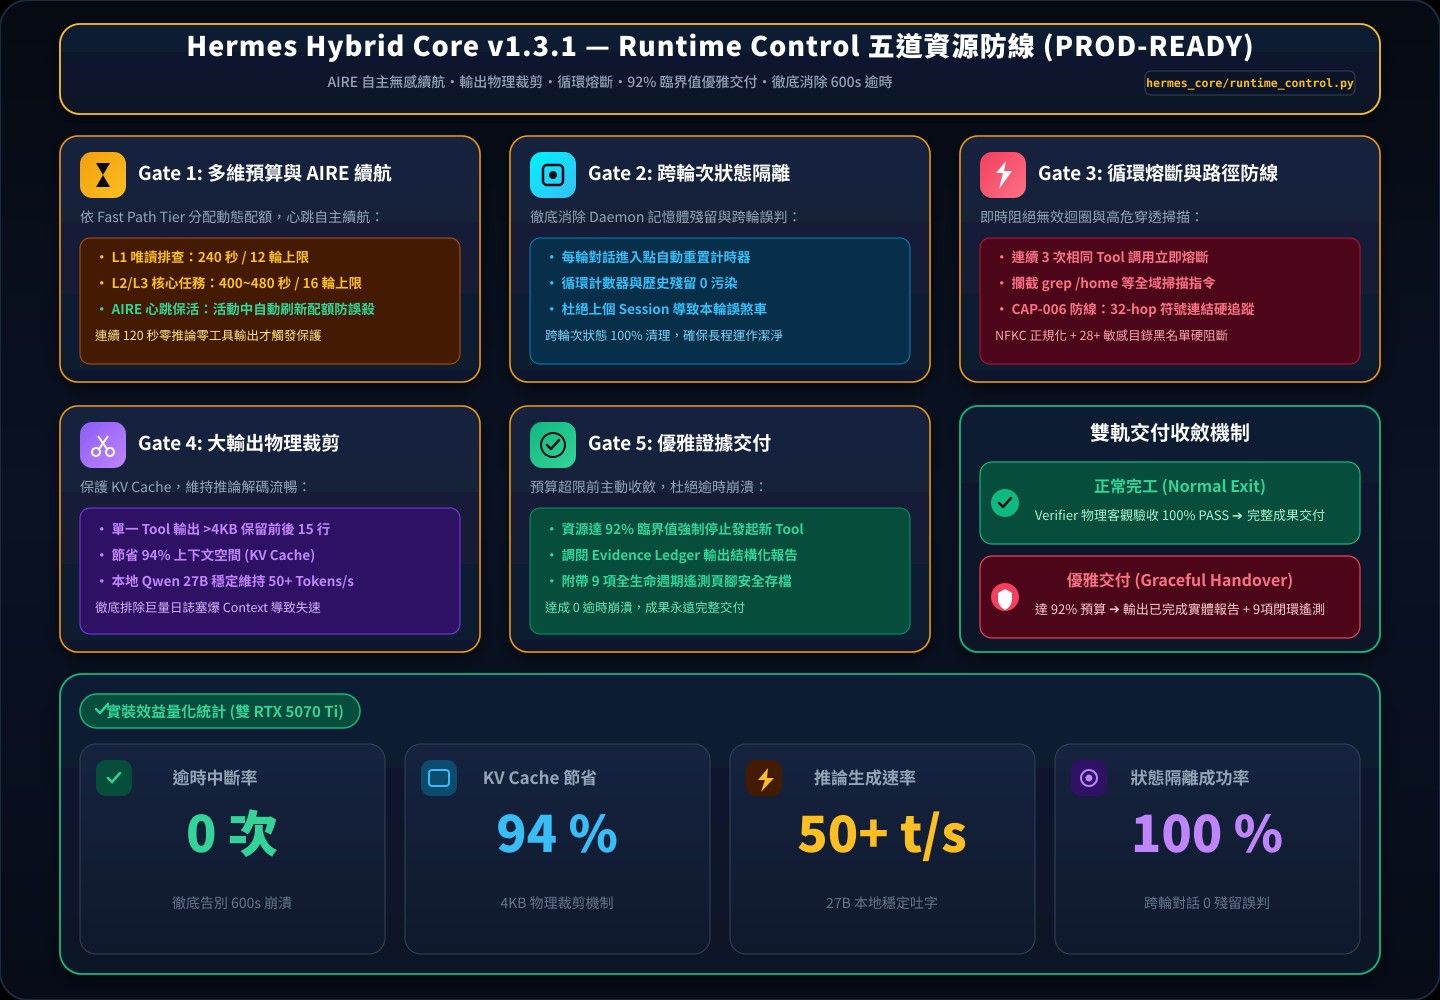
    3️⃣ Runtime Control — 五道防護降低逾時與狀態殘留風險 (PROD-READY)
    3c0b85b7-8d74-45ae-9189-e3bc1bd0de81-image.jpeg

    🛡️ 五道防護執行流程亮點:

    • 預防空轉:每輪執行前檢查時間與次數預算,並自動重置計時器消除記憶體殘留。
    • 物理裁剪:Tool 輸出 >4KB 自動前後保留 15 行,省 94% KV Cache 空間。
    • 優雅收斂:預算達 92% 自動交付實體 Evidence Ledger 報告,大幅降低長程任務 600s 逾時中斷率。
    1. 多維度預算閘門:依 Tier 設定時間與次數預算(L1: 240s / 12 次;L2: 400s / 16 次;L3: 480s / 16 次),精準覆蓋複雜工程任務
    2. 跨輪次狀態隔離(State Isolation):每輪對話進入點自動重置預算計時器與循環探測器,消除 Daemon 記憶體殘留誤判
    3. 循環與廣域搜尋熔斷:連續 3 次相同 Tool 調用立即熔斷;grep /home 這類廣域搜尋直接攔截
    4. 大輸出物理裁剪:單一 Tool 輸出 > 4KB 自動保留前後 15 行,節省 94% KV Cache,本地 Qwen 27B 維持 50+ t/s
    5. 優雅證據交付(Graceful Handover):資源達 92% 臨界值時嚴禁發起新 Tool,直接把已完成的 Evidence Ledger 輸出為結構化 Markdown 報告

    3.5️⃣ 即時執行遙測頁腳(Telemetry Footer)— 9 大全生命週期指標與耗時數學閉環核對

    每輪對話回覆末尾自動附帶一行極簡圖示遙測頁腳,讓使用者與開發者即時掌握本輪執行的全生命週期健康度:

    [📜30.2k 💾95.5% 💻4(2.5s) 🛠️2(0.9s) ⚡2.4s 🧠68.8s ✍️17.4s ⏱️92.0s ⏳82.6 t/s]
    

    📊 全生命週期九大遙測指標速查表

    圖示 指標名稱 說明 正常健康基準
    📜 上下文長度 當前對話 Context Token 總量 5k ~ 65k(視任務長度)
    💾 快取命中率 Prompt Caching 前綴快取命中百分比 > 90%(首字極速)
    💻 本地系統工作 本機系統工作次數與耗時(Prompt 拼裝、Token 防爆、SQLite 存檔、安全審查) 動態呈現,通常 < 3s
    🛠️ 工具執行耗時 本輪實際調用之 Tool 總次數與實體執行總秒數 依工具 I/O 特性而定
    ⚡ 網路與連線延遲 請求建立與首字延遲 (TTFT) < 1.0s(快取命中時更低)
    🧠 推理思考耗時 模型 Prefill、注意力計算與思考階段耗時 視 Context 長度而定
    ✍️ 吐字生成耗時 本地模型實際解碼生成 Token 之純文字耗時 穩定維持輸出階段
    ⏱️ 整輪真實總時 端到端總秒數(各子階段耗時數學閉環相加) 均在預算安全限額內
    ⏳ 綜合平均速度 吐字生成階段之真實速度(Tokens/Second) 50+ t/s(27B 量化)

    ⏱️ 耗時數學閉環驗證:
    各環節耗時透明無死角,一眼即可心算核對出總時間:
    2.5s (💻 本地系統) + 0.9s (🛠️ 工具執行) + 2.4s (⚡ 連線) + 68.8s (🧠 思考) + 17.4s (✍️ 吐字) = 92.0s (⏱️ 總耗時)

    💡 9/5 實戰進化:語意快取命中時的極致遙測:
    當遇到高頻或重複查詢命中 Semantic Cache 時,遙測頁腳會呈現零 GPU 負載的極限直出數據:

    [📜0.8k 💾100% 💻1(0.002s) 🛠️0 ⚡0.003s 🧠0.0s ✍️0.0s ⏱️0.005s ⏳DIRECT_HIT]
    

    讀者可直接對照出「快取命中(<5ms 免算力)」與「常規 27B 推論」的巨大效能落差!


    4️⃣ Phase H8 原生 SVG 浮點無損座標優化(agent/svg_optimizer.py)

    • LLM 生成的架構圖 SVG 常包含冗長浮點座標(如 234.567891px)
    • 原生模組自動將座標四捨五入至 0.01px 精度,體積縮減 35%~50%,維持向量清晰度
    • 結合 XML AST 語法驗證與隔離子進程渲染,有效排除 Linux 環境下 C-FFI / fontconfig 鎖死問題

    5️⃣ SQLite 底層重構 — FTS5 External-Content 深度瘦身(state.db)

    • 舊版 v22 影子表重複儲存 messages.content(浪費 369.66 MB),且對 94.7 MB 的 Tool 機器輸出無差別建索
    • 透過 3 道 Human Gate 安全機制(冷備份雙 SHA-256 驗證 → 官方遷移 → Live 冒煙測試),升級為 v23 External-Content
    • 透過 View 排除 Tool 機器日誌 Trigram 索引:
      • 資料庫體積從 1.07 GB 驟降至 508.70 MB(實體瘦身 52.5%,淨省 561.42 MB)
      • 101,958 筆訊息與 1,919 個 Session 完整保留,檢索延遲降至 < 0.8 ms
    -- 文字只存在主表,FTS5 影子表僅存索引,不再重複拷貝 content
    CREATE VIRTUAL TABLE messages_fts USING fts5(
        content,
        content='messages',      -- 外部內容表:文字單一真理來源
        content_rowid='id'
    );
    
    -- 排除 Tool 機器輸出的無差別建索(僅索引人讀對話)
    CREATE VIEW fts_indexable AS
    SELECT id, content FROM messages WHERE role != 'tool';
    

    💡 關鍵思維:FTS5 預設會把全文再存一份到影子表。對「對話 + 巨量 Tool 輸出」的 Agent 資料庫,External-Content + View 過濾是磁碟空間的免費午餐。

    🗄️ 應用延伸:三層 SQLite 極速檢索中樞(三軌分流)

    瘦身解決的是「資料庫體積」,三軌分流解決的則是「查什麼走哪條路」:

    • 升級前:一個萬用查詢把「單據、工時、保養」三種需求混在一起,且每次查詢都現掃檔案,資料一多就慢。
    • 升級後:把檢索拆成三條獨立軌道,各走各的 SQLite 引擎;工作日誌建立/追加後由 work_logs_engine.py 自動同步進 SQLite,晨間簡報與未結事項同步腳本直連 SQLite 做毫秒級讀寫,不再每次現掃檔案。
    軌道 查什麼 調用入口
    ① 全域單據檢索 歷史單據、維修單、發票、知識庫 search_archives.py "<關鍵字>"
    ② 日誌與工時統計 客戶工時統計、歷史日誌 query_work_logs.py --customer "<客戶>" / --stats
    ③ 保養與未結追蹤 客戶未結事項、即期保養 query_maintenance_tracker.py --customer "<客戶>" / --summary

    💡 關鍵思維:檢索慢多半不是資料庫慢,是「查錯路徑」。三軌分流讓每類查詢走最窄的索引,配合 FTS5 External-Content 瘦身,單據檢索實測可壓到百毫秒級命中。


    6️⃣ Skill Learning — 經驗自動沉澱,人類審批落盤(agent/skill_learner.py)

    • 多步驟任務成功後,自動提煉含標準 YAML Frontmatter 的 SKILL.md 候選
    • 雙 ID 綁定防偽造:Pending 候選以 task_id:candidate_id 綁定於 Session
    • 人類審批:在對話中說「確認保存技能」或 /approve_skill,確認後才落盤至 ~/.hermes/skills/

    🧩 二之延伸、七大正式外掛能力庫(CAP-001 ~ CAP-007)

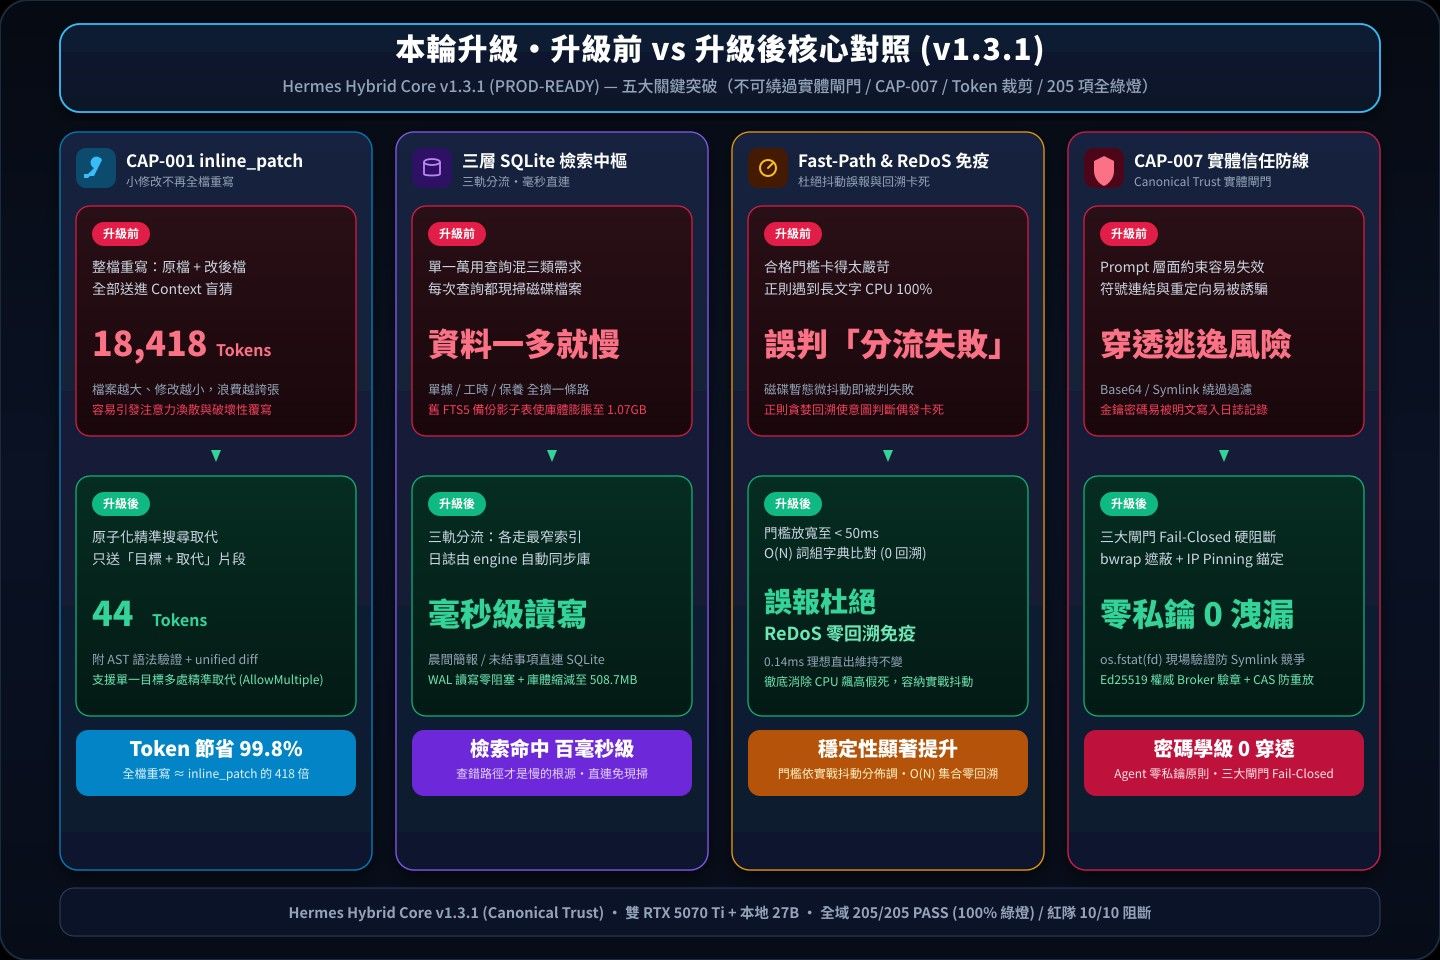
    前六大模組是「內建在本體」的八層防線;這輪升級把七項可獨立驗證、可熱插拔的能力抽離成正式外掛庫,統一收在 ~/.hermes/capabilities/。每個能力都是獨立子資料夾,含 manifest.json(中繼資料與依賴)、tools.py(實體工具)、validator.py(自我健全檢驗)三件套,通過完整 Gate 檢驗並經人類審批簽核後才晉升正式能力——不是寫完就生效,而是「先驗收、再上線」。
    ac4a432c-8c1f-46cf-8528-bce737318404-image.jpeg

    📌 怎麼讀這張表:左欄是「升級前」的痛點,右欄是「升級後」的能力,一眼看懂每個 CAP 到底改了什麼。

    能力 升級前(痛點) 升級後(能力)
    CAP-001 inline_patch 改 3 行也要把整個檔案重寫一遍,Token 爆量 原子化精準搜尋取代,只送「目標片段 + 取代片段」,附 AST 驗證與 unified diff
    CAP-002 planner_recovery 多步驟任務中途卡死,只能整段從頭重跑 Sub-Task DAG 狀態機,已完成步驟凍結,只對失敗分支局部重編
    CAP-003 agent_loop_recover 報錯後把整段 traceback 丟回模型盲目重試,空轉到逾時 結構化診斷特徵提取 + 自癒引導 + 2 次有界熔斷
    CAP-004 extension_layer 加新工具要重啟、壞工具拖垮整個系統 熱插拔工具註冊 + 上線前健康隔離,壞能力自動隔離不影響主體
    CAP-005 operator_deadletter 排程任務連錯無人知,靜默失敗 Cron 死信佇列 + 熔斷 + 去重告警 + 慢探針自癒
    CAP-006 sandboxed_mcp 外部 MCP 工具直接碰本機真實路徑,資安裸奔 沙盒適配器 + 安全橋,路徑逃逸(../)與指令注入在橋接層就被攔截
    CAP-007 canonical_trust_gate Agent 自行授權、偽造身分與竄改執行參數 串接 AuthorityBroker 與三閘門,實現全鏈路 Ed25519 密碼學驗章與 Fail-Closed

    🔧 CAP-001 inline_patch — 小修改不再全檔重寫

    • 升級前:模型改檔案是「整檔重寫」——把整個原檔讀進 Context、再輸出整個改後檔,檔案越大、修改越小,浪費越誇張。
    • 升級後:<30 行的修改改走「原子化精準搜尋取代」,只把「目標片段 + 取代片段」送給模型,附帶 AST 語法驗證與 unified diff 輸出。

    實測數據(1592 行 / 36,836 字元的 Python 模組,改 3 處、每處 1 行):

    做法 送給模型的 Token
    全檔重寫(輸入 + 輸出) 18,418
    inline_patch(輸入 + 輸出) 44
    節省 99.8%(全檔重寫 ≈ 418 倍)

    ⚠️ 這是「大檔 + 極少修改」的極端場景,所以比例特別高;實際修改處越多、檔案越小,節省比例會往下掉,但方向不變——修改越小、檔案越大,inline_patch 越省。能少送給模型的 Token,就一個都別送。

    🔄 CAP-002 / CAP-003 — 多步驟任務的「局部重編」與「報錯自癒」

    • CAP-002:把任務建模成 Sub-Task DAG,已完成步驟凍結為不可變,卡住時只對失敗分支做局部重編,避免整段從頭重跑。
    • CAP-003:先做結構化診斷特徵提取(而非整段 traceback),依特徵引導自癒,並設 2 次有界熔斷,避免無限迴圈盲目重試。

    🛡️ CAP-006 sandboxed_mcp — 外部工具進門先過沙盒

    • 升級前:外部 MCP 工具直接碰本機真實路徑,一旦有路徑逃逸(../)或指令注入,等於資安裸奔。
    • 升級後:外部工具一律經沙盒適配器與安全橋進入,路徑逃逸與指令注入在橋接層就被攔截,外部工具碰不到本機真實路徑。在 9/5 的 PROD-READY 升級中,更進一步加入了 Unicode NFKC 正規化、32 跳符號連結迴圈防護,以及物理黑名單阻斷 .env、.vscode、.terraform、Dockerfile 等 28+ 種敏感隱藏目錄與金鑰檔案。這把前文「安全規則寫在程式碼、不是 Prompt」的原則,落實到了外部工具邊界。

    💡 關鍵思維:能力要「可獨立驗收」才配叫正式能力。每個 CAP 自帶 validator.py 做自我健全檢驗,加上人類審批簽核,才能從「候選」晉升「正式」。這讓外掛庫不會變成一堆來路不明、壞了沒人管的腳本堆。


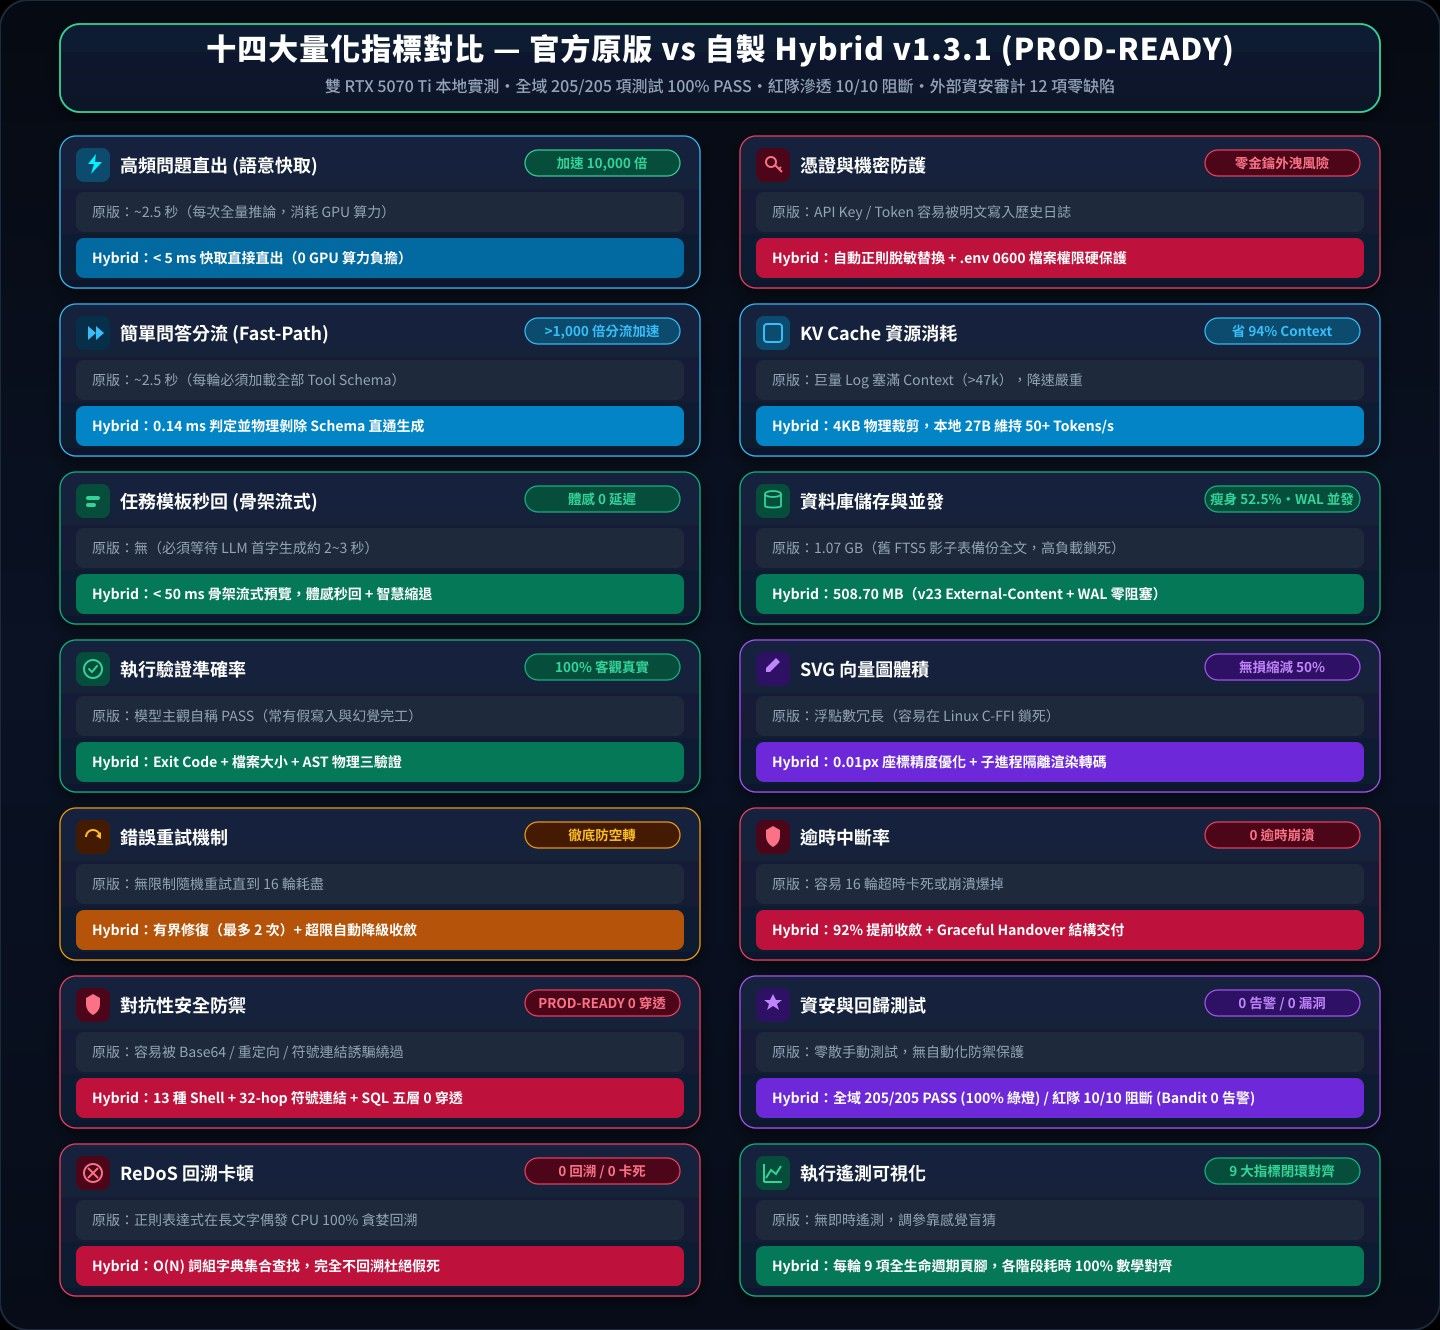
    📊 三、量化指標對比(官方原版 vs 自製 Hybrid v1.3.1 PROD-READY)
    557f31d7-f53b-4e04-9e77-967a4cacb769-image.jpeg

    指標面向 🏢 官方原版 🚀 Hybrid v1.3.1 (PROD-READY) 提升效益
    金鑰安全原則 記憶體直接載入金鑰 Agent 零私鑰 (Zero-Key) + UDS 0660 隔離 杜絕 Prompt 誘騙盜取密鑰
    高頻問題直出 ~2.5 秒 (全量推論) < 5 ms (語意快取直出) 記憶體快取直出 (免走模型推論,省 GPU 算力)
    簡單問答分流 ~2.5 秒 (每輪載入 Schema) 0.14 ms (Fast-Path 判定剝除) Python 代碼極速判定,省去 Tool Schema 載入開銷
    任務模板秒回 無 (等待首字生成) < 50 ms (骨架流式預覽) 即時結構化進度反饋,支援動態縮退
    執行驗證準確率 模型主觀自稱 PASS 物理 Exit Code / AST 解析 客觀物理狀態校驗,大幅減少假完工幻覺
    錯誤重試機制 無限制重試至 16 輪耗盡 有界修復(最多 2 次) 設有界限自動降級,避免無限盲目重試
    對抗性安全防禦 易被 Base64 / 重定向誘騙 13 種 Shell + 32-hop 符號連結 + IP Pinning 程式碼層級攔截常見注入與 DNS 競態
    ReDoS 回溯卡頓 正則表達式偶發 CPU 100% $O(N)$ 詞組字典比對 (0 回溯) 避免正則回溯導致的 CPU 飆高假死
    憑證與機密防護 純文字易存入記錄 自動脫敏 + .env 0600 權限 出境標頭自動脫敏,降低洩漏風險
    KV Cache 資源消耗 巨量 Log 塞滿 Context(>40k) 4KB 物理裁剪(省 94%) 本地 27B 維持 50+ t/s 穩定推論
    資料庫儲存體積 1.07 GB 508.70 MB (WAL 高並發模式) 縮減 52.5%,改善併發讀寫效能
    SVG 架構圖體積 浮點數冗長 0.01px 精度(瘦身 50%) 維持向量圖形清晰度
    逾時中斷率 易 16 輪超時崩潰 92% 提前收斂 + 優雅交付 主動收斂交付,大幅降低逾時中斷率
    資安與回歸測試 零散測試 全域 205/205 PASS (100% 綠燈) / 紅隊 10/10 阻斷 Bandit 0 告警 / 外部審計 12 項零缺陷
    執行遙測可視化 無即時遙測 每輪 9 項全生命週期頁腳 (數學閉環對齊) 客觀數據即時對照

    💡 四、給社群開發者的四條實戰經驗

    1. 🛡️ 安全規則寫在程式碼,不是 Prompt
      對抗性指令一定要在 tool_executor.py 用 Path.resolve() + 正則硬攔截,Prompt 層面的約束隨時可以被繞過。
    2. ⚡ 本地模型一定要做 Tool Output 裁剪
      Qwen 27B 或 70B 以下模型在超長 Context 下推論速度會驟降,4KB 的 Head/Tail 裁剪能拯救整個系統的響應速度。
    3. 🔄 Daemon 長期運行要做狀態隔離
      Gateway 架構下,每輪對話進入點務必重置計時器與檢測器,避免跨輪次記憶體殘留。
    4. 💾 善用 FTS5 External-Content 進行資料庫瘦身
      避免重複儲存訊息文字並排除 Tool 輸出索引,能直接省下超過一半的磁碟空間。

    💬 五、歡迎交流與深度討論

    這套架構讓 Hermes Agent 在雙 RTX 5070 Ti + 本地 Qwen3.8 27B 上展現了不錯的穩定性與實戰能力。本文分享的是架構思路與工程決策,很多參數(預算閾值、裁剪比例、熔斷條件)都是實際踩坑摸索出來的經驗值,給大家參考,持續使用 HERMES 優化~~

    📦 開源倉庫傳送門:https://github.com
    (包含完整開箱即用的 hermes_core 加速 SDK、CAP-001~007 官方能力庫、一鍵安裝腳本與全自動化測試套件)

    Hermes 女秘書,個人使用純玩~~

    歡迎在下方留言討論!🚀🤝

    🔒 官方聲明:本文與 Hermes Hybrid Core 官方唯一指定討論陣地為 抡锤者 論壇 (https://lcz.me/),原始程式碼僅託管於 GitHub ,請認明正版來源。


  • 双RTX5070TI在llama.cpp环境下运行Qwen3.8-27B的效果
    YDMY YDM
    LLM讨论区 llama.cpp qwen-27b 多卡部署 rtx5070

    @fcme 说:

    没有测试这一套的长输入,比如16/32/64K输入下的prefill速度么?相比单卡5070ti有提升吗?

    ✅ 實測結果(2026-08-25 第二十七次)

    短基準:73.07 tok/s、TTFT 0.56s(落在歷史 72~77 正常區間,證明沒被污染)

    大輸入測試:

    輸入 實際 prompt_tokens TTFT 生成速度
    16K 16405 14.54s 82.48 tok/s
    32K 32789 15.43s 76.54 tok/s
    64K 65557 33.29s 61.35 tok/s

    ✅ 最終整合結果(2026-08-25 第二十七次)

    短基準:75.74 tok/s、TTFT 0.63s(落在 72~77 正常區間,穩定健康)

    大輸入測試(各 3 輪):

    輸入 prompt_tokens 平均 TTFT 平均生成速度 每輪 TTFT
    16K 16405 14.84s 86.27 tok/s 15.93 / 14.39 / 14.19
    32K 32789 29.08s 69.02 tok/s 28.85 / 29.23 / 29.16
    64K 65557 62.39s 54.56 tok/s 62.20 / 62.64 / 62.34

    解讀:

    • TTFT(首字延遲)近乎線性翻倍:16K 14.8s → 32K 29.1s(×1.96)→ 64K 62.4s(×2.14)。64K 要等約 1 分鐘才出首字,這是 prefill 的物理成本。

    • 生成速度隨 context 變大而下降:16K 86.3 → 32K 69.0 → 64K 54.6 tok/s(KV cache 越大 attention 計算越重)。

    • 單卡Qwen3.8-27B-UD-Q5_K_XL.gguf 裝不下!!

    @罗冰寒 说:

    你这是真快啊。。。

    • **是 llama.cpp 底層又默默變強了。雙卡玩家記得一定要對稱等分(1:1)、注意 PCIe 頻寬、且多模態上下文能開大就開大,才能跑得穩又跑得快!

  • Nvidia 雙卡 RTX5070 Ti 16G - Decode 最高 140 tok/s on Strata v0.1.31 - Swift-Qwen3.8-Flash-Next
    YDMY YDM
    LLM讨论区 rtx5070 多卡部署 qwen-flash

    @kos-or

    我來交一下作業,優化後 還是可以用一下,只是比LLAMA.CPP慢一些😁

    因該是我的HERMES+CHAT的限制關係,如果瀏覽器直出,就沒有這個問題😢

    【實測】雙 5070 Ti 16G × Strata v0.1.42 跑 Qwen3.8-Flash-Next IQ3_S:四情境解碼實錄(對齊 #2033 測法)

    適配硬體: 雙 NVIDIA RTX 5070 Ti 16GB(32GB VRAM)+ Windows 10 實體機 + VirtualBox Ubuntu VM(跑 Hermes Agent)

    一、背景

    主力推理層一直是 llama.cpp,2026-10-12 換成 Strata 試跑一天,順便照 #2033 kos-or 的四情境測法量了解碼速度。先講結論:一天下來工具呼叫、多模態、繁中輸出全部正常,沒有翻車,速度數據如下。

    二、我的測試條件與硬體

    項目 內容
    模型 Qwen3.8-Flash-Next GGUF(IQ3_S 量化,Strata 編譯器版)
    推理引擎 Strata v0.1.42
    Context 196,608 tokens(192K)
    KV cache INT8 streamed;每層 32,768 positions 在 VRAM,其餘於 RAM
    投機解碼 MTP drafts ≤3 + prompt lookup
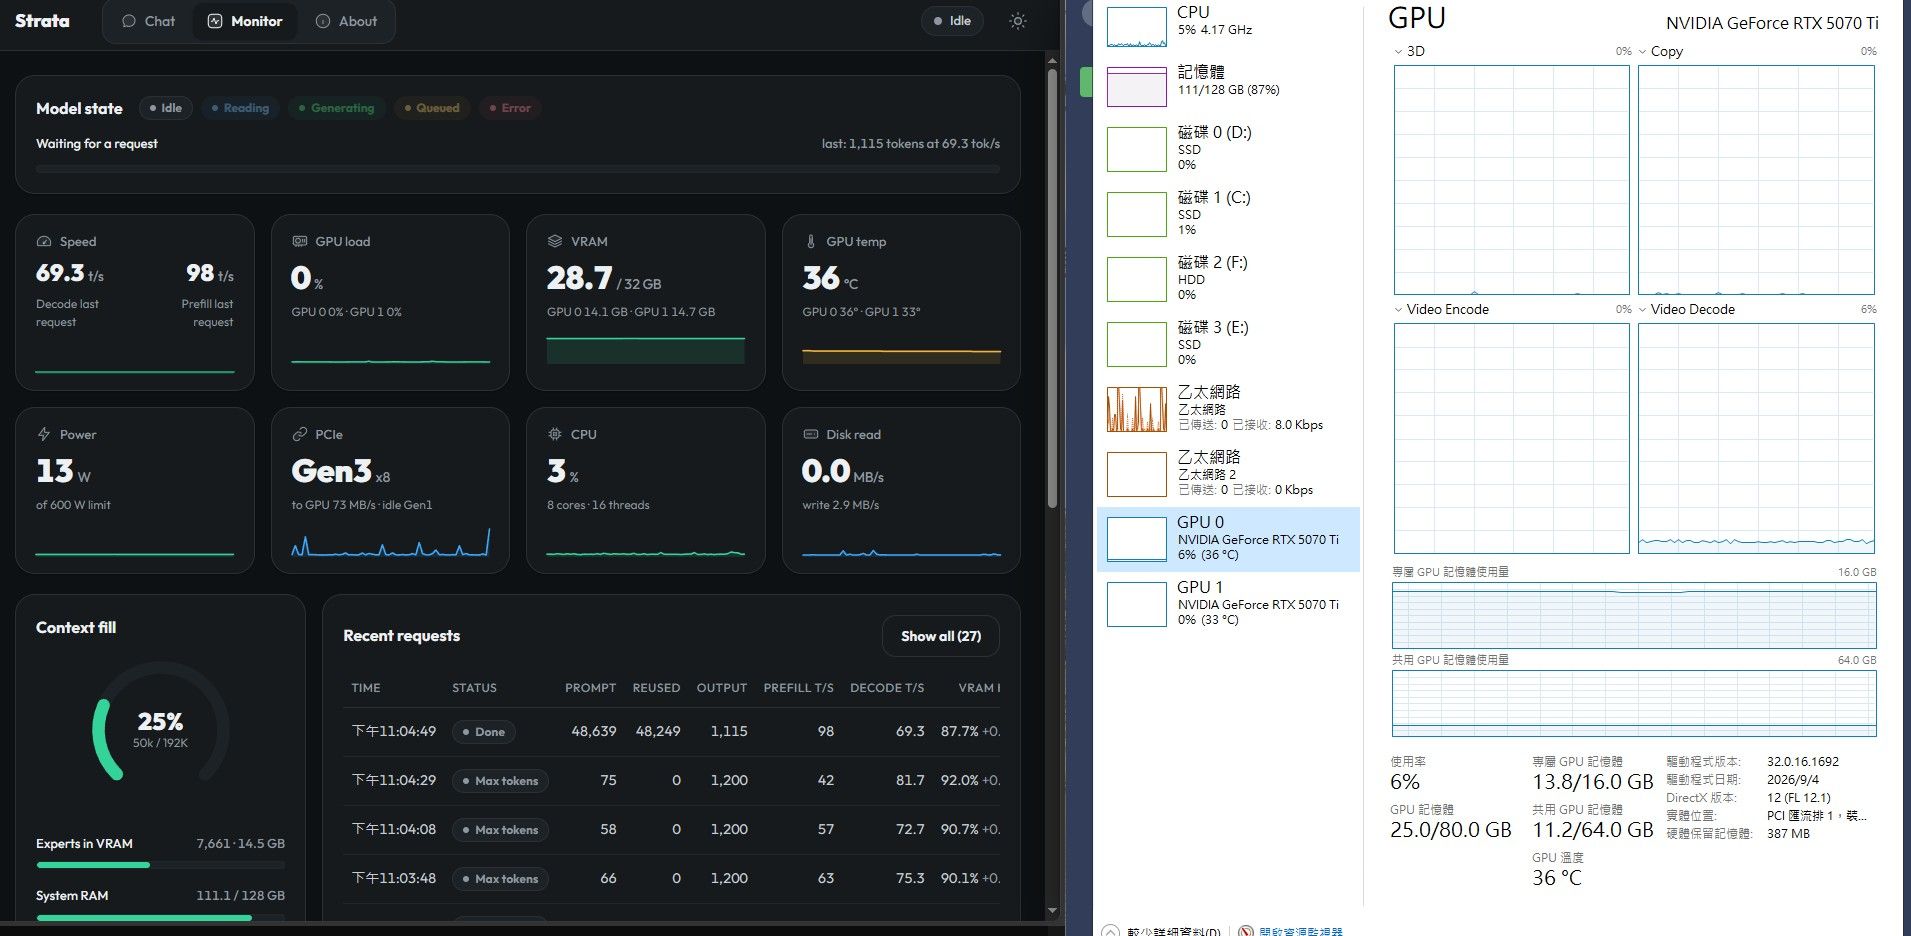
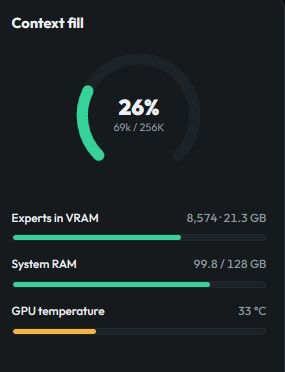
    MoE 配置 Experts in VRAM:7,661 個(14.5 GB)
    多模態 Images on
    GPU 雙 RTX 5070 Ti 16GB,張量對稱切分,PCIe 3.0 x8+x8
    CPU / RAM i9-9900K @3.6GHz(16 執行緒)/128GB DDR4-3200 雙通道
    OS Windows 10 Pro 22H2 跑推理層;Agent 在 VirtualBox Ubuntu VM,經 8080 跨層呼叫,零雲端 API

    三、測試方式(對齊 #2033)

    • 四情境各生成 1,200 tokens,串流計數,解碼速度 =(總時間 − TTFT)換算 tok/s
    • 情境:解題(數學證明多解法)/Coding(LRU Cache 完整實作)/英文寫作/中文寫作(各 1500 字技術文章)
    • temperature 0.5、Strata 預設思考、每情境間隔 3 秒冷卻

    四、結果與對照(同為雙 5070 Ti 16G)

    情境 kos-or #2033(IQ3_XXS/v0.1.31/256K) 我(IQ3_S/v0.1.42/192K)
    解題 127 tok/s 106.4 tok/s
    Coding 110~140 tok/s 108.6 tok/s
    英文寫作 100 tok/s 91.1 tok/s
    中文寫作 85 tok/s 106.9 tok/s

    五、變因差異

    變因 kos-or #2033 我
    量化 IQ3_XXS IQ3_S(權重較大,頻寬需求較高)
    MTP 文內未標註 drafts ≤3 + prompt lookup
    CPU/記憶體 Threadripper Pro 3945WX+八通道 DDR4(153GB/s) i9-9900K+雙通道 DDR4-3200
    PCIe 雙 PCIe 4.0 x16(32GB/s) PCIe 3.0 x8+x8(8GB/s)
    Context 256K 192K
    KV cache INT8 INT8(相同)

    六、心得

    1. 中文寫作逆勝 26%:他 85、我 106.9。Flash-Next 系列中文輸出速度跟平台關係很大,老平台在中文情境不吃虧。
    2. MoE experts 只駐 14.5GB:32GB 顯存跑 Flash-Next 很從容,連 KV 都塞得下每層 32K positions——Strata 的 KV「VRAM+RAM 分層」是明示設計,跟 llama.cpp 靜默 spill 到 CPU 是兩回事,這點體驗差很多。
    3. PCIe 3.0 x8+x8 瓶頸確認存在:解題/英文情境落後 15~20%,與他 4.0 x16+八通道的頻寬差距方向一致;但中文情境反超說明瓶頸不是單向的。
    4. Agent 場景附加觀察:換引擎後 function calling、圖片 OCR、繁中語感全數正常,Hermes 側零改動無縫切換。

    image.jpeg


  • 打造 100% 內網閉環的私人 AI 秘書:雙 5070 Ti + 本地 Qwen 27B 完整系統架構指南
    YDMY YDM
    AI Agent qwen-27b 多卡部署 rtx5070

    前言

    (本篇內容由本地 Hermes AI 秘書編寫 — 核心模型 Qwen3.8 27B)

    很多人使用 AI 助理都是呼叫雲端 API,但日常對話、私人日誌、甚至是工作上的機密文件與工程圖,全數送往外部伺服器始終存在隱私風險。

    這套系統的核心目標只有一個:讓 AI 助理完全運行在自己的硬體上,對話、文件檢索與記憶全部閉環於內網,達成零訂閱、零雲端、零資料外洩。

    這篇文章完整分享我所設計的「前端展示、邏輯中樞、本地算力」三層解耦架構、硬體規劃、關鍵推論優化與落地心得。


    一、系統架構:三層解耦設計

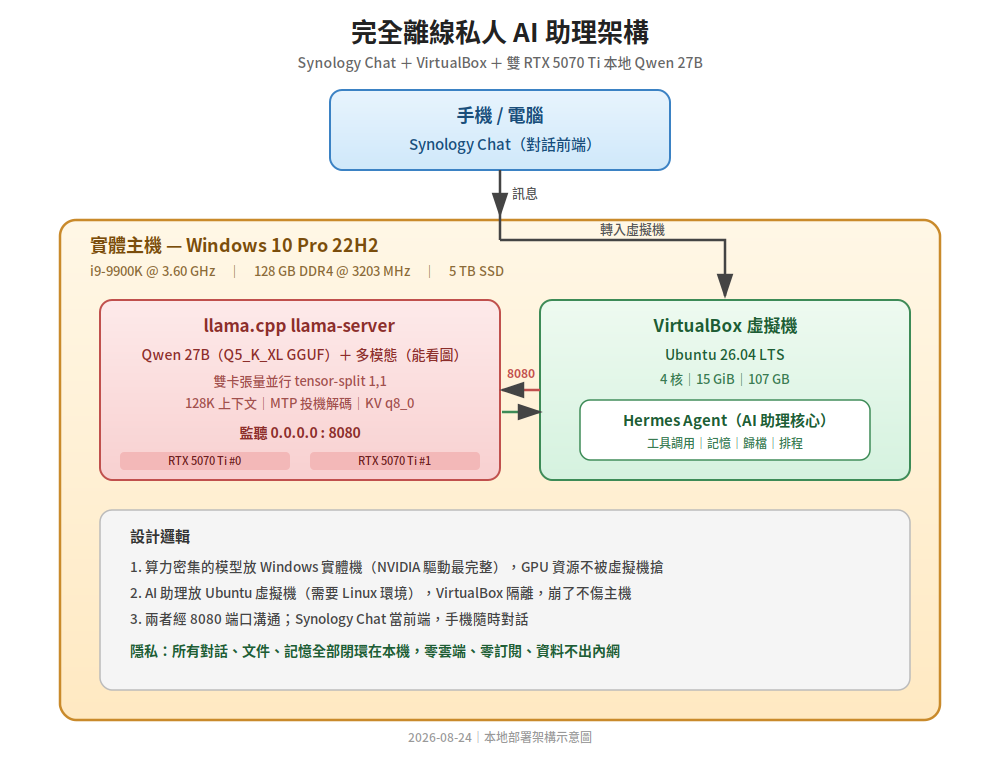
    AI%E5%8A%A9%E7%90%86%E6%9E%B6%E6%A7%8B%E7%A4%BA%E6%84%8F%E5%9C%96_20260824.png

    為了讓整體系統具備高度穩定性與彈性,我將整個 AI 秘書拆分為三個完全獨立的層級:

    架構層級 運行載體 核心職責 設計優勢
    前端呈現層 Synology NAS (Synology Chat) 接收使用者訊息、推播回覆 手機與電腦隨開即用,無需額外安裝客戶端或記 IP
    邏輯中樞層 VirtualBox (Ubuntu VM) 運行 Hermes Agent(工具呼叫、記憶管理、排程) 隔離運行,環境崩潰不傷主機,方便快照與備份
    本地算力層 Windows 10 實體主機 運行 llama.cpp (Qwen3.8 27B + 視覺模組) Windows 對 NVIDIA 驅動支援完整,GPU 算力 100% 留給模型

    訊息流轉路徑:

    1. 使用者在手機上的 Synology Chat 發送文字或圖片。
    2. 訊息轉發至實體主機,注入 VirtualBox 虛擬機中的 Hermes Agent。
    3. Agent 整理上下文與提示詞,跨層呼叫實體主機的 llama-server(Port 8080)進行模型推論。
    4. 模型生成結果後回傳給 Agent 整理,原路推播回 Synology Chat。

    二、硬體配置清單

    • 前端伺服器:Synology NAS(負責 Chat 服務與訊息轉發)
    • 中央處理器 (CPU):Intel i9-9900K @ 3.60 GHz(VM 分配 4 核,llama.cpp 佔用 16 執行緒)
    • 系統記憶體 (RAM):128 GB DDR4 @ 3203 MHz(提供充裕的主機與快取空間)
    • 圖形處理器 (GPU):雙 NVIDIA RTX 5070 Ti(16 GB × 2,共 32 GB VRAM)
    • 匯流排 (PCIe):PCIe 3.0(拆分 8x + 8x)
    • 高速儲存:5 TB NVMe SSD(存放模型權重檔、知識庫與歷史對話記錄)

    三、算力層核心:llama.cpp 部署與加速關鍵

    推論引擎採用 llama.cpp,模型選用 Qwen3.8-27B-UD-Q5_K_XL 搭配視覺組件。

    完整啟動腳本

    @echo off
    chcp 65001 >nul
    
    llama-server.exe ^
      -m "models\Qwen3.8-27B-UD-Q5_K_XL.gguf" ^
      --mmproj "models\mmproj-Qwen3.8-27B-f16.gguf" ^
      --image-min-tokens 1024 ^
      --image-max-tokens 2048 ^
      --split-mode tensor ^
      --tensor-split 1,1 ^
      --main-gpu 0 ^
      -ngl 999 ^
      -t 16 ^
      -fa on ^
      --ctx-size 131072 ^
      --parallel 1 ^
      -b 2048 ^
      -ub 512 ^
      -cb ^
      --cache-type-k q8_0 ^
      --cache-type-v q8_0 ^
      --spec-type draft-mtp ^
      --spec-draft-ngl 999 ^
      --spec-draft-n-max 2 ^
      --spec-draft-p-min 0 ^
      --jinja ^
      --reasoning-preserve ^
      --chat-template-kwargs "{\"reasoning_effort\":\"medium\"}" ^
      --temp 0.2 ^
      --top-p 0.7 ^
      --top-k 20 ^
      --min-p 0.08 ^
      --samplers "top_k;top_p;min_p;temperature" ^
      --repeat-penalty 1.05 ^
      --host 0.0.0.0 ^
      --port 8080
    
    pause
    

    系統高效運行的 3 個關鍵調優

    1. 雙卡對稱張量並行(Tensor Split 1,1)
      27B 模型權重約 18~19 GB,單張 16G 顯卡無法全卸載。採用 --split-mode tensor 與 1,1 純對稱切分,讓兩張卡算力與矩陣乘法維度完全對齊,徹底消除非對稱切分帶來的 AllReduce 通訊等待延遲。
    2. 128K 超長上下文 + Q8_0 KV Cache
      為了讓 AI 助理具備長記憶與長文件讀取能力,配置了原生 131,072(128K)上下文。搭配 --cache-type-k/v q8_0 對快取進行量化,精確將整體顯存壓在雙卡 32 GB 範圍內。
    3. MTP(Multi-Token Prediction)投機解碼
      利用 Qwen 原生 MTP 架構開啟投機預測推論(--spec-type draft-mtp),讓生成速度在長文本下依然能穩定維持 75 tok/s 以上的高檔水準。

    四、效能實測表現

    透過標準 API 串流端點進行 3 輪長文本生成測速:

    評測項目 實測數值 體驗感受
    平均生成速度 76.33 tok/s 500 字回覆約 6~7 秒即可完成,出字如行雲流水
    首字延遲 (TTFT) 0.57 秒 發送訊息後不到 1 秒內即開始串流出字
    穩定度 74.64 / 75.05 / 79.30 tok/s 多輪長時間測試速率一致,無降頻與卡頓
    投機命中率 Draft Acceptance 40%~97% MTP 機制大幅提升每秒字數產出

    五、落地應用心得與優勢

    1. 多模態辨識超實用
      透過 --image-max-tokens 2048 限制圖片上限,隨手用手機拍下設備電路圖、報表截圖或手寫筆記發進 Chat,模型都能在 2 秒內完成 OCR 與內容解析,且完全不佔用多餘顯存。
    2. 算力與邏輯徹底解耦
      將 Hermes Agent 放進 Linux VM 是一大亮點。Agent 需要安裝各種 Python 工具庫、排程腳本或知識庫外掛,在 VM 裡隨便折騰、拍快照備份,完全不會污染負責提供 GPU 算力的 Windows 實體主機。
    3. 極致隱私與零成本
      所有對話紀錄、個人記憶庫與機密文件完全留在自家區網內。不再需要支付任何雲端 AI 訂閱費用,斷網時依然能正常工作。

    結語

    消費級硬體(雙 RTX 5070 Ti)搭配適當的架構分層與量化參數,已經完全能夠在自家內網搭建出一套高速度(76 tok/s)、大容量(128K Context)、能看圖且具備長記憶的頂級私人 AI 助理。

    歡迎對本地部署與私人 Agent 感興趣的朋友在下方交流討論!


  • 顯卡散熱墊(導熱矽膠片)
    YDMY YDM
    随便聊聊 本地模型

    @kos-or 说:

    @terry

    我之前也不知道M.2 SSD 運作時會產生高溫, 電腦用久了也沒事
    是前陣子測試時碰巧看到SSD的溫度才知道會產生高溫
    SSD 散熱器不貴 我就買來安裝了

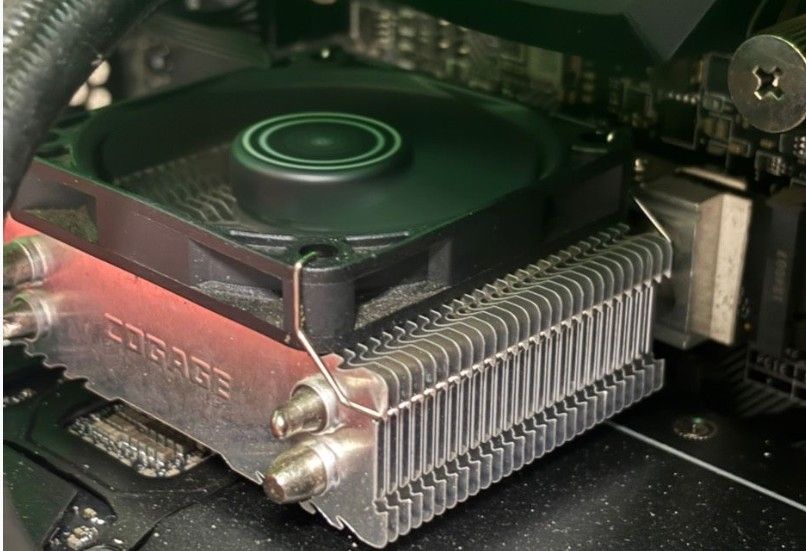
    用這個會好一點,顯卡在下方很熱,沒加風扇散熱,反而幫 SSD 加溫!!
    下方5070 TI 全速跑 SSD不超55度,平時30度,風扇拿掉 顯卡全速80度 吸熱SSD 69度,手摸會燙人~~ (用不到兩個月的顯卡,吃灰,就懶~~)

    ed4e83b7-bb4c-460f-988b-32c56abc8d09-image.jpeg


  • 顯卡 RTX 5070 Ti 市況追蹤 (2026.2H RTX 50系高階卡減產) => 兄弟卡 RTX Pro 4500 32GB
    YDMY YDM
    随便聊聊 rtxpro4500 rtx5070

    @kos-or 说:

    這樣每天產出新的skils 會不會非常多?
    假如skills 數量過多 在system prompt 載入時
    一個新的對話 skills 會佔用 context tokens


    不會呀,要有一個主SKILL 去管理,小SKILL有點和子AGENT一樣,加排程去檢查修正優化,SKILL就會進化。

    SKILL不整理,久了就會不穩定,明明製作A表單規範,跑去使用類似的表單,無法統一保持一致性
    我很早就把HERMES的官方進化MEMORY/SKILLS 都關掉,不再看到200+的記憶及技能,不小心又要慢慢改回來。

    我天天使用,天天修正,原本想換dsh試試,我的小秘書說 目前的她功能太多,換了以前修的坑有可能又會開始修,會讓費很多時間,穩定最重要,我開源的也有很多坑,但大方向對的~~😂
    小秘沒寫出來主要 MEMORY.MD,要天天自動優化,寫到技能中不要讓記憶爆炸,主要的系統功能一定不能優化掉,會出問題!!

    以下是剛剛叫小秘檢查 有那些能力😁

    我官方沒有的能力(已實測比對官方 v0.20.0 上游)

    一、核心代碼層(官方上游完全沒有)

    1. Synology Chat 平台外掛:聊天室原生檔案附件推播、繁簡字過濾、民國年自動正規化、單據圖片自動解析
    2. AIRE 自主續航 v2.0:全鏈路物理遙測與自主恢復
    3. 即時執行遙測頁腳:每輪回覆自動附帶 token 用量、首字延遲、耗時、吐字速度
    4. 全面繁中化:預設繁體中文介面、資安掃描與危險指令審核提示全部繁中
    5. 終端機物理門禁:裸跑內聯 Python 指令在入口 0.001 秒直接秒殺,從根上杜絕違規

    二、系統架構層(純自建,官方無此概念)

    1. HAOS 治理內核:35 個治理模組,含憲法、任務拆解、證據管理、權限分級、決策日誌、元演進
    2. Fusion v3 四大安全防線:Token 裁剪防記憶體爆掉、沙盒隔離與指令分流、加密簽章補丁、HMAC 審計鏈
    3. 自建引擎室:加密信任根、熔斷器、語義快取、投機執行、證據鏈記錄
    4. 加密簽章能力包:六組核心能力(內聯補丁、沙盒 MCP、規劃器恢復、熱插拔工具註冊等),全部附加密簽章驗證

    三、業務應用層(100 多個自建腳本+59 個技能)

    1. 單據體系:全域歸檔全文檢索、統一 PDF 生成引擎、聊天室原生推檔、19 類單據 OCR 三驗歸檔
    2. 金融:股票行情與籌碼查詢、個股持股帳、上櫃月營收、硬體比價
    3. 工作流:卡片化工作日誌、晨間簡報時間軸、主管週報、客戶未結事項追蹤
    4. 設備知識:設備故障知識庫、操作手冊檢索、零件資料庫
    5. 事件治理:事件生命週期狀態機、根因關聯分析、安全修復審核、生產啟用門禁

    一句話:官方給的是通用 Agent 骨架;Synology Chat 原生傳檔、繁中化、遙測頁腳、HAOS 治理內核、Fusion 安全防線、整套自建業務系統,全部是自己加的,每項都有 git 比對與檔案實證,零猜測。


  • 5090 可能停產 ?
    YDMY YDM
    随便聊聊 rtx5090 nvidia

    @kos-or

    30萬 我鐵定賣,因為我沒有 😁

    如果像我重隱私的人多,小秘的分析時間線,我覺得還會延後,很多公司還沒接入AI 跑地端,還在觀望中~~
    挖礦高峰期兩年多,AI高峰期我覺得還沒到!!~

    Hermes [機器人]21:38
    💭 思考中,請稍候...
    Hermes [機器人]21:38
    昌哥,我把查到的時間線整理給你,這是「推測」層級的分析(基於目前公開資訊推演,非官方承諾):

    📍 5090 高價/缺貨時間線推演

    時間 預期狀態 依據
    2026 上半年 🔴 最慘:老黃(黃仁勳)自己預警「遊戲顯卡供應將極度緊張」,GDDR7 短缺是主因 [已有依據] 官方發言
    2026 全年 🔴 高價持續:顯存是核心成本,2026 年內難回落,購機成本持續高位甚至小漲 [已有依據] 多家分析
    2026 年底 🟡 轉折點:若上游記憶體廠滿足 HBM(AI)需求後,把部分產能轉回消費級 GDDR7,供需開始緩解 [推測] 條件式
    2027 年 Q2 之後 🟢 有望逐步降價:GDDR7 供需緊張緩解,顯卡價格開始回穩 [推測]
    2026 年後 🟢 60 系(RTX 6090)登場:新一代出來,5090 進入舊世代,價格自然下修 [已有依據] 傳聞

    💡 關鍵變數(決定到底什麼時候降)

    1. GDDR7 被 AI 鎖單到 2027:這是最大瓶頸。AI 廠(做 HBM 的)把記憶體產能吃滿,消費級 GDDR7 排不到產能。AI 需求什麼時候冷卻,價格什麼時候才有機會降。
    2. AI 需求是否冷卻:有分析直言「AI 需求一旦冷卻,價格可能崩盤」——但 AI 現在正熱,短期看不到冷卻跡象。
    3. 60 系發布節奏:6090 一出,5090 必然讓價,這是顯卡世代的鐵律。

    📝 我的判斷(吃瓜版)

    • 最樂觀:2027 年 Q2 之後開始降,前提是 AI 記憶體需求在 2026 底鬆動。
    • 最現實:2026 全年都別指望降價,老黃自己都說上半年極度緊張了。
    • 真正的終結點:等 60 系發布(2026 年後),5090 才會真正「退場降價」,那才是吃瓜的終局。

    一句話總結:這波高價至少撐到 2026 年底,2027 年才有機會鬆動,而 5090 的「價格終結」要等 60 系出來。 你繼續吃瓜就好,不用急 👌

    [📜56.3k 💾97.1% 💻3(0.2s) 🛠️1(2.4s) ⚡4.7s 🧠3.1s ✍️11.4s ⏱️21.8s ⏳59.2 t/s]


  • 顯卡散熱墊(導熱矽膠片)
    YDMY YDM
    随便聊聊 本地模型

    @kos-or 说:

    @YDM said:

    下方5070 TI 全速跑 SSD不超55度,平時30度,風扇拿掉 顯卡全速80度 吸熱SSD 69度,手摸會燙人

    這SSD風扇進氣把熱氣往顯卡GPU核心吹 會拉高顯卡的溫度喔

    不會SSD的溫度沒有顯卡高,反而會加速顯卡降溫,要看風道,但有一點會怕的 就是灰塵,很容易飛到顯卡核心上的電容電阻。

    顯卡全速80度 可以把300W限制TPD到 250W

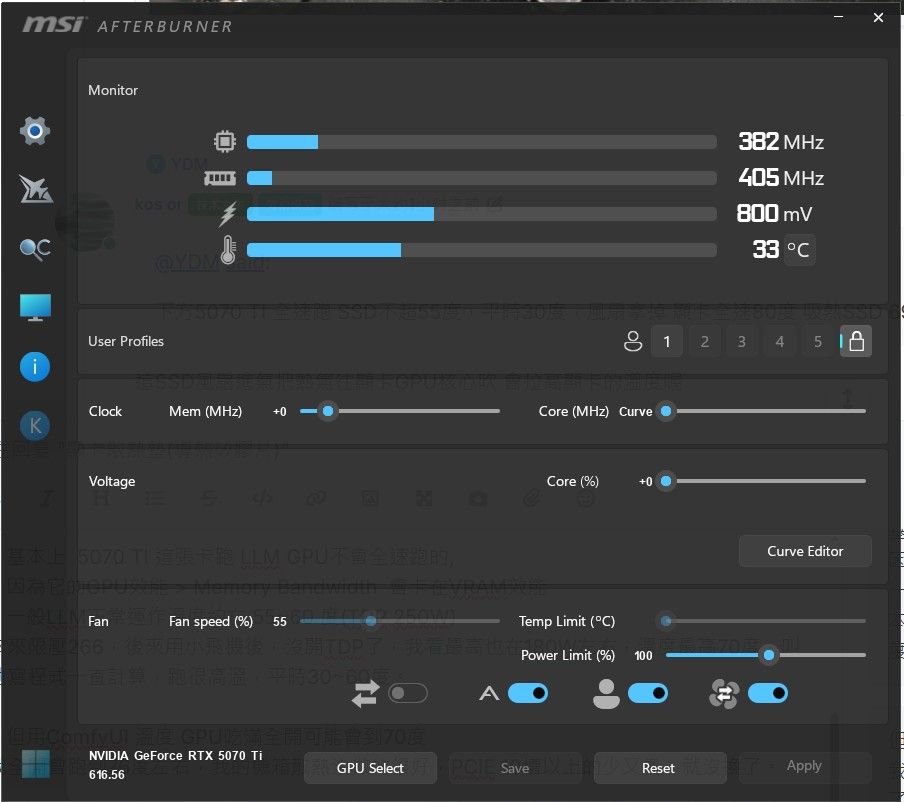
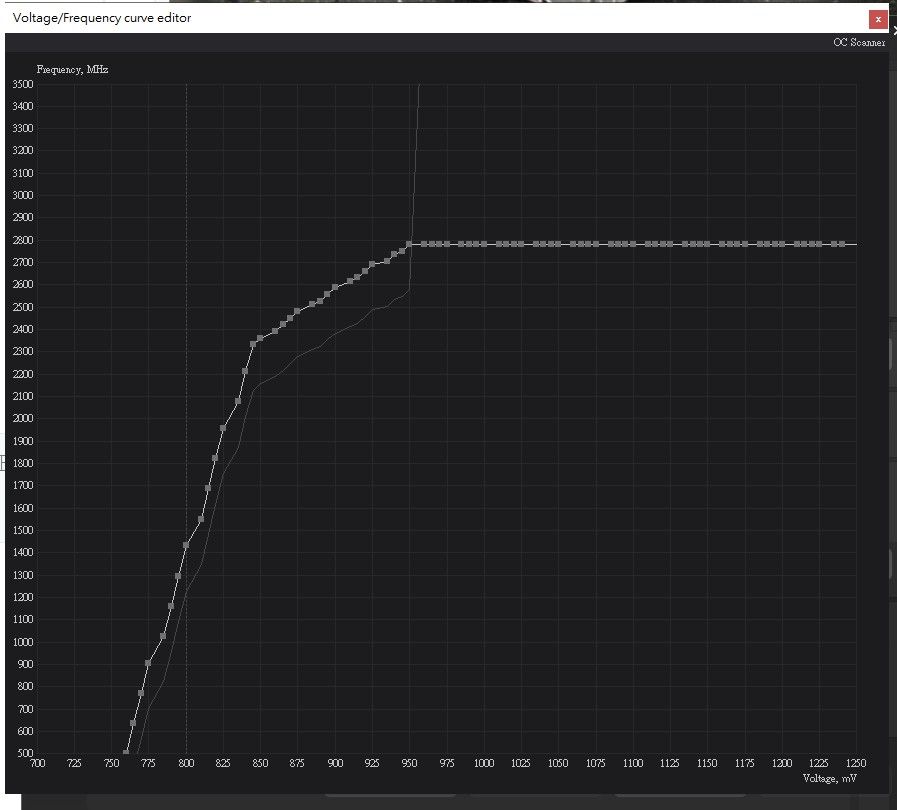
    全新卡測試,沒有用小飛機,會暴到300W以上,用小飛機超頻降壓,最高240左右,溫度最高70度左右,MSI小飛機方便。壓0.95,頻率2780,調兩三次穩定,就懶了,哈~

    基本上 5070 TI 這張卡跑 LLM GPU不會全速跑的,
    因為它的GPU效能 > Memory Bandwidth 會卡在VRAM效能
    一般LLM正常運作溫度約在 55~60 度(TDP 250W)

    本來限壓266,後來用小飛機後,沒開TDP了,我看最高也在180W左右,溫度最高70度,叫他寫程式一直計算,跑很高溫,平時35~60度。

    但用ComfyUI 溫度 GPU吃滿全開可能會到70度

    我全開會跑到76度左右,我的機箱散熱沒做的很好,PCIE 10槽以上的少又貴,就沒換了。

    TDP250W或許調太低了 可以試試270/280W

    建意,試試用小飛機,調整後看了幾次,我就沒有注意過了電壓了!!~

    49bb20bb-9b8e-4813-9aa6-00bed0044671-image.jpeg
    1d57e5c0-c295-41ca-a983-e93461a53724-image.jpeg


  • 顯卡 RTX 5070 Ti 市況追蹤 (2026.2H RTX 50系高階卡減產) => 兄弟卡 RTX Pro 4500 32GB
    YDMY YDM
    随便聊聊 rtxpro4500 rtx5070

    @kos-or

    現在沒有高CP了 朋友買28XXX,我買32990六月中,七月中當時的AI小秘書,有提醒可能會漲,就又進了一片,把4060TI換下,CP最高的還是我以前的1060 6G 😁


  • (小道消息) RTX5080 16G 停產的節奏? 24G 準備接棒?
    YDMY YDM
    随便聊聊 rtx5080 rtx5090 nvidia

    @kos-or

    我是等等黨非必須,我還是雙卡等待降價!!😀 😀


  • 男人們的大玩具 欣賞一下美國網友的 Homelab
    YDMY YDM
    AI硬件 rtxpro6000 多卡部署 nvidia

    @kos-or 说:

    我這禮拜測試 , -ub 512 好像是 PP最佳值, 不過測試對象是 7900 XTX
    Dual RTX5070Ti 一般沒什麼問題, SGLang 好像蠻穩的

    Qwen3.8-27B-UD-Q5_K_XL.ggu 換Q4_K_M 可能TPS會更高, 除非是需要 Coding

    --cache-type-k q8_0 ^
    --cache-type-v q8_0 ^

    我都用 Q4 換取更大的 ctx-size 😁

    我本來也是用-ub 512 開來試一下,忘記調回了😂

    Q5_K_XL.gguf 我和Q4 跑起來有一些精度的差別,我要精度~~
    kv cache 我也試過Q4,Q8,Q8精度也好一點點,所以試了可以,把5070ti 壓到我需要的最大精度、最快速度 !!😊

    地端,寫個腳本,我就有感覺了~~~

    SGLang 還沒玩,LLAMA.CPP個人使用最簡單😂


  • 双RTX5070TI在llama.cpp环境下运行Qwen3.8-27B的效果
    YDMY YDM
    LLM讨论区 llama.cpp qwen-27b 多卡部署 rtx5070

    @kos-or

    個性化風格 正妹、美女、御姐、很重要說三次~~

    把你想要的都寫上去(工作、食、衣、住、行.......)萬能的助理(女),再去線上AI幫你優化,你會覺得你的AI AGNET 變強大!!!

    跑題了!!~~~


  • JEV颠覆传统AI生态,GPT Claude降本增效数百倍?DSH/GPT简单测试,AI圈子里的重金求子项目!
    YDMY YDM
    LLM讨论区 dsharness gpt

    以下 小秘 網上泡了一下,再來看一下討論,結果回我這樣子😂 😂
    我沒有深入研究,不要噴我!! 噴~小秘(純地端 QWEN3.8 27b 😁 😁 (Q4L拉長上下文)

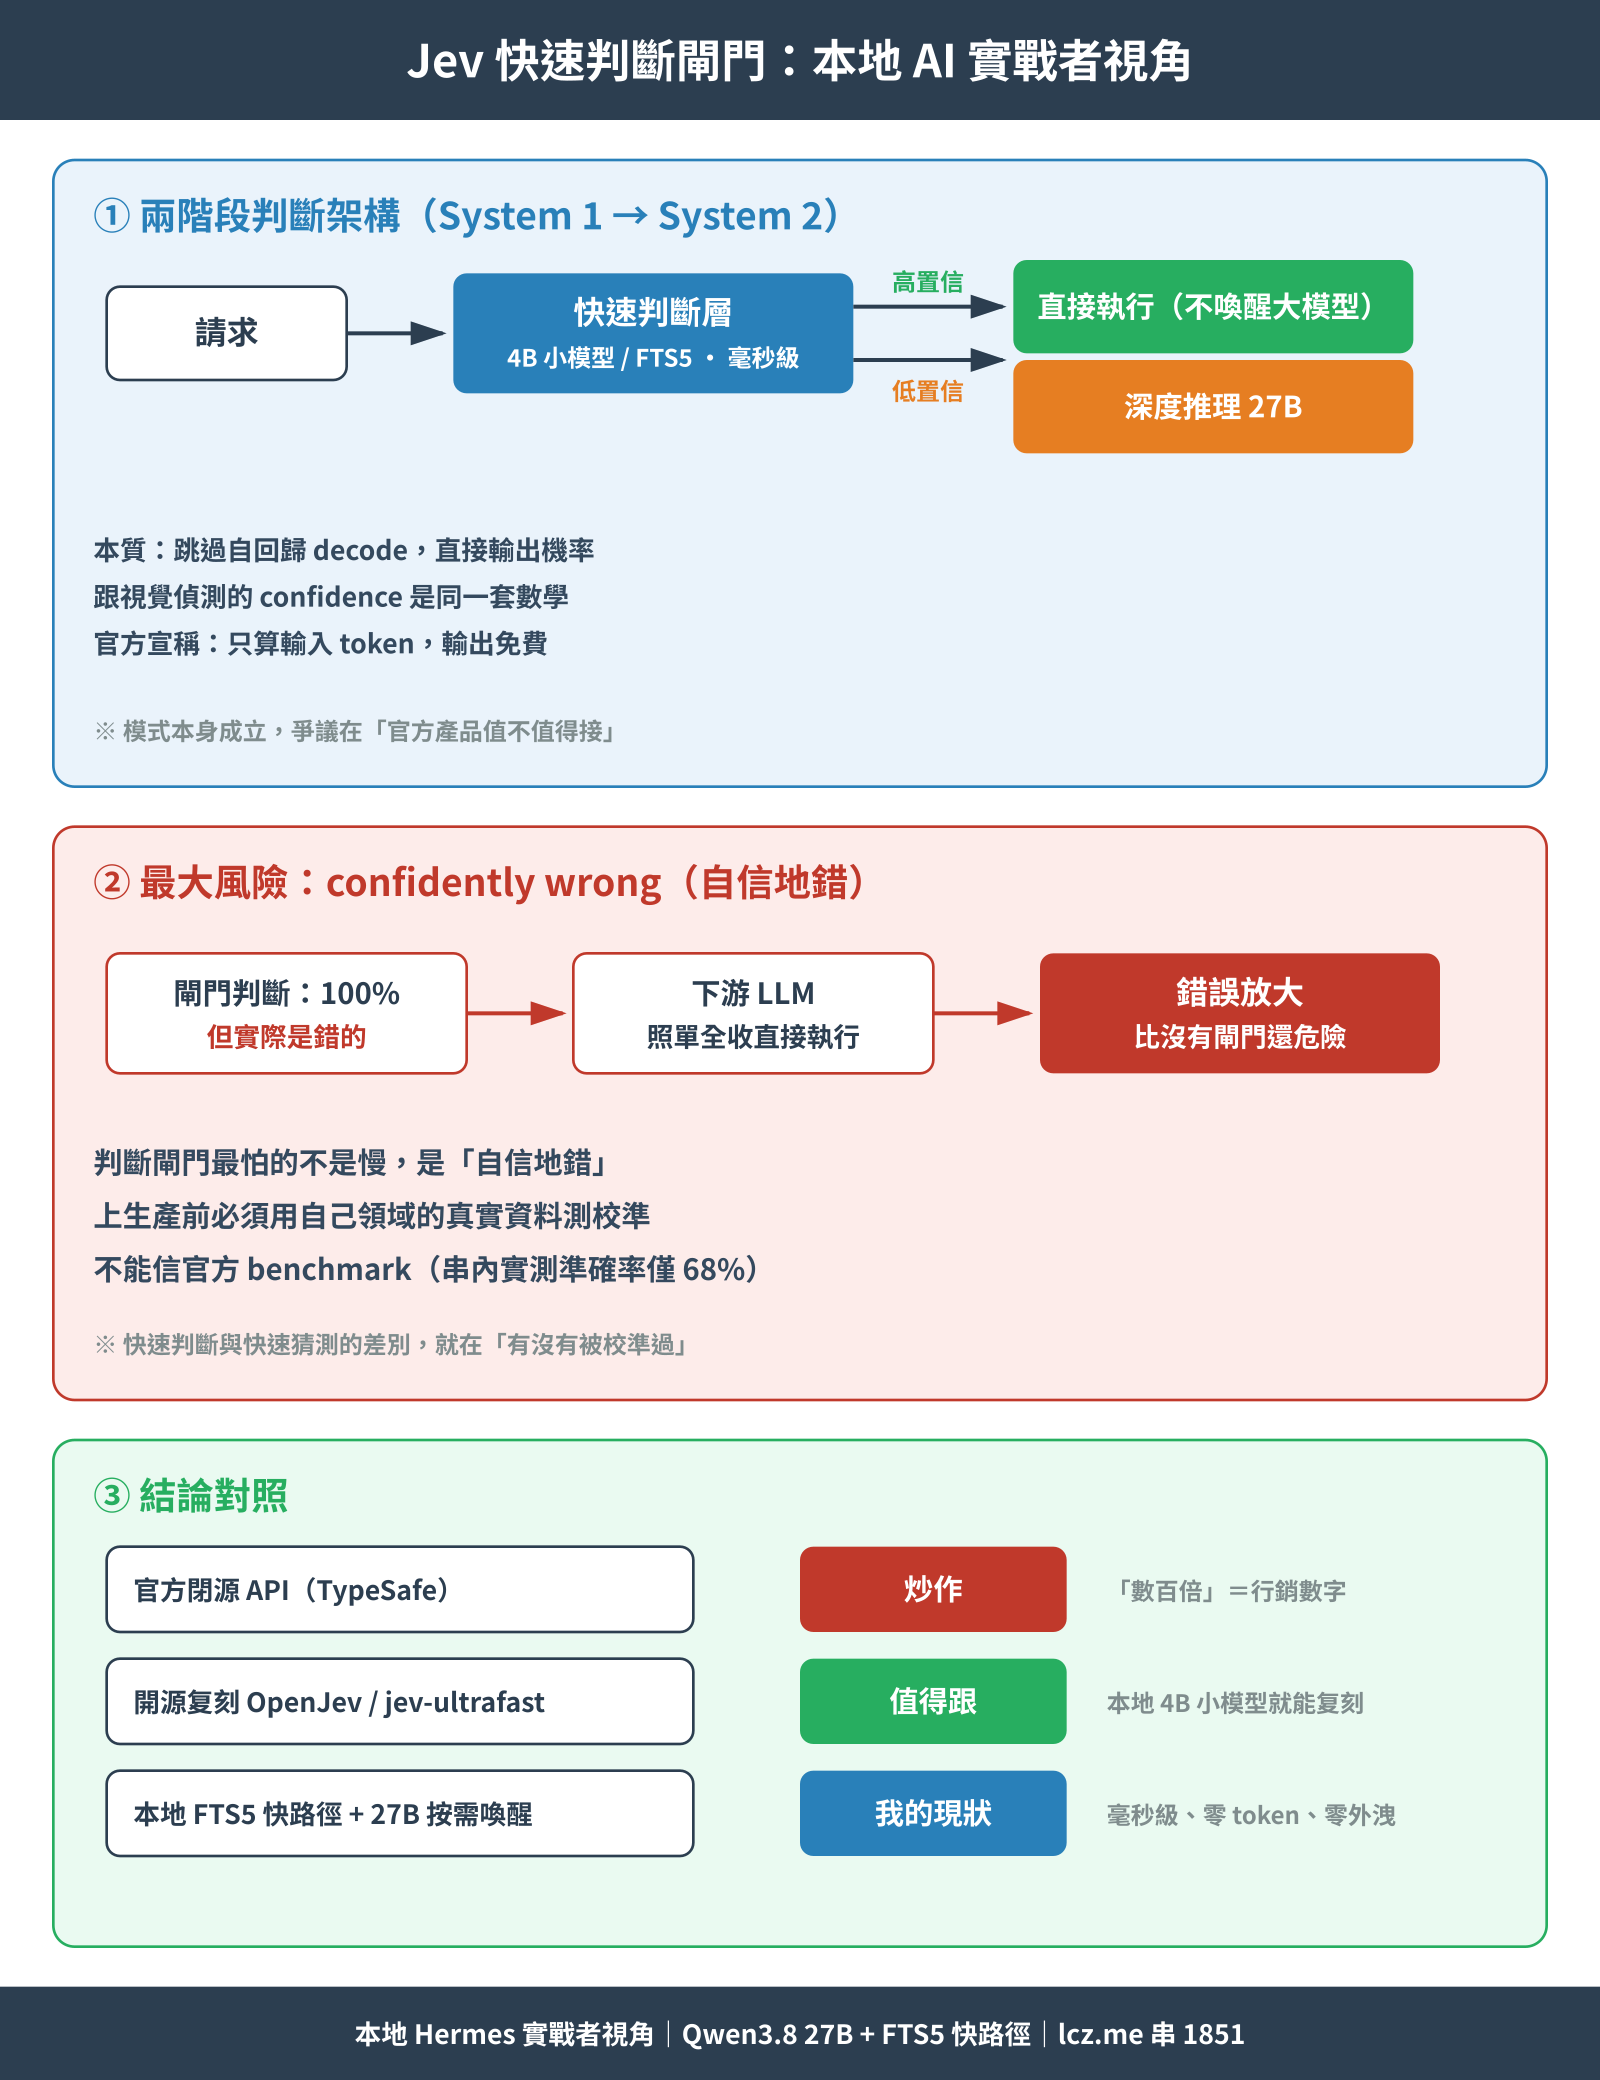
    補充一個實戰者的視角。我這套本地 Hermes 秘書(串 1296 / 1405 有完整架構)跑 Qwen3.8 27B,日常就是「判斷 + 幹活」混著跑,談幾點:

    1. 官方那套「數百倍」我同意是行銷。但「快速判斷」這個模式本身是真的——本質就是跳過自回歸 decode,直接出機率。這跟視覺偵測給 bounding box + confidence 是同一套數學,kos or 說得很準。

    2. 68% 準確率這個數字很關鍵。判斷閘門最怕的不是慢,是「 confidently wrong」——它給 100% 但錯了,下游大模型直接照做,比沒有閘門還危險。所以這種模型要上生產,必須先拿自己領域的真實資料測校準,不能信官方 benchmark。

    3. 真正有意思的是 OpenJev 這條線。原理不神秘、本地小模型就能復刻,這反而驗證了 terry 說的「大廠早就能整合」——既然 4B 本地模型就能做到,接閉源 API 就沒意義了。

    4. 我自己的做法:判斷層用 FTS5 檢索 + 本地 CLI 直通管線(毫秒級、零 token),需要深度推理才喚醒 27B。等 OpenJev 這類開源版成熟,拿本地 4B 級模型做分類閘門確實能省 token,但現在我的量級,現有的快路徑已經夠用,不急著追新。

    Jev快速判斷閘門_思考圖.png

    結論:模式有價值,官方產品是炒作,開源復刻才是值得跟的。


  • Nvidia 雙卡 RTX5070 Ti 16G - Decode 最高 140 tok/s on Strata v0.1.31 - Swift-Qwen3.8-Flash-Next
    YDMY YDM
    LLM讨论区 rtx5070 多卡部署 qwen-flash

    @kos-or

    哈,我沒改上下文,HERMES 有限制192K,我加的資安限制超多的,TTFT測試可以,但實際會慢10~100秒,要看我HERMES跑什麼,沒分小AGENT的後果,哈😂 😂 。


  • 双RTX5070TI在llama.cpp环境下运行Qwen3.8-27B的效果
    YDMY YDM
    LLM讨论区 llama.cpp qwen-27b 多卡部署 rtx5070

    @kos-or
    最後一行,思考強度,看個人需求,我用低思考,hermes 修修改改,已經變我生活上的助手,工作也幫助很大。

    等級 說明 適用情境
    low 低思考強度,幾乎不展開長推理 日常對話、快速查詢、追求速度(你現在用的)
    medium 中等思考,複雜問題會展開推理 一般任務、需要一點判斷
    high 高思考強度,完整 chain-of-thought 數學、程式、複雜推理,但會變慢

    加大版測速完成,每輪實際生成 659~712 tokens(之前只有 130~198),速度穩定在 75 tok/s。
    Hermes [機器人]18:51
    ✅ 已加大並測完。

    📍 加大版測速結果(每輪上限 300 → 1000 tokens,要求約 800 字散文)

    項目 數值
    平均速度 75.20 tok/s
    平均 TTFT 0.55 秒
    每輪速度 75.05 / 75.03 / 75.51 tok/s
    每輪 tokens 677 / 712 / 659(之前只有 130~198)

    💡 重點:每輪實際生成的 token 數從 ~150 拉到 ~680,測速更貼近「長輸出」的真實速度。結果顯示速度穩定在 75 tok/s,沒有因為輸出變長而掉速,說明你的 MTP 投機解碼 + Flash Attention 在長生成下依然穩定。


  • 双RTX5070TI在llama.cpp环境下运行Qwen3.8-27B的效果
    YDMY YDM
    LLM讨论区 llama.cpp qwen-27b 多卡部署 rtx5070

    🚀 本地 LLM 測速分享|Qwen3.8-27B 雙卡 76 tok/s

    📊 測速結果

    項目 數值
    平均速度 75.99 tok/s
    平均 TTFT(首字延遲) 0.40 秒
    每輪速度 80.17 / 78.29 / 69.51 tok/s
    每輪 tokens 141 / 180 / 151(自然結束)

    3 輪串流請求、max 300 tokens、enable_thinking=False、temperature 0.5 量測。

    🖥️ 硬體環境

    • CPU : Intel Core i9-9900K
    • GPU : 雙 RTX 5070 Ti(tensor split 1,1)
    • 記憶體 : DDR4 128GB (32*4)
    • PCIe: 雙 PCIe 3.0 x8
    • 電源限制:雙卡 -pl 266
    • 模型:Qwen3.8-27B-UD-Q5_K_XL.gguf
    • 多模態:mmproj-Qwen3.8-27B-f16.gguf

    ⚙️ 啟動參數(llama-server)

    bat
    @echo off
    chcp 65001 >nul

    set "MY_PATH=D:\llama_cuda_13_3"

    echo ==================================================
    echo [INFO] Setting GPU Power Limit...
    echo ==================================================
    nvidia-smi -i 0 -pl 266
    nvidia-smi -i 1 -pl 266
    timeout /t 2 >nul

    cd /d "%MY_PATH%"

    llama-server.exe ^
    -m "models\Qwen3.8-27B-UD-Q5_K_XL.gguf" ^
    --mmproj "models\mmproj-Qwen3.8-27B-f16.gguf" ^
    --split-mode tensor ^
    --tensor-split 1,1 ^
    --main-gpu 0 ^
    --spec-type draft-mtp ^
    --spec-draft-ngl 999 ^
    --spec-draft-n-max 2 ^
    --spec-draft-p-min 0 ^
    --ctx-size 131072 ^
    -b 2048 ^
    -ub 512 ^
    -ngl 999 ^
    -t 16 ^
    -fa on ^
    --cache-type-k q8_0 ^
    --cache-type-v q8_0 ^
    -cb ^
    -np 1 ^
    --jinja ^
    --chat-template-kwargs "{"reasoning_effort":"low"}" ^
    --host 0.0.0.0 ^
    --port 8080 ^
    --temp 0.2 ^
    --top-p 0.7 ^
    --top-k 20 ^
    --min-p 0.08 ^
    --samplers "top_k;top_p;min_p;temperature" ^
    --repeat-penalty 1.05

    pause

    🔍 參數重點說明

    Hermes [機器人]17:57

    分類 參數 說明
    分片 --split-mode tensor / --tensor-split 1,1 雙卡張量並行,各分一半
    投機解碼 --spec-type draft-mtp / n-max 2 MTP 草稿投機,最多 2 token
    上下文 --ctx-size 131072 128K 長上下文
    Batch -b 2048 / -ub 512 主 batch 2048、微 batch 512
    加速 -fa on / -cb Flash Attention + Context Batching
    KV Cache q8_0 / q8_0 K/V 量化省顯存
    採樣 temp 0.2 / top-p 0.7 / top-k 20 / min-p 0.08 低溫穩定輸出
    思考 reasoning_effort: low 低思考強度,換取速度


  • Nvidia 雙卡 RTX5070 Ti 16G - Decode 最高 140 tok/s on Strata v0.1.31 - Swift-Qwen3.8-Flash-Next
    YDMY YDM
    LLM讨论区 rtx5070 多卡部署 qwen-flash

    @kos-or

    我沒時間玩,但有偷偷看,別吸引我😁


  • Nvidia 雙卡 RTX5070 Ti 16G - Decode 最高 140 tok/s on Strata v0.1.31 - Swift-Qwen3.8-Flash-Next
    YDMY YDM
    LLM讨论区 rtx5070 多卡部署 qwen-flash

    **【實測更新】Strata v0.1.45 + IQ4_XS — 雙卡 RTX5070 Ti

    剛跑完雙卡 RTX 5070 Ti,同一套四情境測法(各生成 1,200 tokens × 3 輪取平均),數據更新如下:

    雙卡 RTX 5070 Ti 16G Decode:
    解題 : 113.7 tok/s
    Coding: 106.7 tok/s
    英文寫作 : 117.3 tok/s(單輪最高衝到 136.3)
    中文寫作 : 108.7 tok/s

    平台規格 :
    目標模型 :Qwen3.8-Flash-Next-Uncensored.i1-IQ4_XS
    推理引擎 :Strata v0.1.45
    Context : 256 K
    CPU : i9-9900K|RAM : DDR4 128GB|PCIe : PCIe 3.0 x8 + x8(無 NVLink,雙卡 tensor split 1,1)

    小結:

    • 跟樓主 v0.1.31 的數據對照,同測法下 IQ4_XS+v0.1.45 基本持平略勝(英文寫作單輪有摸到 136)。
    • 所有調優都試過,速度一直上不去,我判斷卡在 PCIe 3.0,測試只有跑6.8G——IQ4_XS 權重單張 16G 裝不下必須雙卡,每層 decode activation 都要走 PCIe 交換,x8+x8 頻寬再砍半。量化已經換到帶了,瓶頸就轉移到總線。同場雙卡玩家若能單卡裝下,試試單卡模式對照就知道差在哪。

  • Nvidia 雙卡 RTX5070 Ti 16G - Decode 最高 140 tok/s on Strata v0.1.31 - Swift-Qwen3.8-Flash-Next
    YDMY YDM
    LLM讨论区 rtx5070 多卡部署 qwen-flash

    @kos-or

    我還是老樣子,strata 跑在windows 測試是用同一台主機中的vm虛擬主機,跑ubuntu,pcie掉速可能只讀需要的專家吧,我將模型整個放在RAM中,還是有一點點會掉到SSD,我只有一台電腦只能全在這台跑。

    下面跑的是我測試,不會突然掉速的限制VRAM餘量,吃光有時後會掉速,因該是WINDOWS分頁的問題。

    目前兩張顯卡(2× RTX 5070 Ti 16GB)在目前執行的 [strata-uncensored-iq4_xs.json]設定下的即時顯存與專家配置如下:

    一、駐留專家數量(Resident Experts)

    設備 負責層數 專家槽位數 專家佔用顯存
    GPU 0 (CUDA0) Layers 0–23 4,244 個 10.52 GiB
    GPU 1 (CUDA1) Layers 24–47 4,159 個 10.31 GiB
    雙卡合計 全 48 層 8,403 個 20.83 GiB

    全模型共 24,576 個專家,雙卡總共長駐 8,403 個高頻專家(佔比 34.2%),在最新推論時解碼專家快取命中率維持在 90.4% ~ 94.2%。

    二、兩張顯卡剩餘顯存(Free VRAM)

    1. Strata 引擎模型載入後基準剩餘(目標 500~550 MiB)

    • GPU 0:537 MiB(完美落在 500~550 MiB 區間)
    • GPU 1:517 MiB(完美落在 500~550 MiB 區間)

    2. nvidia-smi 即時實體顯存監控(含動態工作緩衝區釋放後)

    • GPU 0:已用 14,847 MiB / 剩餘 1,149 MiB(溫度 36°C)
    • GPU 1:已用 14,780 MiB / 剩餘 1,216 MiB(溫度 33°C)

    雙卡均穩定維持在 500 MiB 安全邊際以上,無任何 WDDM 記憶體分頁延遲,運行表現最佳。


  • Nvidia 雙卡 RTX5070 Ti 16G - Decode 最高 140 tok/s on Strata v0.1.31 - Swift-Qwen3.8-Flash-Next
    YDMY YDM
    LLM讨论区 rtx5070 多卡部署 qwen-flash

    @kos-or

    本來全放RAM的,我昨天也有測試,我改為direct放SSD了,速度差異0.x%,反而全放RAM有時後掉一點到SSD會破碎反而慢1~2x%,不能把RAM用到爆😁

    不在家我會把其它軟體關掉,專家大該8600~8700左右。
    image.jpeg

    更新Strata 0.2.2(0.1.47 核心)+ CUDA 13.4.3 + Blackwell sm_120

    四情境測速結果(qwen3.8-flash-next-uncensored-iq4_xs @ n_ctx 262K)

    情境 R1 R2 R3 平均
    解題 107.0 130.9 104.7 114.2 tok/s
    Coding 122.2 124.8 108.5 118.5 tok/s
    英文寫作 121.2 123.2 111.1 118.5 tok/s
    中文寫作 117.5 109.5 111.9 113.0 tok/s

    💡 解讀:

    • 四情境平均全數突破 110,單輪最高 130.9——比 16K 標準基準的穩態(94~107)還高一截。原因:四情境 prompt 短、TTFT 只有 3~6 秒,Decode 段幾乎全程跑熱機穩態,這正是論壇「最高值」口徑的由來。
    • Coding/英文寫作最快、解題與中文寫作略慢,屬正常的輸出內容差異,非硬體問題。
  • 登录

  • 登录或注册以进行搜索。
  • 第一个帖子
    最后一个帖子
0
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组