
2017 年我人在中國大陸,當時透過 VPN 使用 YouTube 上傳影片,結果帳號直接被封,整個頻道也被刪掉。
從那次之後,我就一直覺得,把自己的內容、品牌,甚至收入來源完全建立在第三方平台上,其實是一件很可怕的事。平台今天可以給你流量,明天也可以因為規則改變、誤判,甚至你根本不知道的原因,直接把一切收走。
所以對我來說,自己的品牌和網域就像「聖經正典」一樣,是最核心、最原始、也最不應該被任何平台取代的東西。社群平台可以來來去去,但自己的網站和網域,才是真正屬於自己的根基。
 Y
2017 年我人在中國大陸,當時透過 VPN 使用 YouTube 上傳影片,結果帳號直接被封,整個頻道也被刪掉。
從那次之後,我就一直覺得,把自己的內容、品牌,甚至收入來源完全建立在第三方平台上,其實是一件很可怕的事。平台今天可以給你流量,明天也可以因為規則改變、誤判,甚至你根本不知道的原因,直接把一切收走。
所以對我來說,自己的品牌和網域就像「聖經正典」一樣,是最核心、最原始、也最不應該被任何平台取代的東西。社群平台可以來來去去,但自己的網站和網域,才是真正屬於自己的根基。
我找到問題了,官方的prompt guide有說該怎麼用。我是智障。。。
在summary section 裡第一行加[reference generation]就行了
謝謝! 我試試看
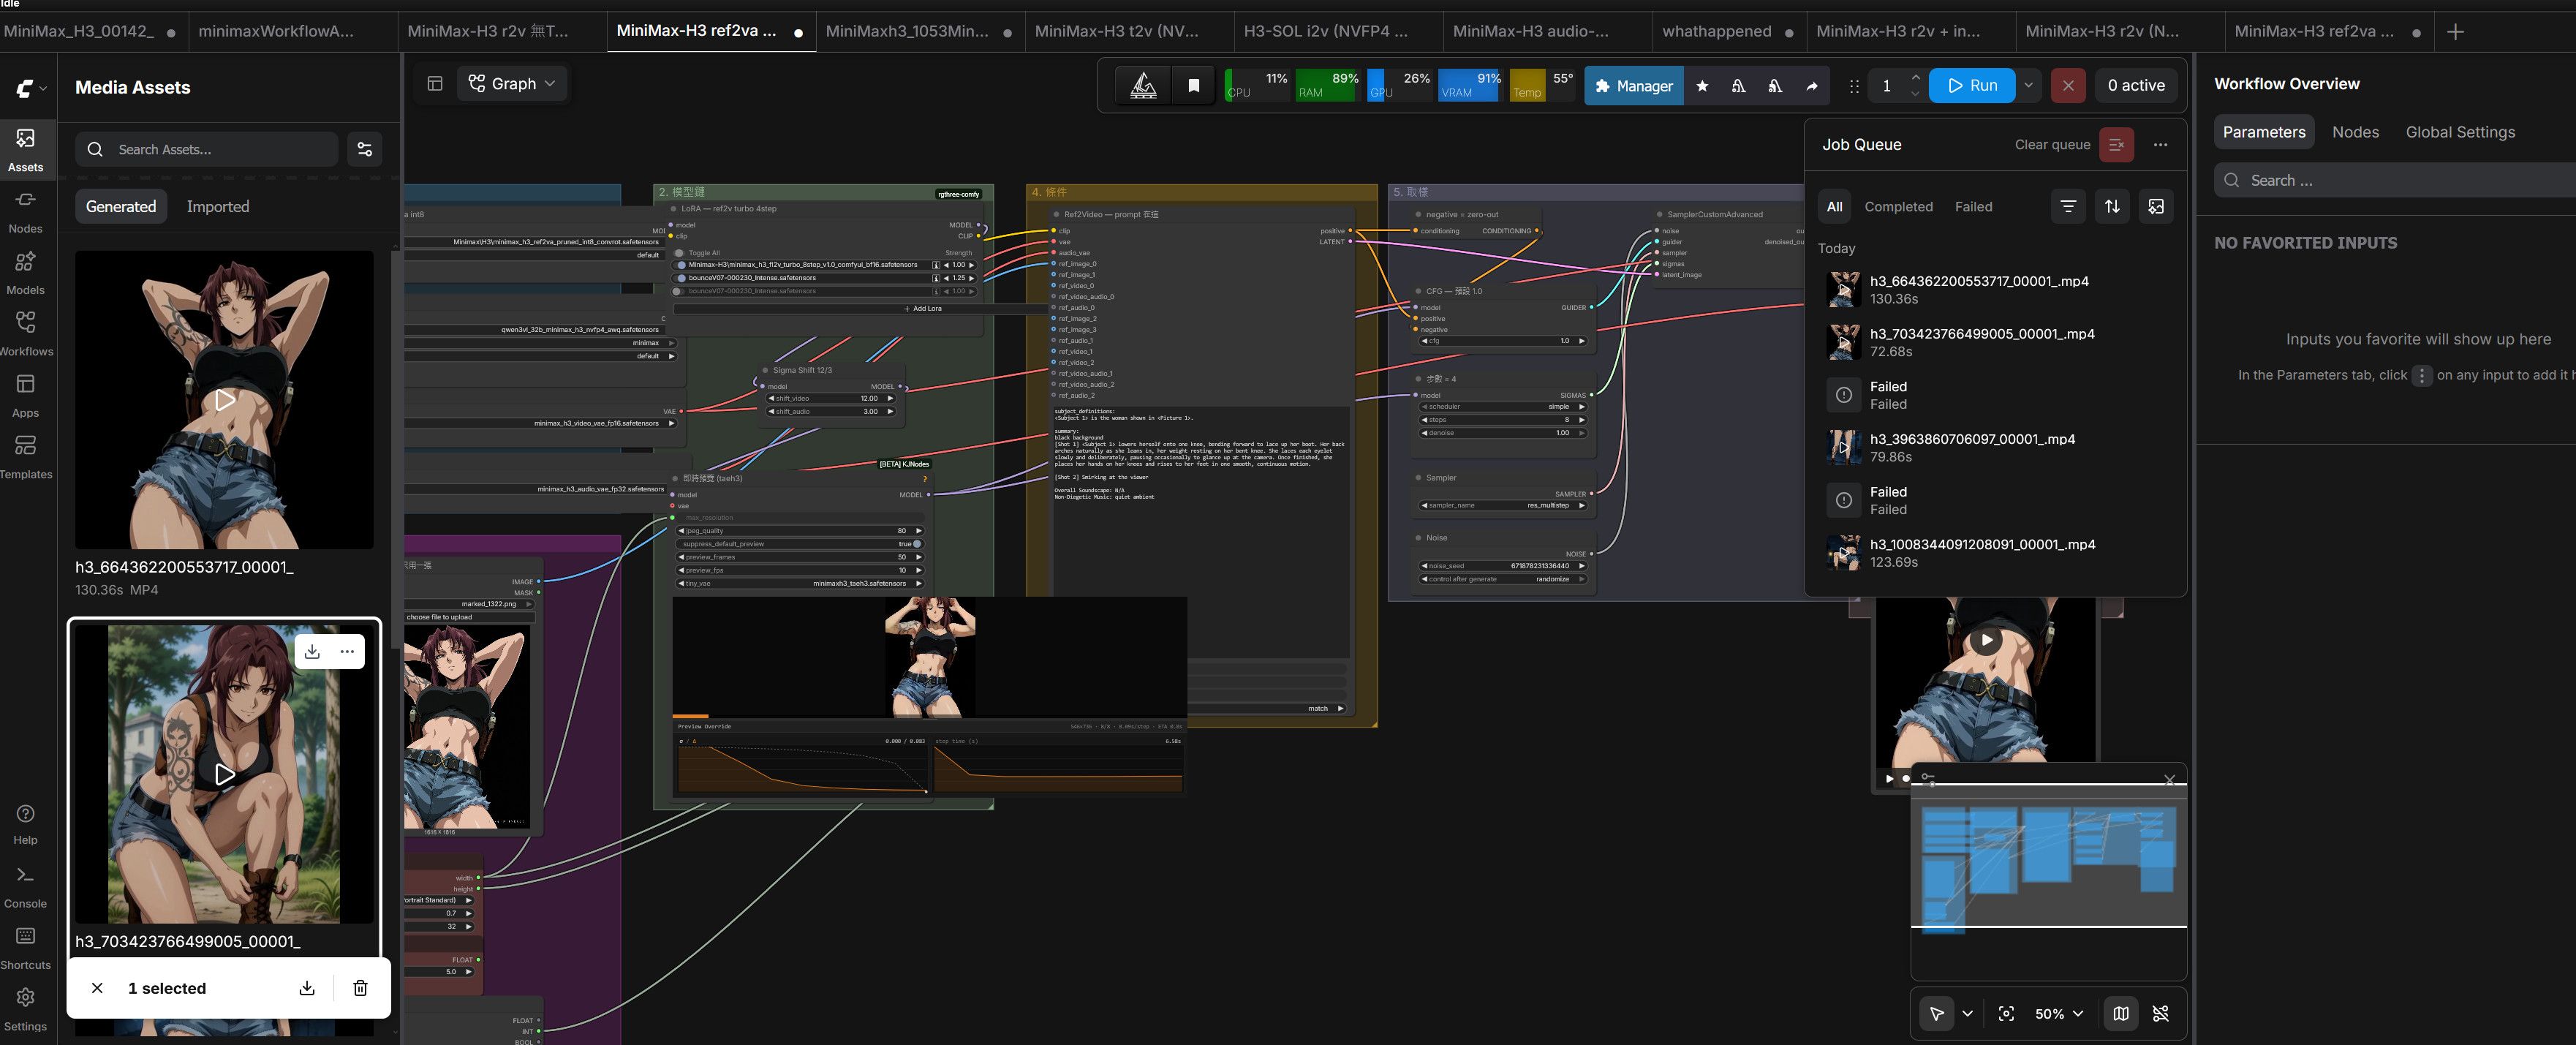
給附圖,其實這問題困擾我很久了。每次用 r2v model 很常常首幀直接拿 ref image,或甚至直接搬移影片(ref video)。用起來常常變成 fl2v 一樣了,要常常抽卡,有機會 ref 的素材才真的變成「參考素材」。
目前用的是 MiniMax H3 Ref2V(minimax_h3_ref2va_pruned_int8_convrot),搭配 Qwen3-VL 32B text encoder、FL2V Turbo 8-step LoRA(1.0)。附圖這次是丟 1張 ref image。
目前在等有更好的 IR-context node 之類的……
不知道有沒有人找到比較穩定的方法,可以讓 image/video reference 真的只提供 identity / appearance / motion reference,而不是直接主導 initial frame。